Семинар 1. знакомство
Семинар 1 · ~77 мин · 17 слайдов
01 · О преподавателе — Левко Максим Николаевич
Для начала позвольте представиться — тут вы услышите про мою предпринимательскую сторону, а на лекции — индустриальный опыт.
02 · Разминка: как вы используете AI?
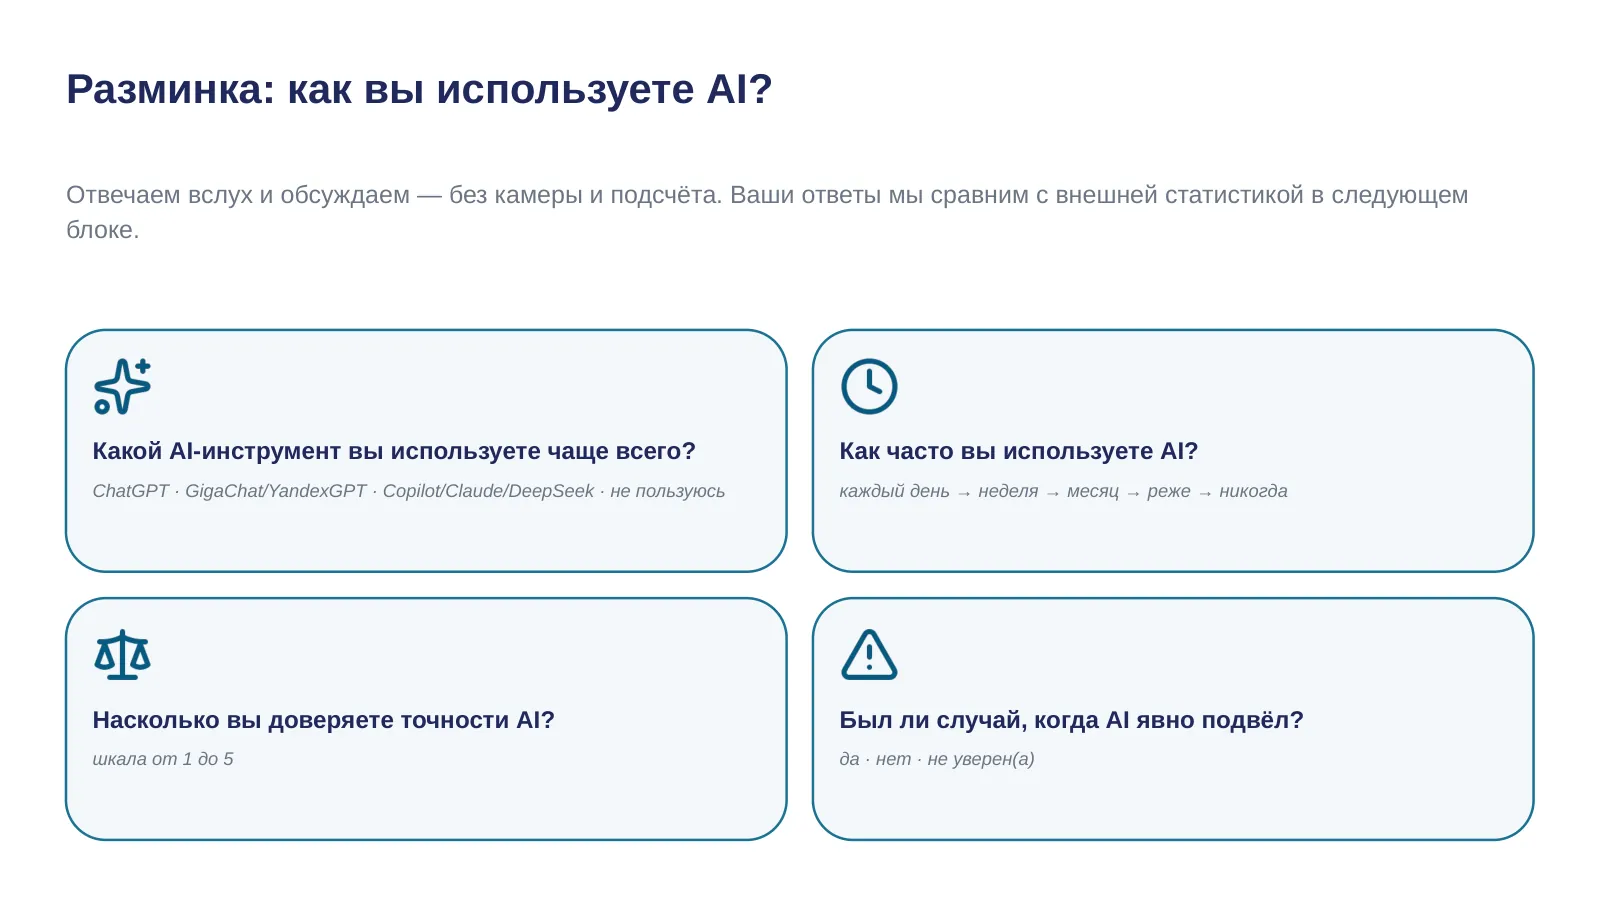
Небольшая разминка перед статистикой — знакомимся с тем, как группа работает с AI. Формат простой: я задаю вопрос, отвечаете вслух, при желании поднимаете руку — это не голосование с камерой и подсчётом, а живой разговор, чтобы увидеть картину группы.
Четыре вопроса. Первый — какой AI-инструмент вы используете чаще всего: ChatGPT, GigaChat или YandexGPT, GitHub Copilot / Claude / DeepSeek, или не пользуетесь вовсе. Второй — как часто: каждый день, несколько раз в неделю, реже, никогда. Третий — насколько доверяете точности AI по шкале от одного до пяти. Четвёртый — был ли случай, когда AI вас явно подвёл.
Эти ответы понадобятся в следующем блоке — будем сравнивать вашу группу с внешними исследованиями: выше вы или ниже по доверию, чаще или реже пользуетесь.
03 · Используют чаще, доверяют меньше — и это не парадокс
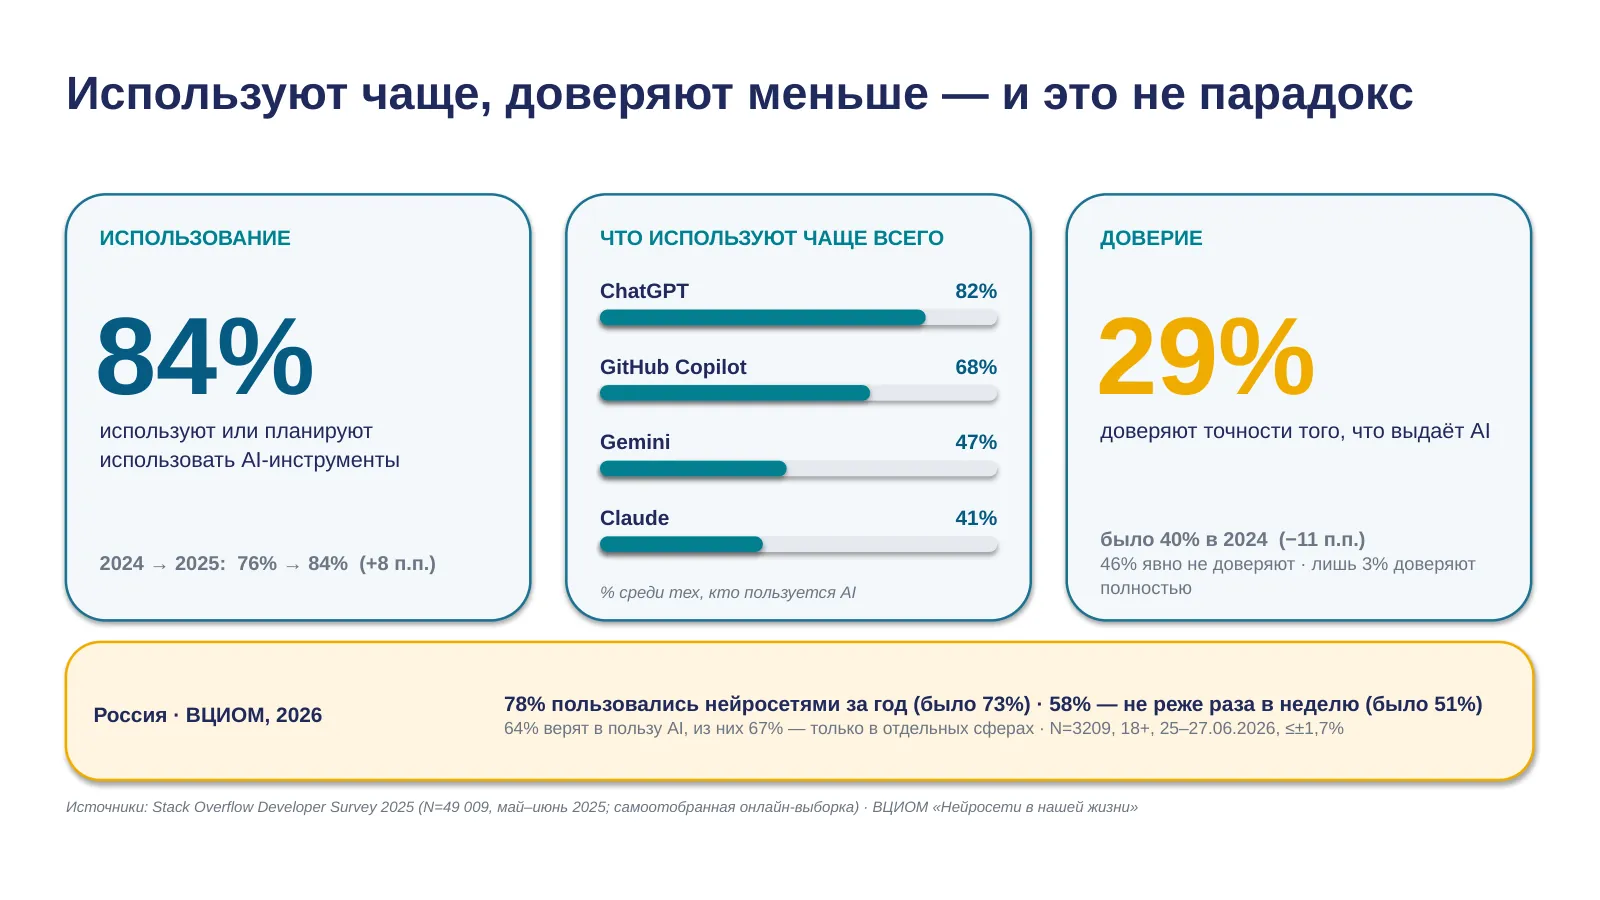
Первый источник — Stack Overflow Developer Survey 2025. Восемьдесят четыре процента разработчиков используют или планируют использовать AI-инструменты в разработке — рост с семидесяти шести процентов в 2024 году. При этом лишь двадцать девять процентов доверяют точности того, что выдаёт AI — падение с сорока процентов годом ранее.
Как это возможно — использовать инструмент чаще, но доверять ему меньше? Это не парадокс: инструмент используют как черновик, который обязательно проверяют, — признак зрелого использования. Важная деталь методологии: это самоотобранный онлайн-опрос — отвечают те, кто сам зашёл на сайт Stack Overflow, аудитория смещена в сторону англоязычных разработчиков.
Второй источник — ВЦИОМ, «Нейросети в нашей жизни». В 2025 году семьдесят три процента россиян пользовались нейросетями за последний год, пятьдесят один процент — не реже раза в неделю; по данным 2026 года эти цифры выросли до семидесяти восьми и пятидесяти восьми процентов. ВЦИОМ опрашивает россиян в целом, а не только инженерную студенческую аудиторию.
Нижняя полоса — ваши собственные цифры из опроса минуту назад, по всем четырём вопросам. Впишите (устно, вслух, я подпишу на слайде или зафиксирую на доске) результаты: какой AI-инструмент называли чаще всего, как часто группа пользуется AI, среднее значение доверия по шкале 1–5, и сколько человек подняли руку на «AI меня подводил». Как ваша группа соотносится с двумя внешними источниками — выше или ниже по доверию, чаще или реже пользуется?
04 · У кого есть история — помогло или подвело?
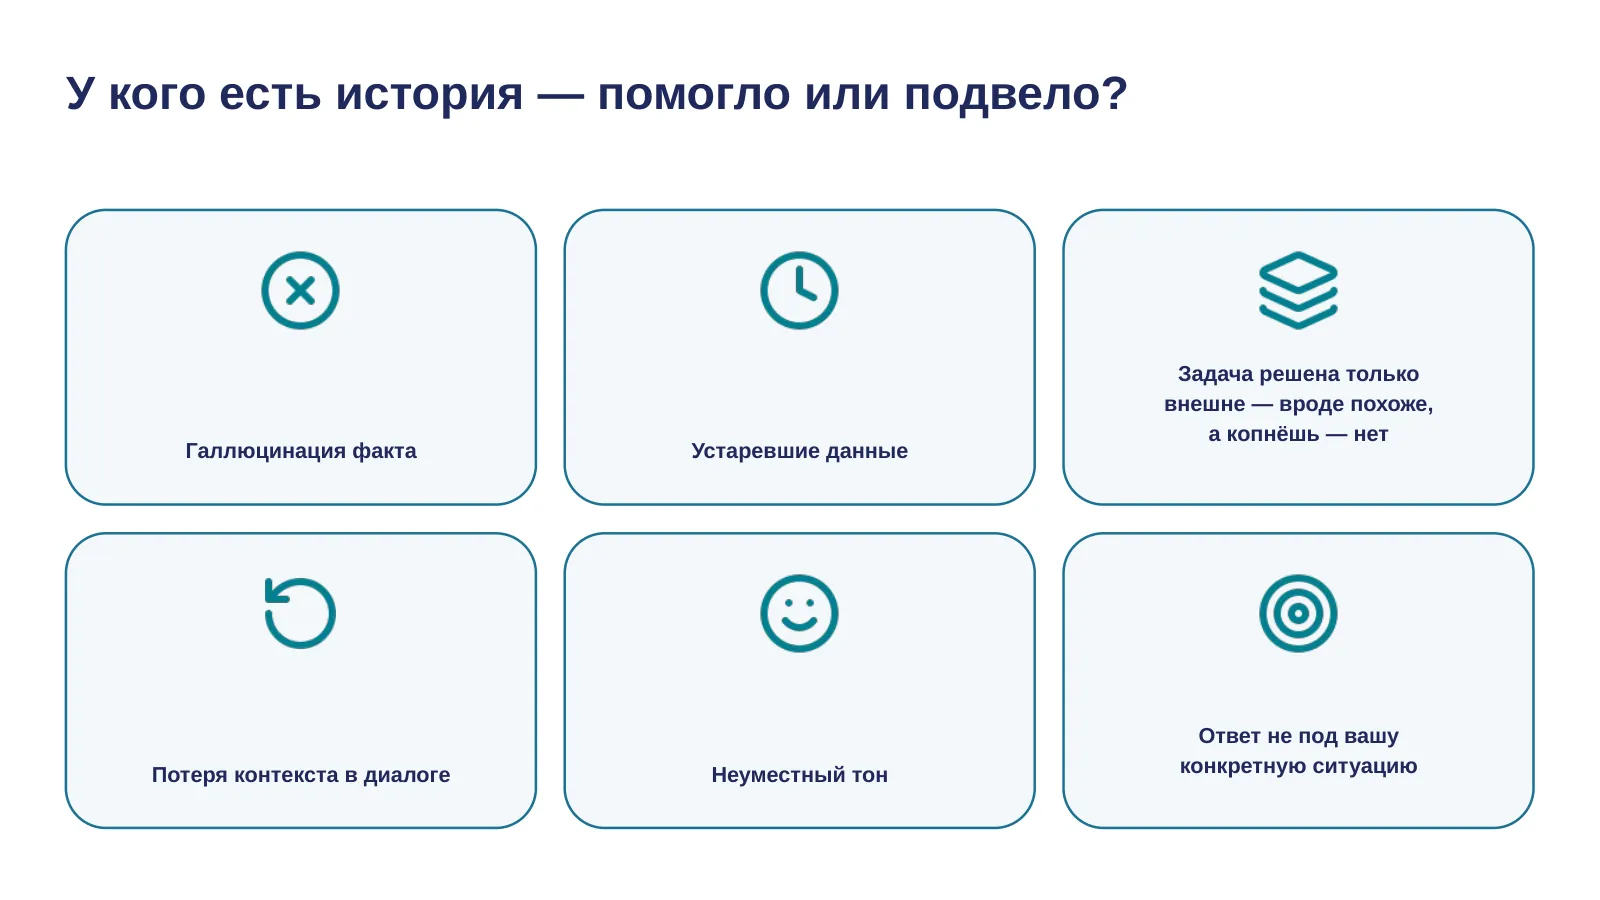
Теперь — открытый обмен опытом перед всей аудиторией. По очереди, по желанию или по вашему вызову, вы вслух расскажете один случай, когда AI реально помог, и один случай, когда AI подвёл или ошибся. Мы вместе, на доске, найдём общие закономерности в собранных историях.
У кого есть история, когда AI реально помог — поднимите руку. Если желающих не находится сразу — не страшно, я могу обратиться к кому-то из вас напрямую. Будем чередовать: одна история успеха, затем провал, снова успех — так удерживаем баланс и не даём разговору скатиться в одну тональность.
Шесть категорий провалов AI, которые встречаются чаще всего: галлюцинация факта — AI уверенно выдумывает несуществующий факт или источник; устаревшие данные — AI отвечает информацией, которая была верна на момент обучения, но устарела; задача, решённая только внешне — результат выглядит похожим на правильный, но при проверке оказывается, что суть не решена (это шире, чем просто код: тот же паттерн бывает и в тексте, и в расчёте); потеря контекста в длинном диалоге, когда AI забывает условия из начала разговора; неуместный тон или стиль ответа; и слишком общий совет — AI даёт правильный в целом, но неспецифичный ответ, который не учитывает вашу конкретную ситуацию. Когда рассказываете историю-провал — попробуйте сами предположить, к какой категории она относится, мы уточним вместе. Именно неудачные истории особенно ценны сегодня: они помогают увидеть реальные границы возможностей AI, а не только впечатляющие примеры. Этот же термин — галлюцинация — вернётся точным определением в блиц-квизе позже.
— Личные истории преподавателя (рассказать в этом блоке, по одной на категорию) —
-
Галлюцинация факта. В прошлом году, когда я писал статью для конференции, модель выдала несколько ссылок на научные работы, которых не существует, — а часть ссылок вела на реальные статьи, но совсем по другой теме, чем она заявляла. Выглядело уверенно и правдоподобно, поэтому каждую ссылку пришлось проверять руками.
-
Устаревшие данные. В разработке это особенно заметно: модель тянет устаревшие версии библиотек и, хуже того, устаревшие подходы. Например, просишь компонент на React — а она пишет его на классах с componentWillMount вместо хуков; или предлагает moment.js, который давно не развивается, вместо date-fns или встроенного Temporal. Код формально рабочий, но подход — из позавчерашнего дня.
-
Задача решена только внешне. Так происходит почти с каждым продуктом, который я делаю: первый прототип от AI выглядит очень похоже на нужное — экран, кнопки, ответы, — но копнёшь внутрь, и часто оно либо не работает, либо имитирует работу (данные захардкожены, обработка ошибок нарисована, но не подключена). Снаружи готовый продукт, внутри декорация.
-
Потеря контекста. В длинном диалоге по рефакторингу через пару десятков сообщений модель забывает то, о чём мы договорились в начале: скажем, я явно сказал «не тянем внешних зависимостей» и мы переименовали модуль — а через двадцать реплик она снова предлагает стороннюю библиотеку и старое имя, будто разговора не было. Контекст уехал за пределы окна, и условия приходится напоминать заново.
-
Неуместный тон. Пример прямо перед вами — эти лекции. Я готовлю их с активным участием AI, и до сих пор на слайдах и в заметках можно поймать странные обороты и тон, которые я не дочистил. Это честный пример того, что тон модели надо править вручную.
-
Ответ не под вашу ситуацию. У меня постоянно всплывает одна и та же история — параноидальная «информационная безопасность» модели на дев- и тест-стендах: она сопротивляется сохранить или показать логины и пароли тестовых пользователей, потому что «это небезопасно», хотя речь про заведомо тестовые учётки на локальном стенде, где это ровно то, что нужно. Совет правильный вообще — но не под мою конкретную ситуацию.
05 · Кто автор — художественный текст: AI или человек?
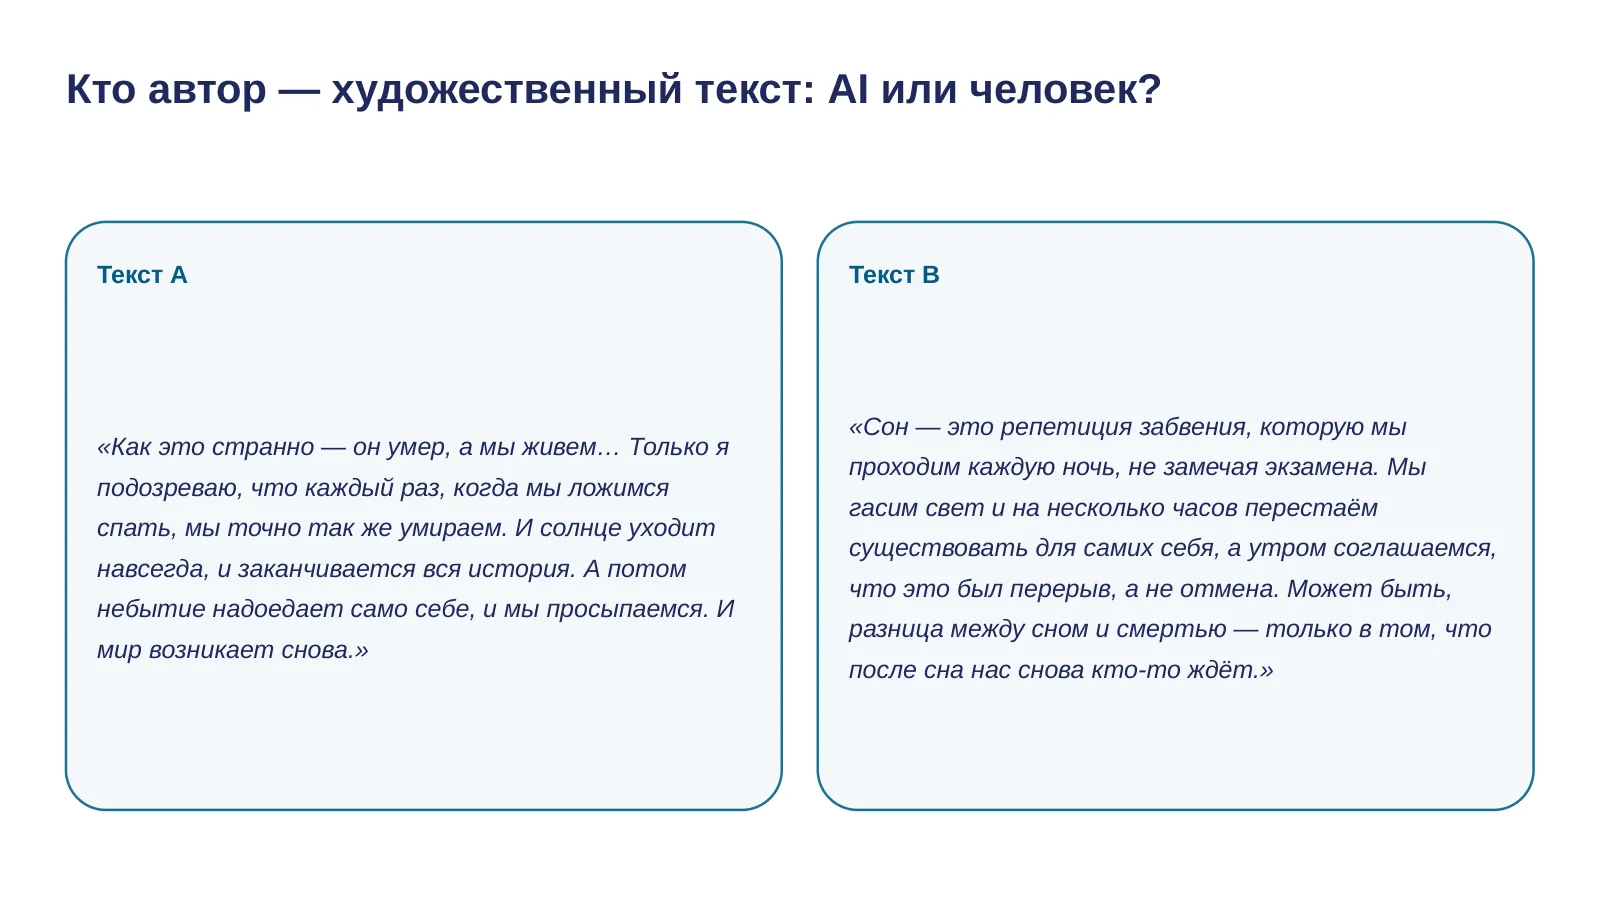
Первая категория калибровочной игры — художественный текст. Два коротких фрагмента на тему сна и реальности, без подписи. Голосуем: какой написал человек, какой — AI.
Оба текста нарочно похожи по теме и по интонации — задача не в том, чтобы найти очевидную разницу в теме, а в том, чтобы услышать разницу в стиле, если она вообще заметна на таком коротком фрагменте.
После голосования — спросите одного-двух студентов, что натолкнуло их на выбор: ритм фразы, характерные обороты, узнаваемая интонация? В художественном тексте объективного измеримого критерия «кто лучше» нет — это категория про стиль и узнавание, не про производительность.
06 · Текст A — Пелевин, «Generation П». Текст B — AI
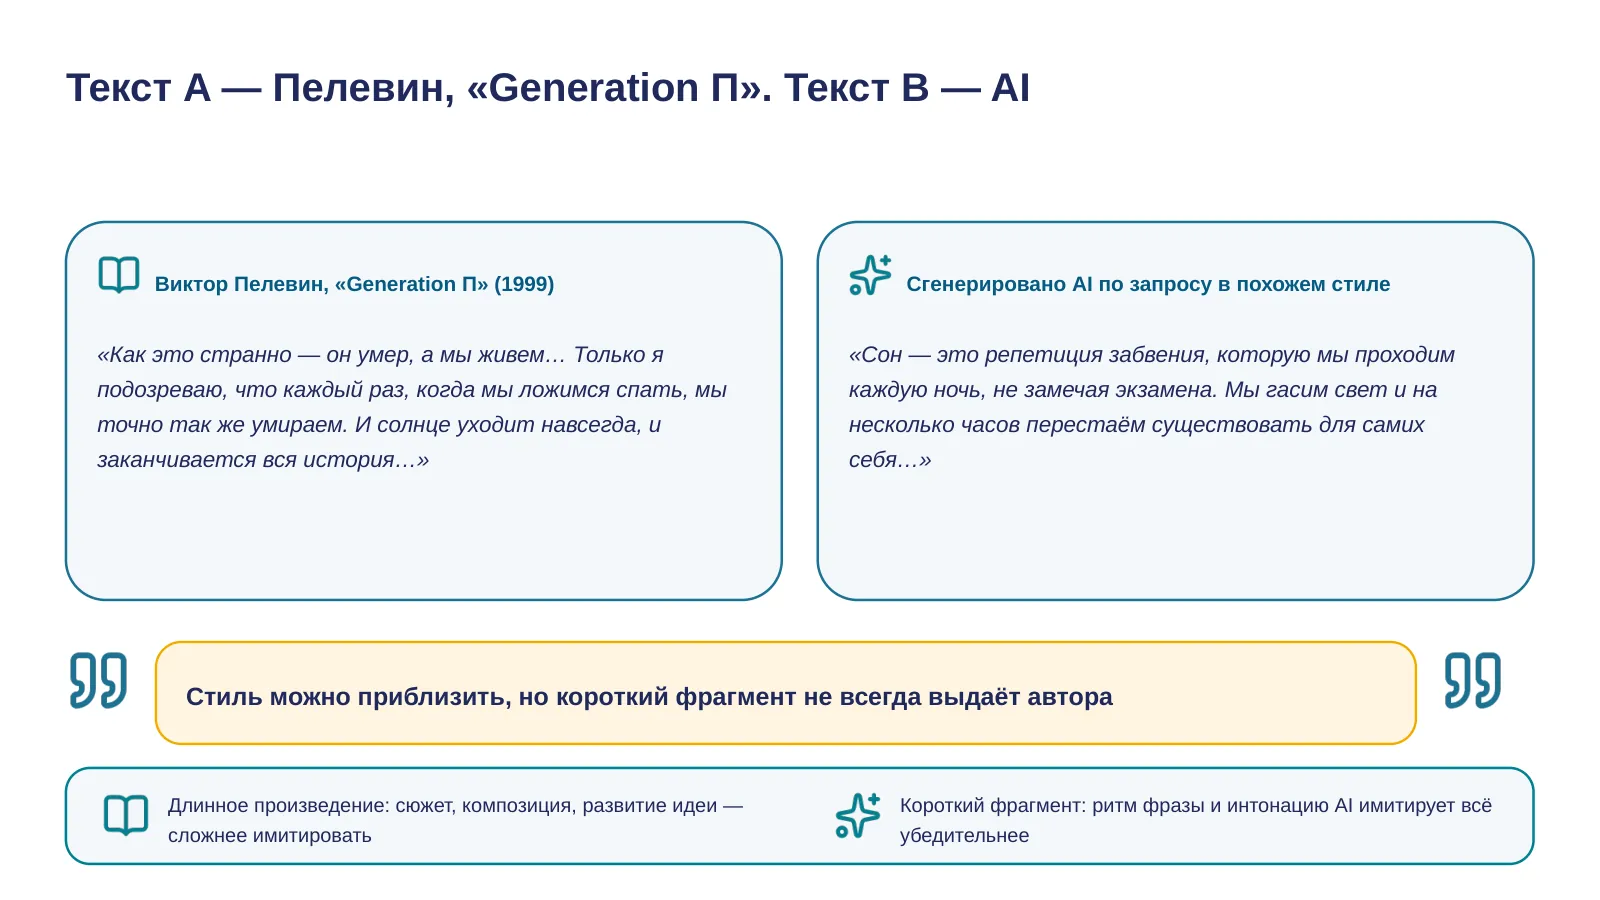
Текст А — реальная цитата из романа Виктора Пелевина «Generation П», 1999 год. Текст Б сгенерирован AI по запросу приблизить похожий философско-рефлексивный стиль на тему сна и реальности.
На таких коротких фрагментах современные модели действительно неплохо имитируют узнаваемую манеру письма — ритм фразы, характерные конструкции. Это не значит, что AI «пишет как Пелевин» в широком смысле — воспроизвести стиль на двух-трёх предложениях и написать целостное произведение с оригинальной мыслью — разные по сложности задачи. Урок этого раунда: короткий стилизованный фрагмент — ненадёжный тест для определения авторства, особенно в художественном тексте.
07 · Кто автор — технический текст: AI или человек?
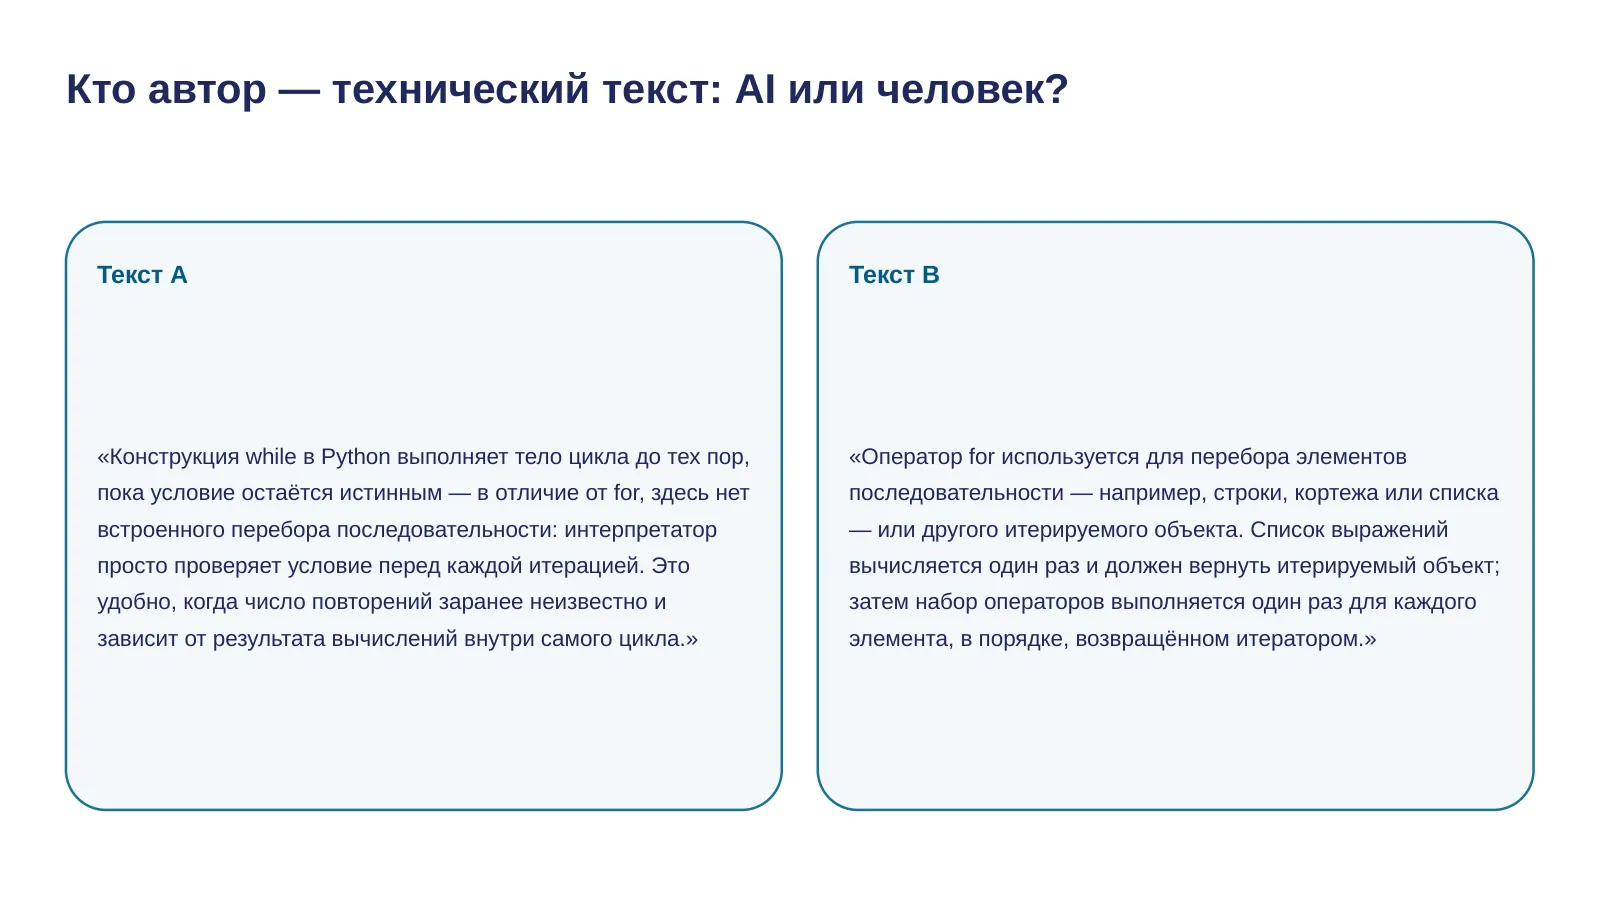
Вторая категория — технический текст, документация. Два фрагмента, объясняющих поведение конструкции языка программирования. Голосуем, какой писал человек, какой — AI.
Здесь, помимо вопроса «кто автор», обсудим ещё один: в чём и насколько измеримо AI-версия отличается по практической продуктивности от официальной документации? Не только «кто написал», но и «что это значит для того, кто ищет ответ прямо сейчас».
После голосования спросите: какие признаки натолкнули на выбор — точность формулировок, характерная структура объяснения через сравнение с другими языками?
08 · Текст A — AI, за секунды. Текст B — официальная документация Python
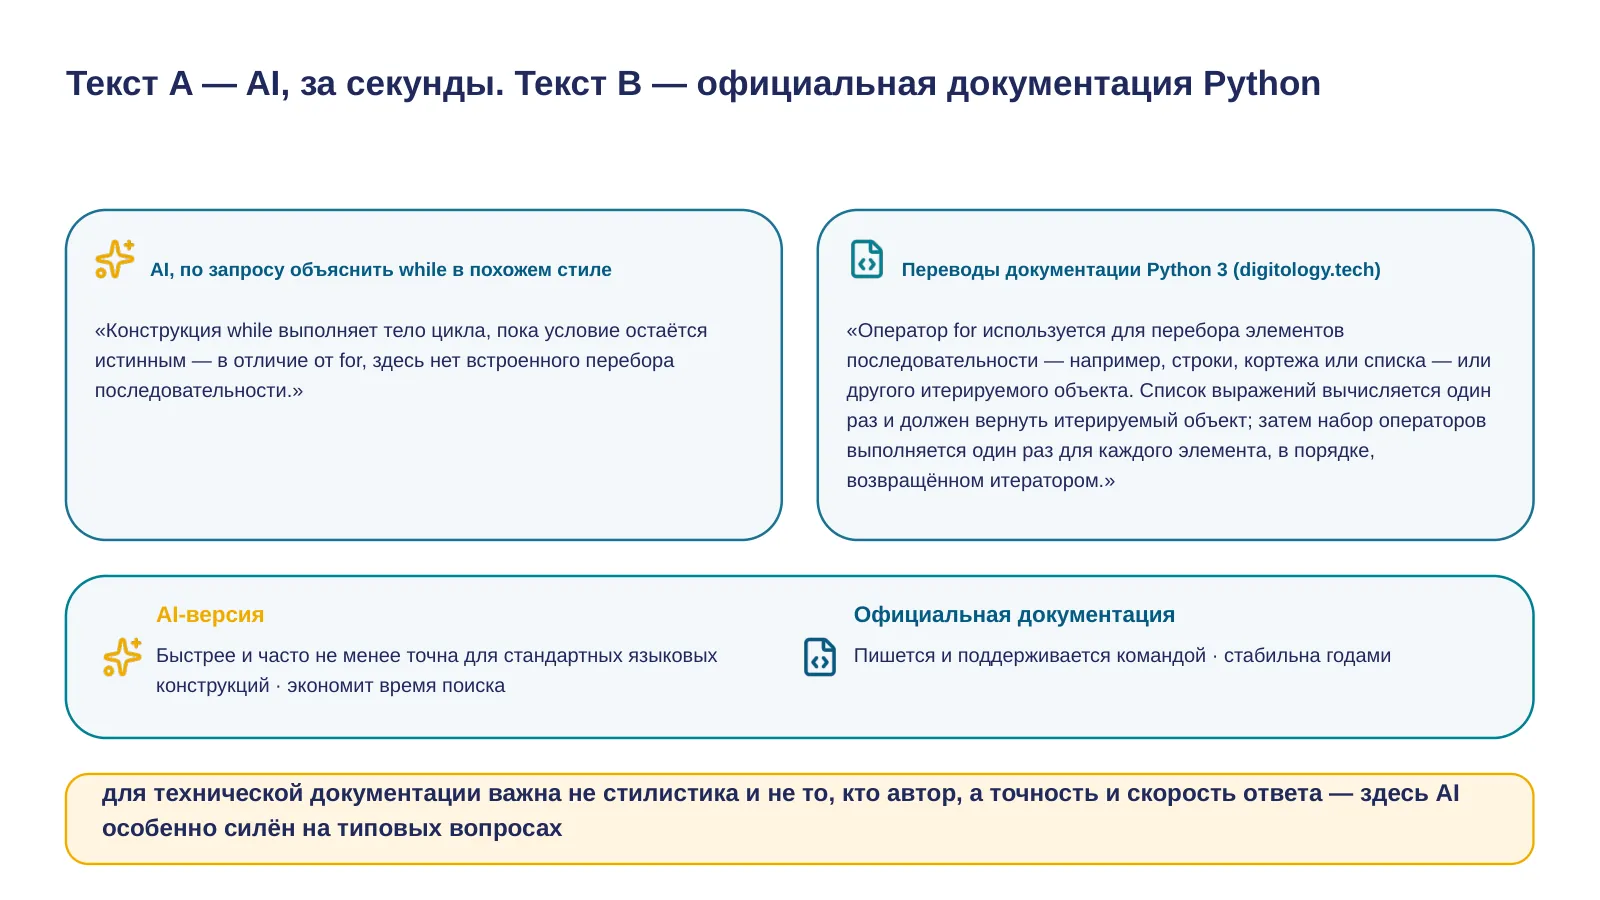
Текст А сгенерирован AI по запросу объяснить while в документационном стиле. Текст Б — точная цитата из официального русского перевода документации Python 3 (портал «Переводы документации Python 3», digitology.tech), раздел «8.3. Оператор for».
Здесь важен не только вопрос авторства, а честное сравнение: официальная документация пишется и поддерживается командой, проходит ревью, стабильна годами. Но для стандартных языковых конструкций вроде for и while AI-версия часто не менее точна — а получаете вы её за секунды, без необходимости искать и читать документацию целиком.
Урок: для технической документации на первый план выходит не то, кто автор, а точность и скорость получения ответа. На типовых, хорошо документированных вопросах — синтаксис языка, стандартные конструкции — AI особенно силён именно потому, что эта информация многократно и единообразно описана в его обучающих данных.
09 · Кто автор — код: AI или человек?
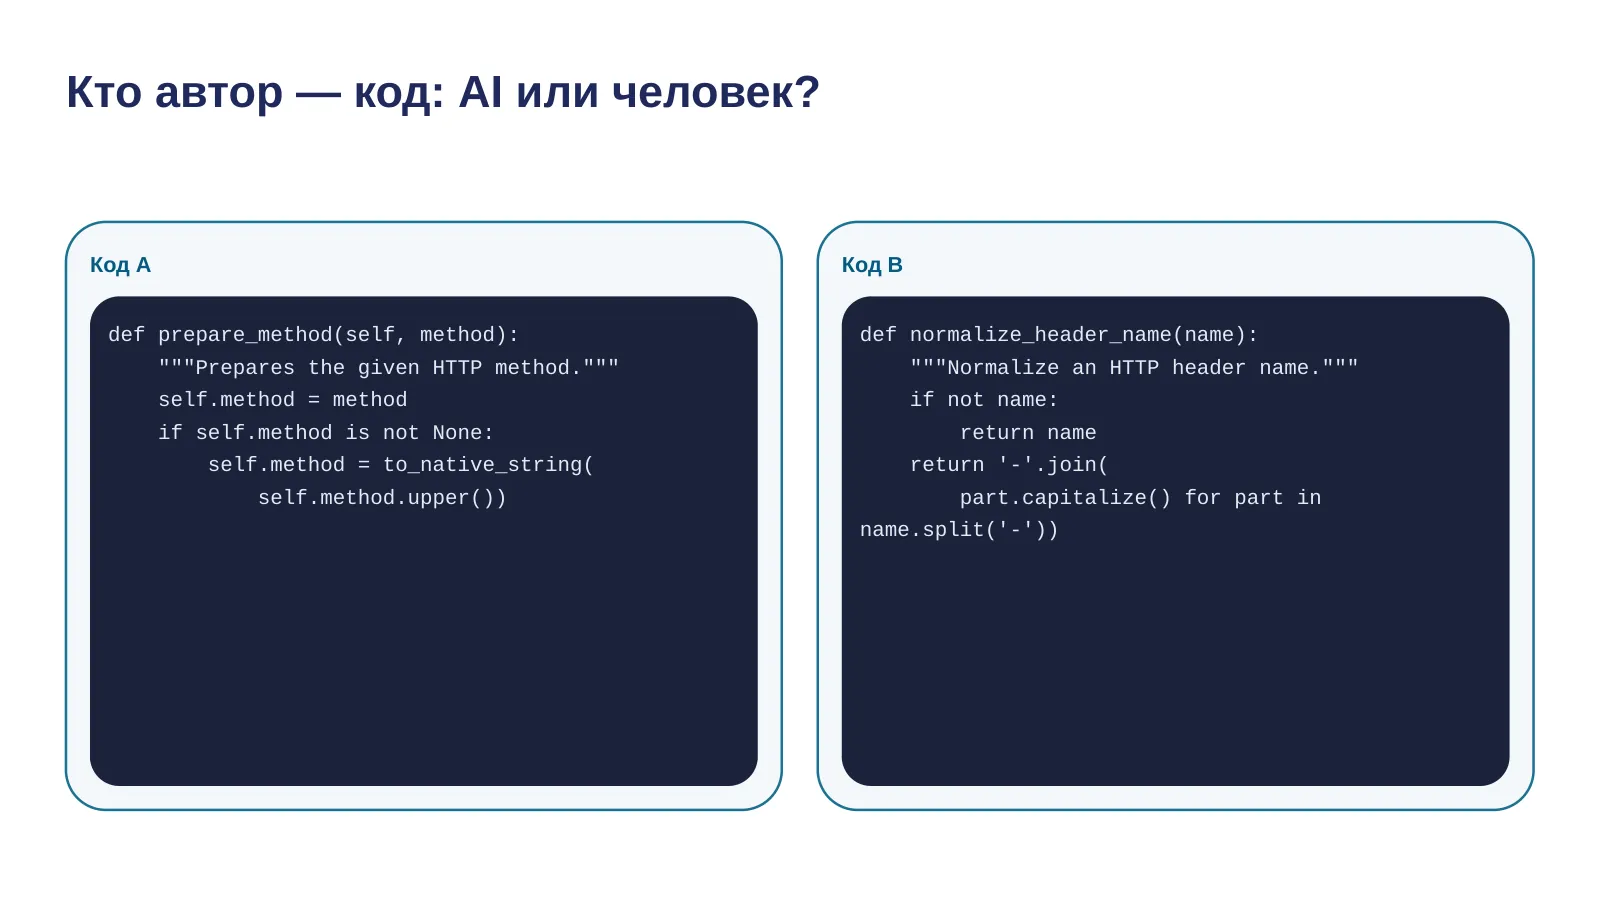
Третья категория — код. Две маленькие функции, примерно одного масштаба. Голосуем: какую написал человек, какую — AI.
Здесь тоже важен не только вопрос авторства: в чём измеримая разница в продуктивности между «получить функцию от AI» и «использовать проверенную библиотеку»? Обсудим это в разборе.
После голосования спросите: что натолкнуло на выбор — стиль именования переменных, docstring, структура условной проверки?
10 · Код A — библиотека requests, 10+ лет в проде. Код B — AI, 10-20 секунд
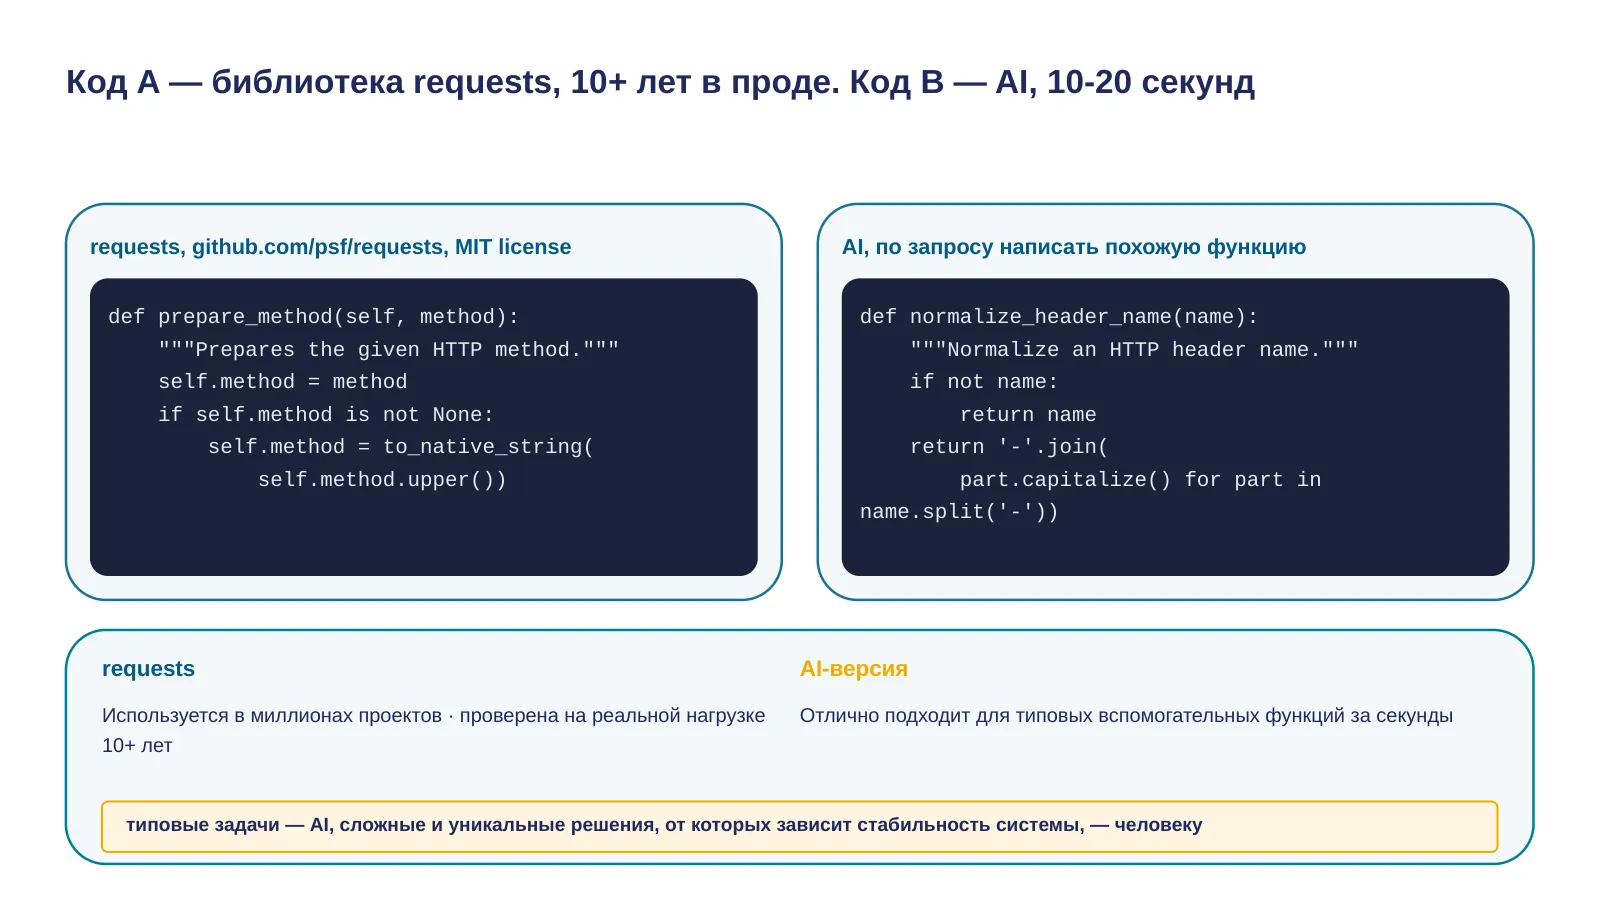
Код А — реальная функция из библиотеки requests, одной из самых используемых библиотек Python, с открытым исходным кодом на GitHub, лицензия MIT. Код Б сгенерирован AI по аналогичному запросу — написать небольшую функцию похожего масштаба.
Честное сравнение, без принижения любой из сторон: requests — код, который уже больше десяти лет работает в тысячах и миллионах реальных проектов, каждый скрытый баг за это время скорее всего найден и исправлен сообществом — это результат многолетней проверки на сложной нагруженной инфраструктуре. AI-версию вы получаете за 10–20 секунд — отличный вариант именно для таких типовых вспомогательных функций, boilerplate-кода, одноразовых скриптов.
Урок этого раунда — не «AI хуже», а разделение по типу задачи: типовые, вспомогательные задачи — AI, это быстрее и достаточно надёжно. Сложные и уникальные решения, архитектурные, высокоставочные, от которых зависит стабильность системы, — человеку, с его опытом и ответственностью за решение.
11 · Кто автор — картина: AI или человек?
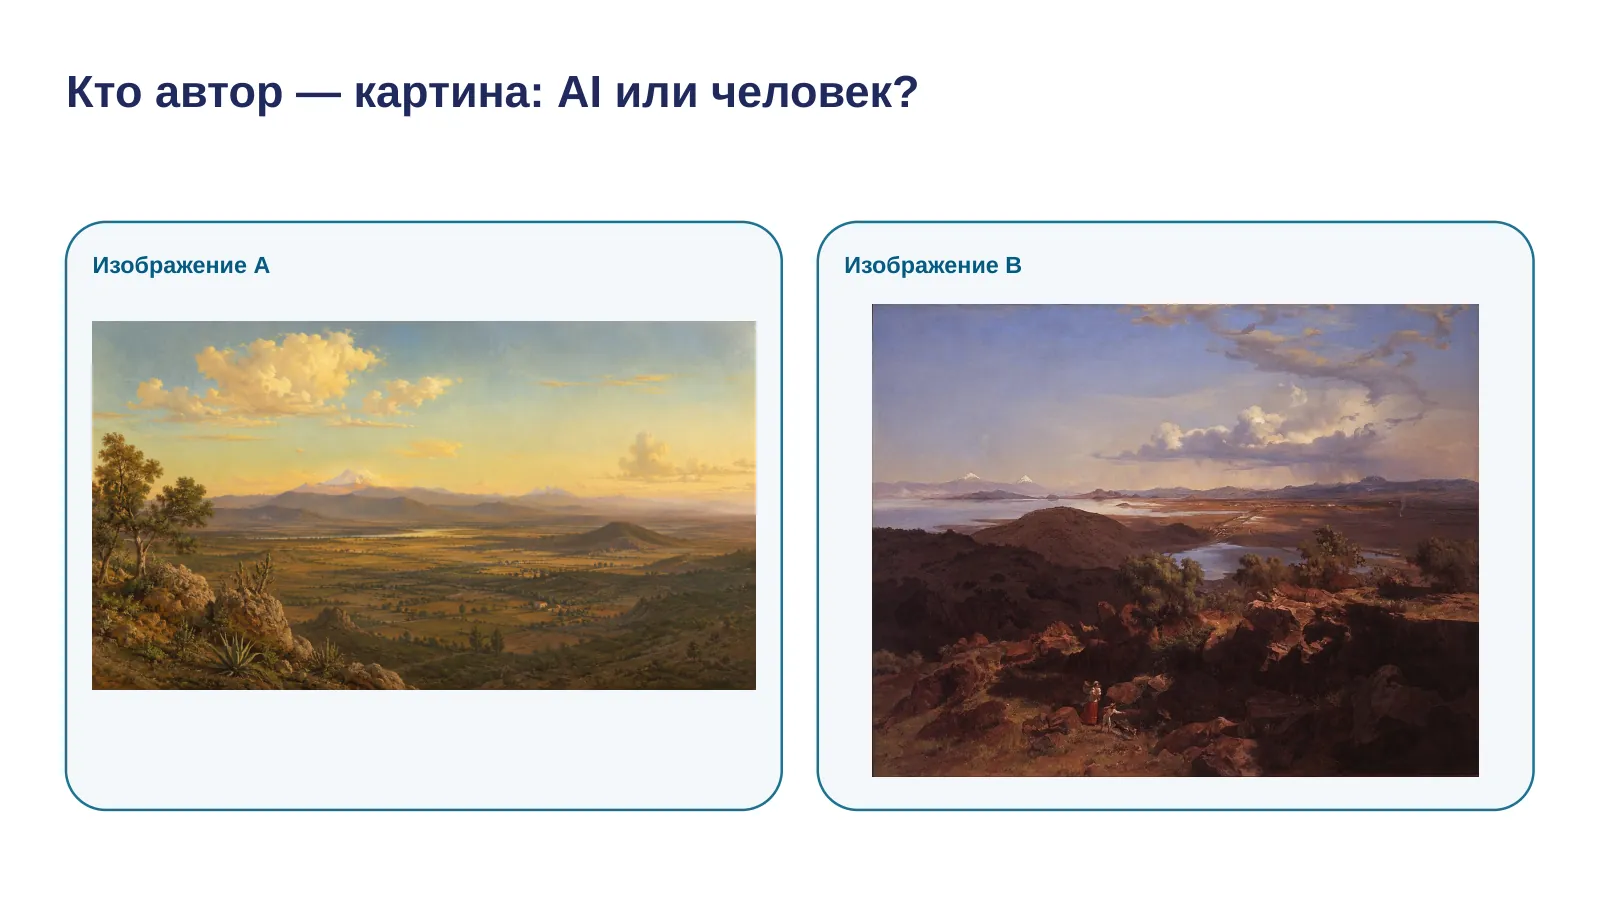
Четвёртая категория — изображение. Одна из двух карточек — реальная картина, вторая показывает стилизованный пример того, что мог бы сгенерировать AI по похожему запросу.
Эта категория — про стиль и восприятие, а не про измеримую продуктивность: современные модели генерации изображений действительно способны имитировать узнаваемые художественные стили за секунды, но вопрос не «что быстрее», а «что вы вообще видите и как это отличить».
После голосования обсудите: какие визуальные признаки выдают руку человека — свет, композиция, мелкие несовершенства? Современные генеративные модели становятся всё убедительнее именно в стилизации под конкретных художников.
12 · Изображение B — Хосе Мария Веласко, 1875. AI сгенерирует похожее за секунды
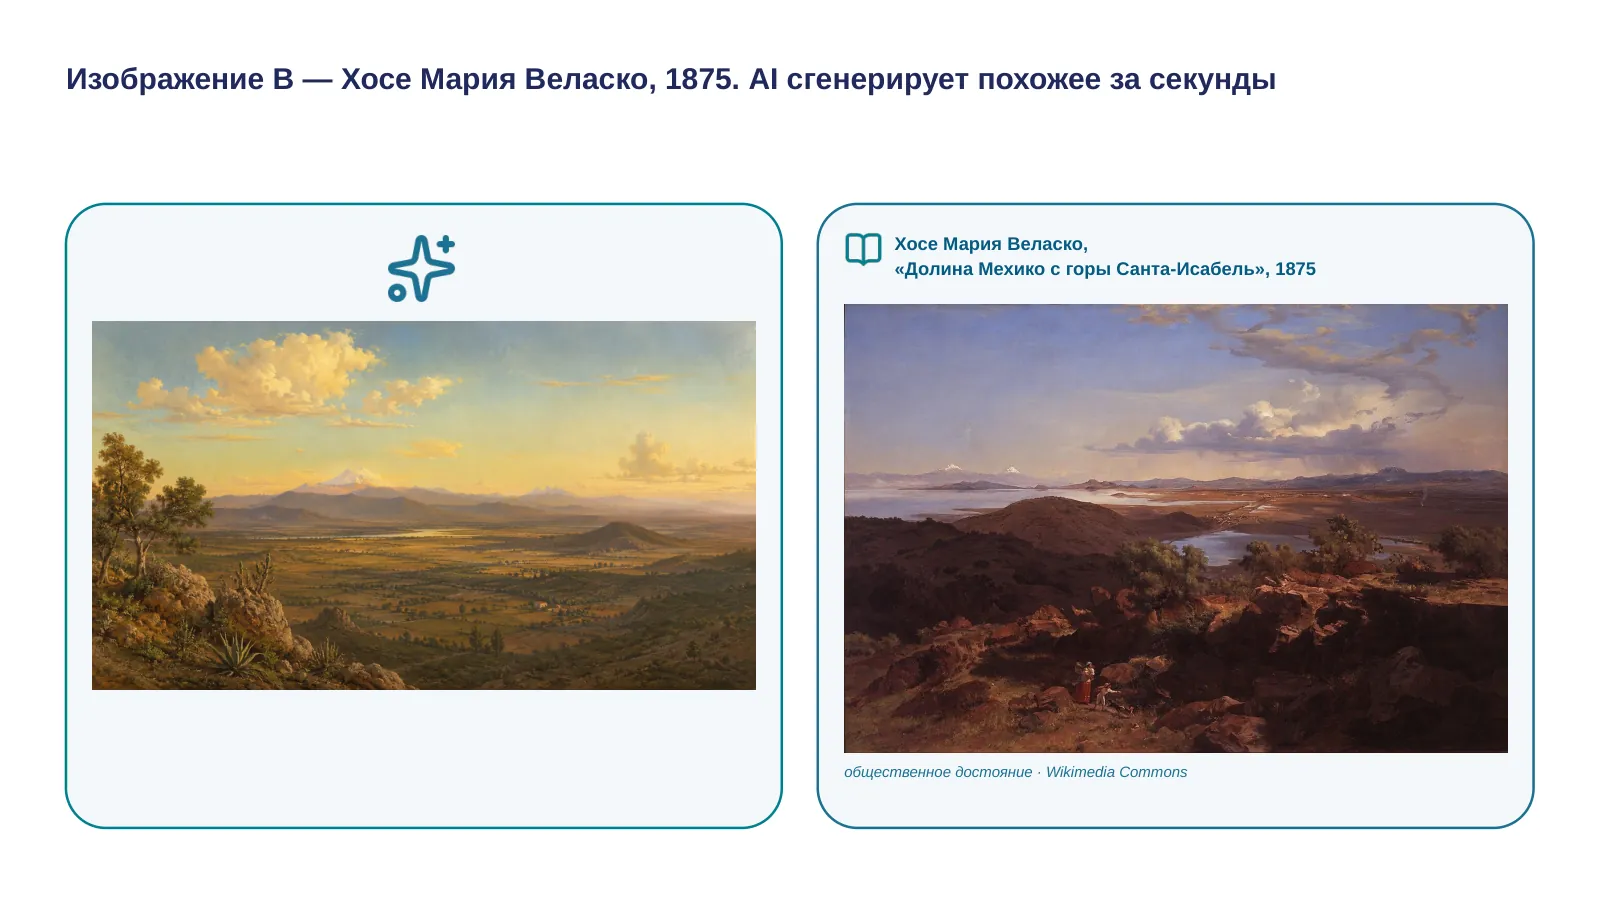
Реальная картина — «Долина Мехико с горы Санта-Исабель», 1875 год, Хосе Мария Веласко — мексиканский художник-пейзажист XIX века, одна из самых известных панорам долины Мехико в истории латиноамериканской живописи, общественное достояние.
По аналогичному текстовому запросу — «панорама долины, дальние горы, вулканы на горизонте, тёплый вечерний свет, стиль пейзажной живописи девятнадцатого века» — современная модель генерации изображений создаст похожую по духу композицию за несколько секунд. Мы не показываем здесь готовый сгенерированный файл — честно проговариваем это как гипотетический пример, а не выдаём собственное описание за реальный результат.
Урок этого раунда: AI умеет имитировать узнаваемый стиль быстро и убедительно, но за скоростью нет истории создания, авторского замысла и подлинности момента — коммерческая или художественная ценность оригинала строится не только на визуальном сходстве. В отличие от технического текста или кода, здесь вопрос не про надёжность, а про этику и подлинность авторства.
13 · Кто автор — визуализация данных: AI или человек?
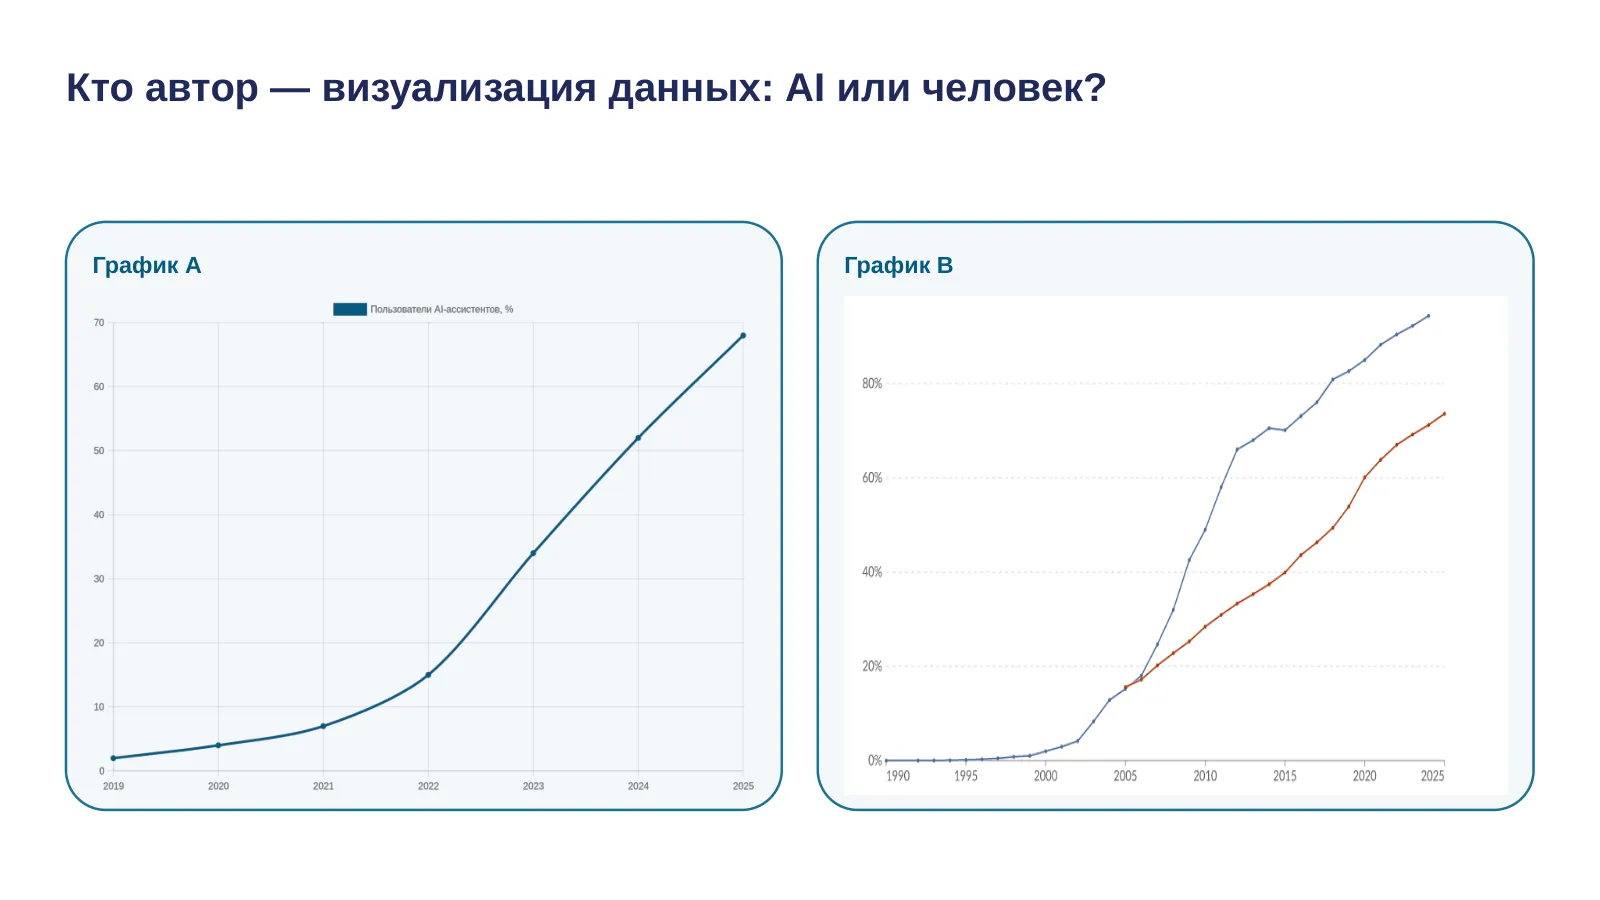
Пятая категория — визуализация данных. Два графика похожего формата — линия роста показателя по годам. Голосуем: какой сделан на основе реального исследования, какой сгенерирован по вымышленным данным.
Здесь снова акцент на измеримом выигрыше: не только «какой график красивее», а «какому из двух можно доверять и почему». Внешне два аккуратных line chart почти неотличимы — это специально: сама неотличимость и есть урок.
После голосования спросите: что вообще может отличить график с реальными данными от правдоподобно нарисованного — источник данных, подпись методологии, или ничего, если оформление одинаково аккуратное?
14 · График A — AI, секунды. График B — Our World in Data, недели верификации
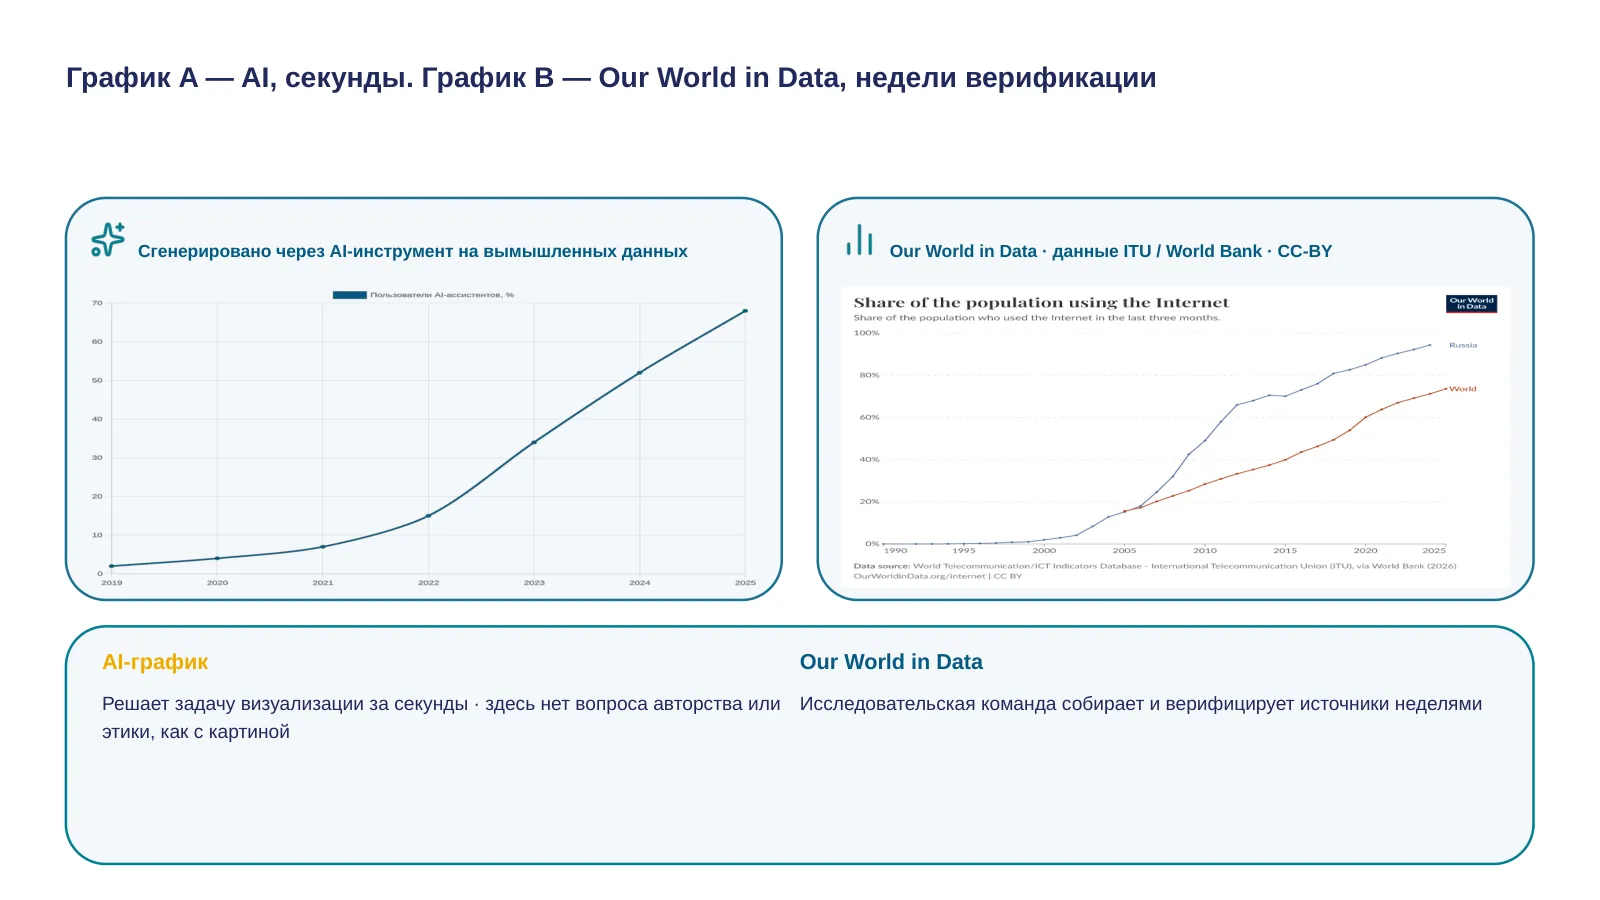
График А сгенерирован нами через AI-инструмент на правдоподобных, но вымышленных цифрах — специально для этой игры. График Б — реальные данные Our World in Data о доле населения, использующей интернет, Россия и мир, источник — International Telecommunication Union через World Bank, лицензия CC-BY.
Честное сравнение: AI-инструмент решает задачу визуализации данных за секунды и делает это хорошо — в отличие от категории «картина», здесь нет вопроса подлинности или авторского замысла, визуализация — чисто техническая задача. Единственный вопрос, который имеет значение, — откуда взяты данные и насколько они верны. Our World in Data строится исследовательской командой, которая неделями собирает, сверяет и перепроверяет источники данных, прежде чем опубликовать график.
Это главный урок всей игры: чем аккуратнее визуальное оформление, тем меньше оно само по себе говорит о достоверности данных внутри. Форма и содержание — разные вопросы: AI отлично и быстро решает вопрос формы, но за проверку содержания — откуда данные и насколько они реальны — по-прежнему отвечает человек.
15 · Верно или неверно? Проверим интуицию про AI
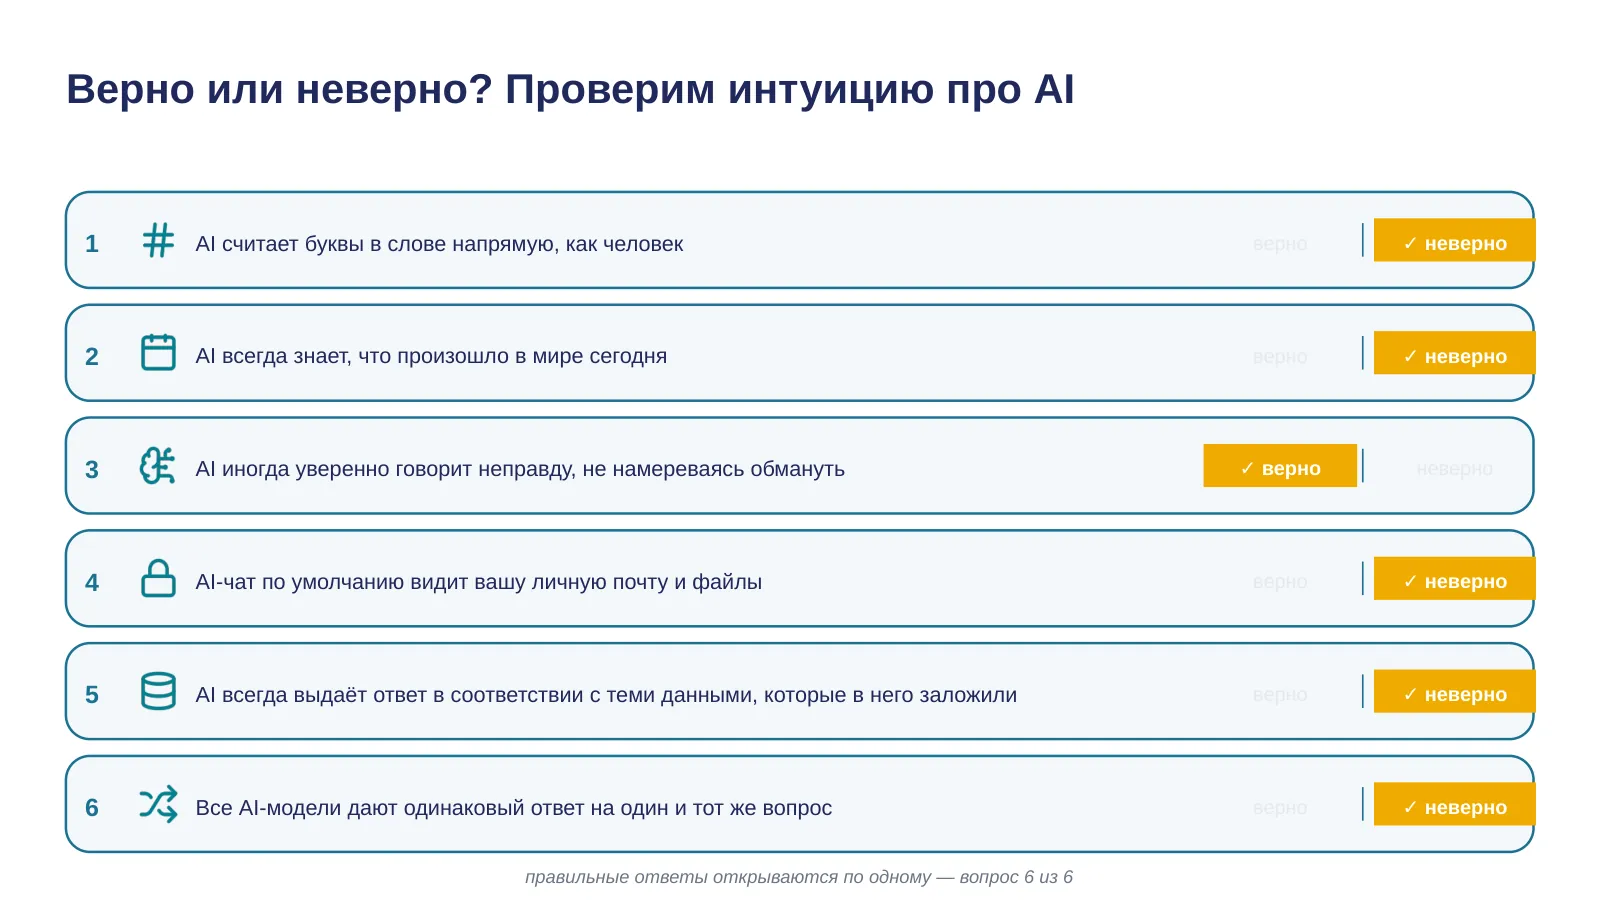
Блиц-квиз: я зачитываю утверждение, вы голосуете поднятием руки — верно или неверно, прежде чем я дам ответ. Объяснение будет коротким, с уроком, а не просто голым фактом.
Первое: AI считает буквы в слове напрямую, как человек. Неверно — AI разбивает текст на токены, а не читает по буквам.
Второе: AI всегда знает, что произошло в мире сегодня. Неверно — модель обучена на данных до определённой даты среза и без веб-поиска не знает о более поздних событиях.
Третье: AI иногда уверенно и убедительно говорит неправду, даже не намереваясь обмануть. Верно — это явление называют галлюцинацией, мы уже обсуждали его в предыдущем блоке под названием «галлюцинация факта». Уверенный тон ответа — не показатель точности.
Четвёртое: AI-чат по умолчанию видит вашу личную почту и файлы. Неверно — без явного подключения AI не имеет доступа к личным данным.
Пятое (новое утверждение round-2): AI всегда выдаёт ответ в соответствии с теми данными, которые в него заложили. Неверно — обучающие данные действительно формируют «характер» модели и её систематические искажения, но ответ не выводится из них жёстко и однозначно. Из-за случайности сэмплирования (temperature) одна и та же модель может дать разные ответы на один и тот же вопрос. Модель не «ищет» готовый кусок текста в обучающей выборке, а генерирует продолжение на основе выученных статистических закономерностей — поэтому возможны и обобщения на новые случаи, и галлюцинации. Дополнительно поведение модели сильно правится уже после предобучения — через дообучение и настройку под диалог (RLHF), так что финальный ответ отражает не только «сырые» тренировочные данные.
Шестое: все AI-модели дают одинаковый ответ на один и тот же вопрос. Неверно — разные модели, и даже один и тот же промпт при разных запусках, могут давать разные по содержанию ответы. Сверка с несколькими источниками разумна для важных решений.
По третьему и пятому вопросам аудитория обычно делится почти поровну — если увидите разделение, спросите пару человек с каждой стороны, почему они проголосовали именно так, прежде чем озвучивать ответ.
16 · Памятка «AI reality-check» — 5 пунктов на неделю вперёд
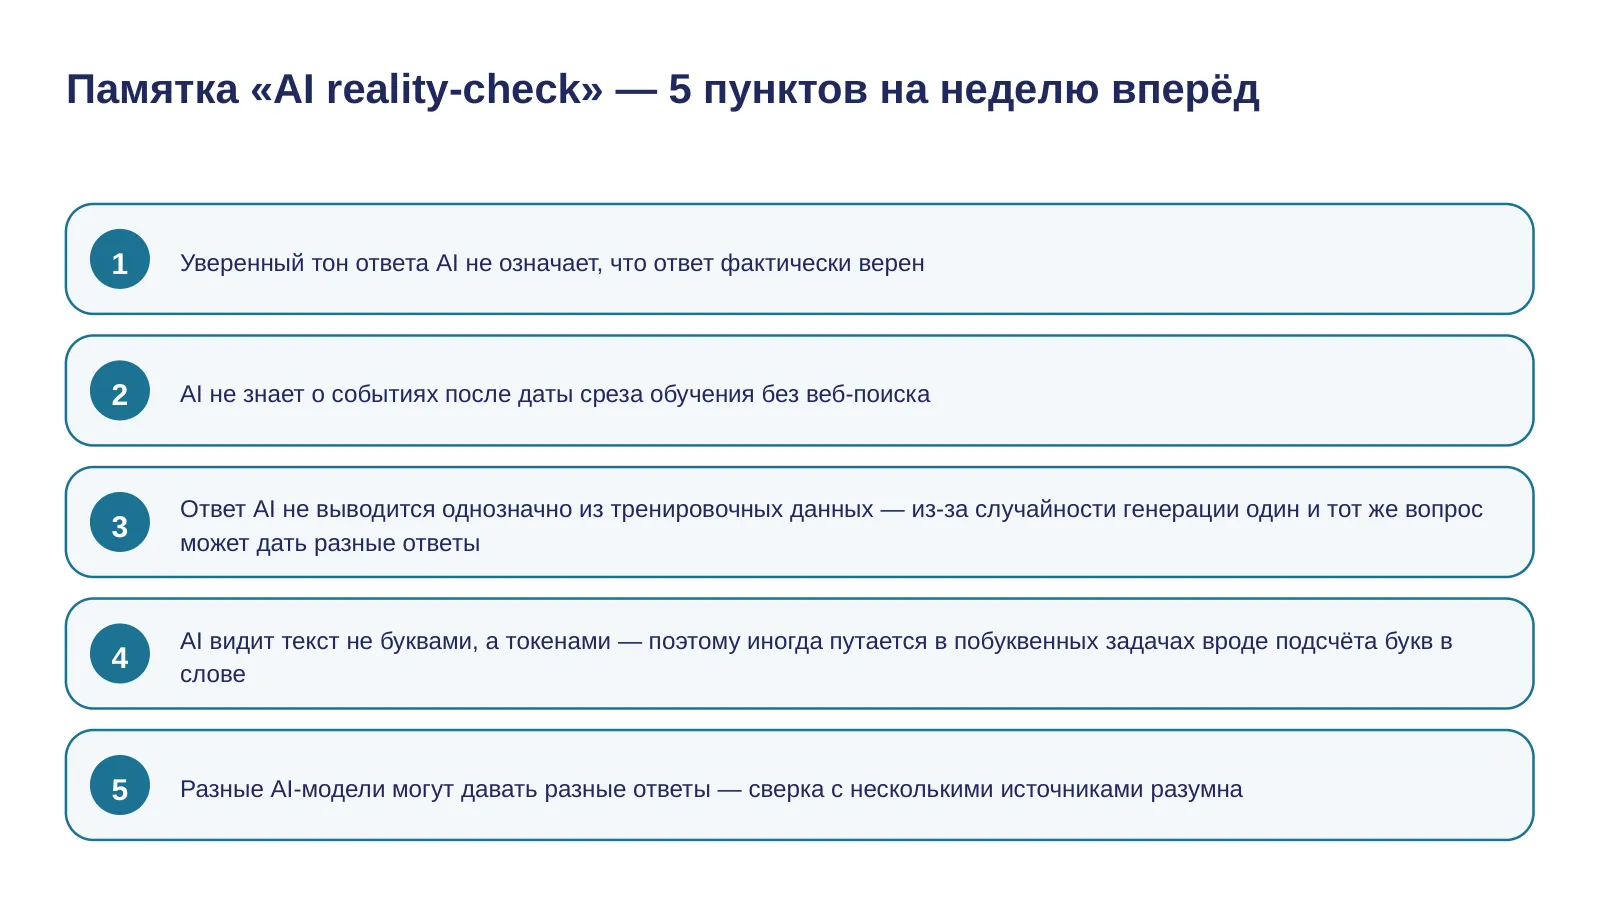
Вот памятка «AI reality-check» — пять пунктов, которые пригодятся вам уже на этой неделе, составлены на основе сегодняшнего квиза.
Первое: уверенный тон ответа AI не означает, что ответ фактически верен. Второе: AI не знает о событиях после даты среза обучения без доступа к веб-поиску. Третье: ответ AI не выводится однозначно из тренировочных данных — модель не «ищет» готовый кусок текста в обучающей выборке, а генерирует продолжение на основе статистических закономерностей, и из-за случайности сэмплирования один и тот же вопрос может дать разные ответы. Четвёртое: AI видит текст не буквами, а токенами — кусками из нескольких символов, поэтому в задачах, требующих побуквенного счёта (например, сколько букв «р» в слове), модель может ошибаться, хотя в целом прекрасно работает с языком. Пятое: разные AI-модели могут давать разные ответы на один и тот же вопрос — сверка с несколькими источниками разумна для важных решений.
Возьмите с собой этот лист. Эти пять пунктов пригодятся вам не только в этом курсе, а в любой работе с AI-инструментами.
17 · От сегодняшнего среза — к системному разбору AI по отраслям
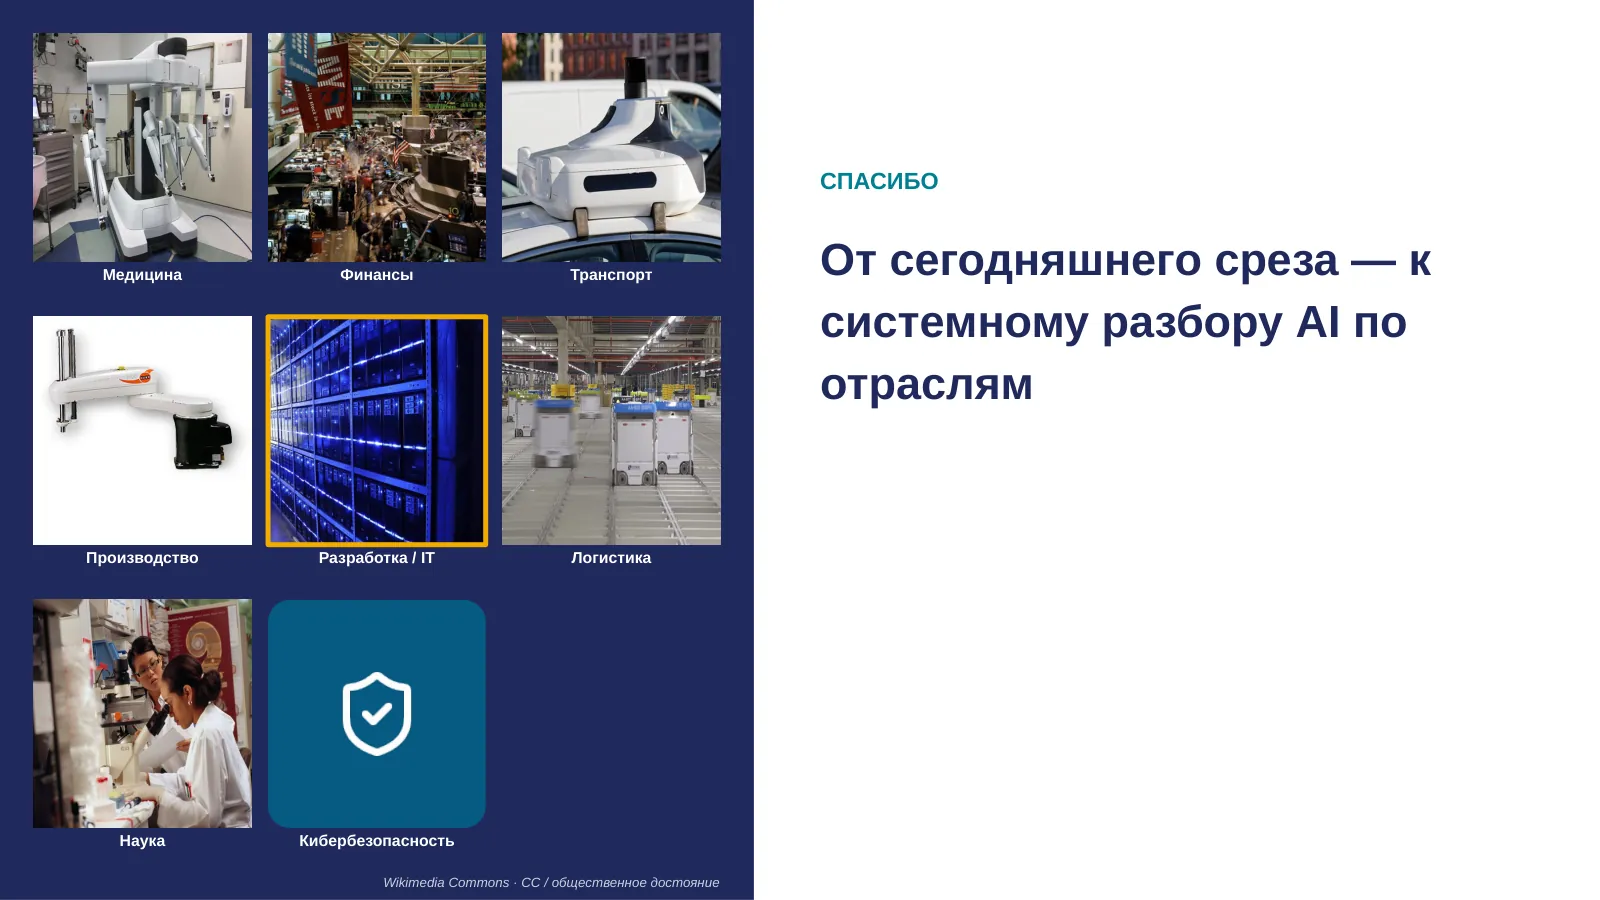
Спасибо за сегодняшнее занятие. Сегодня вы честно зафиксировали свой опыт использования AI: что получилось, что не получилось, и с чем вы приходите на этот курс.
Дальше — лекция один и весь курс, где мы системно, отрасль за отраслью, разберём, как AI реально применяется в разработке, финансах, медицине, промышленности, креативных индустриях и других сферах: какие инструменты работают, где границы применимости, и как выбирать подходящий инструмент под задачу. Всё, что вы сегодня рассказали — истории успеха и провала, — не единичные случаи, а узнаваемые закономерности, к которым мы будем возвращаться на протяжении курса.
Если остались вопросы — самое время задать их сейчас, до того как начнётся системная часть курса. Контакты — телеграм-канал курса и телеграм преподавателя — появятся здесь отдельно. До встречи на следующем занятии.