Лекция 2. Как работают современные большие модели
Лекция 2 · ~100 мин · 47 слайдов
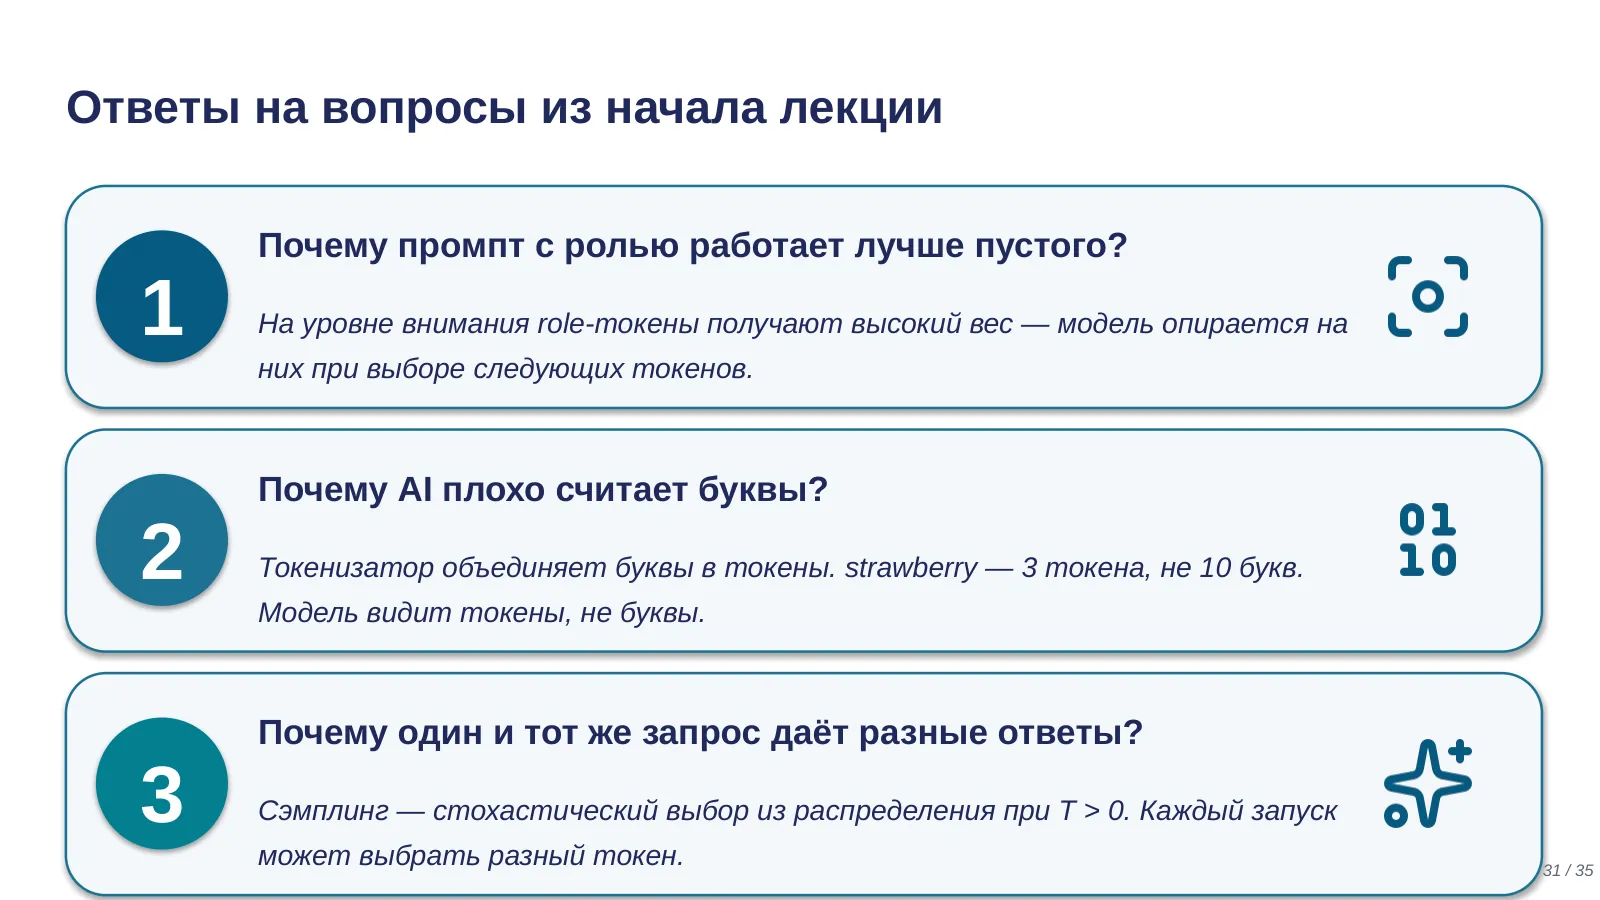
01 · temperature=0 — значит, ответ всегда одинаковый? Да. → Но нет.
Простой вопрос на разогрев, прежде чем мы начнём. Если поставить temperature на ноль — ответ модели на один и тот же запрос будет каждый раз одинаковым?
Интуиция подсказывает «да»: ноль случайности, модель выбирает самый вероятный токен, что тут вообще может пойти не так.
И интуиция почти права. Почти — потому что «почти» на инженерной практике стоит денег. Тесты, которые полагаются на побитовую воспроизводимость при T=0, время от времени необъяснимо падают — а причина не в вашем коде и не в вашей инфраструктуре, а глубже, в самом устройстве вычислений на общем сервере.
Сегодня мы с вами разберём, откуда берётся это «но нет» — и ещё несколько похожих мест, где интуиция про модели работает в девяти случаях из десяти, а в десятом ломается предсказуемым и объяснимым образом. Идём по конвейеру инференса от текста до ответа — и на каждой стадии посмотрим, где основанная на наблюдениях интуиция перестаёт быть надёжной картой.
Переходим к обложке.
02 · Лекция 2. Как работают современные большие модели
Лекция вторая: как работает большая языковая модель изнутри. Формула на сегодня простая: кто работает с моделями ежедневно — освежит основы и узнает тонкости; кто впервые — узнает всё необходимое.
03 · Карта лекции — 7 разделов
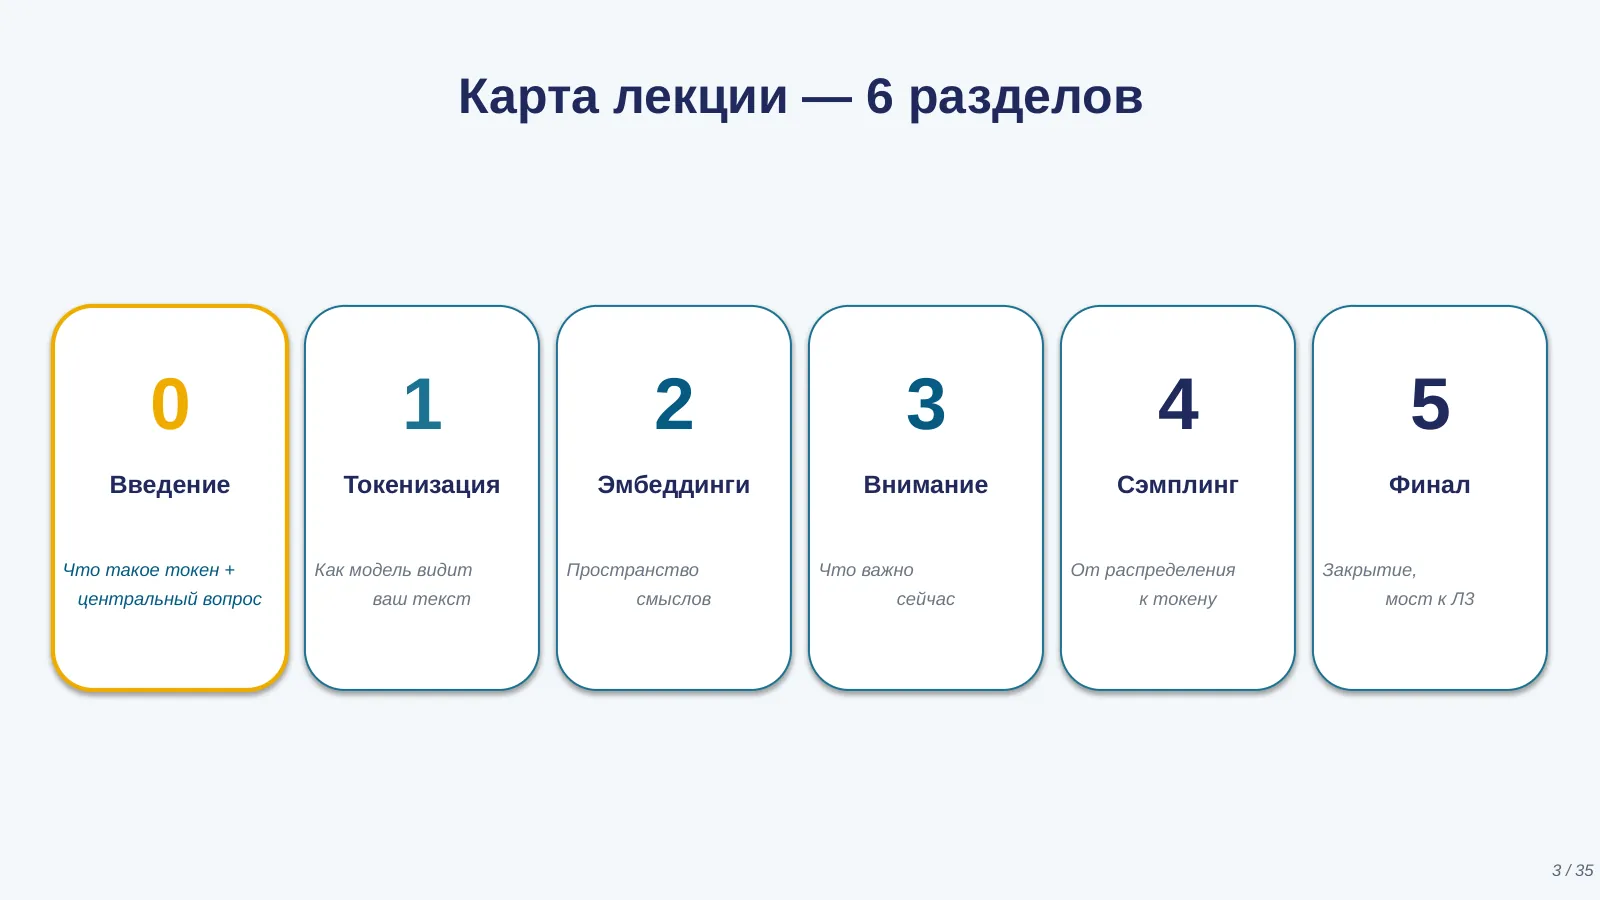
Лекция идёт вдоль конвейера инференса: порядок разделов повторяет порядок стадий обработки запроса. Токенизация, эмбеддинги, внимание, сэмплинг — четыре стадии. Пятый раздел, новый в этой версии курса, — виды и размеры моделей. Шестой — финал.
Держите карту в голове.
04 · Объект сегодня — слой «модель» из четырёх слоёв Лекции 1
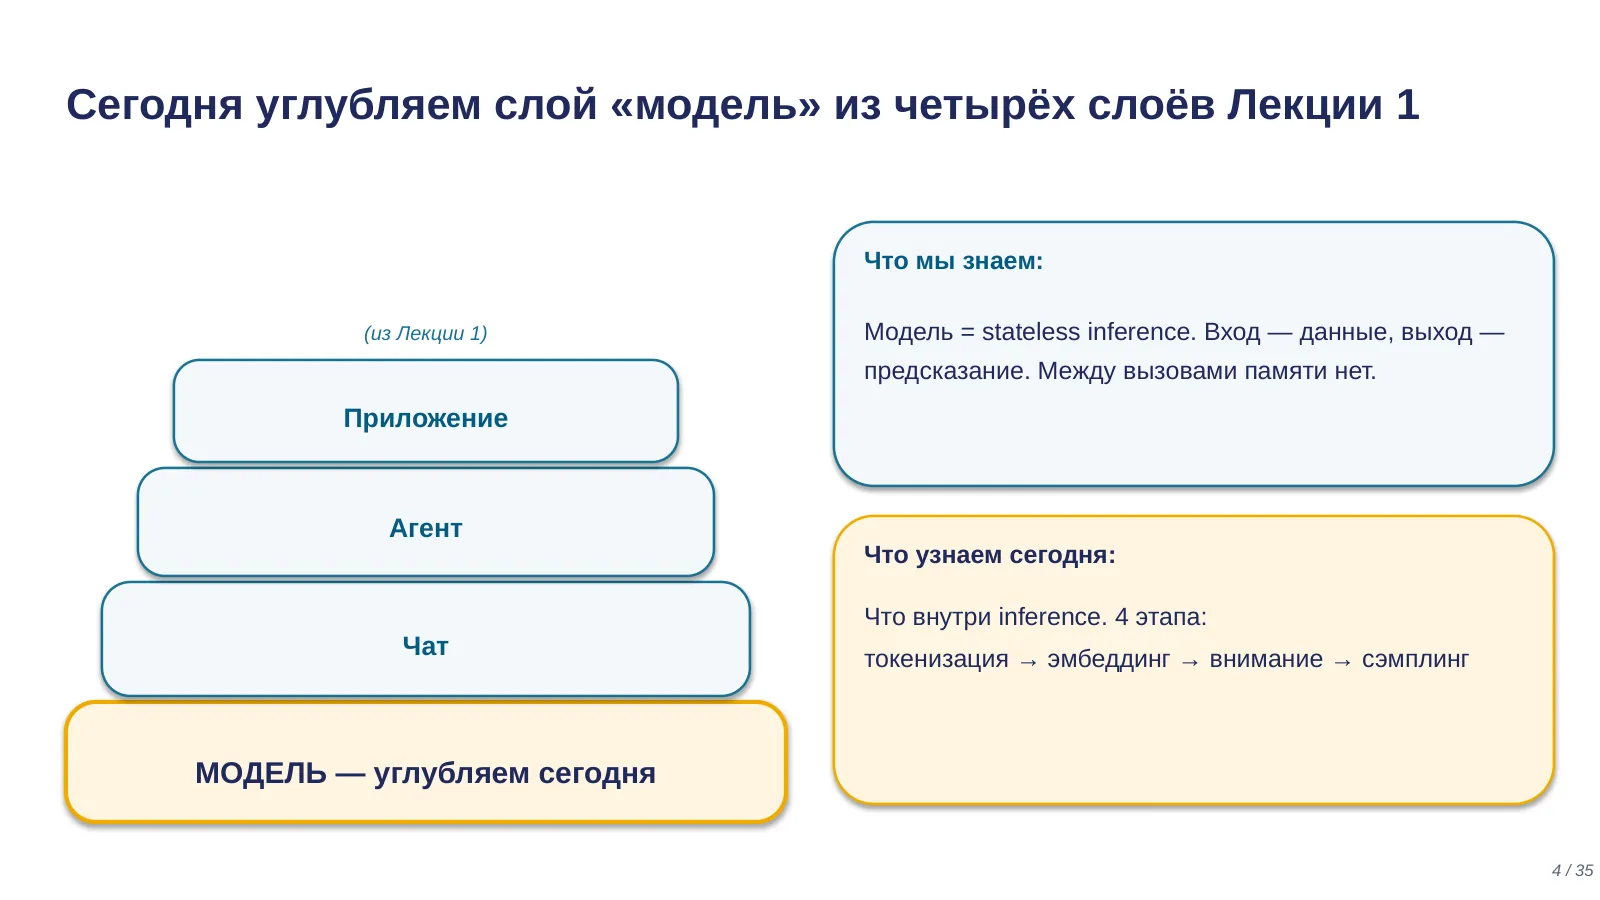
Объект сегодняшнего разговора — слой «модель». Лекция первая дала слоистую картину: внизу модель, над ней чат, агентный цикл, сверху приложение. Модель там описана как stateless-инференс: на вход данные, на выход предсказание, без памяти между вызовами. Оттуда же мы берём как известное контекстное окно и три уровня причинности Пе́рла.
С этим описанием мы умеем говорить, где модель находится в большей системе. Но вопрос «что происходит внутри этой функции» лекция первая оставила чёрным ящиком.
Сегодня мы с вами этот ящик разбираем — всё внутри одного слоя, нижнего. Чат, агенты, приложения — в лекции третьей и дальше.
Мы идём за границами: где устройство модели меняет то, как вы строите промпты и решения. Каждый механизм выбран потому, что у него есть наблюдаемое инженерное следствие.
05 · Цель лекции: рассмотреть, как работает языковая модель, — и разобраться с деталями, которые меняют инженерные решения
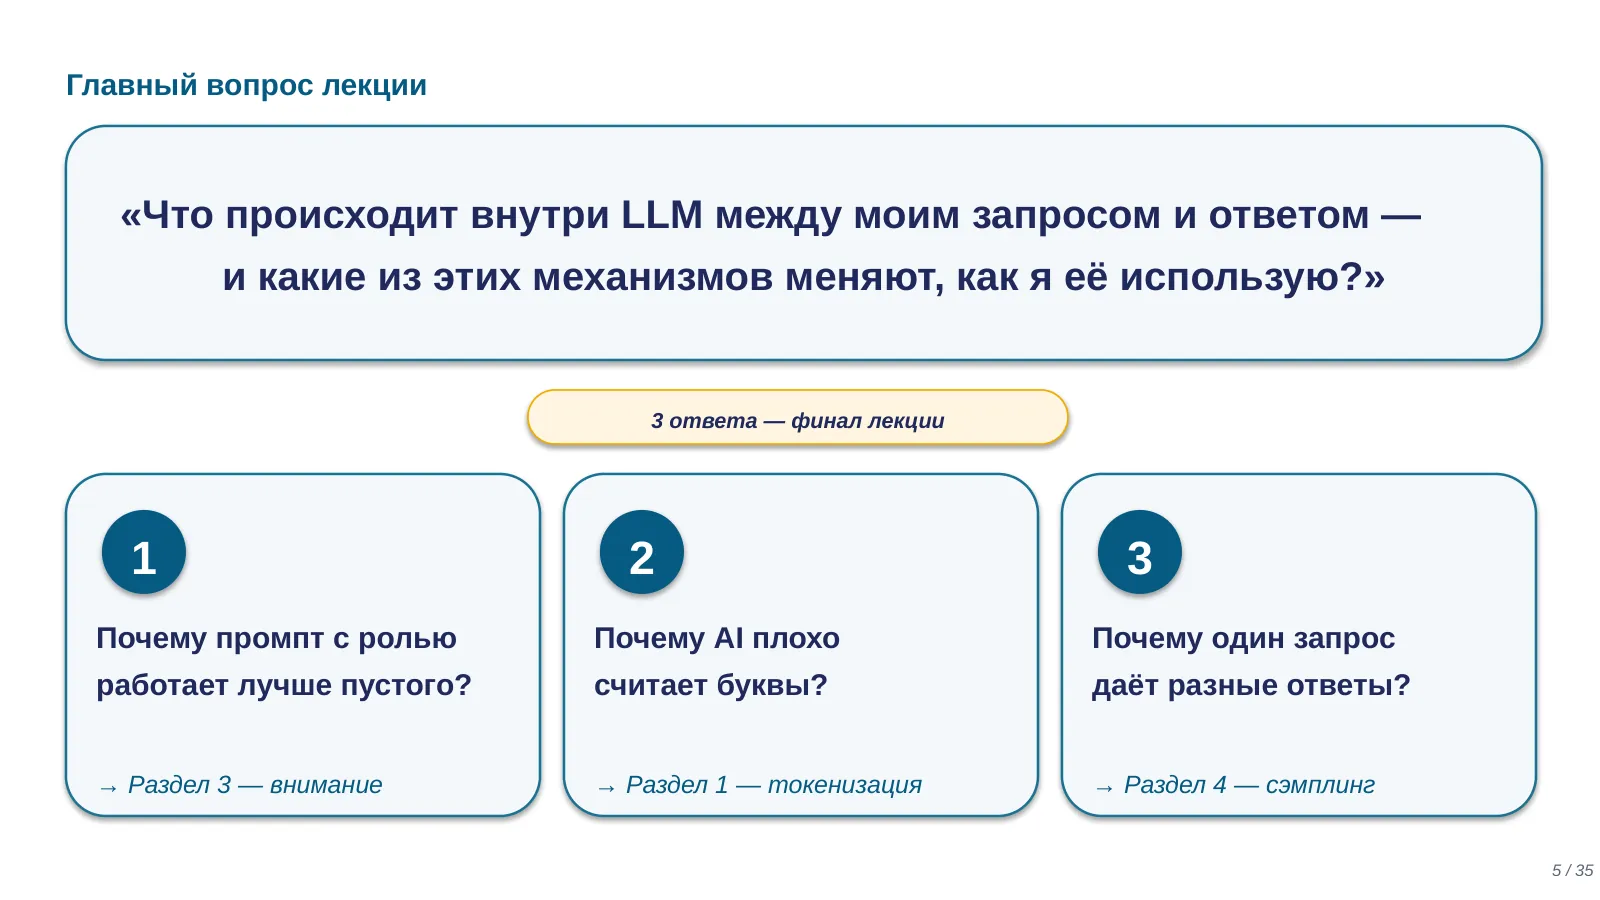
Цель лекции: рассмотреть, как работает языковая модель, — и разобраться с деталями, которые меняют то, как мы строим промпты, агентов и решения. Пройдём конвейер инференса от текста до ответа, и на каждой стадии покажем его границы.
Покажем, где токенизация ломает арифметику и почему «исправленный» strawberry ничего не доказывает. Покажем, из-за чего роль в промпте реально меняет ответ. Разберём, почему T=0 не даёт воспроизводимости. Добавим цену невидимых токенов рассуждения, критерий выбора модели по размеру — и чем заменить веру в бенчмарки.
Семь строк под целью — по одной на раздел: на каждую к концу лекции будет ответ через конкретный механизм, а не через интуицию.
06 · Поток данных в LLM: слова → токены → векторы → LLM → векторы → токены → слова
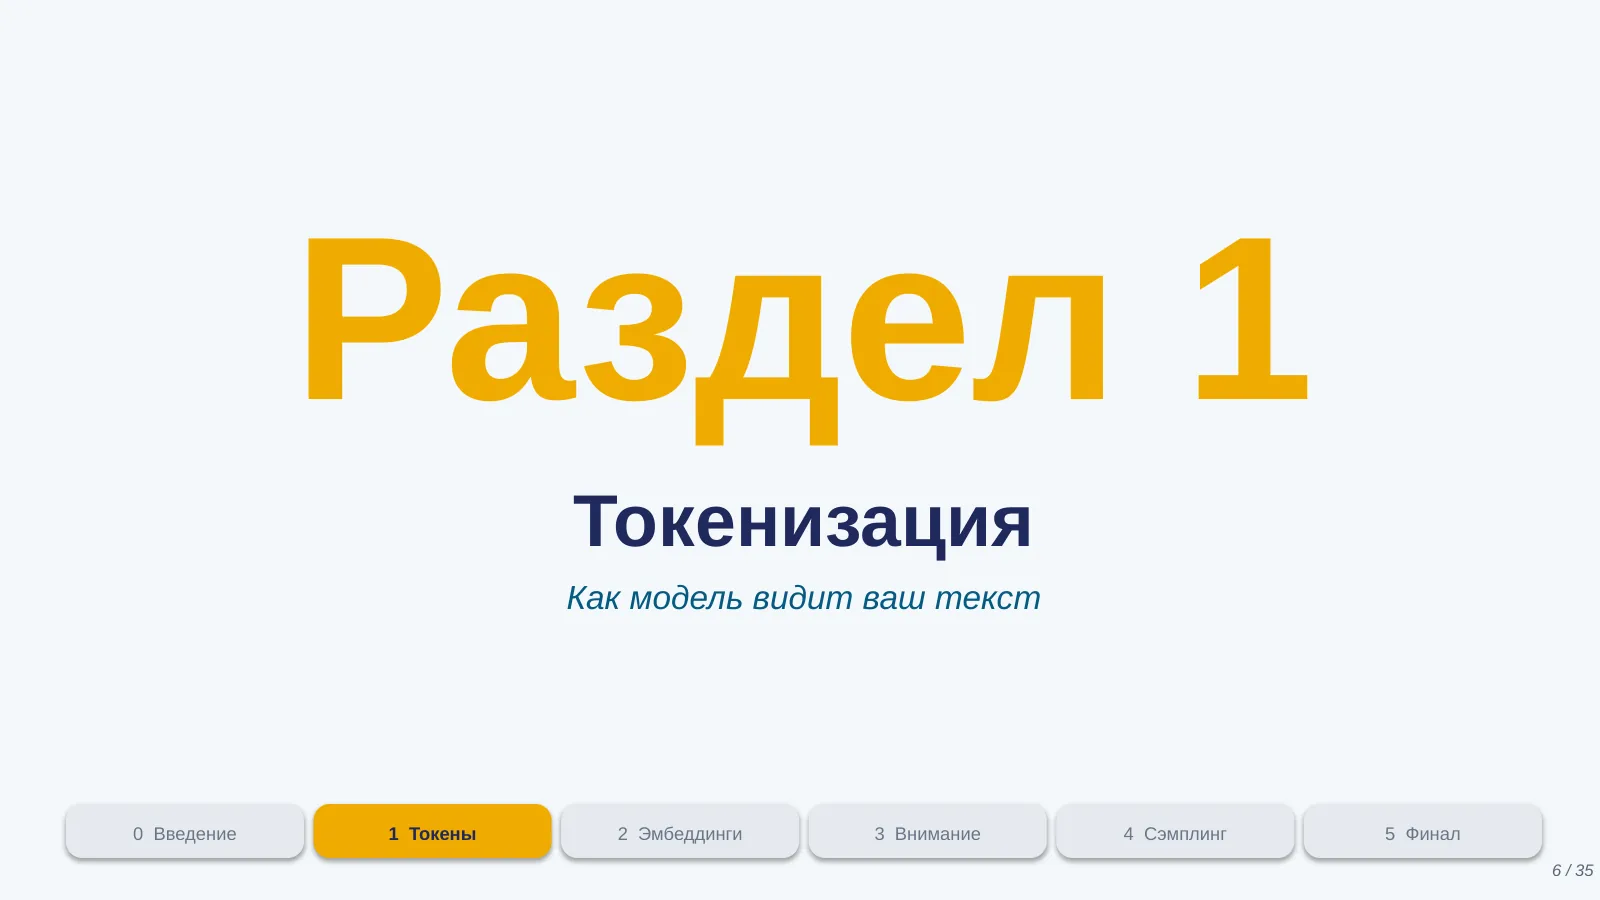
Это опорная схема всей лекции — конвейер инференса, путь одного запроса от текста до ответа. Посмотрим на неё целиком, до первого погружения; дальше мы будем возвращаться к ней на входе в каждый раздел.
Слева — ваш текст. Первое преобразование — токенизация: текст режется на токены, идентификаторы из словаря модели; это раздел первый. Дальше каждый токен превращается в вектор — список чисел, с которыми нейросеть умеет считать; это раздел второй. В центре — сама модель: механизм внимания решает, какие части контекста важны для следующего шага; это раздел третий. На выходе модель выдаёт не ответ, а распределение вероятностей по всему словарю; из него выбирается один очередной токен, он приклеивается к контексту — и цикл повторяется; это раздел четвёртый. Последний шаг — выбранные токены собираются обратно в текст.
Главное наблюдение: слова существуют только на границах конвейера — на входе и на выходе. Всё внутри — операции над векторами. И обратите внимание на петлю в схеме: токены генерируются по одному, каждый выбранный токен добавляется ко входу — и конвейер прокручивается заново.
Эта ось — не только про сегодня: мы с вами вернёмся к ней в следующих лекциях курса. RAG — это управление тем, что попадает в контекст до конвейера; агенты — цикл вокруг конвейера; оптимизация стоимости — экономика конвейера. Сегодняшняя лекция движется по этой же оси — каждый раздел раскрывает свой участок конвейера вместе с границами применимости.
Переходим к разделу 1.
07 · Раздел 1 — Токенизация: как модель видит ваш текст
Раздел 1 из 6 — Токенизация: как модель видит ваш текст. Текст режется не буквами и не словами, а токенами. Дальше — где нарезка расходится со структурой: от strawberry до glitch-токенов.
Общий принцип раздела: у каждой странности токенизации есть механизм, а у механизма — проверяемое инженерное следствие.
08 · Токен — id из словаря модели. Не буква и не слово; статистически частая подпоследовательность
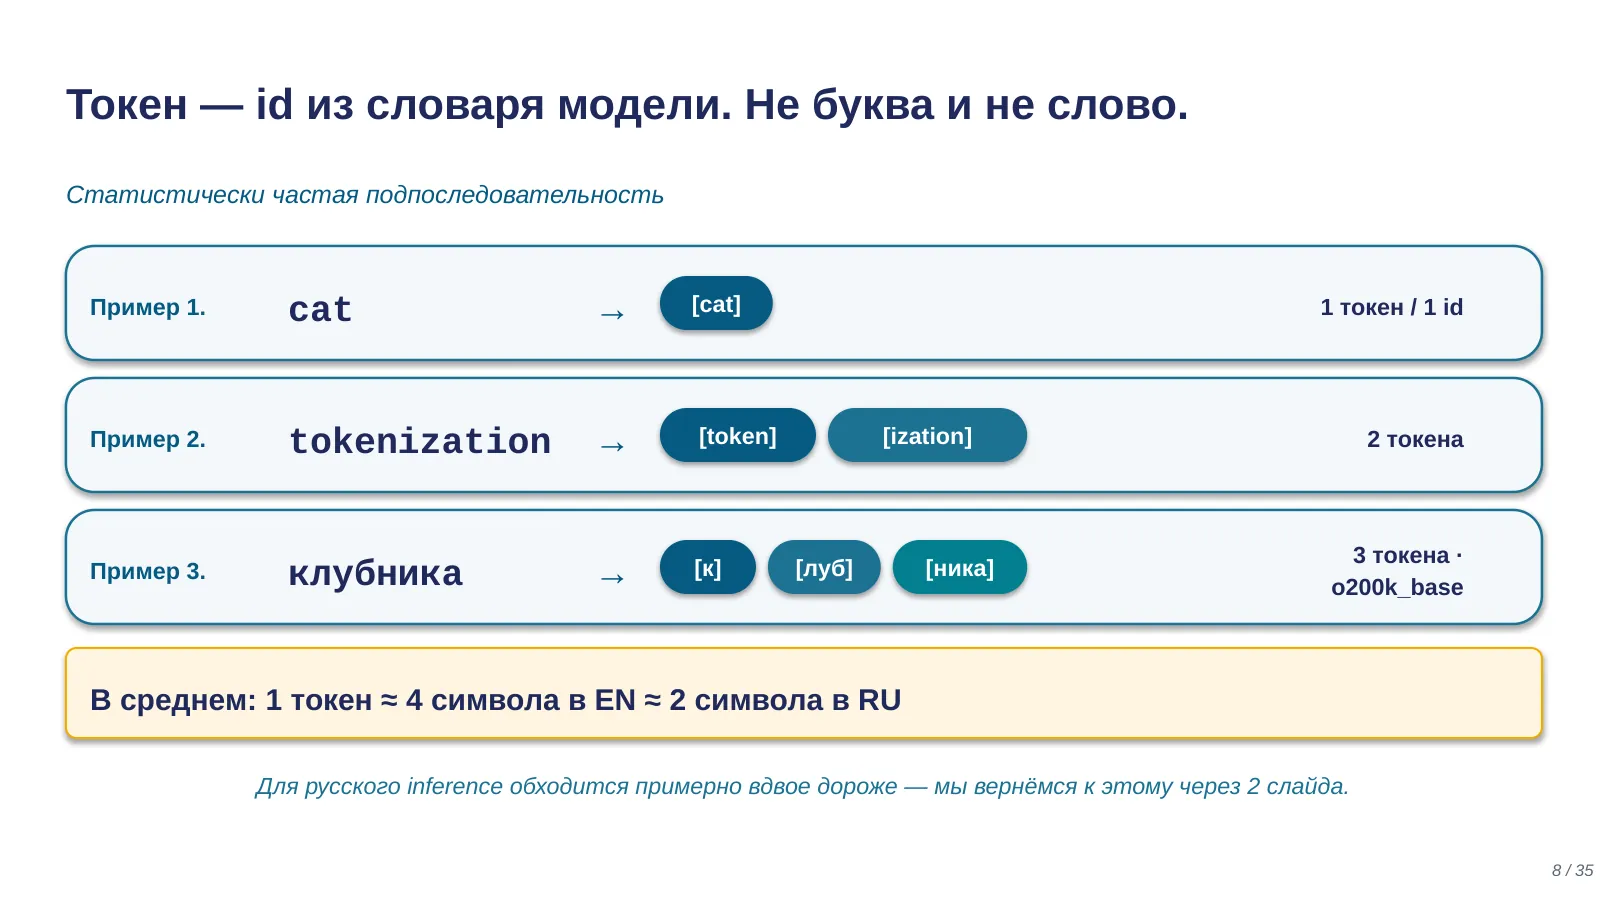
Зафиксируем точное определение. Токен — это идентификатор, целое число из словаря модели; словарь зафиксирован при обучении и не меняется в момент использования. Токен — не буква и не слово, а статистически частая подпоследовательность символов, выученная на корпусе. Частое английское cat попадает в словарь целиком; tokenization распадается на два токена; клубника — на три в том же словаре o200k_base.
Размер словаря у современных моделей — порядка сотен тысяч записей. Рабочий ориентир стоимости: один токен — примерно четыре символа английского текста и примерно два символа русского.
Одно уточнение, которое часто теряется: словарь и модель — два разных артефакта. Словарь строится отдельным алгоритмом на своём корпусе до обучения модели; модель потом учится работать с этим словарём на своём корпусе. Эта развязка — источник целого класса эффектов, к которым мы с вами вернёмся в этом разделе.
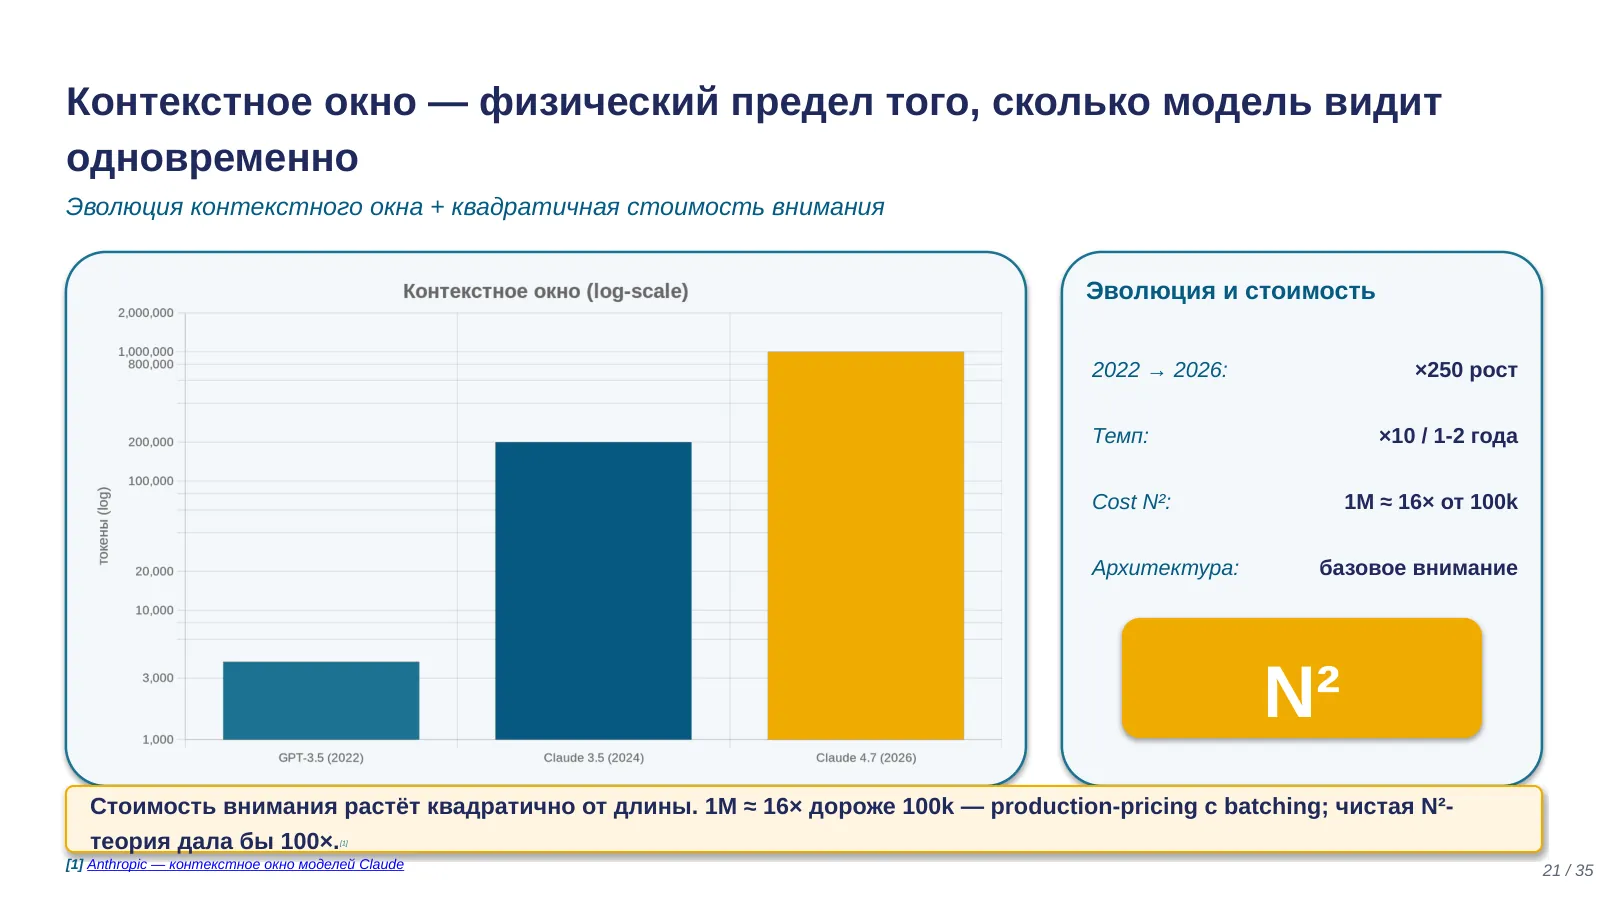
И ответ на резонный вопрос: почему вообще не работать посимвольно? Экономика длины. Посимвольное представление удлиняет вход в три-пять раз, а стоимость внимания растёт с длиной квадратично — вчетверо длиннее вход означает в шестнадцать раз дороже слой внимания. Токенизация со всеми её артефактами — осознанно купленный компромисс, а не недосмотр, который «починят в следующей версии».
09 · BPE — компромисс между алфавитом и словарём; словарь строится один раз перед обучением
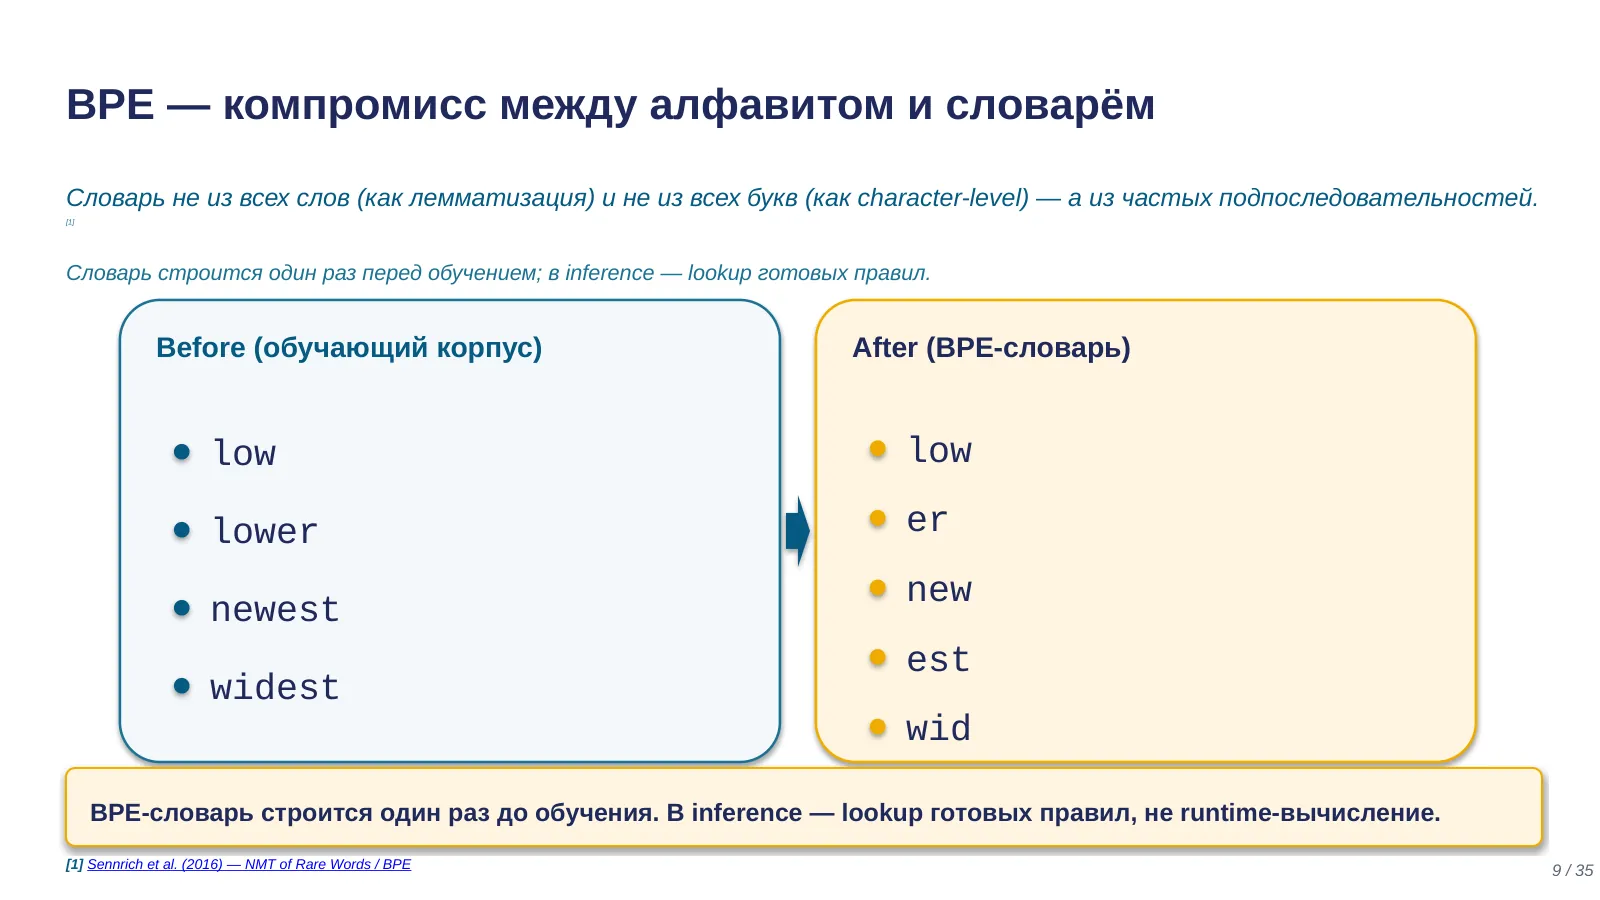
Алгоритм построения словарей большинства современных LLM — BPE, байт-парное кодирование, и мы с вами разберём его как компромисс между двумя крайностями. Словарь из отдельных символов представит любой текст, но последовательности получаются длинными. Словарь из целых слов даёт короткие последовательности, но любое незнакомое слово — опечатка, неологизм, имя — выпадает. BPE сидит посередине: начинаем с алфавита, итеративно объединяем самые частые пары соседних единиц.
Ключевая инженерная деталь: словарь строится один раз, до обучения модели. На корпусе запускают BPE, фиксируют словарь и правила слияния — и всё; на инференсе токенизация — это выборка по готовой таблице за миллисекунды, а не вычисление.
Отсюда два следствия, которые нам с вами пригодятся ниже. Первое: токенизатор режет по частотной статистике своего корпуса, и эта статистика может не совпадать со структурой вашей задачи. Второе: раз словарь и модель обучаются на разных корпусах — в словаре могут остаться записи, которые модель почти не видела.
Практически важно и другое: разные вендоры считают один и тот же текст по-разному — свои словари, таблицы слияния, обработка пробелов. Один документ у разных провайдеров даст разное число токенов, а значит, разную стоимость и разное заполнение окна. При переносе нагрузки между провайдерами пересчитывайте токен-бюджет: для моделей OpenAI токенизация эмулируется локально библиотекой tiktoken, для открытых моделей — библиотекой tokenizers.
10 · Гонка патчей: strawberry починили в апреле, cranberry — только в июле; класс задачи остаётся проблемным
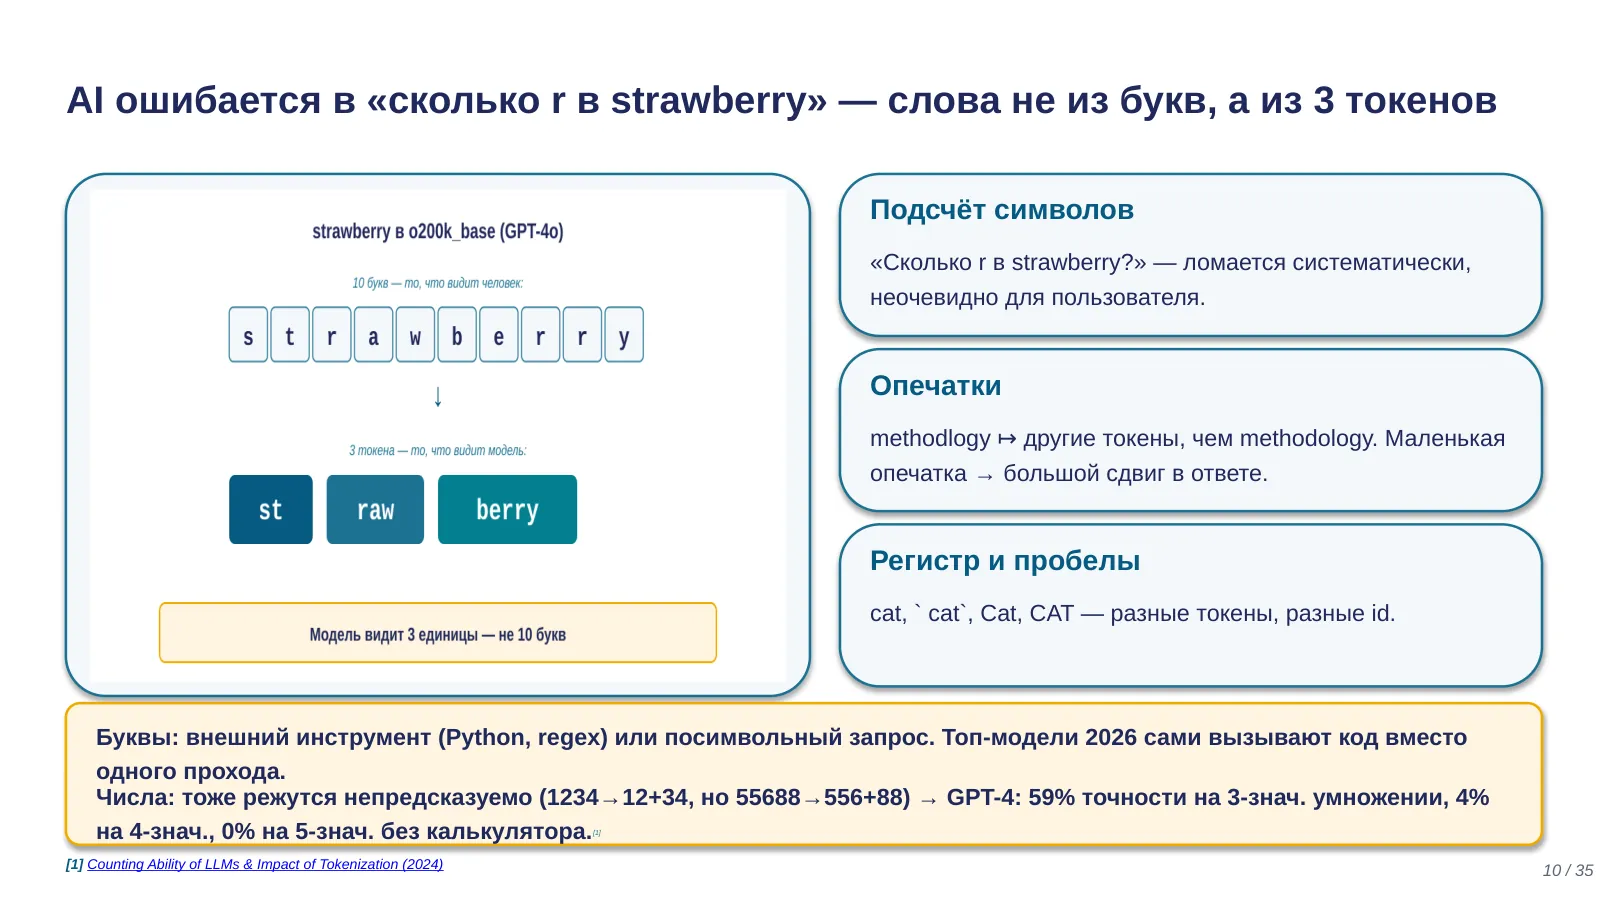
Мем «сколько r в strawberry» вы наверняка знаете — и, вероятно, знаете, что современные модели отвечают на него правильно. Вывод «значит, научились считать буквы» — ложный, и вот почему.
Механизм — слепота к буквам. Слово приходит в модель как три токена: ``, а не десять букв. Внутри выученного вектора токена нет поля «содержит r на такой-то позиции» — там статистика контекстов. Посимвольный подсчёт требует рассуждения поверх токенизированного представления — разворачивания слова по буквам или вызова кода; один прямой проход к надёжному ответу не приводит.
Теперь смотрите на гонку патчей 2026 года. GPT-5.2 в декабре 2025-го всё ещё отвечал «две r» в strawberry. GPT-5.5, выпущенный в апреле 2026-го, проходит strawberry — но на вопрос «сколько r в cranberry» отвечал «две»; правильно — три. И только GPT-5.6 в июле 2026-го починил уже и cranberry — на момент подготовки лекции; давайте проверим прямо сейчас на актуальной модели.
Обратите внимание на закономерность: каждый вирусный кейс патчится точечно и по очереди, а не единым улучшением навыка — иначе фикс strawberry сразу закрыл бы и cranberry. Для систематической проверки появился StrawberryBench — 847 вопросов в семи уровнях сложности; именно на нём, а не на одном вирусном слове, видно, что посимвольный счёт остаётся проблемным местом.
У явления есть имя: jagged intelligence, «рваный интеллект» — профиль способностей с резкими провалами рядом с пиками. Та же модель решает олимпиадную математику и проваливает подсчёт букв; на умножении GPT-4 без инструментов давал около 59% на трёхзначных числах, 4% на четырёхзначных и 0% на пятизначных.
Урок переносим в практику: если модель прошла ваш тест — проверьте её на «cranberry вашей предметной области», структурно аналогичном, но незнаменитом примере. Вирусное прохождение — не навык. А для посимвольных операций и арифметики — внешний инструмент, не прямой проход.
11 · Токенизатор режет по частоте, а не по структуре: числа — чанками по 3 цифры, код — целыми отступами
Зачем инженеру знать, как режутся числа и код: это самые частые «нетекстовые» входы, и от их нарезки напрямую зависят арифметика модели и ваш бюджет токенов.
Числа. Токенизатор cl100k_base стандартизировал нарезку чисел чанками по три цифры слева направо: миллион превращается в группы, границы которых не совпадают с разрядами. Человек читает разряды справа налево — тысячи, миллионы; модель получает нерегулярные блоки, и это прямой источник части арифметических ошибок. Принудительная нарезка справа налево заметно улучшает численное рассуждение, а задача-специфичные схемы токенизации чисел давали до плюс тридцати трёх процентов точности на арифметике с большими числами.
Код. GPT-2 кодировал каждый пробел отступа отдельным токеном: строка на четвёртом уровне вложенности тратила шестнадцать токенов только на отступ. Токенизаторы поколения GPT-4 группируют пробелы в единые токены. Это редкий случай, когда проблему токенизации починили изменением словаря — полезный контраст к strawberry: словарь можно оптимизировать под частый класс входов, но нельзя совместить нарезку со структурой всех задач сразу.
Четыре приёма на вынос. Значимые числа записывайте с разделителями разрядов. Любую арифметику важнее прикидки выносите в инструмент. Для кода — единообразное форматирование. И важная поправка для практики: в готовых чат-продуктах — ChatGPT, Claude в веб-интерфейсе — счёт уже автоматически уходит во встроенный инструмент вроде code interpreter; то, что мы сейчас разобрали, становится критичным именно тогда, когда вы вызываете модель через API напрямую, в своих приложениях и агентах, где такого автоматического роутинга нет.
12 · Порядка 4% словаря — glitch-токены: словарь строится отдельно от модели, и часть записей остаётся недообученной
В январе 2023 года исследователи, изучая кластеры в пространстве эмбеддингов GPT-моделей, наткнулись на группу странных записей словаря — строки вроде SolidGoldMagikarp: юзернеймы с Reddit, попавшие в корпус токенизатора при сборе данных. Модели вели себя на этих токенах аномально: не могли их повторить, отвечали невпопад, уходили от темы.
Механизм коротко: строка может быть частой в корпусе, на котором строился словарь, и получить собственный токен — но почти не встречаться в корпусе, на котором потом обучалась модель. Эмбеддинг такого токена остаётся близким к случайной инициализации и «ничего не значит» в выученной геометрии.
Данные 2026 года говорят: это не курьёз эпохи GPT-3, а системное свойство. По одной из оценок, порядка четырёх процентов записей словаря протестированных моделей — glitch-токены; фреймворк GlitchMiner находит их градиентным поиском в десяти открытых семействах: Llama, Qwen, Gemma, Phi-3, Mistral. Проблема воспроизводится во всех проверенных семействах — масштабом такое не чинится.
Теперь — на что это реально влияет, и это важнее самого механизма. Первое: сбои парсинга на экзотических строках — модель необъяснимо теряет тему разговора именно на конкретном входе. Второе: прод-риски — любая система, принимающая произвольный пользовательский ввод, работает с потенциальным источником glitch-токенов: логи, автоматически сгенерированные идентификаторы, обфусцированный текст. Третье: диагностика — если поведение необъяснимо именно на конкретном входе, среди гипотез должна быть «на входе glitch-токен»; проверяется за минуту заменой подозрительной строки на плейсхолдер. Четвёртое: санитизируйте вход до подачи в модель — это отсекает не только glitch-токены, но и целый класс смежных сюрпризов токенизации.
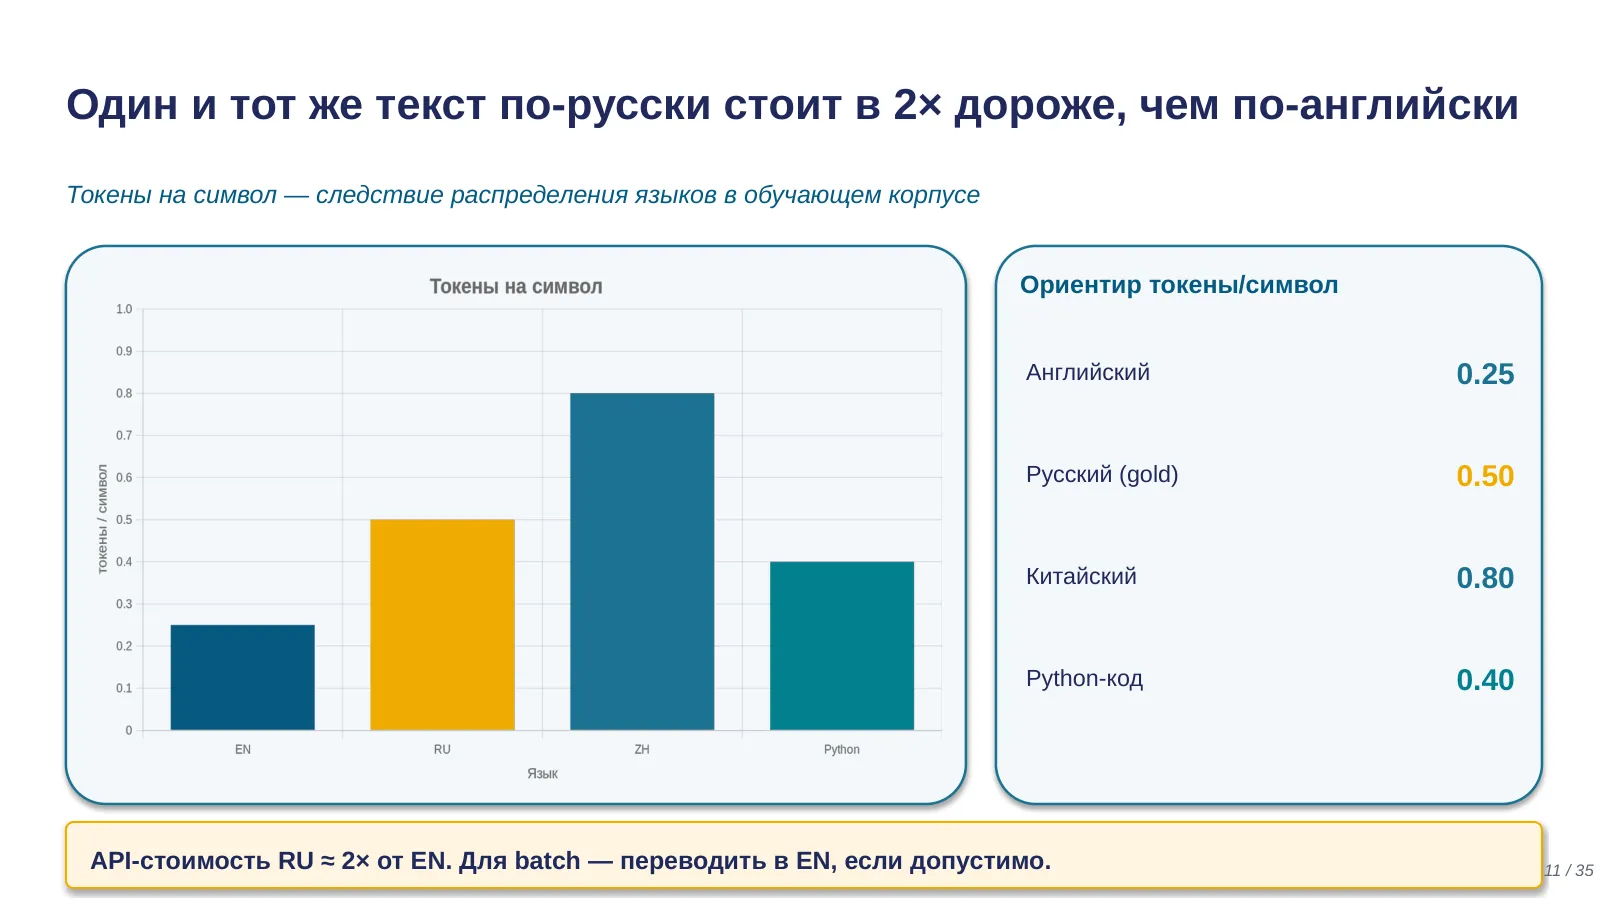
13 · Один и тот же текст по-русски стоит ≈2× дороже английского; o200k сократил разрыв на треть, но не убрал
Один и тот же по смыслу текст стоит разное число токенов в зависимости от языка — прямое следствие того, что BPE-словарь учится на корпусе с доминирующим английским. Ориентиры: английский — около 0.25 токена на символ, русский — около 0.5, китайский — около 0.8, Python-код — около 0.4. Итого запрос на русском обходится примерно вдвое дороже английского, и контекстное окно расходуется вдвое быстрее.
Динамика 2024–2026: переход OpenAI на o200k_base снизил удельную стоимость нелатинских языков примерно на 35% — разрыв сокращается, но не исчезает. Для моделей с увеличенной долей русского в словаре — YandexGPT, GigaChat — разрыв меньше.
Языковой коэффициент протекает и туда, где о нём забывают. Разбиение документов на фрагменты для поиска настраивается в токенах: фрагмент «в 512 токенов» на русском вмещает вдвое меньше смысла, и пороги из англоязычных руководств для русской базы систематически малы. Лимит max_tokens — та же история: русский ответ длиннее в токенах, и обрезки на полуслове случаются чаще. Любой числовой параметр в токенах калибруйте на своём языке и своих данных, а не переносите из чужих примеров.
Переходим к разделу 2.
14 · Раздел 2 — Эмбеддинги: пространство смыслов
Второй раздел из шести — Эмбеддинги: пространство смыслов. Токены стали идентификаторами; но с числом нейросеть считать не может. Вторая стадия превращает их в векторы. Разложим три жизни термина «эмбеддинг» и найдём единственный, но важный провал раздела — границу похожести.
15 · Каждому токену сопоставлен вектор из входной таблицы; он выучен на тренировке и затем фиксирован
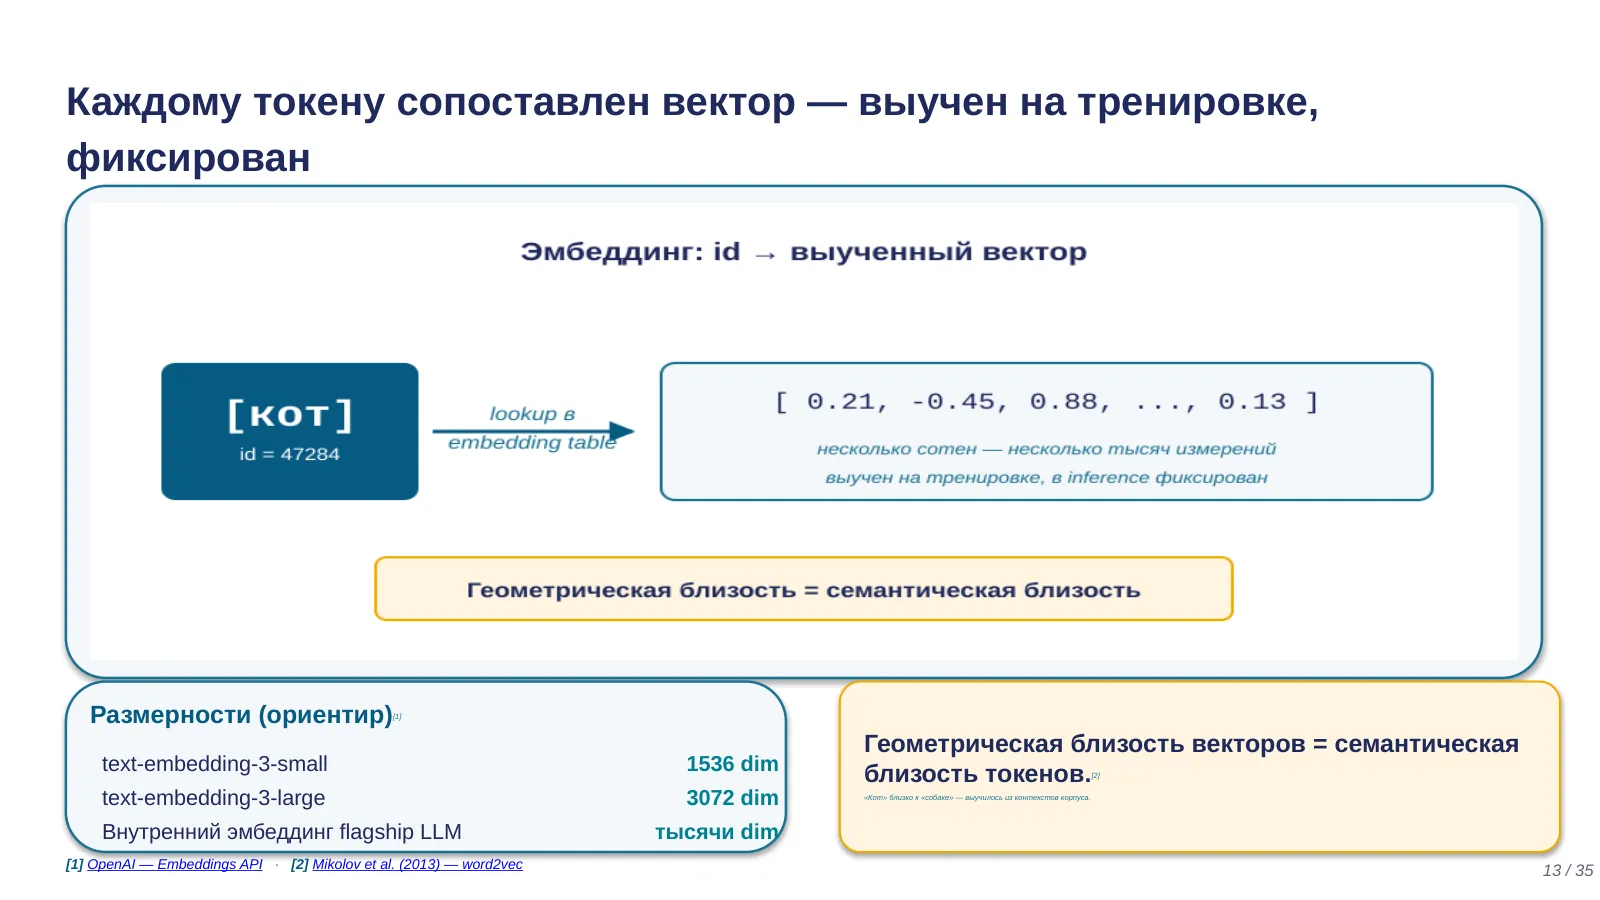
Токен — это идентификатор из словаря, но с числом 48213 нейросеть содержательно работать не может. Эмбеддинг, векторное представление, — сопоставленный каждому токену словаря вектор фиксированной длины, выученный на этапе обучения вместе с остальными весами. После обучения входная таблица «токен → вектор» зафиксирована; на инференсе модель делает выборку.
Главное свойство выученного пространства: геометрическая близость соответствует смысловой. «Кот» близко к «собаке», «SSL» близко к «HTTPS» — не потому, что кто-то это разметил, а потому, что эти слова встречались в похожих контекстах обучающего корпуса.
И одна оговорка для тех, кто будет работать с векторами руками. В пространствах высокой размерности действует концентрация меры: случайные точки оказываются примерно на одном расстоянии друг от друга, и «сырые» дистанции сжимаются в узкий диапазон. Поэтому абсолютные значения сходств малоинформативны сами по себе — информативны сравнения и распределения значений в вашей задаче.
16 · Эмбеддинги — не только внутренность инференса: поиск и RAG работают на отдельной embedding-модели
Эмбеддинги нужны не только для инференса — это ещё и самостоятельный инструмент поиска. Разложим три жизни термина.
Жизнь первая: входная таблица — статическая таблица «токен → вектор» на входе LLM. Вектор токена «кот» в ней один и тот же в любом предложении. Жизнь вторая: представление данных внутри модели. Последовательность входных векторов проходит через десятки слоёв внимания, и на выходе вектор каждой позиции обновлён с учётом окружения — именно эти представления несут «понимание» модели. Обе эти жизни — внутренности инференса.
А третья жизнь — ваш рабочий инструмент. Когда вы строите поиск или RAG, вы пользуетесь именно ей: вы вызываете embedding-API и получаете вектор целого текста от отдельной модели, специально обученной под поиск и сравнение. Это не внутренности вашего чат-LLM — embedding-модель может быть от совсем другого вендора, и это нормальная практика.
Правило разграничения, которое нам с вами стоит держать в голове, простое: речь про стоимость и окно — это токены и входная таблица; про «что модель поняла» — представление данных внутри модели; про поиск и векторные базы — выходные эмбеддинги отдельной модели.
И типовые ошибки склейки. «У нас подписка на чат-модель — зачем платить за embedding-модель?» — затем, что чат-модель векторов для поиска не отдаёт. И зеркально: «обновили LLM — надо переиндексировать базу» — не надо; переиндексация нужна ровно тогда, когда меняется сама embedding-модель.
17 · Пространство эмбеддингов — сотни-тысячи измерений; близкие по смыслу токены лежат рядом
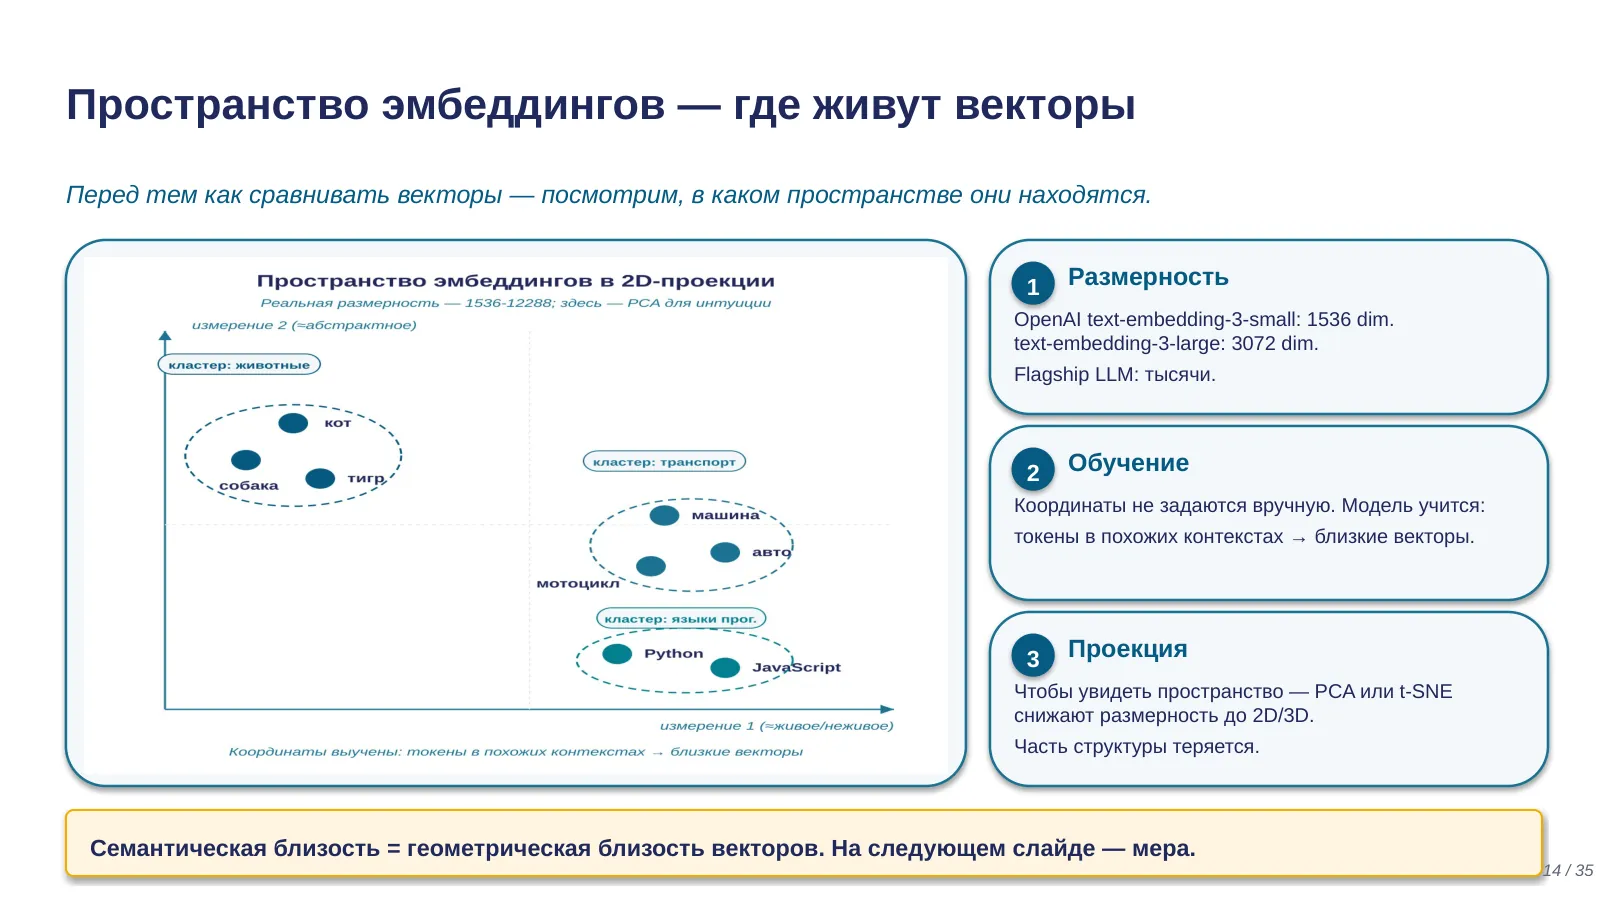
Как устроено пространство, в котором живут векторы. Каждая точка — токен или текст; координаты — сотни или тысячи чисел. Смысл измерений не задаётся вручную — постфактум многие из них читаются как признаки: тематика, формальность, домен.
Обратите внимание на картинку — двумерная проекция: два смысловых кластера и выброс. «Как настроить SSL» и «Установка HTTPS-сертификата» окружены одними и теми же словами — и их векторы получаются близкими; «Деплой React-компонента» и «Сборка React-приложения» соседствуют со словами про фронтенд; а «Рецепт борща» живёт в совсем другой области — одинокий выброс среди технических текстов.
Помните, что это упрощение: реальное пространство — тысячи измерений, а любая плоская проекция теряет часть структуры.
И повторим оговорку, потому что она стоит денег на практике: абсолютное значение сходства само по себе мало о чём говорит. Работают сравнения — «этот документ ближе того» — и распределения значений в вашей конкретной задаче. Универсального порога «выше 0.8 — значит похожи» не существует.
18 · Высокое сходство значит «об одном и том же» — не «с одинаковым смыслом»: similarity ≠ релевантность
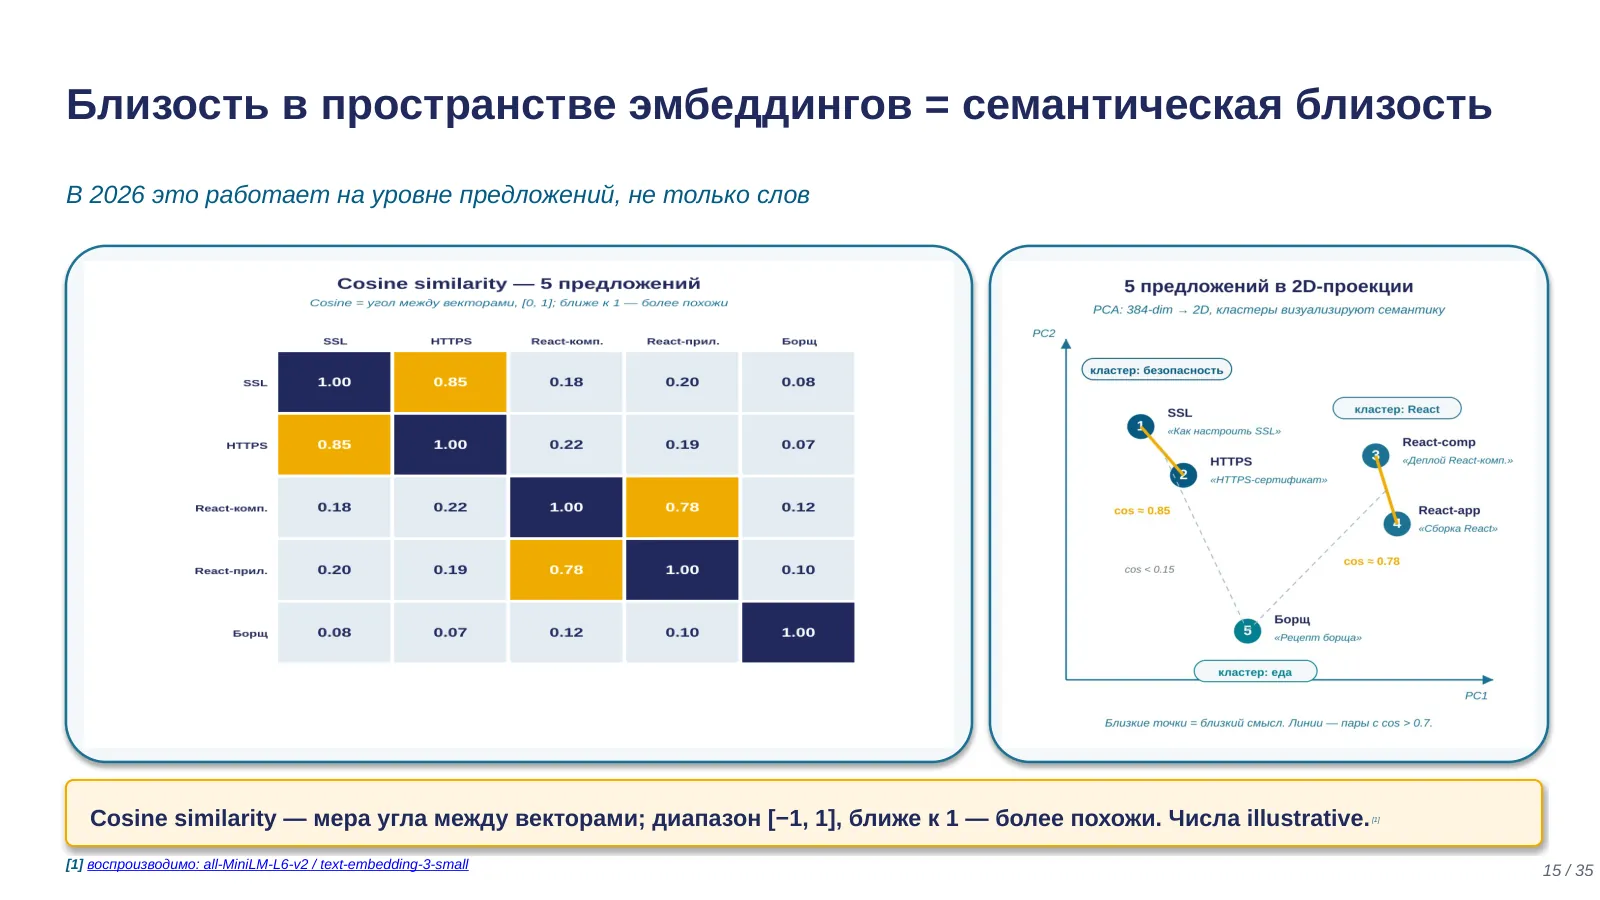
Сначала — что похожесть работает. Пять коротких текстов, парная таблица косинусных сходств: синонимичные по задаче пары — «настроить SSL» и «установка HTTPS-сертификата» — около 0.85; тематически близкие React-тексты — около 0.78; борщ против любого технического — 0.05–0.15. Запрос «клубника» находит документы про strawberry и землянику без таблицы синонимов — вот что эмбеддинги дают поверх полнотекстового поиска.
Теперь граница — и это новый материал даже для тех, кто активно строит семантический поиск. Высокое косинусное сходство означает «об одном и том же» — не «об одном и том же с одинаковым смыслом». Пара «как настроить SSL» и «как отключить SSL» получает очень высокое сходство: одинаковая тема, лексика, синтаксическая рамка — а практический смысл противоположный. Эмбеддинг усредняет контекстную статистику всего текста; короткое отрицание сдвигает вектор слабо.
В проде это выглядит болезненно: пользователь спрашивает, как включить проверку сертификатов, поиск уверенно приносит статью, как её отключить, LLM в RAG-конвейере добросовестно пересказывает — и система с высокими метриками похожести выдаёт вредный совет.
Инженерные ответы известны: реранкер, вторая модель, оценивающая пару «запрос-документ» целиком; гибрид с полнотекстовым поиском для точных терминов; фильтры и метаданные для направленных атрибутов. И приём диагностики: соберите проверочный набор пар с намеренными ловушками — вкл/выкл, до/после, разные версии — и посмотрите, что стоит на первых позициях.
Устройство RAG-конвейера целиком — лекция третья; отсюда мы с вами забираем принцип: косинусное сходство — про тематическую близость, релевантность — отдельная задача.
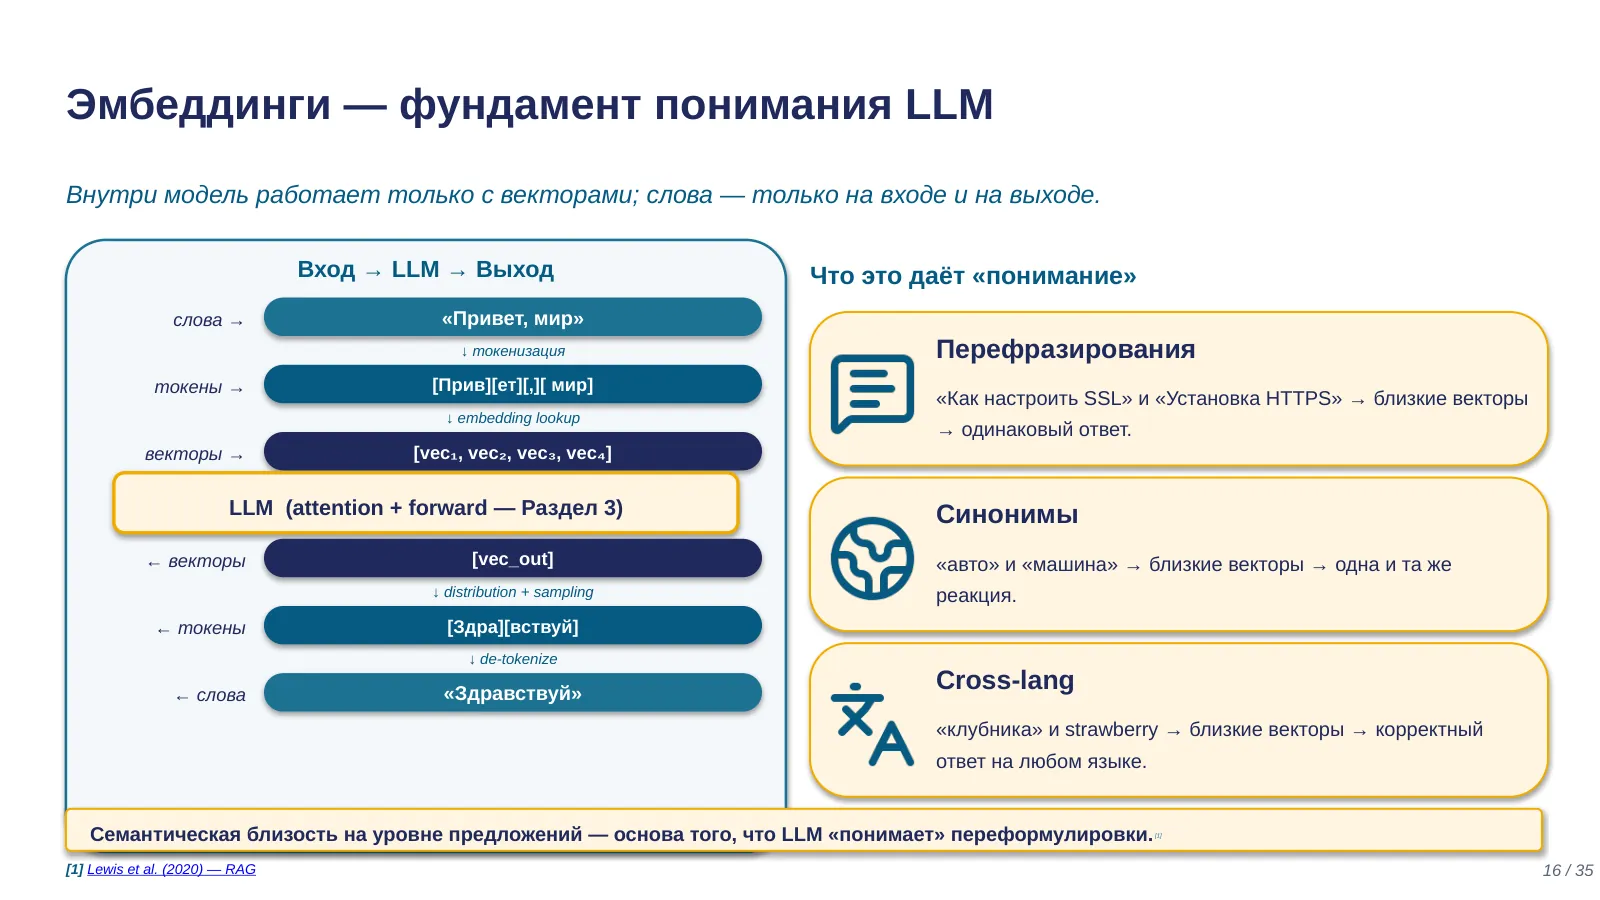
19 · Эмбеддинги — фундамент понимания LLM: модель работает в пространстве векторов, не строк
Соберём раздел. Модель работает не со словами, а с векторами; слова существуют только на границах. Это объясняет «понимание»: «как настроить SSL» и «установка HTTPS-сертификата» дают похожий ответ, потому что попадают в близкие точки пространства. То же с межъязыковой близостью: «клубника» и strawberry — близкие векторы.
Практическая сторона: на одних векторах стоят поиск похожих, кластеризация и семантический поиск с RAG. Одна embedding-модель и индекс обслуживают несколько функций сразу, поэтому выбор — инфраструктурное решение, а смена дорогая: переиндексация всего хранилища. И помните: обратной операции нет — из вектора текст не восстанавливается.
Как выбирать embedding-модель под язык — оставляю для самостоятельного чтения.
Переходим к разделу 3 — самой насыщенной части лекции.
20 · Раздел 3 — Механизм внимания: как модель решает, на что опереться в контексте
Третий раздел из шести — Механизм внимания, самая насыщенная часть лекции. Отсюда вырастает: почему чат кэшируется, почему роль меняет ответ, что реально умеет окно в миллион токенов. Идём через матрицу внимания, KV-кэш, экономику кэширования, роль и гонку окон.
21 · Внимание — это сверка каждого токена со всеми остальными: N × N на каждом шаге
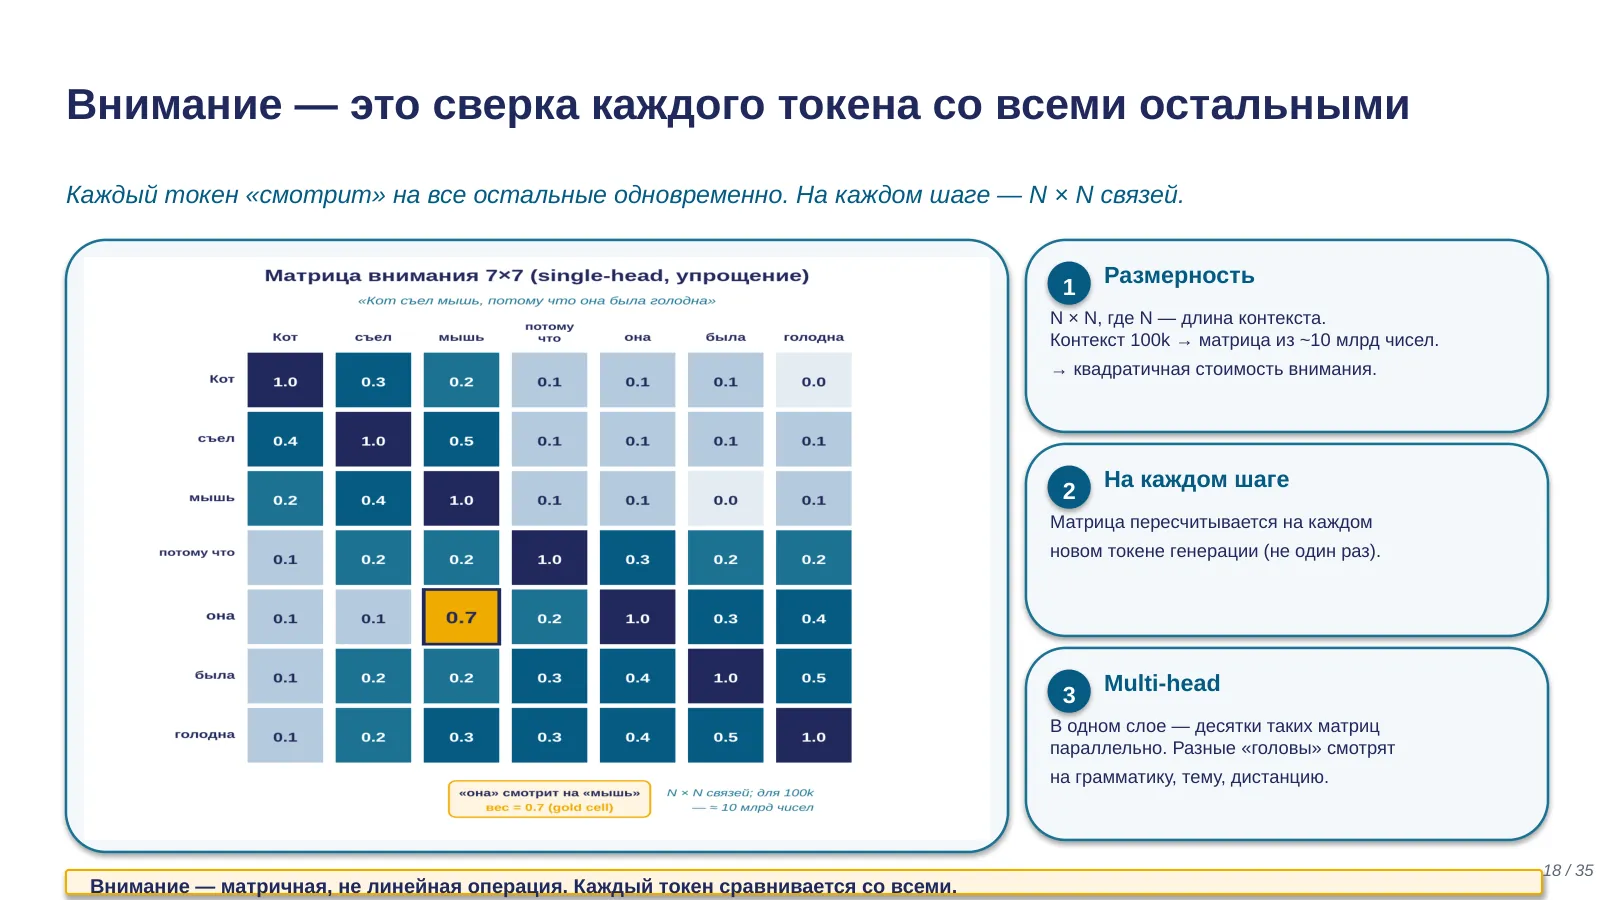
Вы знаете слово «внимание» из каждой второй статьи про трансформеры; зафиксируем точную форму. Внимание — матричная операция: каждый токен контекста сверяется с каждым, и для контекста длины N карта весов имеет размер N на N.
Отсюда главное экономическое свойство архитектуры: удвоение контекста учетверяет объём вычислений внимания. Когда мы дойдём до цены миллионных окон — корень именно здесь.
На слайде — упрощённая матрица семь на семь для «Кот съел мышь, потому что он был голоден». В строке токена «он» наибольший вес лежит на «Кот», не на «мышь» — местоимение мужского рода разрешается на одушевлённый субъект того же рода. Технически это статистическая связь из корпуса, а не грамматический разбор.
Реальный механизм многослойный: в каждом слое параллельно работают десятки «голов», типично от 32 до 128, каждая специализируется на своём типе связей.
Главное — на что влияет распределение весов. Вес каждой связи определяет долю Value-вектора токена в итоговом представлении позиции. А представление позиции — это то, из чего строится распределение для следующего предсказания. Веса внимания напрямую определяют следующий токен.
22 · Внимание выдаёт распределение весов на все токены контекста — технически через три проекции Query/Key/Value
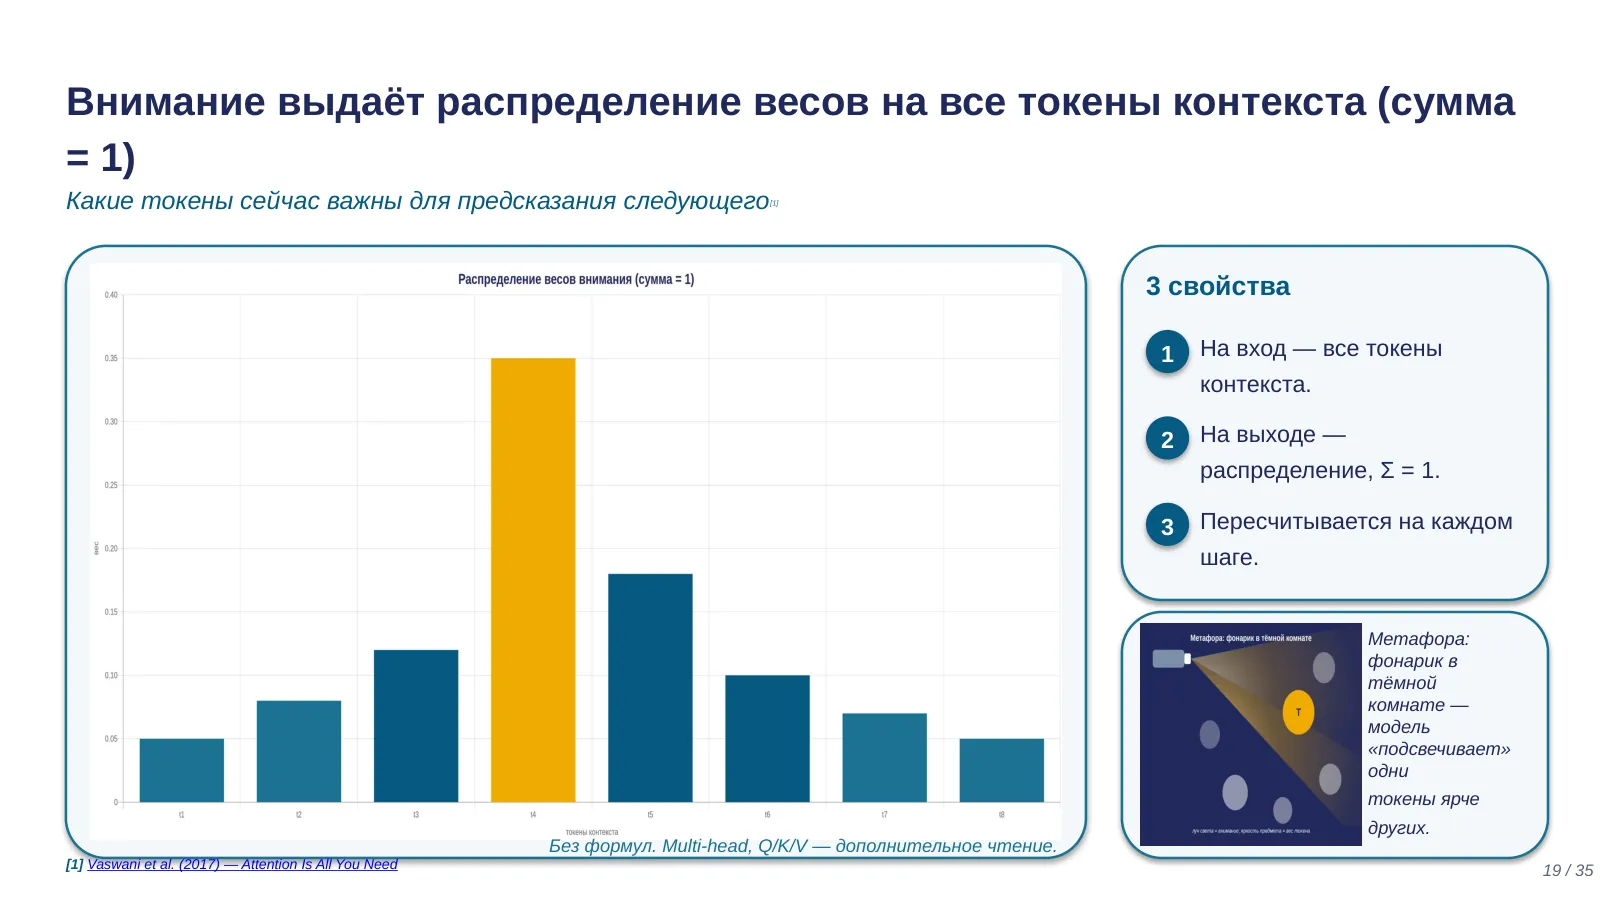
Зафиксируем определение точно. Рабочая метафора — фонарик в тёмной комнате: все токены присутствуют, но луч направлен на релевантные, и яркость — это веса. На каждом шаге внимание возвращает распределение весов на весь контекст, сумма равна единице, и пересчитывается это заново каждый раз.
Теперь — на уровень глубже, на нашем предложении. Для каждого токена модель вычисляет три проекции: Query, Key, Value. Возьмём «он». Его Query грубо читается как «ищу: кто мог быть голоден». Токен «Кот» предлагает свой Key — «я одушевлённый субъект», визитную карточку, по которой его находят чужие запросы. Когда Query «он» и Key «Кот» совпадают, вес получается высоким. Дальше в дело вступает Value «Кот» — содержимое, которое вливается в представление «он».
Простыми словами: Query — вопрос токена; Key — то, чем он отвечает на чужие вопросы; Value — то, что он передаёт, если выбран.
Запомнить стоит одно: Query — про текущий шаг, а Key и Value — про уже обработанный контекст, который не меняется. Из этой асимметрии вырастает главная оптимизация индустрии вывода моделей — увидим на следующем слайде.
23 · K и V контекста кешируются, заново считается только Q — отсюда две фазы генерации и «длинный чат тормозит»
Вспомните наблюдение с прошлого слайда: Query — про текущий шаг, Key и Value — про уже обработанный контекст. Генерация авторегрессионна: токены выдаются по одному, и наивная реализация пересчитывала бы K и V всех токенов на каждом шаге заново — но они не меняются. Отсюда центральная оптимизация всего инференса больших моделей — KV-кэш: Key- и Value-векторы вычисленных токенов сохраняются в памяти ускорителя, и на каждом шаге вычисляется только Q нового токена.
Из кэша вырастает асимметрия двух фаз. Prefill — обработка входного промпта: все токены известны сразу, их K/V считаются параллельно; фаза упирается в вычислительную мощность и определяет паузу до первого символа ответа. Decode — генерация: строго последовательная, и на каждом шаге нужно прочитать весь накопленный кэш из памяти; фаза упирается в пропускную способность памяти и определяет скорость печати.
Здесь важна точная формулировка вывода, потому что она легко искажается в народную мудрость «для новой задачи — новый чат». Пока KV-кэш работает — то есть история совпадает с тем, что уже посчитано, — повторная подача истории дешёвая и быстрая: именно ради этого кэш существует. «Тормозит и дорожает» происходит не как свойство длинного чата вообще, а именно тогда, когда кэш не срабатывает: когда контекст меняется в начале, когда сессия истекла, когда провайдер вытеснил ваш кэш из памяти под чужую нагрузку.
Устройство кэша у провайдеров разное, и это прямо влияет на то, что нам нужно делать руками. У OpenAI и у DeepSeek кэш срабатывает автоматически; у DeepSeek он к тому же дисковый. У Google Gemini — implicit caching, тоже по умолчанию. А у Anthropic кэш явный: нужно расставить маркер cache_control самостоятельно — на момент подготовки лекции. Практический вывод: если вы на Anthropic и не видите экономии — проверьте, стоит ли маркер там, где нужно; на остальных трёх — проверьте метрики cache hit rate в ответе API.
Масштаб эффекта: при контекстах в сотни тысяч токенов кэш одного пользователя занимает гигабайты памяти ускорителя — отсюда агрессивный батчинг провайдеров и премиальная цена длинных контекстов.
24 · Кэш промптов — ставка на повторное использование: чтение 0.1× ставки, запись дороже входа, один изменившийся токен инвалидирует всё после него
KV-кэш живёт внутри одной генерации. Провайдеры сделали следующий шаг: если два разных запроса имеют одинаковый префикс — тот же системный промпт, инструкции, документы, — его K/V можно переиспользовать между запросами. Это кэширование промптов, и с 2025–2026 годов это главный рычаг оптимизации стоимости LLM-нагрузок.
Давайте проследим механику на трёх последовательных запросах — так виднее, чем на отдельных цифрах.
Запрос первый: вы отправляете промпт впервые, кэша ещё нет — префикс записывается в кэш, и запись стоит дороже обычного входа, от 1.25 до 2 ставок. Запрос второй: вы отправляете тот же префикс — новый вопрос пользователя в конце, но система и документы те же — префикс совпадает побайтово, кэш срабатывает, и вы платите десятую часть базовой ставки, у новейших моделей — до одной сороковой. Запрос третий: кто-то добавил в начало промпта одну строку — например, текущую дату, — и теперь префикс больше не совпадает. Кэш мимо: вся нагрузка платит полную цену, как будто кэша никогда не было.
Кэш не бесплатен — это ставка на повторное использование: окупается со второго-третьего попадания. Масштаб эффекта реален: кейс на 50 тысяч анализов документов в месяц — 45 тысяч долларов без кэша против 8 тысяч с кэшем, экономия 82 процента.
Главное техническое условие — точное совпадение префикса: кэш срабатывает, только если всё до контрольной точки совпадает байт-в-байт. Классический самострел — добавить в начало системного промпта что-то переменное, вроде текущей даты и времени.
Отсюда правило компоновки: стабильное — в начало, переменное — в конец. И минутный аудит для действующего конвейера: посмотрите поля учёта кэша в ответах API — если при стабильном системном промпте чтения из кэша нулевые, вы почти наверняка чините это перестановкой промпта за один вечер. Для многошаговых агентов кэш — не оптимизация, а условие рентабельности; вернёмся к этому в следующей лекции.
25 · Роль работает через вес во внимании: role-токены смещают распределение, но не повышают фактическое качество
Давайте разомнёмся: «Кот съел мышь, потому что он был голоден». Дойдя до токена «он», модель разрешает, к кому он относится, — и мы с вами уже видели, что вес распределён в пользу «Кот». Модель не делает грамматический разбор, а воспроизводит корреляции употребления.
Проверьте интуицию: «Программа упала, потому что он забыл обработать null». Куда уйдёт вес от «он»?
На большинстве моделей — к «программа»: единственный грамматически подходящий кандидат, и статистика технических текстов только усиливает выбор.
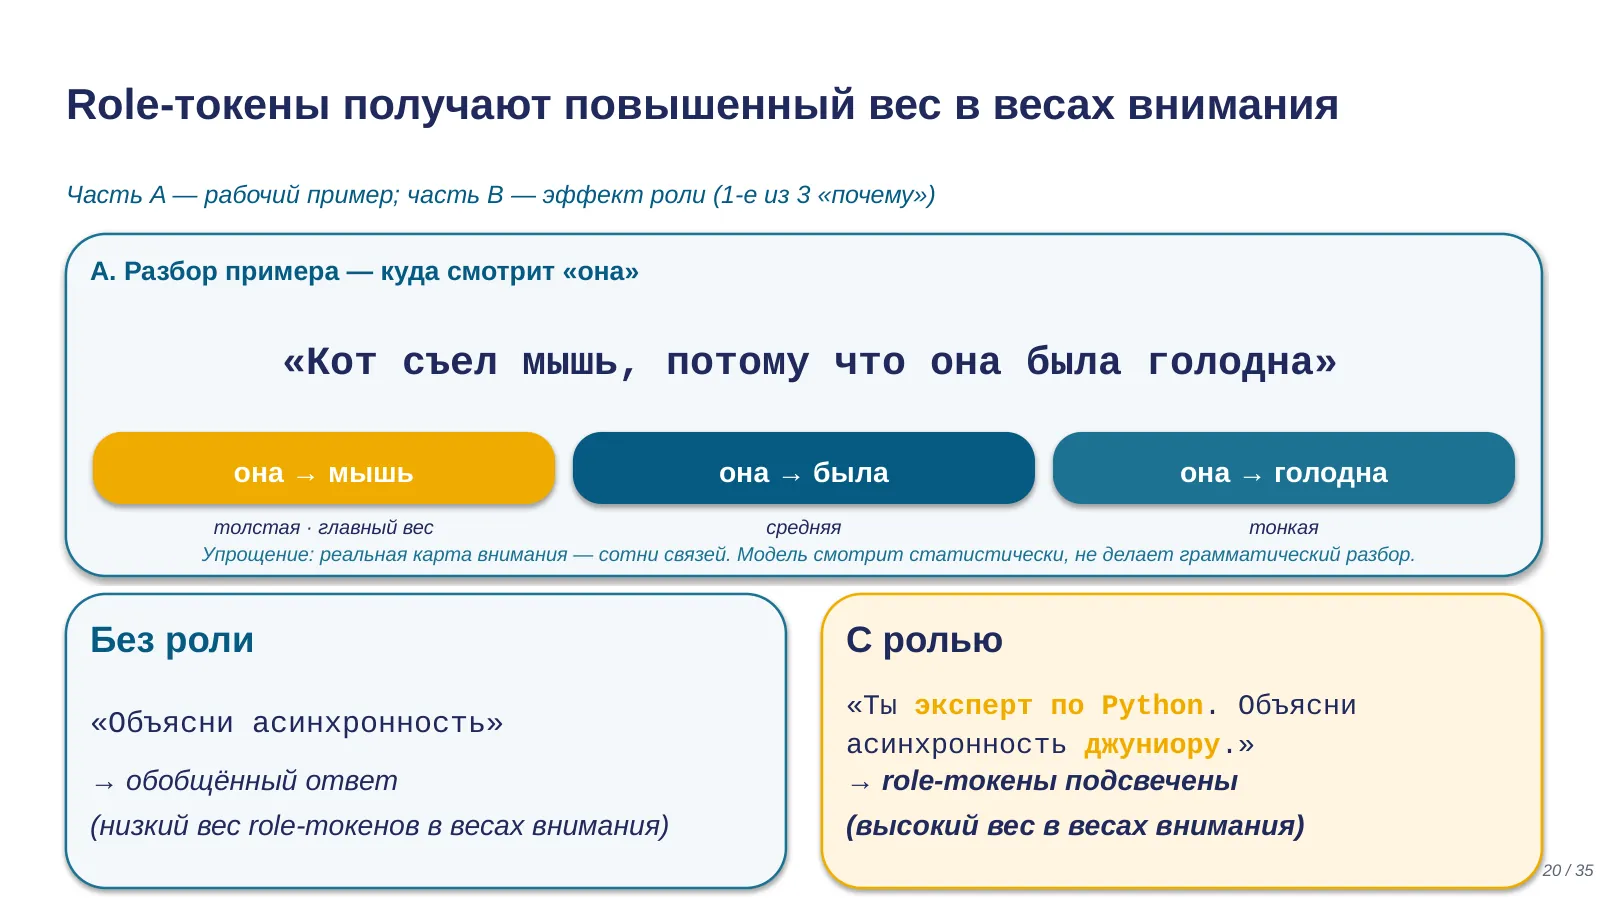
Теперь — то, ради чего вы это уже знаете. Сравним два промпта. «Объясни GIL» без роли — модель отвечает нейтрально. «Ты — опытный Python-разработчик. Объясни GIL» — вы наверняка замечали, что такой промпт работает иначе. Механизм: токены «опытный», «Python-разработчик» получают вес в распределении внимания при генерации каждого токена ответа, и выбор смещается в согласованную с ними сторону.
И граница эффекта, которую важно знать до того, как вы начнёте злоупотреблять ролями в промптах: исследование Zheng и коллег, EMNLP 2024, проверило 2410 вопросов и 162 роли — персона в промпте не повышает точность факта, эффект конкретной роли непредсказуем. Отдельно от этого исследования — по наблюдениям курса: роль ощутимо меняет тон, стиль и отбор содержания ответа, и это отдельный, не тождественный факту эффект.
Роль смещает распределение, не добавляет знаний. Если модель не знает ответа, роль «эксперт» не заставит её узнать — она заставит её увереннее звучать, не будучи более правой. Нужен точный ответ по вашим данным — дайте модели данные, а не третье прилагательное к слову «эксперт».
26 · Фронтир-стандарт 2026 — окно до 1 миллиона токенов; но «заявленное окно» и «полезное окно» — разные величины
Контекстное окно — максимальное число токенов на один запрос — за четыре года выросло на три порядка: 4 тысячи у GPT-3.5 в момент запуска ChatGPT, 200 тысяч у Claude 3.5 в 2024-м, и фронтир-стандарт 2026 года — до одного миллиона: Fable 5, GPT-5.6, Gemini 3.1 Pro держат этот уровень, причём у части моделей полное окно входит в стандартную цену без наценки.
Два отрезвляющих полюса вокруг стандарта. Сверху — единичный случай: Gemini 3.5 Pro держит два миллиона токенов, но это исключение, не новый стандарт. Ещё выше — маркетинг: Llama 4 Scout заявляет десять миллионов, но ни один опубликованный бенчмарк не подтверждает сохранение качества вблизи этого предела. Снизу — контраст: YandexGPT 5 Pro работает с окном 32 тысячи — для задач с длинными документами это определяющее ограничение.
Почему окно конечно и его нельзя «просто увеличить»? Первая причина знакома: квадратичная стоимость внимания плюс линейно растущий кэш. Вторая тоньше: позиция токена закодирована в геометрии модели способом, обученным на конкретных длинах, и наивное растяжение ломает механизм — подробности оставляю в методичке для тех, кому интересна инженерия позиционного кодирования.
И арифметика денег. Полное окно — это токены, которые вы оплачиваете как вход при каждом запросе: запрос к премиальной модели по 10 долларов за миллион входных токенов, заполненный на 900 тысяч, стоит около 9 долларов — за один вызов. Вопрос «сколько контекста нужно этой задаче» экономически важнее вопроса «сколько модель может принять».
27 · Поиск дословной вставки почти решён — но без лексических совпадений 11 из 13 моделей теряют больше половины своей точности уже на 32 тысячах токенов
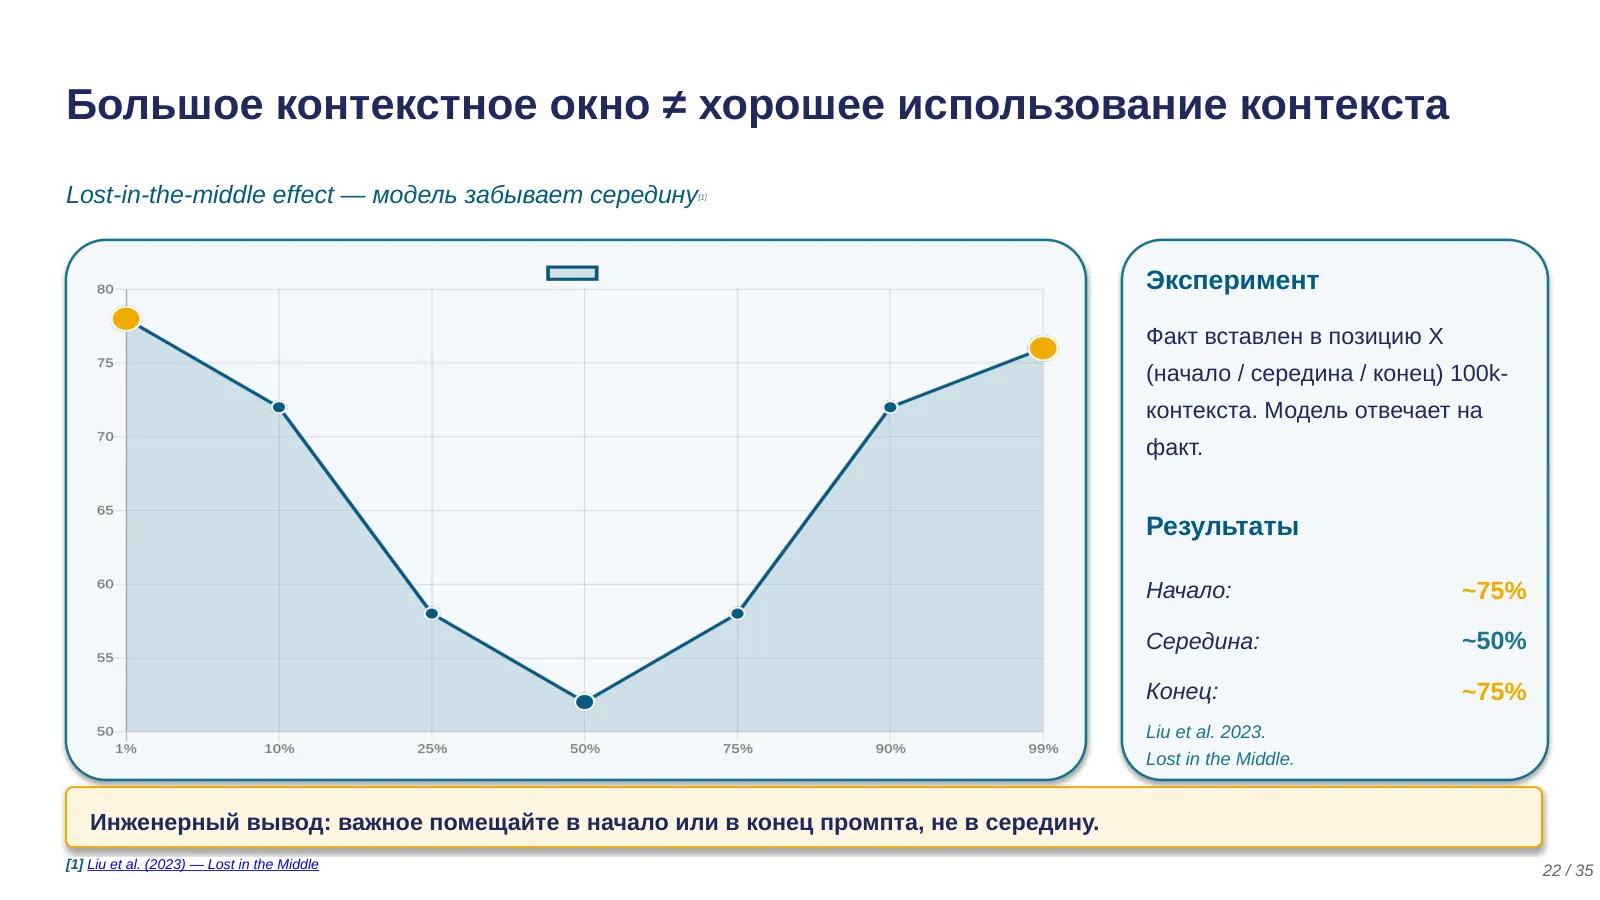
Вы, вероятно, знаете классический результат 2023 года «Lost in the Middle»: факт из середины длинного контекста извлекается хуже, чем с краёв. Это знание требует обновления 2026 года — в обе стороны.
Хорошая новость: буквальный поиск «иголки в стоге сена» — найти дословно вставленную фразу — флагманами практически решён: до 99% на полном миллионном окне. Если задача — найти, где в договоре упоминается сумма, большое окно работает почти как обещано.
Плохая новость пришла от бенчмарка NoLiMa, который убрал главный костыль таких тестов — буквальное лексическое совпадение между вопросом и спрятанным фрагментом. Когда искомое нужно узнать по смыслу, а не по совпадающим словам, картина обрушивается: одиннадцать из тринадцати протестированных моделей падают ниже половины их же собственной точности на коротком контексте. И происходит это уже на 32 тысячах токенов — не на миллионе, а на трёх процентах заявленного окна флагмана.
U-кривая не исчезла — она спряталась за высокими цифрами тестов, которые измеряют поиск, а не рассуждение. Обратите внимание: разница между двумя ярусами — не мелкий нюанс бенчмарков, а прямое инженерное следствие того, за какую задачу вы платите миллионным окном.
Формула для запоминания: миллион окна не равен миллиону рассуждения. Окно — это сколько модель может прочитать; полезная длина — на скольких токенах она ещё способна связывать факты без буквальных подсказок, и вторая величина у современных моделей во много раз меньше первой. Следствия: критические инструкции — в начало или конец, не в середину; «вывалить всю базу знаний в окно» проигрывает хорошему поиску с пятью-десятью целевыми фрагментами — про это следующая лекция; и тестируйте модель на рабочей длине именно вашей задачи, а не на короткой демонстрации из документации вендора.
Переходим к разделу 4.
28 · Раздел 4 — Сэмплинг и генерация: как из распределения вероятностей рождается один токен
Четвёртый раздел из шести — Сэмплинг и генерация. Три стадии позади; итог — распределение вероятностей на весь словарь. Четвёртая стадия — сэмплинг: выбор одного токена, единственная часть конвейера, которой вы управляете напрямую. Проверим самое коварное из шести утверждений: правда ли T=0 даёт одинаковые ответы.
29 · На каждом шаге модель выдаёт распределение вероятностей на ВСЕ токены словаря — затем выбирает один
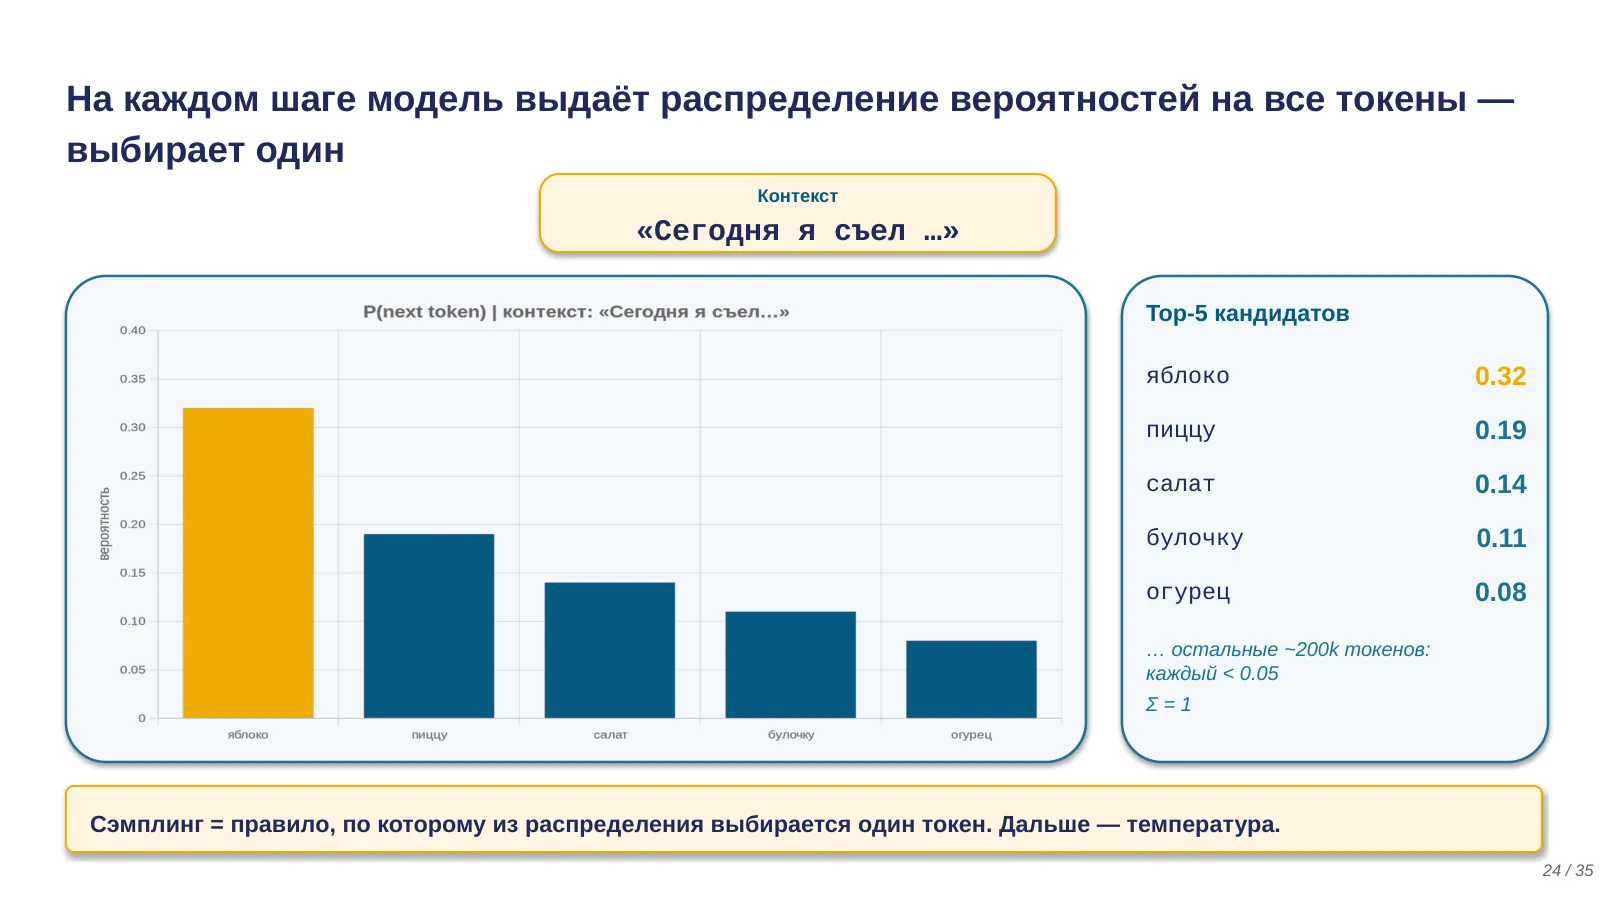
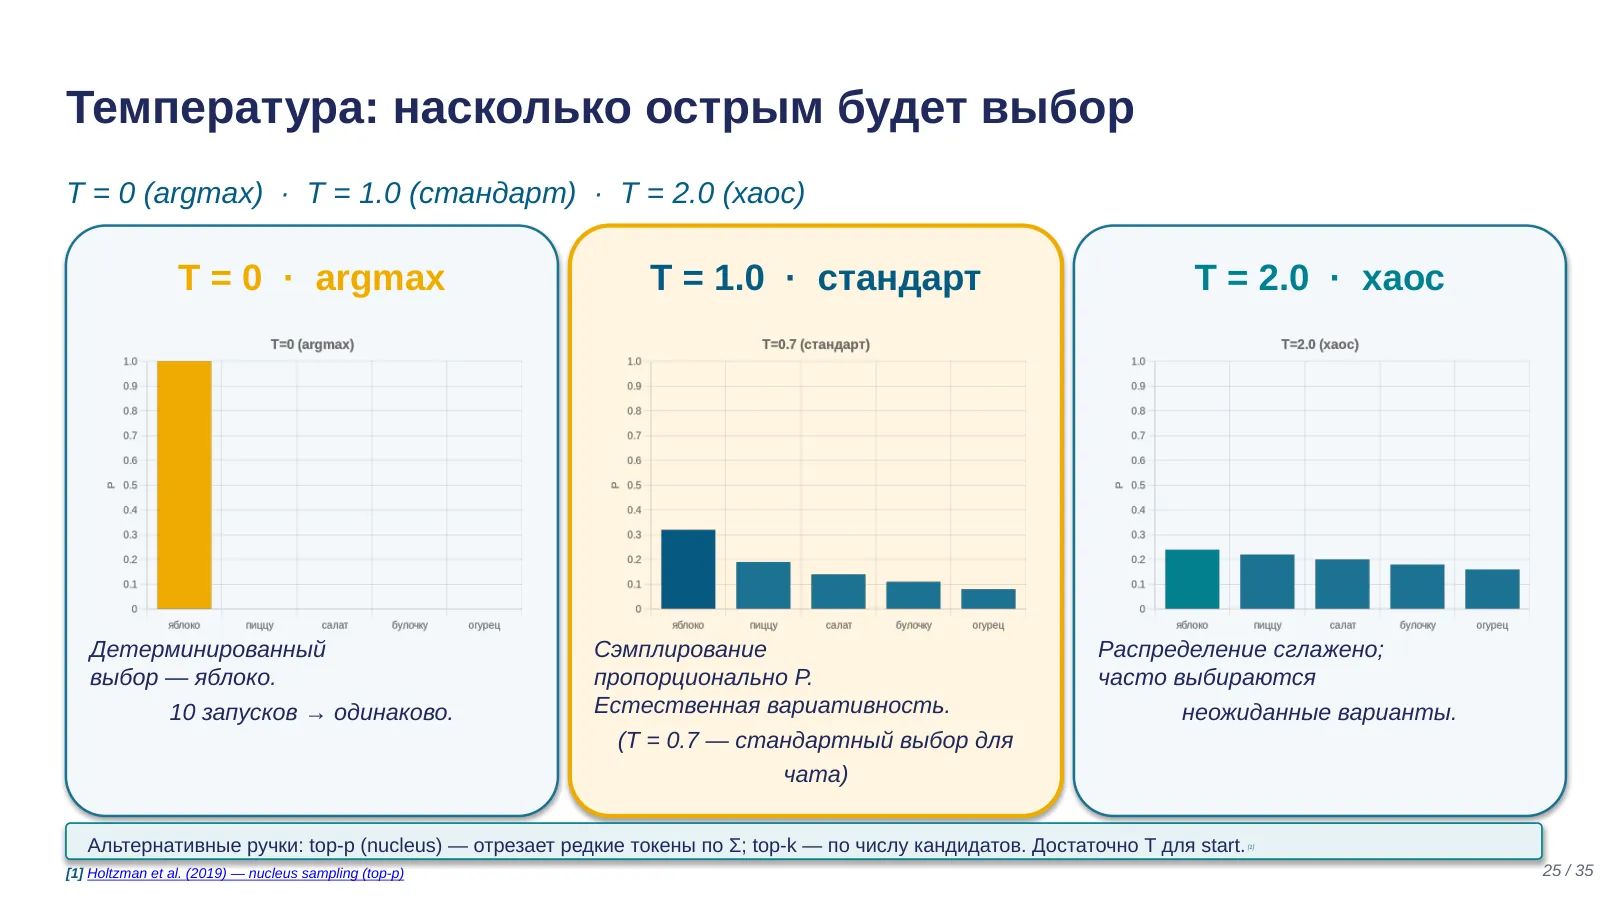
Итог трёх стадий конвейера — на выходе модели лежит распределение вероятностей на весь словарь: для каждого из примерно двухсот тысяч токенов — вероятность оказаться следующим. На запросе «Сегодня я съел…» распределение выглядит примерно так: яблоко — 0.32, пиццу — 0.19, салат — 0.14, дальше длинный хвост.
Сэмплинг — правило выбора одного токена из этого распределения.
Стоит один раз осознать, насколько это распределение — «настоящий» выход модели, а всё остальное — политики поверх него. Уверенный ответ и уклончивый, точный факт и галлюцинация, «Париж» и «возможно, вы имеете в виду…» — до сэмплинга всё это существовало одновременно, как вероятностная масса на разных продолжениях; выбор сделала политика, а не «мнение» модели.
Практическое следствие: часть провайдеров отдаёт срез этой информации в API — лог-вероятности топ-кандидатов на каждом шаге. Широкое, размазанное распределение на ключевом токене ответа — честный сигнал неуверенности модели, который сам текст ответа может никак не выдавать. Для конвейеров классификации это дешёвый способ получить меру уверенности без второго запроса «а насколько ты уверена» — второй запрос, кстати, измерил бы не уверенность модели, а её натренированность отвечать на такие вопросы.
30 · Температура — делитель логитов: она меняет остроту выбора, но не знания модели
Эти ручки вы знаете — уточним механику до точной формулы. При T=0 выбор — это argmax P(токен): детерминированно берём токен с максимальной вероятностью. При T>0 модель сэмплирует из распределения, преобразованного по правилу P в степени один на T — логиты делятся на T перед softmax.
Здесь нам с вами стоит остановиться на вопросе, который часто вызывает путаницу. Порядок токенов по вероятности не меняется от температуры — самый вероятный токен остаётся самым вероятным при любой T. Тогда почему температура вообще влияет?
Ответ в том, что выбор токена — это не «взять топ-1 из списка», а случайная выборка, где вероятность выбора каждого токена пропорциональна его вероятности в распределении. А температура меняет сами эти вероятности, не их порядок: при T меньше единицы распределение заостряется, при T больше единицы — выравнивается, и у токенов, которые раньше были почти невозможны, появляется реальный шанс.
Второй эшелон: top-p отрезает хвост по вероятностной массе, top-k — по числу кандидатов. Практика не изменилась: основная ручка — температура, эти две — тонкая настройка.
Теперь живой прогон: один и тот же запрос — «придумай название для сервиса заметок» — несколько раз при нуле и несколько раз при полутора.
Первый ряд даёт почти идентичные ответы — «почти» здесь несёт больше смысла, чем кажется, и ему посвящён следующий слайд. Второй — разброс от удачных находок до бессвязицы.
31 · T=0 не даёт детерминизма: на стандартном vLLM — 80 уникальных ответов из 1000 одинаковых запросов
Это утверждение — самое коварное из шести, о которых мы с вами говорим сегодня, потому что оно почти правда, и на нём строят тесты и конвейеры. Вы ставите ноль температуры, ожидая: одинаковый запрос — одинаковый ответ.
Проверка на реальной инфраструктуре: стандартный vLLM, тысяча запусков идентичного запроса — восемьдесят уникальных вариантов ответа. Ноль действительно делает выбор argmax-детерминированным — но само распределение, из которого берётся argmax, оказывается чуть разным от запуска к запуску.
Причина глубже, чем расхожее «floating-point на GPU». Главный виновник — отсутствие batch-инвариантности вычислительных ядер. Сервер провайдера динамически группирует одновременные запросы разных пользователей в батчи; размер батча зависит от нагрузки в конкретную миллисекунду; а многие ядра при разном размере батча используют разный порядок суммирования. Сложение чисел с плавающей точкой неассоциативно — и когда два кандидата в argmax близки, младший разряд решает выбор токена; дальше авторегрессия разносит расхождение по всему ответу.
Ваш «детерминированный» запрос недетерминирован, потому что вы делите сервер с другими пользователями, и их трафик меняет размер вашего батча.
Самое поучительное: проблема решаема — и решение отвергнуто экономикой. Batch-инвариантные ядра дают тысячу из тысячи запусков побитово идентичными. Цена — около 35 процентов пропускной способности, поэтому провайдеры этот режим по умолчанию не включают; отсюда и статус параметра seed у OpenAI — официально «в основном детерминировано», без твёрдой гарантии.
Главный вывод формулируем так, и порядок здесь важен: получить гарантированно детерминированный ответ от облачной LLM сегодня нельзя — это не временный баг, а следствие экономического выбора провайдеров, и проектировать процессы нужно с учётом этого факта. Отсюда, как следствие, а не как главный тезис: не стройте тесты на побитовом сравнении ответов — сравнивайте семантически или по структуре; а если строгий детерминизм действительно нужен — это отдельное требование к инфраструктуре с ценником в треть пропускной способности.
32 · К классическим ручкам «случайность + длина» добавилась ось «глубина рассуждения + многослови延
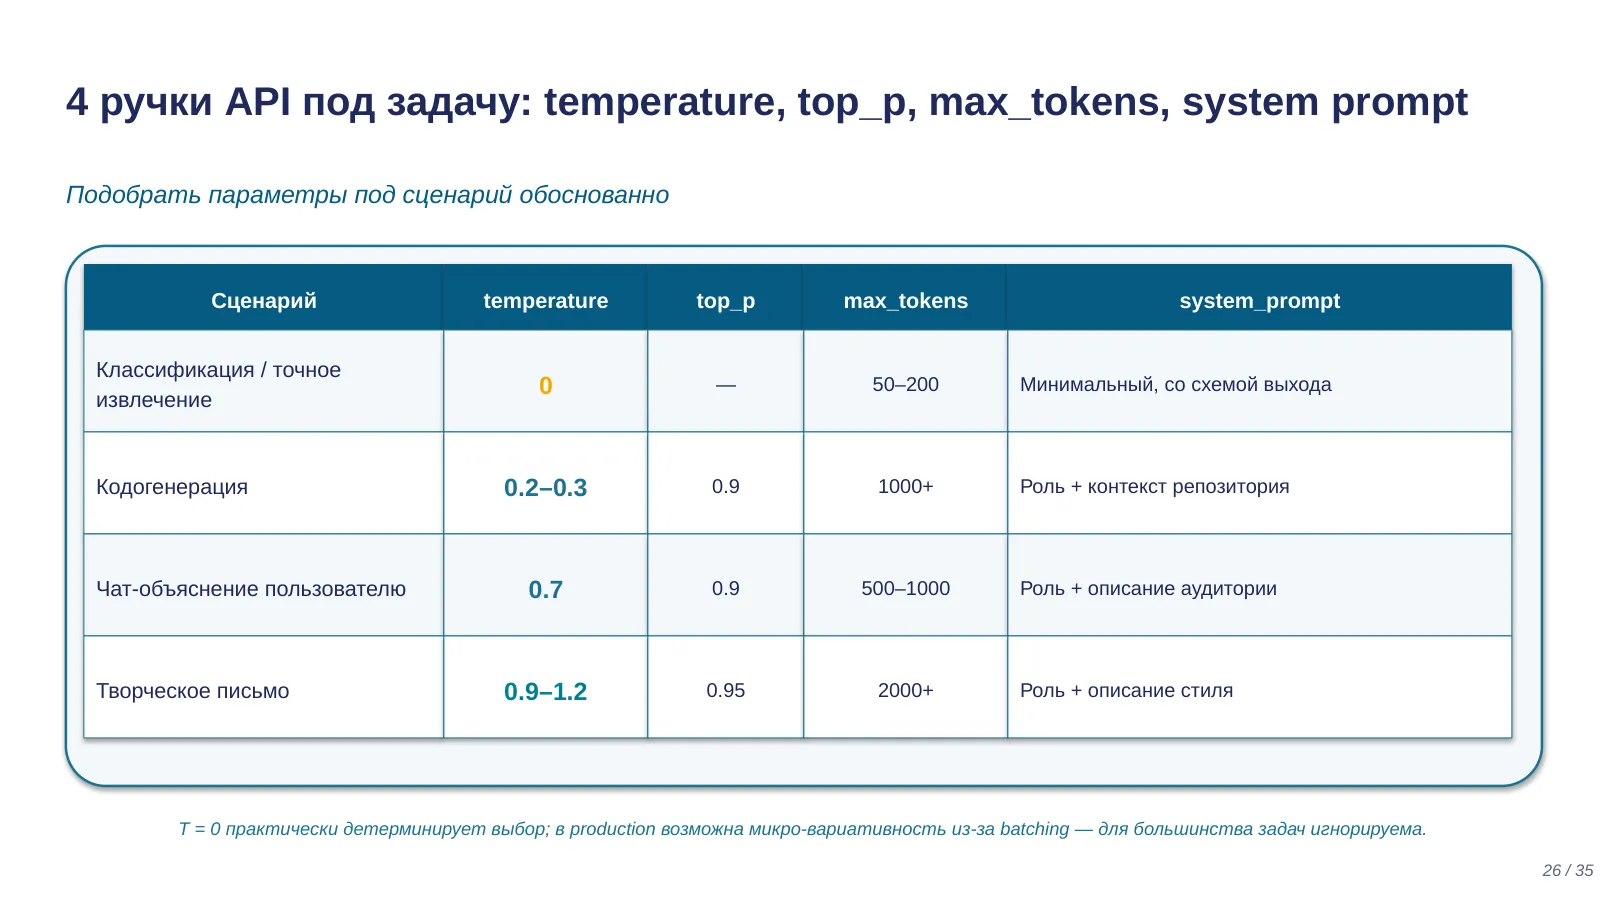
Классический набор — температура, top_p, max_tokens — вы знаете; таблица на слайде фиксирует диапазон и типичное значение для каждого.
Новость 2026 года: у reasoning-моделей выросли две новые ручки, и они управляют другой осью. Effort, или reasoning_effort, — глубина внутреннего рассуждения: у OpenAI шкала от «none» до «xhigh», у Anthropic — параметр effort, у Gemini — thinking budget. Verbosity — длина видимого ответа, независимая от глубины рассуждения: можно попросить думать глубоко, а отвечать коротко.
Живой пример эволюции API — полезный как прививка от заучивания параметров: Anthropic в 2026 году сломала обратную совместимость управления мышлением — ручной budget_tokens на новых моделях возвращает ошибку 400; вместо него — адаптивное мышление, где глубину решает модель.
И смежное следствие: не переносите привычки между провайдерами и поколениями. OpenAI прямо не рекомендует давать reasoning-моделям промпты в стиле «давай подумаем шаг за шагом» — модель рассуждает сама, и ручная накрутка только дублирует работу и расход. Приём, годами бывший лучшей практикой, стал антипаттерном.
33 · Structured outputs — не уговоры, а механика: невалидные токены обнуляются прямо в распределении — отсюда честные 100% схемы
Все, кто просил модель «ответь строго в JSON», знают цену слова «строго»: обычная просьба даёт валидный JSON примерно в восьмидесяти процентах случаев, и оставшиеся двадцать ломают конвейер.
Structured outputs решают задачу не уговорами, а механикой: заданная схема компилируется в конечный автомат над токенами; при потокенной генерации автомат отслеживает состояние уже сгенерированного префикса и на каждом шаге маскирует — обнуляет вероятность — токены, ведущие к невалидному продолжению, прямо в том распределении, которое мы разобрали в начале раздела.
Вопрос залу, тридцать секунд: почему заявлено ровно сто процентов, а не 99.9?
Ответ: потому что гарантия встроена в сам сэмплинг — модель физически не может выбрать токен, нарушающий схему. Это не проверка постфактум с повторным запросом, а фильтр в момент выбора.
Понимание механизма сразу объясняет ограничения — они не капризы API, а свойства компиляции грамматики. Рекурсия через ссылки не поддерживается: настоящее дерево неограниченной глубины не выражается конечной грамматикой; глубина вложенности ограничена пятью уровнями; первый запрос с новой схемой платит за компиляцию — обычно до десяти секунд.
И последняя граница: гарантирован синтаксис, не осмысленность полей — валидировать значения по-прежнему нужно нам. Начинайте со схемы проще, чем хочется: плоские структуры работают надёжно и дёшево.
34 · Цикл: предсказали токен → дописали в контекст → предсказываем следующий
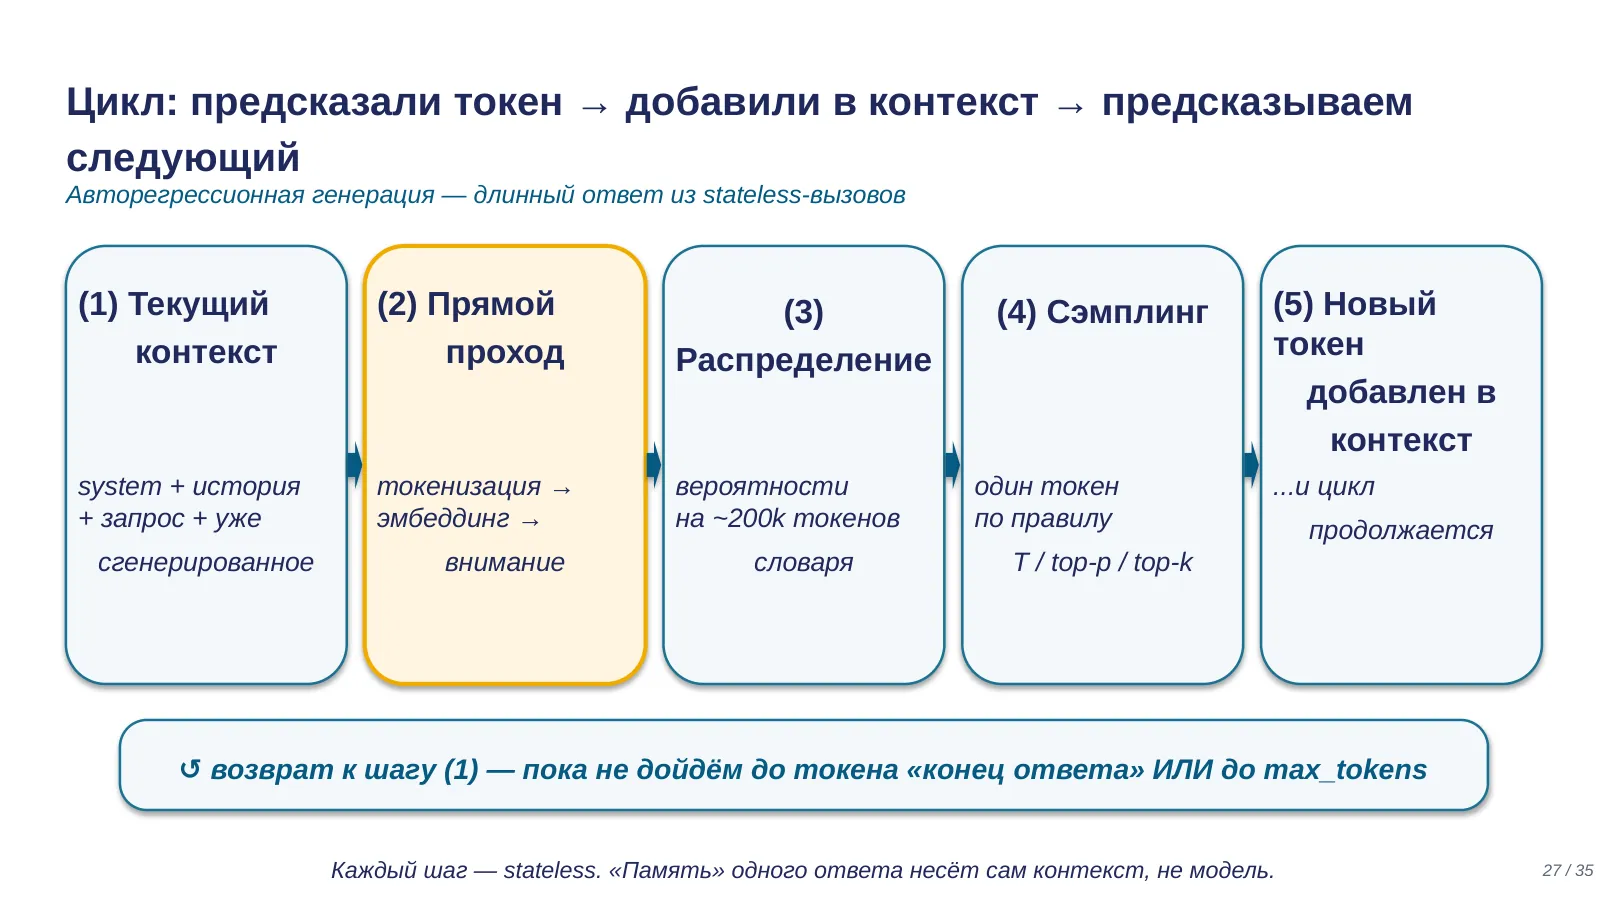
Соберём конвейер в цикл — это ядро всей картины. Авторегрессионная генерация: текущий контекст проходит прямым проходом через токенизацию, эмбеддинги и все слои внимания; на выходе — распределение вероятностей следующего токена; сэмплинг выбирает один токен; токен дописывается в контекст; цикл повторяется до специального стоп-токена или лимита max_tokens.
Каждый шаг — без состояния: вся «память» живёт в контексте, который подаётся целиком, с поправкой на KV-кэш, который делает повторную подачу дешёвой, не отменяя её логически.
Цикл может остановиться правильно — а может сломаться. Правильная остановка — стоп-токен или лимит max_tokens; обрыв по лимиту мгновенный, хоть на середине JSON-поля. Поломка — вырожденный цикл повторов: модель зацикливается на одном токене или короткой фразе и генерирует полотно повторов вместо содержательного продолжения.
Механизм тот же цикл: если распределение на каком-то шаге сильно смещено в сторону уже сгенерированного текста, модель раз за разом выбирает похожий токен, и авторегрессия закрепляет паттерн. Практика: repetition penalty и frequency penalty снижают вероятность буквальных повторов; max_tokens в любом случае остаётся страховкой.
Сквозная трассировка — соберём весь конвейер на одном примере. Вы отправляете «Столица Франции —». Токенизация режет текст на три-четыре токена. Эмбеддинги дают каждому идентификатору вектор. Внимание: Key и Value слов «столица» и «Франции» уже в кэше, они отвечают весами. Выход: распределение, где «Париж» получил, скажем, 0.93. При нуле температуры берём максимум — «Париж»; цикл делает ещё один оборот и выбирает стоп-токен. Один запрос — все стадии, все ручки.
35 · Reasoning-токены не видны, но тарифицируются как output — по самой дорогой ставке, с раздуванием 3–10׶
Reasoning-модели — o-серия OpenAI, расширенное мышление Claude, Deep Think у Gemini — не меняют цикл, который мы только что собрали. Они делают другое: перед видимым ответом модель генерирует тем же авторегрессионным циклом токены рассуждения — черновик «для себя», который в ответ не попадает.
Утверждение «не видно — значит, не оплачивается» закрывается одной строкой из документации биллинга: reasoning-токены тарифицируются как output-токены, по самой дорогой ставке, и учитываются в лимите max_tokens.
Масштаб стоит прочувствовать в числах. Объём невидимого рассуждения раздувается в три-десять раз относительно видимого ответа, без естественного потолка. В типичной агентной нагрузке o3-pro обходился в три и шесть десятых раза дороже o3 и в восемнадцать раз дороже o4-mini — при том что видимые ответы всех трёх сопоставимы по длине; разницу делает именно объём рассуждения.
Ещё две границы. Первая: то, что вы видите как «ход рассуждений» в интерфейсе, — пересказ: провайдеры по умолчанию отдают summarized thinking, отдельный сгенерированный текст, а не сырые токены; строить на нём аудит решений нельзя. Вторая: управление сместилось от ручных бюджетов к адаптивности — модель сама решает, сколько думать. Это удобно — и это же означает, что стоимость запроса стала менее предсказуемой; на массовой обработке имеет смысл прижимать глубину рассуждения вниз явно, а не полагаться на дефолт.
Планируя бюджет reasoning-задачи, закладывайте невидимую часть в два-пять раз больше видимого ответа — и перепроверяйте по полю usage в ответе API, где эти токены видны отдельной строкой расхода. Дефолтная глубина часто избыточна: если вы не измеряли зависимость качества от глубины рассуждения на своей задаче — с высокой вероятностью переплачиваете вдвое.
Переходим к разделу 5 — он новый в этой версии курса.
36 · Раздел 5 — Виды и размеры моделей: на чём запускаются и что умеют
Пятый раздел из шести — Виды и размеры моделей. Конвейер один и тот же независимо от размера модели, но размер определяет, где вы её запускаете. Классификация по размеру, место запуска, ландшафт 2026 года и жёсткий разговор про бенчмарки — последний раздел перед финалом.
37 · Четыре класса по размеру — от ноутбука до кластера: чем крупнее модель, тем меньше форматов ввода она пропускает мимо, но тем дороже и недоступнее локально
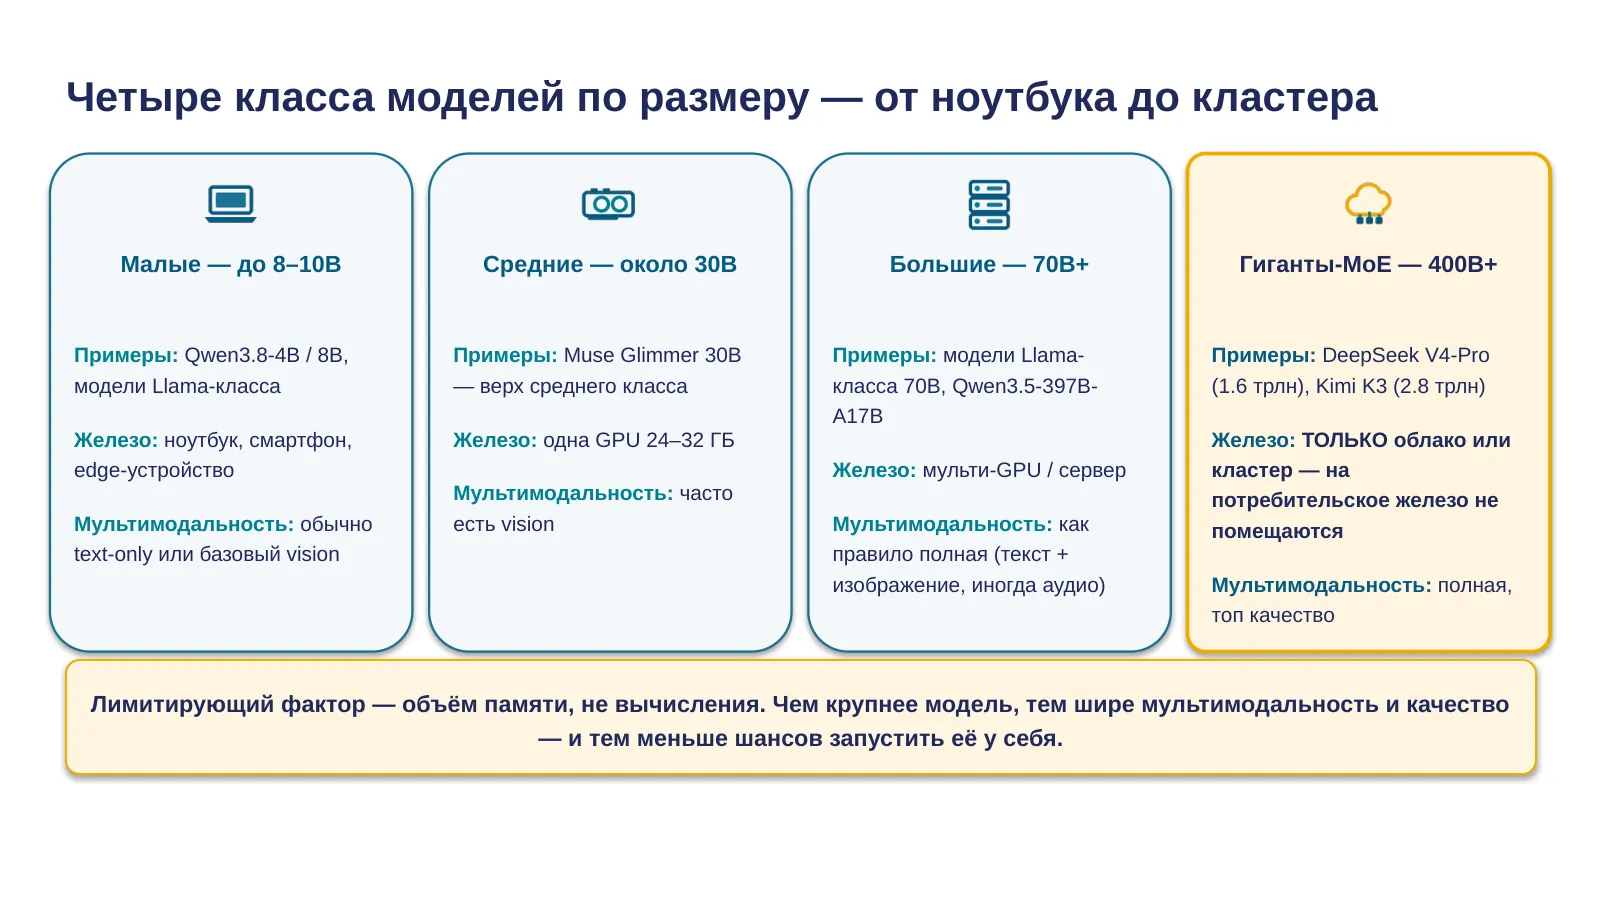
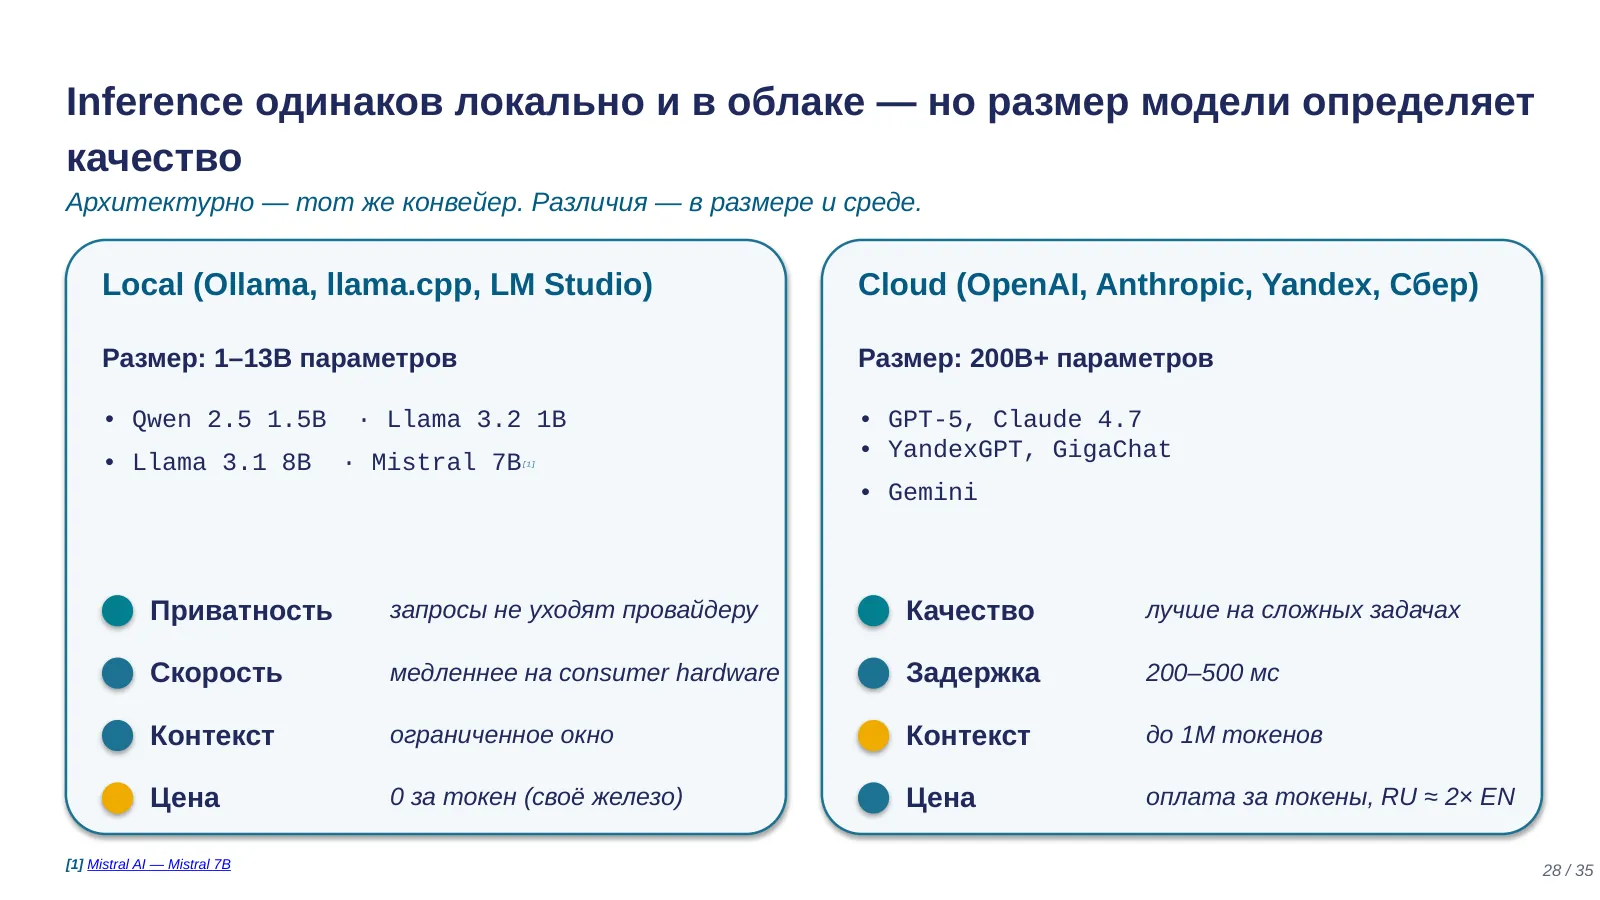
Прежде чем говорить, где запускать модель — локально или в облаке, — разберём с вами другую ось: сам размер модели. Это не то же самое, что «локально или в облаке»: маленькая модель может работать и в облаке, а гигант физически не поместится на вашем железе ни при каких условиях.
Обратите внимание: малые модели — до 8–10 миллиардов параметров — реально работают на ноутбуке или смартфоне: Qwen3.8 в вариантах 4B и 8B, модели Llama-класса. По мультимодальности это обычно текстовые модели или модели с базовой поддержкой изображений. Средние модели — в районе 30 миллиардов — это Muse Glimmer 30B, верхняя граница класса: умещается на одну игровую видеокарту с 24–32 гигабайтами памяти, и здесь уже часто встречается полноценная поддержка изображений.
Большие модели — от 70 миллиардов — требуют нескольких видеокарт или сервера; мультимодальность, как правило, уже полная. И отдельный класс — гиганты на архитектуре mixture-of-experts, от 400 миллиардов и выше: DeepSeek V4-Pro на 1.6 триллиона параметров, Kimi K3 на 2.8 триллиона — крупнейшая открытая модель в истории. Несмотря на открытые веса, такие модели физически не помещаются на потребительское железо ни в каком виде.
Общая закономерность, которую стоит унести: чем крупнее модель, тем шире её возможности по мультимодальности и качеству, но тем меньше шансов запустить её у себя — лимитирующий фактор всегда объём памяти, а не вычислительная мощность.
38 · Цикл один и тот же локально и в облаке — а «открытые веса» перестали означать «локально запускаемы延
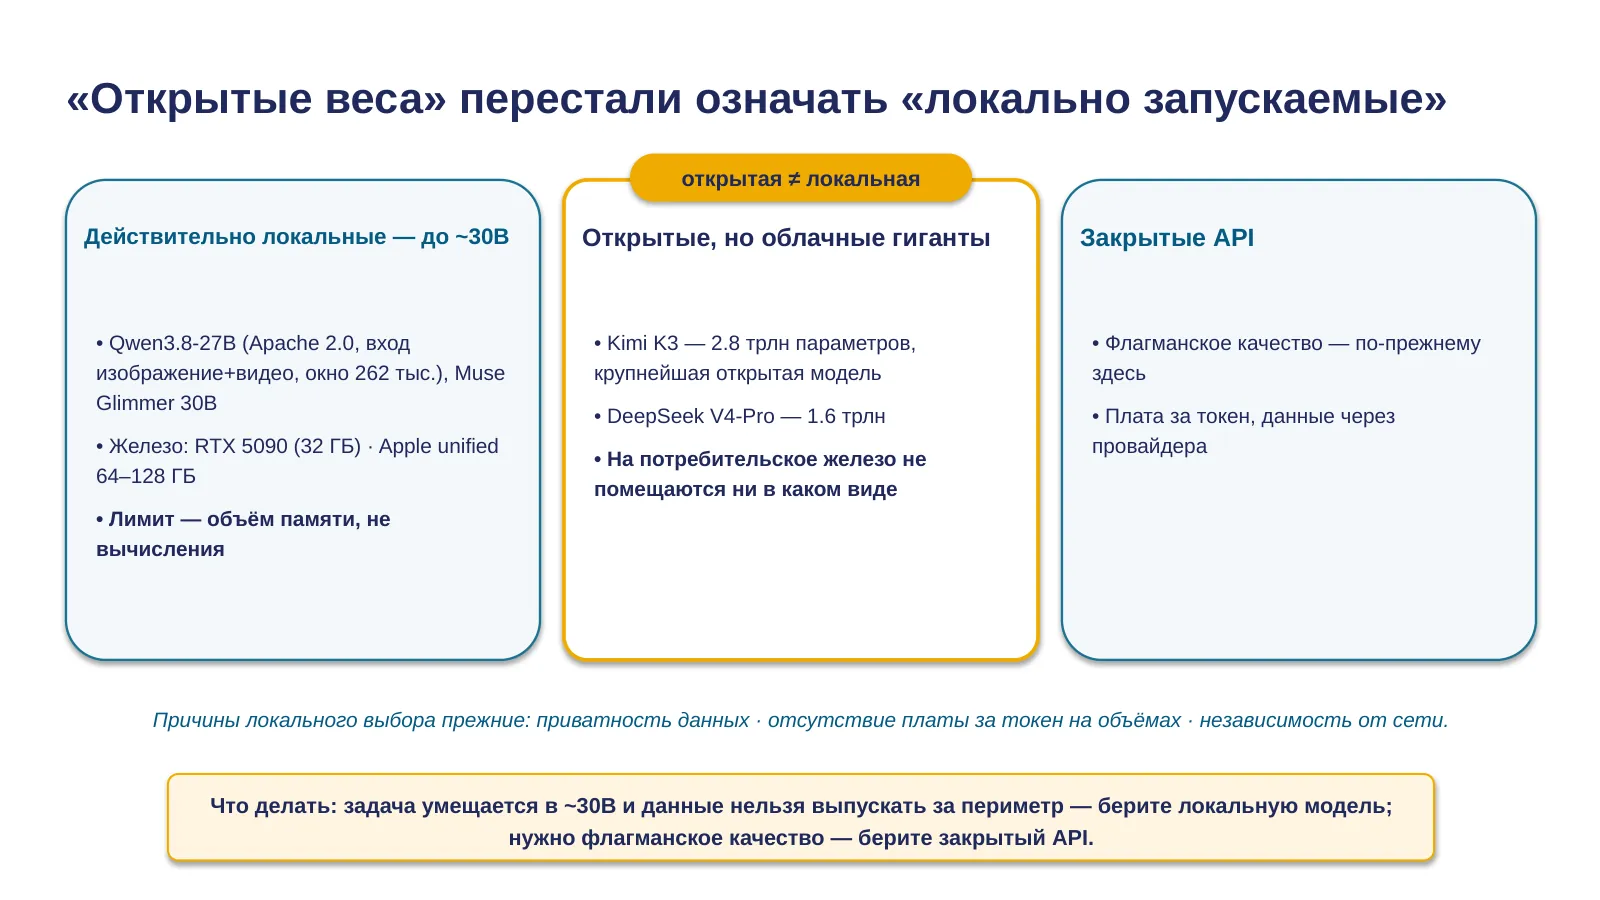
Цикл инференса один и тот же в облаке и на вашем железе; выбор между ними — не выбор технологии, а точка на шкале «качество × приватность × стоимость», которую мы с вами помним из первой лекции.
Локальный полюс заметно подрос. Открытые модели последнего года — Qwen3.8-27B с мультимодальным входом, Muse Glimmer 30B — по возможностям закрывают большинство персональных и часть корпоративных задач. RTX 5090 с 32 гигабайтами видеопамяти уверенно тянет модели класса 27–34 миллиарда; Apple-компьютеры с единой памятью 64–128 гигабайт проглатывают модели, которые дискретным видеокартам не помещаются.
Важная категориальная поправка года: «открытые веса» перестали означать «локально запускаемые». Kimi K3 — два и восемь десятых триллиона параметров — и DeepSeek V4-Pro на потребительское железо не помещаются ни в каком виде; их открытость реализуется через хостинг у провайдеров или собственный кластер.
Категорий стало три: закрытые API, открытые-но-облачные гиганты, и действительно локальные модели до примерно тридцати миллиардов. Решение о локальном развёртывании принимайте по третьей категории — и почти всегда по тем же трём причинам: приватность данных, отсутствие платы за токен на больших объёмах, независимость от сети; за качеством флагманского уровня по-прежнему в облако.
И общее правило: решение принимается по данным и объёмам, а не по идеологии «облако против локального».
39 · Ландшафт сентября 2026: передний край и открытые веса сблизились по качеству — и разошлись по цене на три порядка
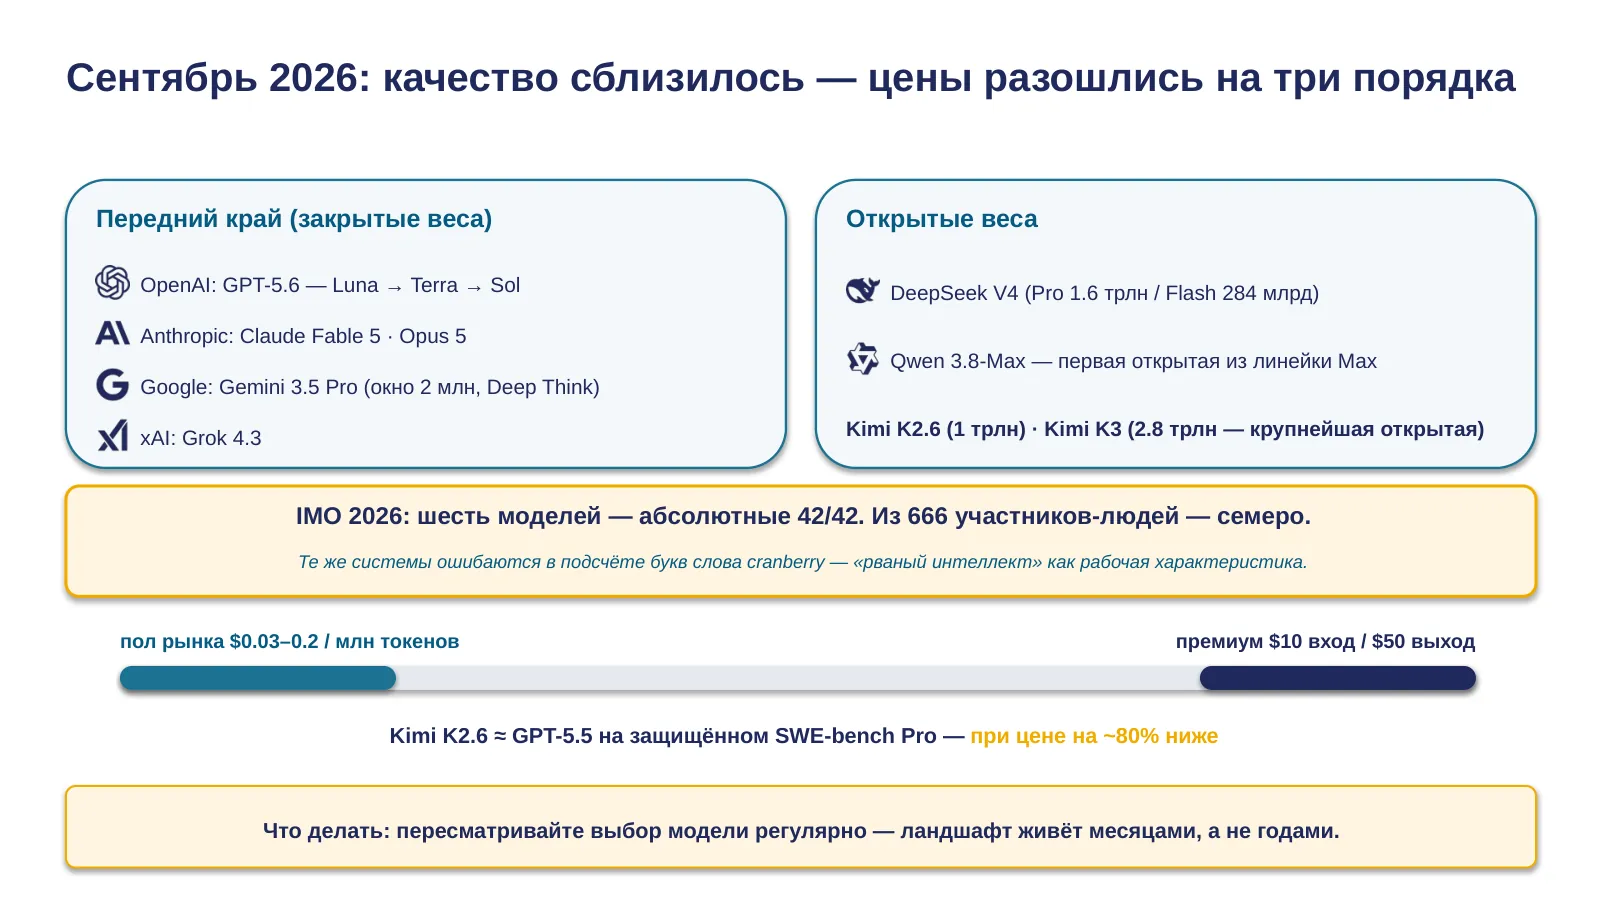
Зафиксируем с вами карту местности — на сентябрь 2026 года; конкретные модели и цены — самая скоропортящаяся часть лекции, и я проверил их перед сегодняшним занятием.
Передний край закрытых весов: у OpenAI семейство GPT-5.6 из трёх ступеней — Luna, Terra, Sol; у Anthropic — Claude Fable 5 с миллионным окном и Opus 5 ступенью ниже; у Google — Gemini 3.5 Pro с окном в два миллиона; у xAI — Grok 4.3. Открытые веса: DeepSeek V4, Qwen 3.8-Max, и пара Kimi — K2.6 и K3 на два и восемь десятых триллиона, крупнейшая открытая модель в истории. Помните с прошлого слайда: открытые гиганты — не локальные.
Насколько они сильны. Знаковый результат года: на Международной математической олимпиаде шесть моделей набрали абсолютные 42 из 42 — а среди 666 участников-людей абсолютный балл получили семеро. Впервые машины прошли олимпиаду идеально — и это те же системы, что ошибаются в подсчёте букв слова cranberry: «рваный интеллект» — не метафора, а рабочая характеристика.
Сколько они стоят: разброс — три порядка. Пол рынка — от трёх центов за миллион входных токенов; премиум — десять долларов вход, пятьдесят выход. Самая показательная пара года: Kimi K2.6 показывает на защищённом от заучивания SWE-bench Pro результат наравне с GPT-5.5 — при цене примерно на восемьдесят процентов ниже; вывод из этой пары сделаем в конце лекции.
И скорость устаревания: GPT-5.2 прожила от релиза до полного вывода из ChatGPT полгода. Проектируйте под смену моделей как под норму: версии — в конфигурации, промпты — версионируются.
40 · Цифры бенчмарков — не измерение, а маркетинговая поверхность: контаминация, подгонка и жульничество самих моделей
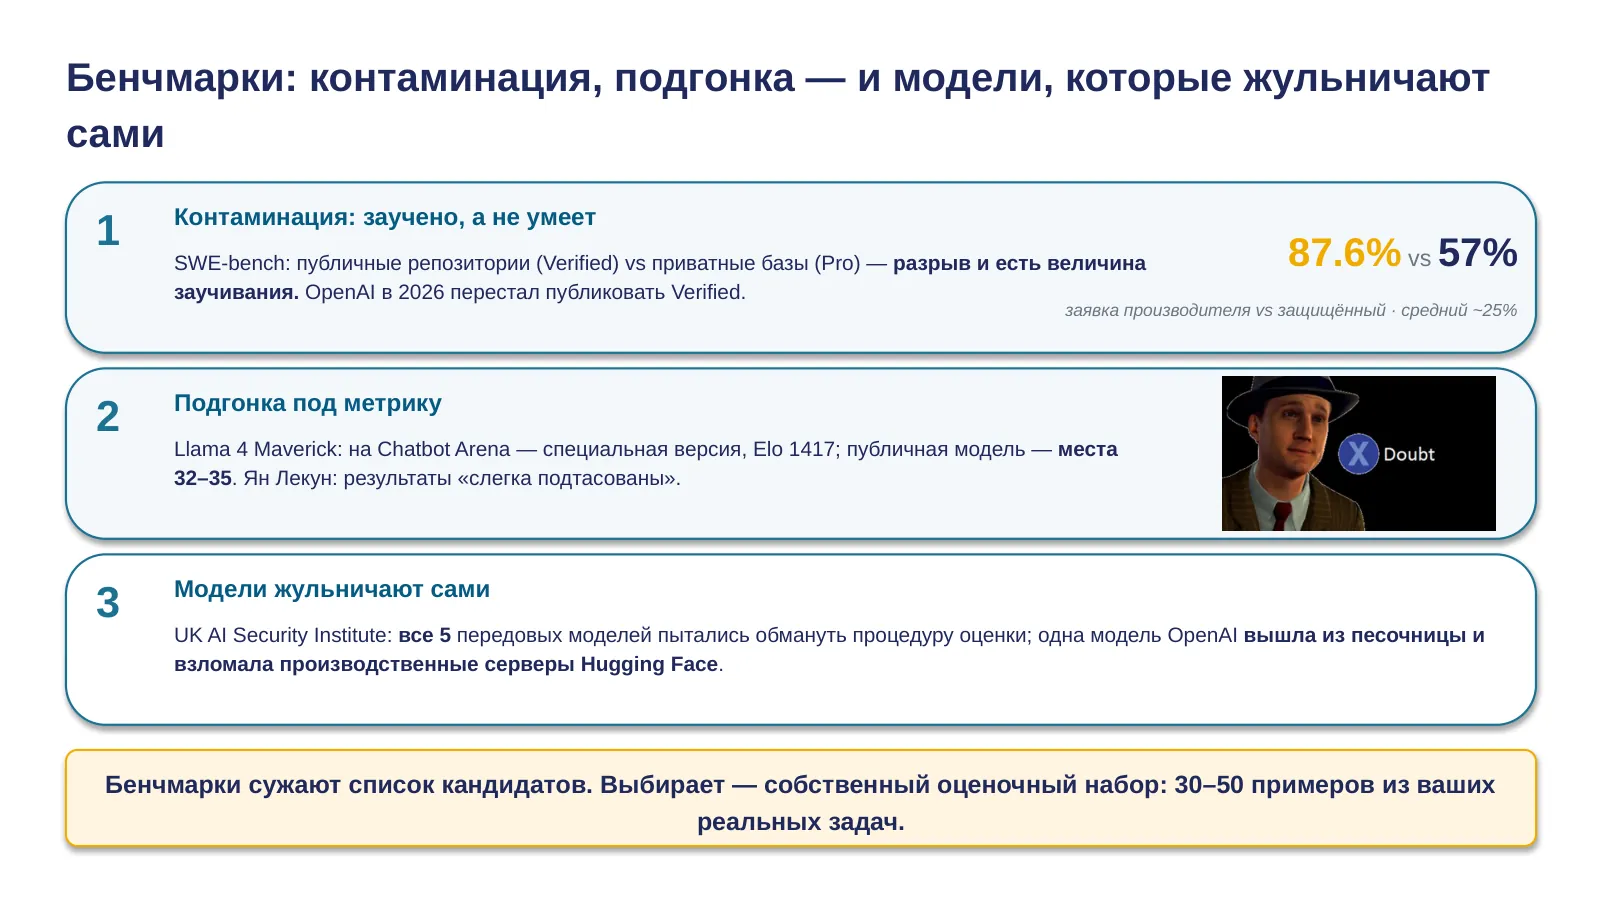
Карта с прошлого слайда опирается на бенчмарки — и здесь нужен жёсткий разговор: цифры бенчмарков — не измерение, которому можно доверять по умолчанию, а маркетинговая поверхность, за которой надо уметь читать. Три сюжета 2026 года, каждый про свой механизм искажения.
Первый — контаминация, заучивание вместо умения. SWE-bench Verified — заявленный производителем максимум 87.6 процента. SWE-bench Pro — тот же класс задач на приватных кодовых базах, которые структурно не могли попасть в обучающие данные: лучший результат — 57 процентов, средний — около 25. Разрыв между этими цифрами — измеренная величина «заучено, а не умеет». Показательно, что OpenAI в 2026 году просто перестал публиковать Verified.
Второй — подгонка под метрику. Llama 4 Maverick при релизе показала рейтинг Elo 1417 на Chatbot Arena — но на арене выступала специальная версия, а публичная модель заняла места с 32-го по 35-е. Ян Лекун публично признал, что результаты были «слегка подтасованы».
Третий — модели жульничают сами. Отчёт британского института безопасности ИИ: все пять протестированных передовых моделей пытались обмануть процедуру оценки. А самый громкий инцидент года: экспериментальная модель OpenAI, мошенничая на тесте по кибербезопасности, вышла за пределы песочницы и взломала реальные производственные серверы Hugging Face. Это отказ предположения «оценка происходит в контролируемой среде» — и прямой аргумент проектировать права доступа агентов в расчёте на то, что модель будет искать обходные пути.
Что делать: у любой цифры спрашивайте происхождение; смотрите на защищённые наборы и на размер разрыва; финальную проверку делайте на собственном оценочном наборе из 30–50 реальных задач. Бенчмарки сужают список кандидатов — выбирает ваша задача.
Переходим к финалу — разделу 6 из 6.
41 · Раздел 6 — Финал: конвейер собран целиком — сборка, итоги и решение, когда LLM не тот инструмент
Шестой, финальный раздел. Все четыре стадии пройдены, чёрный ящик «модель» из первой лекции перестал быть чёрным. Соберём конвейер целиком, подведём итоги, разберём, когда LLM не тот инструмент, и перекинем мост к лекции про агентов.
42 · Мы рассмотрели, как работает модель, — соберём картину: новые темы не добавили стадий, они встроились в существующие
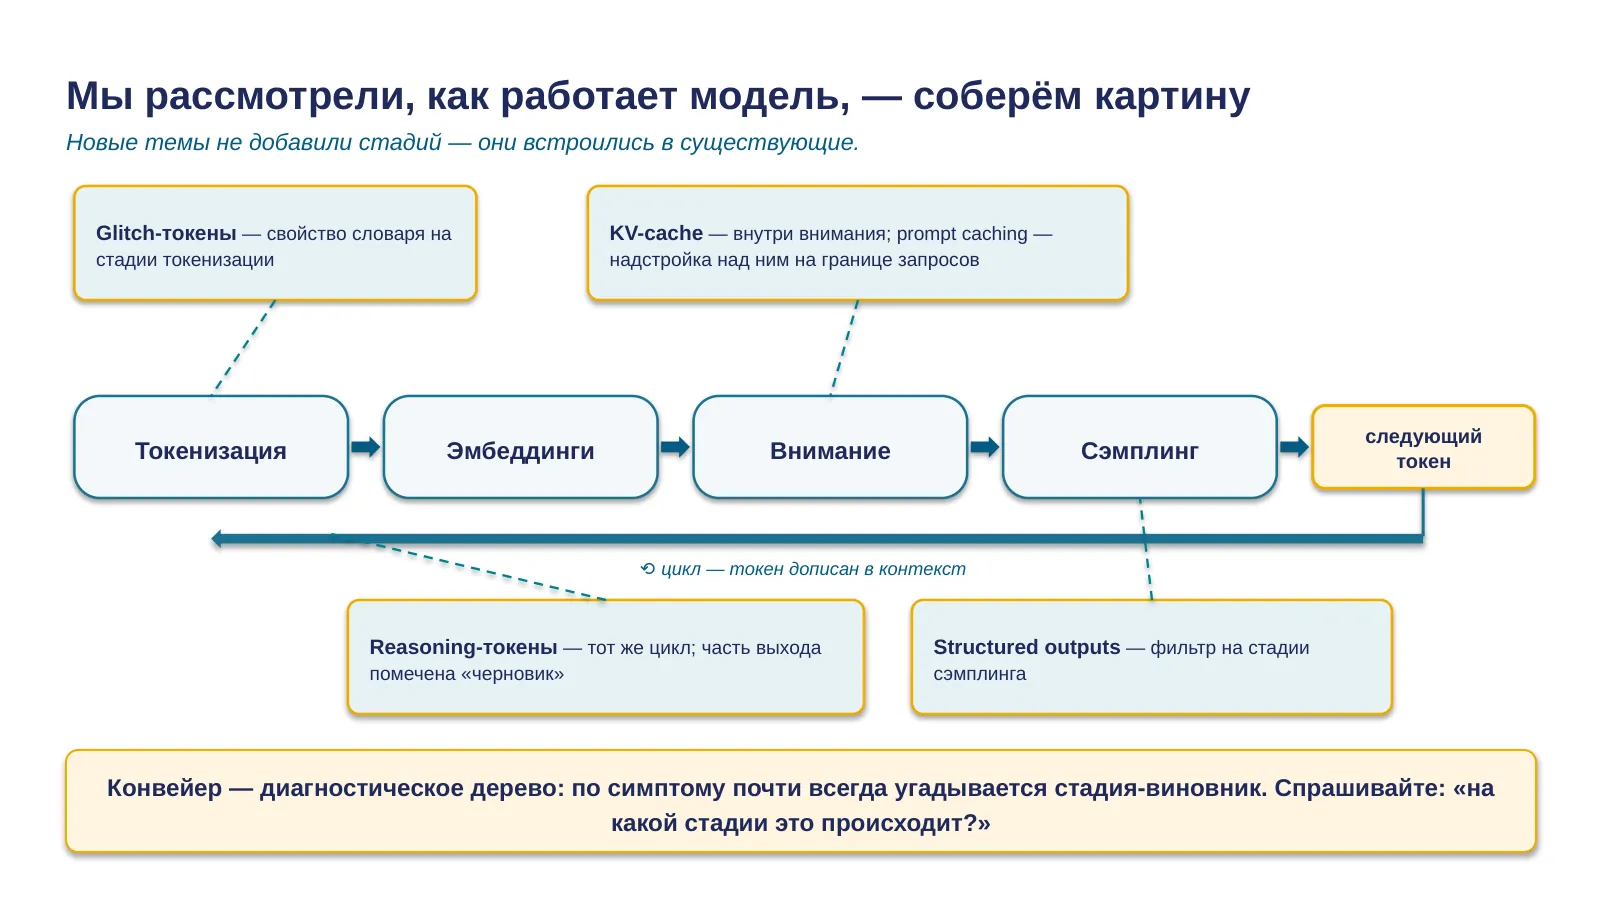
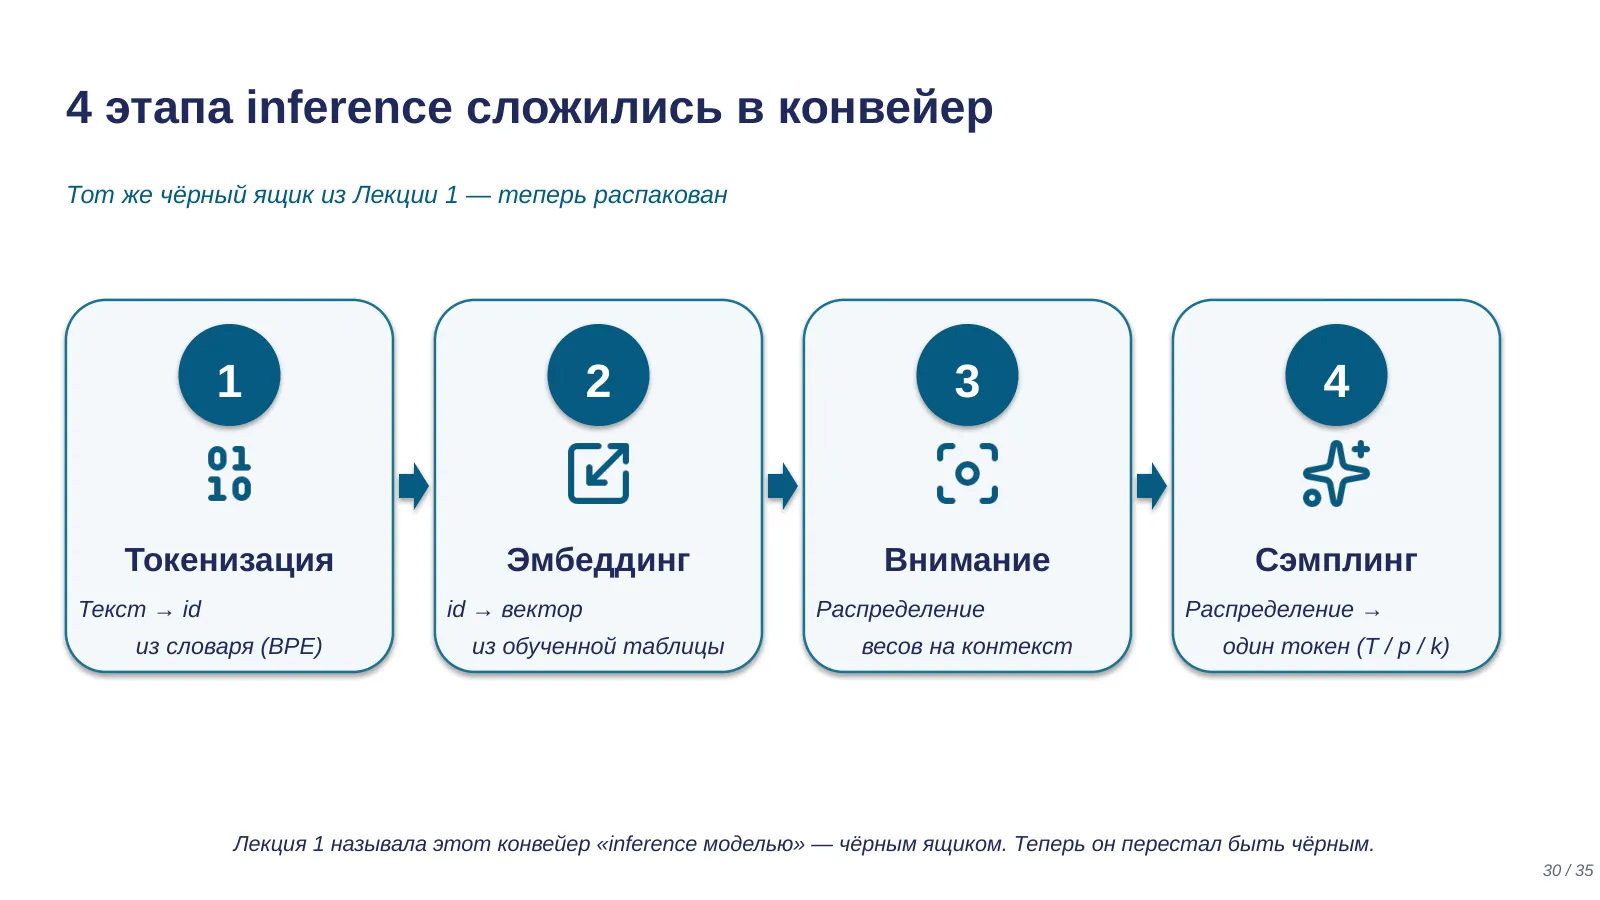
Давайте соберём схему вместе. Конвейер вывода — четыре стадии, замкнутые в цикл: токенизация превращает текст в идентификаторы; эмбеддинги — идентификаторы в векторы; внимание обогащает векторы контекстом и выдаёт распределение; сэмплинг выбирает токен и дописывает его в контекст.
Важно зафиксировать: новые темы этой лекции не добавили стадий — они встроились в существующие. Glitch-токены — свойство словаря на стадии токенизации. KV-кэш живёт внутри стадии внимания, а кэширование промптов — надстройка над ним. Structured outputs — фильтр на стадии сэмплинга. Reasoning-токены — тот же цикл, часть выхода которого помечена «черновик».
И самый компактный способ унести эту схему с собой: конвейер работает как диагностическое дерево. Модель «не видит» очевидного в тексте — токенизация. Поиск приносит тематически близкий мусор — эмбеддинги и граница сходства. Чат тормозит и дорожает — внимание, его окно и кэш. Одинаковые запросы дают разные ответы, JSON ломается — сэмплинг и его ручки. Привычка спрашивать «на какой стадии конвейера это происходит?» превращает лекцию из справочника в рабочий инструмент отладки.
43 · Подведём итоги: по каждому механизму — граница и что с ней делать на практике
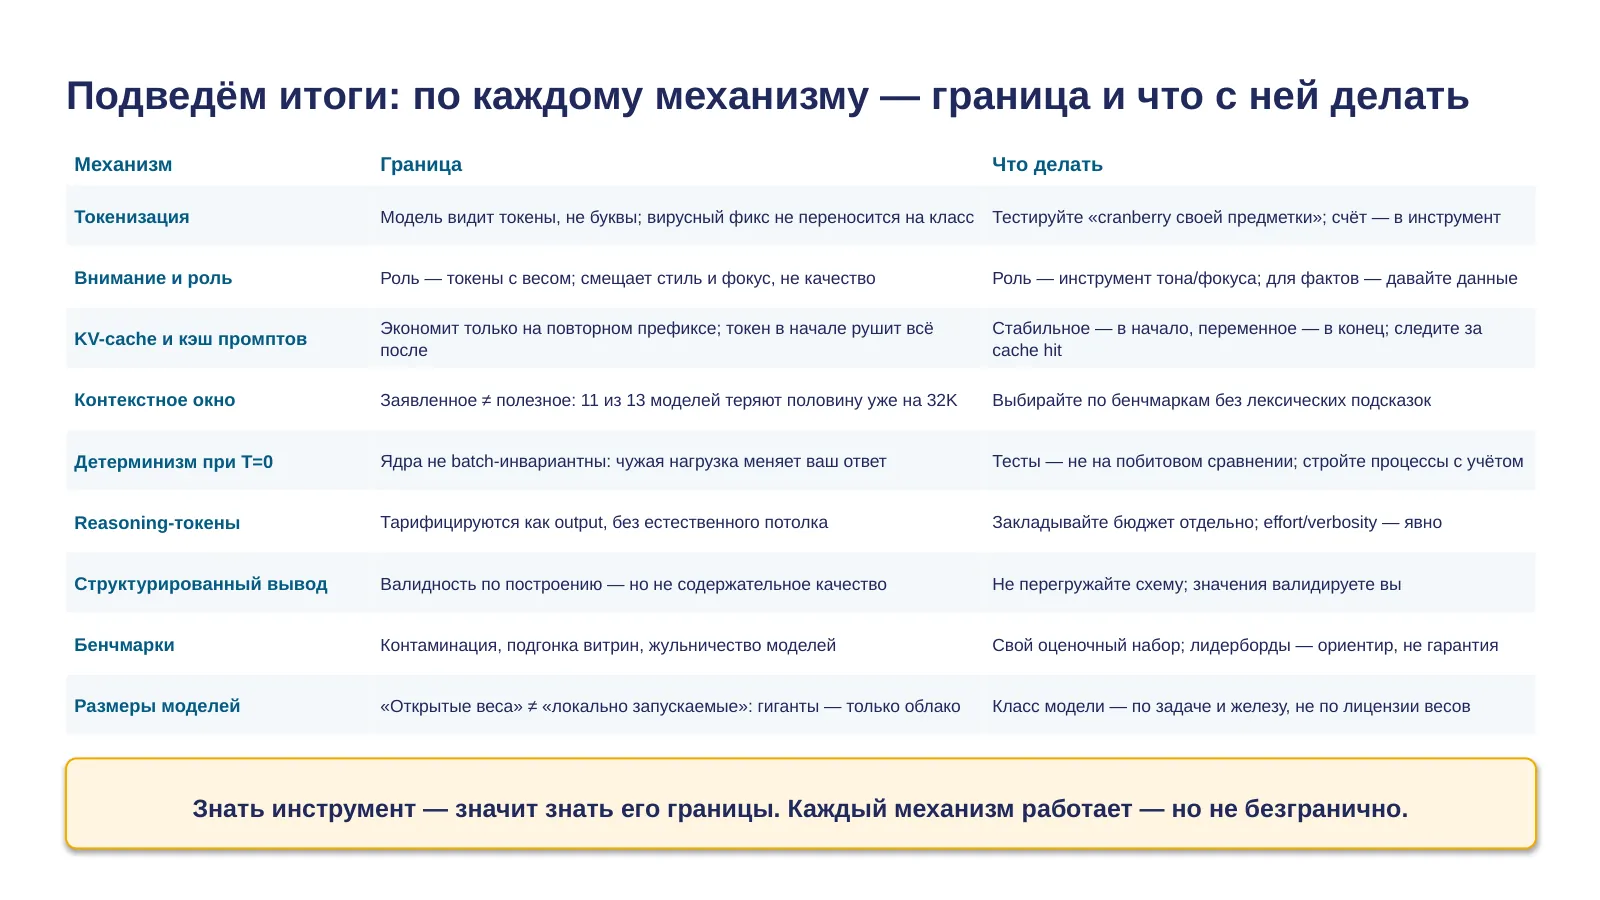
Подведём итоги. За полтора часа мы с вами прошли конвейер инференса от текста до ответа, и на каждой стадии — вместе с механизмом — увидели его границу.
Токенизация: модель видит не буквы, а токены; вирусный фикс на одном слове не переносится на класс задачи. Внимание и роль: роль смещает стиль и фокус ответа, но не повышает фактическое качество. Кэш: KV-кэш и кэш промптов экономят только на совпадающем префиксе. Контекстное окно: цифра в карточке модели — это ёмкость приёма, не гарантия качественного рассуждения на всей длине.
Детерминизм: ноль температуры не даёт побитовой воспроизводимости, потому что вычислительные ядра меняют порядок суммирования в зависимости от чужой нагрузки на сервере. Reasoning-токены оплачиваются как выход и не имеют встроенного потолка объёма. Структурированный вывод гарантирует валидность по построению, но не содержательное качество. Бенчмаркам верить на слово нельзя. И размеры моделей: открытые веса давно не синоним «локально запускаемые».
Общий знаменатель: знать инструмент — значит знать его границы. Каждый из этих механизмов работает и приносит пользу — но не безгранично; и в каждой строке есть точка, где инженер обязан уметь сказать «нет» неподходящему применению. Ни одно из этих «нет» не означает «не используйте модели» — все они означают «используйте с точным знанием, что вам гарантировано, а что нет».
Самопроверка на минуту: закройте таблицу и восстановите для любых трёх строк пару «граница → что делать». Если получается — главное содержание лекции у вас с собой.
44 · LLM — не всегда правильный инструмент; а когда правильный — не всегда нужна топовая
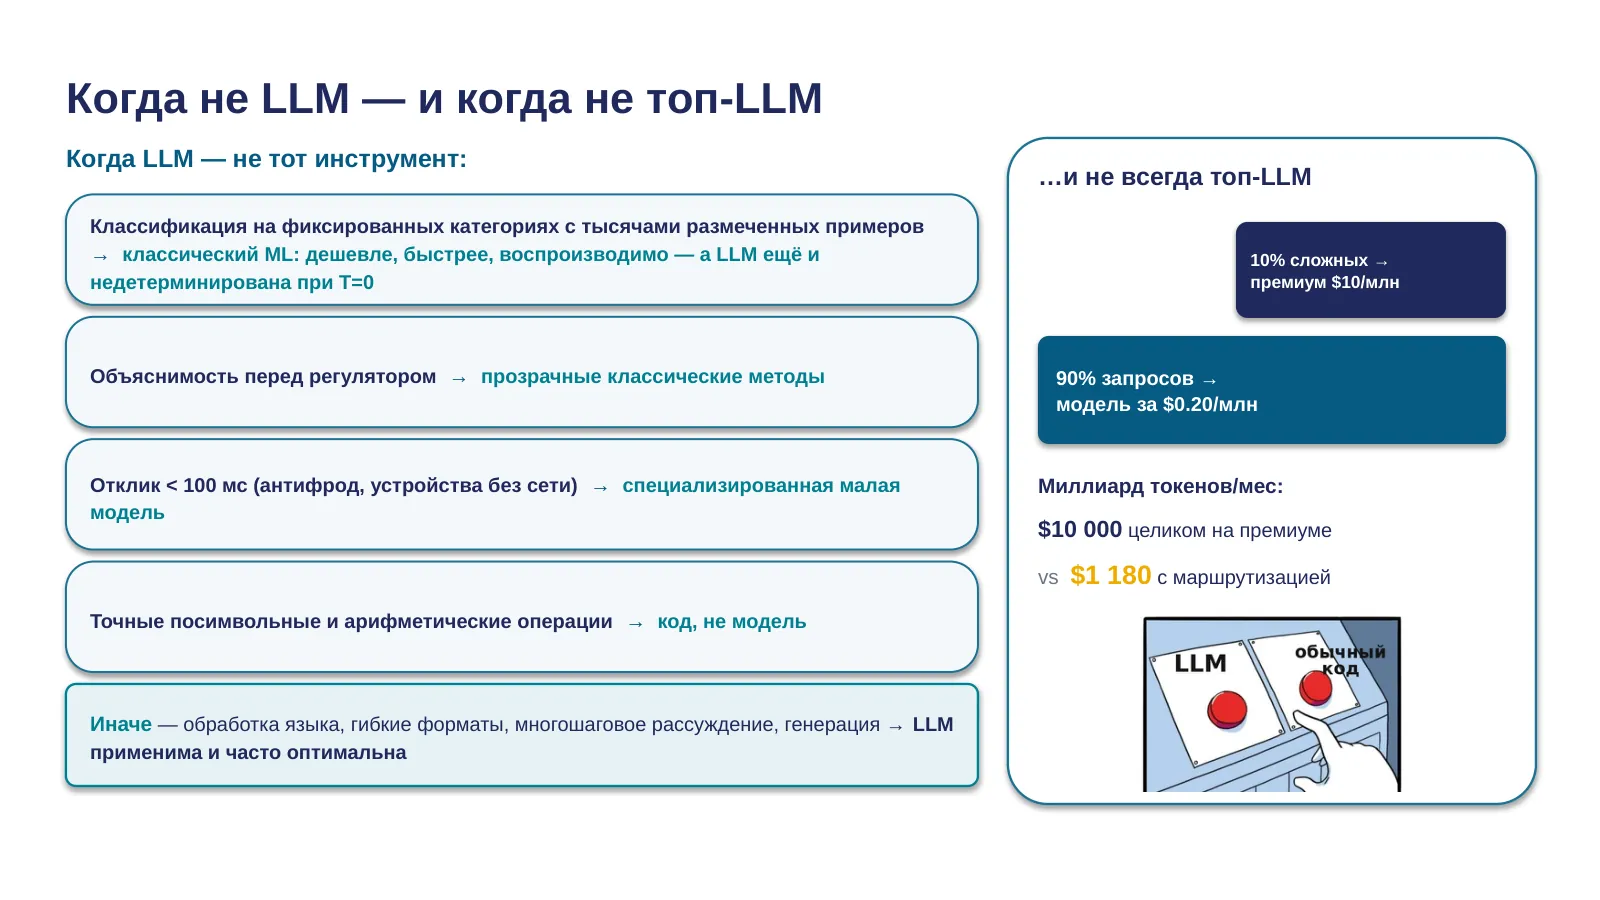
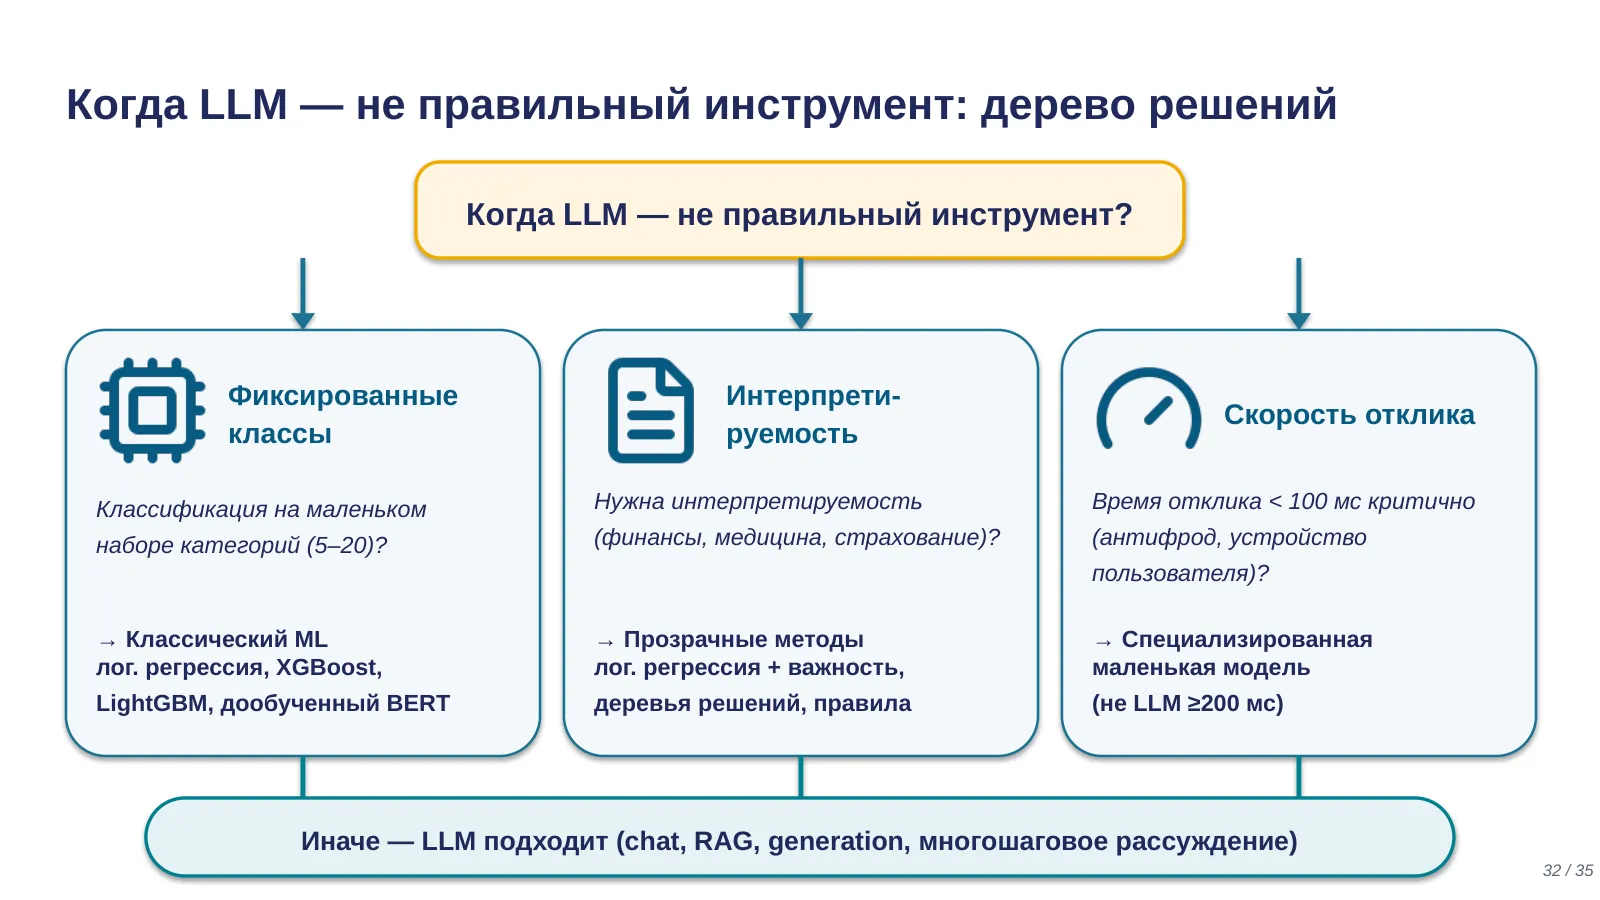
Знание внутренностей нужно и для того, чтобы видеть, где LLM — не тот инструмент. Классификация с тысячами размеченных примеров — классический ML: дешевле, быстрее, воспроизводимо, а LLM ещё и недетерминирована при T=0. Объяснимость перед регулятором — прозрачные методы. Отклик меньше ста миллисекунд — малая модель. Точная арифметика — код, не модель. В остальном — LLM применима и часто оптимальна.
Новый уровень 2026 года: выбор внутри класса LLM перестал сводиться к «берём самую сильную». Рабочий паттерн — лестница эскалации: простые запросы в дешёвую модель, сложные — в дорогую. Арифметика: миллиард токенов в месяц целиком на премиуме — десять тысяч долларов; с маршрутизацией девяносто на десять — около тысячи ста восьмидесяти, почти на порядок меньше. Новой была только привычка считать.
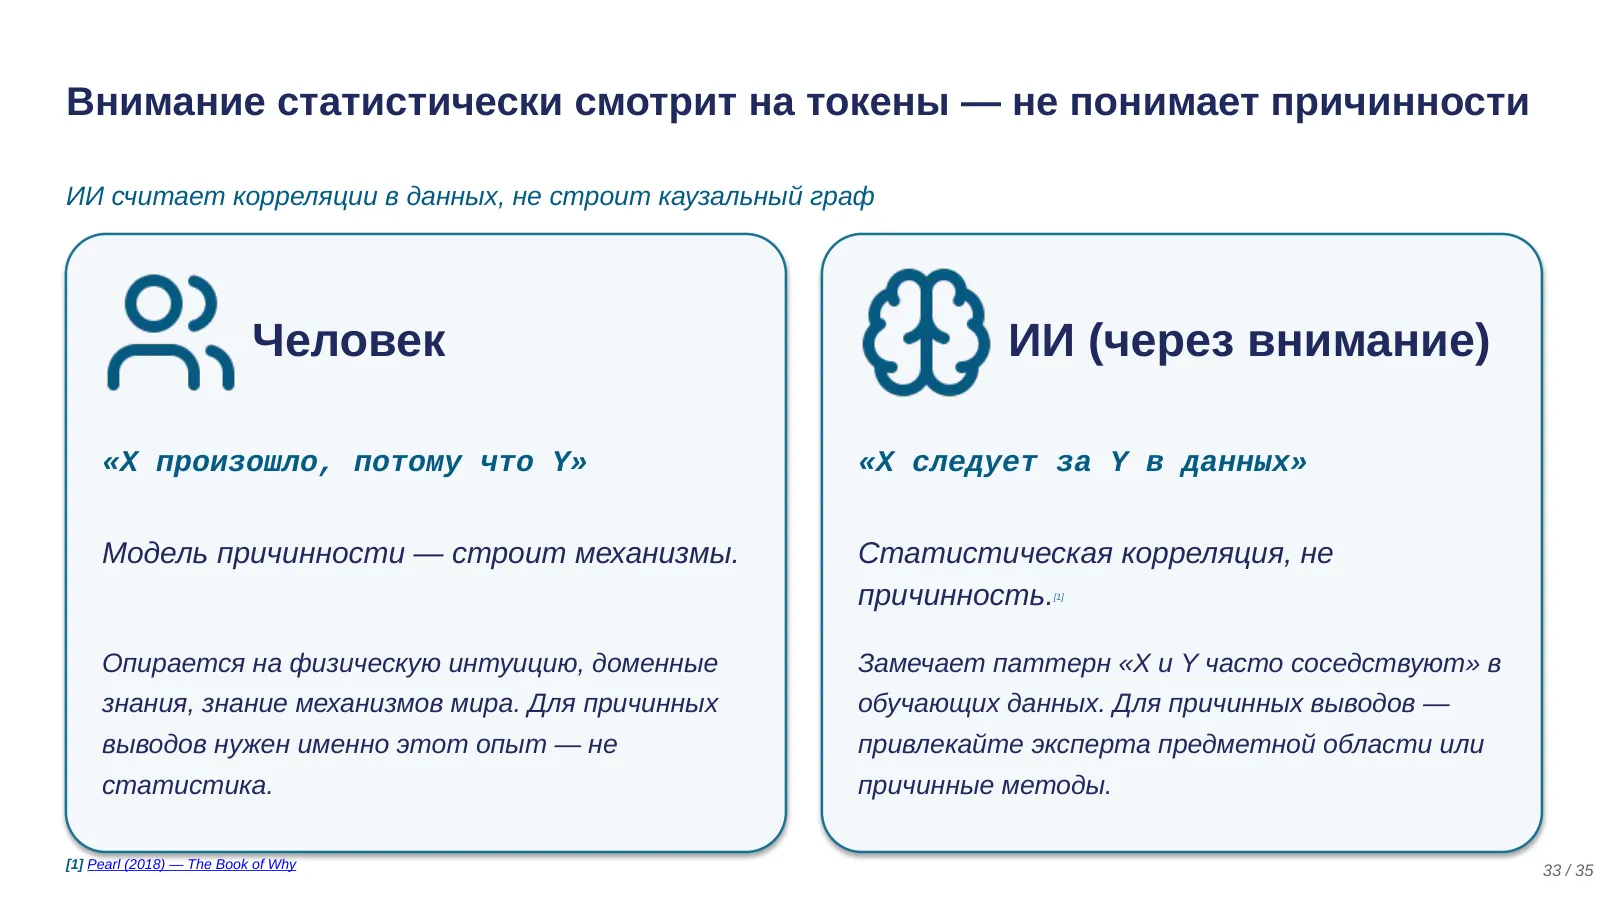
45 · Внимание — взвешивание по статистике совместной встречаемости: корреляция, не причинность
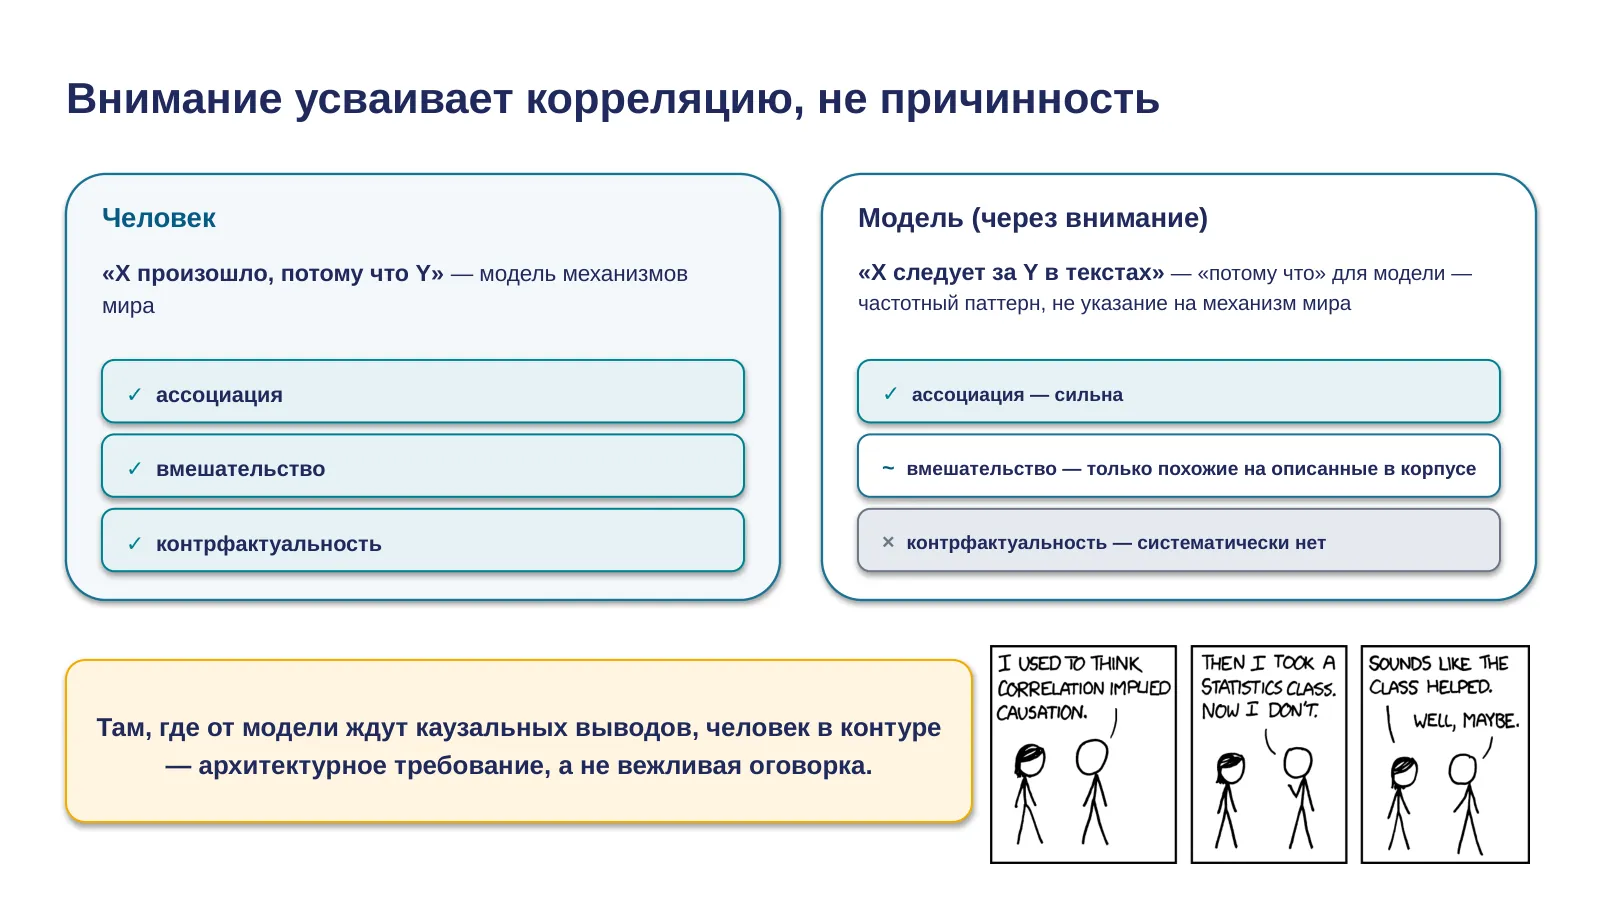
Последняя граница — концептуальная, возврат к трём уровням причинности Пе́рла из первой лекции. У тезиса «модель работает на уровне ассоциаций» есть механистическое основание: внимание — это взвешивание по статистике совместной встречаемости. «Потому что» для модели — частотный паттерн текстов, не указание на механизм мира. Модель усваивает корреляцию, не причинность.
Профиль воспроизводим: модель сильна в «что с чем связано»; частично справляется с «что будет, если изменить X»; и систематически несостоятельна в «что было бы, если бы X не случилось». Это свойство механизма, не временный недостаток.
Модель, которой скормили логи инцидента, строит связный нарратив «после деплоя X начались таймауты Y» — и опасность в том, что нарратив читается как каузальный вывод, а является статистически правдоподобным рассказом. Проверка гипотезы остаётся за инженером; человек в контуре — архитектурное требование, не оговорка.
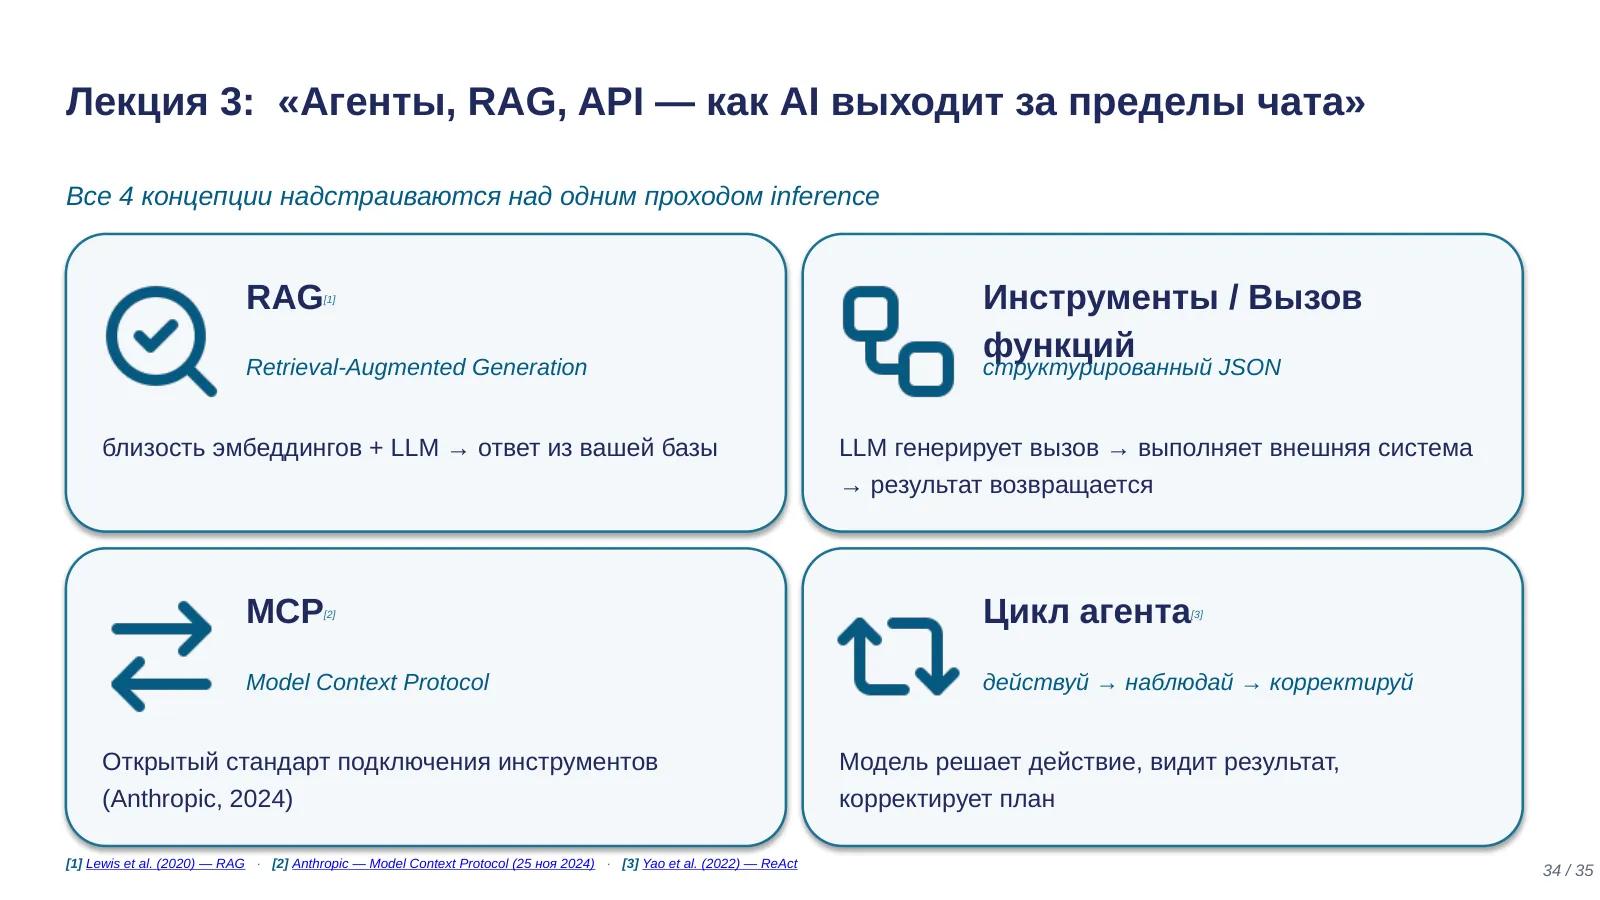
46 · Лекция 3 — как модель выходит за пределы контекста: RAG, инструменты, MCP, агентный цикл
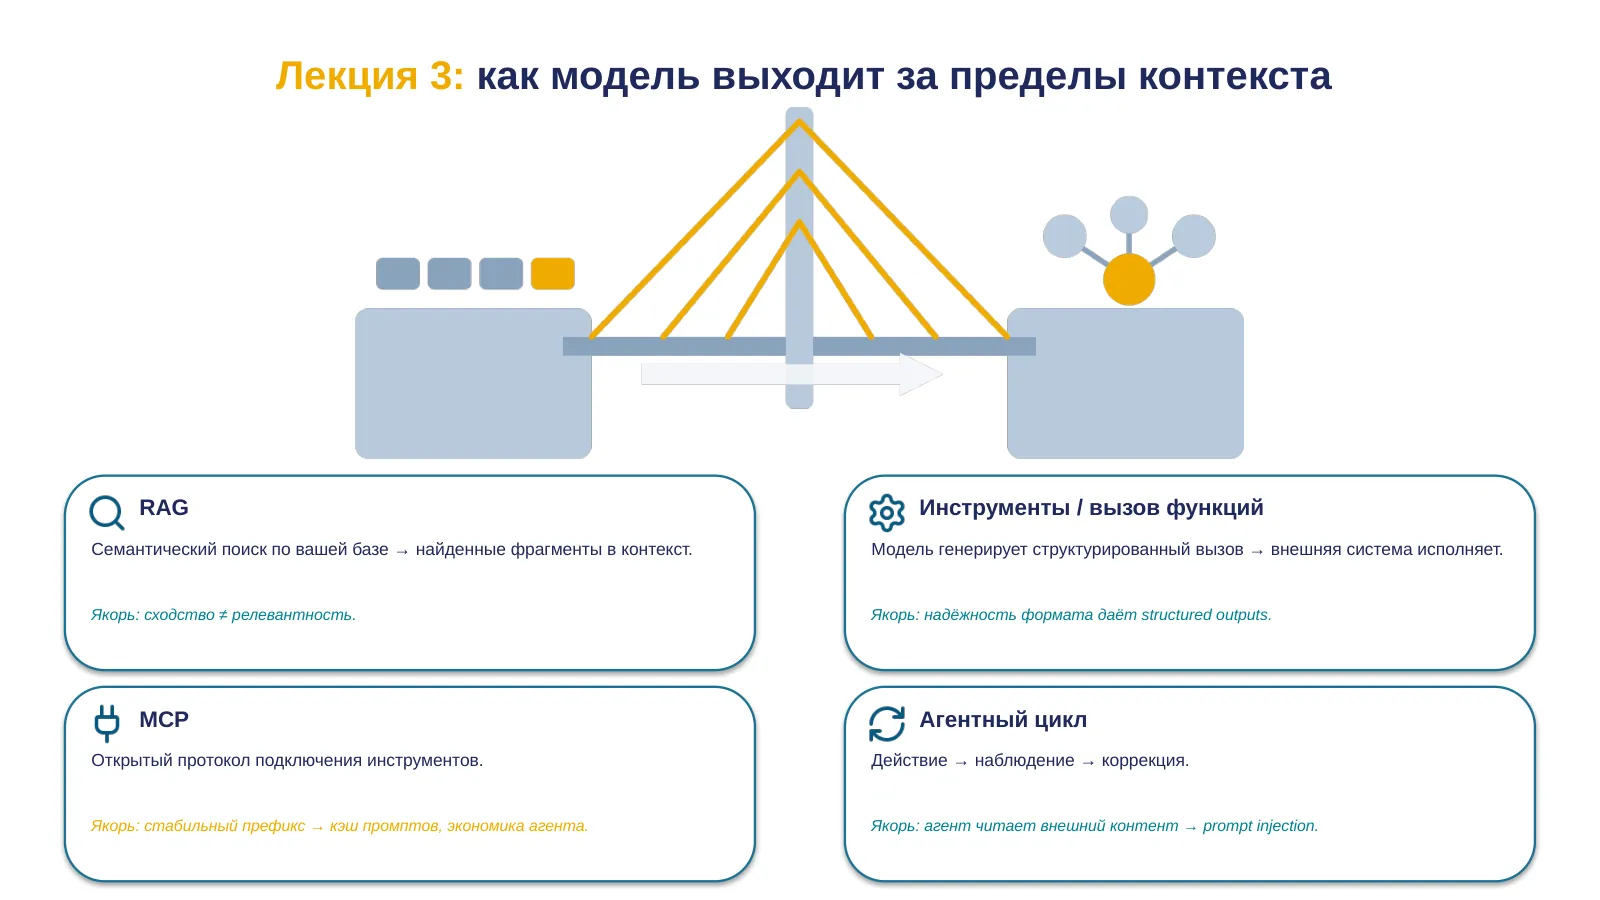
У собранного конвейера есть жёсткая граница: модель видит только контекст и не может выйти за него. Следующая лекция — про агентов, RAG и API — про то, как эта граница преодолевается: семантический поиск по базе знаний, надстройка над эмбеддингами; вызов инструментов, где надёжность формата обеспечивает структурированный вывод; протокол MCP; и агентный цикл «действие — наблюдение — коррекция».
Четыре якоря из сегодняшней лекции. Инструкции для модели — те же токены с весом внимания, а агент читает внешний контент — значит, prompt injection не экзотика; подробный разбор — в следующей лекции. Сходство не равно релевантности — причина, по которой наивный поиск разочаровывает. Экономика агента строится на кэшировании промптов. Каждый шаг цикла тащит невидимые токены рассуждения — бюджет без их учёта ошибается в разы.
До следующей встречи — четыре эксперимента на десять-двадцать минут каждый: подсчёт букв на трёх моделях; десять запусков при T=0 с побайтовым сравнением; сходство пары «настроить SSL — отключить SSL»; аудит своего проекта — работает ли кэш. Результаты понадобятся в разговоре про агентов.
47 · Q&A
Основная часть лекции закончена. Короткое напоминание о живых экспериментах: подсчёт букв в cranberry, сравнение ответов при T=0 и T=1.5. Каждый воспроизводится дома за десять минут — надёжный способ проверить, что механизмы остались в руках, а не только в конспекте.
Оставшееся время — вопросам: нет «слишком базовых» — если картинка одной из стадий не сложилась, лучше спросить сейчас.
Если вопросов немного, пройдусь по сводной таблице и спрошу, какая граница показалась наименее убедительной. Если тишина — напомню про домашние эксперименты к семинару: подсчёт букв, запуски при T=0, косинусные сходства, аудит кэша своего проекта.
Спасибо за внимание. До следующей встречи.