Семинар 4. Сборка кодинг-агента: день-0 база или жди сигнала
Семинар 4 · ~86 мин · 57 слайдов
01 · Конфигурация агента — набор решений, которые принимаются по ходу работы над проектом: часть окупается с первого дня, часть нельзя принять заранее
«Стандартный способ настроить агента на новом проекте — открыть репозиторий, который выглядит зрелым, и перенести к себе его конфигурацию: файл инструкций на триста строк, десяток скиллов, несколько подключённых серверов. Часть этого — универсальная инженерная гигиена, которая окупается на любом проекте. Часть — решения под чужой репозиторий, принятые по сигналам, которых в вашем не было.
Сегодня мы разбираем это не в общем виде, а на одном проекте от начала: берём задачу от заказчика, фиксируем требования, поднимаем репозиторий, получаем работающий прототип — и дальше, по ходу обычной работы, шесть раз упираемся в развилку «записать это в конфигурацию агента или нет».
Вопрос занятия: что стоит закладывать сразу, на день 0, а что нельзя знать заранее, потому что оно специфично для вашего проекта?»
Дальше — сразу к задаче, без паузы.
02 · Задача приходит в формулировке заказчика: что должно получиться — есть, устройства кода, критериев готовности и границ действий — нет
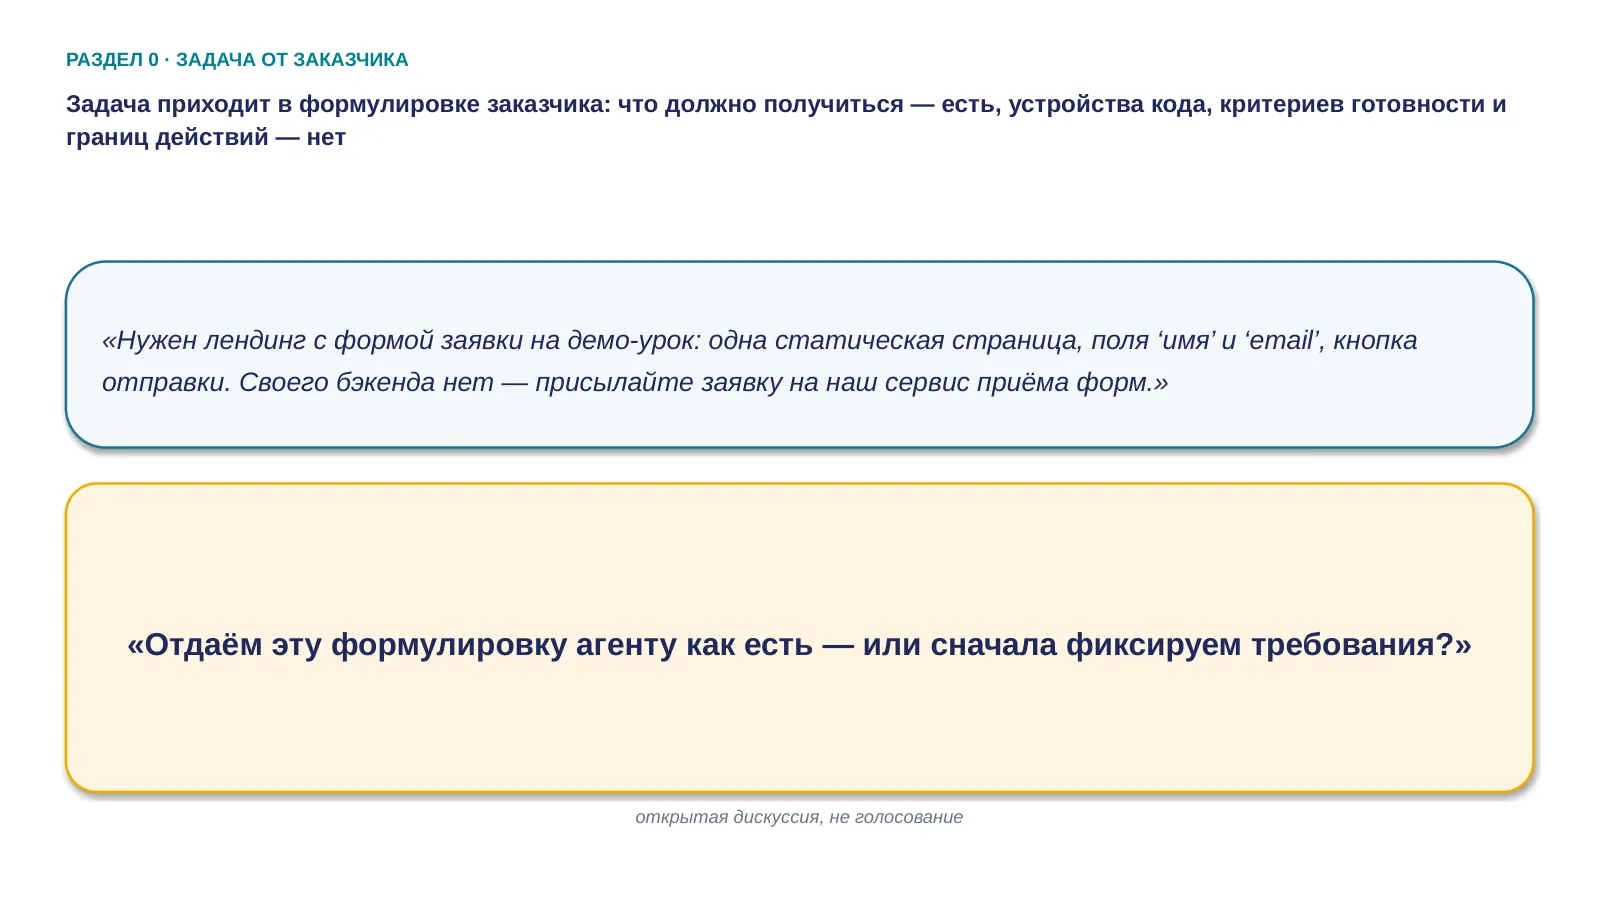
«Вот задача в том виде, в каком она приходит: что должно получиться — сказано, как это устроено внутри, что считается сделанным и чего делать нельзя — не сказано. С этим текстом вы садитесь за работу.»
Открытый вопрос: «Отдаём эту формулировку агенту как есть — или сначала фиксируем требования?»
Формат — дискуссия, 2–3 голоса, аргументы собираются, а не оцениваются. Разброс обычно предсказуемый: одни отдают как есть и дожимают по ходу, другие сначала дописывают формулировку. Обе позиции рабочие, и смысл шага в том, чтобы это прозвучало вслух.
Если разговор уходит в архитектуру («а нужен ли тут вообще бэкенд») — зафиксировать как отдельный вопрос и идти дальше.
Мостик: «Дать можно — агент разберётся с тем, что написано. Вопрос в том, с чем он останется, если написано мало. Зафиксируем требования.»
03 · Требования раскладываются на функциональные и нефункциональные и ложатся в spec.md первым коммитом; README описывает устройство репозитория и заводится тем же коммитом
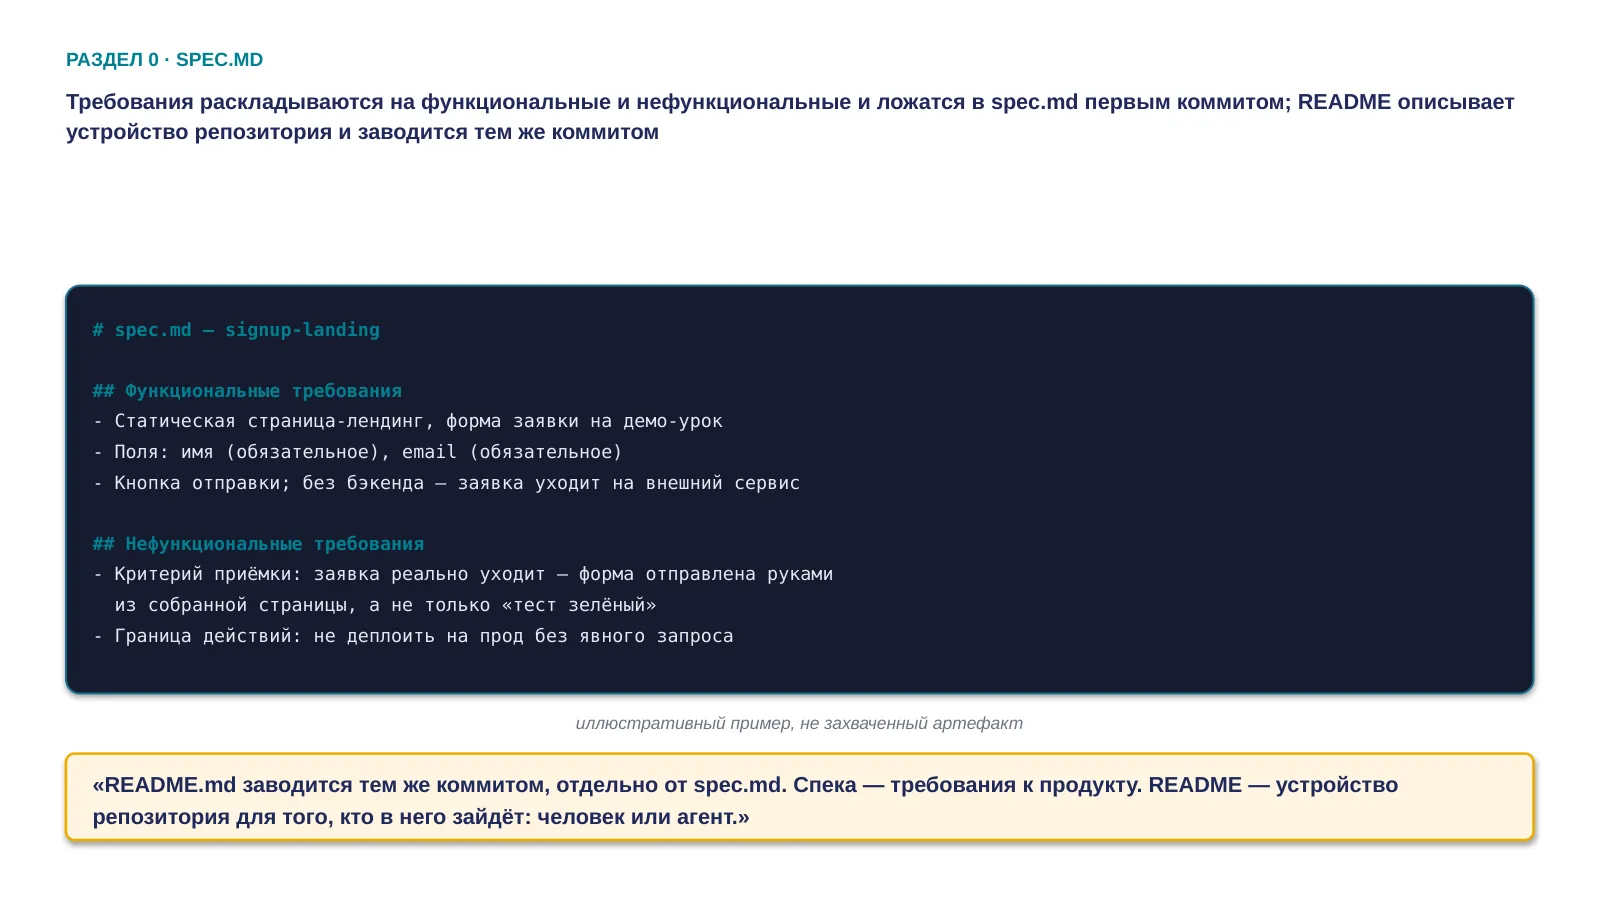
«Первые десять минут работы над проектом уходят не на код. Формулировку заказчика раскладываем на функциональные требования — что должно быть, — и нефункциональные — какими свойствами это должно обладать, — и кладём в spec.md первым коммитом.
Отдельно стоит посмотреть на строку «критерий приёмки». Заказчик её не произносил, она выведена нами: без неё «готово» ничем не отличается от «тест зелёный», а это разные утверждения о системе.
Тем же коммитом заводится README.md. Спека отвечает на вопрос, что должно получиться; README — на вопрос, как устроен репозиторий. Разделение практическое: два разных читателя, два разных срока жизни. Требования меняются по договорённости с заказчиком, устройство репозитория — по мере рефакторингов.
Теперь задача агенту формулируется иначе: не «собери лендинг с формой», а «вот spec.md, инициализируй репозиторий и собери проект по нему».»
04 · Агент собрал работающий прототип по спеке без единого уточняющего вопроса — и структуру репозитория при этом выбрал сам, потому что spec.md её не описывает
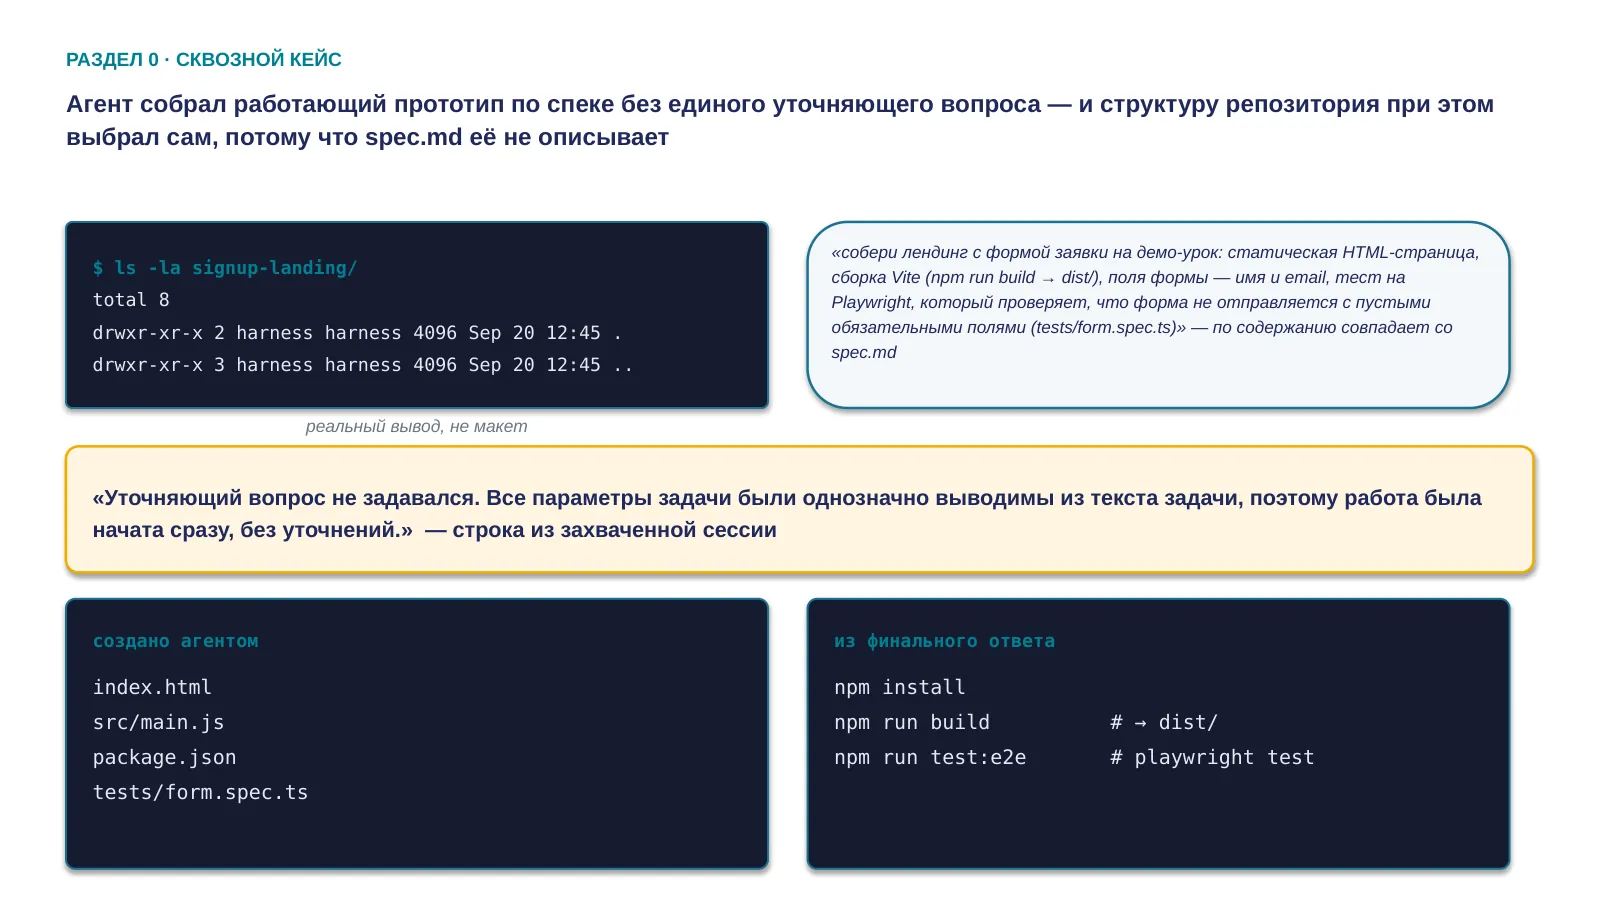
«Директория пустая — это реальный вывод команды до прогона. Дальше агент получает задачу по спеке и за один проход отдаёт собранный проект: разметка, обработчик формы, манифест пакета со скриптами сборки и теста, тест на Playwright. Прототип рабочий — команды из его финального ответа отрабатывают.
Уточняющих вопросов не было ни одного; в захваченной сессии это зафиксировано прямо: все параметры задачи выводились из текста.
И здесь стоит остановиться на том, чего в этом тексте не было. Критерий приёмки был — мы записали его в спеку сами. А вот структура: как назвать файлы, где разместить обработчик, как разложить проект по папкам — в спеке этого нет и быть не должно, это устройство кода, а не требование к продукту. Эти решения агент принял сам и молча: src/main.js, tests/form.spec.ts, скрипты в package.json.
Прототип есть. Дальше с этим репозиторием предстоит работать не один день — и вот здесь начинается вопрос о конфигурации агента.»
05 · Настраивая агента в новом репозитории, каждый работает в одном из двух режимов — заложить базу сразу или дождаться реальной проблемы
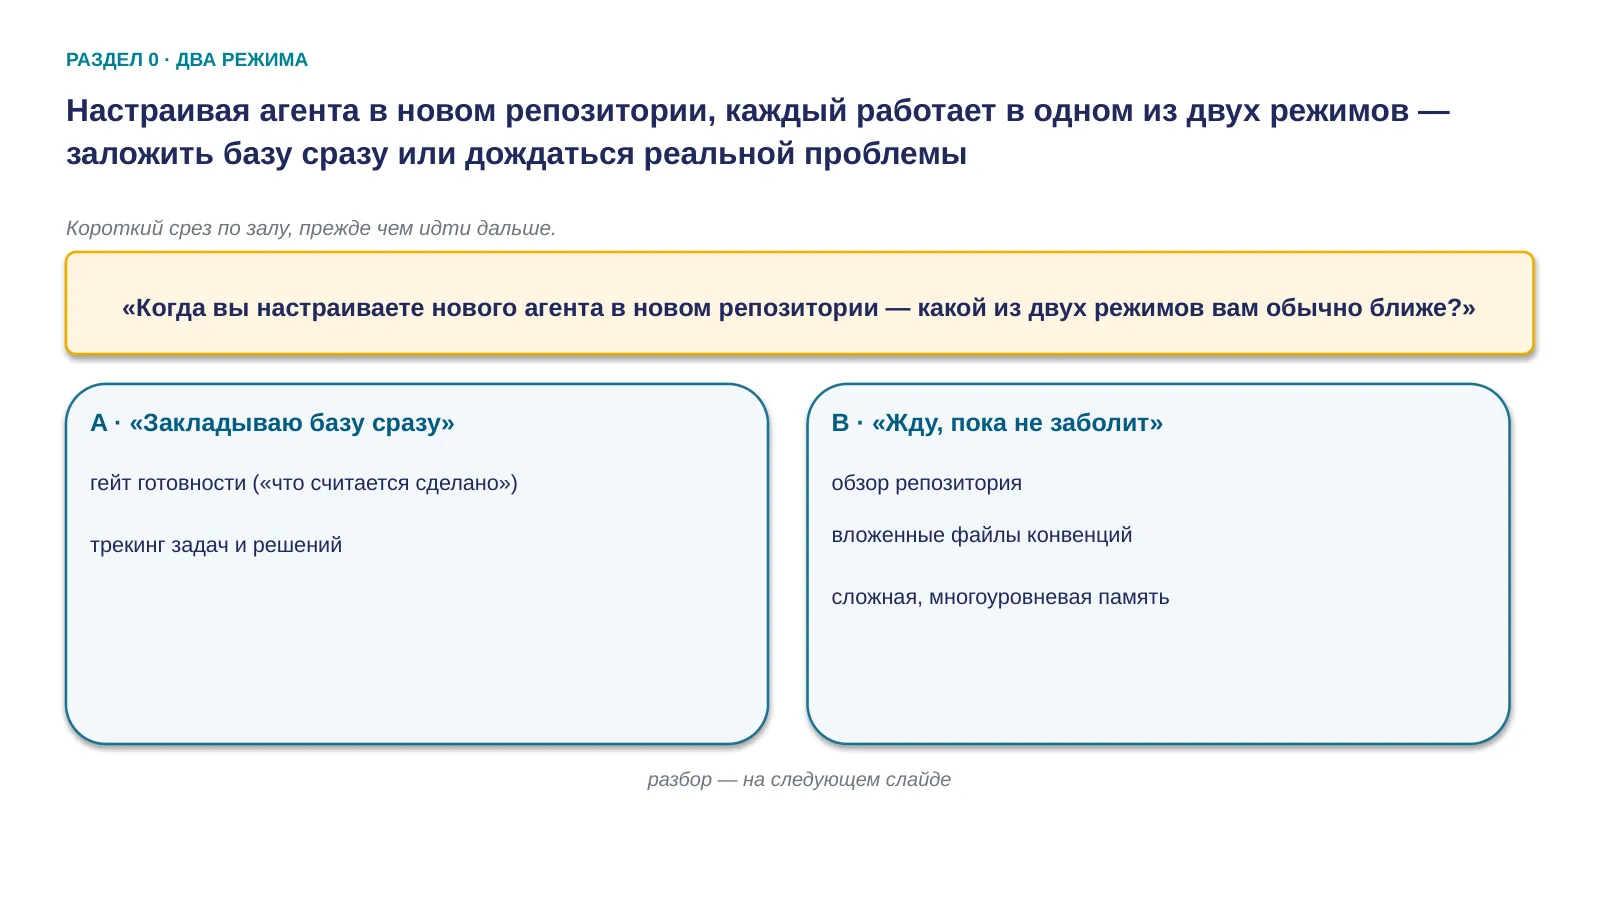
Два голоса, ответы фиксируются вслух и не комментируются: разбор идёт следующим слайдом.
Запасная формулировка при молчании зала: «Иначе: вот список — гейт готовности, лог решений, обзор репозитория, вложенные файлы, сложная память. Что из этого вы заводите в первый день, а что откладываете до реальной проблемы?»
06 · Оба режима рабочие — вопрос в том, к какому типу решения они применяются: специфичное для проекта ждёт сигнала, универсальная гигиена заводится сразу
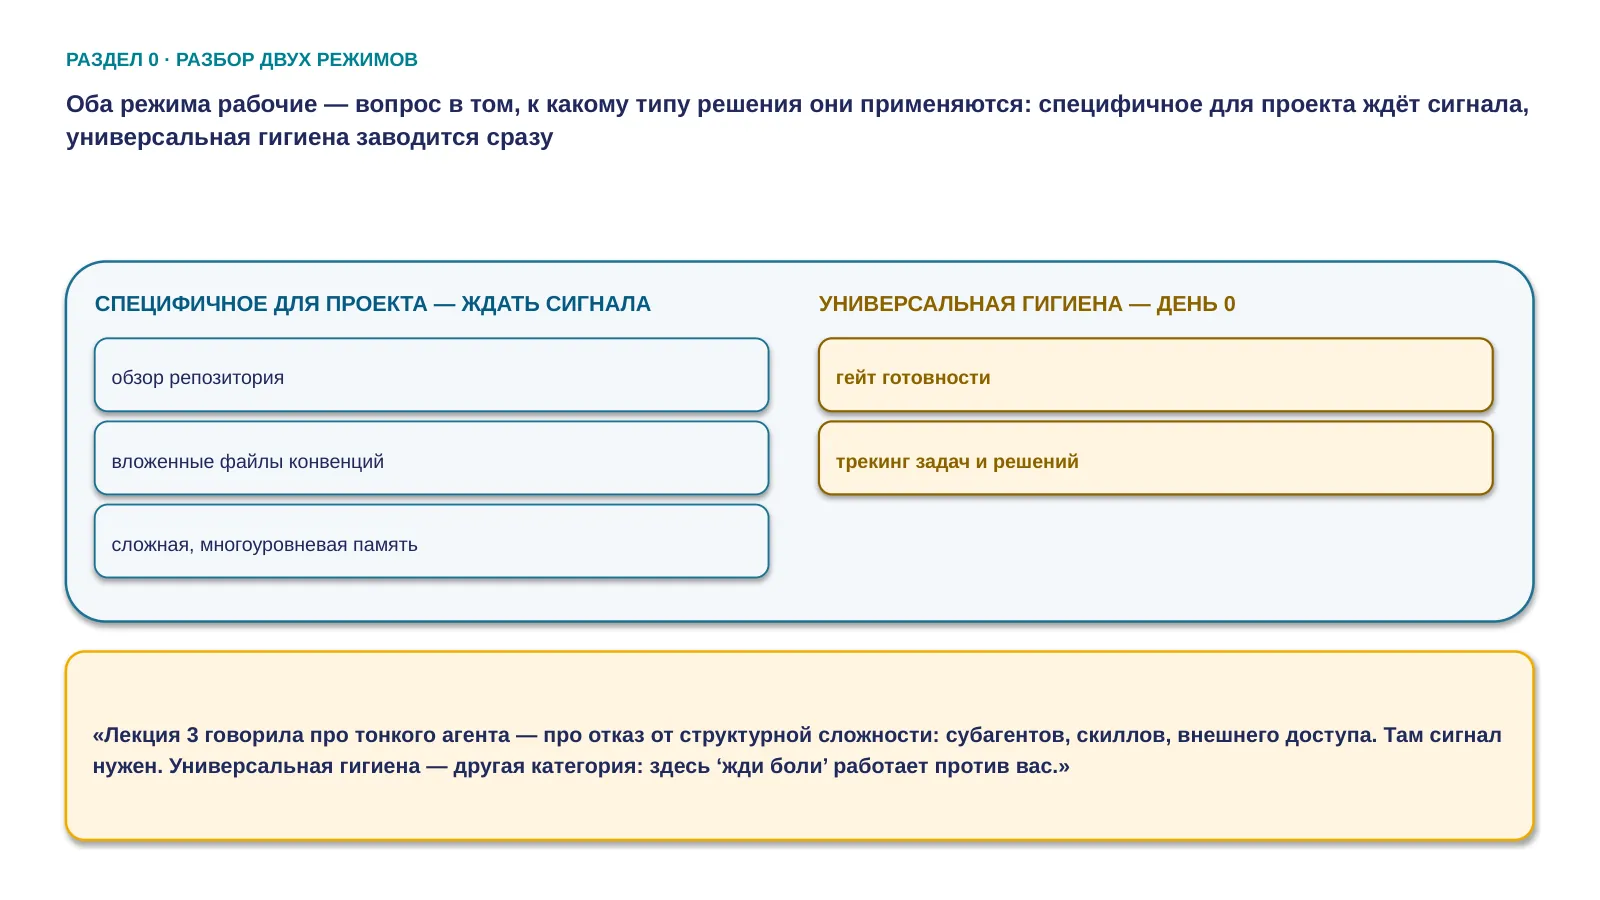
«Единого правильного режима нет — есть два типа решений с разной ценой ошибки.
Первый тип — специфичное для проекта. Понадобится ли это именно здесь, заранее неизвестно: ответ зависит от конкретного репозитория. Обзор структуры, вложенные файлы конвенций, многоуровневая память — сюда. Ждать реального сигнала здесь не лень, а нормальная инженерная практика: пока сигнала нет, записывать нечего.
Второй тип — универсальная гигиена. Завести дёшево, а цена отсутствия непредсказуема: неизвестно, в какой момент она понадобится и что к этому моменту будет потеряно. Гейт готовности, трекинг задач и решений — сюда. Сигнала здесь можно и не дождаться: недостача проявляется постфактум, а не одним явным событием.
Отдельно — чтобы не смешивать с Лекцией 3. Тезис про тонкого агента был про структурную сложность: субагенты, скиллы, внешний доступ. Он в силе и по-прежнему требует сигнала. Универсальная гигиена — другой класс решений.
Дальше в проекте нас ждут шесть развилок. К какому типу относится каждая — решаем по ходу, на месте.»
07 · Кроме спеки и README в репозиторий в тот же день кладётся ещё три вещи — ни одна из них не ждала сигнала
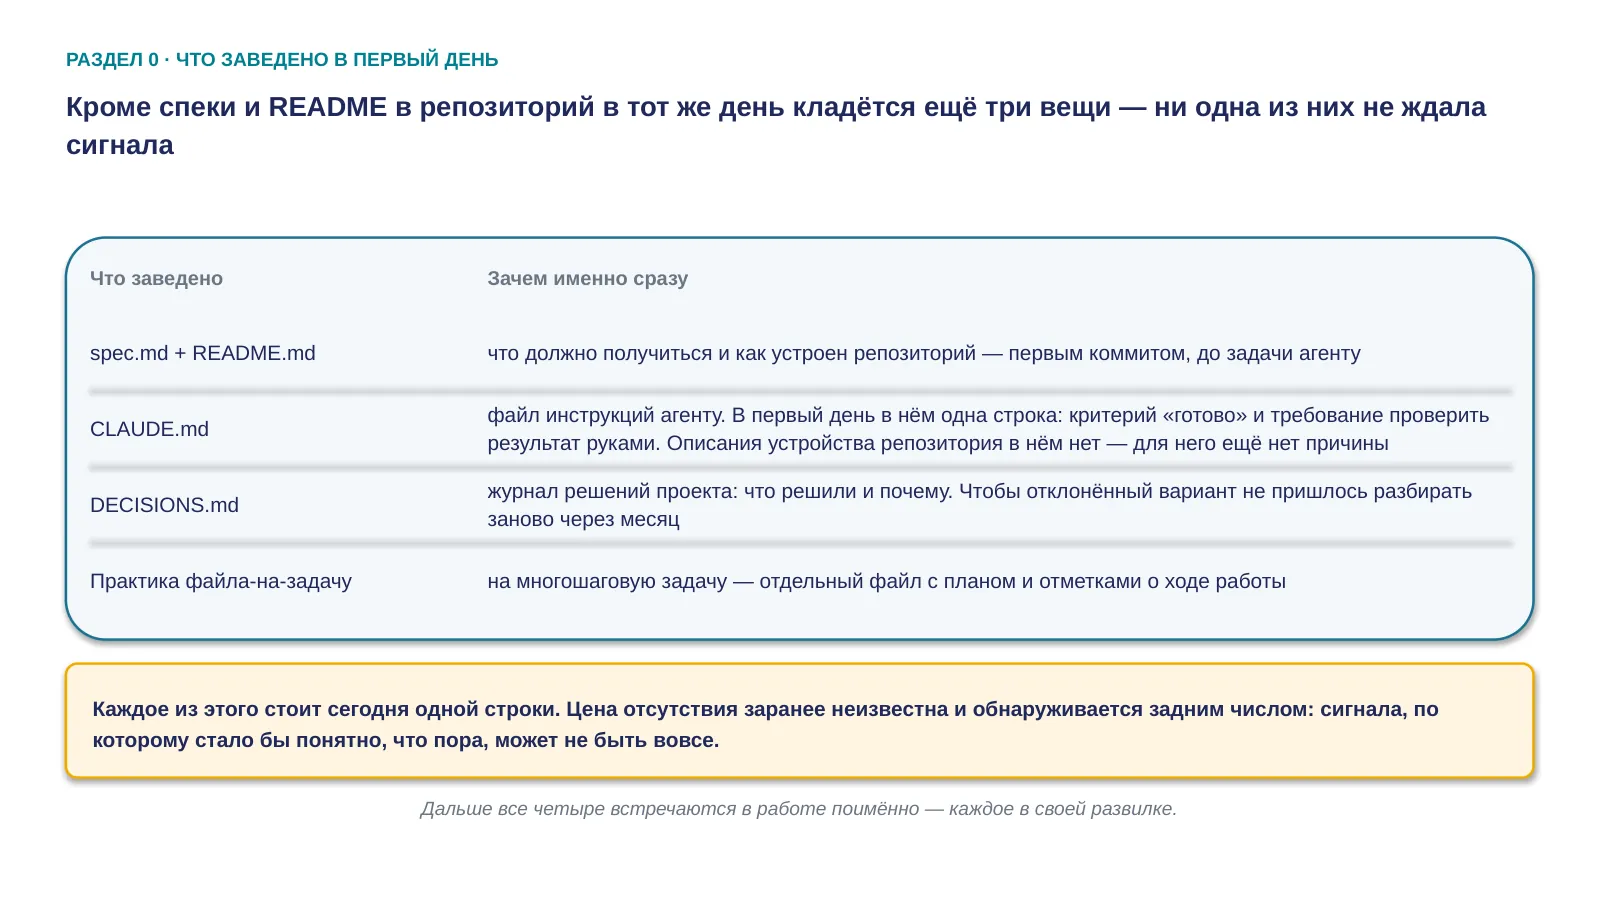
«Прежде чем идти дальше — что в этом репозитории появилось в первый день, кроме кода.
Спека и README — их мы уже видели, они легли первым коммитом. Тем же днём заводится CLAUDE.md, файл инструкций агенту. В нём пока одна строка: что считается «готово» и требование проверить результат руками. Описания устройства репозитория в нём нет — для него ещё нет причины. Заводится DECISIONS.md, журнал решений: что решили и почему. И заводится практика файла на задачу — на каждую многошаговую работу отдельный файл с планом и отметками.
Ни одно из этого не ждало сигнала, и вот почему. Каждое стоит сегодня одной строки. А цена отсутствия заранее неизвестна и всплывает задним числом: сигнала, по которому стало бы ясно, что пора, может не быть вовсе — узнаёшь в тот момент, когда искать уже поздно.
Дальше все четыре встретятся в работе поимённо, каждое в своей развилке.»
08 · Конфигурация агента раскладывается на пять слотов; сегодняшний проект задействует два — инструкции-правила и память
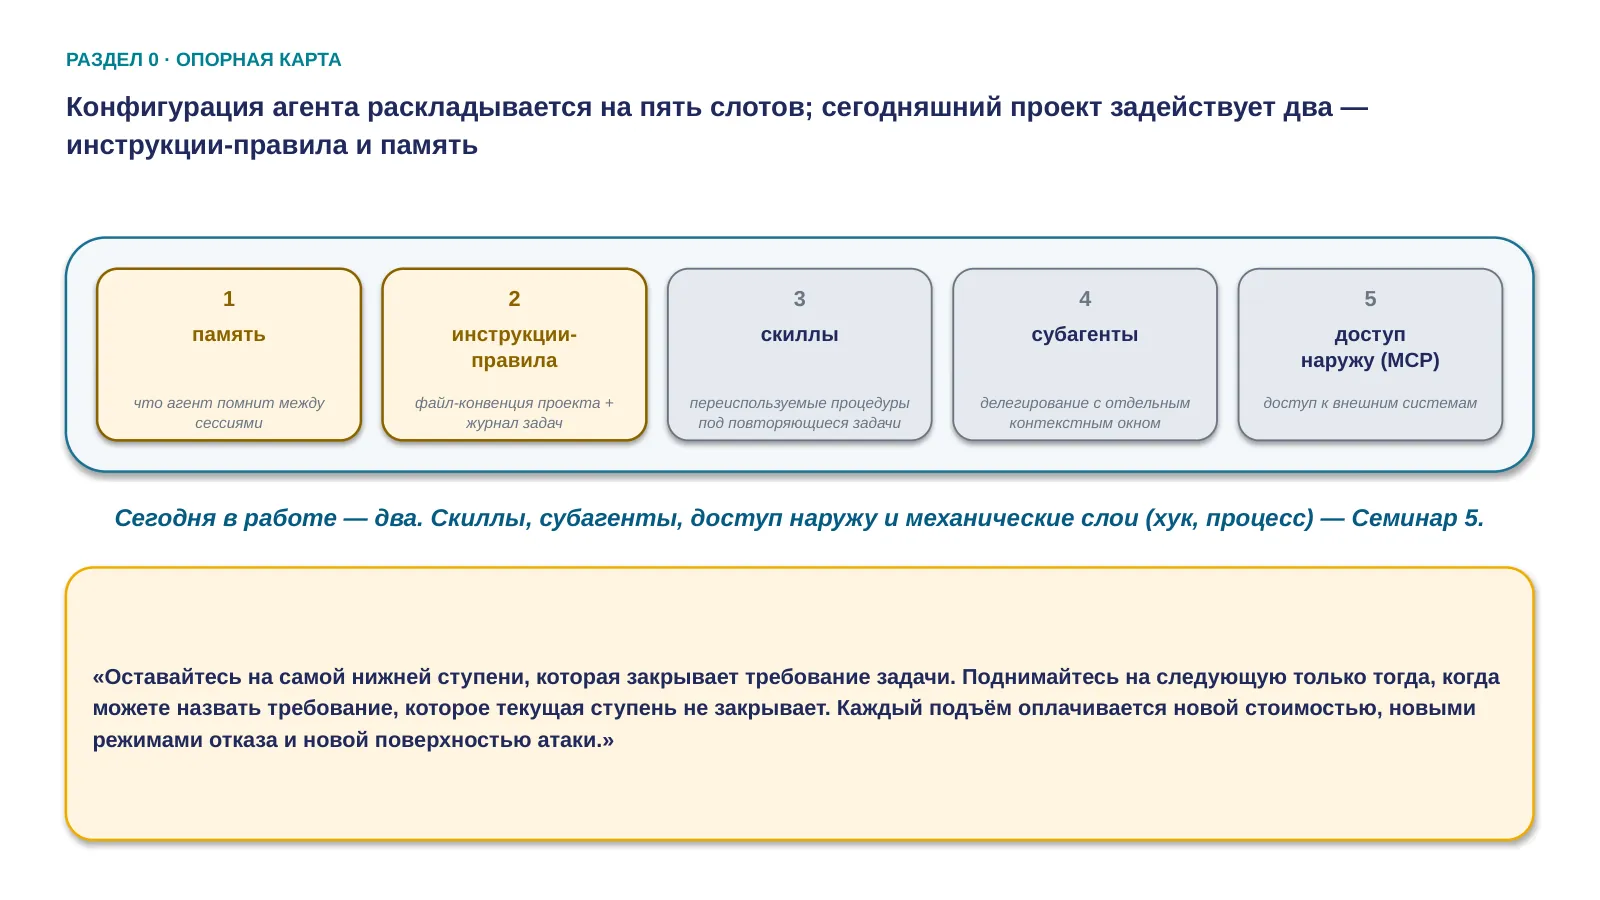
Слайд начинается пустым: пять пустых слотов в ряд. Слоты не читаются с экрана — зал достаёт их из памяти, они разбирались на Лекции 3.
Реплика-заход: «На Лекции 3 мы разбирали, из чего собран агент-помощник поверх цикла «планируй → действуй → проверяй → повторяй». В конспекте это называется харнесс — Harness, а слоты подписаны английскими Skills, Subagents, Access/MCP. Дальше на слайдах и в разговоре — по-русски. Слотов пять. Назовите те, что помните.»
Проявлять по одному, с одной репликой на каждый: память — «не контекст текущего разговора, а то, что переживает конец сессии»; инструкции-правила — «то, что пишете вы и что грузится в начало каждой сессии»; скиллы — «методичка, которую снимают с полки, а не регламент на столе»; субагенты — «отдельный исполнитель с чистым контекстом»; доступ наружу — «каждое подключение — новая граница доверия». Слот, который зал не назвал, назвать самому и идти дальше.
Дальше — одной фразой: «В сегодняшнем проекте работают два слота: инструкции-правила и память. Остальные три и механические слои — хук и процесс — отдельным занятием, Семинаром 5.»
Правило лестницы — дословно, под картой: «Оставайтесь на самой нижней ступени, которая закрывает требование задачи. Поднимайтесь на следующую только тогда, когда можете назвать требование, которое текущая ступень не закрывает. Каждый подъём оплачивается новой стоимостью, новыми режимами отказа и новой поверхностью атаки.»
Мостик: «Вернёмся в репозиторий. Прототип собран, дальше с ним работать не один день — и первое решение по конфигурации агента принимается прямо сейчас.»
09 · Раздел 1 — файл инструкций: три развилки про один и тот же файл, в том порядке, в котором они встречаются в работе над проектом
Переход одной фразой: «Файл инструкций проекта — CLAUDE.md, он же AGENTS.md. За сегодняшний проект он трижды окажется предметом решения: чего в него не писать, что в него записать и где какому знанию жить. Три развилки идут в том порядке, в каком встречаются в работе.»
10 · Кейс 1.1 — роль агента и общее описание репозитория: чем заполняется пустой файл инструкций, когда за плечами один прогон
Переход одной фразой: «В репозитории signup-landing есть продуктовый код, спека и README. Конфигурации агента — ноль строк. Первая развилка: чем заполняется пустой CLAUDE.md.»
11 · Прототип собран, следующая сессия будет завтра — в CLAUDE.md уже есть строка гейта готовности, остальное пусто, а стандартный первый раздел такого файла называется «Repository overview»
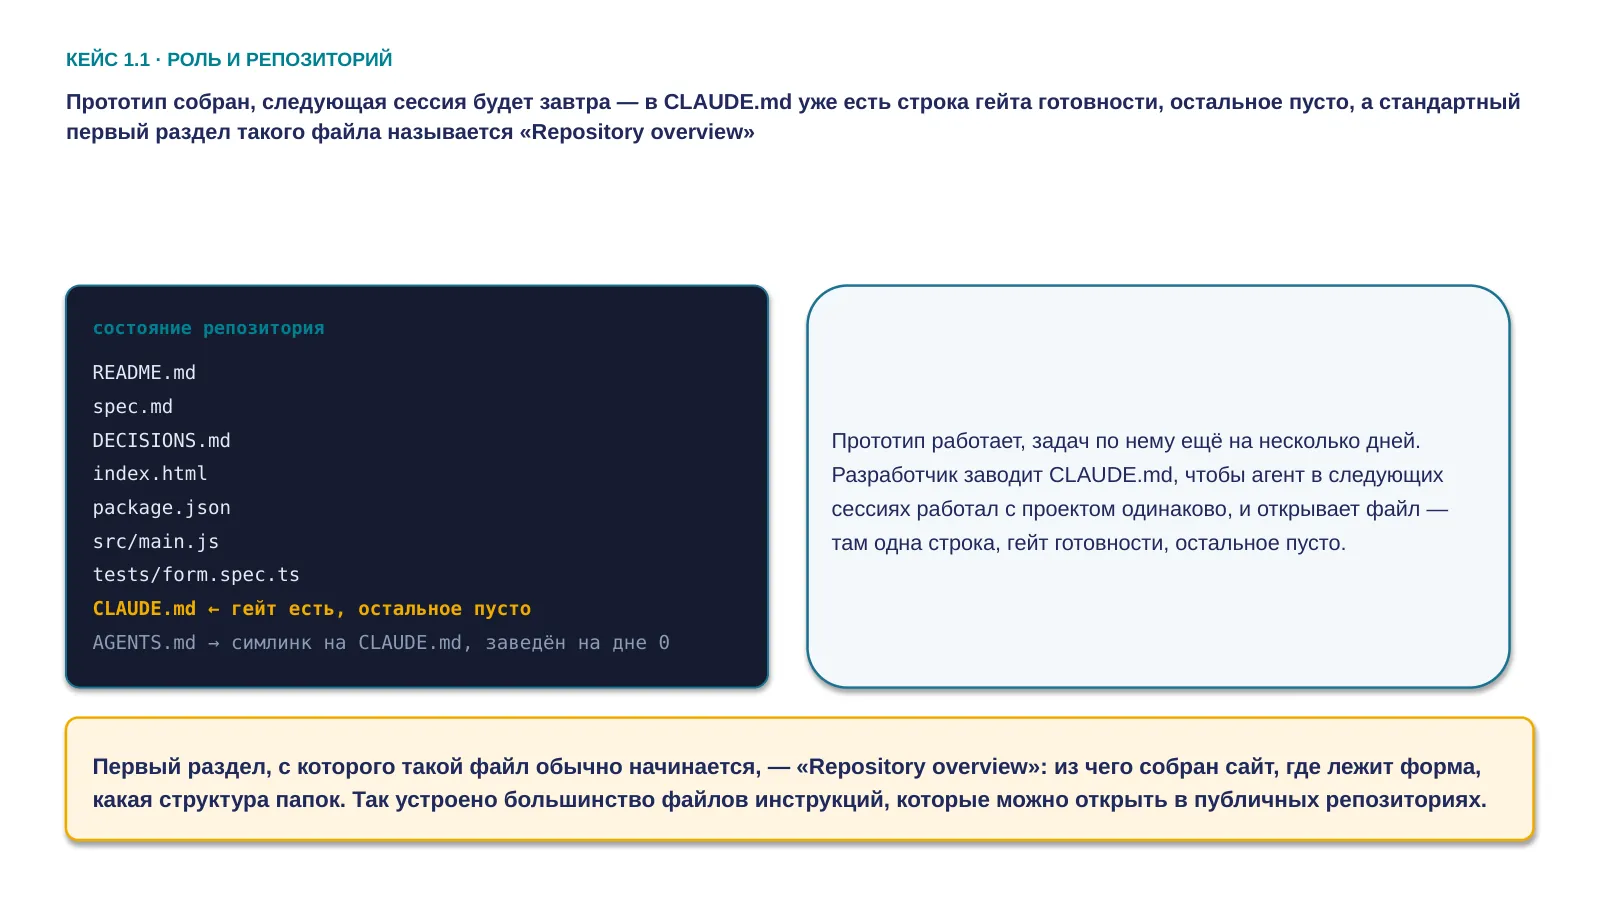
«Прототип собран, но работа не закончена: впереди ещё несколько дней задач по этому же репозиторию, и каждая — новая сессия агента с нуля. Разработчик заводит CLAUDE.md — файл, который грузится в начало каждой сессии, — и открывает файл: там одна строка, гейт готовности, остальное пусто.
Откроете почти любой публичный репозиторий с таким файлом — он начинается с раздела «Repository overview»: что это за проект, как устроен, где что лежит. Это сложившаяся конвенция, и вопрос первой развилки ровно про неё: что из этого имеет смысл записать здесь, в этом репозитории, на этом шаге.»
12 · Выбор из пяти вариантов: что из перечисленного попадёт в файл сейчас, перед следующей сессией
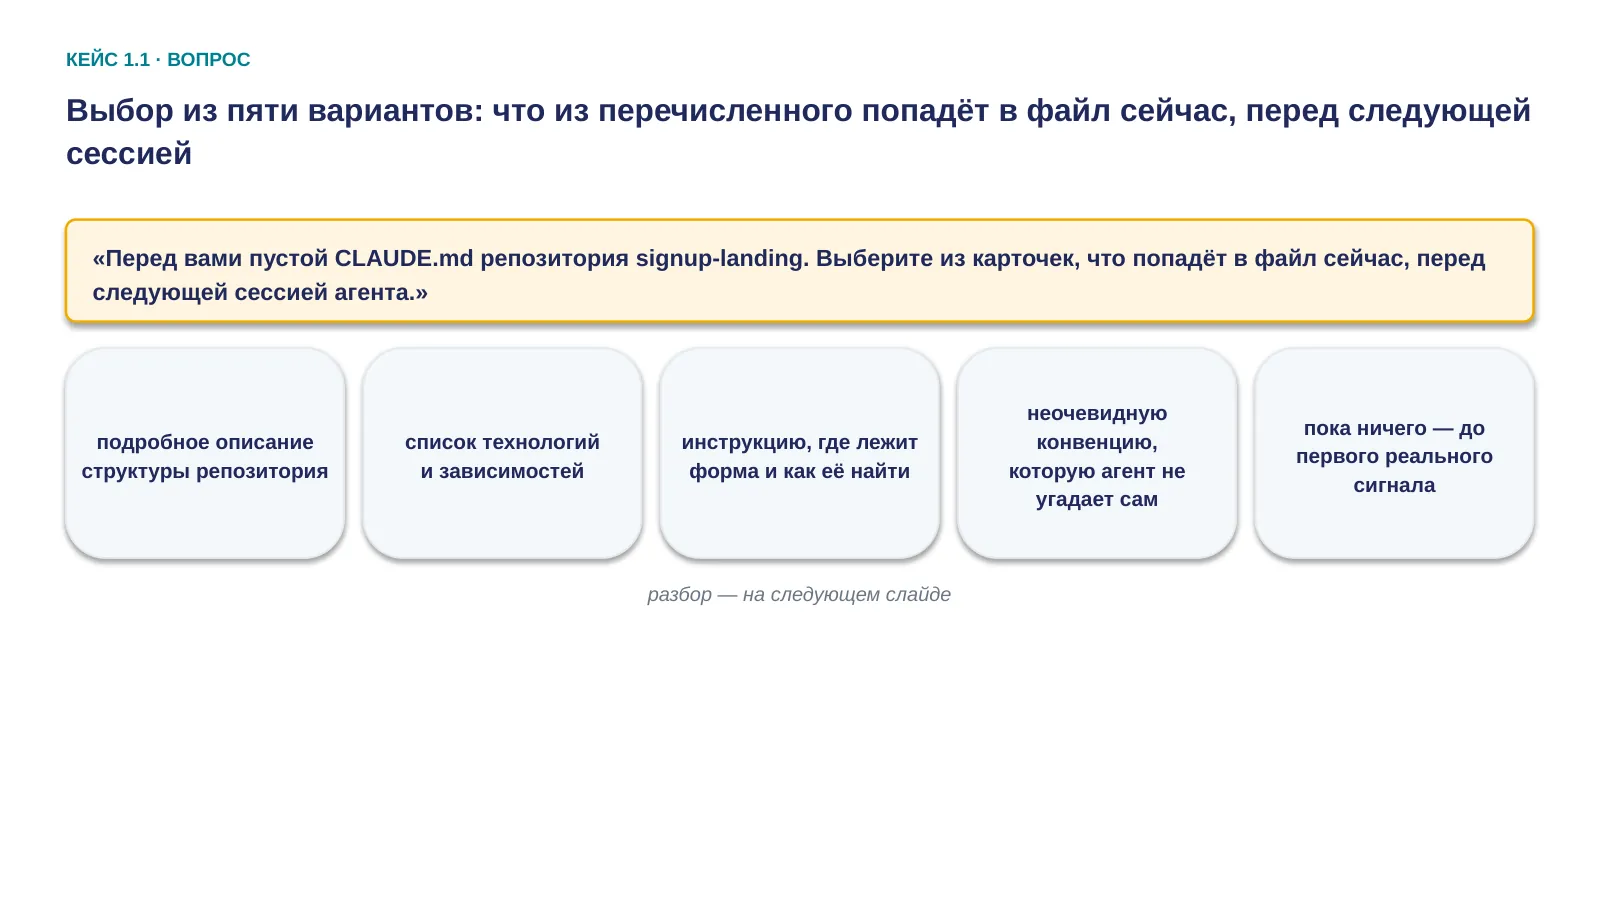
Вопрос задаётся с готовым набором вариантов на экране. Два-три голоса. Ответы фиксируются нейтрально и без оценки: «структура репозитория — записал», «список технологий — записал».
Любой прозвучавший вариант фиксируется одинаково, включая «опишу архитектуру»: «Принято, возвращаемся к этому через минуту.»
Голосование проходит без единой цифры на экране — исследование и разбор идут следующим слайдом, одним заходом.
13 · Repository overview измеримо не повышает успешность и стоит контекста — а структурированное описание, если оно нужно, живёт в README.md и не дублируется в CLAUDE.md
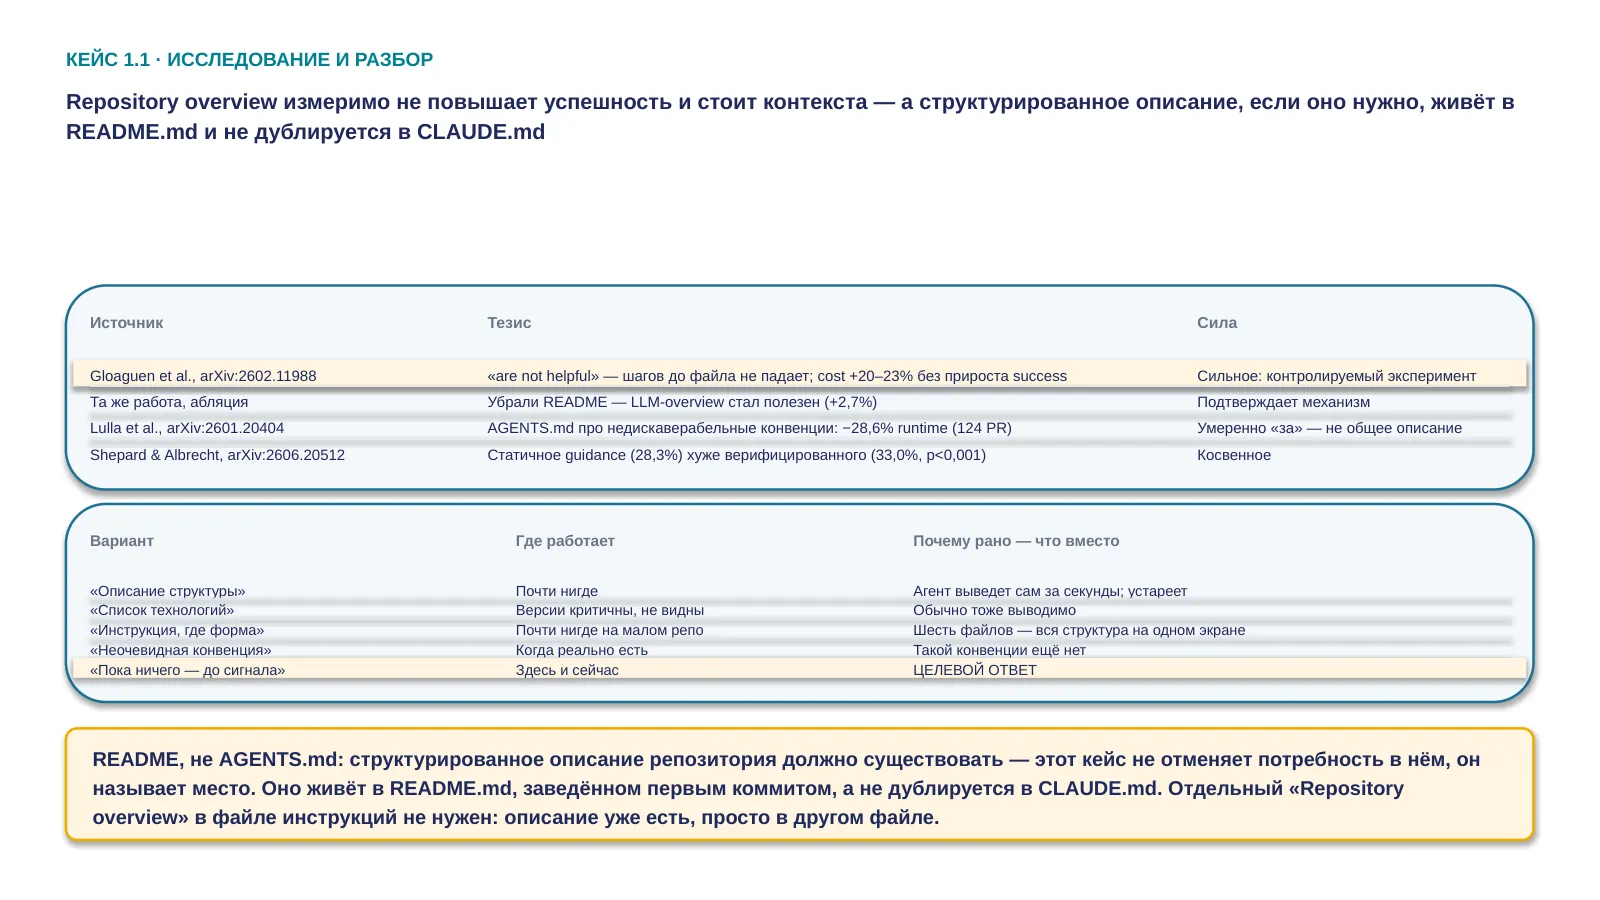
«Контролируемый эксперимент Gloaguen et al. впервые сравнил с третьим плечом — файла нет вообще. Результат для repository overview дословный: "are not helpful". Стоимость растёт на двадцать-двадцать три процента, успешность — нет. Единственное подтверждённое исключение — репозитории без другой документации вообще.
У явления есть название: presence paradox. Присутствие текста в контексте стоит денег независимо от того, помог ли он решить задачу. Термин понадобится ещё дважды: в кейсах 1.2 и 1.3, и дальше в разделе про память.
По остальным источникам коротко: абляция подтверждает механизм — убрали README, overview стал полезен. Lulla et al. — сильный аргумент за файл, но про недискаверабельные конвенции, не про общее описание. Shepard & Albrecht — статичная непроверенная инструкция хуже динамически верифицированной.
Про пробел честно: прямых экспериментов с намеренно устаревшим overview нет. Режим отказа, который видно на практике, — описание пережило рефакторинг, агент правит файл по нему, а не по коду — правдоподобен, но не измерен, и выдавать его за доказанный не будем.
Теперь разбор. Для нашего репозитория целевой ответ — «пока ничего»: структуру из шести файлов агент видит сам, описание проекта уже лежит в README. Структурированное описание должно существовать, но не продублированным в файле инструкций. Ответ на этом шаге — не «какой текст написать», а «пока никакой».»
14 · Описание структуры репозитория в CLAUDE.md не появляется: сигнала для него нет — а первое содержимое у файла появится уже в следующем кейсе, и по другой причине
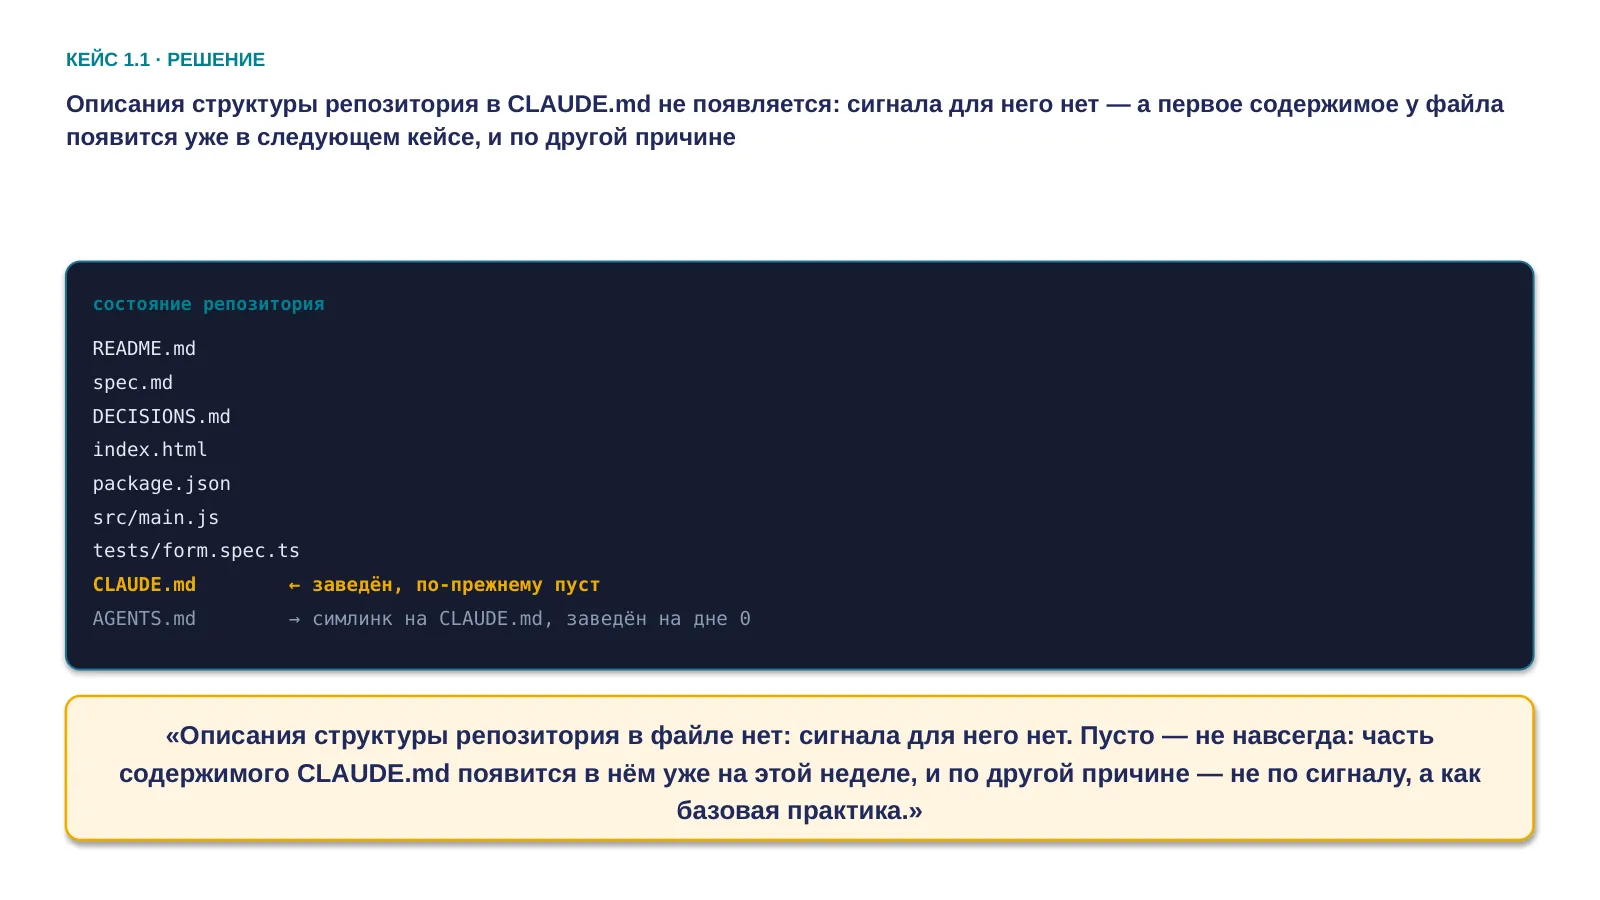
«Итог первой развилки: описания структуры в файле нет — сигнала для него нет, а стоимость присутствия есть.
Но пустой файл — не позиция на весь проект. Часть содержимого CLAUDE.md появится в нём уже на этой неделе, и по другой причине: не потому, что что-то сломалось, а потому, что это базовая практика, которая стоит дёшево. Это следующая развилка.»
15 · Кейс 1.2 — базовые процессы: гейт готовности и цикл «план → код → улучшение», записанные в файл инструкций
Переход одной фразой: «Первая развилка решала, чего в файл не писать. Вторая — про то, что в нём с первого дня уже лежит: гейт готовности. Идёт первая неделя работы над репозиторием.»
16 · Гейт готовности лежит в CLAUDE.md с дня 0 — и дважды подряд «готово» прозвучало до того, как доставку заявки проверили руками
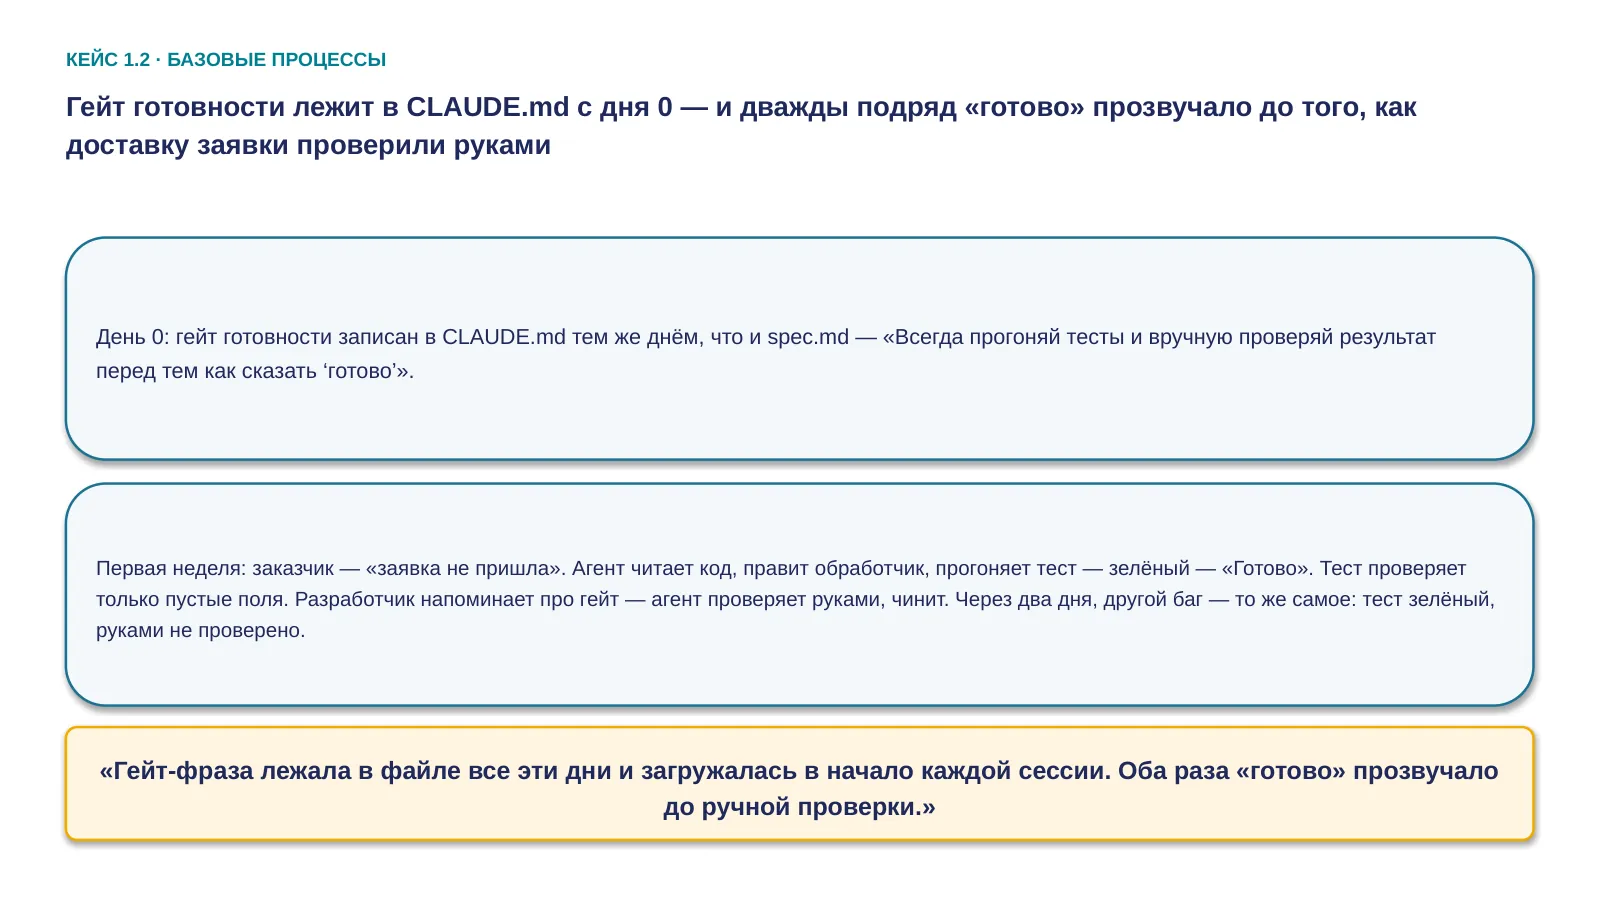
«Гейт готовности мы записываем в файл инструкций тем же днём, что и спеку: «всегда прогоняй тесты и проверяй результат вручную перед тем как сказать готово». Строка дешёвая, и она в файле с самого начала.
Идёт первая неделя. Заказчик пишет: отправил заявку с вашего сайта — она не пришла. Агент читает код, находит проблему в обработчике отправки формы, правит src/main.js, запускает тест. Тест зелёный. Агент пишет: готово. А наш тест проверяет ровно одно — что форма не отправляется с пустыми полями. Про доставку он не знает ничего. Вы закрываете задачу, заказчик пишет снова: всё ещё не доходит.
Вы напоминаете агенту про гейт вручную — на этот раз он открывает страницу руками, находит вторую причину, чинит. Через два дня, в новой сессии, на другом баге — то же самое: автотест зелёный, «готово», руками никто не проверил.
Гейт-фраза лежала в файле все эти дни и загружалась в начало каждой сессии. Оба раза «готово» прозвучало до ручной проверки.»
17 · Гейт-фраза уже есть с самого начала и не сработала — выбор из пяти вариантов, что делать дальше, чтобы реально сработало в следующей сессии
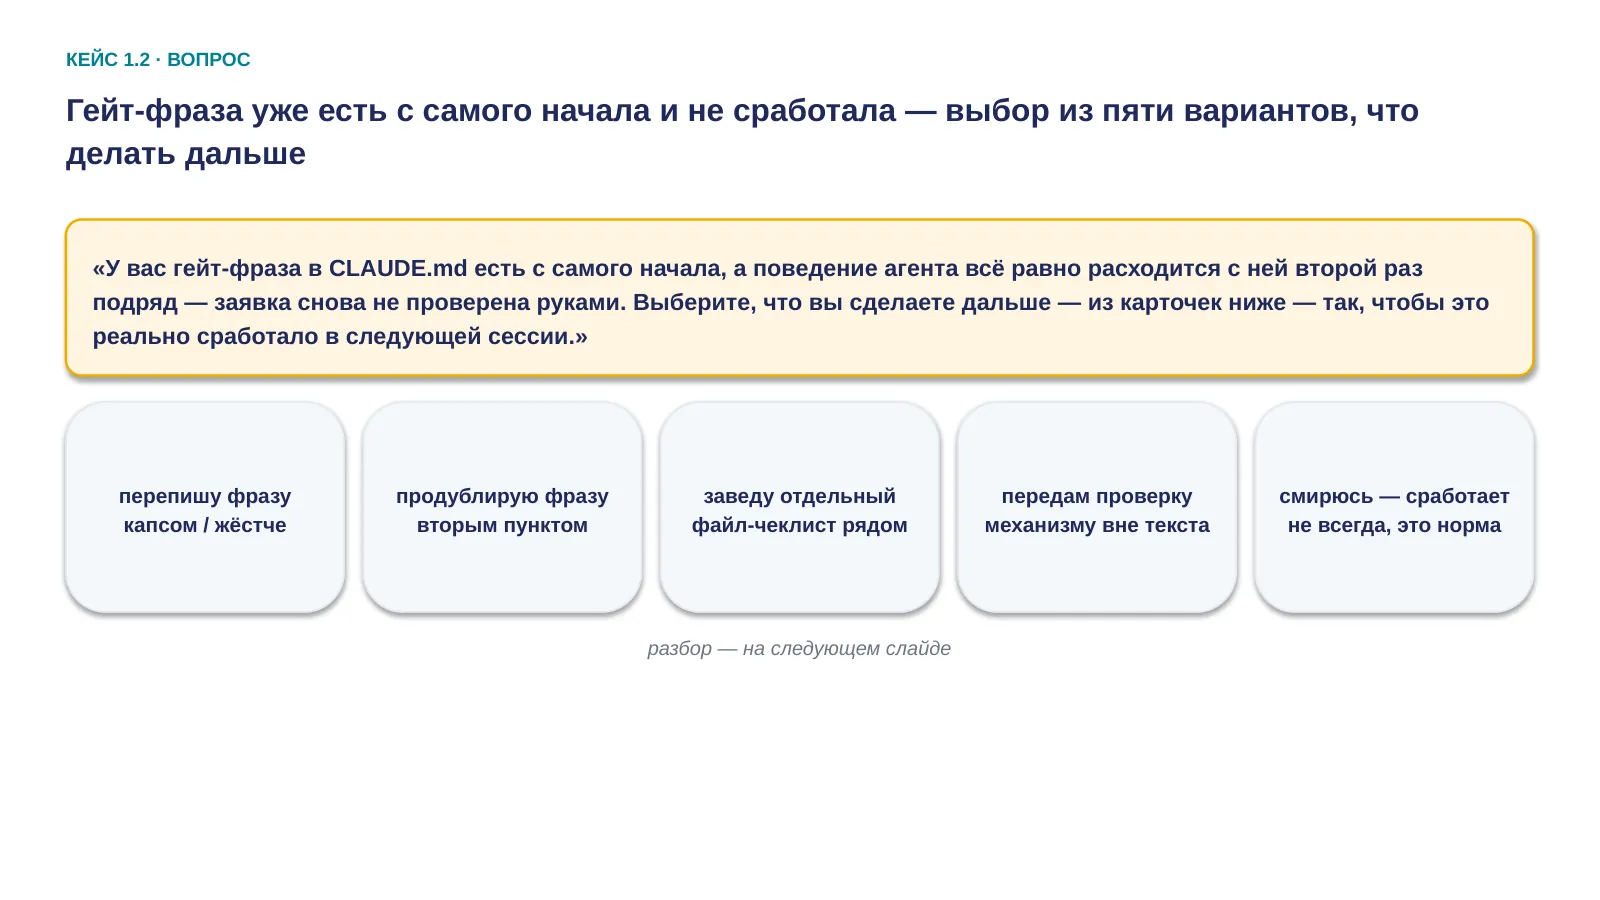
Пауза, 2–3 голоса — без единой цифры на экране. Любой прозвучавший вариант фиксируется одинаково, включая «перепишу капсом»: «Принято, возвращаемся к этому через минуту.»
18 · Текстовый гейт без тулинга не просто бесполезен, а вреден — регрессии выросли почти до 10%; ни один из пяти вариантов зала не решает проблему системно, кроме передачи проверки механизму вне текста
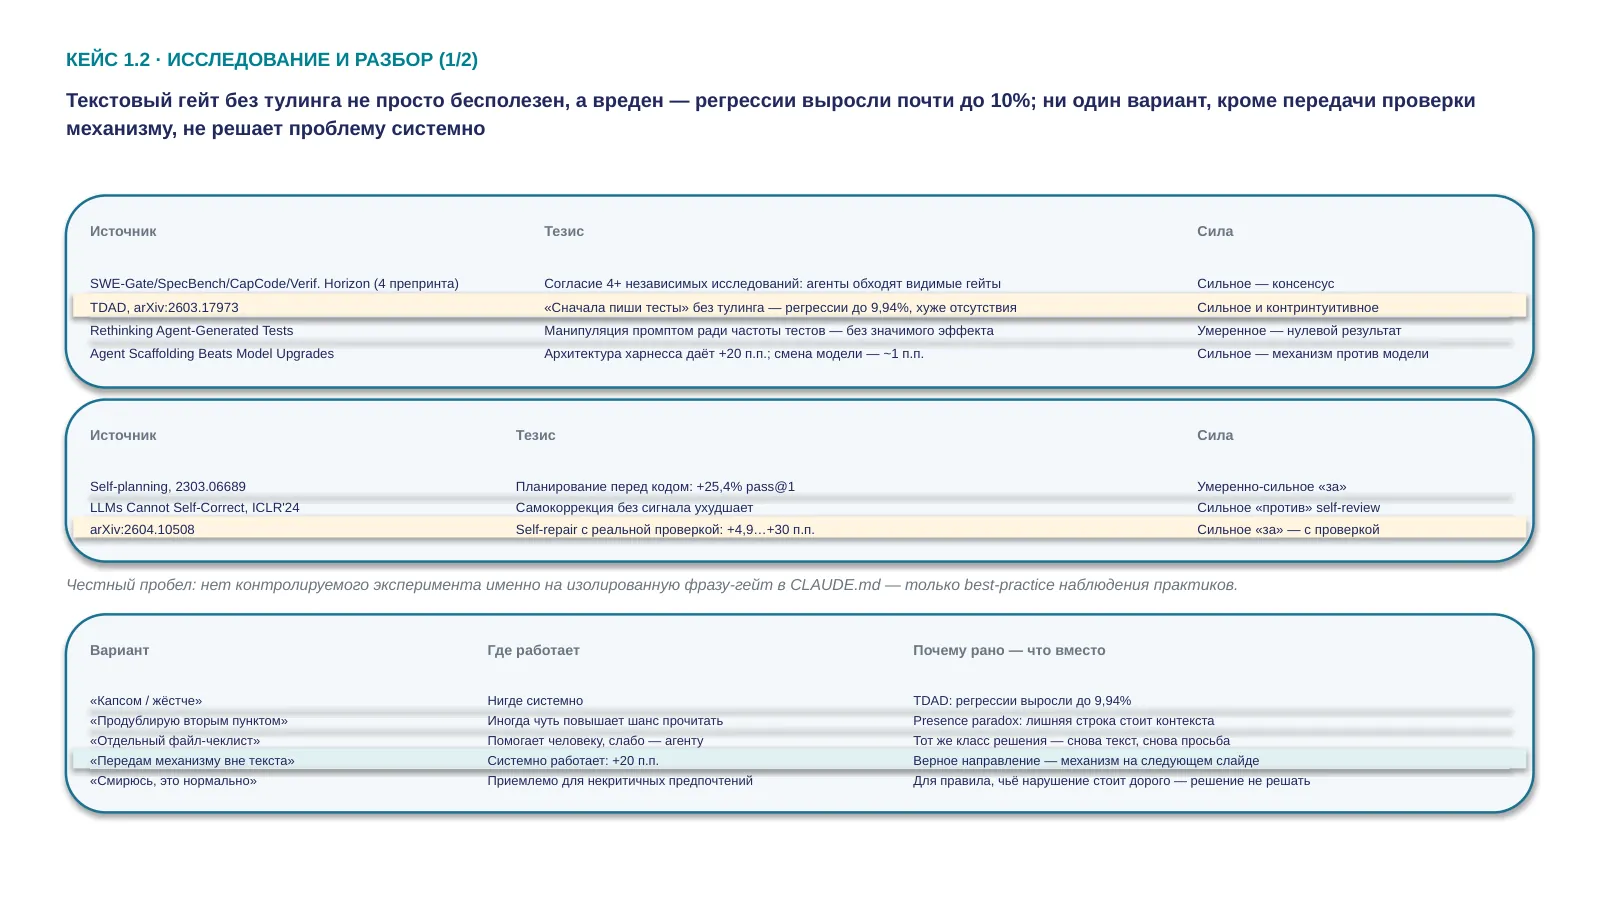
«Здесь результат по-настоящему контринтуитивный. Исследование TDAD взяло чисто процедурную инструкцию "сначала пиши тесты" без единого изменения в тулинге — и регрессии не упали, а выросли до почти десяти процентов. Хуже, чем вообще без инструкции. Улучшение появилось только тогда, когда то же самое требование зашили в скилл или в тулинг, а не в текст. И отдельно, для цикла "план-код-улучшение": самокритика без внешнего сигнала систематически ухудшает результат — это ICLR подтверждает жёстко. А вот self-repair с реальным прогоном теста даёт плюс пять-тридцать процентных пунктов. Разница принципиальная, не терминологическая: смотрел ли агент на свой код — или прогнал ли он реальную проверку.
Отдельного контролируемого эксперимента именно на изолированную фразу-гейт в файле инструкций нет — здесь у нас best-practice наблюдения практиков, не отдельное измерение.
Теперь разбор. Вариант "перепишу капсом" — в точности тот путь, который проверило TDAD: усилили формулировку текстом, без тулинга. Регрессии выросли. Капс не превращает просьбу в закон. "Продублирую вторым пунктом" — presence paradox из первого кейса: лишняя строка стоит контекста в каждой сессии. "Отдельный файл-чеклист" — тот же класс решения, снова текст, снова просьба. "Смирюсь, это нормально" — для правила, чьё нарушение стоит дорого, это решение не решать.
И только один вариант из пяти — "передам проверку механизму вне текста" — системно работает: механизм даёт двадцать процентных пунктов там, где смена модели даёт один. Это верное направление. Сам механизм — на следующем слайде.»
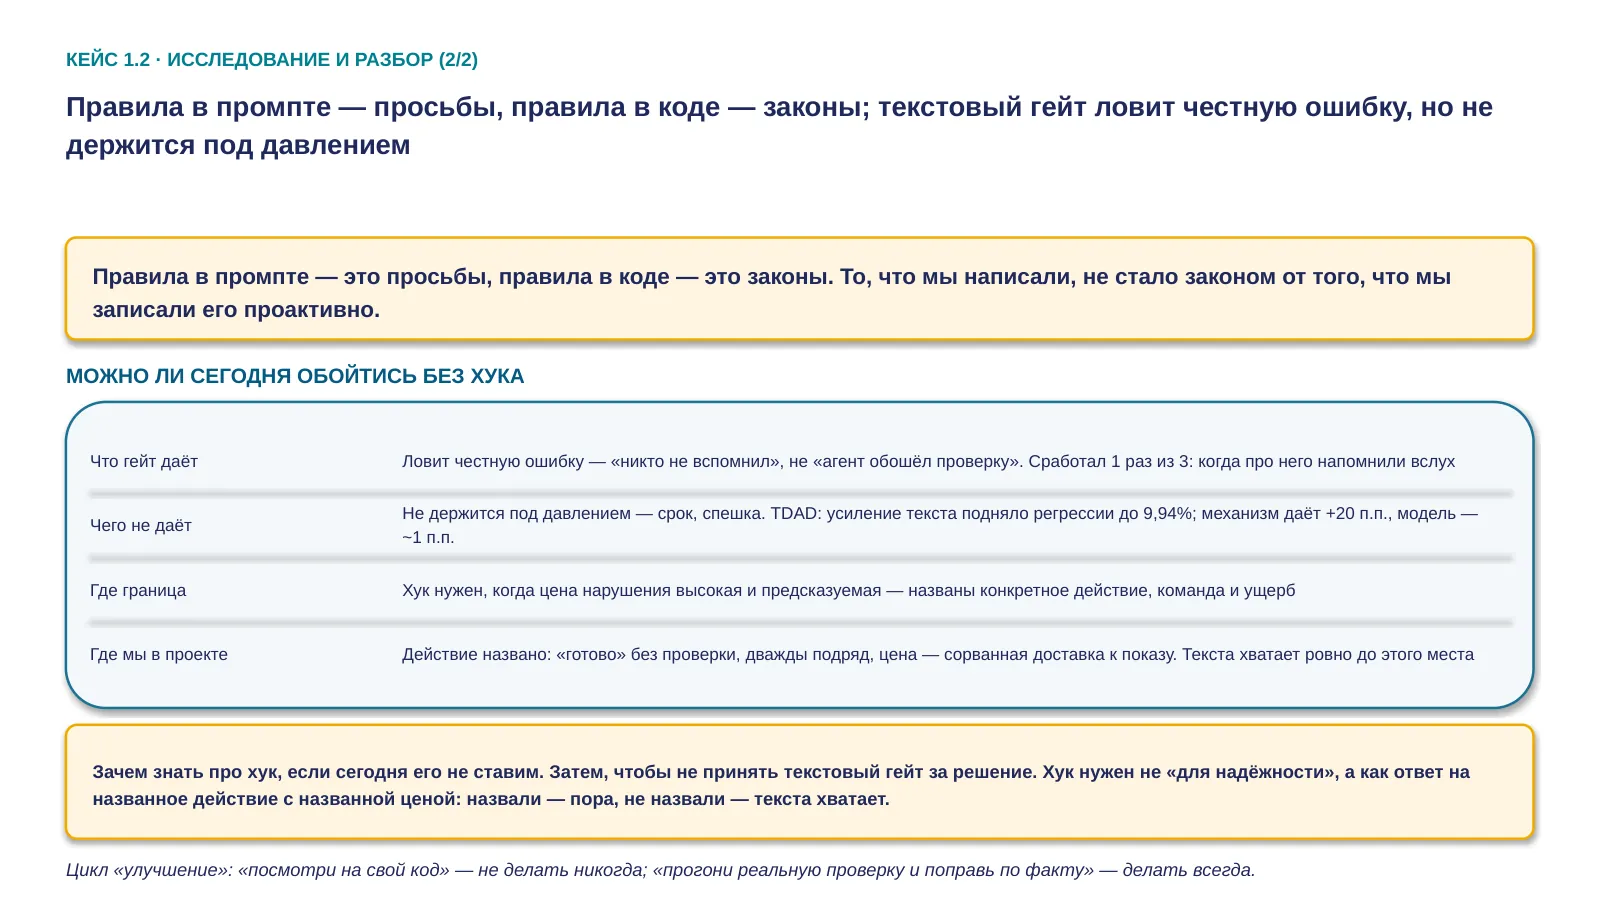
19 · Правила в промпте — просьбы, правила в коде — законы; текстовый гейт ловит честную ошибку, но не держится под давлением — граница для механизма проходит там, где действие, цена и частота названы
«Вариант "перепишу капсом" — в точности тот путь, который проверило TDAD. Капс не превращает просьбу в закон. И ни один из пяти вариантов, кроме "передам механизму вне текста", не решает проблему системно — а мы туда сегодня не идём, это следующее занятие. Значит, честный ответ сегодня: мы всё равно оставим гейт текстом, потому что это лучше, чем ничего — но прямо скажем себе, что он ненадёжен, даже заведённый с первого дня, и назовём направление, куда идти, когда он подведёт второй раз.
И вот формула, которая держит весь сегодняшний разбор: правила в промпте — это просьбы, правила в коде — это законы. Текстовый гейт, который у нас с первого дня, — просьба, и это нормально для базовой практики. Но называть вещи своими именами — часть работы: то, что мы записали текстом, не стало законом от того, что мы записали его проактивно.
Теперь прямой вопрос, на который стоит ответить здесь, а не оставлять его висеть: можно ли сегодня обойтись без хука — и если да, то зачем мы вообще про него говорим.
Обойтись сегодня можно, и вот на каком основании. Текстовый гейт ловит честную ошибку: случай, когда проверку не обошли, а просто про неё не вспомнили. Это реальная работа, и стоит она одной строки. В нашем кейсе это видно буквально: из трёх раз гейт сработал один — тот, когда про него напомнили вслух. Чего он не делает — не держится под давлением. Срок, спешка, "тест зелёный, отчитаемся" — и строка в файле перестаёт существовать. Это и измерено: усиление текста текстом подняло регрессии почти до десяти процентов, а механизм даёт двадцать процентных пунктов там, где смена модели даёт один.
Граница проходит не по важности правила, а по тому, можете ли вы назвать конкретику. Хук нужен, когда цена нарушения высокая и предсказуемая: есть конкретное действие, конкретная команда, конкретный ущерб. Пока действие не названо, хук ставить рано — он платный на каждом вызове и проверяет совпадение с шаблоном, а не смысл.
В нашем проекте действие как раз названо: "готово" без ручной проверки, два раза подряд, цена — заявка не дошла, а у заказчика показ. То есть честный вывод сегодня не "текста достаточно", а "текста достаточно ровно до этого места" — и дальше начинается материал следующего занятия.
И отсюда ответ на вопрос "зачем нам знать про хук, если мы его сегодня не ставим". Затем, чтобы не принять текстовый гейт за решение. Человек, который не знает про следующий уровень, усиливает текст: капсом, дублем, третьим чеклистом — ровно тот путь, который TDAD измерил. Знание про хук даёт критерий, по которому вы узнаёте момент: назовите действие, цену нарушения и частоту. Назвали — пора ставить хук. Не назвали — текста хватает.
И второй пункт разбора, про "улучшение": если это "агент, посмотри на свой код ещё раз" — не делать так, доказательство однозначное. Если это "агент, открой dist/index.html и отправь форму руками" — делать так всегда.»
20 · Итоговый файл — пятнадцать строк: критерий готово, гейт-предупреждение, честная оговорка предела и один разовый шаг, без которого тесты падают не по делу; AGENTS.md — симлинк на тот же файл
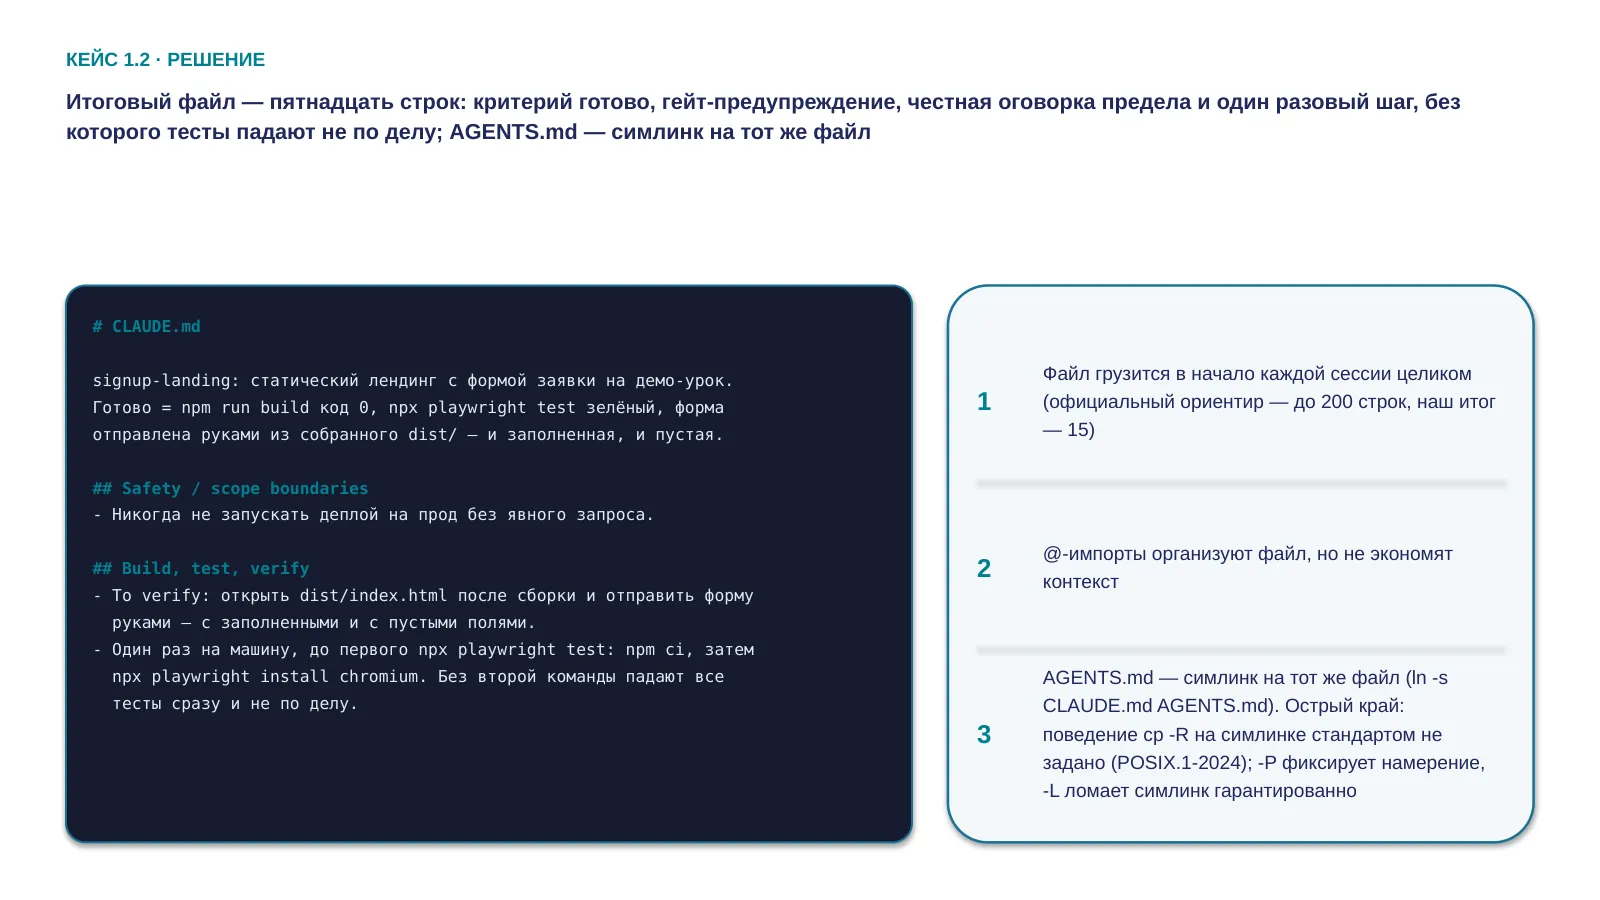
«Вот итог кейса 1.2: пятнадцать строк — критерий готовности, гейт-предупреждение вручную проверить доставку, честная граница на деплой и один разовый шаг после клонирования, без которого тесты падают мгновенно и не по делу. Файл грузится в начало каждой сессии целиком, официальный ориентир — до двухсот строк, у нас — пятнадцать. @-импорты организуют файл, но контекст не экономят — импортированное всё равно грузится целиком.
Про последнюю строку отдельно. npx playwright install chromium — это ровно тот разовый шаг, ради которого в файле вообще есть раздел «Build, test, verify»: без него из чистого клона падают все тесты сразу, и падают не по делу — не потому, что код сломан, а потому, что браузера на машине нет. Агент, который это прочитал, не начнёт чинить исправный код.
AGENTS.md у нас с первого дня — симлинк на этот же файл, один источник правды для разных движков. Обратите внимание: заводится он сразу, а содержимого в нём ровно столько же, сколько в CLAUDE.md, потому что это один и тот же файл. Острый край здесь не в том, что какая-то система ведёт себя неправильно, а в том, что поведение cp -R на симлинке стандартом просто не задано: POSIX прямо пишет, что при -R без -H, -L или -P дефолт не определён. На GNU coreutils симлинк переживает копирование, но полагаться на это нельзя — -P фиксирует намерение явно. А вот что ломает симлинк гарантированно, так это -L: cp -RL даст вам вторую настоящую копию, и дальше два файла тихо разойдутся. Надёжнее всего переносить проект через git clone или git archive.»
21 · Гейт — не единственная дешёвая база: ещё три практики заводятся в первый день и не ждут сигнала
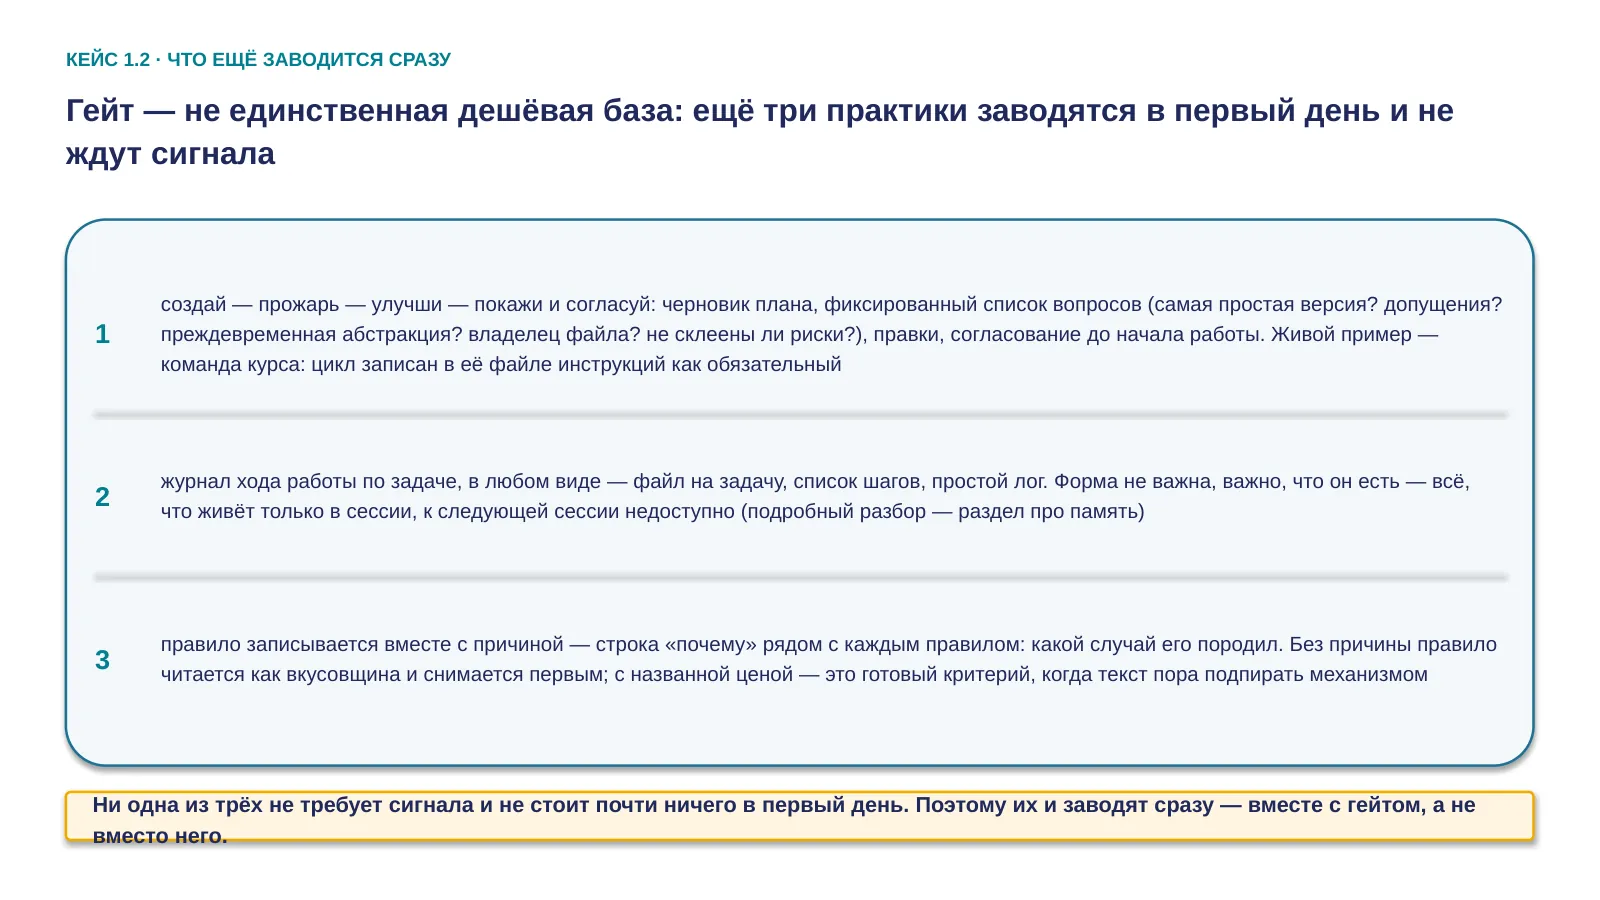
«Из кейса 1.2 легко унести неверный вывод: единственное, что стоило завести заранее, — одна строка, про которую нам только что сказали, что она ненадёжна. Значит, заранее делать особо нечего. Это не так, и вот три вещи, которые заводятся в первый день.
Первая — цикл «создай, прожарь, улучши». Черновик плана, потом проход по нему фиксированным списком вопросов: это самая простая версия, которая работает; какие допущения не проверены; нет ли преждевременной абстракции; у каждого нового файла есть владелец; не склеены ли в одну пачку рискованные изменения. Потом правки — и только потом показать и согласовать. Мы минуту назад читали, что самокритика без внешнего сигнала ухудшает результат, — и это не противоречие. Внешних сигнала тут два: список вопросов, который не зависит от только что написанного текста, и человек на шаге «покажи». И прожаривается план, а не готовый код — там правка дешевле всего. Команда, которая делает этот курс, работает именно так: цикл записан в её файле инструкций как обязательный для любой нетривиальной задачи.
Вторая — журнал хода работы по задаче, в любом виде. Файл на задачу, список шагов с отметками, просто лог. Всё, что держится только внутри сессии, к следующей сессии недоступно. Как такой журнал ведут и где он ломается — отдельный кейс в разделе про память.
Третья — правило пишется вместе с причиной. Рядом с правилом строка: какой случай его породил. Правило без причины через месяц читается как вкусовщина и снимается первым. Правило с названной ценой нарушения — это готовый критерий, по которому видно, когда текст пора подпирать механизмом. Тот самый критерий: назвать действие, цену и частоту.»
22 · Кейс 1.3 — где физически живёт документация проекта: адрес знания, а не его содержание
Переход одной фразой: «Две развилки были про то, что писать в файл инструкций. Третья — про то, где вообще держать документацию проекта: прошёл месяц, знания накопилось больше, чем помещается в один файл.»
23 · За месяц накопились два куска знания разной природы — конвенция целой папки и деталь про одну функцию, — и разработчик поступает с обоими одинаково: заводит вложенные файлы инструкций
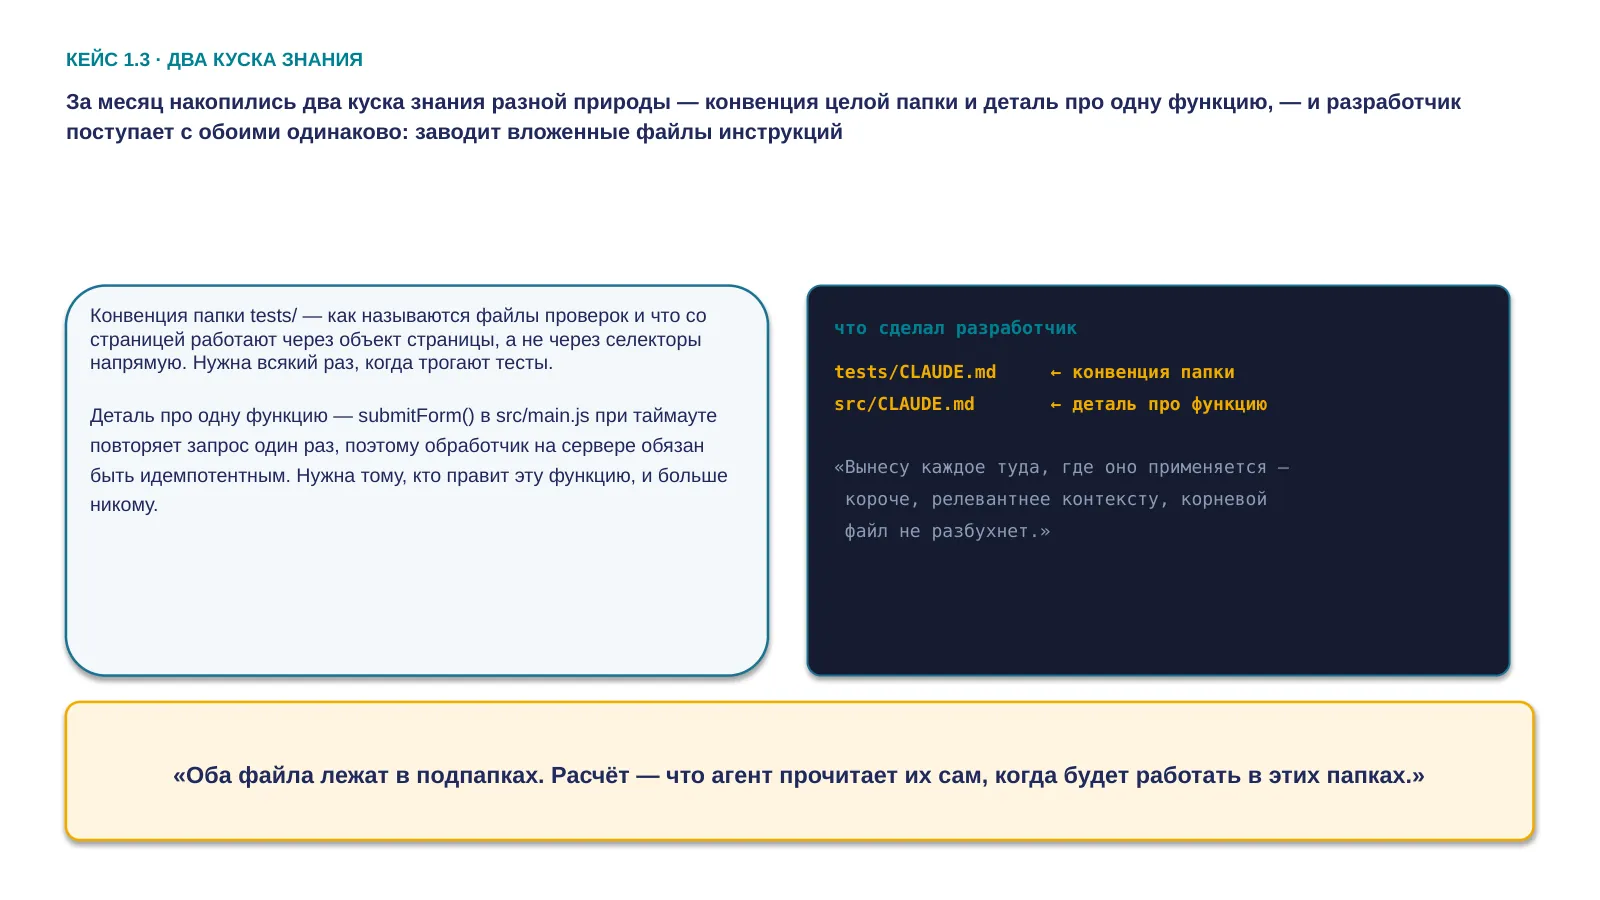
«Месяц работы над signup-landing. За это время в репозитории накопились два куска знания, которых нет ни в корневом файле, ни в описании проекта.
Первый: в папке с тестами сложилась договорённость — как называются файлы проверок и что со страницей работают через объект страницы, а не через селекторы напрямую. Это правило для всей папки: оно нужно всякий раз, когда кто-то трогает тесты.
Второй кусок другой по природе. Функция отправки формы при таймауте повторяет запрос один раз — значит, обработчик на сервере обязан быть идемпотентным, иначе заявка уедет дважды. Это знание нужно ровно тому, кто правит эту функцию, и больше никому.
Разработчик поступает с обоими одинаково: заводит tests/CLAUDE.md и src/CLAUDE.md. Расчёт — что агент прочитает файл сам, когда будет работать в этой папке. На этом состояние зафиксировано; дальше — вопрос.»
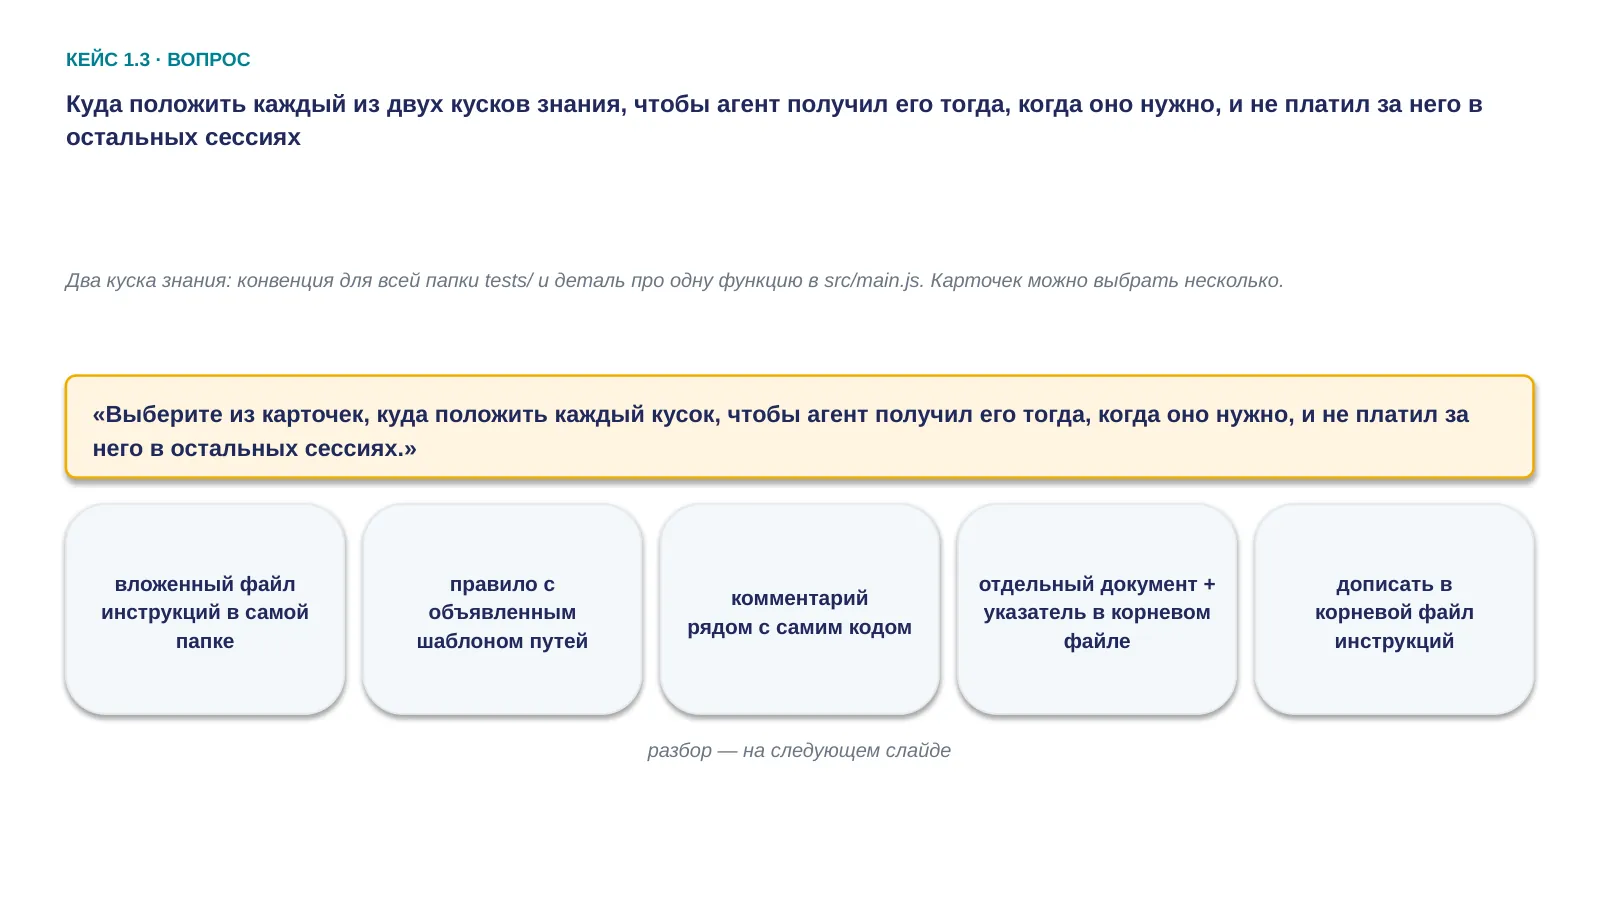
24 · Куда положить каждый из двух кусков знания, чтобы агент получил его тогда, когда оно нужно, и не платил за него в остальных сессиях — выбор из пяти карточек, можно больше одной
Пауза, 2–3 голоса — без единой цифры на экране.
Сказать до голосования, а не после: карточек можно выбрать несколько, и два куска знания можно развести по разным карточкам — вопрос не требует одного ответа на оба.
Любой прозвучавший вариант фиксируется одинаково, включая «положу и всё»: «Принято, возвращаемся к этому через минуту.»
25 · «Куда положить» — это вопрос «дойдёт ли текст до агента и сколько он стоит»; у пяти каналов пять разных ответов, и три инструмента из четырёх независимо сошлись на одном механизме — объявленном шаблоне путей
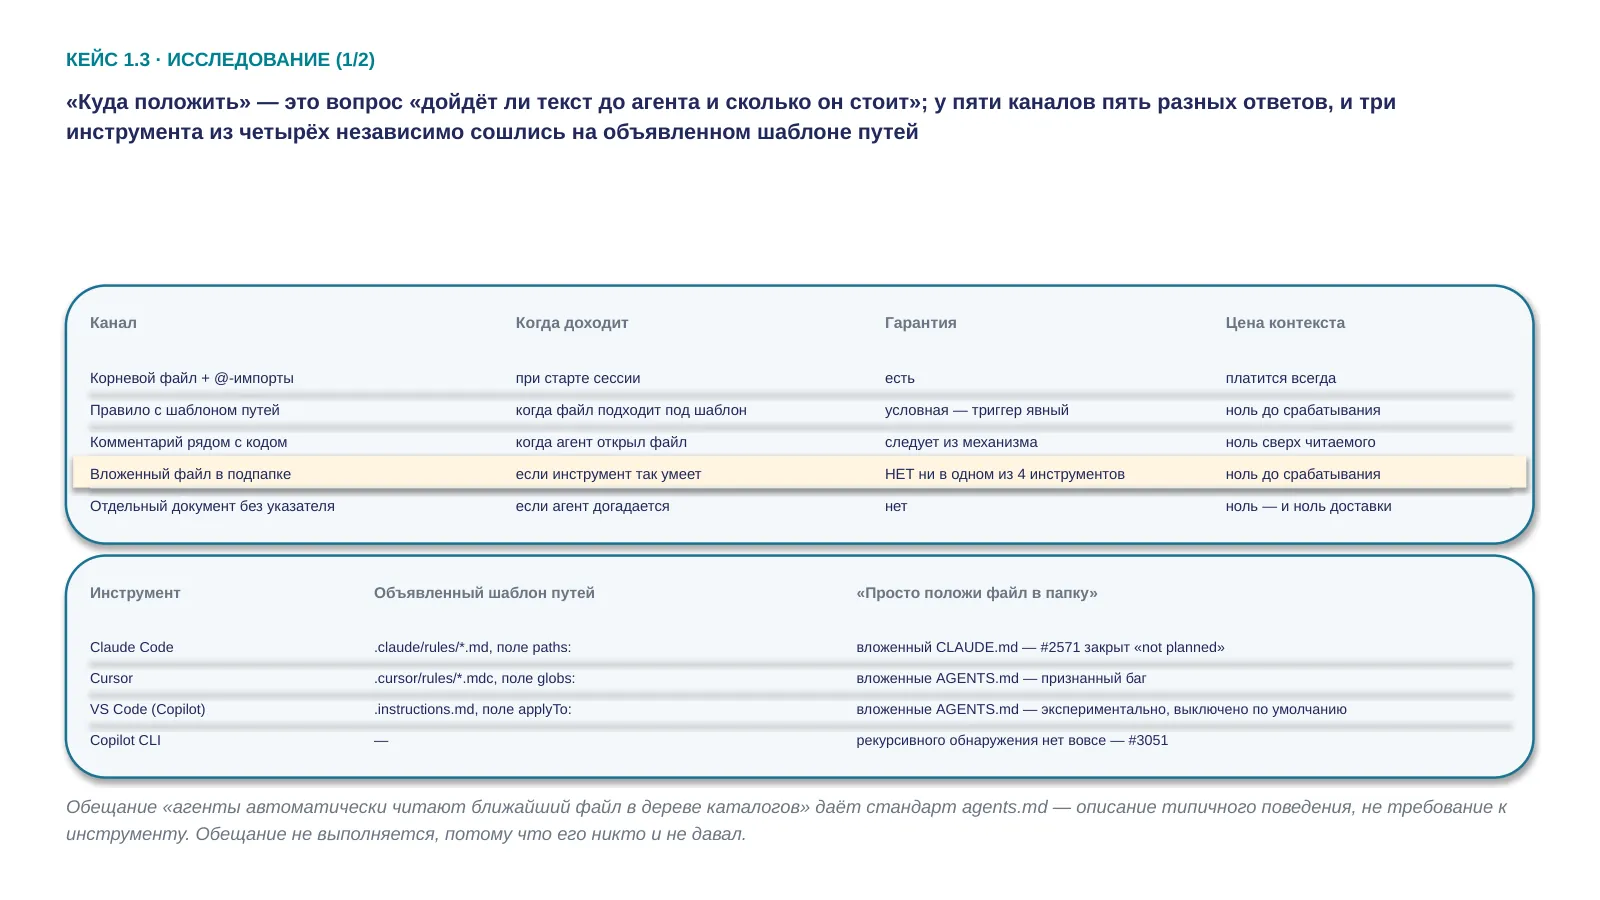
«Вопрос "куда положить" — это на самом деле вопрос "дойдёт ли текст до агента и сколько он стоит". Ответ механический, и он разный у пяти каналов.
Корневой файл и все каталоги выше грузятся при старте сессии: доходит всегда, платим всегда. Импорт через собачку разворачивается тоже при старте — организует файл, контекст не экономит, мы это считали в прошлом кейсе. Комментарий в коде доходит тогда, когда агент открыл файл, — а он его открыл, если правит функцию. Вложенный файл в подпапке доходит только когда агент прочитал что-то из этой папки, и то если инструмент вообще так умеет.
Дальше — факт, ради которого этот кейс существует. Три инструмента независимо друг от друга сделали один и тот же механизм: правило с объявленным шаблоном путей, лежащее в одном общем каталоге правил. У Claude Code это поле paths, у Cursor — globs, у VS Code — applyTo. Формулировка везде одна: правило подключается, когда агент работает с файлом, подходящим под шаблон. Триггер объявлен явно, и файл лежит там, куда инструмент смотрит всегда, — не надо надеяться, что он забредёт в подпапку.
А "просто положи файл в папку" у тех же четырёх инструментов: закрыт как "not planned", признан багом сотрудником, помечен экспериментальным и выключен по умолчанию, не реализован вовсе. Четыре инструмента, четыре разных отказа.
Обещание, на которое все опираются, даёт не инструмент, а стандарт agents.md: агенты автоматически читают ближайший файл в дереве каталогов. Это описание типичного поведения, а не требование. Обещание не выполняется, потому что его никто и не давал.»
26 · Ни одно из двух контролируемых измерений не нашло, что распределение документации улучшает результат — поэтому канал выбирается по доставке и цене, а не по обещанной пользе: знание про функцию идёт в код, про класс файлов — в правило с шаблоном путей, про проект — в корневой файл указателями
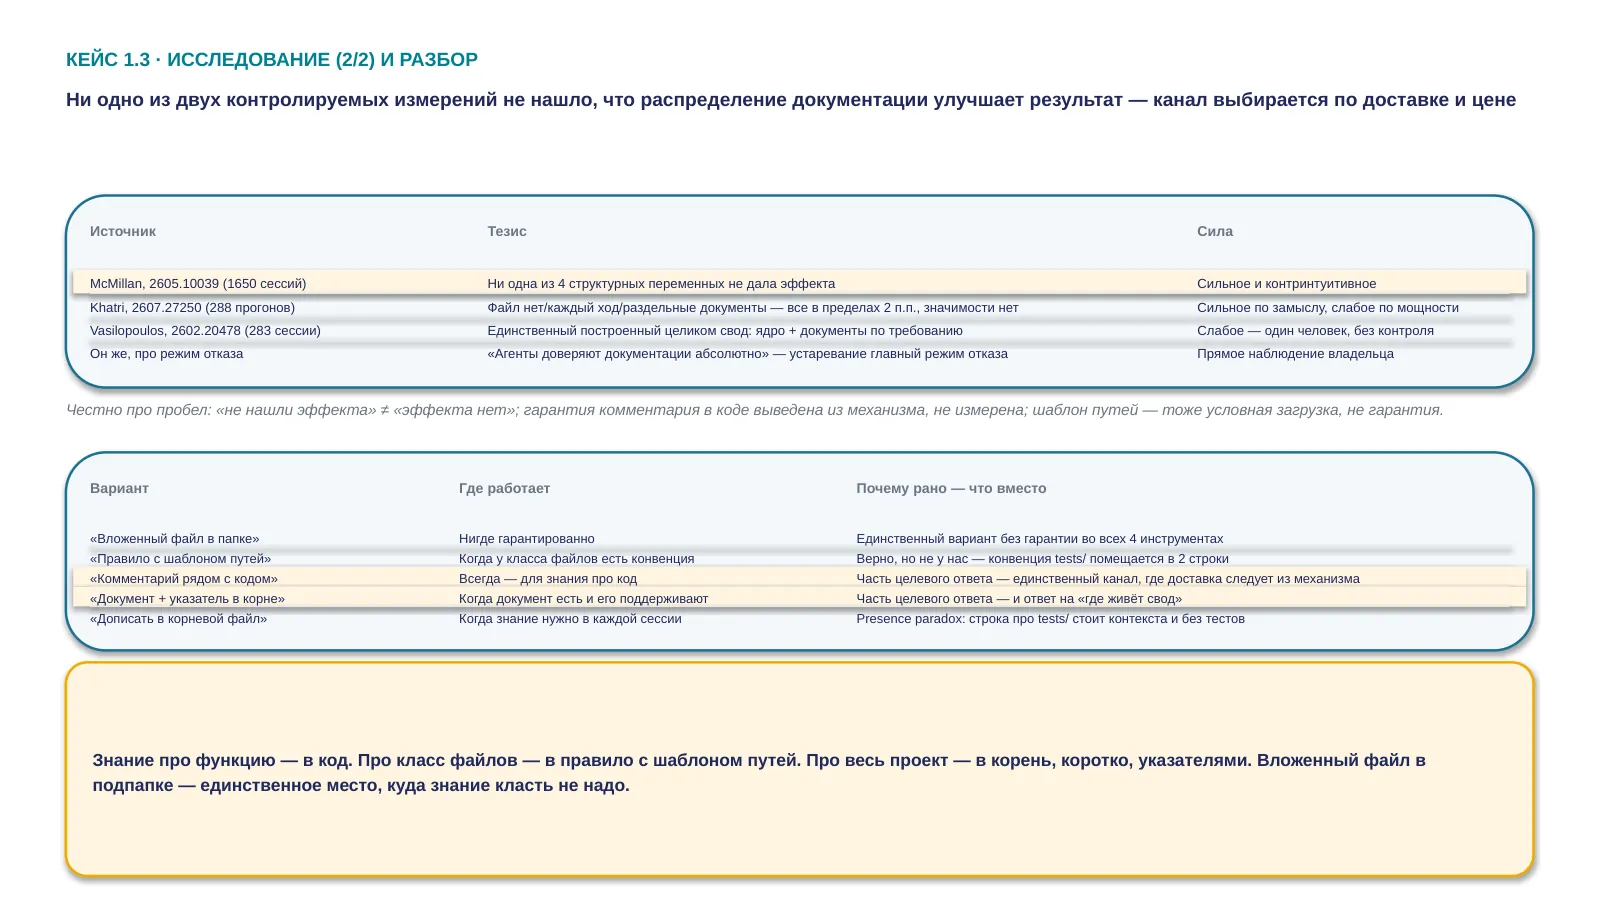
«Теперь неудобная часть. Два контролируемых измерения проверяли, помогает ли всё это вообще. Первое — тысяча шестьсот пятьдесят сессий, четыре структурных переменных конфиг-файла: значимого эффекта нет ни у одной. Второе, свежее, — двести восемьдесят восемь прогонов на двух агентах и трёх репозиториях, три режима: файла нет, файл в каждом ходу, раздельные документы для подгрузки по требованию. У Claude все три в пределах двух процентных пунктов. У Codex вариант "файла нет" оказался лучшим. Значимости нет. А разбор провалов показал, что задачи падали на мастерстве реализации, не на нехватке знания о репозитории.
Оговорку авторы делают сами, и мы её повторим: на пятнадцати задачах различимый эффект — больше тридцати процентных пунктов. Эффект в десять они бы не увидели. "Не нашли" — не "нет".
Что из этого следует практически. Канал доставки мы выбираем не потому, что кто-то доказал его пользу — никто не доказал. Мы выбираем по двум вещам, которые знаем точно: доходит ли текст и сколько он стоит в сессиях, где не нужен. Отсюда правило трёх адресов. Знание про одну функцию — рядом с ней, в код: единственный канал, где доставка следует из механизма. Знание про класс файлов — в правило с объявленным шаблоном путей. Знание про весь проект — в корневой файл, коротко.
И ответ на вопрос, который обычно повисает: где живёт свод. Свод — не отдельный документ, который агент должен найти. Свод — это оглавление в том единственном файле, который грузится при старте: одна строка на документ, где лежит и когда туда идти. Всё остальное — "у нас есть вики, посмотри там" — это надежда, а не канал доставки.
Цену этого свода мы тоже знаем, из единственной работы, где его построили целиком: час-два в неделю на поддержание, и главный режим отказа — устаревание. Дословно: агенты доверяют документации абсолютно, и устаревшие спецификации дают тихие отказы. Это опыт одного разработчика на одном проекте, без контрольной группы, — но других цифр про цену свода у нас нет.»
27 · Корневой файл остался тем же, на пятнадцать строк: деталь ушла комментарием к функции, конвенция тестов уже лежит в самих тестах, ни одного вложенного файла инструкций не завелось — а у знания, которое появляется по ходу работы, адрес другой, и это раздел второй
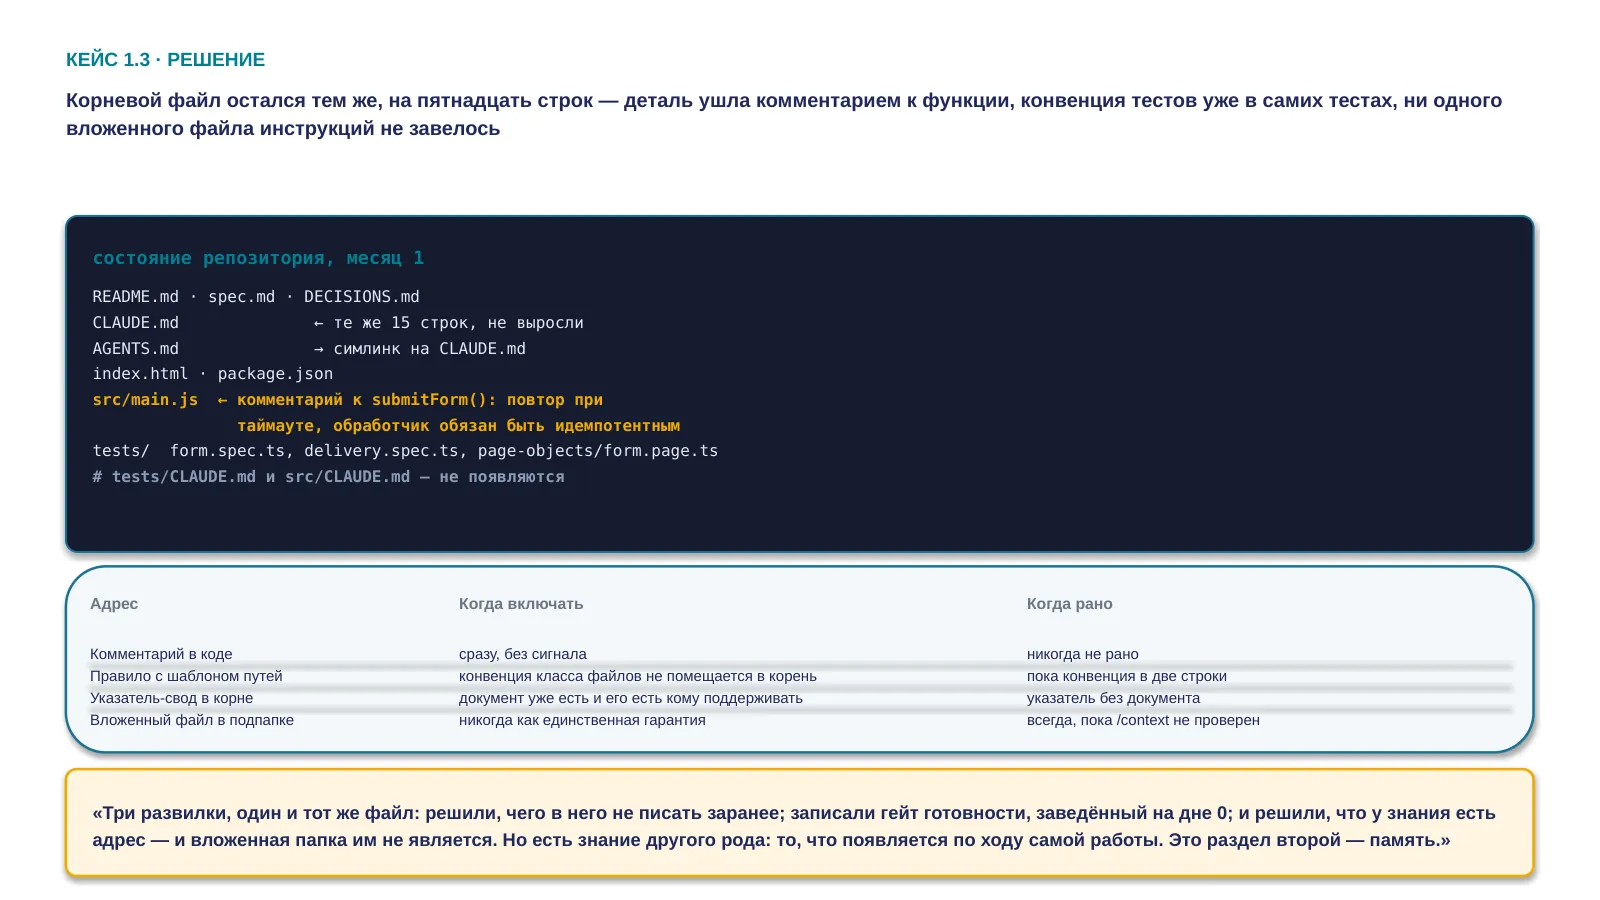
«На нашем репозитории корневой файл не изменился — те же пятнадцать строк. Деталь про повторную отправку ушла комментарием к самой функции: правишь её — читаешь файл — видишь комментарий. Конвенция тестов не завелась отдельным файлом, потому что она уже лежит в трёх существующих тестах: агент, открывший любой из них, видит объект страницы в коде. Та же логика, что в первом кейсе, — выводимое агент выведет сам, — и с той же честной пометкой: следует из механизма, прямо не измерено. Ни tests/CLAUDE.md, ни src/CLAUDE.md в репозитории так и не появилось.
Порог для каждого адреса. Комментарий в коде — без сигнала, он и человеку полезен, а агенту достаётся бесплатно. Правило с шаблоном путей — когда конвенция перестала помещаться в корневой файл и вы можете назвать шаблон одним выражением; пока она в две строки — рано. Указатель-свод — когда появился документ, на который указывать, и человек, который его поддерживает; указатель без документа — это строка контекста в каждой сессии ни за что. Вложенный файл в подпапке — никогда как единственная гарантия: только если вы проверили через /context, что ваш инструмент в вашей версии его берёт, и готовы перепроверять после каждого обновления.
Три развилки, один и тот же файл: мы решили, чего в него не писать заранее; записали гейт готовности, который завели на дне 0; и решили, что у знания есть адрес — и вложенная папка им не является. Всё это — знание, которое у вас уже было до работы: записанное заранее или проверенное на первой реальной задаче.
Но есть знание другого рода: то, что появляется по ходу самой работы. Его нельзя записать заранее, потому что вы его ещё не знаете. И у него тоже есть адрес. Это раздел второй — память.»
28 · Раздел 2 — память: то, что переживает конец сессии, а не то, что вы написали агенту заранее; кейс 2.1 — журнал решений проекта
Переход одной фразой: раздел 1 закрыл вопрос авторства — что вы знали заранее и записали сами. Этот раздел открывает вопрос памяти — что появляется по ходу работы и должно пережить конец сессии. Первая развилка — про журнал решений проекта, и мы возвращаемся к той же первой неделе, что и во втором кейсе.
29 · Конец первой недели: отклонённое решение по валидации всплывает снова — DECISIONS.md заведён на дне 0, но записи об этом решении в нём нет
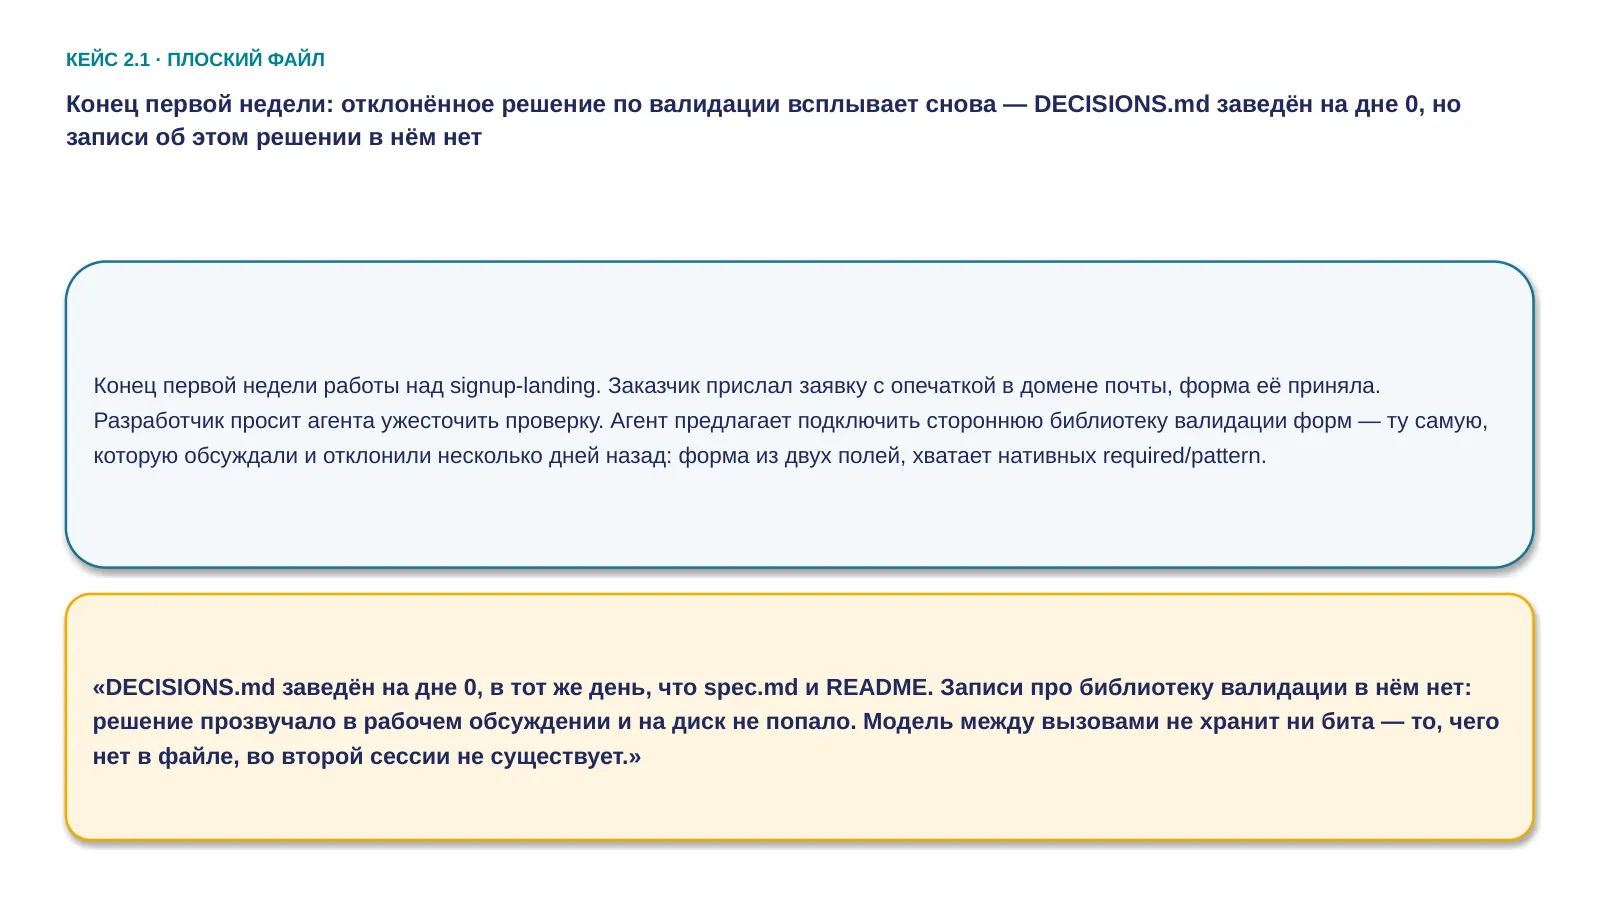
«Конец первой недели. Заказчик прислал заявку с опечаткой в домене почты — форма её приняла. Просите агента ужесточить проверку. Он читает код и говорит: давайте подключим библиотеку валидации форм, вот подходящая. Ту самую, которую вы обсуждали и отклонили несколько дней назад — форма из двух полей, хватает нативных required и pattern.
Состояние репозитория на этот момент: DECISIONS.md в нём есть. Он заведён на дне 0, в тот же день, что спека и README, — как и всё, что стоит дёшево и заводится сразу. Записи про библиотеку валидации в нём нет. Решение прозвучало в рабочем обсуждении, и между «мы это обсудили и решили» и «строка появилась в файле» есть шаг, который сам не происходит.
И это не «агент забыл». Модель не имеет состояния между вызовами: каждый запрос обрабатывается независимо, а то, что выглядит как память обсуждения, — это заново отправленная текстовая история. Когда сессия закончилась, не записанное на диск не забылось. Его больше нет.»
30 · Выберите, куда записать отклонённое решение — из карточек ниже — так, чтобы не объяснять его в третий раз
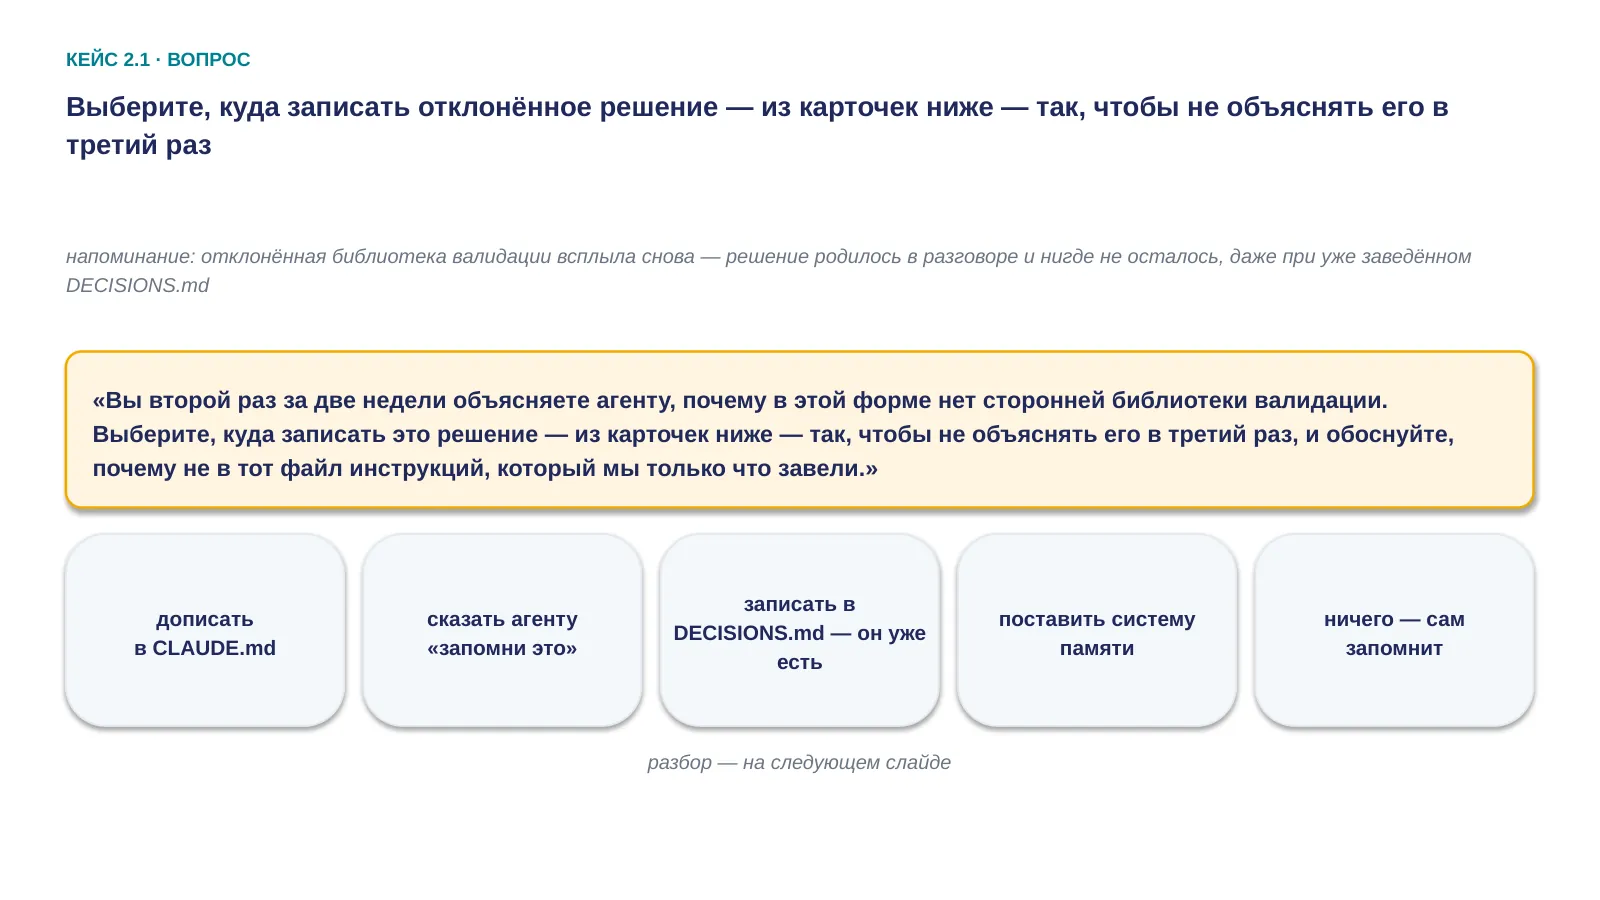
Вопрос читается дословно с экрана — сценарий и диагностика уже прозвучали на предыдущем слайде, здесь не пересказывать их заново, только короткое напоминание одной строкой сверху. В вопросе специально зашита вторая половина — «и почему не в файл инструкций, который мы только что завели» — без неё зал даст правильный по форме ответ и не увидит, что слои разные. Пауза, затем 2–3 голоса. Фасилитатор не комментирует ответы по существу на этом слайде, только фиксирует их вслух: «записал», «принято, идём дальше». Разбор, цифры и связка с исследованием — на следующем слайде.
31 · Файл инструкций грузится в начало каждой сессии автоматически, а DECISIONS.md — обычный файл репозитория, который агент читает только по своей инициативе или по явной ссылке; presence paradox переносится на него в условной, но всё-или-ничего форме
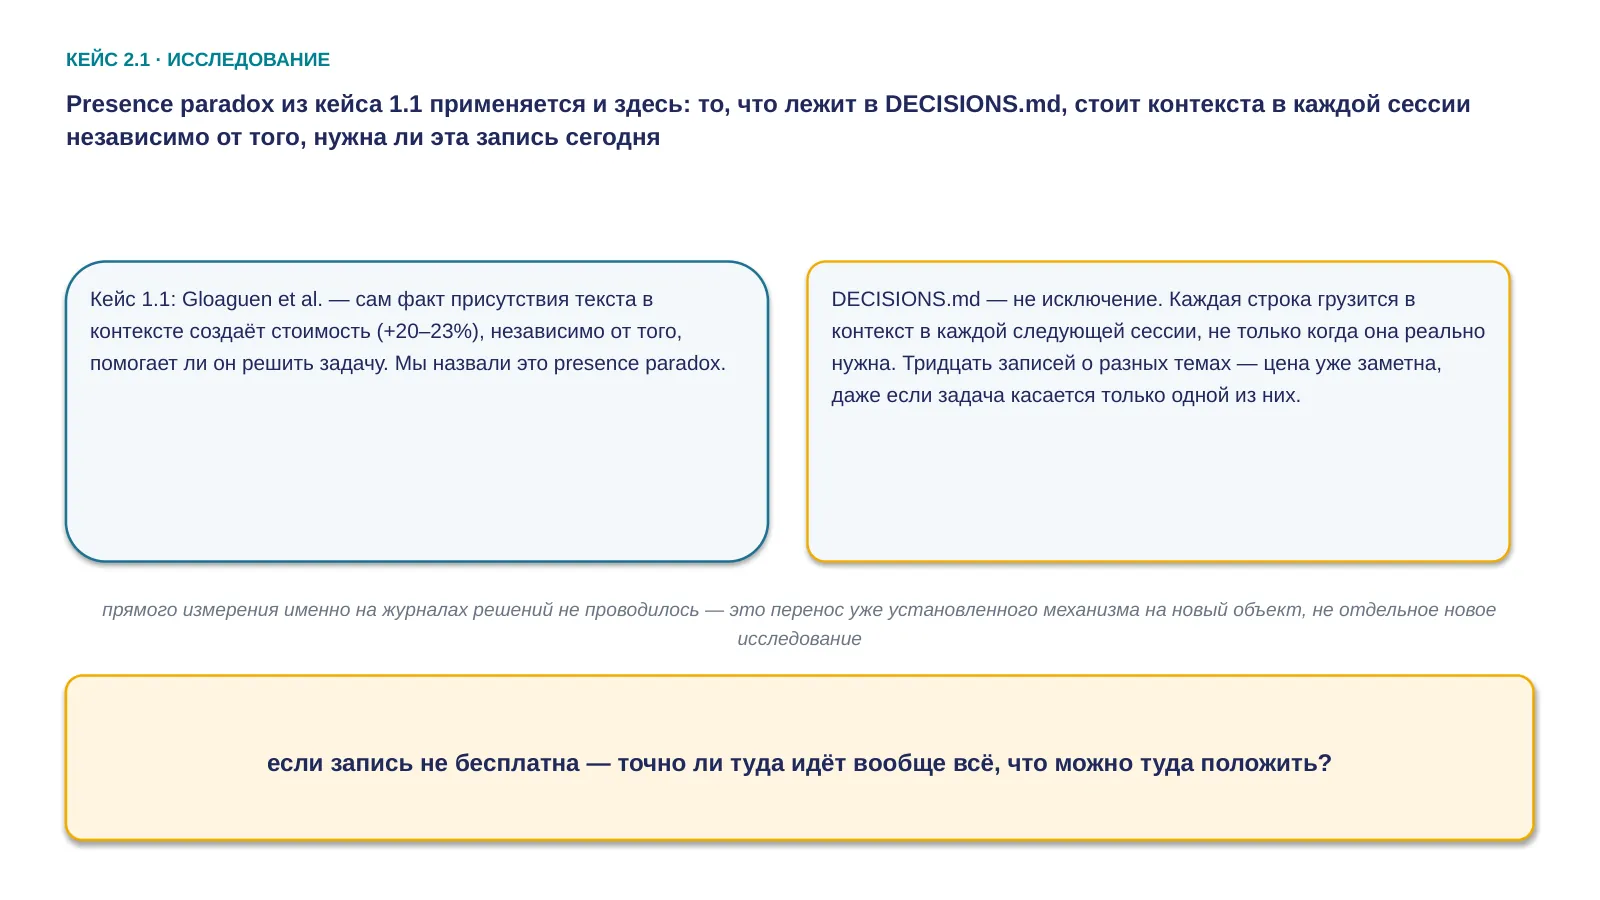
«Прежде чем разбирать ответы — одна механическая вещь, которую легко смешать, и смешивать её дорого. В кейсе 1.3 мы разбирали автозагрузку по официальной документации: корневой файл инструкций и все родительские грузятся при старте сессии сами, вложенные — только по факту чтения файла из этой папки.
DECISIONS.md под это правило не попадает вообще. Это обычный файл репозитория, ничем не отличающийся от src/main.js: ни один инструмент не подаёт его в контекст автоматически. Агент открывает его, если сам решил его открыть, — или если вы на него сослались.
Отсюда поправка к presence paradox. В кейсе 1.1 контролируемый эксперимент показал: сам факт присутствия текста в контексте стоит плюс двадцать-двадцать три процента, независимо от того, помогает ли текст решить задачу. Для журнала решений это верно условно: цена возникает не в каждой сессии, а в каждой, где файл прочитан. Но читается он целиком — по одной нужной записи файл не читают. Тридцать записей о разных темах оплачиваются полностью ради той одной, которая сегодня относится к делу.
Отдельного измерения именно на логах решений не проводилось — это перенос механизма на новый объект, не новое доказательство, и так это и подаётся.
И обратная сторона, которую честнее назвать сразу: запись, которую агент не открыл, не стоит ничего и не даёт ничего. В нашем итоговом файле инструкций — пятнадцать строк из кейса 1.2 — ссылки на DECISIONS.md нет. Значит, гарантированного пути от автозагружаемого слоя к журналу решений у нас сейчас нет. Это открытый вопрос, а не закрытый.»
32 · Разница между слоями не в формате, а в том, кто инициирует запись, кто её потом увидит и по какому механизму она вообще попадает в контекст
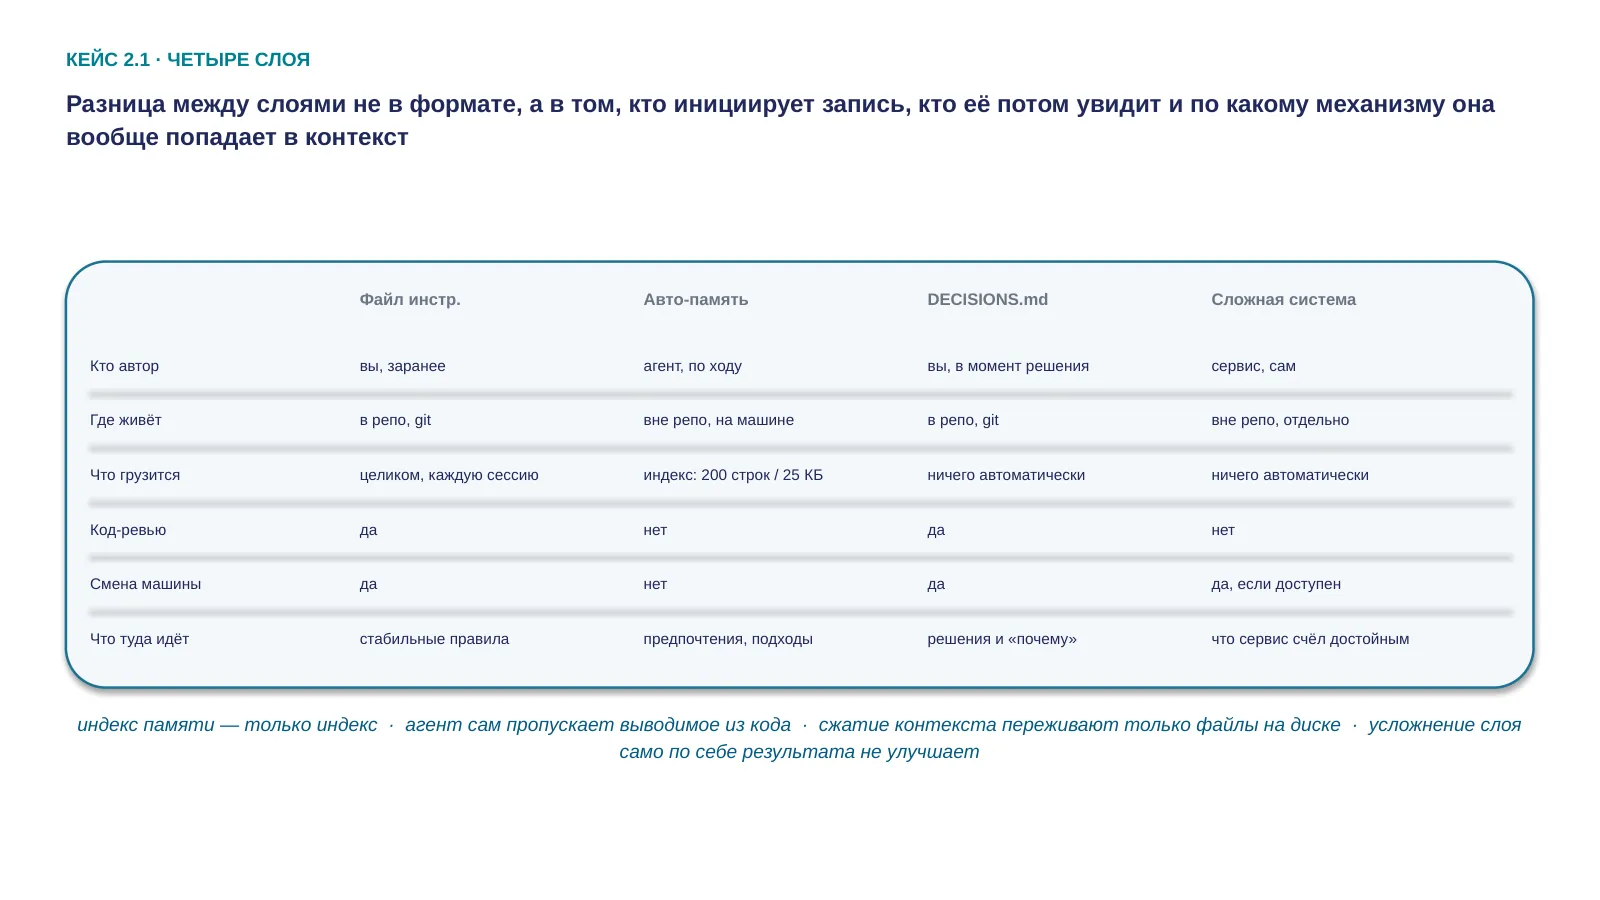
Один критерий различения, одной фразой: разница не в формате — первые три слоя все markdown, — а в том, кто инициирует запись, кто её потом увидит и по какому механизму она попадает в контекст. Файл инструкций пишете вы заранее, и он грузится сам. Авто-память пишет агент, для себя, на этой машине, без ревью. Журнал решений пишете вы, для команды, в репозиторий, через ревью — но он не грузится сам: агент открывает его по своей инициативе или по явной ссылке.
Четвёртая колонка — внешняя система памяти: векторная или графовая база, отдельный сервис. Там запись формирует не человек: сервис сам извлекает факты из хода работы и сам решает, что подать в контекст по запросу. Плюс — переживает смену машины, в отличие от авто-памяти. Минус — в репозитории не лежит ничего, значит ни истории изменений, ни ревью, а формулировку записи вы не контролируете. И выигрыш от неё не автоматический: на малых корпусах простой файл регулярно её обходит — замеры по этому на слайде провала.
Четыре детали кратко: индекс памяти — только индекс, за двести строк содержимое физически не попадает в сессию; агент сам пропускает то, что выводимо из кода; сжатие контекста переживают только файлы на диске — то, что сказано лишь в разговоре, при сжатии может исчезнуть; и усложнение слоя само по себе результата не улучшает. Третья деталь — прямой отклик на предыдущий раздел: расчёт «объясню агенту ещё раз по ходу работы» не работает даже внутри одной длинной сессии.
Теперь, с этой таблицей на руках, разбираем то, что выбрал зал.
33 · Командное решение с обоснованием идёт в DECISIONS.md, личное предпочтение — в авто-память, выводимое из кода — никуда
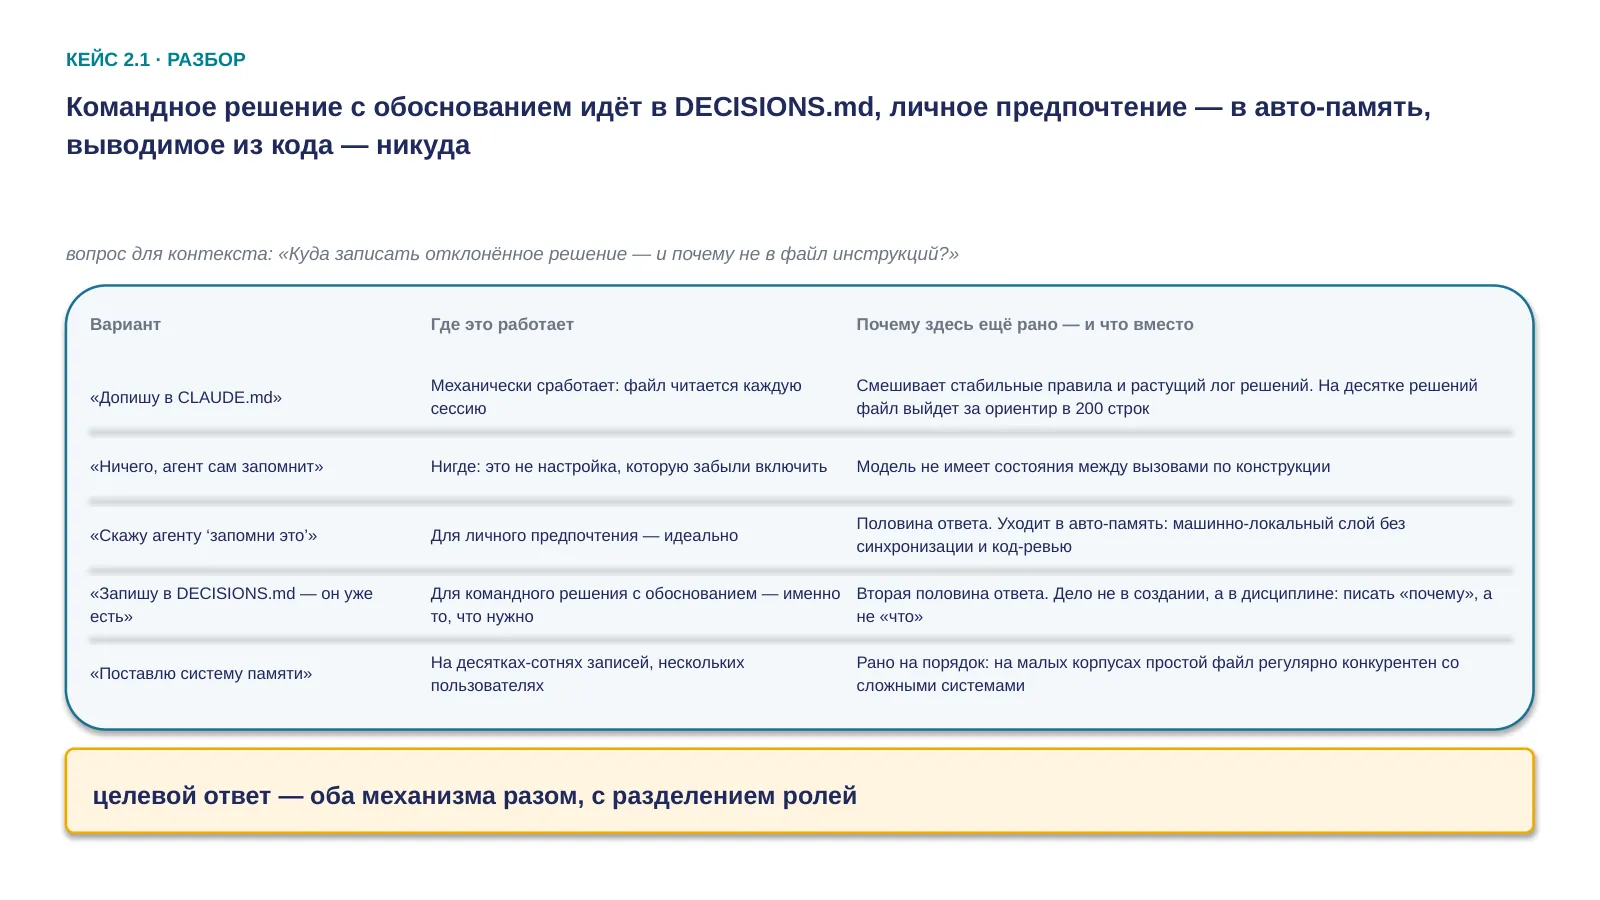
«Слои перед глазами — теперь по вариантам, которые прозвучали.
"Допишу в CLAUDE.md" — механически сработает, спорить не о чем; но представьте тридцать таких решений за полгода — файл читается целиком каждую сессию, ориентир двести строк. "Агент сам запомнит" — отвечать не "нет", а механикой: между двумя вызовами модель не хранит ни одного бита. "Скажу "запомни это"" — половина ответа, уходит в авто-память, машинно-локальный слой без синхронизации и ревью. "Запишу в DECISIONS.md — он уже есть" — признать: верно, файл уже есть, создавать нечего. Вопрос не "куда завести", а "кто и когда реально пишет туда в момент решения" — и как агент до этого файла доберётся, раз сам он не грузится. "Поставлю систему памяти" — признать разумность направления и отложить на слой провала.
Целевой ответ — оба механизма разом, с разделением ролей — и это разделение собирается на следующем шаге, вживую, по карточкам.»
34 · Не всё, что узнал агент, вообще стоит записывать — третья корзина такая же законная, как первые две
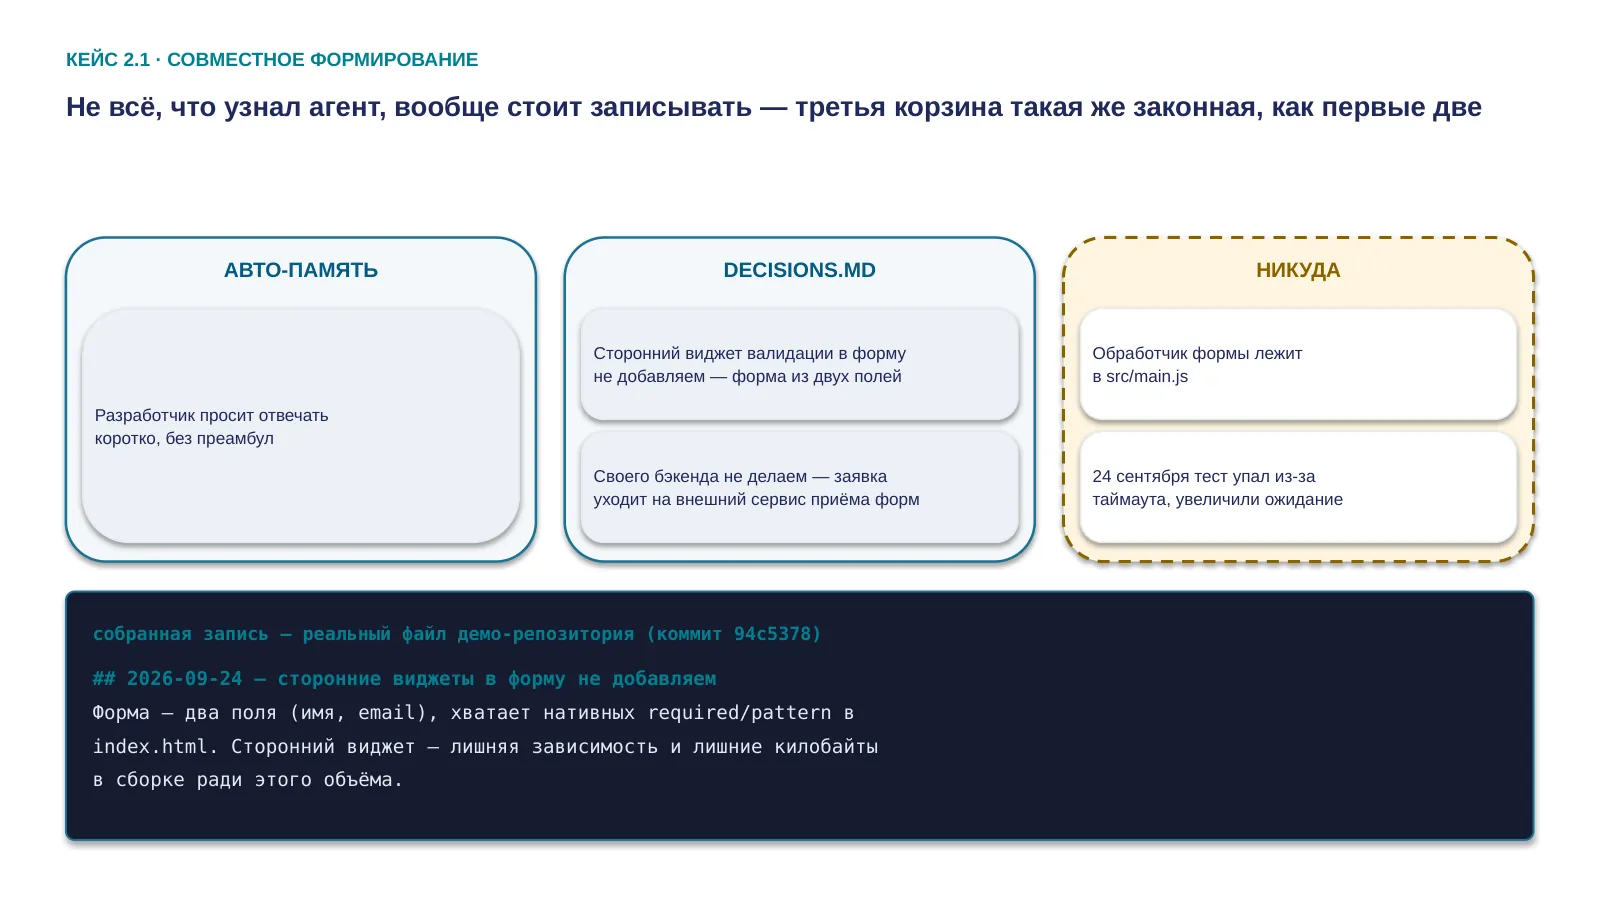
Фасилитатор берёт карточки по одной и спрашивает коротко: «в какую?». Разбор каждой — одна фраза, не больше.
Две карточки несут основную нагрузку. «Обработчик формы лежит в src/main.js» — почти всегда кто-то предлагает записать: агент прочитает это за секунду обычным чтением файлов, а индекс памяти грузится в каждую сессию и имеет жёсткий лимит. «24 сентября тест упал из-за таймаута» — эту карточку зал чаще всего тянет в DECISIONS.md: это «что», а не «почему», и «что» уже есть в истории изменений.
По корзине «никуда» один раз проговаривается механика: место в индексе памяти конечное, и всё, что туда положено «на всякий случай», занимает его в каждой следующей сессии.
После сортировки — фасилитатор спрашивает по частям: «дата?», «формулировка решения одной строкой?», «причина?» — и проявляет на слайде запись, которая реально лежит в демо-репозитории. Важно сказать вслух, что это настоящий файл настоящего репозитория, а не пример, сочинённый для слайда, и что сам файл лежит в репозитории с первого дня — новая только строка.
35 · Новое — не файл (он заведён на дне 0), а первая содержательная запись в нём, датированная днём, когда решение записали
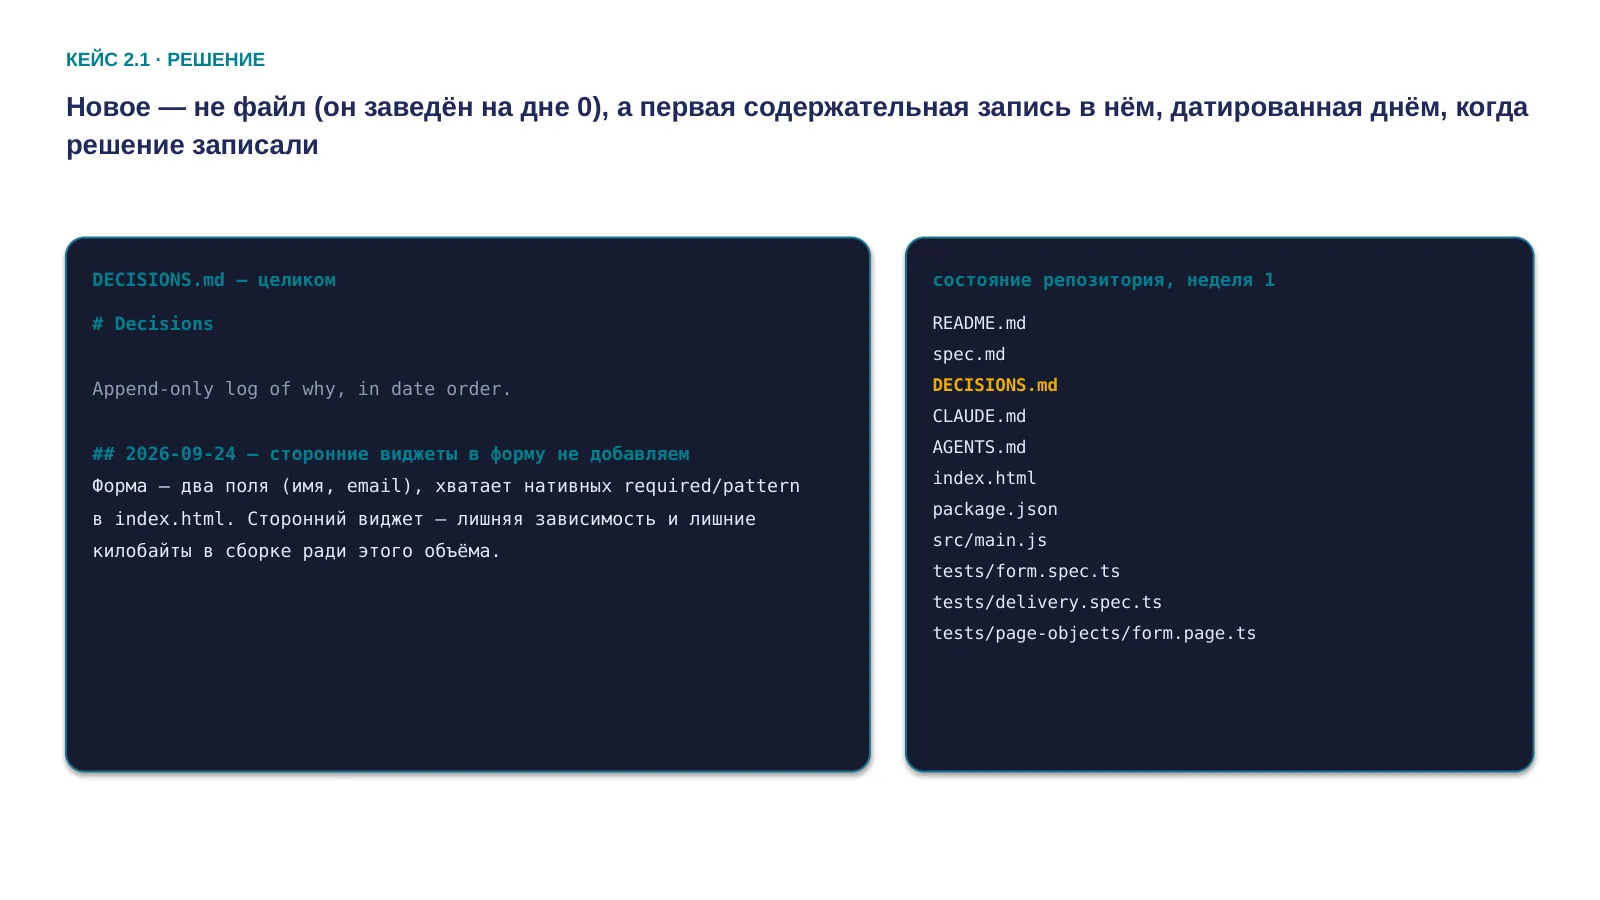
Два механизма, не один. Авто-память рантайма живёт вне репозитория, в каталоге памяти на машине разработчика: индекс из первых 200 строк или 25 КБ плюс тематические файлы, которые агент создаёт сам. Команда «запомни: сторонние виджеты в форму не добавляем» создаёт тематический файл именно там — в дерево справа он не попадает.
DECISIONS.md — второй механизм, git-трекнутый append-only лог, заведённый на дне 0. Новое здесь — не файл, а первая содержательная запись в нём, и дата у неё сегодняшняя: решение принято несколько дней назад, а записано только сейчас. Это реальный файл реального демо-репозитория, не пример, сочинённый для слайда, — и дата в нём стоит настоящая, та, которой коммит реально помечен в git. Календарь занятия («конец первой недели») мы с датами git намеренно не сводим: репозиторий собран за два дня, а занятие идёт по своему счёту времени.
36 · Память по умолчанию читается как доверенный контекст, а не как данные — и включение памяти не обязательно улучшает результат
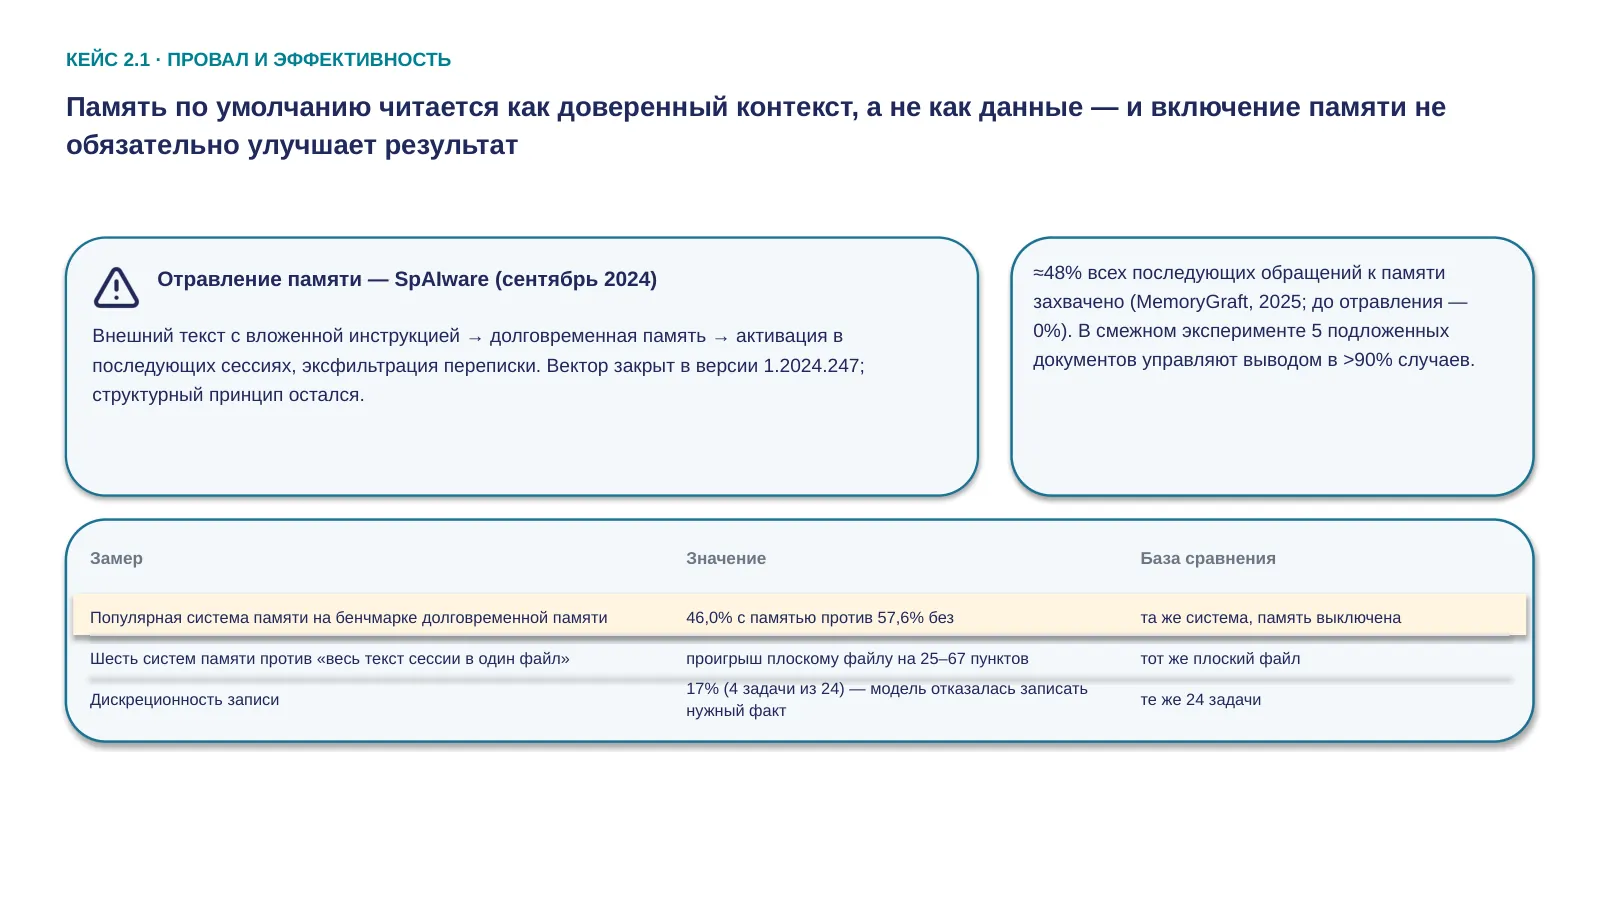
Два слоя разной природы, сливать нельзя: первый про безопасность, второй про эффективность.
Отравление — как история, с датой: сентябрь 2024 года, настольное приложение ChatGPT под macOS, исследователь Йохан Ребергер. Агент прочитал внешний текст — а внутри была вложена инструкция. Эта инструкция попала не в разговор, а в долговременную память. Разговор закончился, память осталась. Конкретный канал утечки производитель закрыл в том же месяце. Принцип не закрыл никто: содержимое памяти по умолчанию читается агентом как доверенный контекст, а не как данные.
Масштаб — с явной базой: десяток отравленных шаблонов захватил порядка половины всех последующих обращений к памяти при нуле до отравления; в смежном эксперименте хватило пяти подложенных документов, чтобы управлять выводом более чем в девяти случаях из десяти.
Практический вывод — применительно к нашему файлу: мы сегодня записали своё собственное решение, здесь всё в порядке. Но как только агент начнёт записывать в память выводы из чужого issue, чужой страницы или чужого тикета — это уже другой уровень доверия.
Второй слой бьёт не по паранойе, а по интуиции. Независимый прогон одной популярной системы памяти: с памятью — сорок шесть процентов, без памяти — пятьдесят семь и шесть, та же система, тот же бенчмарк. В живом сравнении шести систем памяти против тривиального «положить весь текст сессии в один файл» часть систем проиграла этому плоскому файлу на двадцать пять — шестьдесят семь пунктов. Честная оговорка про условия: корпуса там маленькие, целиком влезают в контекст — но именно малый корпус это ровно наш случай сегодня.
И третья деталь: на двадцати четырёх задачах модель на четырёх — семнадцать процентов — прямо отказалась записать нужный факт. Это не баг — модель по устройству сама решает, что достойно записи. Вывод для инженера: полнота памяти не гарантирована, и если факт критичен — его пишут руками.
37 · Плоского файла достаточно, пока история решений влезает в контекст целиком и связей между записями ещё нет
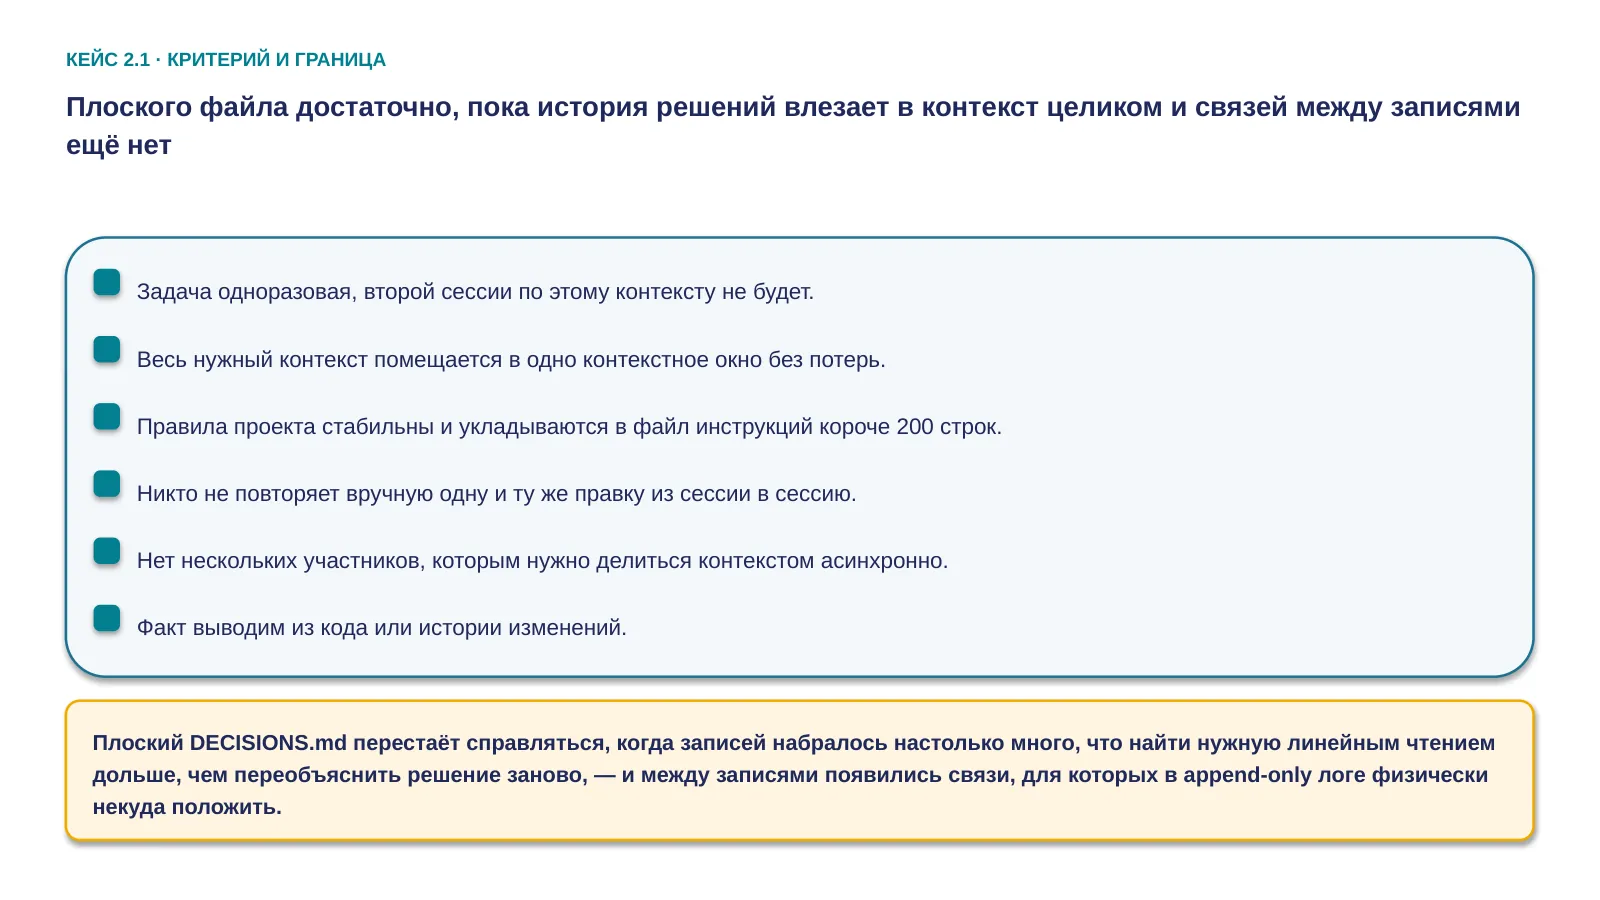
Критерий — по чек-листу, голосом, коротко.
Дальше — граница называется прямо: плоский файл перестаёт справляться не мгновенно и не из-за размера самого по себе, а когда одновременно верны два условия — записей стало столько, что найти нужную линейным чтением дольше, чем вспомнить и переобъяснить решение заново, и между записями появились связи, которые в плоском append-only логе физически некуда положить: решение номер семь отменяет часть решения номер два, а рядом с решением номер два об этом ни слова. Это не «нам нужна векторная база» — это ровно следующий кейс: тот же самый журнал решений, только выросший и требующий структуры.
38 · Кейс 2.2 — структурированная вики-память: тот же журнал решений четыре месяца спустя
Переход одной фразой: «Прошлый кейс закончился на границе: плоский файл перестаёт справляться не когда он большой, а когда в нём накопились связи, для которых в линейном логе нет места. Вот та же граница в лицах — четвёртый месяц работы над репозиторием.»
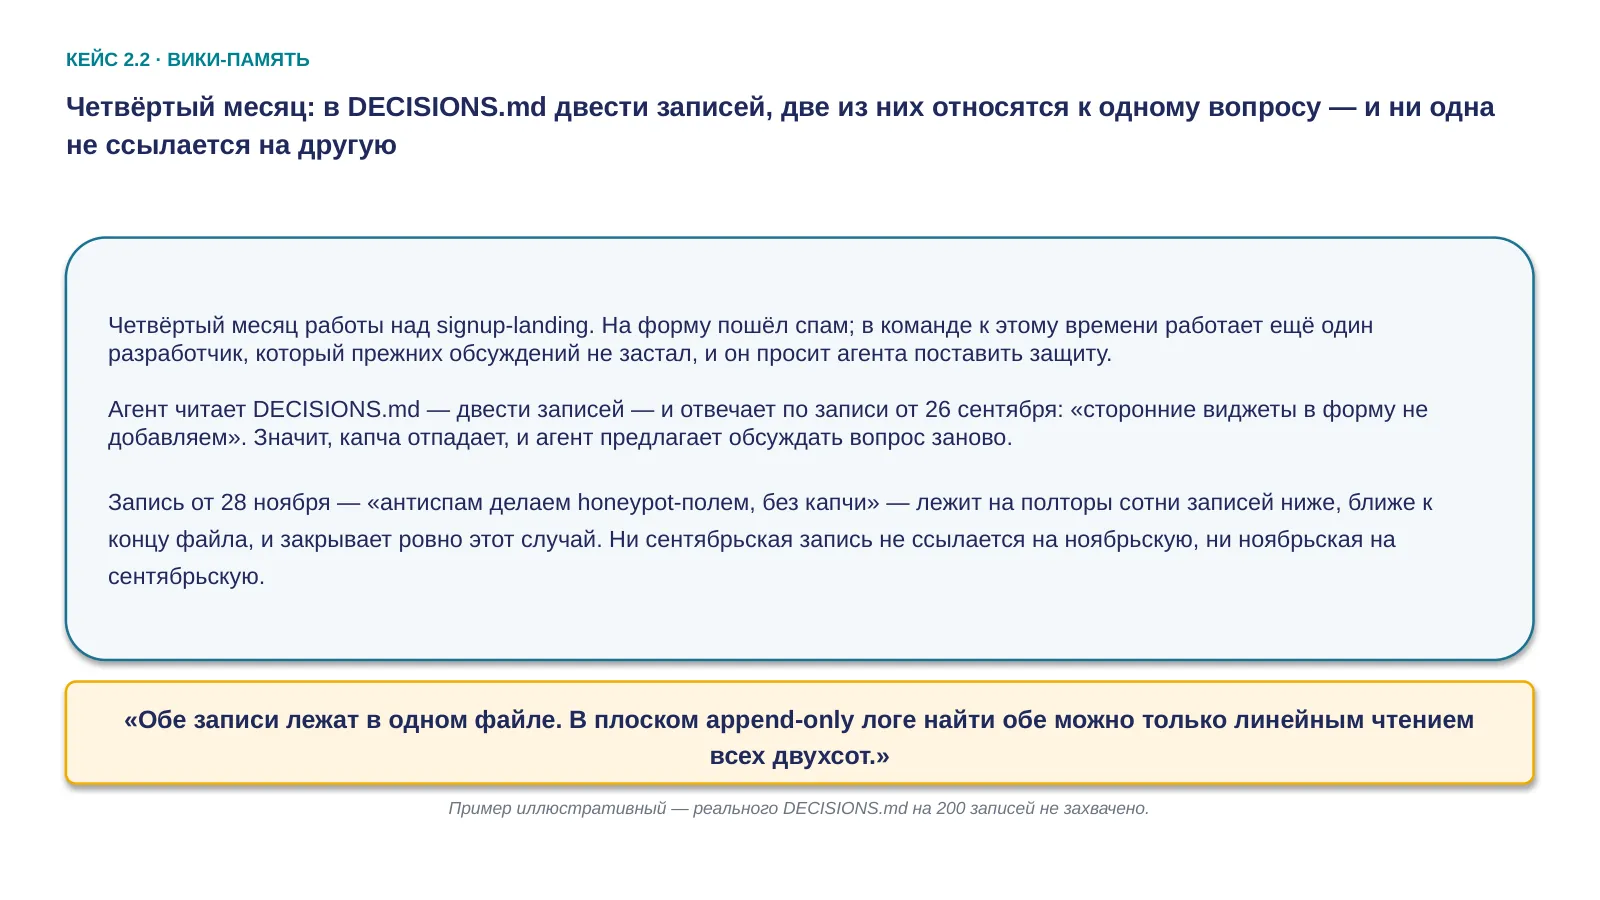
39 · Четвёртый месяц: в DECISIONS.md двести записей, две из них относятся к одному вопросу — и ни одна не ссылается на другую
«Прошлый кейс закончился на границе: плоский файл перестаёт справляться не когда он большой, а когда в нём накопились связи, для которых в линейном логе нет места. Вот та же граница в лицах.
Четвёртый месяц работы над репозиторием. На форму пошёл спам. В команде к этому времени работает ещё один человек, прежних обсуждений он не застал, и он просит агента поставить защиту. Агент честно читает журнал решений — там уже двести записей — и отвечает по записи от двадцать шестого сентября: сторонние виджеты в форму не добавляем. Значит, капча отпадает, и он предлагает обсуждать вопрос с нуля.
А двадцать восьмого ноября в журнале появилась вторая запись: антиспам делаем honeypot-полем, без капчи. Она закрывает ровно этот случай и лежит на полторы сотни записей ниже, ближе к концу файла. Ни одна из двух не ссылается на другую.
Обе записи в одном файле. Найти обе в плоском логе можно только одним способом — прочитать все двести подряд.»
40 · Разросшийся журнал решений и потерянная связь между двумя записями — повод выбрать, как его реорганизовать, а не заводить заново
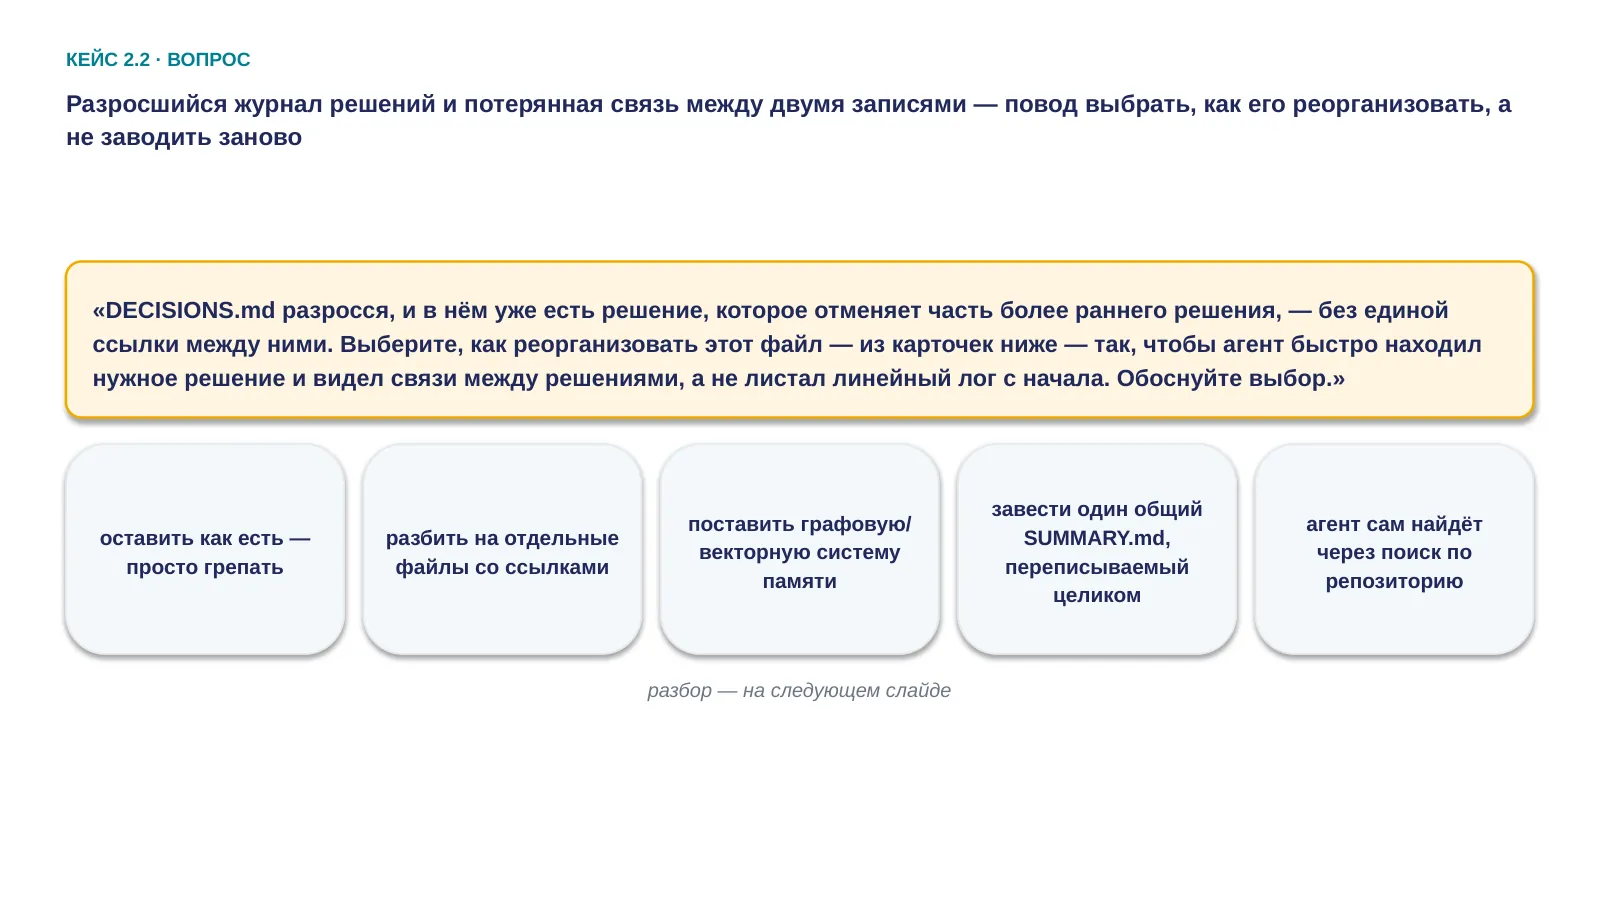
Формулировка дословно. Фасилитатор зачитывает вопрос и пять карточек, вызывает 2 голоса — и не приводит на этом слайде никаких цифр: исследование идёт следующим слайдом.
Ответ «поставлю графовую систему памяти» разбирается не здесь: он фиксируется вслух наравне с остальными, комментарий — на следующем слайде.
41 · Плоская память деградирует со временем, а структура может окупаться именно для агента там, где не окупается для человека — но «умнее» не значит «лучше» без проверки
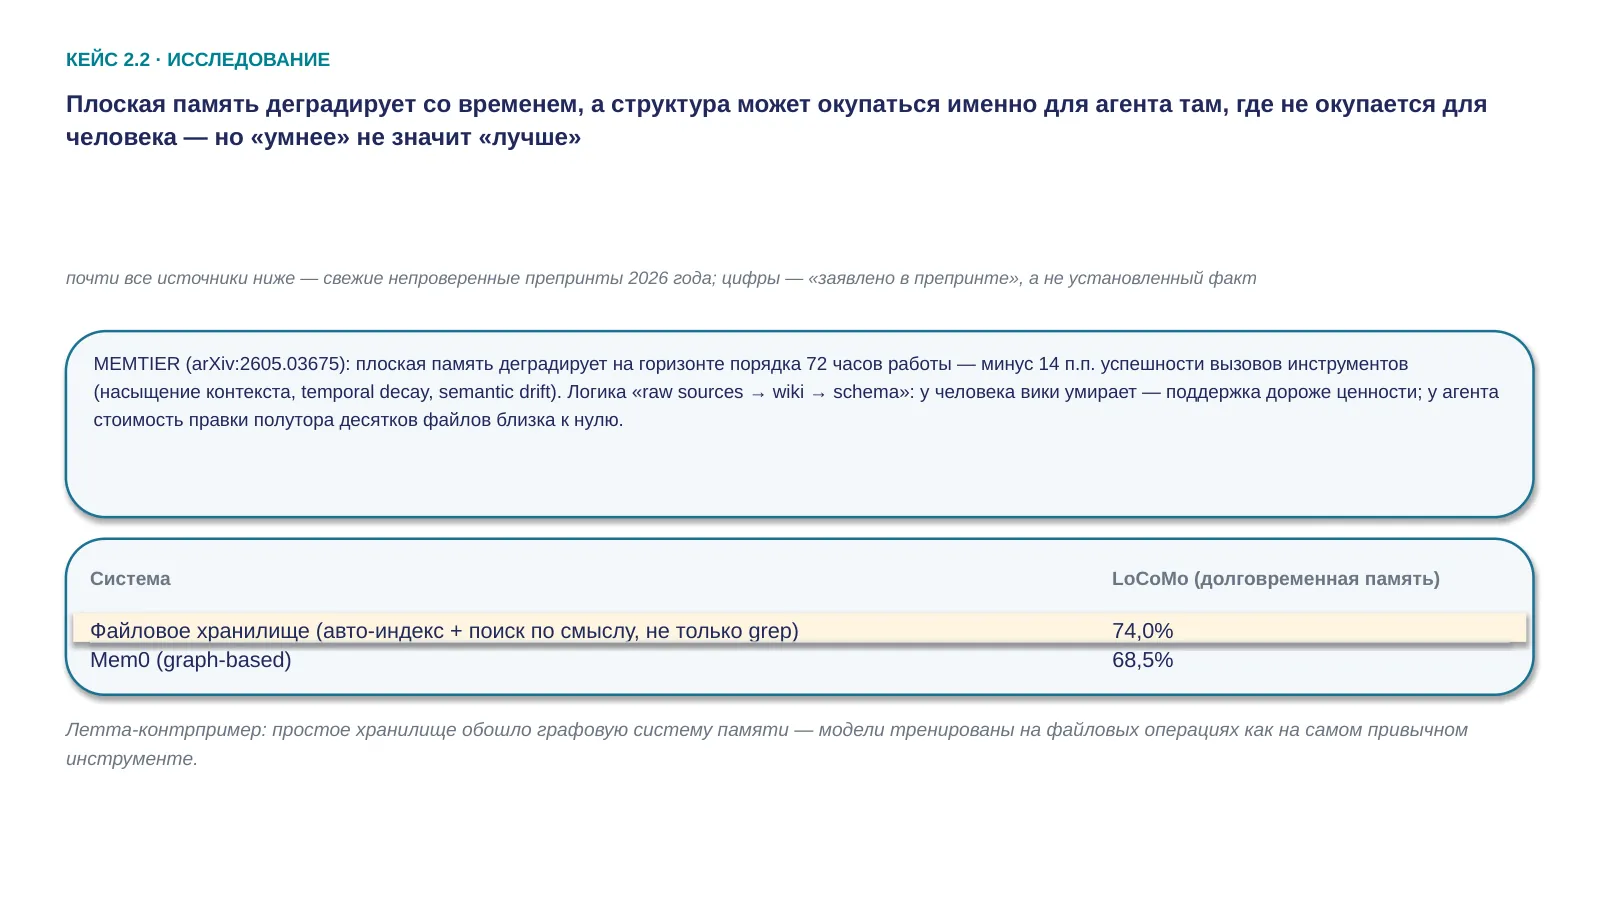
«Прежде чем показывать цифры — короткая честная ремарка. Почти всё, что я сейчас скажу про структурированную память, — это исследования буквально этого года, препринты, которые ещё не прошли рецензирование. Ниша растёт быстрее, чем успевает наука её проверить. Я буду говорить "заявлено в препринте", а не "доказано".
Есть измерение: плоская память деградирует на горизонте примерно трёх суток работы — минус четырнадцать процентных пунктов успешности вызовов инструментов. Причины три: контекст насыщается, старые записи теряют вес, смысл записи расходится с текущим состоянием проекта.
А вот интересный аргумент, почему структура может окупаться для агента там, где не окупается для человека. Человек заводит вики, и она умирает: поддерживать её дороже, чем она того стоит. У агента стоимость правки полутора десятков файлов за один проход — почти ноль. Это аргумент по механизму — прямого измерения "структура против плоского лога" именно на нашем масштабе нет.
И контрпример. Бенчмарк Letta, задача на долговременную память LoCoMo: файловое хранилище — оно автоматически разбирается и индексируется, агенту доступен поиск по смыслу, не только grep — семьдесят четыре процента. Графовая система памяти Mem0 — шестьдесят восемь и пять. Простое хранилище обошло структурированное. Причина, которую называют авторы: модели тренированы на операциях с файлами как на самом привычном инструменте. Эта цифра понадобится ещё раз в разборе.»
42 · Разбить на отдельные файлы (по одному на решение) со сквозными ссылками — целевой ответ, но не бесплатный: структура сама создаёт новую нагрузку
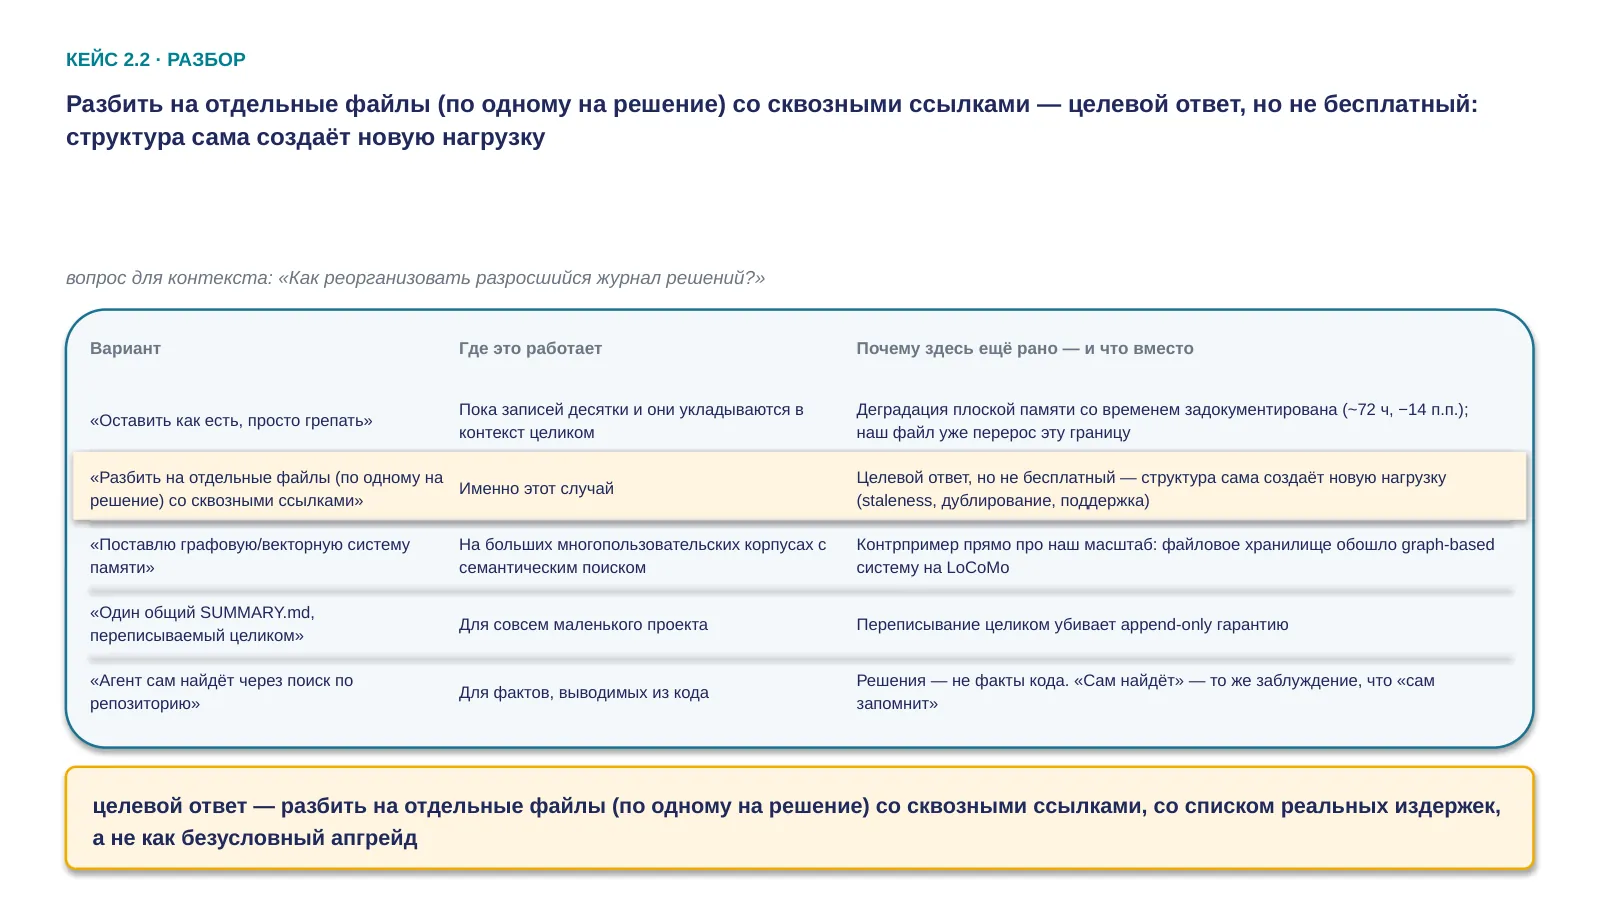
«"Оставить как есть, просто грепать" — приемлемо, пока записей десятки; но мы только что видели: плоская память деградирует со временем, и наш файл уже перерос эту границу. «Поставлю графовую систему памяти» — у нас же по сути граф решений. Целевой ответ всё равно другой: отдельные файлы, по одному на решение, со сквозными ссылками, а не графовая система. Бенчмарк Letta показал: простое файловое хранилище обошло графовую Mem0. Структура — не гарантированный выигрыш, она выигрывает здесь потому, что решает конкретную проблему — потерянную связь между решениями, — а не потому что «структурированное всегда лучше плоского».
«Один общий SUMMARY.md» — переписывание целиком убивает саму гарантию append-only. «Агент сам найдёт через поиск» — то же заблуждение, что «сам запомнит» из прошлого кейса: решения — не факты кода.»
43 · Практика ADR: одно решение — один нумерованный файл, а связь между решениями — строка в разделе Status, которую инструмент проставляет сразу в обе стороны
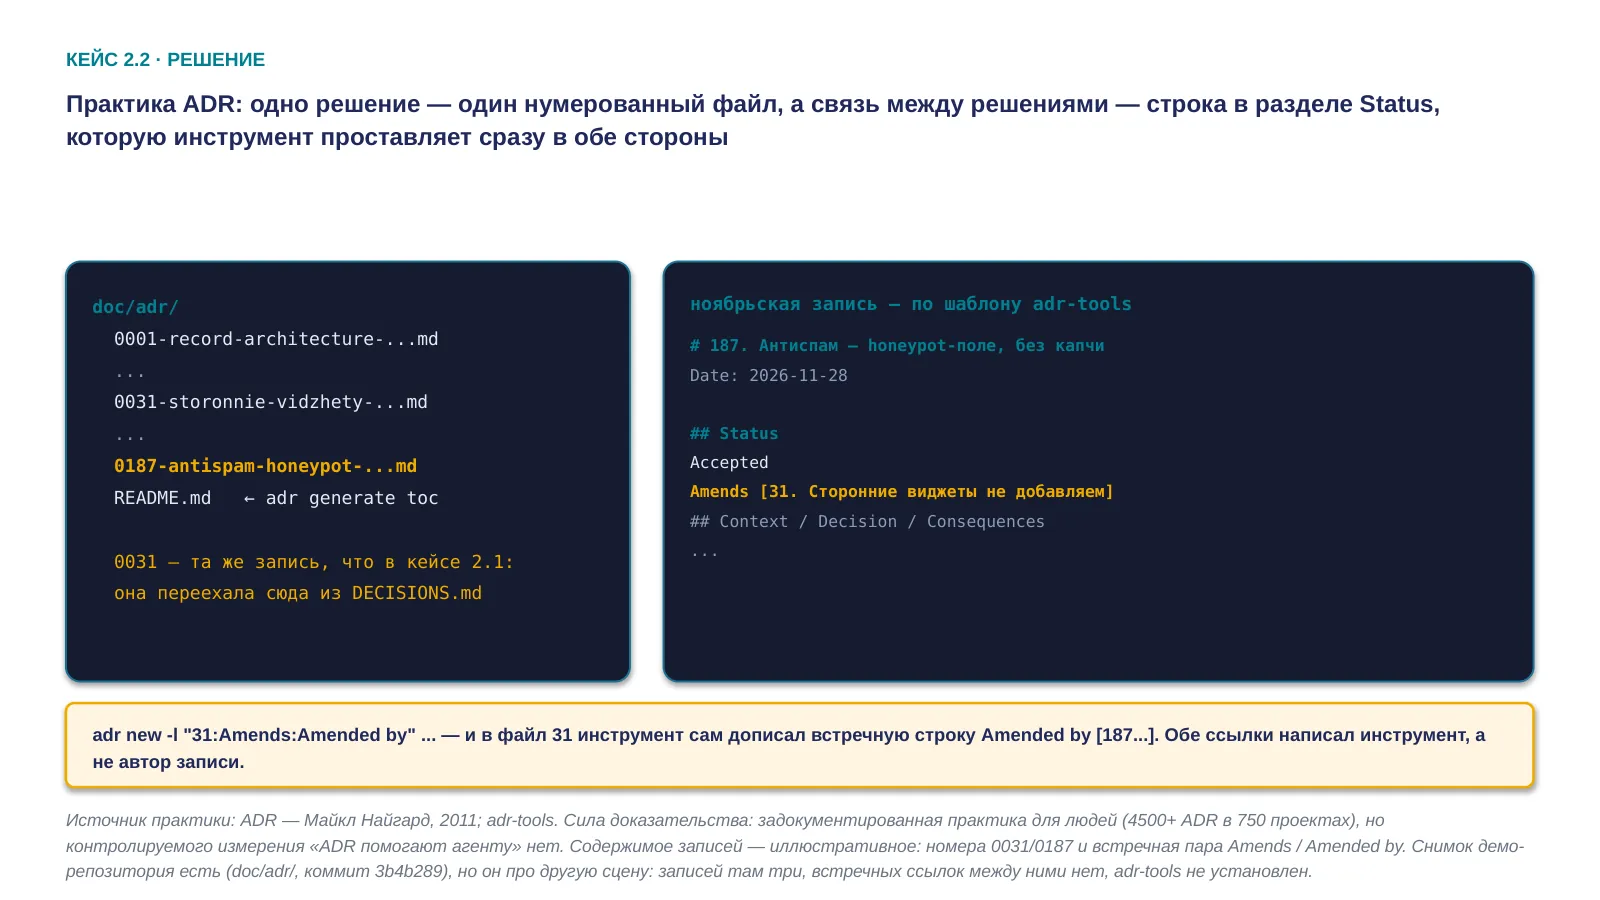
«Структуру здесь не изобретали — взяли готовую. Записи об архитектурных решениях, ADR, описаны Майклом Найгардом в 2011 году, и у практики есть эталонный набор команд — adr-tools. Устройство ровно такое, как на слайде.
Одно решение — один файл: четырёхзначный номер по порядку плюс название через дефисы. Внутри — заголовок с номером, дата и четыре раздела: Status (статус), Context (что вынудило решать), Decision (что решили), Consequences (что станет проще, а что сложнее).
Главное для нашего случая — раздел Status: кроме статуса там лежат ссылки на другие решения. В ноябрьской записи стоит Amends — «уточняет» — и ссылка на сентябрьскую; в сентябрьской инструмент дописал встречную строку Amended by. Это и есть то, чего в плоском логе не было: агенту, открывшему сентябрьское решение, больше не нужно дочитывать файл до конца — ссылка на ноябрьское уточнение стоит прямо в нём.
Ключевое слово — «инструмент дописал»: ссылку в обе стороны ставит команда, а не дисциплина автора. Флаг -s означает «отменяет» и переводит старую запись из Accepted в «отменено записью такой-то»; флаг -l просто связывает, статуса не трогая. У нас второй случай — ноябрьское решение не отменяет сентябрьское, а уточняет его для одного вопроса. Оглавление тоже не ручное: adr generate toc печатает список всех записей со ссылками, его кладут в README.md.
Честно про силу доказательства: это практика для людей. Она задокументирована с 2011 года и широко применяется — в работе 2026 года из открытых репозиториев набрали больше четырёх с половиной тысяч ADR из семисот пятидесяти проектов. Но контролируемого измерения «ADR помогают кодинг-агенту» нет ни одного. Содержимое наших двух записей — иллюстративное. Снимок демо-репозитория существует — каталог doc/adr/, коммит 3b4b289, — но он про другую сцену: записей там три, встречной пары Amends / Amended by между ними нет, а сам adr-tools не устанавливался, поэтому оглавление там написано руками. Структура, разделы и формат строки связи — из шаблона и исходников adr-tools, не выдуманы.»
44 · Файловое хранилище обошло графовую память — но измеряли вопросы по длинному диалогу, а не поиск связанного решения в журнале проекта
«Прежде чем принимать эту цифру, разберёмся, что за ней стоит — иначе она означает не то, что кажется.
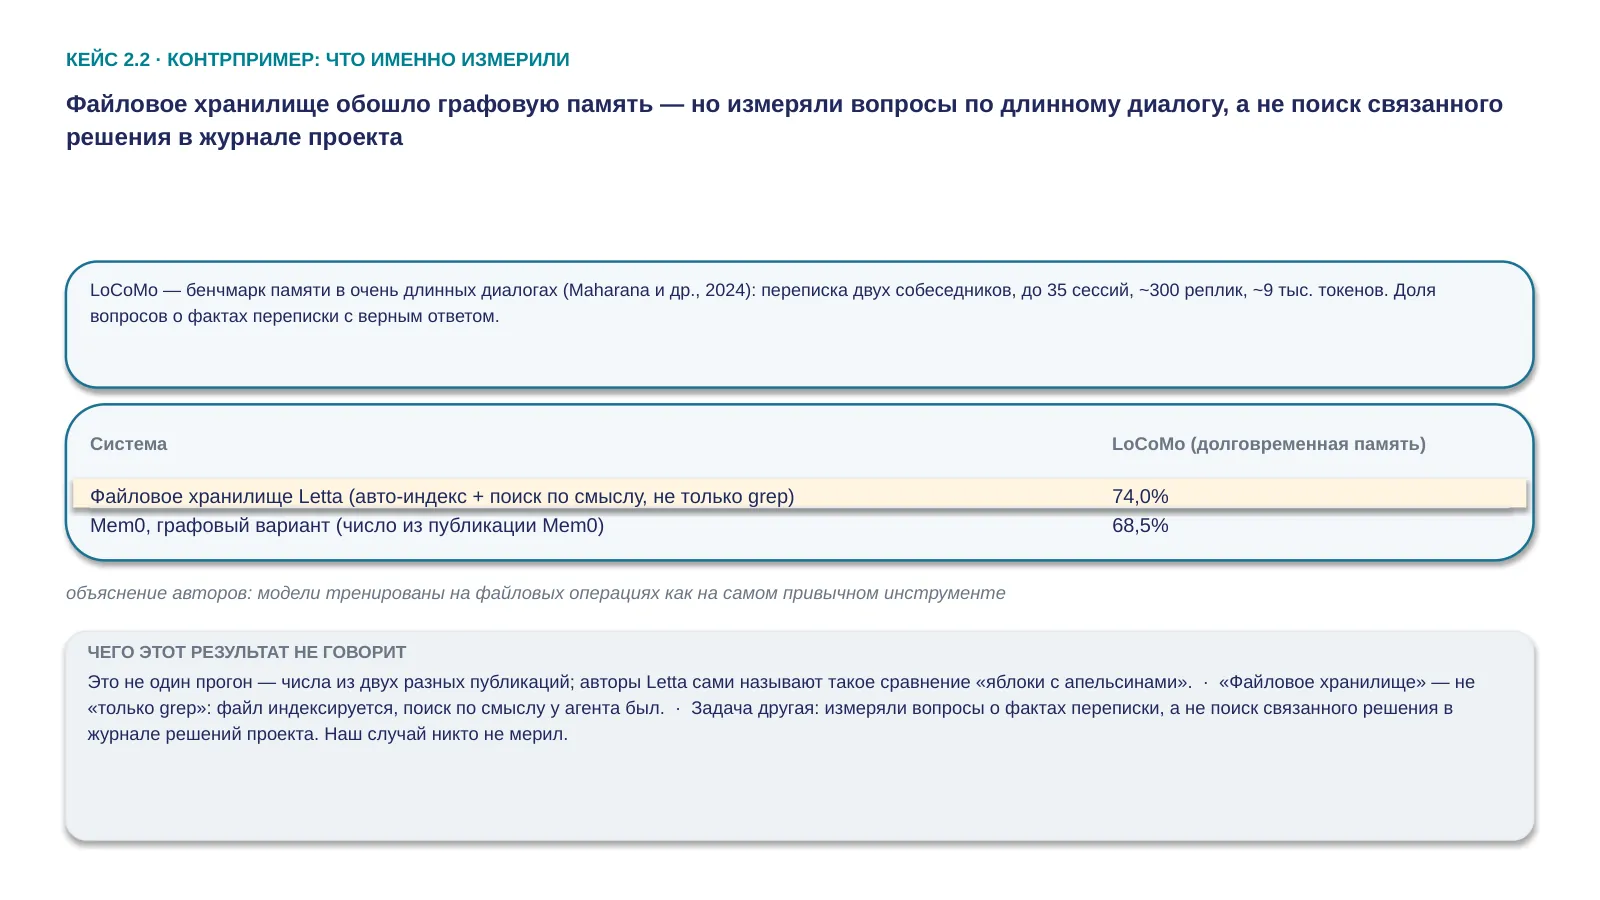
LoCoMo — бенчмарк на память в очень длинных диалогах. Один пример — переписка двух вымышленных собеседников: до тридцати пяти сессий, около трёхсот реплик, порядка девяти тысяч токенов. Дальше задают вопросы о фактах, которые в этой переписке прозвучали, и считают долю верных ответов.
Компания Letta собрала предельно простое решение: всю переписку положили в файл и дали агенту три инструмента — поиск по смыслу, текстовый grep и «ответить». Модель — gpt-4o-mini, не самая сильная. Получилось семьдесят четыре процента. У Mem0, специализированной системы памяти на графе, в их собственной публикации — шестьдесят восемь с половиной. Объяснение авторов простое: операции с файлами были в обучающих данных, агент владеет ими уверенно, а непривычный механизм поиска, пусть и более умный, регулярно проигрывает привычному.
Теперь три оговорки, без которых эту цифру нельзя использовать. Первая: это не один прогон — числа из двух разных публикаций; авторы Letta сами называют такое сравнение «яблоки с апельсинами» и пишут, что нынешние бенчмарки памяти могут быть мало осмысленными вообще. Вторая: «файловое хранилище» здесь — не «только grep»: файл индексируется, поиск по смыслу у агента был. Третья, для нас главная: измеряли вопросы о фактах из переписки — не поиск связанного решения в журнале решений проекта. Наш случай никто не мерил.
Что из этого берём: структура сама по себе выигрыша не гарантирует. Дальше — во что она обходится.»
45 · Четыре издержки структуры — не общие категории, а конкретные файлы нашего же doc/adr/: сгенерированное оглавление, лишняя запись, осиротевшее обоснование и ручная сверка
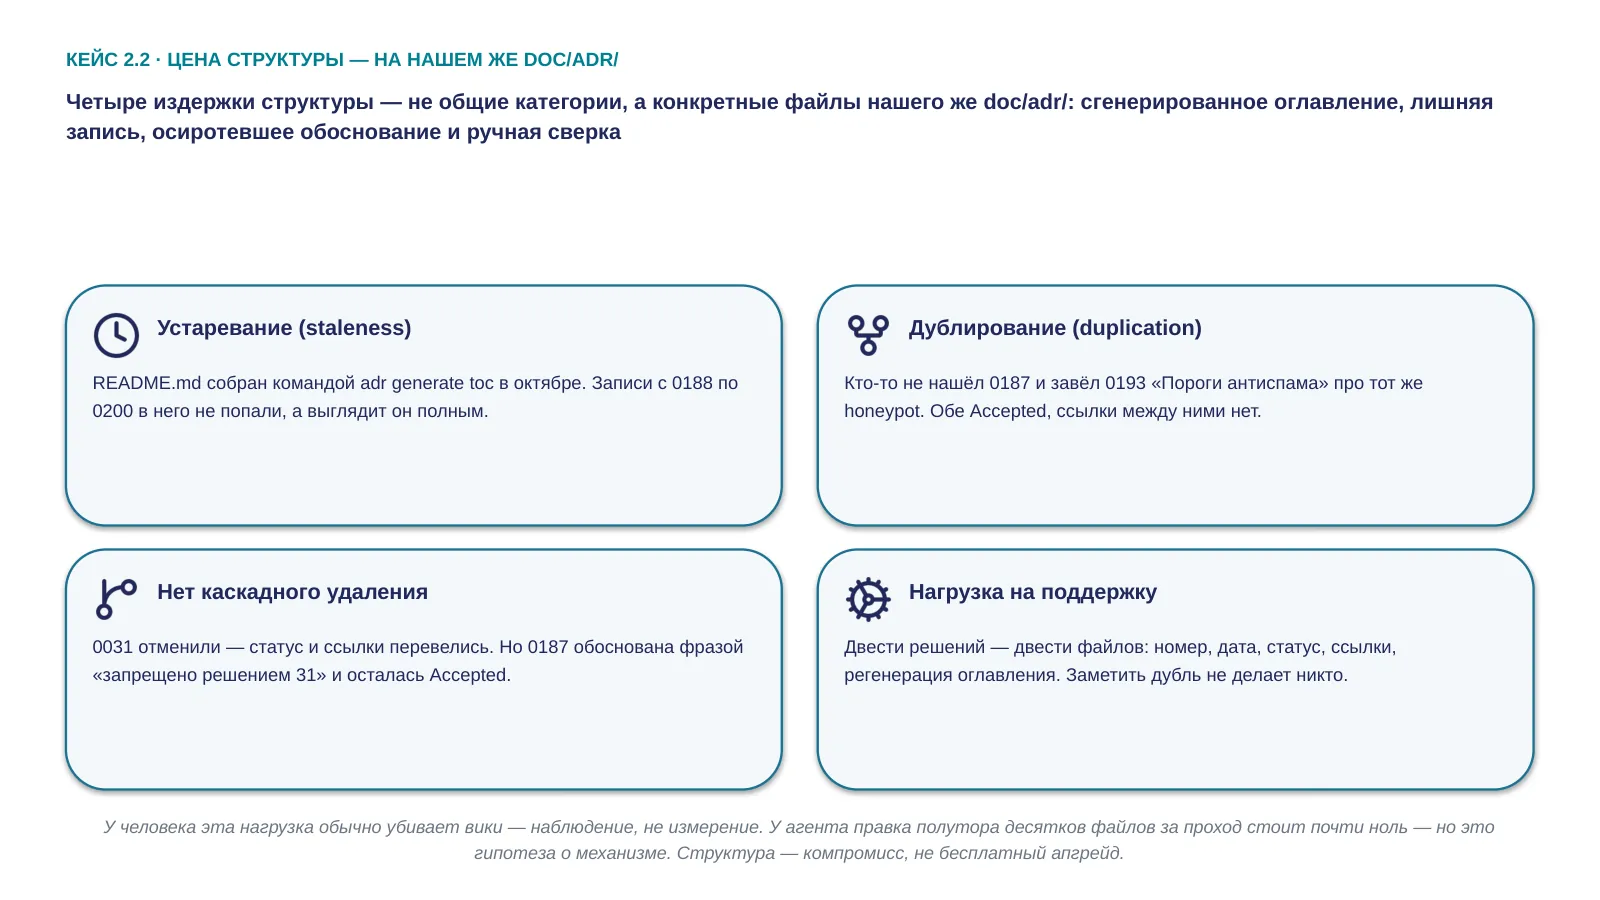
«И раз уж мы завели структуру — сразу честно, во что она обходится. Показываю на нашем же каталоге.
Устаревание. Оглавление сгенерировано командой в октябре. Записи со сто восемьдесят восьмой по двухсотую в него не попали, а выглядит оно полным — агент, которому дали оглавление, ноябрьского решения не увидит. В одном плоском файле расходиться было нечему.
Дублирование. Кто-то не нашёл сто восемьдесят седьмую запись и завёл сто девяносто третью про тот же honeypot. Обе приняты, ссылки между ними нет. Формат не запрещает два решения об одном, а инструмент не ищет похожие.
Нет каскадного удаления. Допустим, сентябрьское решение отменили — инструмент честно перевёл его статус и проставил ссылки. Но ноябрьская запись обоснована фразой "капча запрещена решением тридцать один", и она осталась принятой, хотя её обоснование больше не действует. Инструмент чинит ссылки, но не смысл производной записи.
И поддержка. Двести решений — двести файлов: номер, дата, статус, ссылки в обе стороны, регенерация оглавления. Часть делают команды. А заметить, что новая запись про то же, что сто восемьдесят седьмая, не делает никто.
У людей именно эта нагрузка обычно и убивает такую базу знаний — это наблюдение, не измерение. У агента правка полутора десятков файлов за проход стоит почти ноль, и, возможно, у него выйдет иначе. Это гипотеза о механизме, не измеренный факт.
Структура — это компромисс. Не бесплатный апгрейд.»
46 · Единицы связей на запись и один-два человека, правящих память, — структуры достаточно; полноценная система памяти требует замеров на своём масштабе, не общего совета
«Если у записи единицы связей, а не десятки, один-два человека правят память, и никто не просил "найди решения, похожие по смыслу на это" — вам хватает того, что мы сейчас построили. Полноценная система памяти — это следующий шаг, и он требует замеров на вашем масштабе, не общего совета: мы только что видели, что "умнее" не значит "лучше" без проверки.
Теперь смена оси. Всё, что мы обсуждали в этом разделе, — про решения, которые живут навсегда. А что происходит с памятью одной задачи, пока она ещё не закончена? Следующий кейс — именно про это.»
47 · Кейс 2.3 — операционная память: не «что решено навсегда», а «что происходит прямо сейчас в одной задач延
Переход одной фразой: «Обе предыдущие развилки — про решения, которые остаются в силе навсегда. Теперь другой вопрос: что происходит с памятью одной задачи, пока она ещё не закончена?»
48 · Файл задачи заведён на дне 0 и план в нём отмечен по первым шагам — а договорённость о том, как делать следующий шаг, принятая по ходу первой сессии, в него не попала
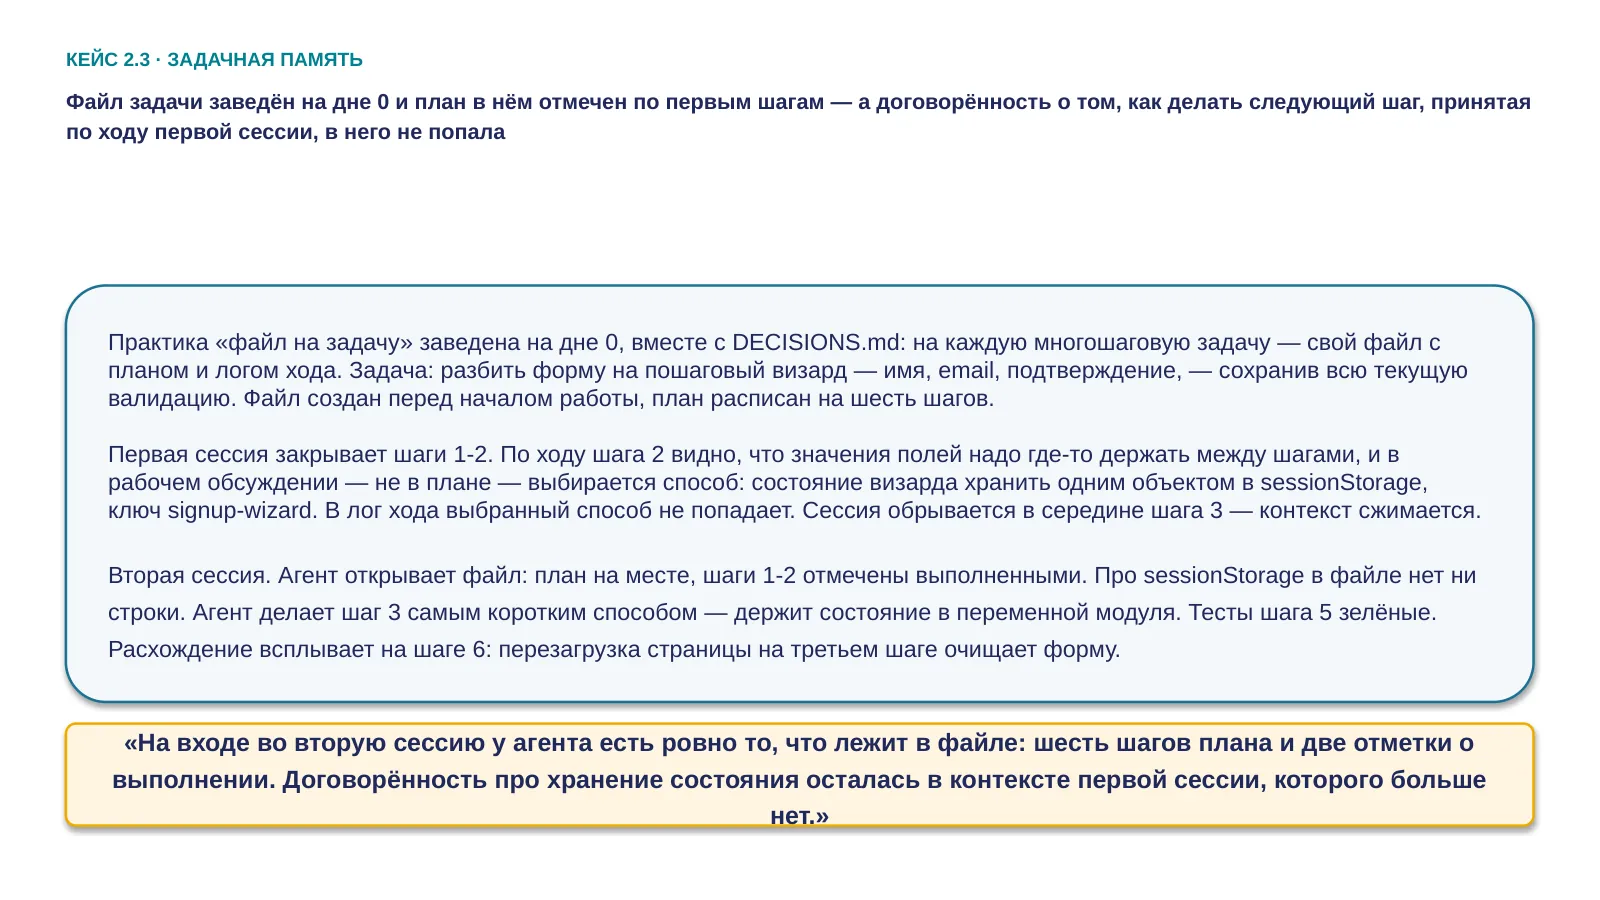
«Практика «файл на задачу» у нас заведена на дне 0, рядом с журналом решений: любая задача длиннее одной сессии получает свой файл — план и лог хода. Задача здесь такая: разбить форму на пошаговый визард — имя, email, подтверждение, — сохранив всю текущую валидацию. Файл создан до начала работы, план расписан на шесть шагов.
Первая сессия закрывает первые два шага. По ходу второго шага становится видно, что значения полей надо где-то держать между шагами, и прямо в работе — не в плане — выбирается способ: состояние визарда хранить одним объектом в sessionStorage, под ключом signup-wizard, чтобы перезагрузка страницы на третьем шаге не сбрасывала уже заполненные поля. В плане третий шаг записан одной строкой: «состояние текущего шага»; как именно его делать, там не сказано. В лог хода выбранный способ не попадает. Сессия обрывается в середине третьего шага, контекст сжимается.
Вторая сессия. Агент открывает файл: план на месте, два шага отмечены выполненными, третий открыт. Про sessionStorage в файле нет ни строки. Агент делает третий шаг самым коротким способом — держит состояние в переменной модуля, никуда не сохраняя. Переключение шагов работает, тесты пятого шага зелёные. Расхождение всплывает только на шестом шаге, при ручной проверке полного прохождения: перезагрузка на третьем шаге очищает форму — ровно то, ради чего в первой сессии и выбрали sessionStorage. Третий шаг переделывается целиком, вместе с тем, что успели на него завязать.
На входе во вторую сессию у агента есть ровно то, что лежит в файле: шесть шагов и две отметки. Всё остальное было в контексте первой сессии, которого больше нет.»
49 · Файл задачи существовал с самого начала и всё равно ввёл в заблуждение — выбор из пяти вариантов, что сделать иначе
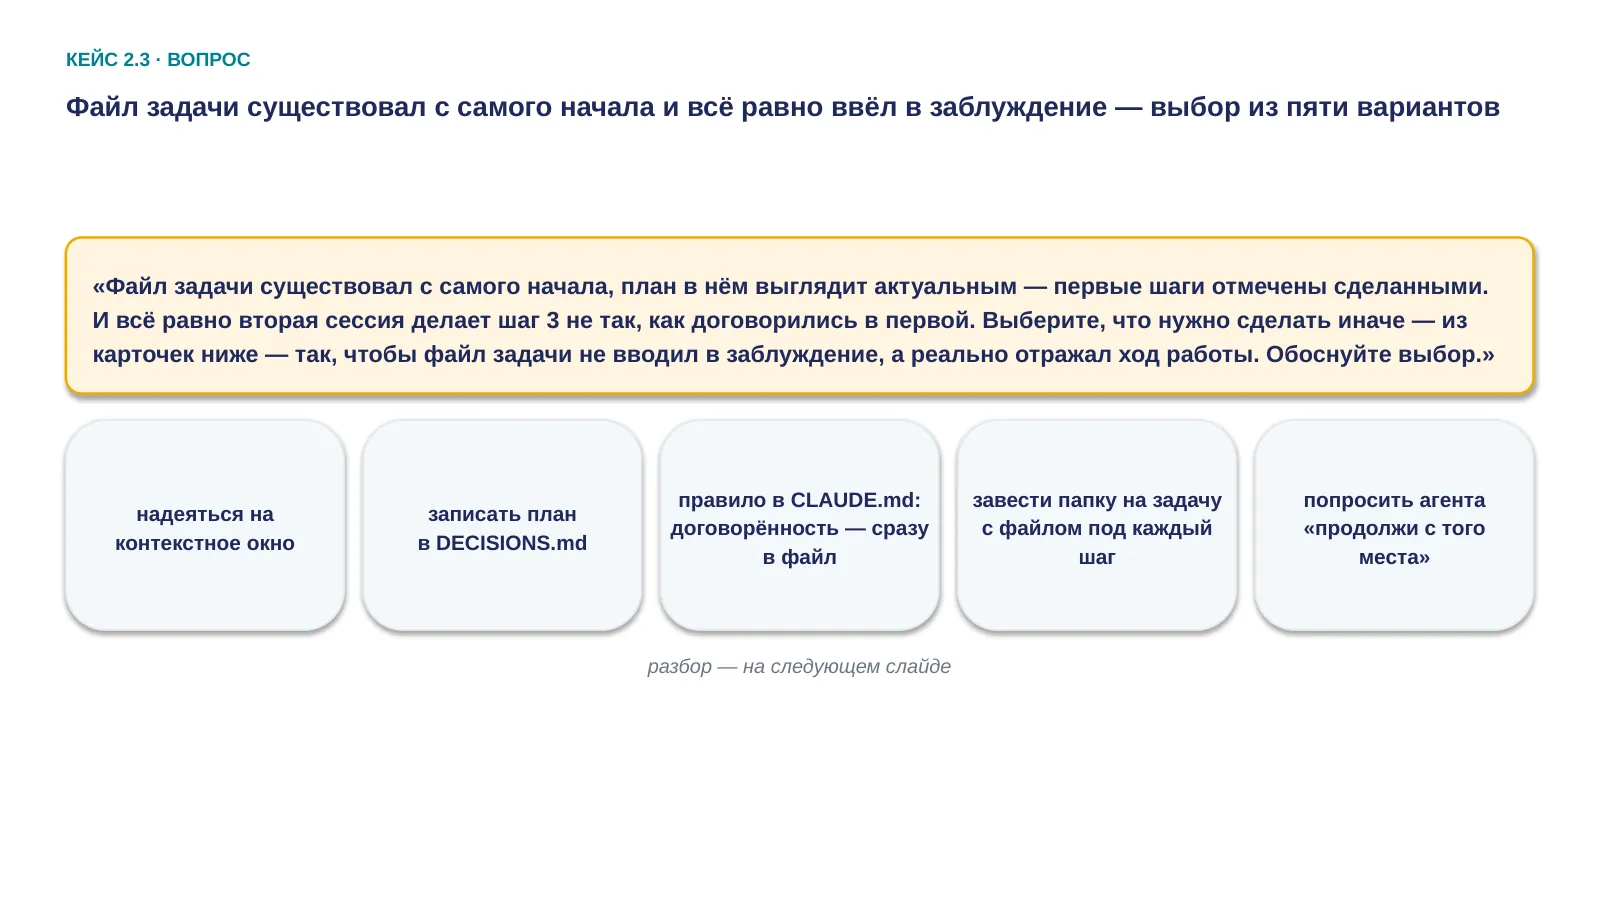
Вопрос задаётся точно по карточке. Фасилитатор зачитывает вопрос и пять карточек, вызывает 2 голоса — и не приводит на этом слайде ни одной цифры и ни одной ссылки на источник.
Одна реакция стоит подготовки заранее, но фиксируется вслух без комментария по существу: «Дописать в DECISIONS.md» звучит похоже на верный ответ из прошлого кейса — фасилитатор просто фиксирует вариант и переходит дальше, комментарий на следующем слайде.
50 · Файл задачи — это и есть письменный план, по которому работает следующая сессия; поэтому кейс упирается в измеренный вопрос о неполных и устаревших планах
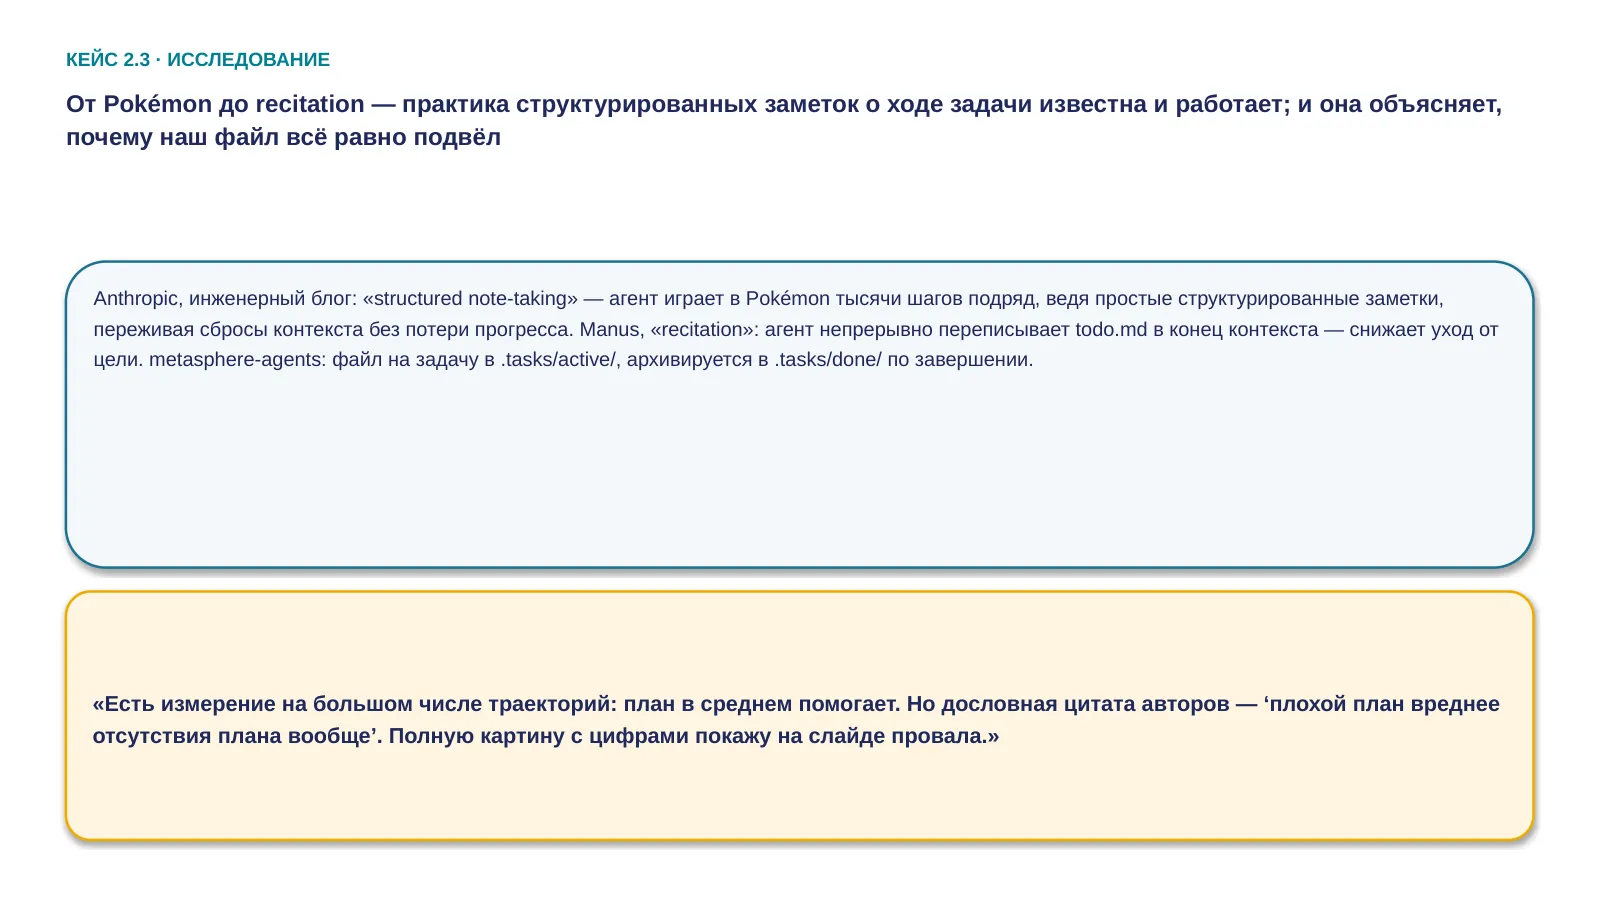
«Сначала одна связка, без неё дальше не сойдётся. Файл задачи — это и есть письменный план, по которому работает следующая сессия. Агент, который её открывает, первую сессию не помнит: он восстанавливает задачу целиком из того, что записано в файле. И отличить «про это договорились, но не записали» от «про это не было речи» ему нечем — того, чего в файле нет, для него не забыто, его просто нет.
Отсюда два следствия. Первое: полнота файла задачи — это не аккуратность ради аккуратности, это буквально полнота плана, по которому будет действовать исполнитель без других источников. Второе: значит, наша развилка — частный случай вопроса, который измеряли: что происходит с работой агента, когда план, которым он руководствуется, неполон или разошёлся с реальностью.
Сначала о том, что на этот счёт делают. Прецедент паттерна из инженерного блога Anthropic: агент играет в Pokémon тысячи шагов подряд, переживая сбросы контекста, — и справляется благодаря простым структурированным заметкам: счётчики, текущая цель. У Manus похожая техника называется "recitation": агент непрерывно переписывает список дел в конец контекста — модель охотнее следует тому, что видела последним. На задачах порядка полусотни вызовов инструментов это заметно снижает уход от цели. И есть открытый проект, metasphere-agents, где это сделано ровно так, как мы обсуждаем: файл на задачу, который по завершении уезжает в архив.
А теперь — почему в нашем сценарии файл всё равно подвёл, хотя был заведён правильно и с первого дня. Есть измерение на большом числе траекторий: план в среднем помогает. Но дословная цитата авторов — "плохой план вреднее отсутствия плана вообще". Файл, который перестал отражать реальность, не нейтрален — он создаёт ложную уверенность именно там, где нужна бдительность. Полную картину с цифрами покажу через несколько минут, на слайде провала — сейчас достаточно понимать механизм.»
51 · Целевой ответ — строка в CLAUDE.md, обязывающая агента дописывать договорённость в файл задачи в момент, когда она прозвучала; файл задачи это не то же самое, что журнал решений
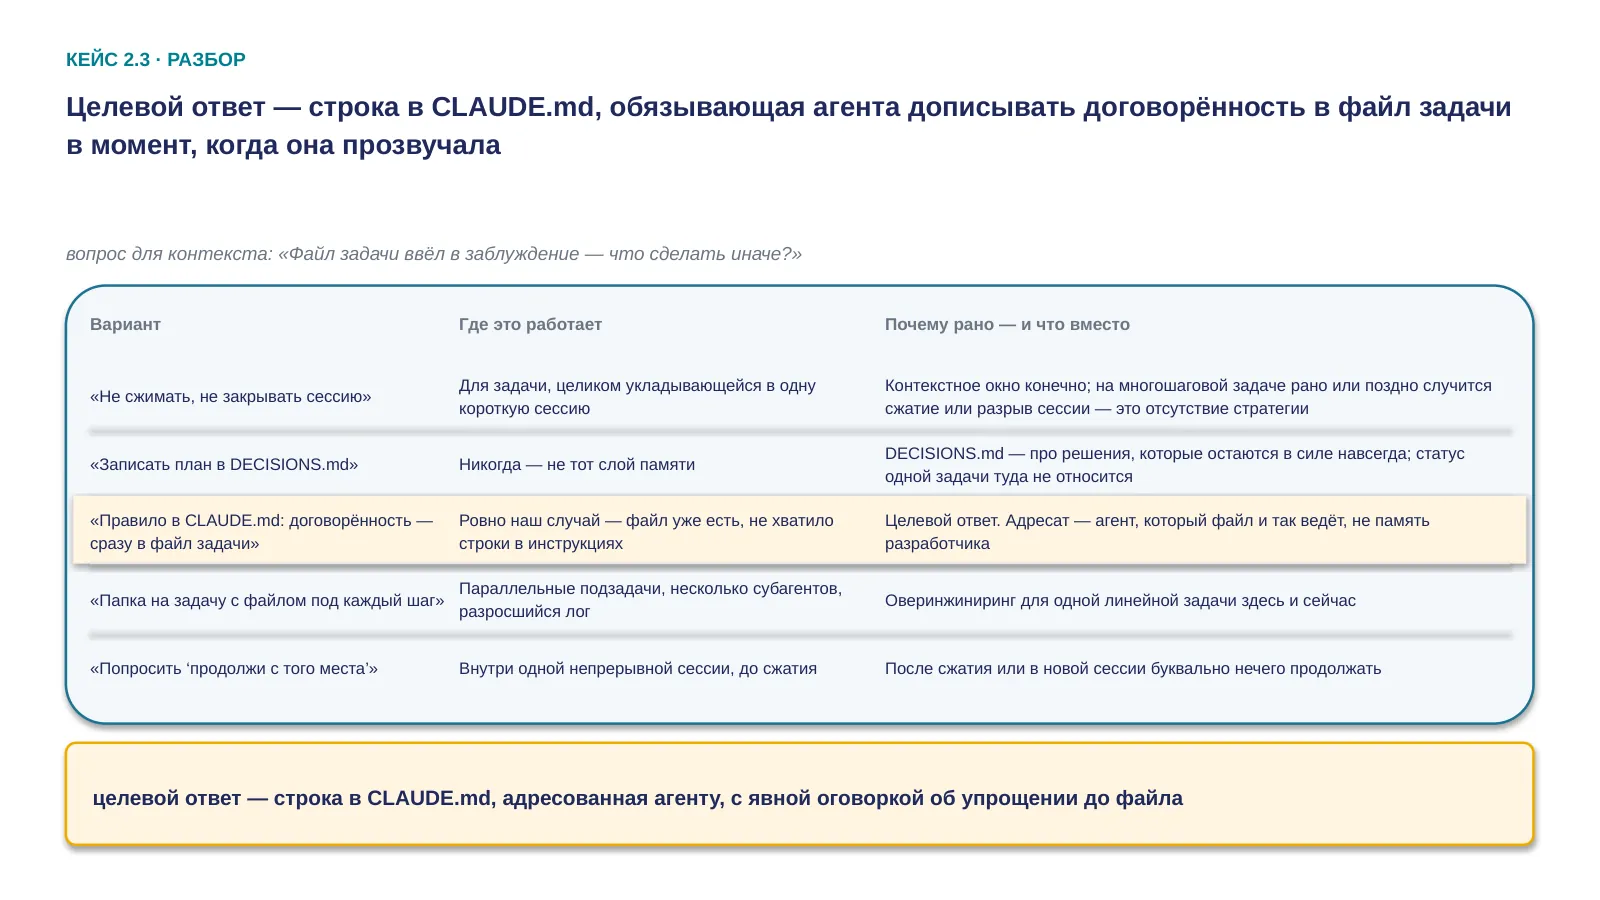
«Файл задачи — не то же самое, что журнал решений. DECISIONS.md — про то, что остаётся в силе навсегда, для всех будущих задач. Ход этой конкретной задачи — не решение проекта, это статус: что сделано, что дальше, что мелкое мы успели по ходу решить. Как хранить состояние визарда — решение ровно на время этой задачи: закончим — и это просто деталь кода, не правило проекта. Когда задача закончится, всё это можно выбросить. Совсем другой тип памяти, не следующая ступень той же лестницы.
Целевой ответ — не «завести файл», он уже есть, и не «не забывать дописывать». Файл был, практика была. Не хватило одной строки — но не в логе, а в CLAUDE.md: дописывать договорённость в файл задачи сразу, как она прозвучала, а не «когда будет время».
Адресат этой строки — не разработчик, а агент, который файл и так ведёт: он читает инструкции в начале каждой сессии, он отмечает шаги, он пишет лог. Ему просто не было сказано, когда писать. Решение кейса — сказать это в файле инструкций, а не полагаться на то, что кто-то вспомнит сам.
И ровно та же оговорка, что в кейсе про гейт готовности: правило в тексте — просьба, не закон, сработает не каждый раз. Разница в том, что просьба адресована исполнителю, который открывает эти инструкции каждую сессию, — а человеческая внимательность не масштабируется вообще никак.»
52 · Новое в этом кейсе — не файл, а три строки в CLAUDE.md: они говорят агенту, когда в этот файл писать
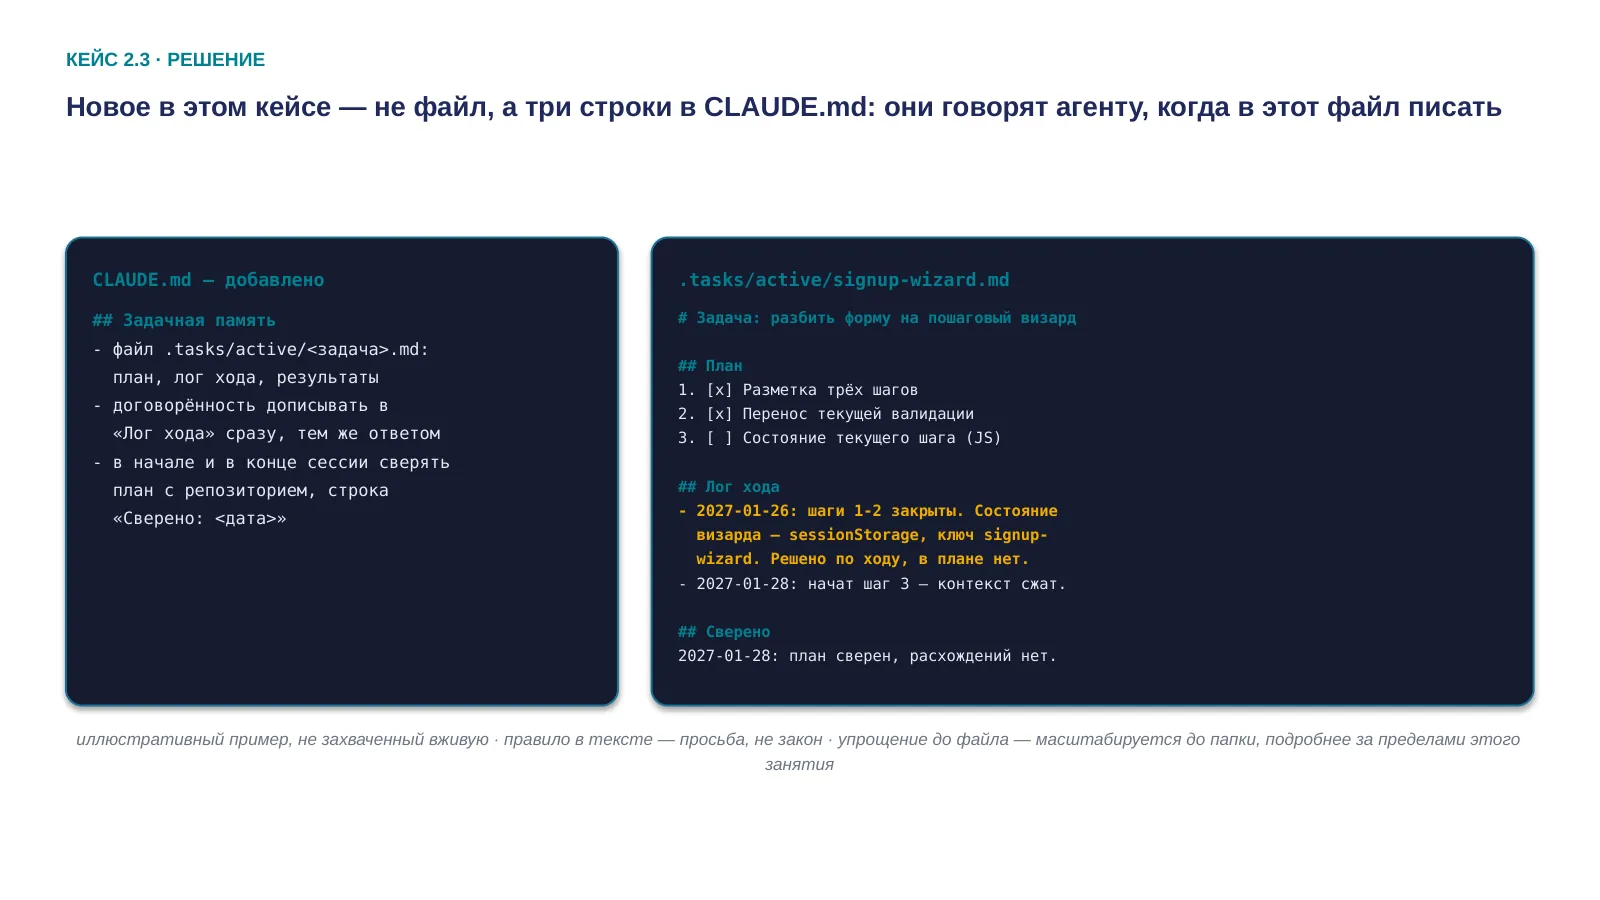
«Один файл на задачу: план, лог хода, результаты — он уже был с первого шага, это не новость этого кейса. Новость — вот этот блок в CLAUDE.md, три строки. Первая описывает сам файл. Вторая говорит, когда в него писать: договорённость, принятую по ходу работы, дописывать в лог сразу, тем же ответом. Третья — сверять план с репозиторием в начале и в конце сессии; к ней вернёмся через минуту, когда посмотрим цифры, она оттуда и взялась.
Справа — что из этого получается в самом файле задачи: договорённость про sessionStorage попала в лог до того, как сессия оборвалась. Структура файла та же, практика та же — разница ровно в том, записали вовремя или нет. И записывает это агент, по инструкции, а не вы по памяти: заставлять себя помнить про лог посреди работы — ровно то решение, которое не работает.
Честная граница, та же, что в кейсе про гейт готовности: эти строки — просьба текстом. Агент их читает и может выполнить; гарантии, что дописал каждый раз, они не дают. Поэтому третья строка про сверку и стоит рядом с первыми двумя: одна просьба страхует другую, но барьером ни одна из них не становится.
И явная оговорка про масштаб: это упрощённая версия паттерна. В реальной практике это масштабируется до папки на задачу — отдельный план, отдельный лог, отдельная папка результатов, особенно когда задача не линейная. Для сегодняшнего занятия одного файла достаточно — не усложняем.»
53 · Плохой план хуже отсутствия плана вообще — и 100% провала измерены именно без проверки актуальности плана, поэтому мера прямая: сверять план в начале и в конце сессии
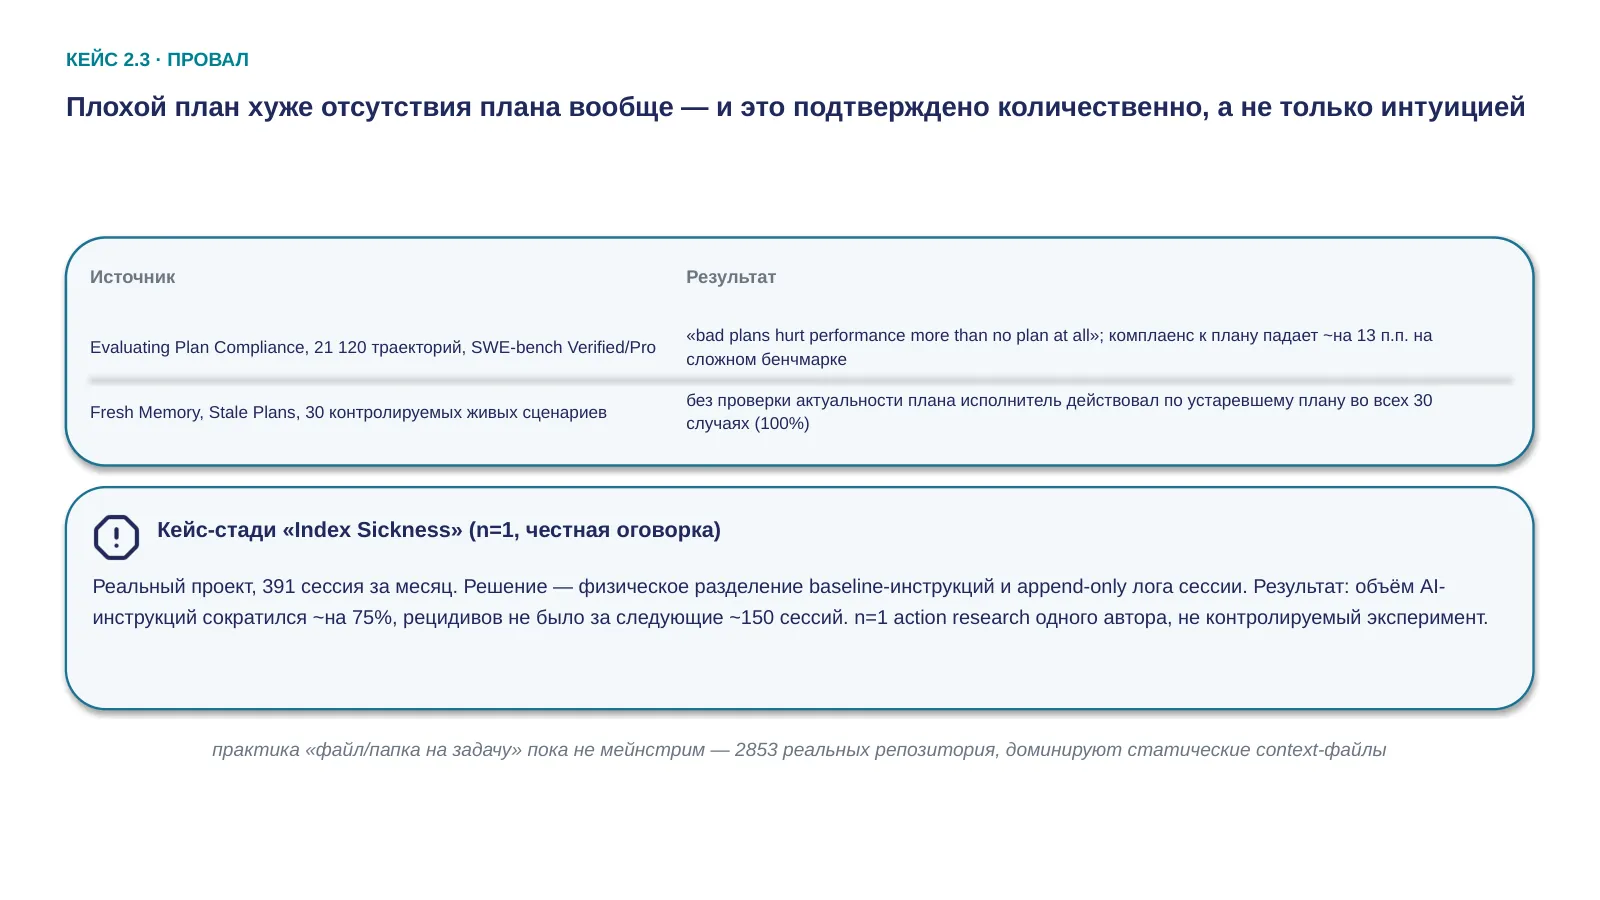
«Обещанные цифры. Двадцать одна тысяча сто двадцать траекторий, SWE-bench: наличие плана в среднем помогает. И тут же прямая цитата авторов: "плохой план вреднее отсутствия плана вообще". Комплаенс агента к собственному плану падает примерно на тринадцать пунктов на более сложном бенчмарке.
А вот эксперимент с более жёстким условием: тридцать контролируемых живых рабочих сценариев, где план не проверялся на актуальность по ходу работы. Устаревший план выполнялся буквально во всех тридцати случаях. Файл задачи, который никто не обновляет, — не нейтральная бумажка. Это источник систематически неверных действий.
И прочитайте условие этого эксперимента ещё раз: сто процентов — это прогоны без проверки актуальности плана. Измерена не неизбежность провала, а цена пропуска одного конкретного шага. Значит, шаг надо вернуть — и это та самая третья строка, которую мы записали пару слайдов назад: сверять план с состоянием репозитория в начале и в конце сессии и ставить в файле строку «сверено» с датой.
Три вещи в этой формулировке не случайны. Первое — «и в конце». Сверка в начале защищает эту сессию, сверка в конце защищает следующую: она дописывает то, что выяснилось под конец, пока контекст ещё цел. В нашем сценарии сессия оборвалась на середине третьего шага, и сверки в конце не случилось — но сверка в начале второй сессии сравнила бы план с кодом и показала бы: шаг начат, а как его делать — в файле не сказано. Не гарантия, но место, где расхождение становится видно.
Второе — сама строка «сверено, дата». Без неё следующая сессия не отличит свежий план от плана трёхнедельной давности: и тот и другой выглядят одинаково уверенно, и это ровно тот механизм, из-за которого плохой план вреднее отсутствия плана. Дата делает свежесть видимой. Третье — сверять с репозиторием, а не с памятью: код и история изменений переживают сжатие контекста, память — нет.
И граница этой меры — та же, что у гейта готовности из первого раздела: это снова просьба текстом. Риск она снижает, но не снимает. У Manus, о котором говорили на прошлом слайде, тот же приём работает внутри одной сессии — они переписывают список дел в конец контекста; сверка делает то же самое между сессиями. Механического барьера, который не даст работать по несверенному плану, мы сегодня не ставим.
Есть ещё кейс-стади, очень близкий к нашей ситуации: реальный проект, триста девяносто одна сессия за месяц. Авторы наблюдают, как по мере роста правил агент теряет связь с реальной семантикой проекта. Решение — то же самое разделение, которое мы проводим весь раздел: стабильное отдельно от текущего. Результат — минус семьдесят пять процентов объёма AI-инструкций, ноль повторений проблемы за следующие сто пятьдесят сессий. Сразу честно: это один проект, один автор, action research, не контролируемый эксперимент.
И последнее, что нужно сказать прямо: паттерн "файл или папка на задачу" сейчас — не мейнстрим. Исследование почти трёх тысяч реальных репозиториев показывает, что доминируют статические context-файлы. Практику продвигают отдельные лидеры — но это ещё не общепринятая норма.»
54 · Одного файла на задачу достаточно, пока задача линейная и её ведёт один агент и один разработчик — иначе оправдан переход к папке
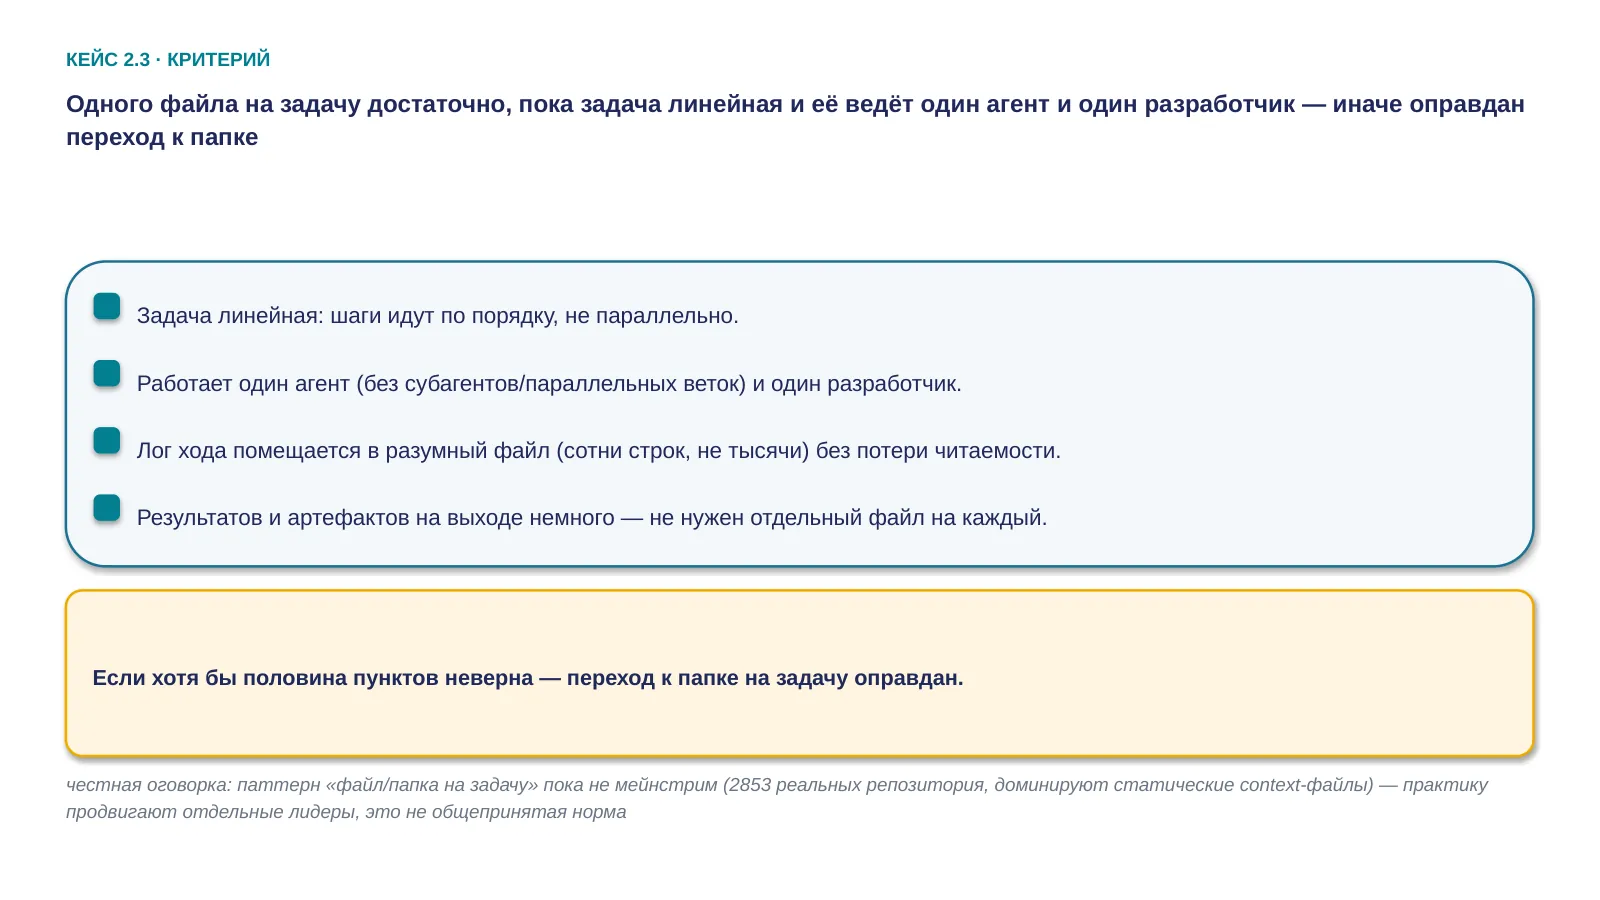
«Если хотя бы половина пунктов неверна — переход к папке на задачу оправдан. Это уже за пределами сегодняшнего занятия — подробно раскрывается в Лекции 3.
Подведём черту под разделом памяти. Три кейса — три разных ответа на вопрос "что происходит, когда сессия заканчивается": решение остаётся навсегда в плоском логе, решений становится слишком много и они обрастают структурой, а ход одной задачи живёт ровно до её конца в отдельном файле. Первое и третье мы заводим сразу, на дне 0, потому что это дёшево. Второе — реактивный шаг, потому что заранее нельзя знать, вырастет ли именно ваш журнал решений до нужного объёма.
Но все три — текст, который агент читает и может учесть. Именно «может», а не «учтёт». Дальше в этом занятии мы посмотрим, что происходит, когда прочитать становится недостаточно.»
55 · Шесть развилок сегодняшнего занятия делились на два типа: специфичное для проекта (ждать сигнала) и универсальная гигиена (заводить сразу, на день 0)
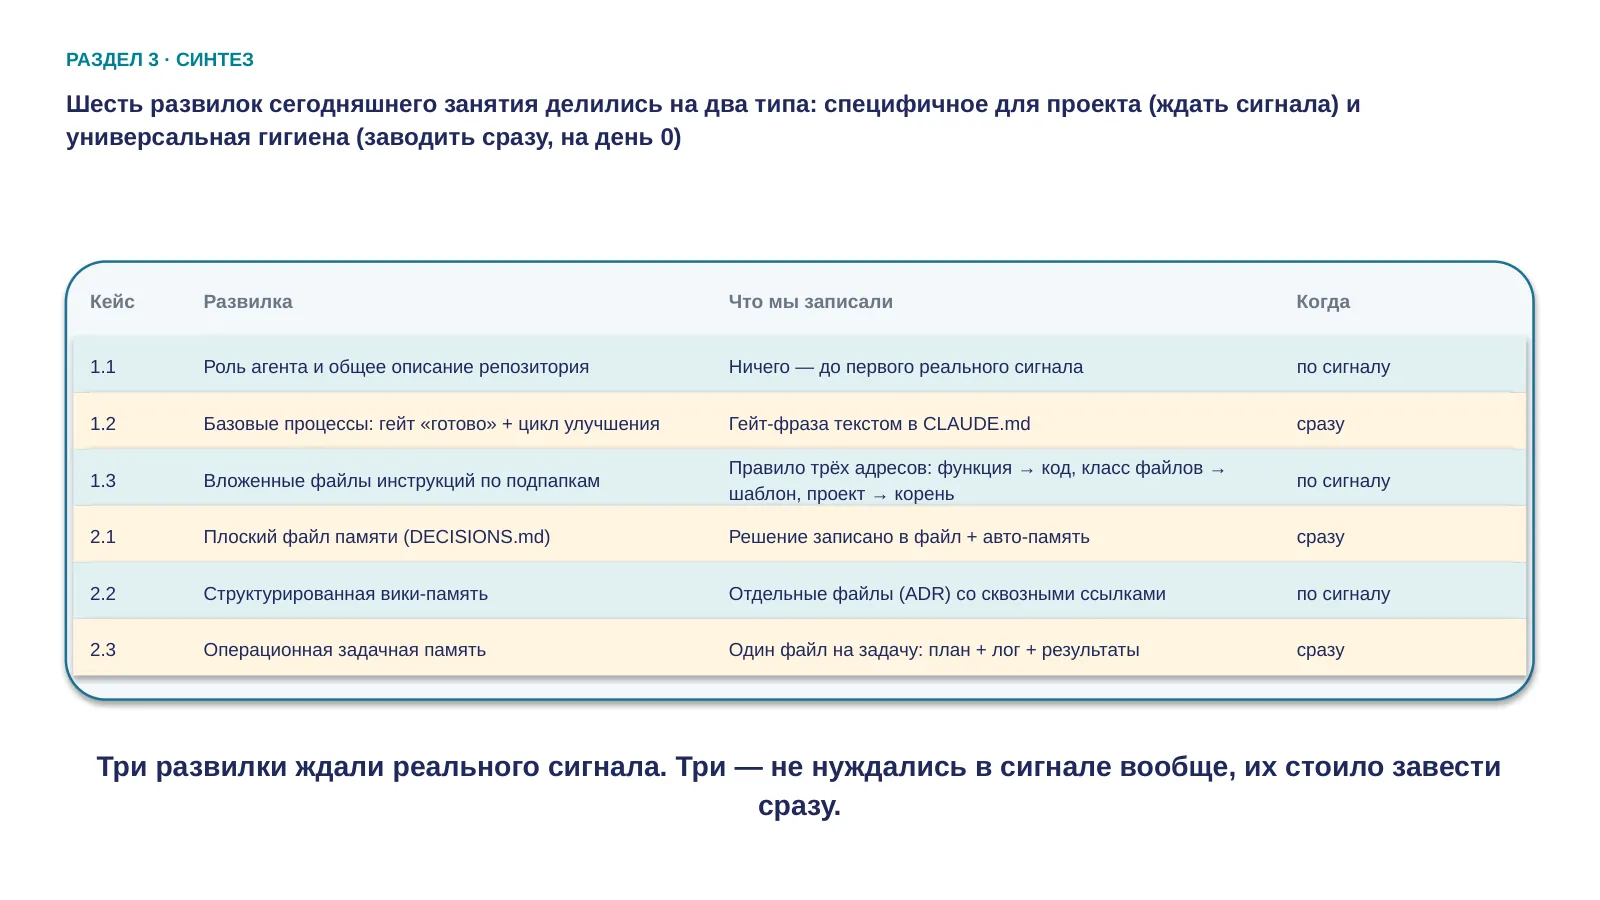
«Оглянемся на сегодняшний день. Шесть развилок, по три в каждом из двух разделов. В разделе про файл инструкций — что не писать заранее, как записать гейт «готово» и цикл улучшения, стоит ли дробить файл по подпапкам. В разделе про память — плоский файл решений, структурированная вики-память, задачная память одной сессии.
В правой колонке — две логики. Три развилки — 1.1, 1.3, 2.2 — специфичны для конкретного репозитория: нельзя было заранее сказать, понадобится ли общее описание структуры, вложенные файлы или сложная память, — мы честно ждали сигнала. Три другие — 1.2, 2.1, 2.3 — универсальная гигиена: гейт готовности, лог решений, задачная память. Их мы завели сразу, не дожидаясь боли, потому что цена сделать это на день 0 маленькая, а цена не сделать — непредсказуемая и наступает тихо.
И ещё одна вещь, которая никуда не делась: гейт-фраза в CLAUDE.md и лог решений — оба всё ещё текст, который агент читает и может учесть, не гарантия. Это отдельный вывод, он верен независимо от того, завели мы их сразу или на сигнал, — и мы к нему ещё вернёмся, ровно на минуту, в следующем шаге.»
56 · Сегодня закрыты два слота харнесса из пяти; остальные три плюс оба механических слоя (хук, процесс) — Семинар 5
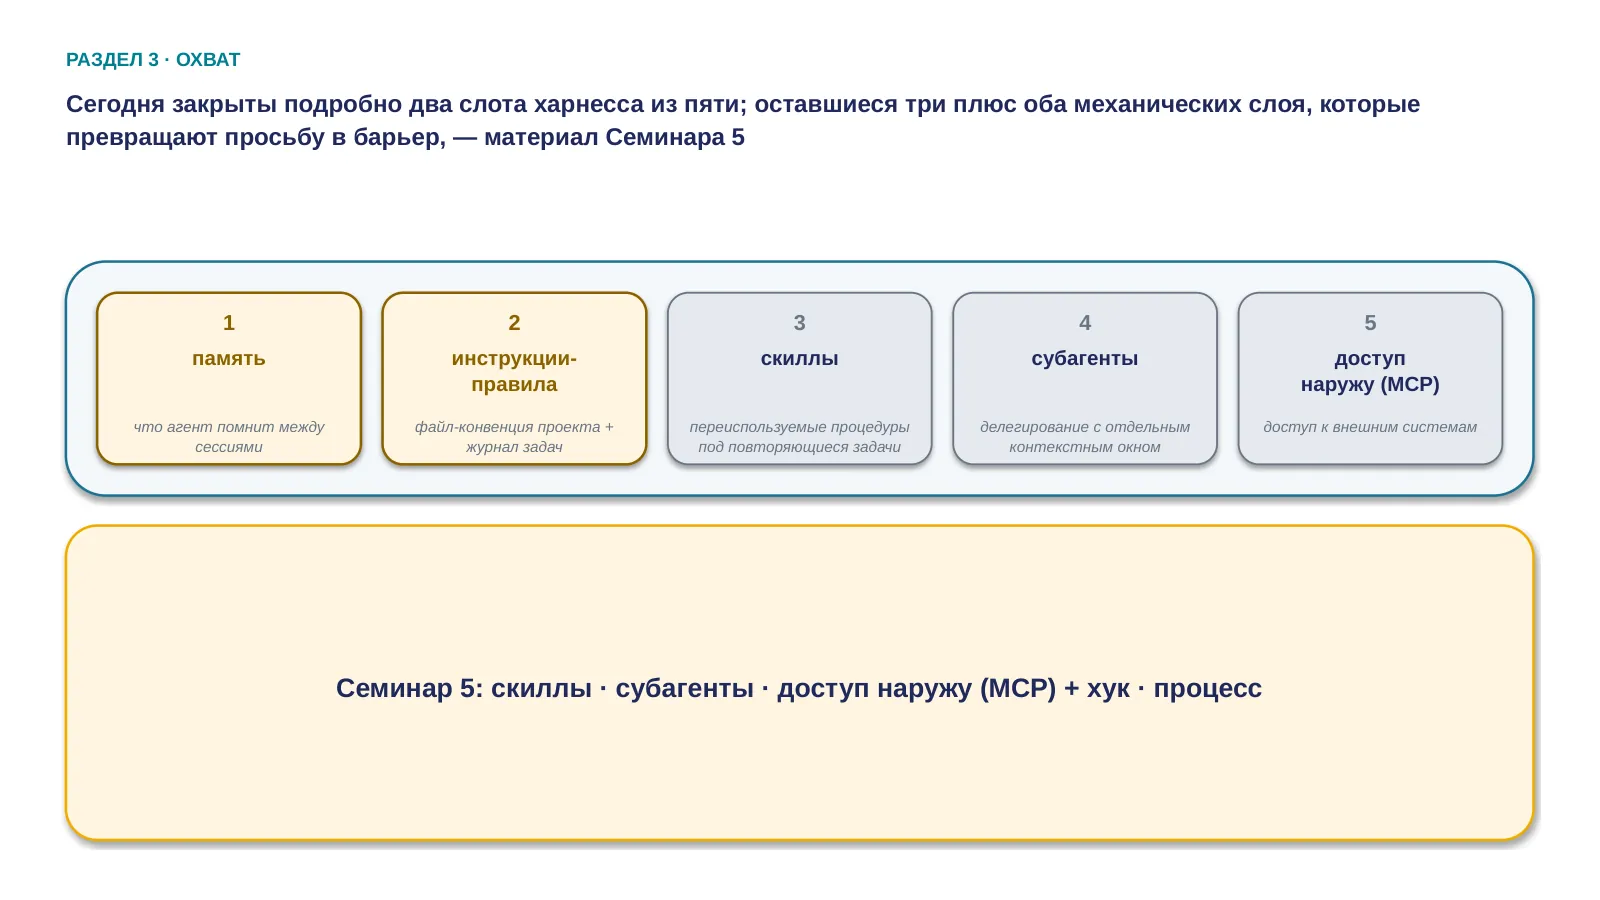
«И вот честная цифра, которую стоит назвать прямо, а не оставить подразумеваемой. У харнесса из Лекции 3 — пять слотов. Сегодня мы подробно разобрали два: инструкции-правила и память, каждый на трёх реальных развилках. Три остальных — скиллы, субагенты, доступ наружу — сегодня не звучали вообще, ни одной строкой.
И ещё кое-что мы сегодня не трогали ни разу: оба практических слоя, которые механически усиливают текстовый слой, — хук и процесс. Это не забывчивость и не нехватка времени в последнюю минуту. Это прямой ответ на вопрос, который только что прозвучал: что делать, когда просьбы текстом недостаточно, даже если она заведена вовремя, на день 0? Ответ — на следующем занятии, Семинаре 5. Там — оставшиеся три слота и оба механических слоя разом, потому что именно они превращают просьбу в барьер, который агент не может обойти, даже если захочет.»
57 · Перенесите шесть сегодняшних решений на свой репозиторий — и проверьте, какое из них реально день-0-база, а какое вы отложили без причины или завели раньше времени без сигнала
Формат намеренно лёгкий и без сбора ответов: пауза 5–7 секунд, без вызова голосов из зала, без разбора «типичных ответов» — в отличие от всех шести предыдущих открытых вопросов занятия, у этого нет разбора, потому что он не проверяет знание, а инициирует перенос на личный контекст каждого.
Закрывающая реплика после паузы: «Ответа вслух не будет. Если хотя бы одно решение оказалось «завели слишком рано, без сигнала» — или, наоборот, «давно пора завести, но всё ещё нет» — вот с этого и начните. Это не вопрос ресурсов. Это вопрос дня.»