Семинар 3. Три механизма модели в системном дизайне
Семинар 3 · 43 слайда
01 · Три механизма модели в системном дизайне
02 · Три блока, шесть задач
03 · Эмбеддинги: сравнение и группировка по смыслу
04 · Какую embedding-модель взять под свой корпус
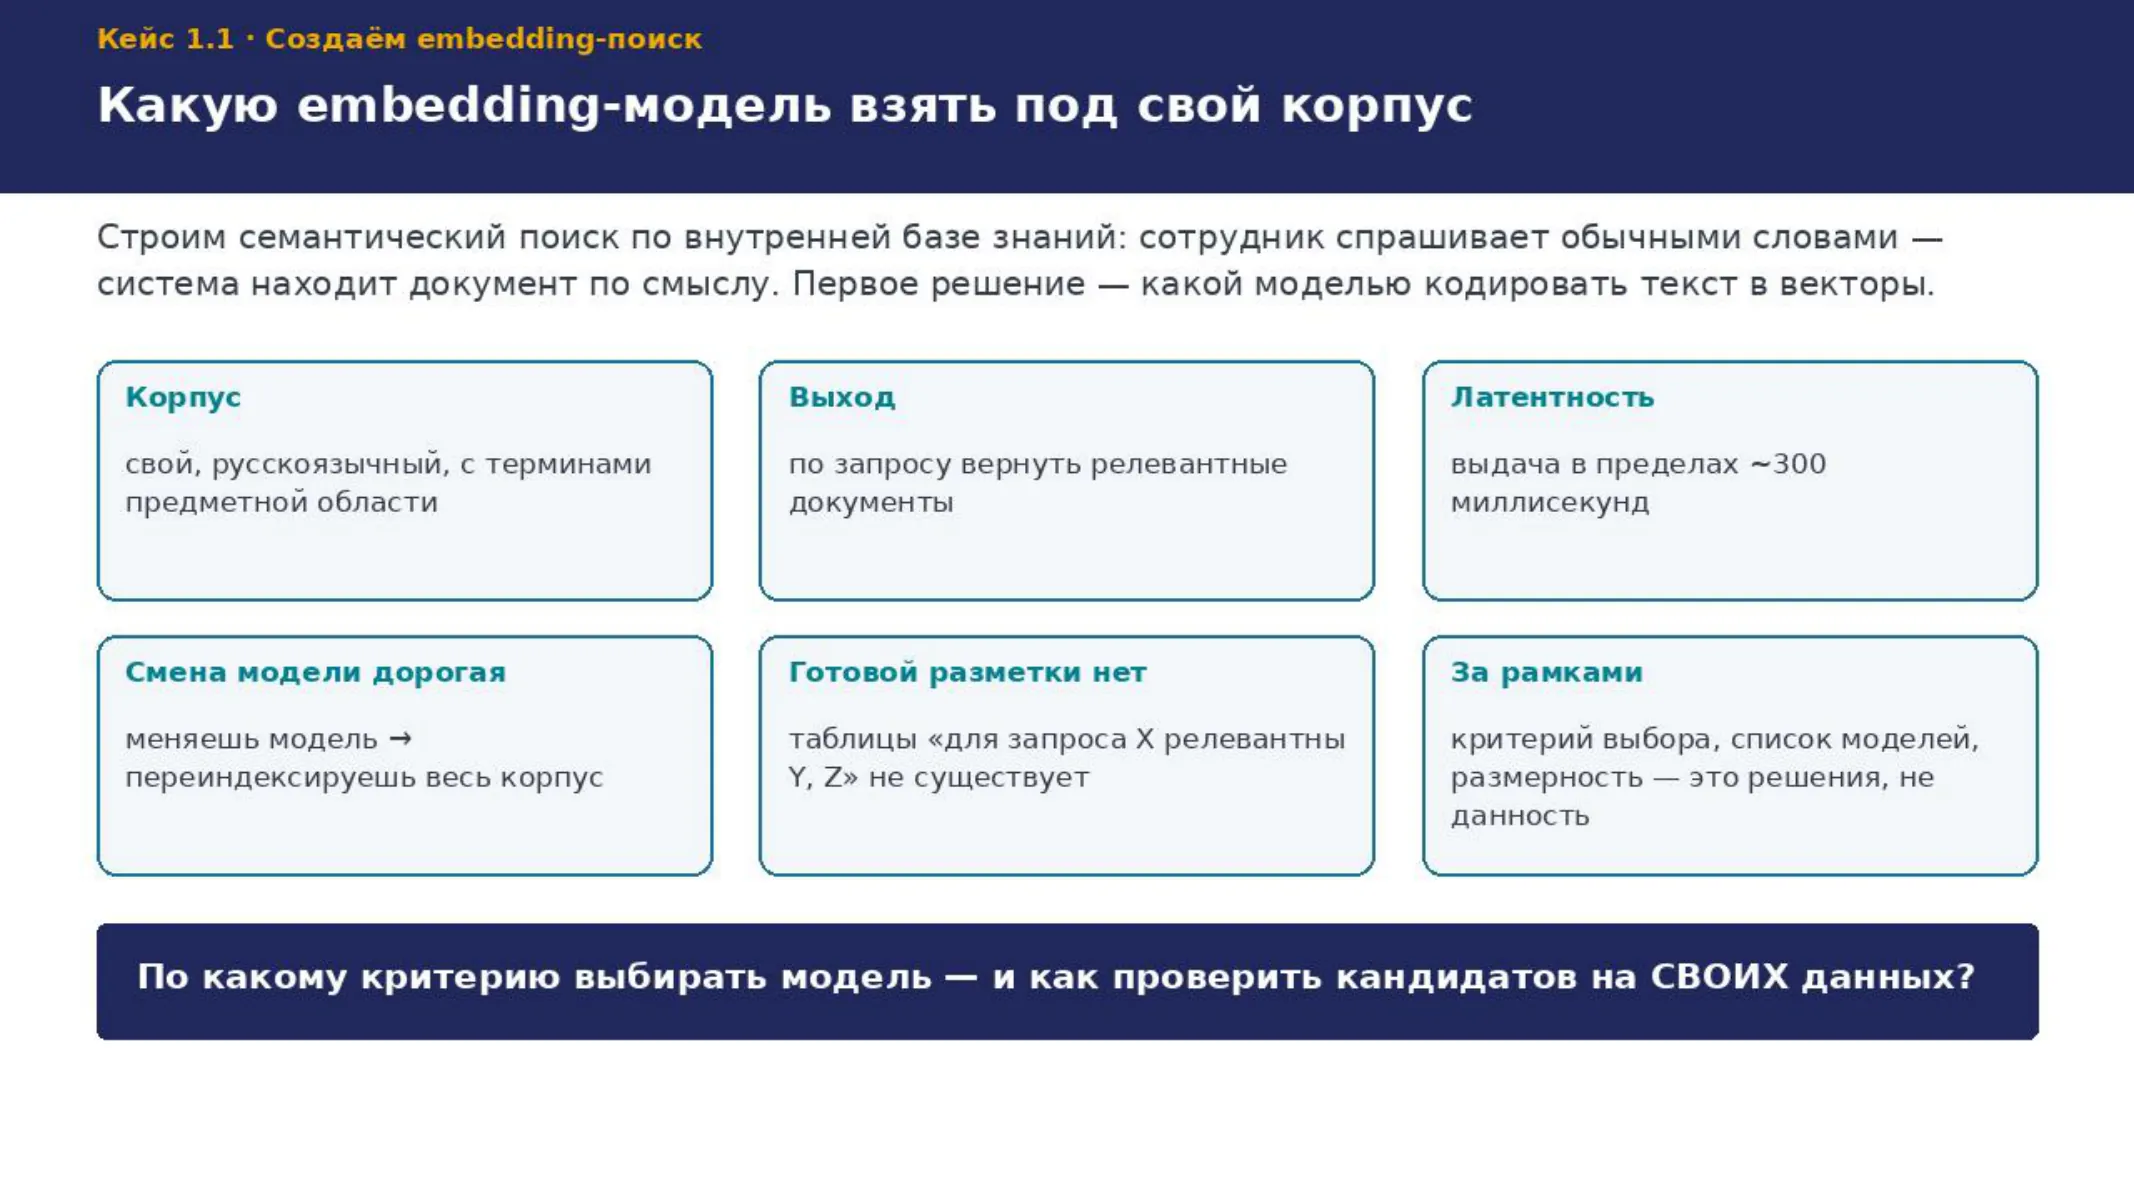
На слайде — только постановка: свой русский домен, бюджет латентности ~300 мс, дорогая смена модели (векторы разных моделей несравнимы, смена = переиндексация всего корпуса), готовой разметки релевантности нет. Критерий выбора и список моделей намеренно вынесены за рамки — их студенты предлагают сами. Класс задачи — выбор компонента, который дорого менять потом. Здесь два напрашивающихся хода: взять лидера бенчмарка MTEB и не думать (быстро, но лидер усредняет десятки языков) или собрать мини-eval на своих парах «запрос → документ» и померить кандидатов (час работы, зато цифры про твой корпус). Ловушка новичка — выбрать по первому месту лидерборда и через месяц обнаружить плохой recall на своих запросах. Вероятный вопрос: «нельзя ли просто взять самую большую модель?» — большая размерность дороже по хранению и латентности, а прироста качества на домене может не быть; это как раз показывает мини-eval. Дальше на слайдах — как собрать eval, оси сравнения и таблица кандидатов.
05 · Как выбирать: сначала eval, потом всё остальное
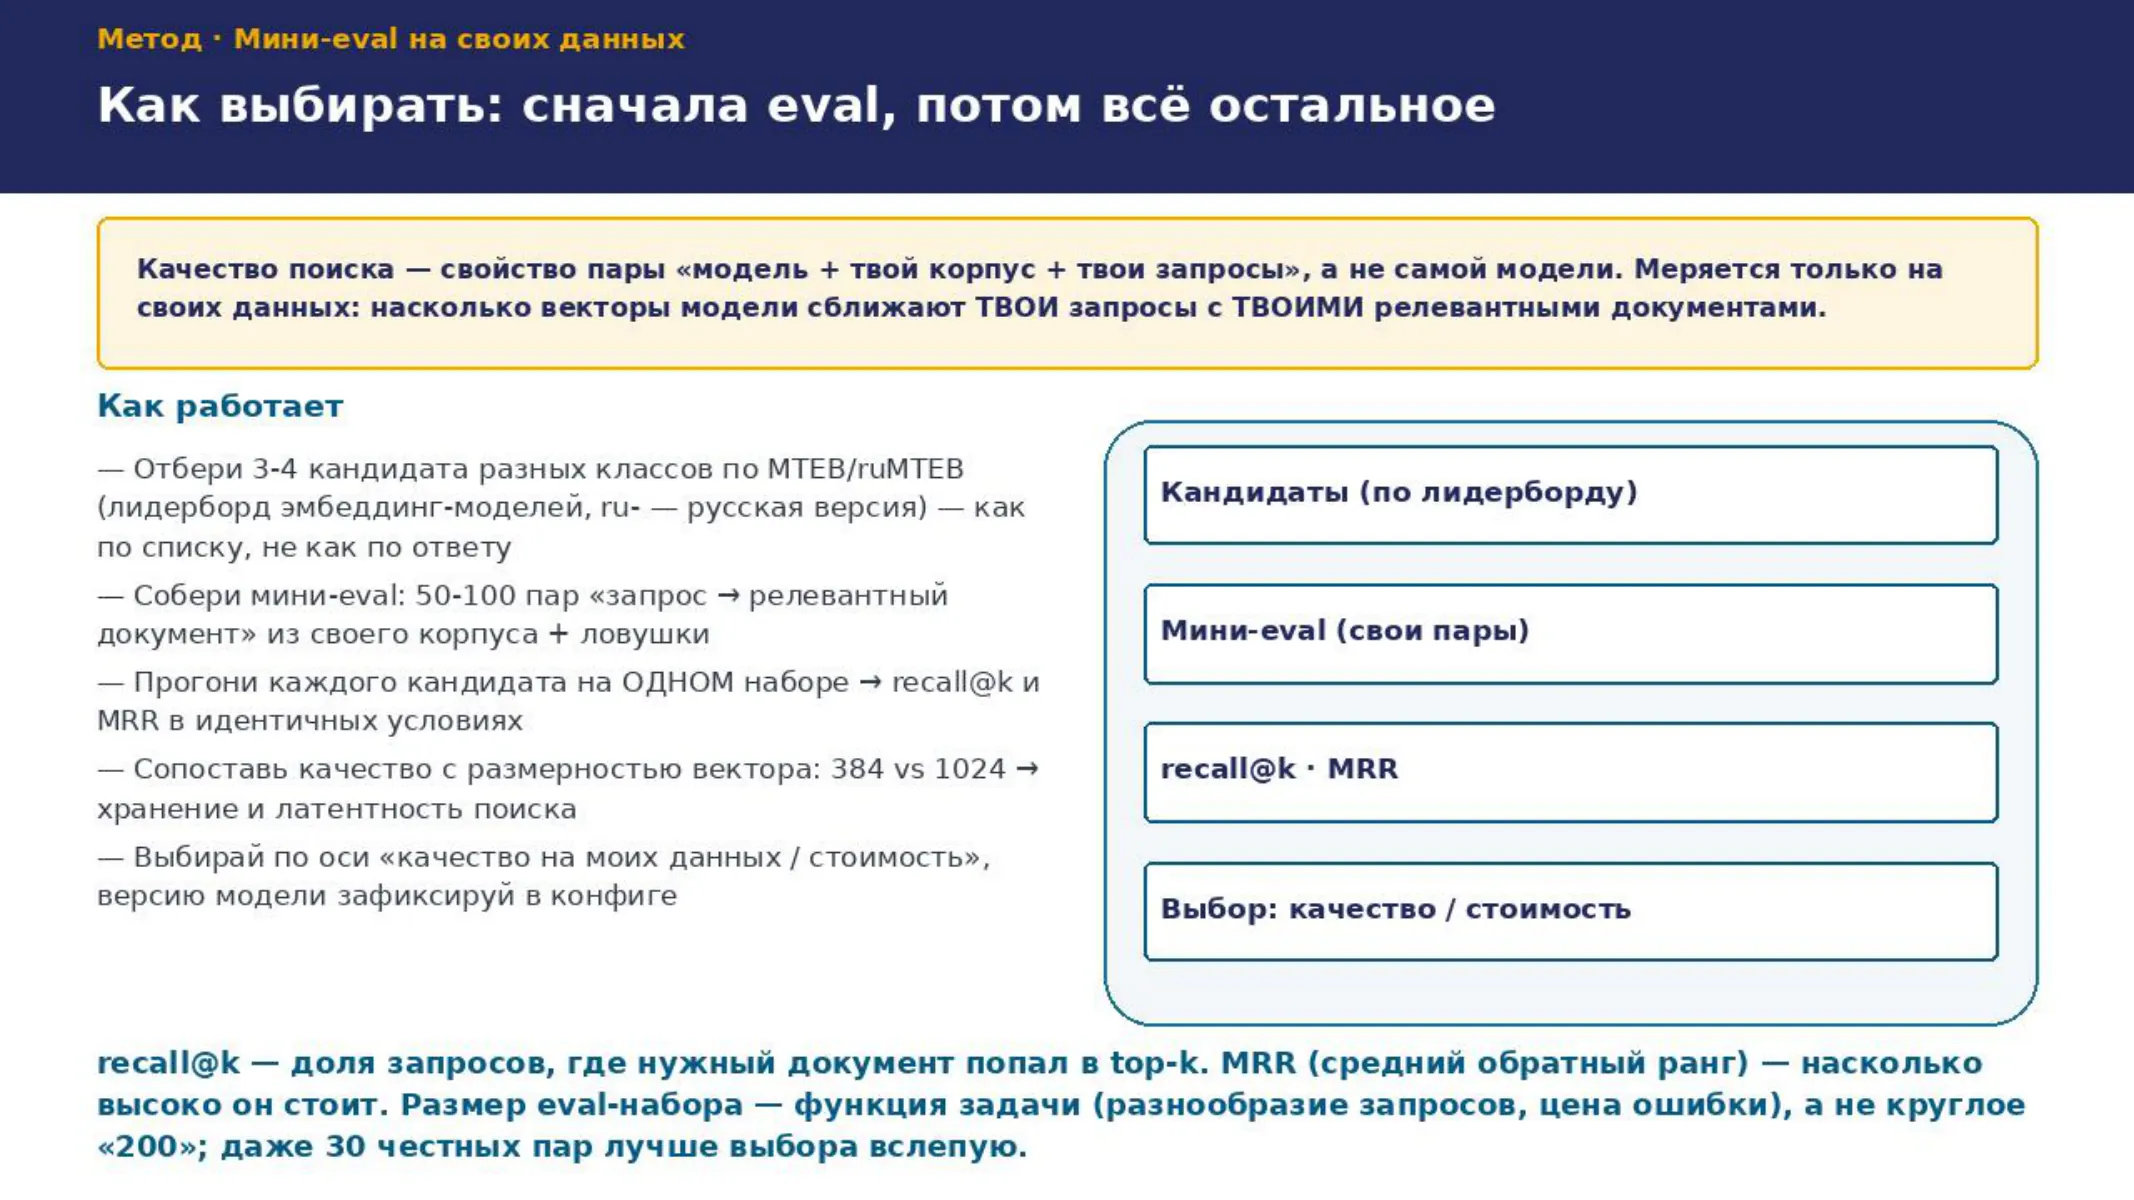
Здесь — метод сравнения, ещё не сами варианты. Две метрики покрывают выбор: recall@k (нашёлся ли нужный документ среди первых k) и MRR (на каком он месте — первое место 1.0, второе 0.5, третье 0.33). Обе нужны вместе: recall@10=1.0 у двух моделей может скрывать, что одна ставит нужное на первое место, другая на девятое. k берётся из архитектуры продукта: смотрят первую страницу из 10 ссылок → recall@10; RAG кладёт в контекст 5 фрагментов → recall@5. Мерить recall@100 — обман себя: документ на 87-м месте пользователь не увидит. Две тихие ошибки в псевдокоде замера: режимы query/document (у e5/bge-m3 разные префиксы для запроса и документа — кодируешь всё одинаково, теряешь качество) и рассогласование метрики дистанции/нормализации с обучением модели. Вероятный вопрос: «данных на eval мало, 30 пар — стоит ли?» — да, 30 честных пар дают сигнал; признак, что мало, — результаты скачут при добавлении новых пар.
06 · Три оси выбора — каждая проверяется тем же eval
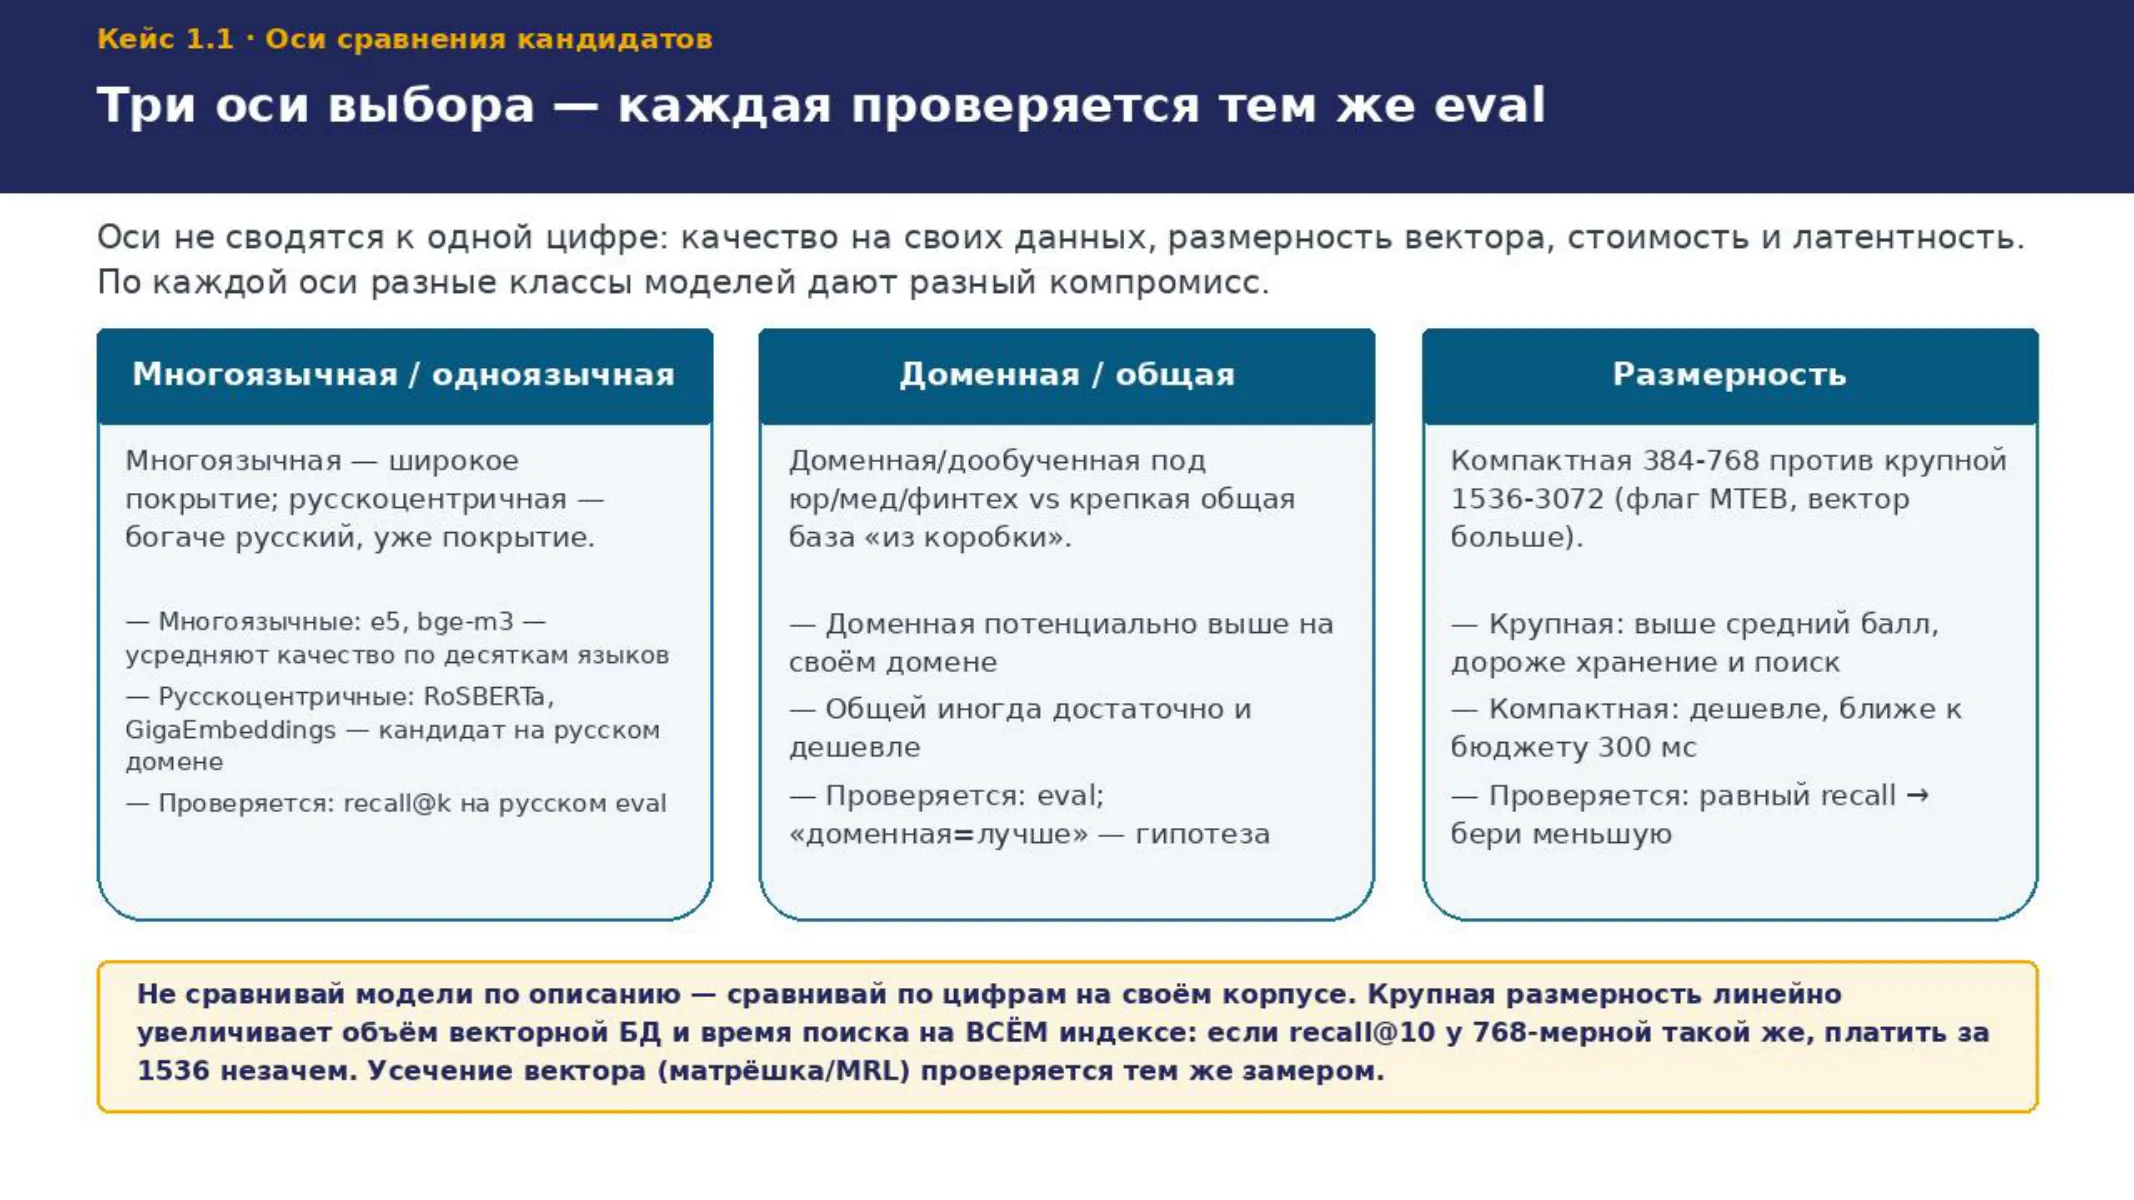
Три оси вариантов из разбора кейса вынесены в заголовки колонок. Ось «многоязычная/одноязычная»: многоязычная модель обучена на десятках языков и её качество на русском — усреднение; русскоцентричная видела больше русского и на домене часто выигрывает — но проверяется это recall@k на русском eval, а не по описанию. Ось «доменная/общая»: доменная потенциально точнее, но требует разметки и дообучения; есть задокументированные случаи, где общая база обходила специализированную, поэтому «доменная = лучше» — такая же непроверенная гипотеза, как «лидерборд = лучше». Ось «размерность» — прямой размен качество ↔ стоимость: вектор 1536 занимает вдвое больше места, чем 768, и линейно медленнее в поиске на всём индексе. Как зафиксировать выбор: таблица модель × recall@k × MRR × размерность × латентность, решение по столбцу «качество на моих данных / стоимость». Вопрос: «взять embedding того же вендора, что LLM, — совместимее?» — «совместимости» нет как категории: LLM выходные эмбеддинги поиска вообще не видит, бери лучшую поисковую модель под свой язык независимо от генератора.
07 · Лидер бенчмарка проседает именно на русском домене
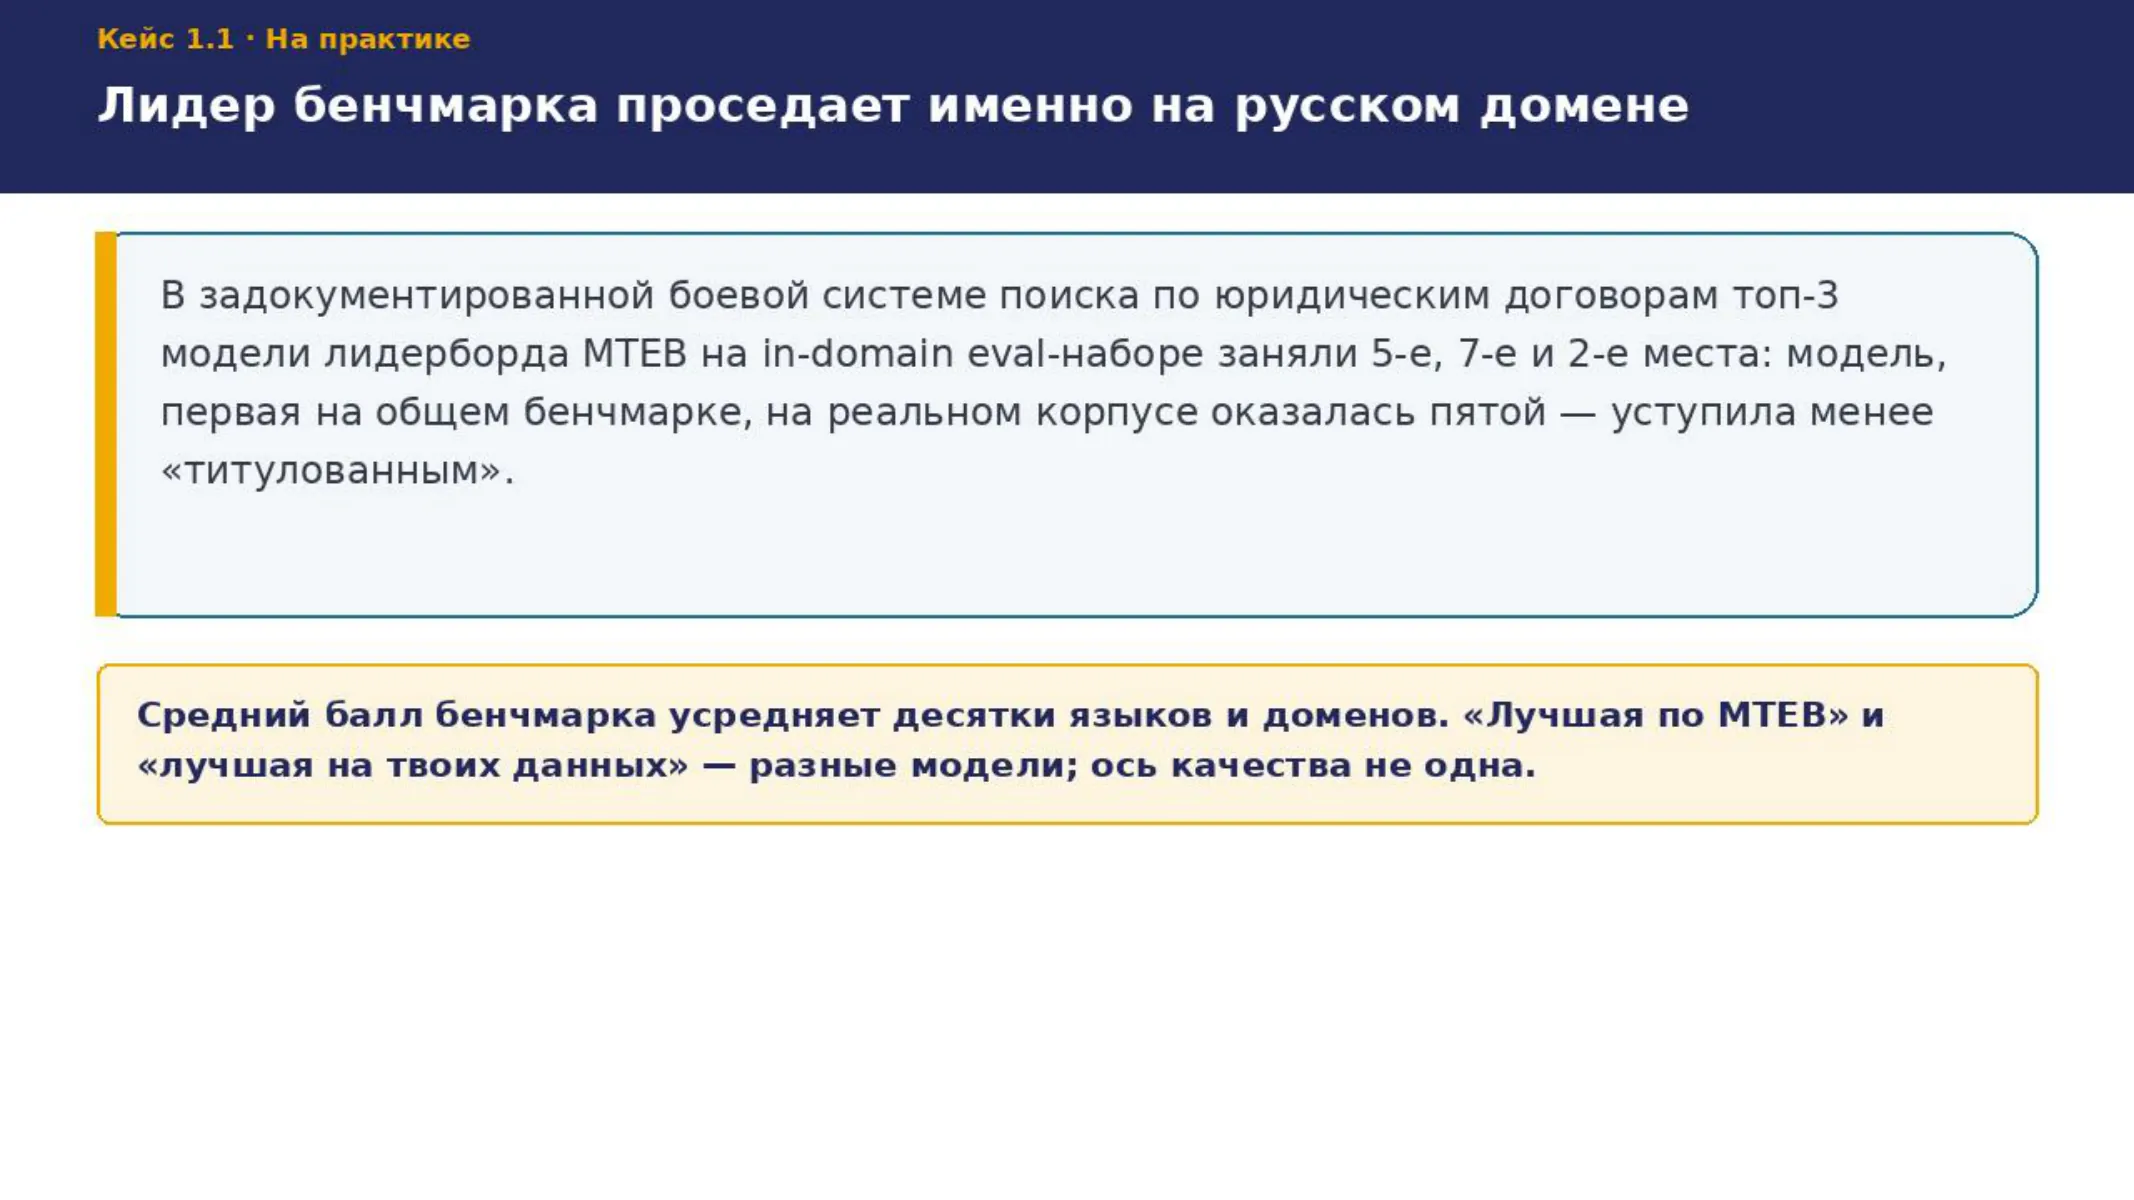
Это не «бенчмарк врёт», а свойство агрегата: MTEB усредняет поиск, классификацию, кластеризацию по многим языкам, и высокий средний балл может держаться на языках, которых у тебя нет. Отдельная ось — устойчивость к усечению размерности (матрёшка/MRL): лидер полноразмерного поиска может оказаться последним при обрезке вектора, и наоборот; работа 2026 года показала, что эмбеддинги устойчивы к усечению и без специального MRL-обучения, пока сокращение не превышает ~70-80%. Есть и обратный нюанс (химический домен, ChEmbed): доменная модель ВЫИГРЫВАЕТ на retrieval (nDCG@10 0.82→0.91), но общая база конкурентоспособна на не-retrieval задачах — отсюда правило «мерь под свою основную функцию», а не «доменная всегда лучше». Как детектировать расхождение с лидербордом: у тебя уже есть мини-eval — сравни recall@k кандидатов на своих парах, разрыв виден сразу. Отсюда правило: лидерборд даёт список кандидатов, решение принимает eval. Вероятный вопрос: «а если на моём домене вообще нет хорошей готовой модели?» — тогда кандидат на дообучение эмбеддера на своих парах или гибрид с полнотекстовым BM25, но это следующий шаг после того, как eval показал потолок готовых.
08 · Пайплайн выбора: лидерборд → eval → метрики → выбор
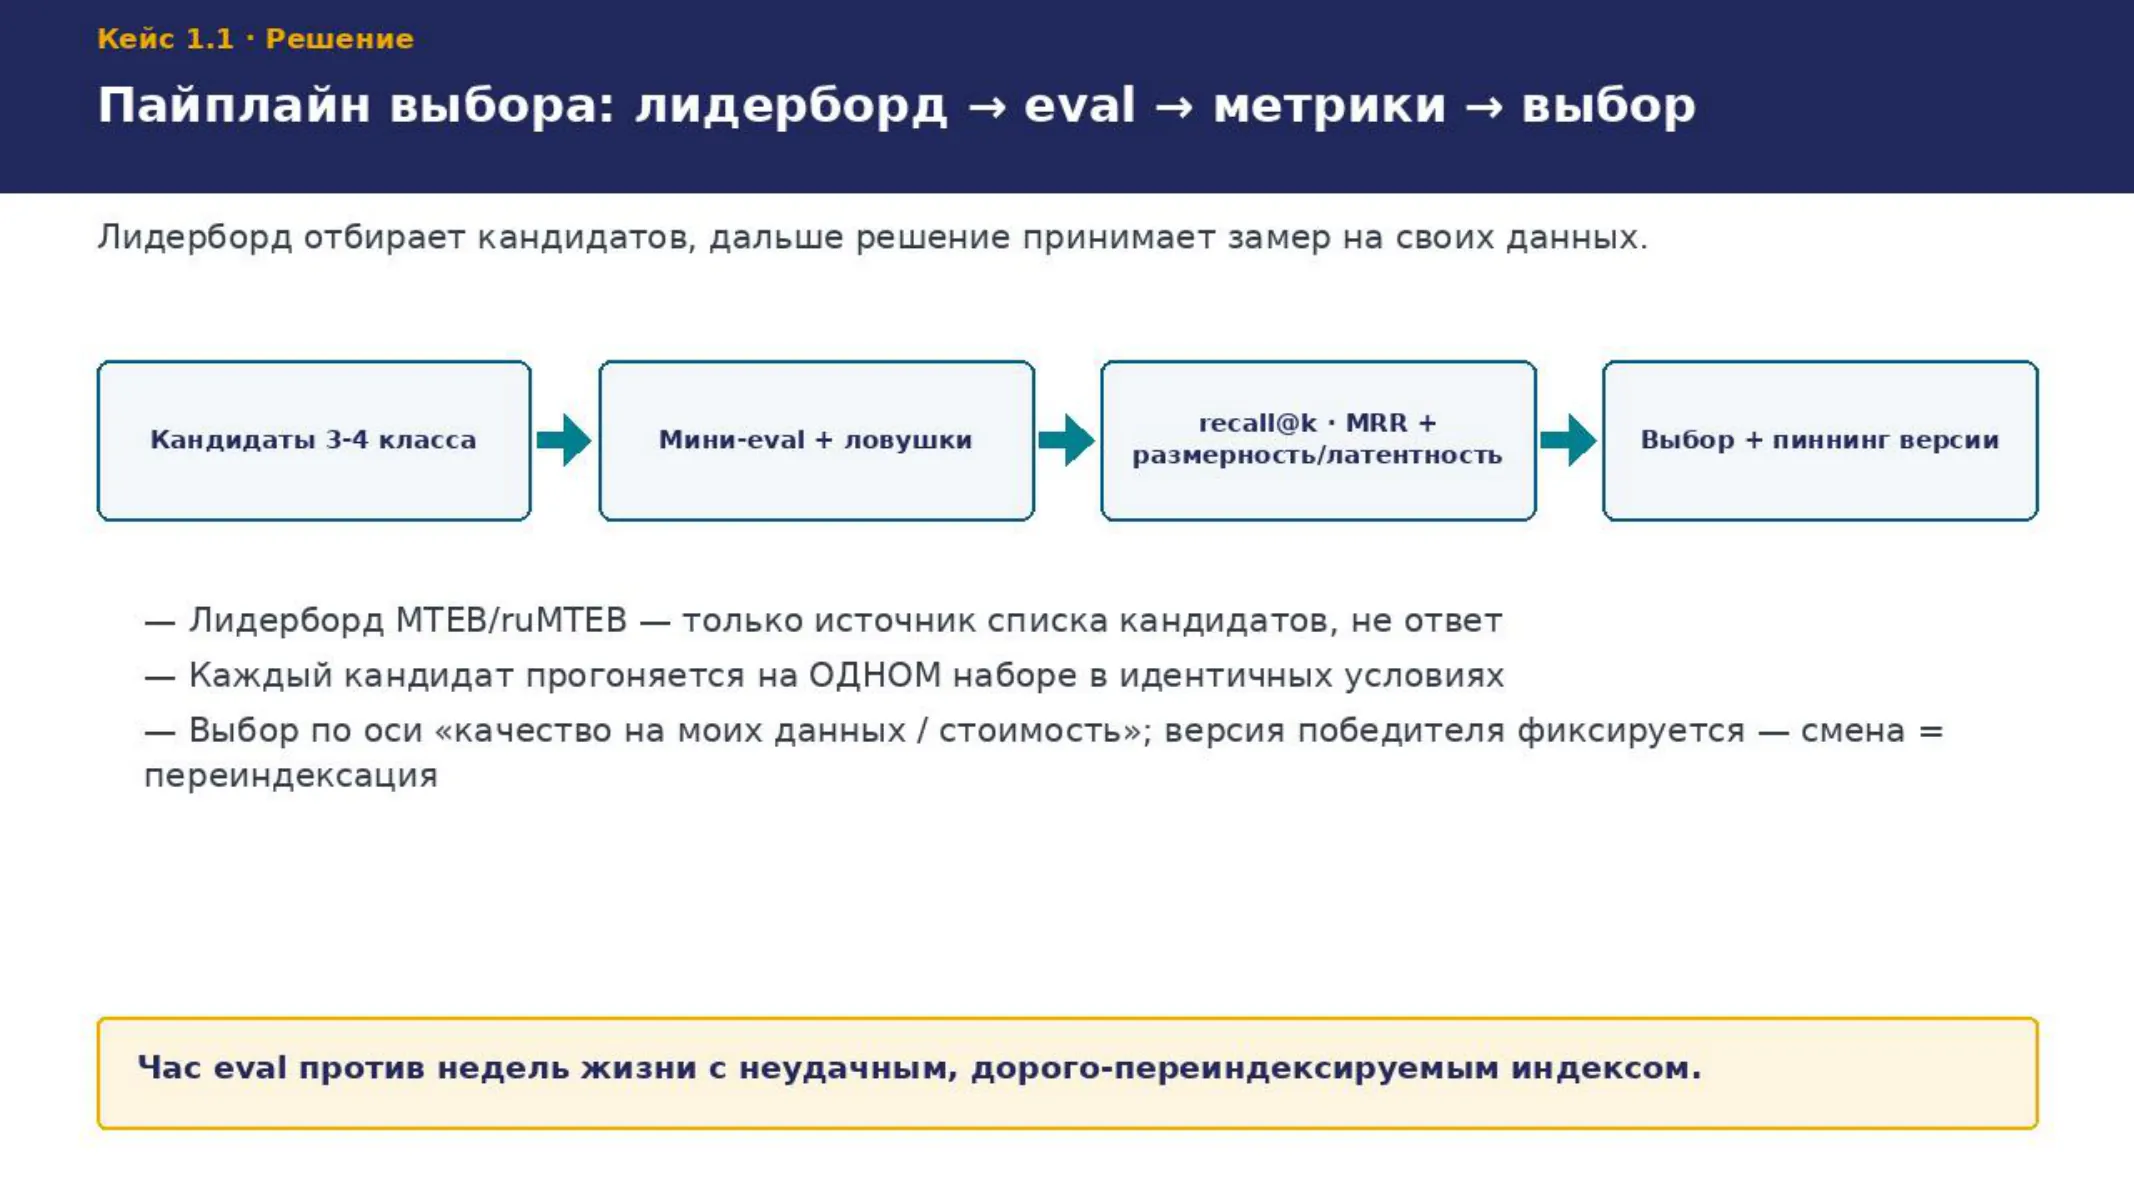
Схема из раздела 6.1 файла-кейса. Логика в трёх шагах. Лидерборд используется только чтобы отобрать 3-4 модели-кандидата разных классов — дальше он в решении не участвует. Собирается маленький честный eval-набор из реальных пар «запрос → нужный документ» с намеренными ловушками (антонимичные пары «вкл/выкл», разные версии продукта — на них видна граница метода). Каждый кандидат прогоняется на одном и том же наборе в идентичных условиях, давая сравнимые recall@k, MRR, размерность, латентность. Латентность мерят на реальном размере индекса и по перцентилям (p95/p99), а не по среднему: пользователь чувствует худшие случаи. Выбор — по оси «качество именно на моих данных ↔ стоимость», версия победителя фиксируется в конфиге (пиннинг), потому что тихое обновление модели вендором меняет её векторы, а они несравнимы со старым индексом. Вероятный вопрос: «сменили чат-модель в RAG — надо переиндексировать?» — нет, индекс живёт в координатах embedding-модели и от генератора не зависит; переиндексация нужна только при смене самой embedding-модели.
09 · Кейс 1.1 · Разбор
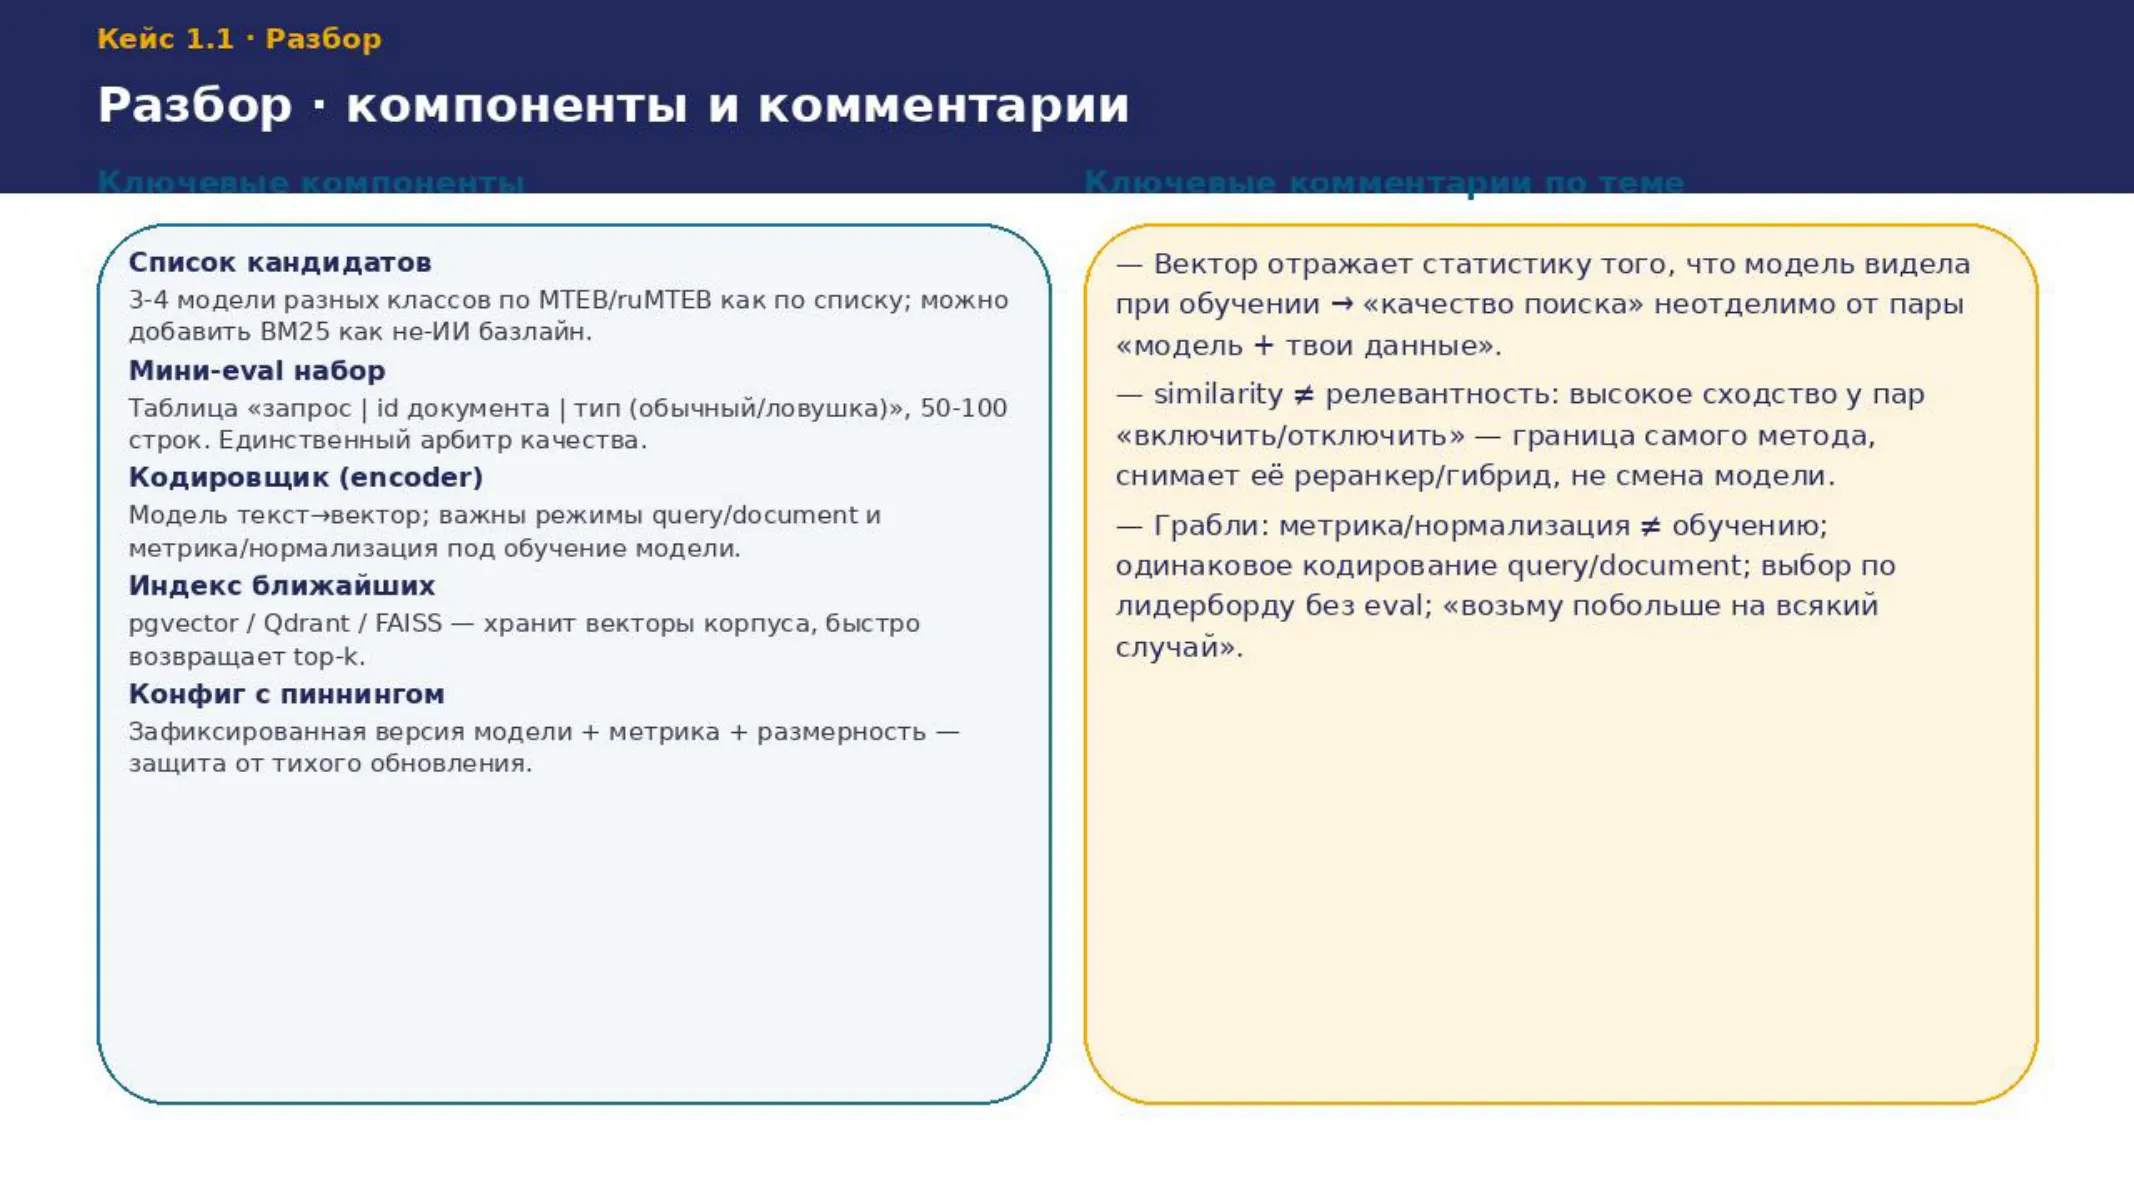
Разбор из разделов 6.2-6.4 файла-кейса. Центральный вывод: вектор — статистическое отражение того, что модель видела при обучении, поэтому качество поиска неотделимо от пары «модель + твои данные». Модель, много видевшая твой язык и домен, разведёт документы в пространстве лучше, чем видевшая их мало, — при любом месте в лидерборде. Отдельно проговори границу самого метода эмбеддингов, которую выбор модели не снимает: высокое косинусное сходство означает «об одном и том же», а не «с одинаковым смыслом» — пара «как настроить SSL» / «как отключить SSL» получает очень высокое сходство, потому что отрицание сдвигает вектор слабо. Это чинит не «лучшая модель», а реранкер, гибрид с полнотекстом, фильтры по метаданным; ловушки в eval нужны, чтобы увидеть границу до пользователей. Главные грабли: рассогласование метрики дистанции с обучением модели (тихая просадка при исправной модели), одинаковое кодирование запроса и документа, выбор по лидерборду без eval, плата за размерность без прироста качества. Вероятный вопрос: «можно обойтись без эмбеддингов, старым полнотекстовым поиском?» — на русском полнодокументном поиске BM25 остаётся сильным базлайном; добавь его кандидатом в eval, если догоняет — экономишь на векторной инфраструктуре.
10 · Кейс 1.1
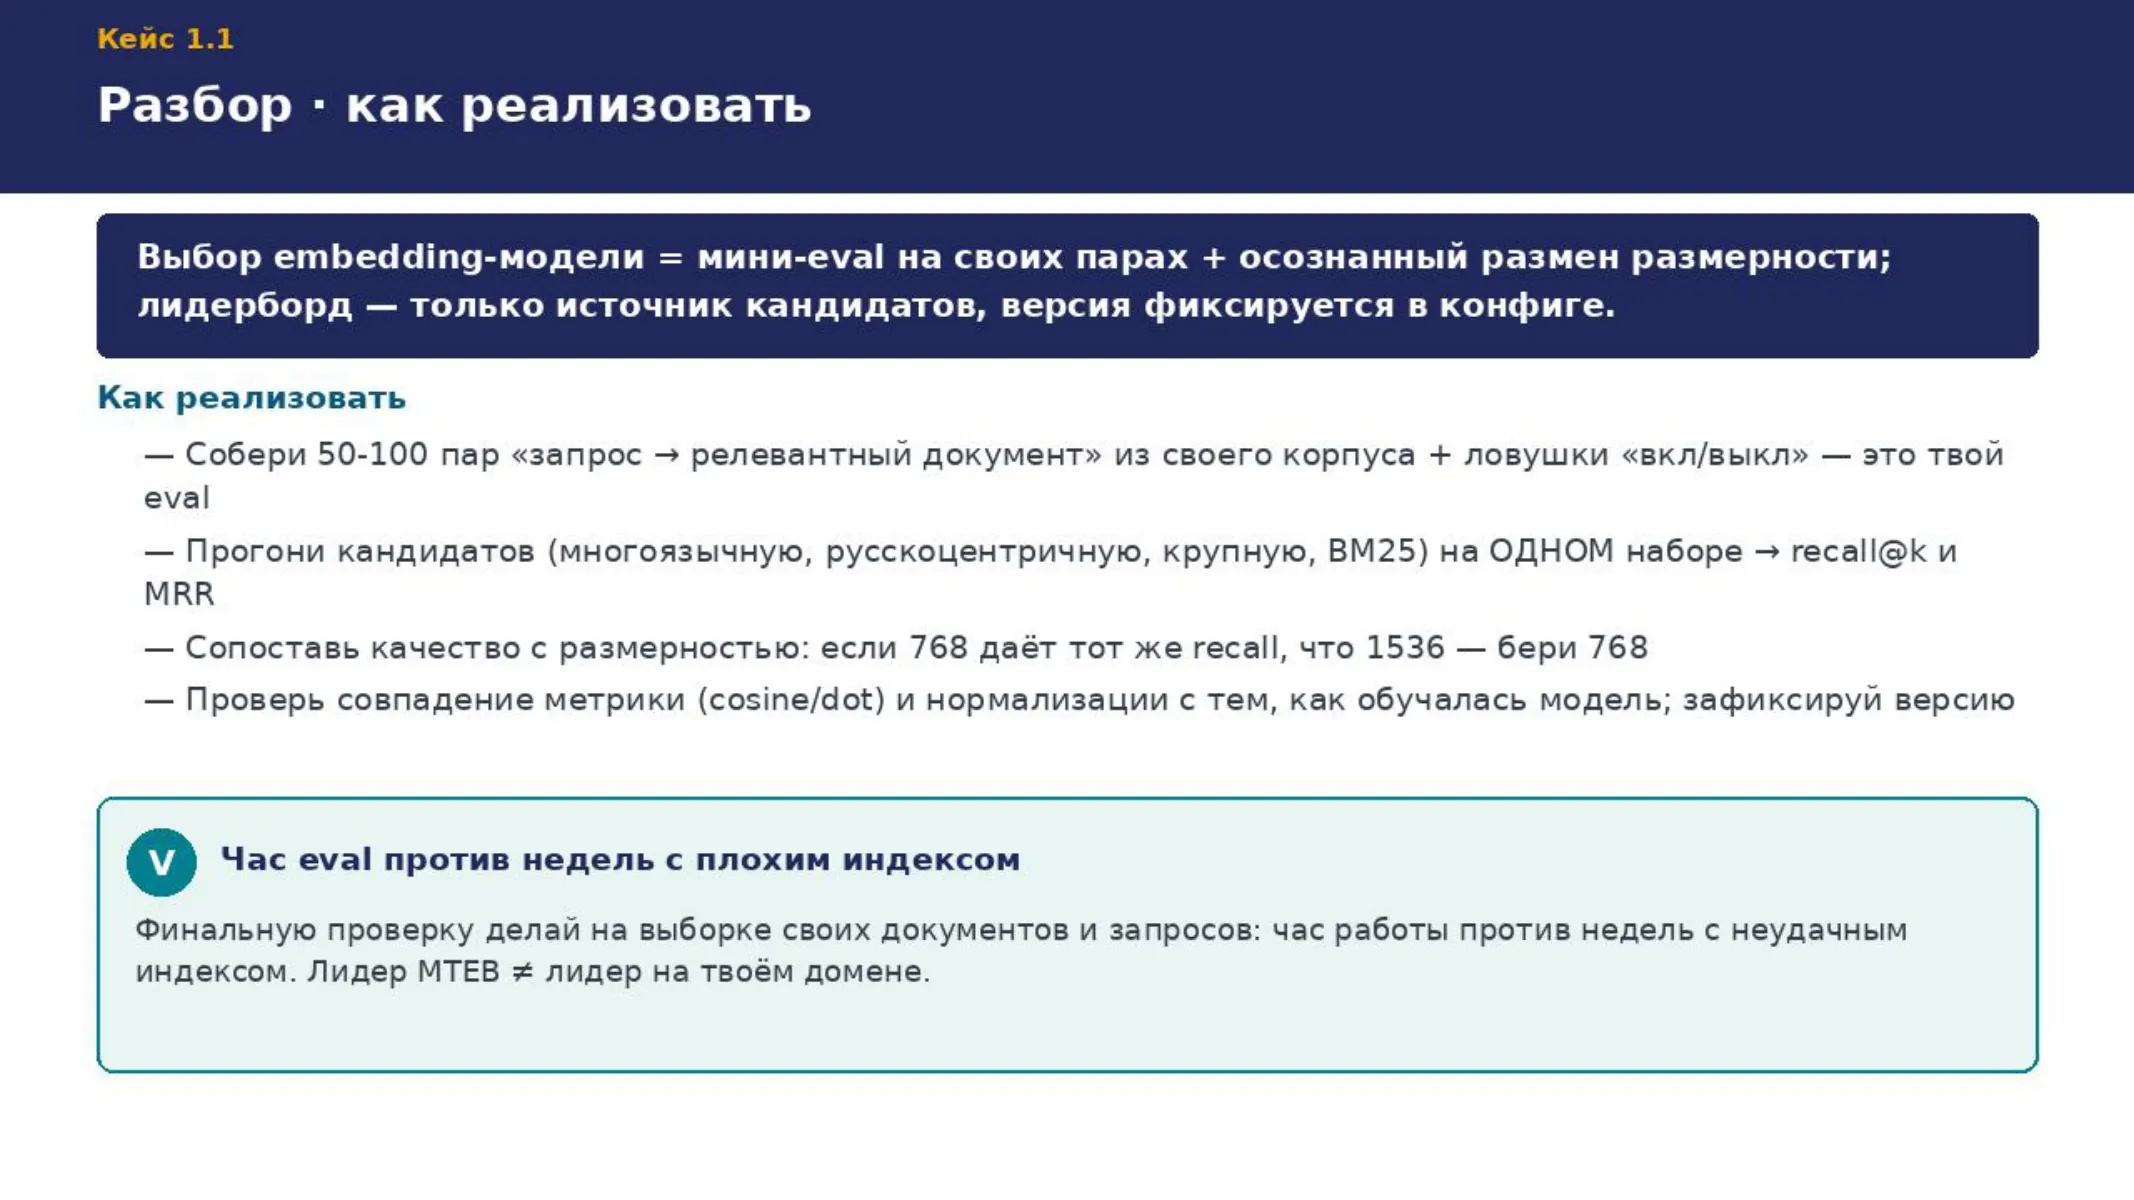
Пошаговый how-to из разбора и Q&A файла-кейса. (1) eval-набор: выпиши реальные запросы и для каждого — документ, который обязан найтись; 50-100 пар дают сигнал, обязательно добавь ловушки (антонимы, разные версии). (2) прогон: закодируй корпус и запросы каждым кандидатом, посчитай recall@k и MRR на идентичных условиях. (3) размерность: у OpenAI параметр dimensions, у матрёшечных моделей вектор режется контролируемо — проверь, теряешь ли recall при усечении. (4) грабли: дистанция и нормализация должны совпадать с обучением модели — если модель обучали на cosine с L2-нормализацией, а ты ищешь по dot без неё, качество падает без всякой «плохой модели». Простой тест согласованности метрики: закодируй два синонимичных текста и два чужих — если синонимы заметно ближе, метрика в порядке; если «всё близко ко всему» — рассогласование. Вероятный вопрос: «насколько часто пересматривать выбор модели?» — редко, из-за цены переиндексации, но eval-набор держи живым: он ловит деградацию и подсказывает, когда новая модель реально стоит перестройки индекса.
11 · Схлопнуть дубли в потоке тикетов поддержки
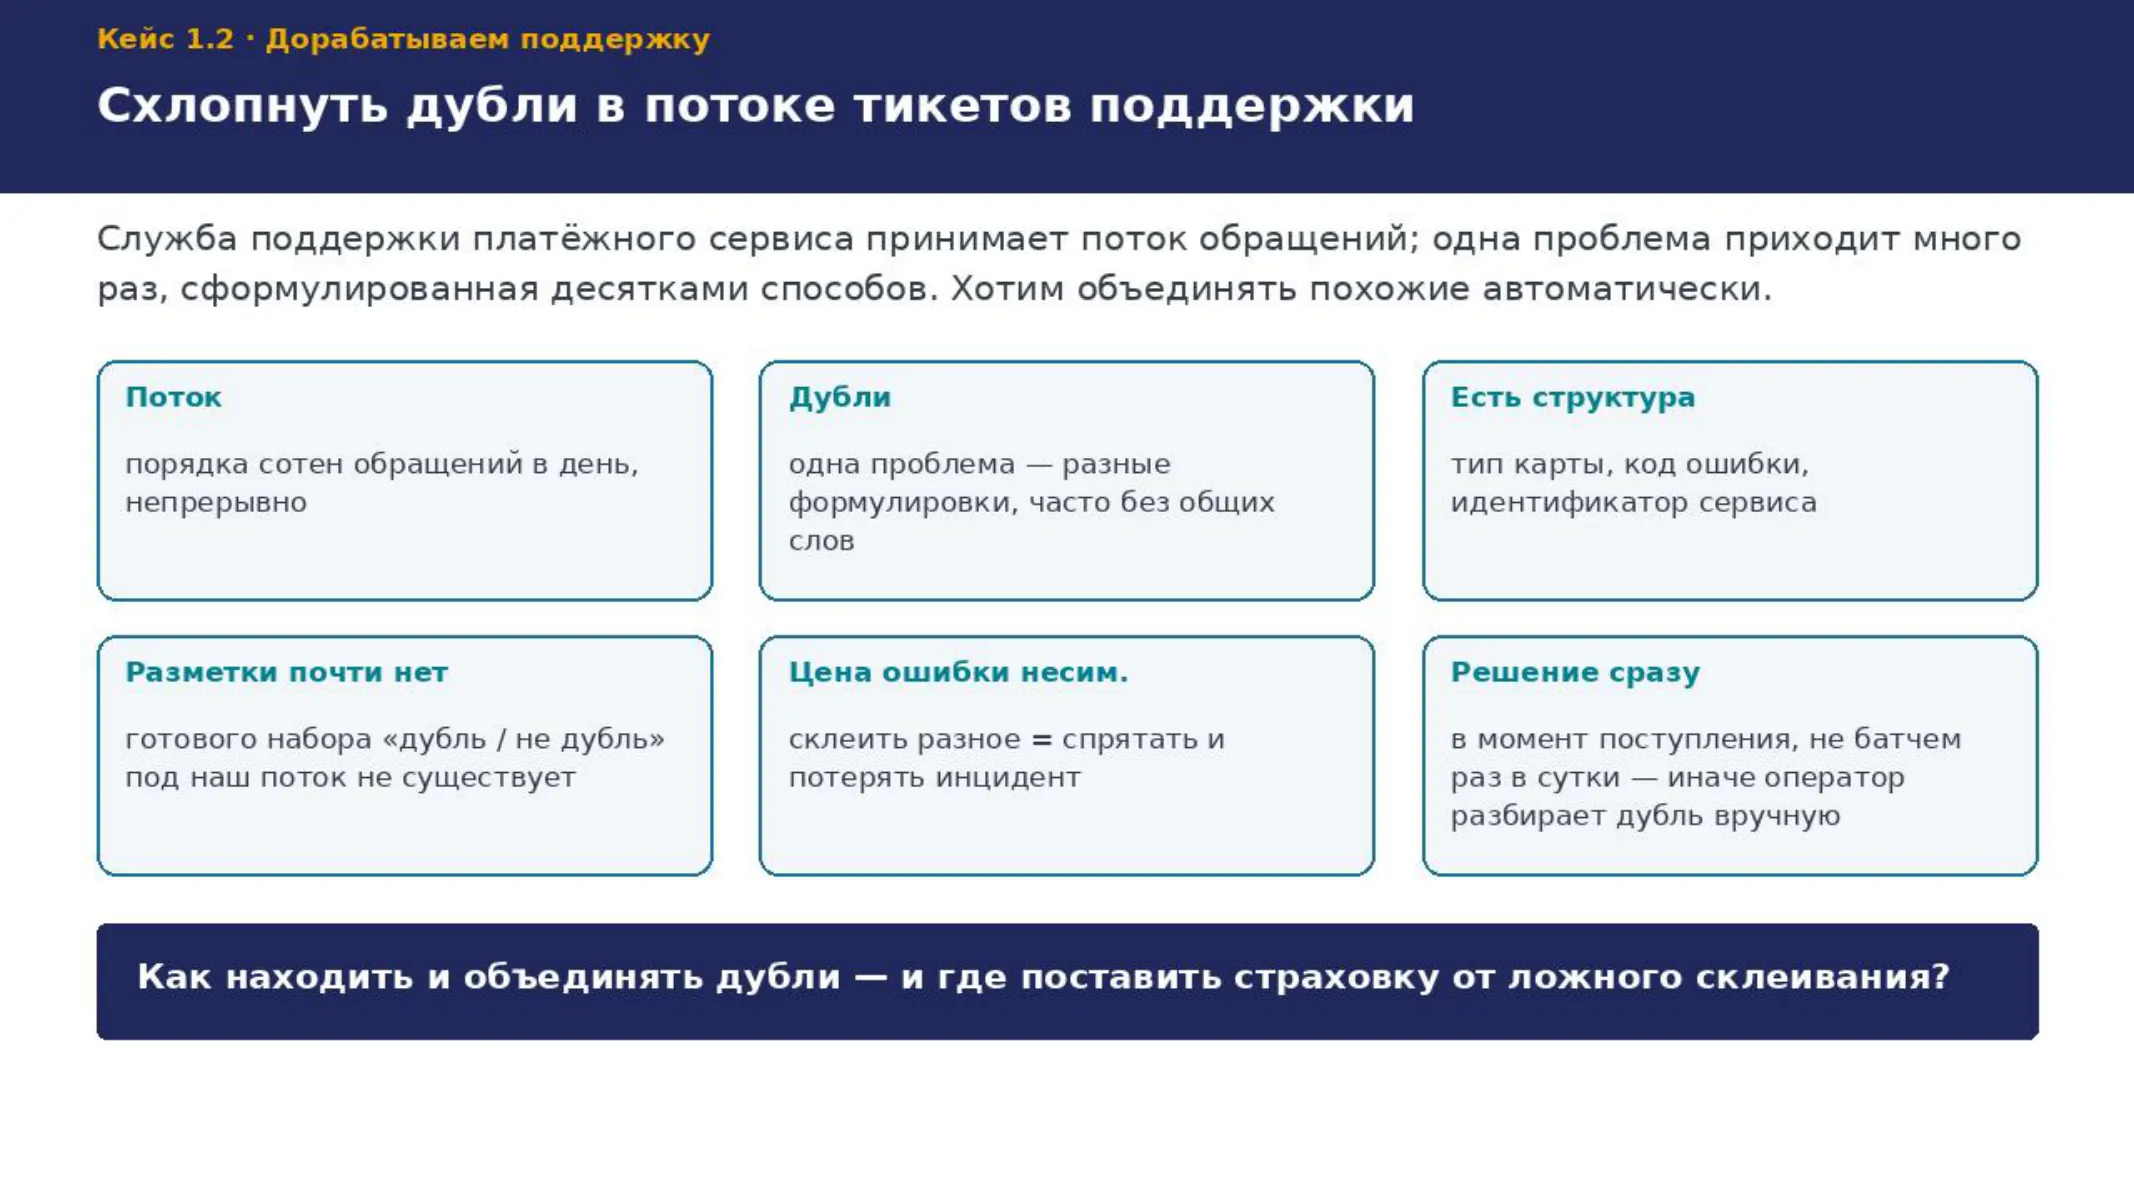
На слайде — чистая постановка, БЕЗ ловушки (она в complication). Ключевое ограничение — несимметричная цена ошибки: пропустить дубль обратимо (оператор потратит лишние минуты), а склеить разное дорого и часто необратимо — один инцидент прячется внутри чужой карточки и выпадает из разбора. Потерянный инцидент — главный риск задачи. Класс задачи — кластеризация по смыслу с защитой от ложного объединения. Два напрашивающихся хода: порог косинусной близости по эмбеддингам (просто, но склеит разные инциденты с похожим текстом) или близость + жёсткий структурный гейт по различающим полям (надёжнее). Ловушка новичка — крутить порог близости, надеясь развести близкие-но-разные тикеты, и так сломать recall на настоящих дублях. Вероятный вопрос: «откуда взять порог τ?» — не «на глаз», а по размеченным парам через precision-recall, это отдельный шаг метода. Ещё нюанс: поток непрерывный, дедуп считаем инкрементально (новый тикет против недавних кластеров через индекс ближайших соседей), а не пересчётом всей матрицы близости — иначе стоимость растёт квадратично.
12 · Как устроен дедуп — и зачем структурный гейт
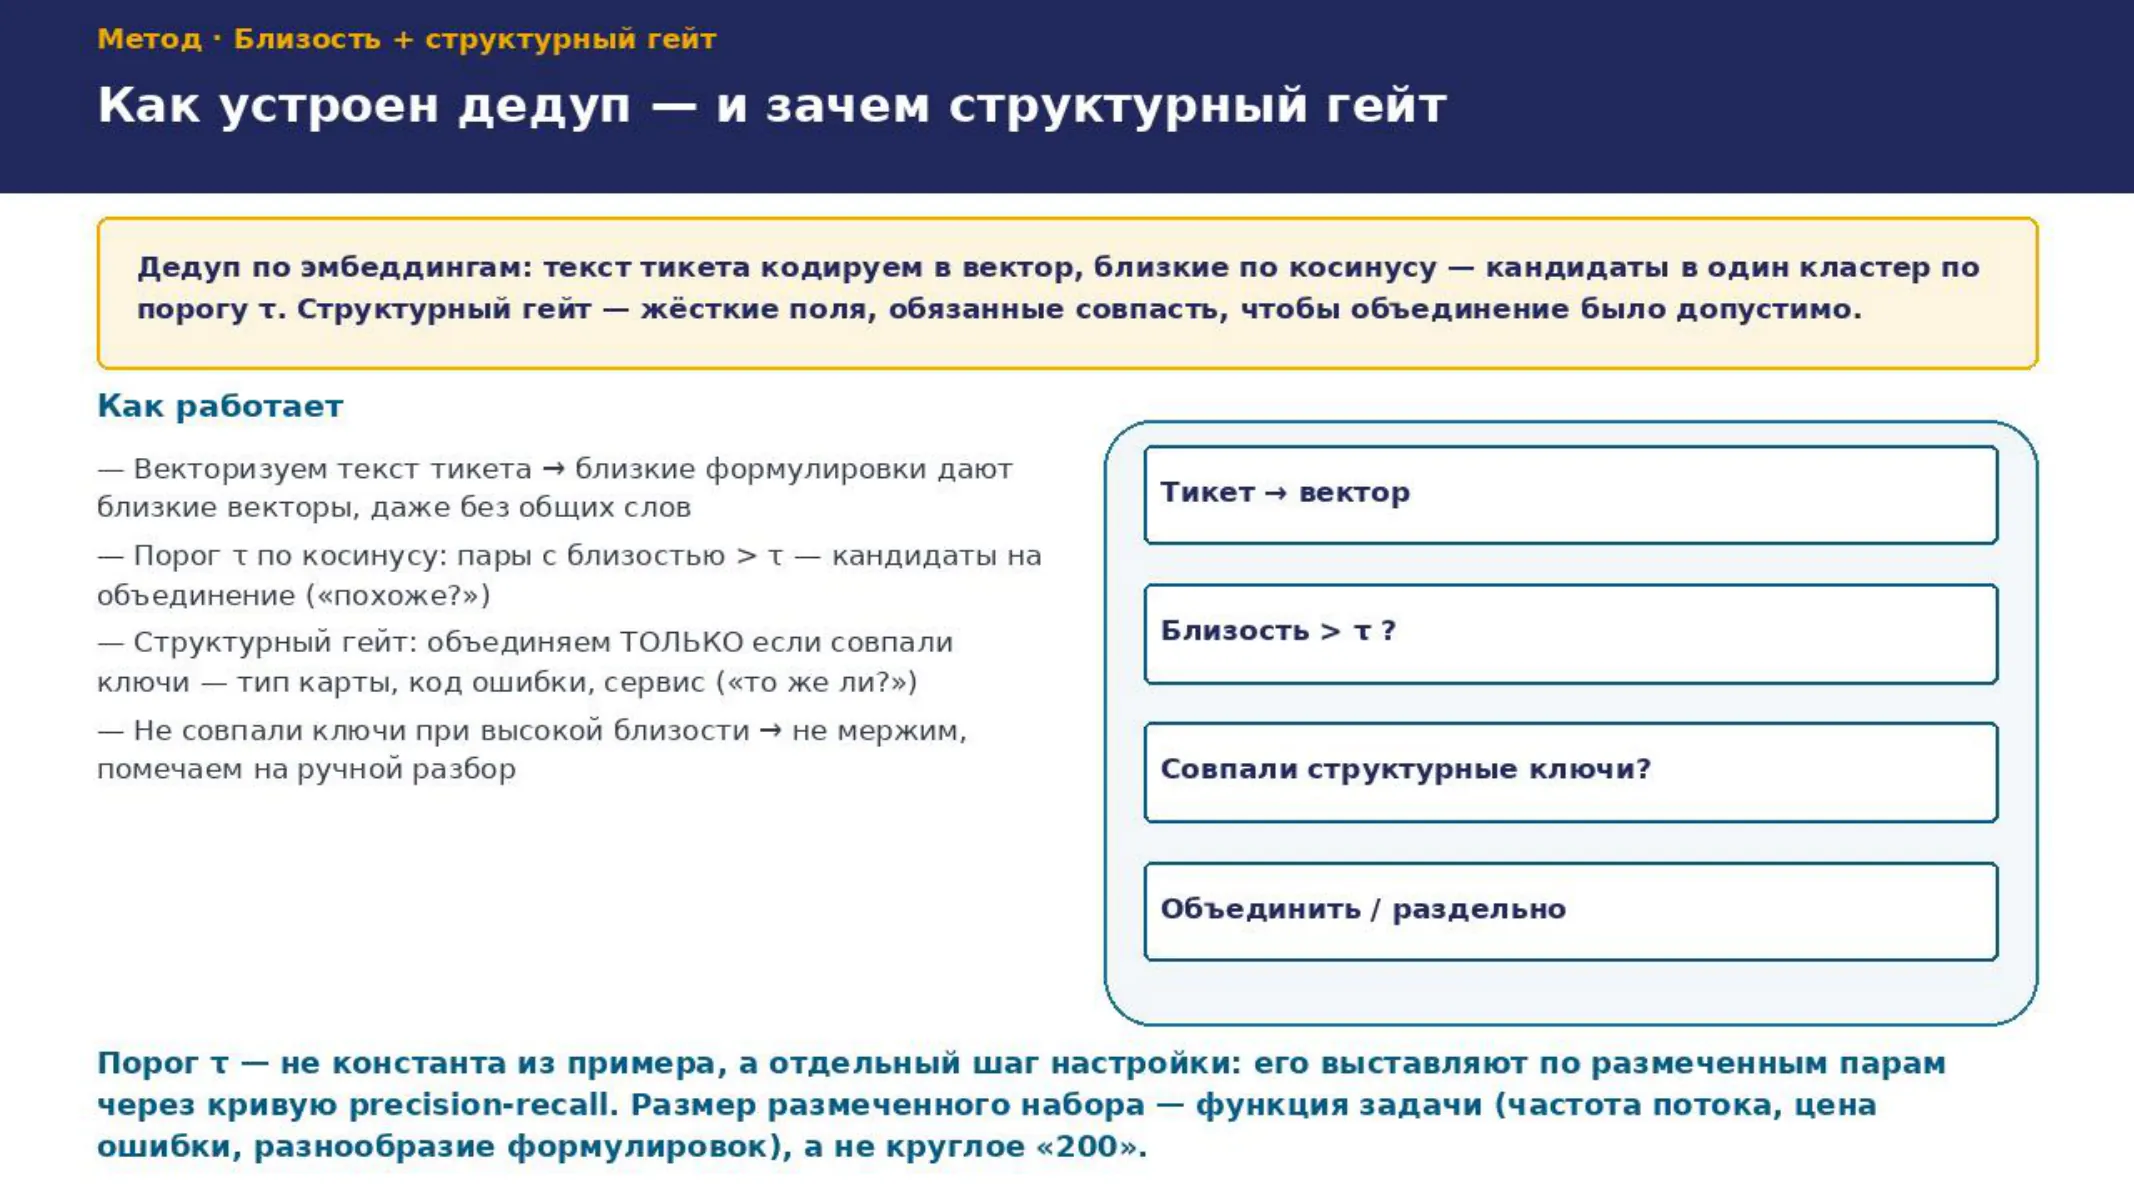
Здесь — метод, ещё не ловушка. Пайплайн разводит два вопроса: «похоже?» решает близость (дёшево, широко, с ошибками на почти-дублях), «то же ли это?» решает детерминированный структурный ключ (точно, безопасно). Порядок «близость → гейт» неслучаен: начни со структурных ключей — сложишь в кучу обращения с одинаковым кодом ошибки по разным причинам; решай всё близостью — получишь ложные склейки. Порог τ выставляют по кривой precision-recall на размеченных парах: precision (доля верных среди объединённых) приоритетна из-за несимметричной цены ошибки, recall (доля пойманных дублей) вторичен. Из-за концентрации меры в многомерном пространстве абсолютное значение косинуса малоинформативно — τ локален: своя модель, свой домен, свой язык, свой τ; чужое 0.90 не переносится. Размер набора определяется не круглым числом, а числом пар-ловушек: если из 200 пар только 8 near-duplicate, оценка precision держится на восьми наблюдениях. Вероятный вопрос: «почему не сравнивать тикеты целиком через LLM?» — на сотнях тикетов в день это тысячи вызовов, дорого и медленно; эмбеддинг+гейт дают то же за копейки, LLM оставляем на редкие спорные пары.
13 · «Visa» и «Mastercard»: похоже по вектору, но не одно и то же
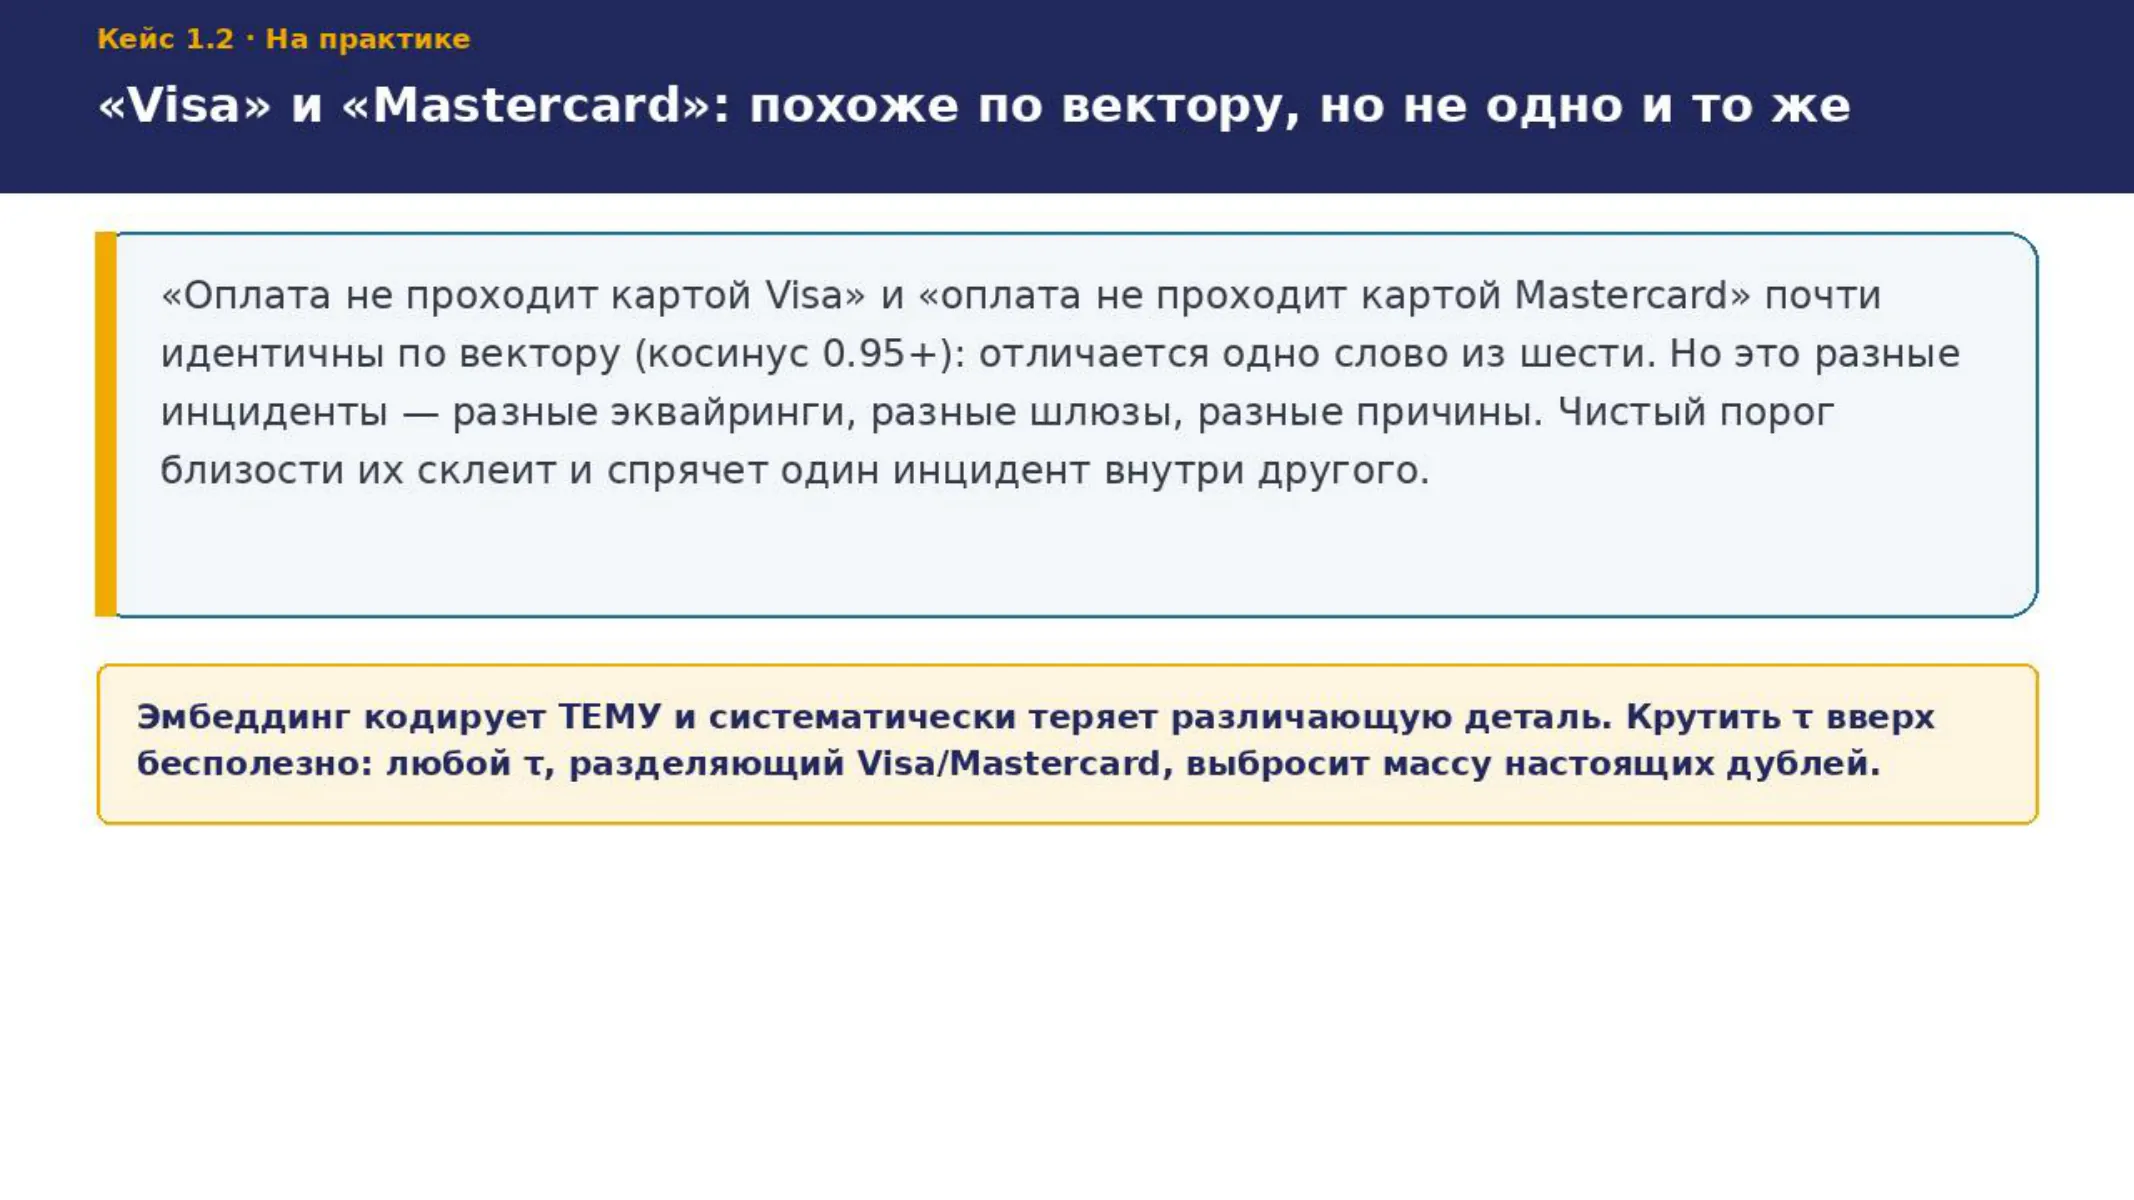
Это та самая ловушка, которую держали за пределами постановки. Почему близость высокая, а не «модель плохая»: отличается одно слово из десяти, почти всё окружение общее, вектор почти не сдвигается — свойство эмбеддинга (кодирует про ЧТО текст, а не различающую деталь). Тот же механизм делает пару «как включить проверку сертификатов» / «как отключить» почти неразличимой. Тот же класс провала документирован практиками под диагнозом «pure text similarity produces confident false merges» — уверенные ложные склейки; под семантикой «только объединять» такие ошибки необратимы, это тихая порча данных. Как детектировать: держи в eval-наборе пары-ловушки (Visa/Mastercard, разные суммы, разные коды при одинаковом тексте) и смотри, не склеивает ли их текущий τ. Решение — не крутить τ до бесконечности (сломаешь recall на настоящих дублях), а поставить жёсткий гейт по различающему полю. Отдельная грабля с обратной стороны: слишком общий структурный ключ (переупрощённый dedup_key) склеивает так же вредно, как наивный порог — поля гейта подбираются под предметную область так же ответственно, как τ. Вероятный вопрос: «почему бы не поднять τ и не городить гейт?» — высокий τ выкидывает настоящие дубли; гейт снимает компромисс, позволяя держать τ ниже без ложных склеек.
14 · Гибрид «близость + структурные ключ軶
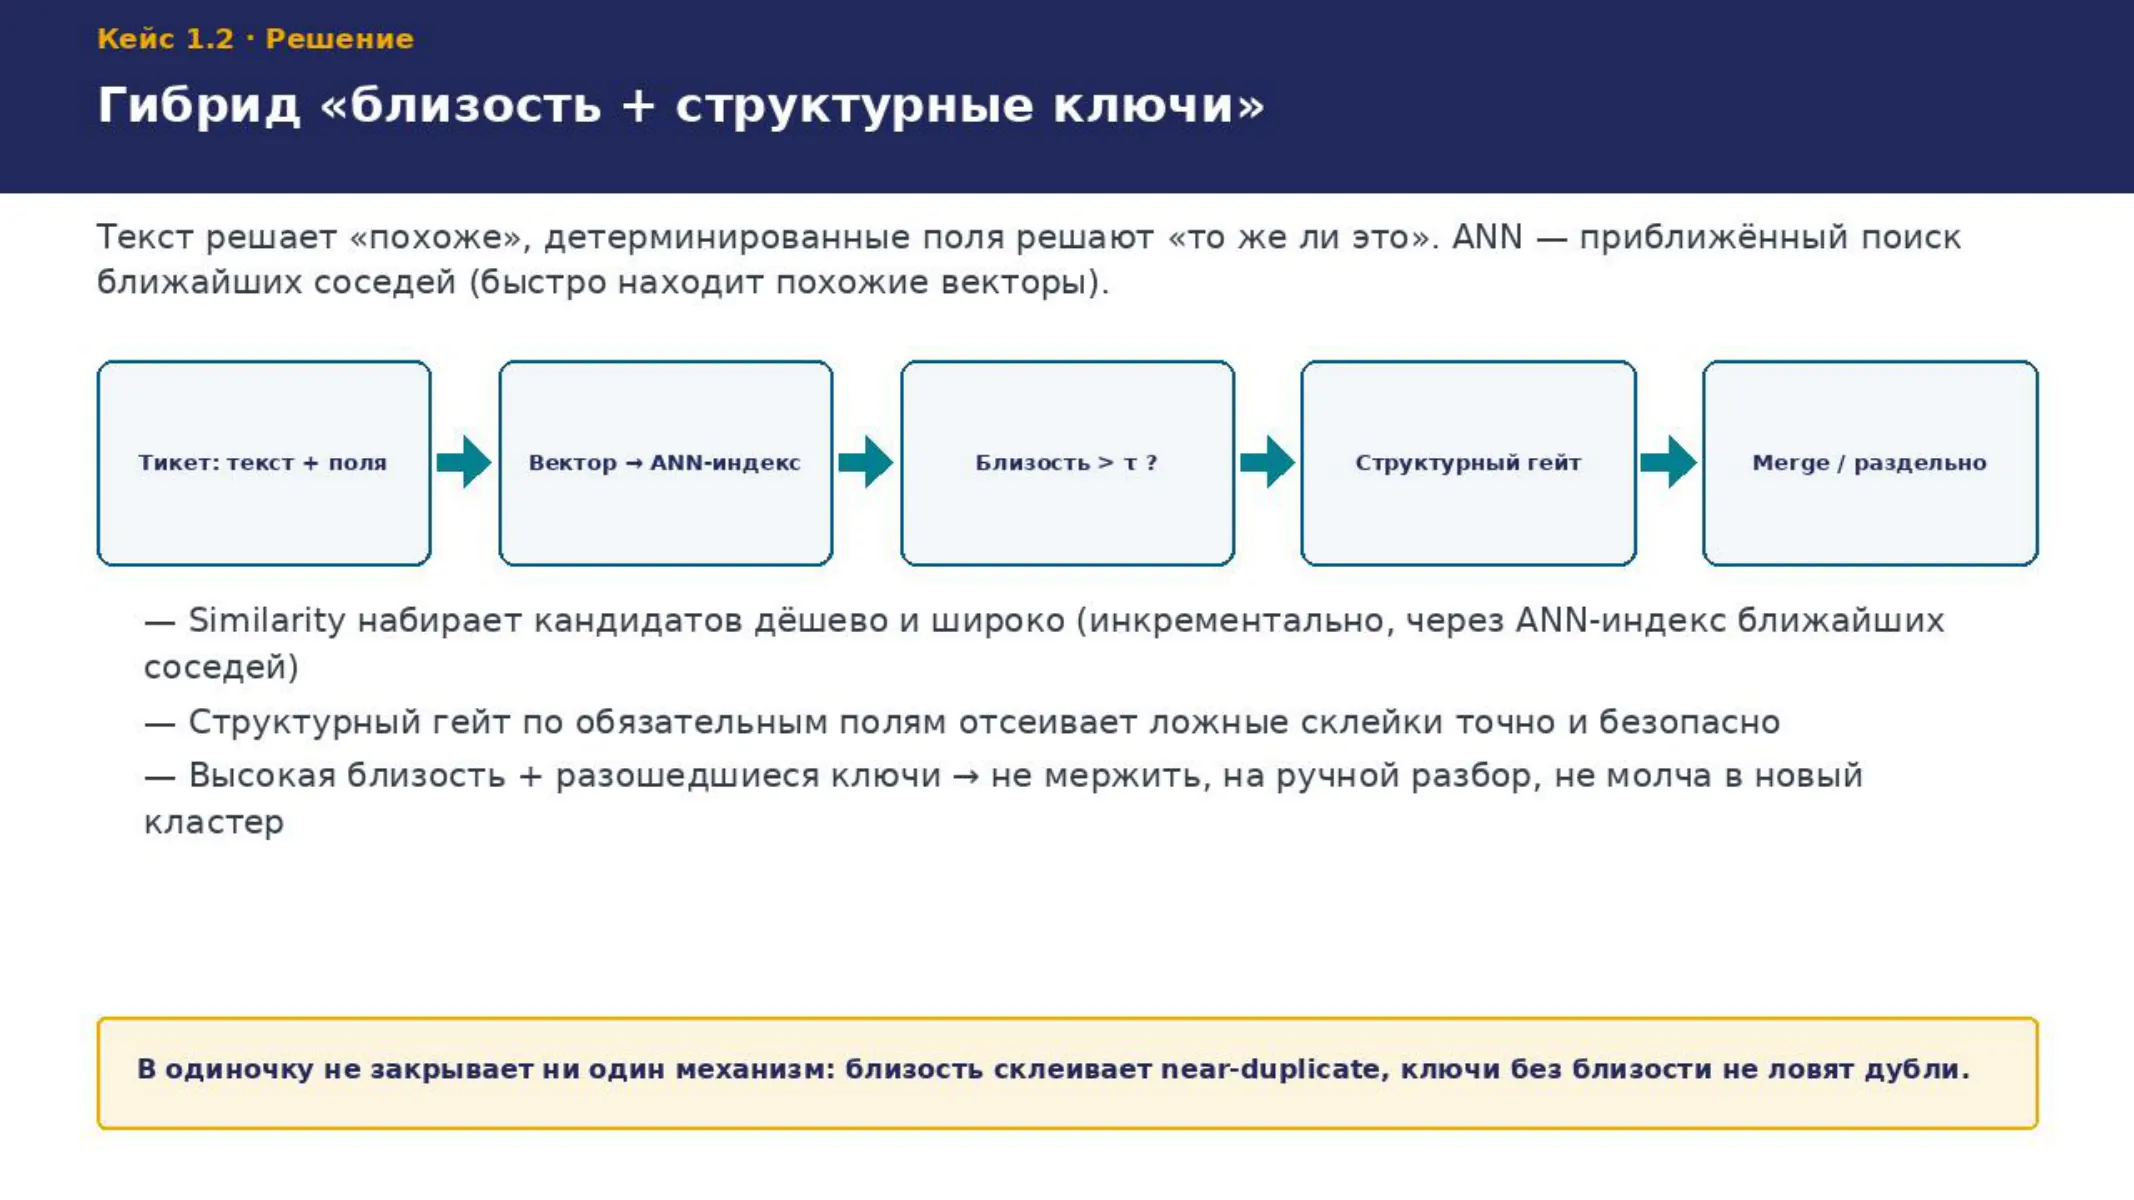
Схема из раздела 6.1 файла-кейса. Новый тикет проходит нормализацию: извлекаются структурные поля (тип карты, код ошибки, сервис) и очищенный текст. Текст кодируется в вектор, ANN-индекс (approximate nearest neighbors — приближённый поиск ближайших) достаёт соседей среди недавних тикетов и центроидов кластеров. Соседи с близостью выше τ становятся кандидатами. Кандидат проходит в объединение только если совпали все обязательные структурные ключи; иначе тикет остаётся отдельным и, если близость была высокой (near-duplicate со спорным ключом), помечается на ручной разбор, а не тихо теряется. Проследи на тикетах: A и B про одну проблему разными словами, error_code=51 у обоих → близость 0.93, гейт прошёл → merge. C по тексту идентичен B, но error_code=05 → близость 0.97, но гейт не прошёл → новый кластер + на ручной разбор; по одной близости C был бы склеен и инцидент с кодом 05 растворился бы. Спорные пары — ещё и источник новых пар-ловушек для дозагрузки набора. Вероятный вопрос: «пересчитывать всё при каждом тикете?» — нет, только против недавних через ANN-индекс; полный пересчёт — только при смене модели.
15 · Кейс 1.2 · Разбор
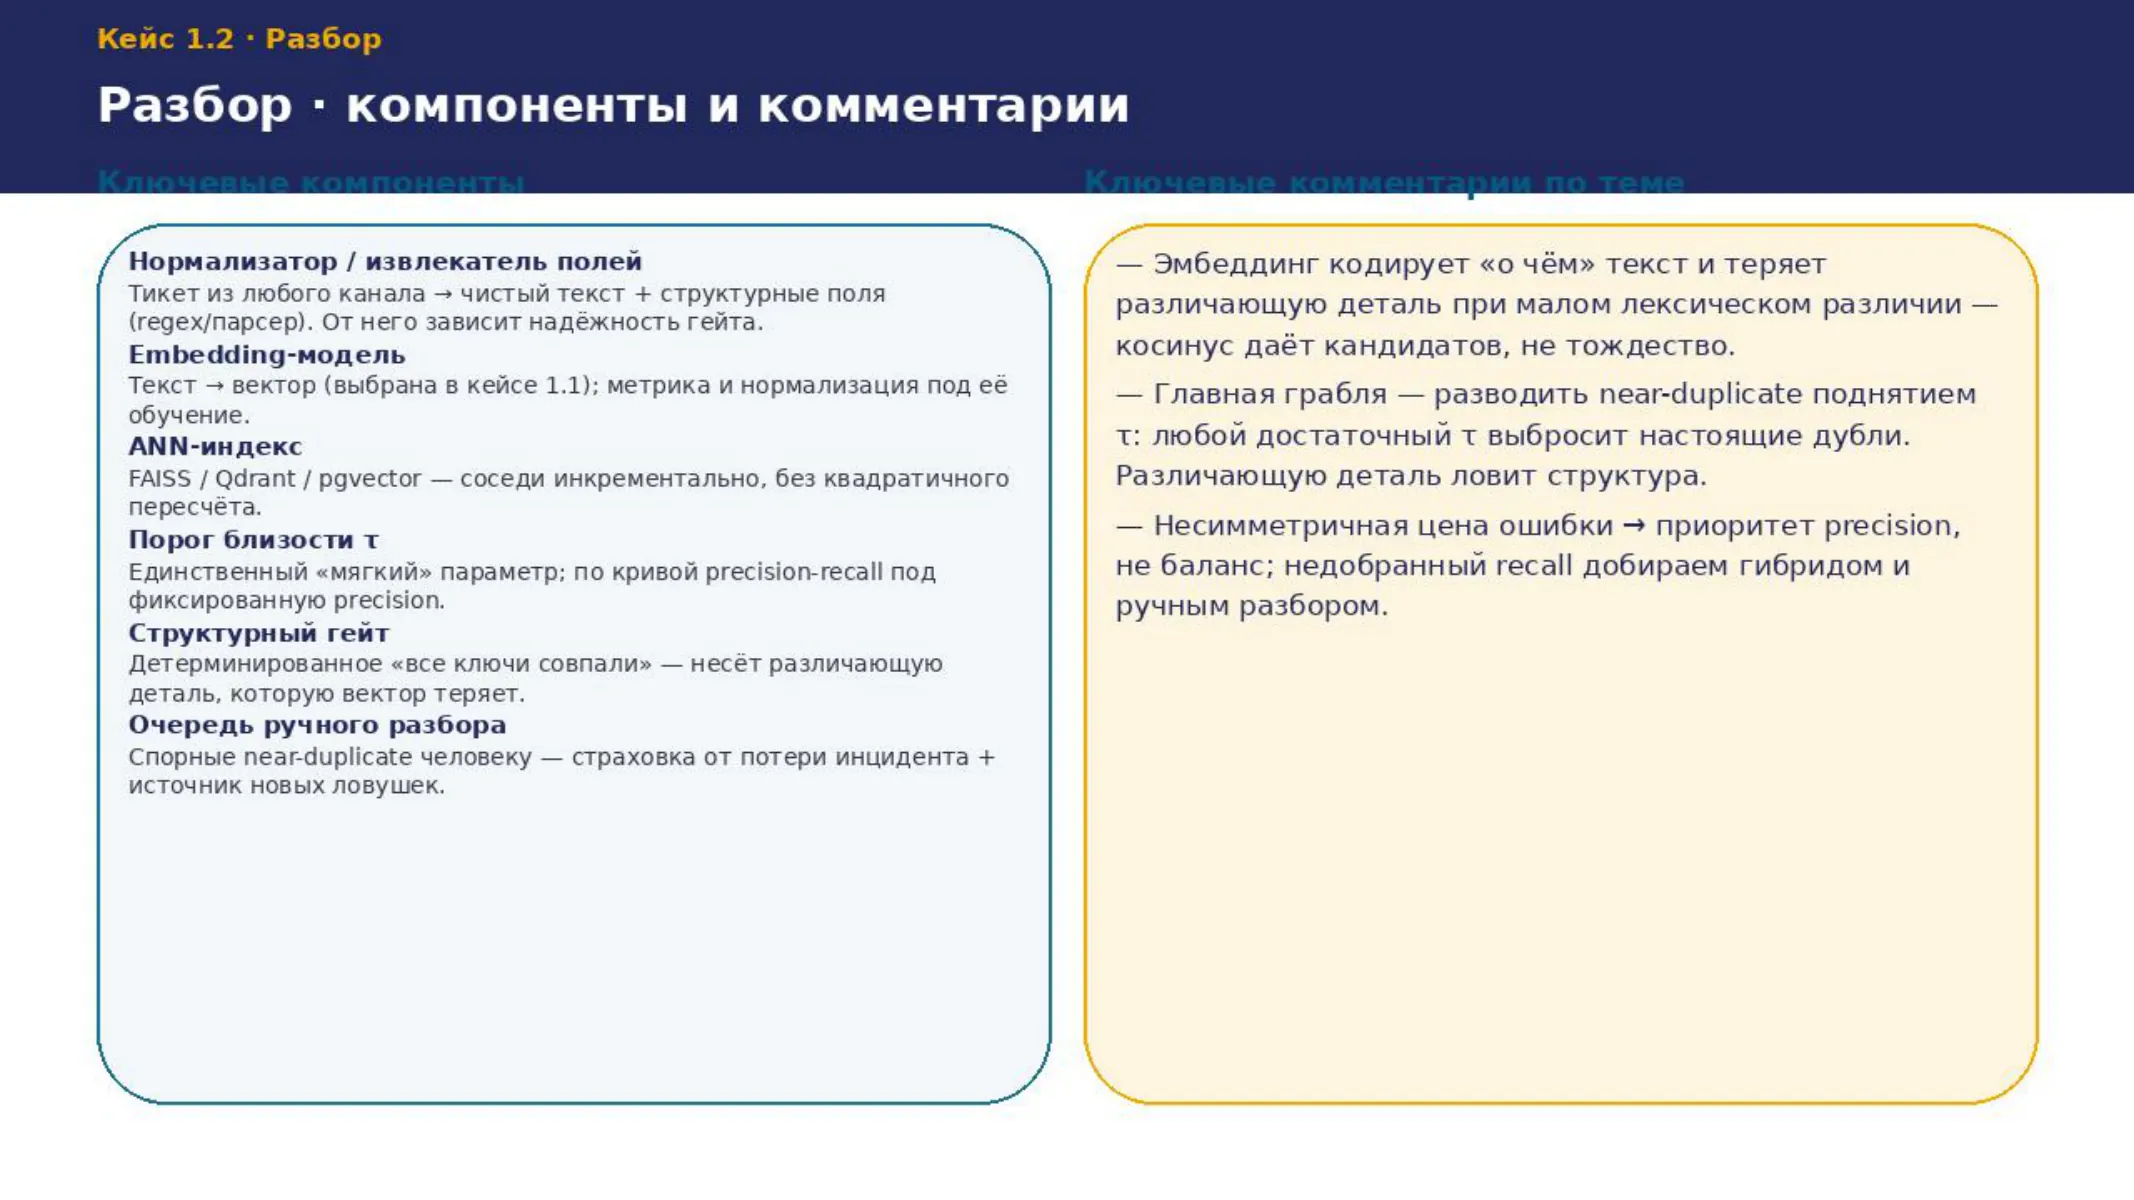
Разбор из разделов 6.2-6.4 файла-кейса. Что иллюстрирует кейс из механизма: эмбеддинг кодирует, О ЧЁМ текст, и систематически теряет различающую деталь при малом лексическом различии — дедуп это чистейшая демонстрация, near-duplicate «Visa/Mastercard» неразличимы по вектору, потому что механизм усредняет контекст. Косинусная близость — сигнал кандидатов, не сигнал тождества. Главная грабля — пытаться развести почти-дубли, поднимая τ: любой τ, достаточный, чтобы разделить почти-идентичные разные инциденты, выбросит массу настоящих дублей — платишь recall'ом за проблему, которую порог не решает в принципе. Различающую деталь ловит структура, не порог. Где граница: структурный гейт надёжен ровно настолько, насколько надёжно извлечены и заполнены поля — пустые/неверные поля делают гейт бесполезным; слишком общий гейт склеивает вредно, слишком узкий не схлопывает дубли. Из-за несимметричной цены ошибки приоритетная метрика — precision на объединениях, а не баланс; порог выбирают под допустимый уровень ложных склеек. Вероятный вопрос: «что при смене embedding-модели?» — новая геометрия, старый τ недействителен, набор перемерить, корпус переиндексировать; версию модели держи в конфиге явно, тихое обновление сдвинет распределение сходств и незаметно сломает дедуп.
16 · Кейс 1.2
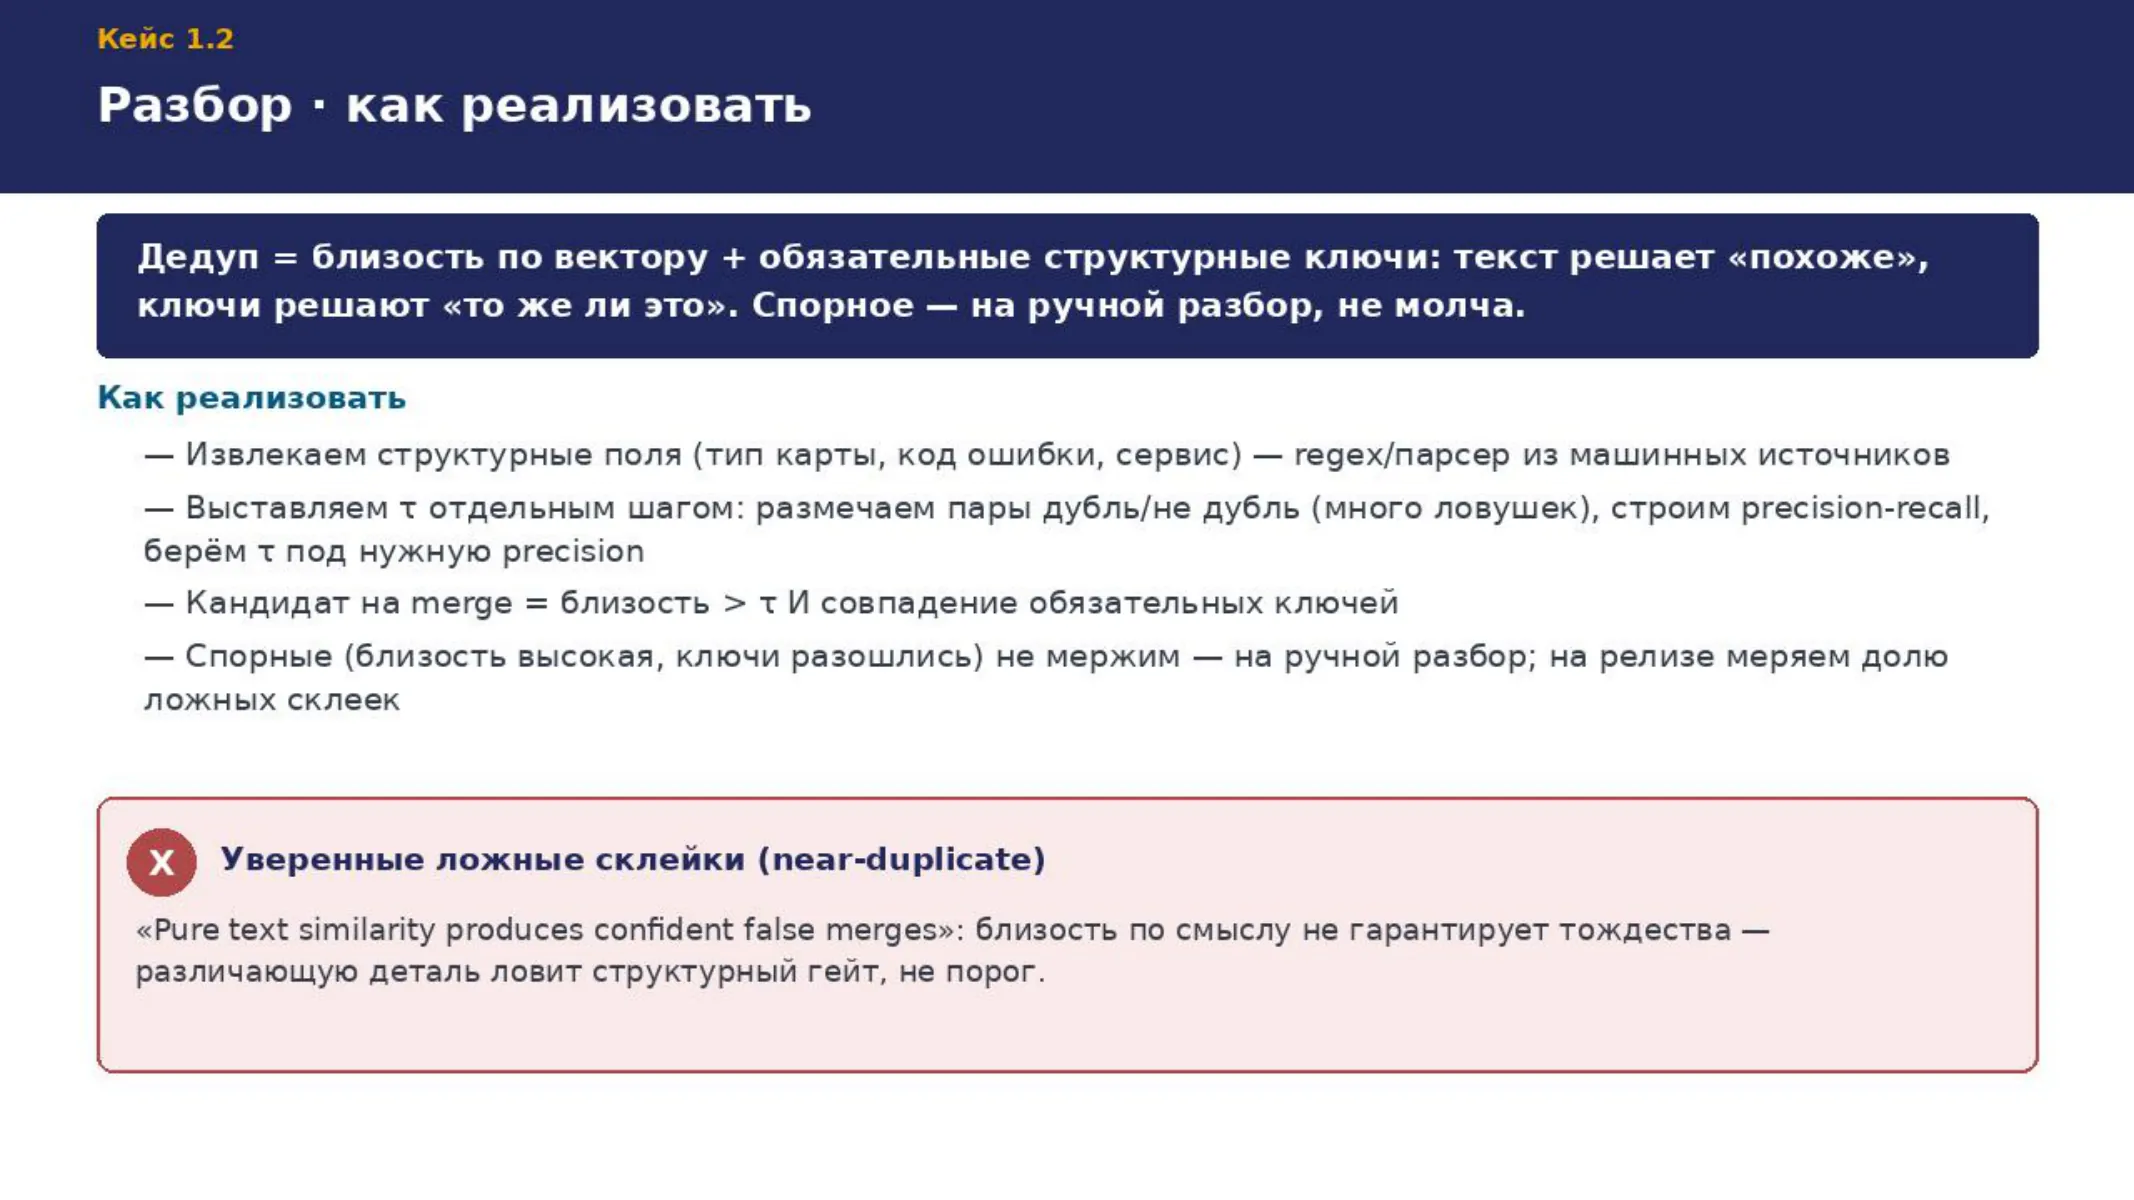
На карточке-примере: одна команда не выкатила чистую вектор-кластеризацию — она давала худшую precision на самых важных склейках; выкатили строгий детерминированный гейт. Пошаговый how-to из разбора и Q&A файла-кейса. Pipeline из двух шагов: шаг 1 — similarity набирает кандидатов (дёшево, широко); шаг 2 — детерминированная проверка ключей решает окончательно (точно, безопасно). Как выставить τ руками: размечаешь пары как дубль/не дубль с высокой долей пар-ловушек; для сетки значений τ считаешь precision и recall; берёшь τ, где precision достаточен под цену ошибки. Размер набора — функция задачи: начни с 30-50 честных пар с ловушками, добирай, пока оценка precision у выбранного τ не перестанет прыгать при добавлении пар. Спорные пары, ушедшие на ручной разбор, — почти готовая разметка: замкни цикл, вердикты пополняют набор. Как выбрать поля гейта: кандидаты — поля, различающие инциденты (тип карты, код ошибки, сервис), а не описывающие их (канал, версия приложения); проверь на парах-ловушках, что поле различается у ловушек и совпадает у настоящих дублей. Грабли: один τ на разнородный поток — плохой компромисс, считай τ по классам. Вероятный вопрос: «обойтись одними структурными ключами без эмбеддингов?» — только если все различающие поля заполнены и надёжны; у пользовательских обращений структура частична, а «одна проблема — разные слова» это про текст.
17 · Внимание: что модель понимает в тексте
18 · Извлечь «кто, кому, сколько и когда платит»
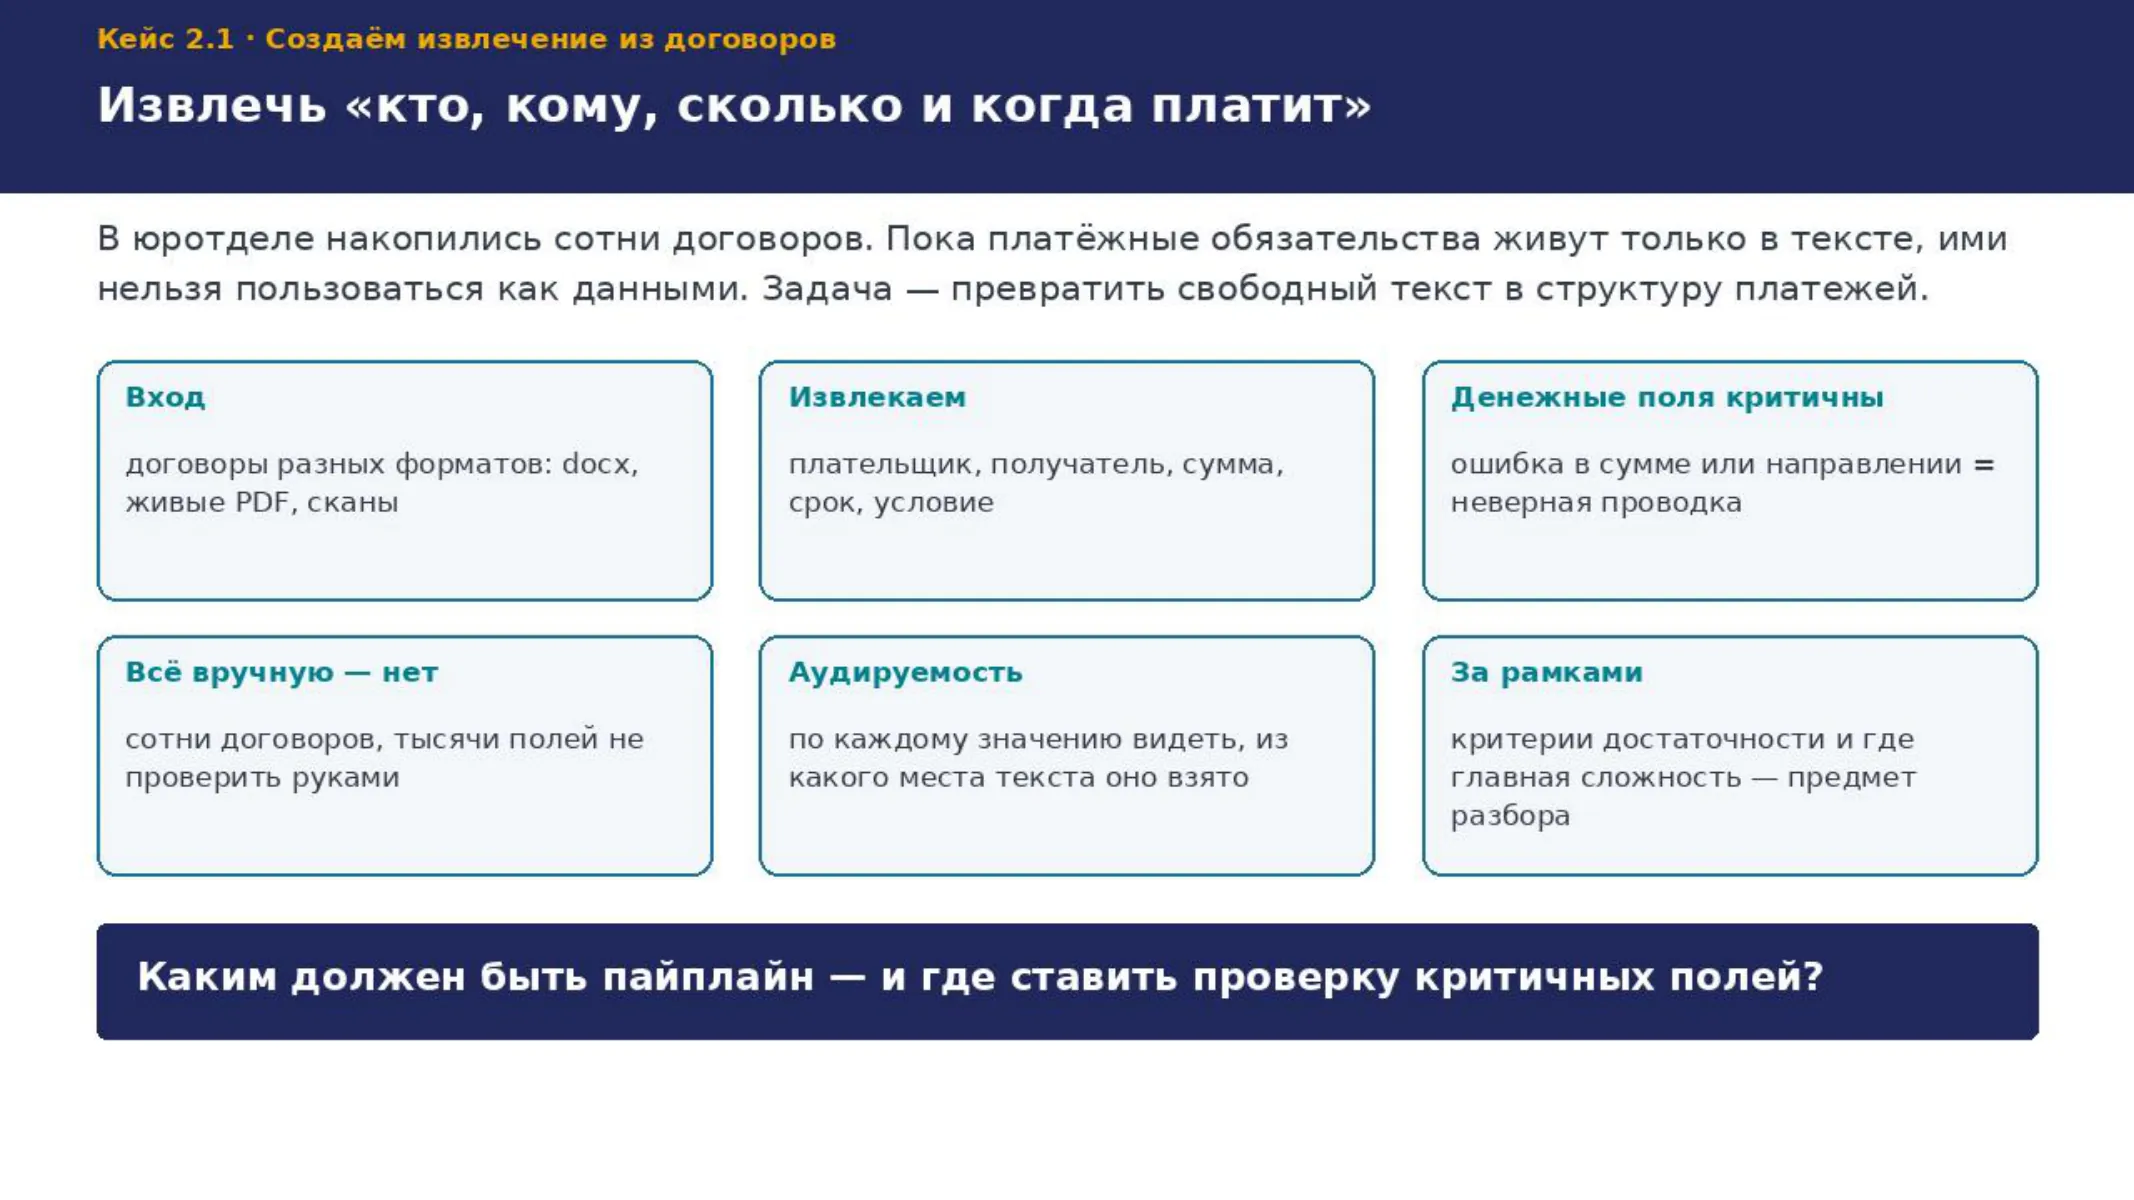
На слайде — только постановка, БЕЗ упоминания сложности (кореференция уходит в complication). Ключевое: денежные поля критичны (ошибка в сумме, валюте или направлении «кто кому» = неверная проводка, потенциально платёж не тому), всё вручную не проверить, нужна аудируемость — по каждому значению видеть место в тексте («модель так сказала» — не аргумент для бухгалтерии). Соблазн — прогнать всё через модель одним запросом; именно поэтому важно заранее понять, почему прямолинейный путь на денежных полях опасен. Класс задачи — извлечение структурированных данных (information extraction) с верификацией. Два напрашивающихся хода: отдать всё LLM «извлеки поля» (быстро на типовом, системно ошибается на неоднозначном) или LLM-извлечение + span-обоснование + детерминированные проверки + гейт уверенности (надёжнее на деньгах). Правильный рефлекс инженера — не «какую модель взять», а «какие поля критичны, что я смогу проверить машинно, где придётся оставить человека». Ещё ловушка входа: сканы и поехавшие PDF — до извлечения нужен нормализатор в текст, иначе модель уверенно «извлекает» чушь из плохого OCR; качество входа проверяй до того, как винить модель за выход.
19 · Значение + span-обоснование + гейт уверенности
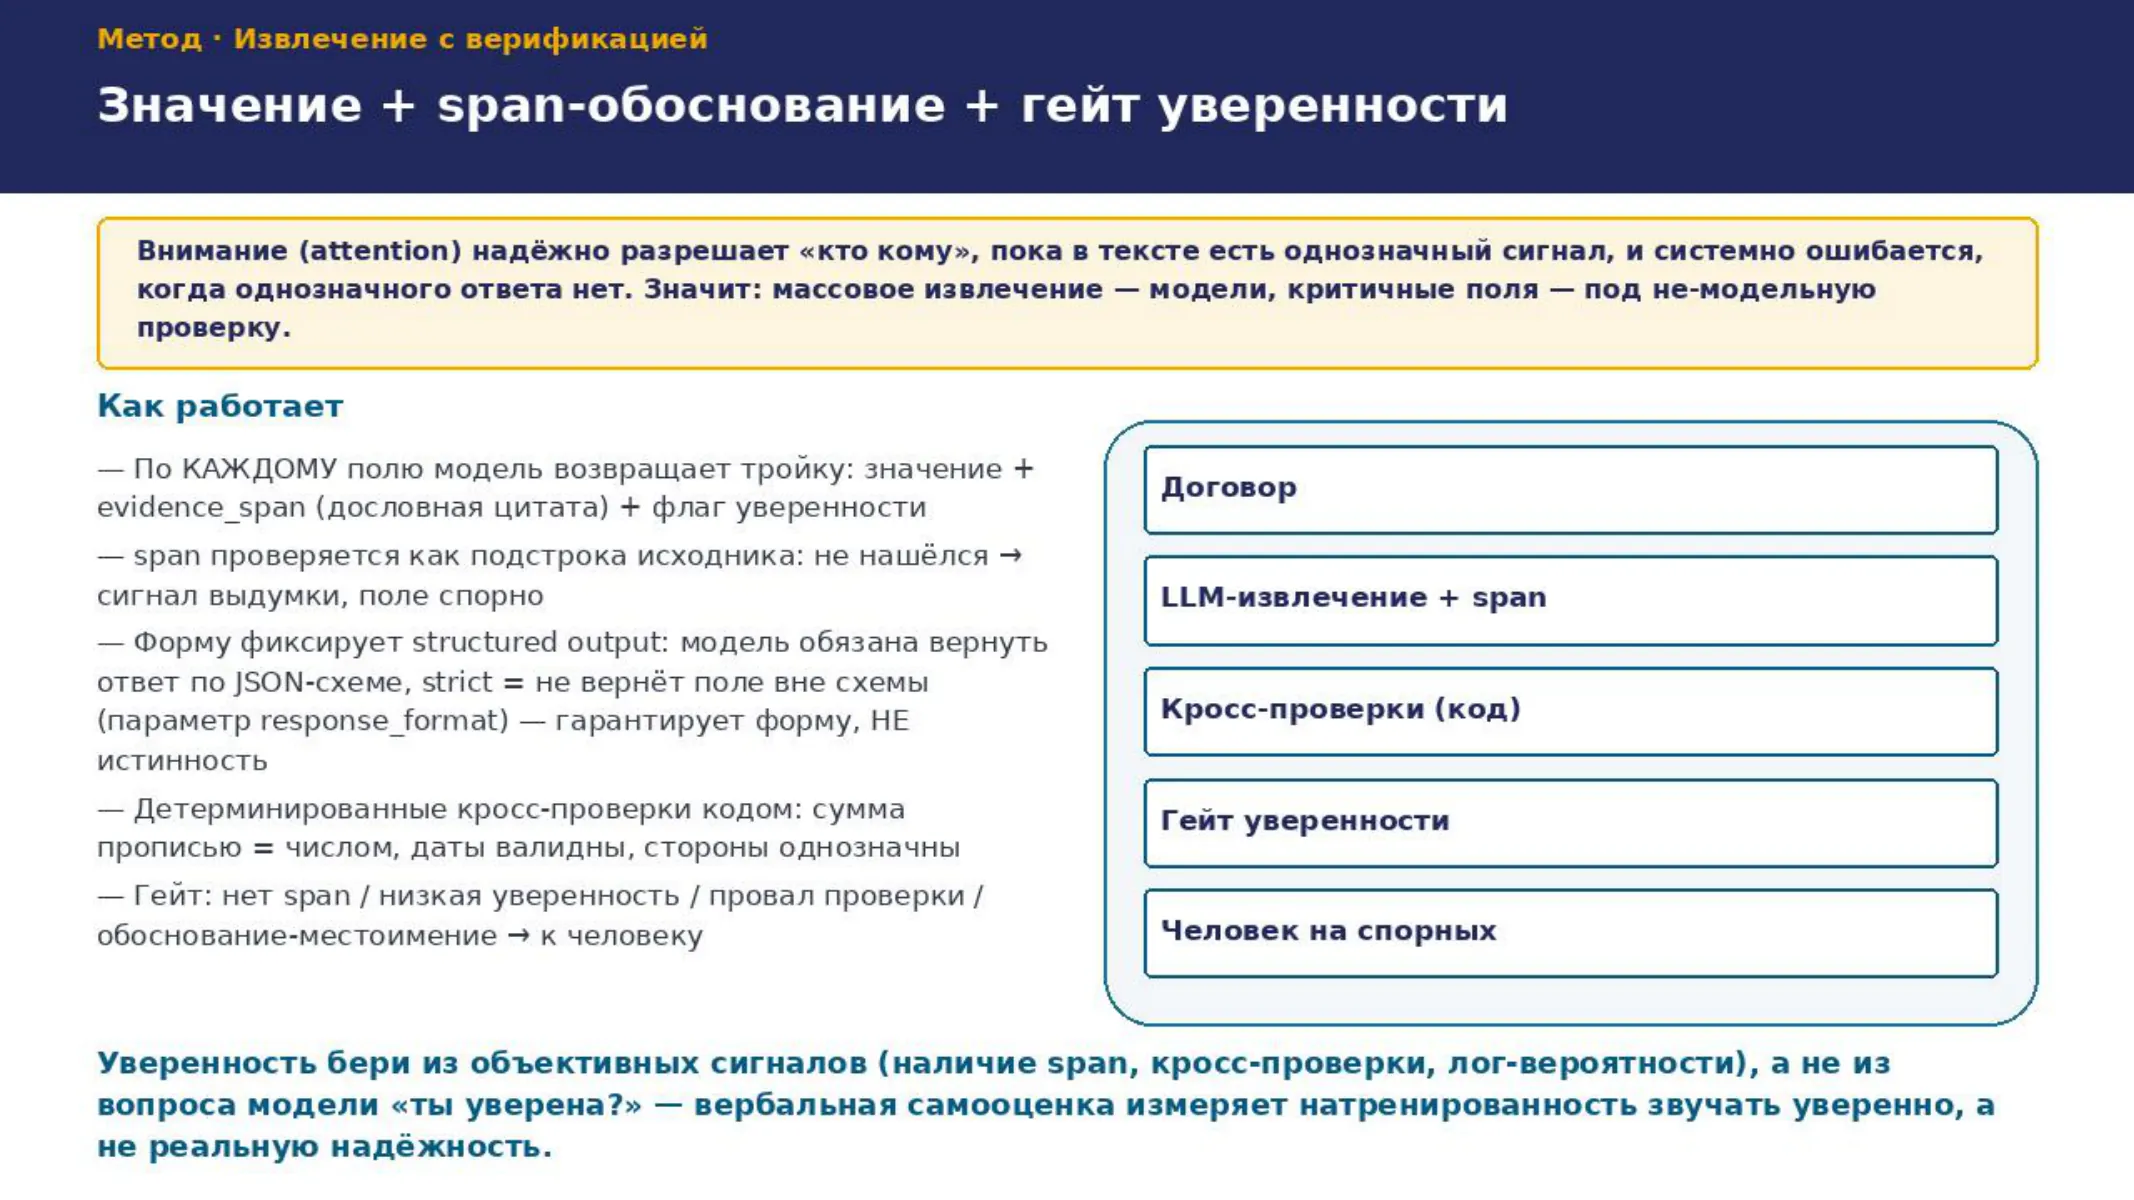
Здесь — метод, ещё не сама сложность. Наивный подход «извлеки JSON» работает на типовом и молча ломается на неоднозначном. Улучшение, дающее зацепку для проверки: по каждому полю тройка значение + evidence_span + confidence. Смысл span не «объяснить» решение (объяснение модель тоже выдумает), а в том, что его можно детерминированно проверить — искать как подстроку в тексте; не нашёлся → сигнал галлюцинации, дешёвый не-модельный детектор. Форму фиксирует structured output (response_format с json_schema, strict) — модель обязана вернуть JSON заданной формы; важная оговорка: схема гарантирует форму, а не истинность (payer будет строкой, но не факт, что это правильная сторона). Порядок стабильное-в-начало (системный промпт + схема кэшируются между сотнями договоров через prompt caching), переменное-в-конец (текст договора). Кросс-проверки — обычный код: num2words/парсер прописи для сумм, dateutil/workalendar для дат, справочники валют, словарь сторон из шапки. Практичный приём для сторон: сначала извлечь реквизиты сторон из шапки, потом требовать, чтобы payer/payee разрешались в известного субъекта; «Сторона», «он» не сопоставятся — неоднозначность из невидимой становится детектируемой. Вероятный вопрос: «как получить уверенность, если самооценке нельзя верить?» — наличие span, лог-вероятности токенов, вербальный флаг только как дополнительный сигнал.
20 · «…если он предоставит гарантию» — кто «он»?
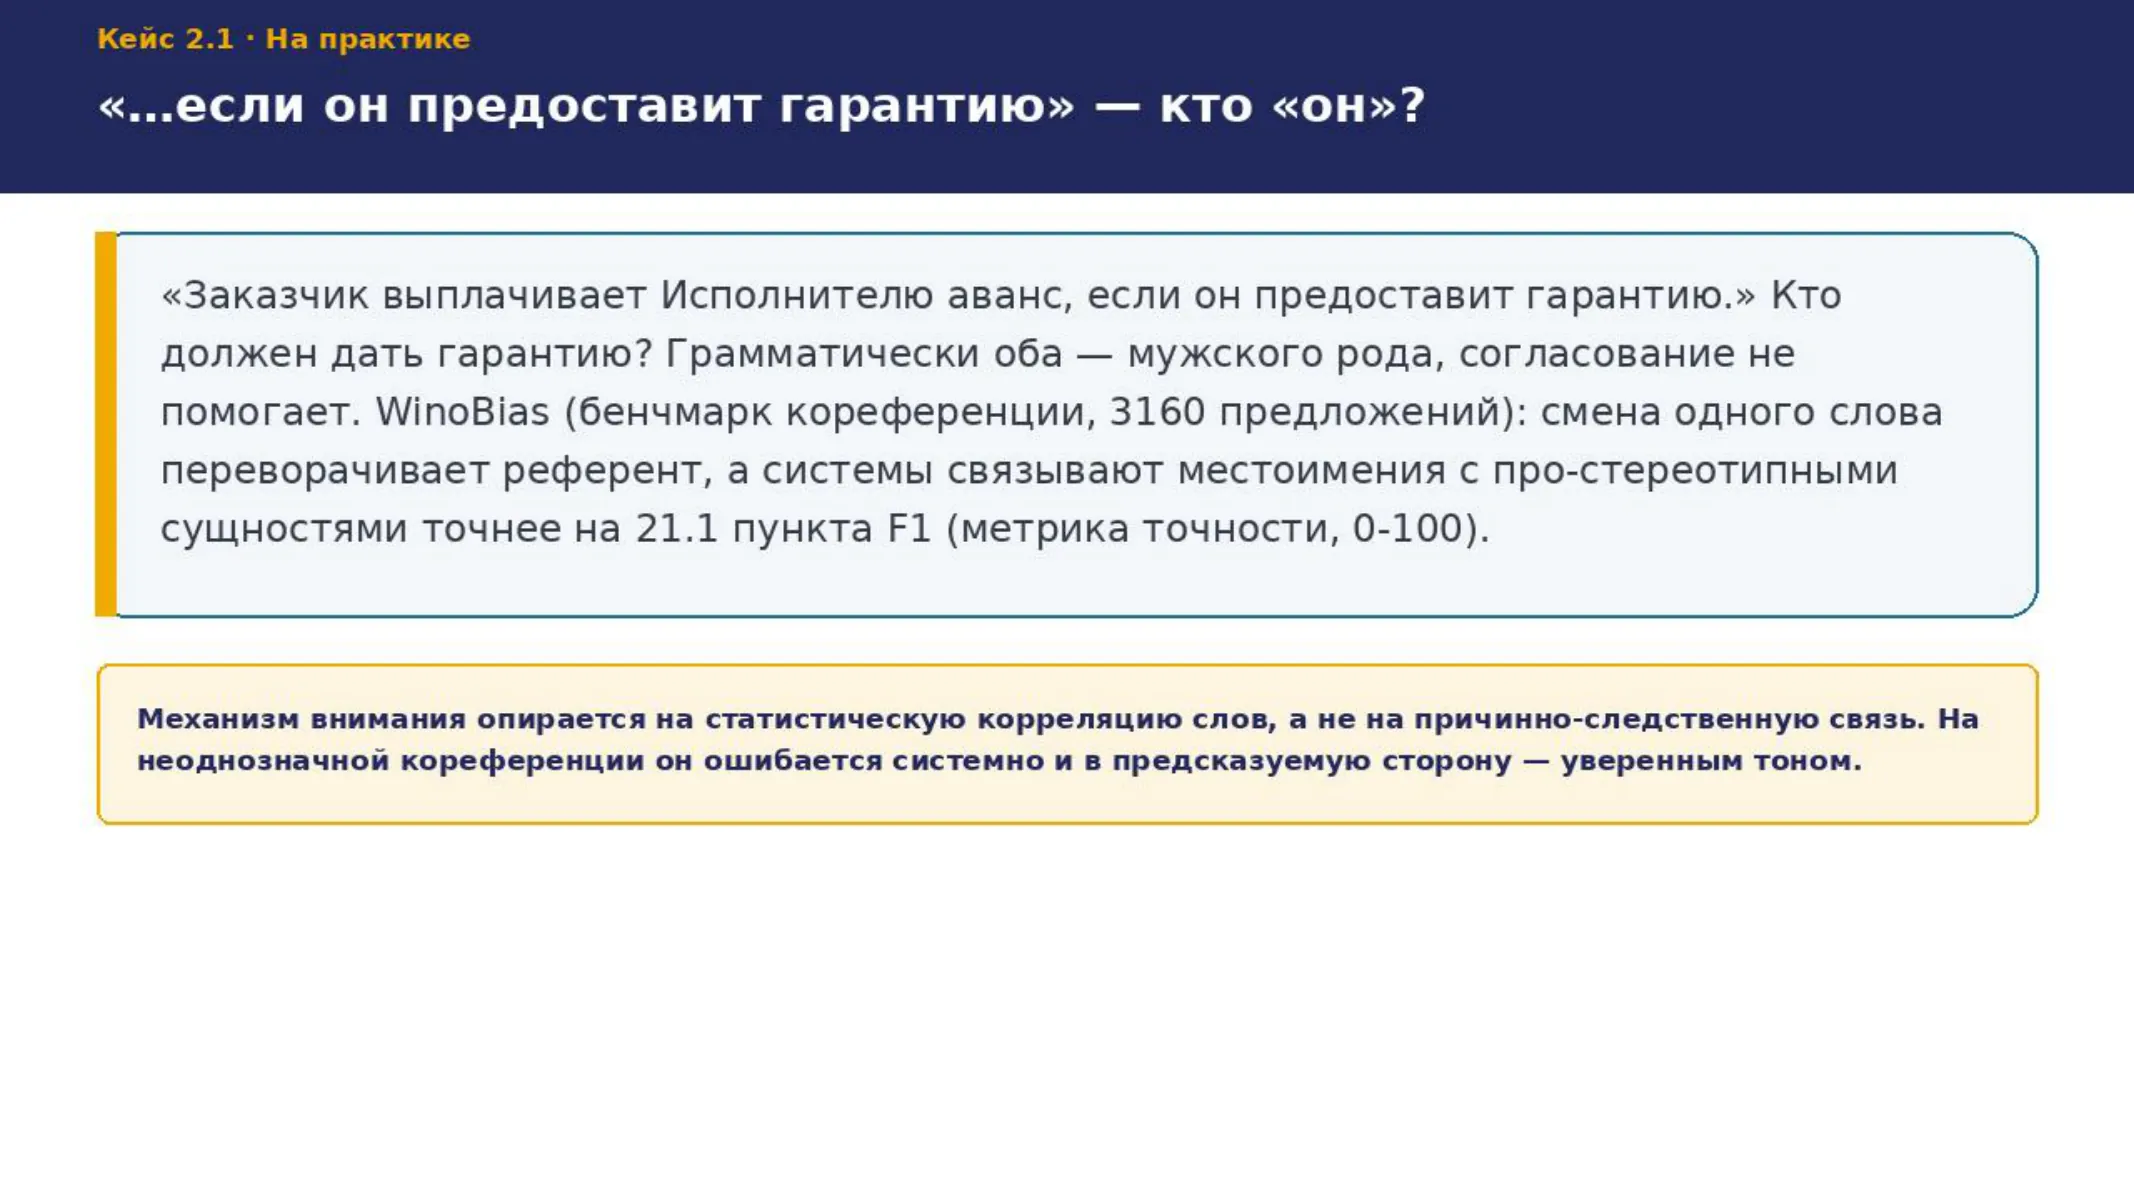
Сложность вынесена сюда из постановки. Это не «плохая модель», а свойство механизма: attention считает вес между позицией местоимения (Query «ищу — кто мог это сделать») и Key каждого кандидата; на однозначном сигнале (грамматика + смысл указывают на одного) — попадание, на неоднозначном вес уходит к статистически более частому варианту, а не к «правильному по смыслу договора», и тон ответа не меняется. Различи два источника трудности: разрешимая неоднозначность (ответ в тексте есть, но требует смысла — хорошая модель справляется, eval меряет) и истинная неоднозначность (ответ из документа не выводится, знает только автор) — второе не решает ни модель, ни проверяющий, только запрос к автору. Смешивать их — частая ошибка: команда «поднимает качество модели» там, где поднимать нечего. WinoBias — прямая иллюстрация: механизм ловит корреляции (статистику «кто обычно кем работает»), а не причинность, и там, где корреляция расходится с истиной, ошибается системно. В договорах роль стереотипа играет частотность конструкций. Задача системы во втором случае — не угадать, а надёжно поймать факт неоднозначности и эскалировать. Вероятный вопрос: «дообучить модель на кореференцию?» — поднимет разрешимые случаи, но часть неоднозначностей неразрешима в принципе, финальный рубеж — гейт + человек.
21 · LLM-извлечение с верификацией критичных полей
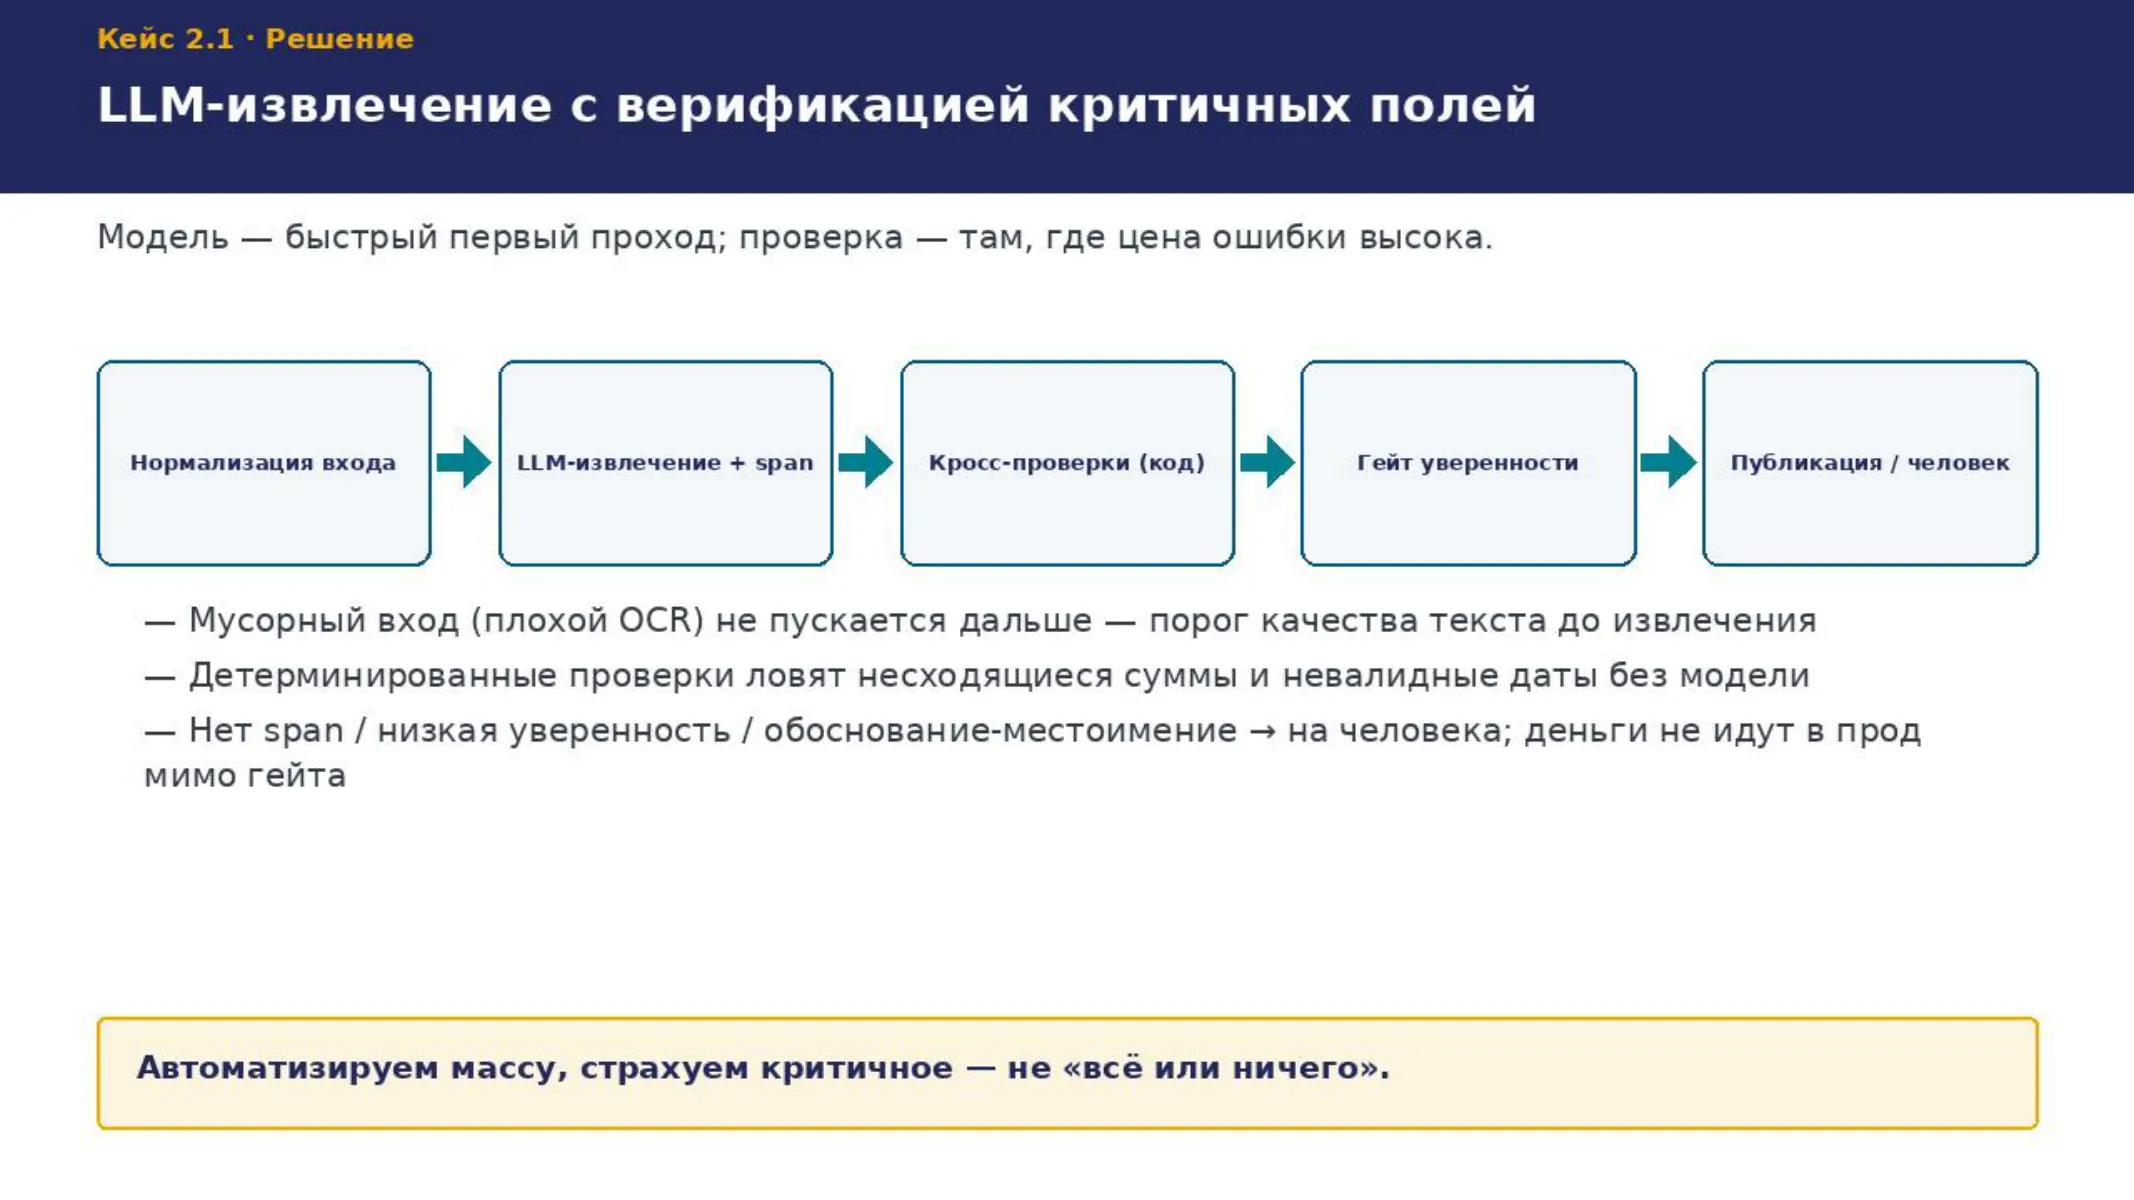
Схема из раздела 6.1 файла-кейса. Договор любого формата сначала приводится к чистому тексту, и текст проходит порог качества — мусорный вход дальше не пускается. Чистый текст уходит в LLM, которая через structured output возвращает по каждому полю значение + дословную цитату-обоснование + флаг уверенности. Кандидаты проходят детерминированный слой проверок (сумма прописью против числа, валидность и непротиворечивость дат, валюта из справочника, однозначность сторон), затем гейт, пропускающий в итог только поля с найденным span, достаточной уверенностью и пройденными проверками; всё спорное уходит человеку. Детерминированный слой важен тем, что у него нулевой дрейф: regex, проверяющий дату начала ≤ дата конца, никогда не «передумает» и не поведётся на уверенный тон. Разумная тактика — максимизировать долю полей, покрытых детерминированными проверками. Это экономический расчёт, а не компромисс: при ошибке чистого извлечения даже в оптимистичные 10% на тысячах полей — это сотни неверных сумм, разбросанных незаметно среди верных с одинаково уверенным тоном; гейт переворачивает экономику — человек читает не 1000 полей, а 50-150. Вероятный вопрос: «RAG или весь договор в контекст уберёт галлюцинации?» — нет, стэнфордское исследование про инструменты С RAG показало 17-33% галлюцинаций; источник истины у нас — span-проверка + кросс-проверки, а не «модель видела текст».
22 · Кейс 2.1 · Разбор
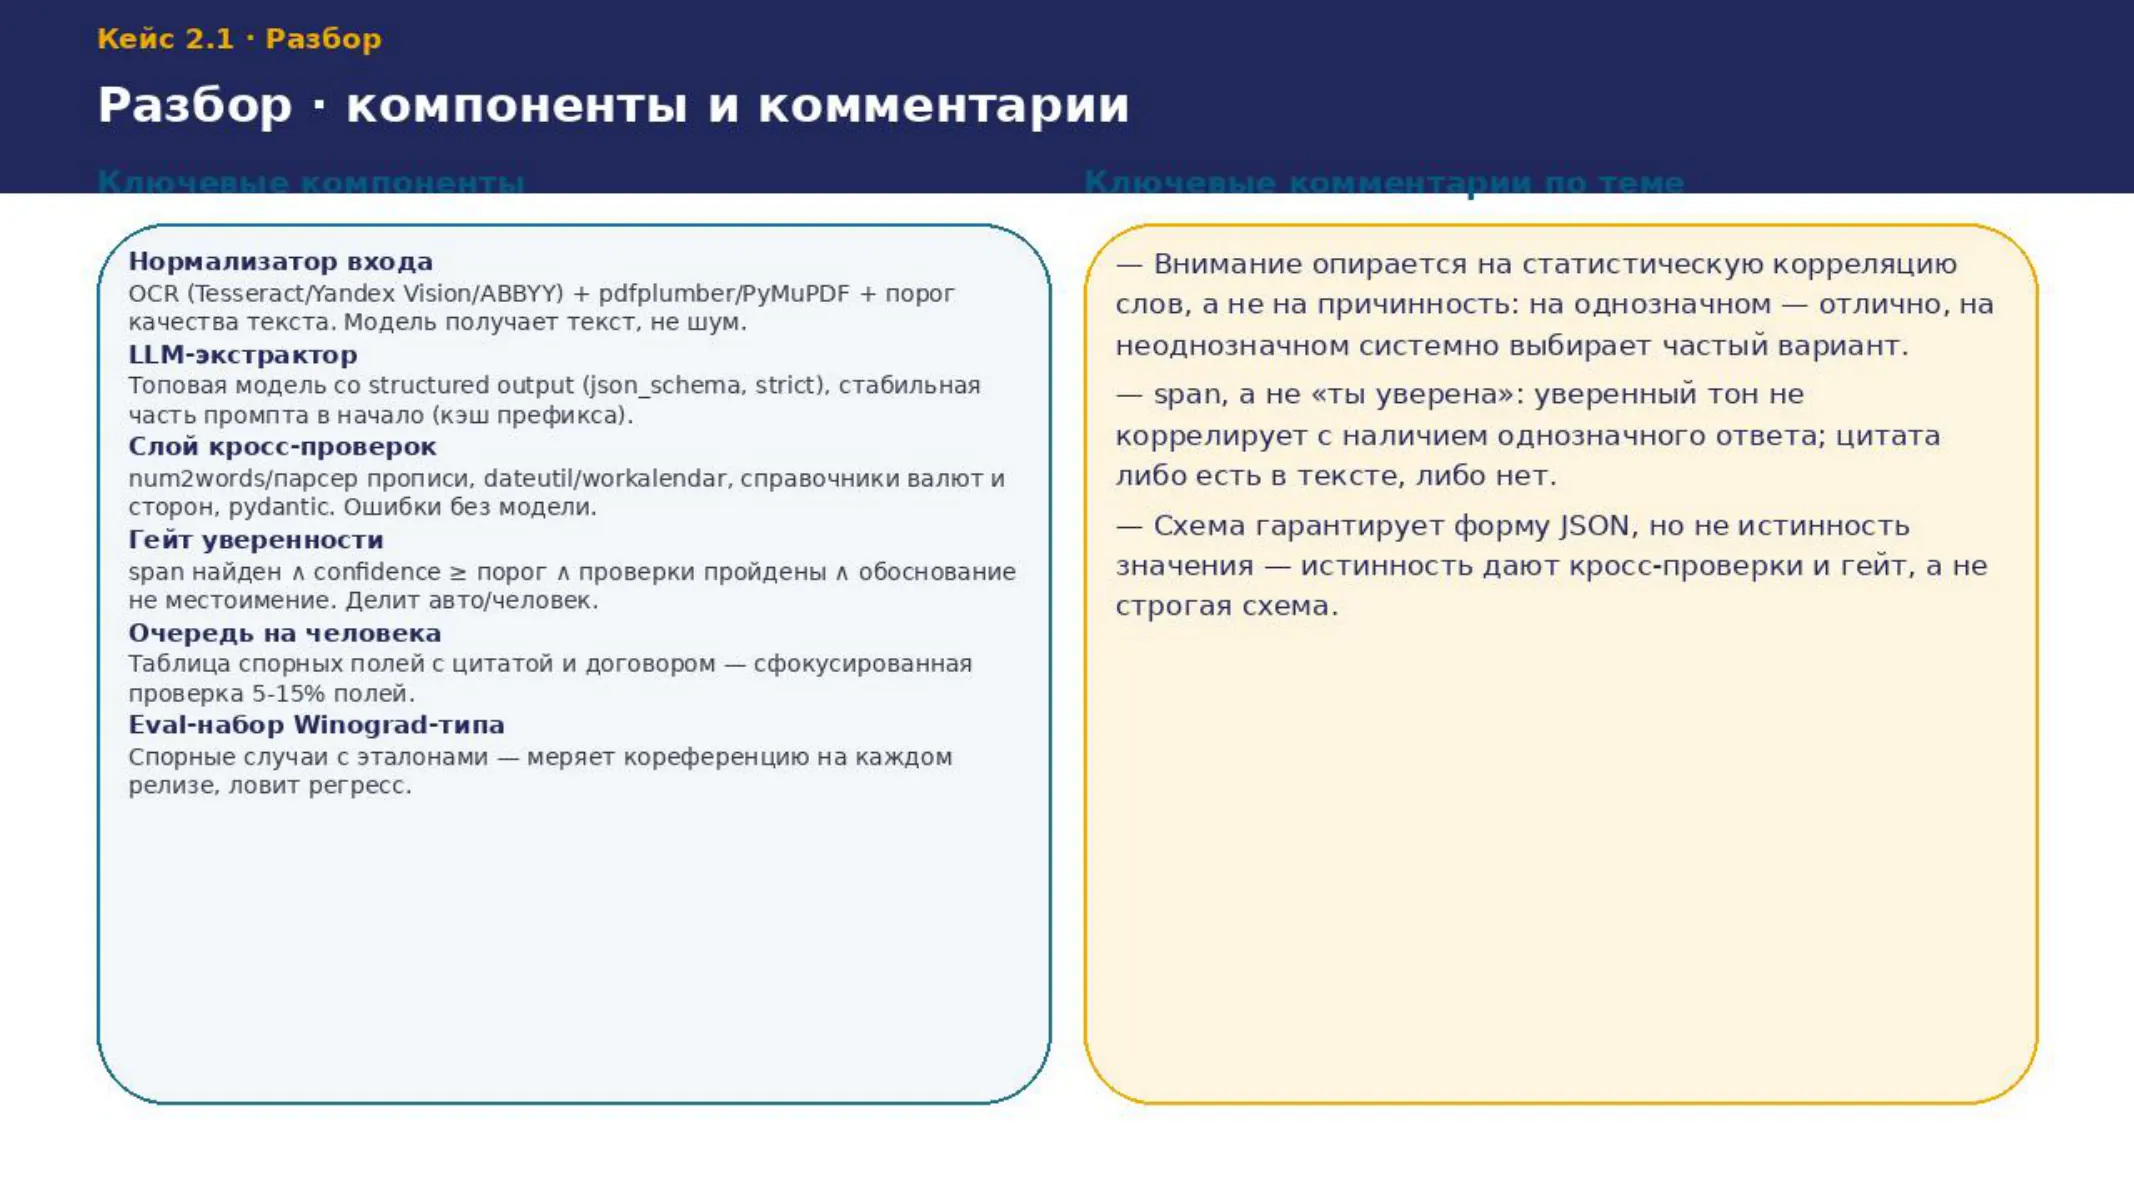
Разбор из разделов 6.2-6.4 файла-кейса. Главный тезис: внимание опирается на статистическую корреляцию слов, а не на причинно-следственную связь. На однозначной кореференции («он» = единственный подходящий кандидат) работает отлично; на неоднозначной модель системно выбирает более частый вариант и подаёт уверенно, потому что в тексте однозначного ответа нет, а модель обязана выдать токен. Где граница — не в «плохой модели», а в самом тексте: если однозначного референта нет, его не разрешит ни attention, ни проверяющий, только автор договора; задача системы — поймать факт неоднозначности, а не додумать ответ. Почему span, а не «ты уверена»: уверенный тон не коррелирует с наличием однозначного ответа — исследования показывают, что модели систематически переоценивают уверенность, а числовые самооценки схлопываются в «0.9/1.0»; evidence_span даёт не-модельный проверяемый сигнал. Почему схема не спасает от неправды: structured output гарантирует форму JSON, но не истинность — её обеспечивают кросс-проверки и гейт. Грабли: доверять уверенному тону на неоднозначной кореференции; спрашивать уверенность вторым вопросом; винить модель, не проверив вход (OCR-мусор); пытаться дообучить модель вместо гейта. Вероятный вопрос: «этот пайплайн для других полей — сроки, штрафы, реквизиты?» — да, архитектура общая, меняются только правила проверок (реквизиты — контрольные суммы ИНН/расчётного счёта, сроки — календарная арифметика).
23 · Кейс 2.1
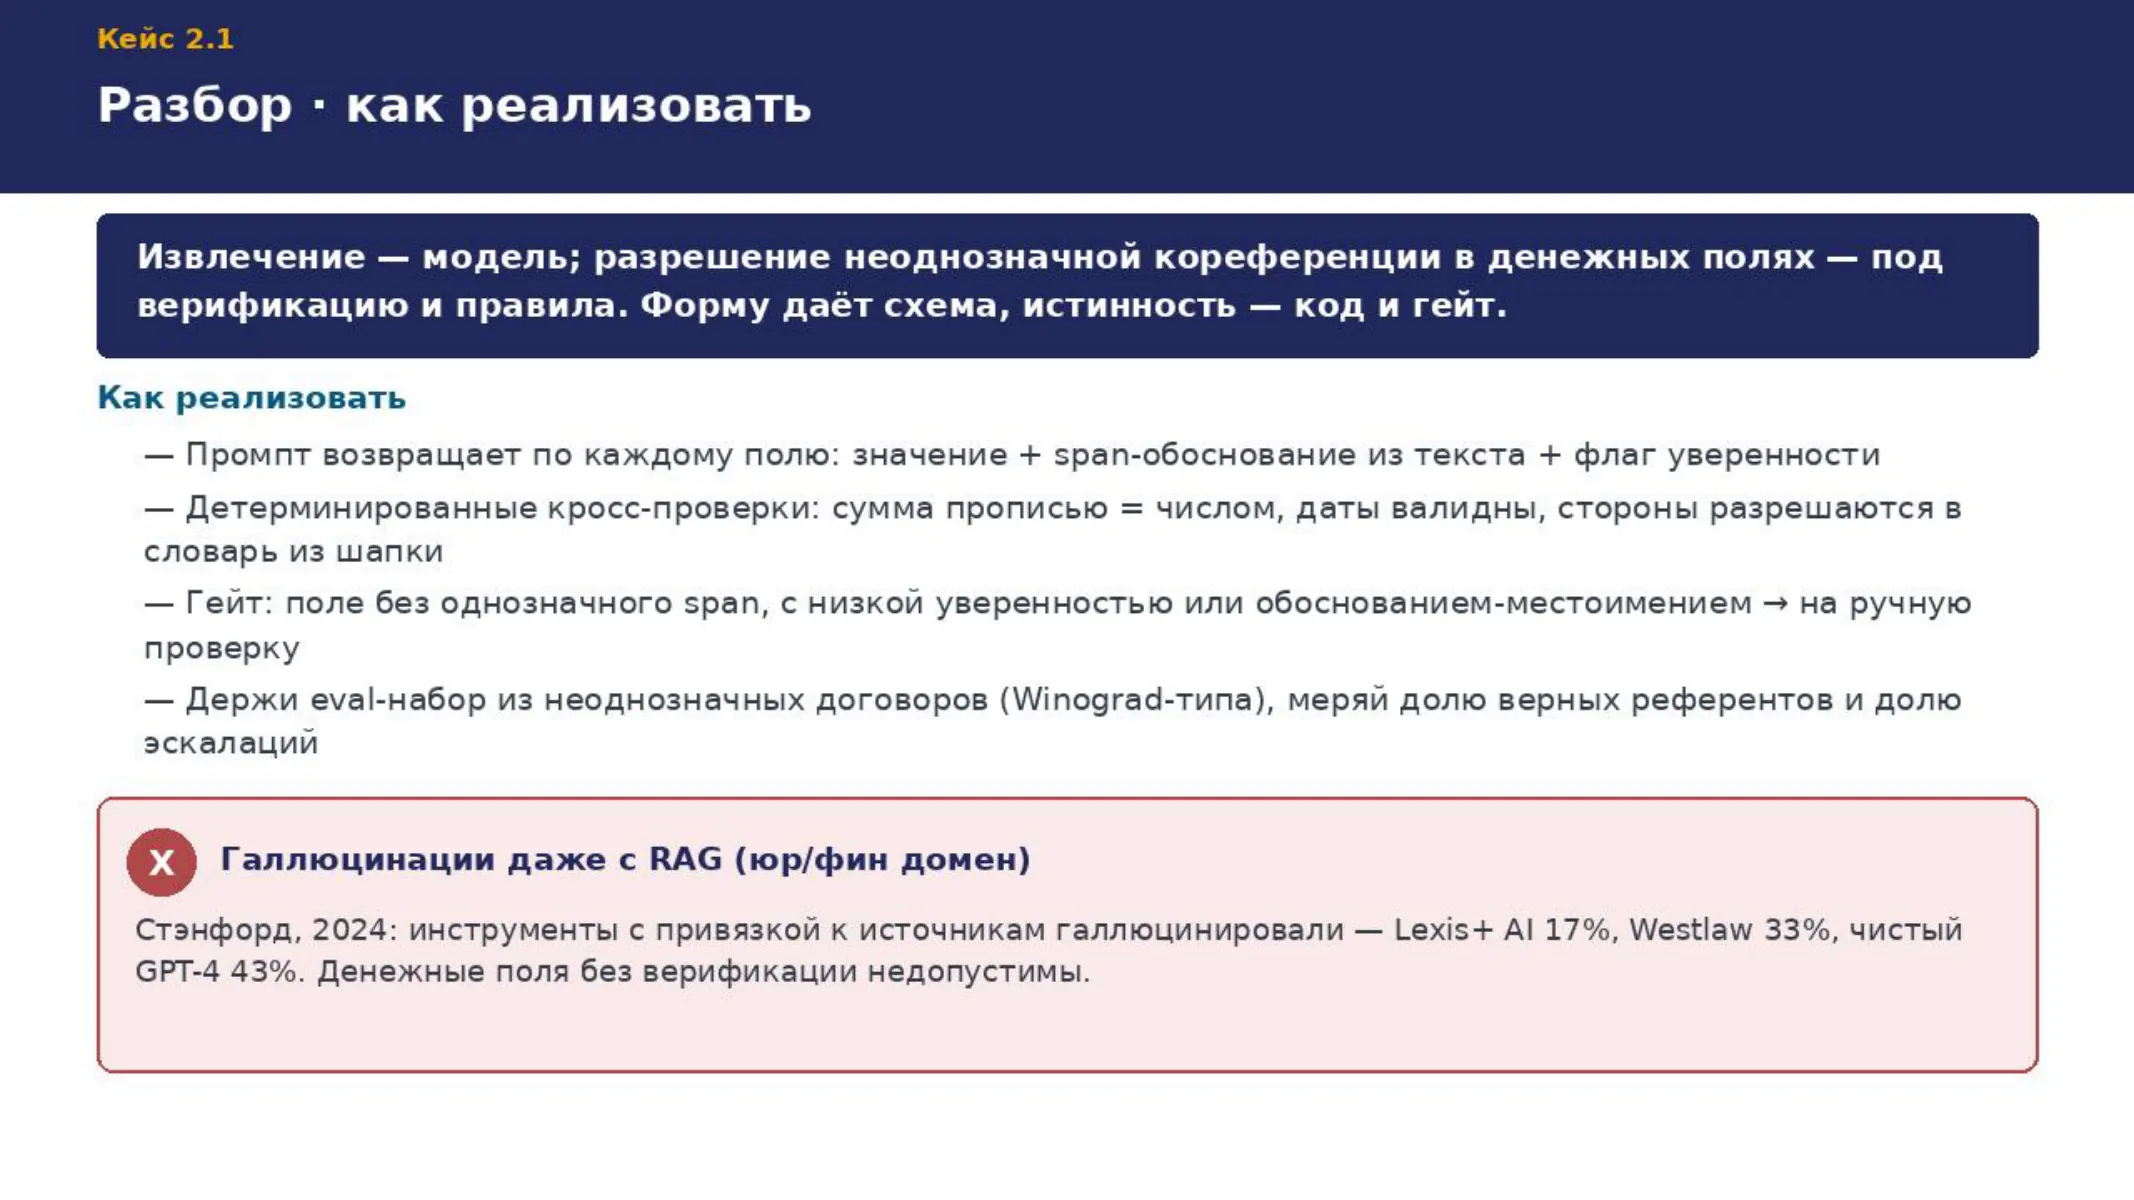
На карточке-примере: даже «заземлённое» (с RAG) извлечение в юр/фин домене не hallucination-free — потому денежные поля идут только через верификацию. Пошаговый how-to из разбора и Q&A файла-кейса. (1) span-обоснование: в промпте требуй по каждому полю процитировать фрагмент исходника; постпроверкой убеждайся, что span реально есть в тексте, иначе выдумка. (2) кросс-проверки: сумма прописью против числа (модель извлекает их из разных мест, ошибка в одном не повторяется дословно в другом — расхождение ловится; заодно ловит опечатки в самом договоре), дата начала ≤ дата конца, валюта распознана — детерминированный код. (3) гейт: без span или уверенность ниже порога → к человеку; настраивай гейт по цене ошибки, для денег смещай к перестраховке. (4) eval: раздели на разрешимые случаи (метрика — точность разрешения) и истинно неоднозначные (метрика — доля эскалаций, идеал 100% эскалаций, а не 100% угаданных). Логируй причину каждой эскалации: если 70% — «span не найден», проблема в промпте/входе, а не в кореференции. Грабли: не проси у модели «оценку уверенности» вторым вопросом — измеряет натренированность отвечать, а не уверенность. Вероятный вопрос: «где здесь именно внимание, а не абстрактно модель ошибается?» — разрешение «он»/«сторона» это то, что делает механизм через Q/K/V; ошибка рождается в самом взвешивании.
24 · «Отвечает неточно — сделайте качественне延
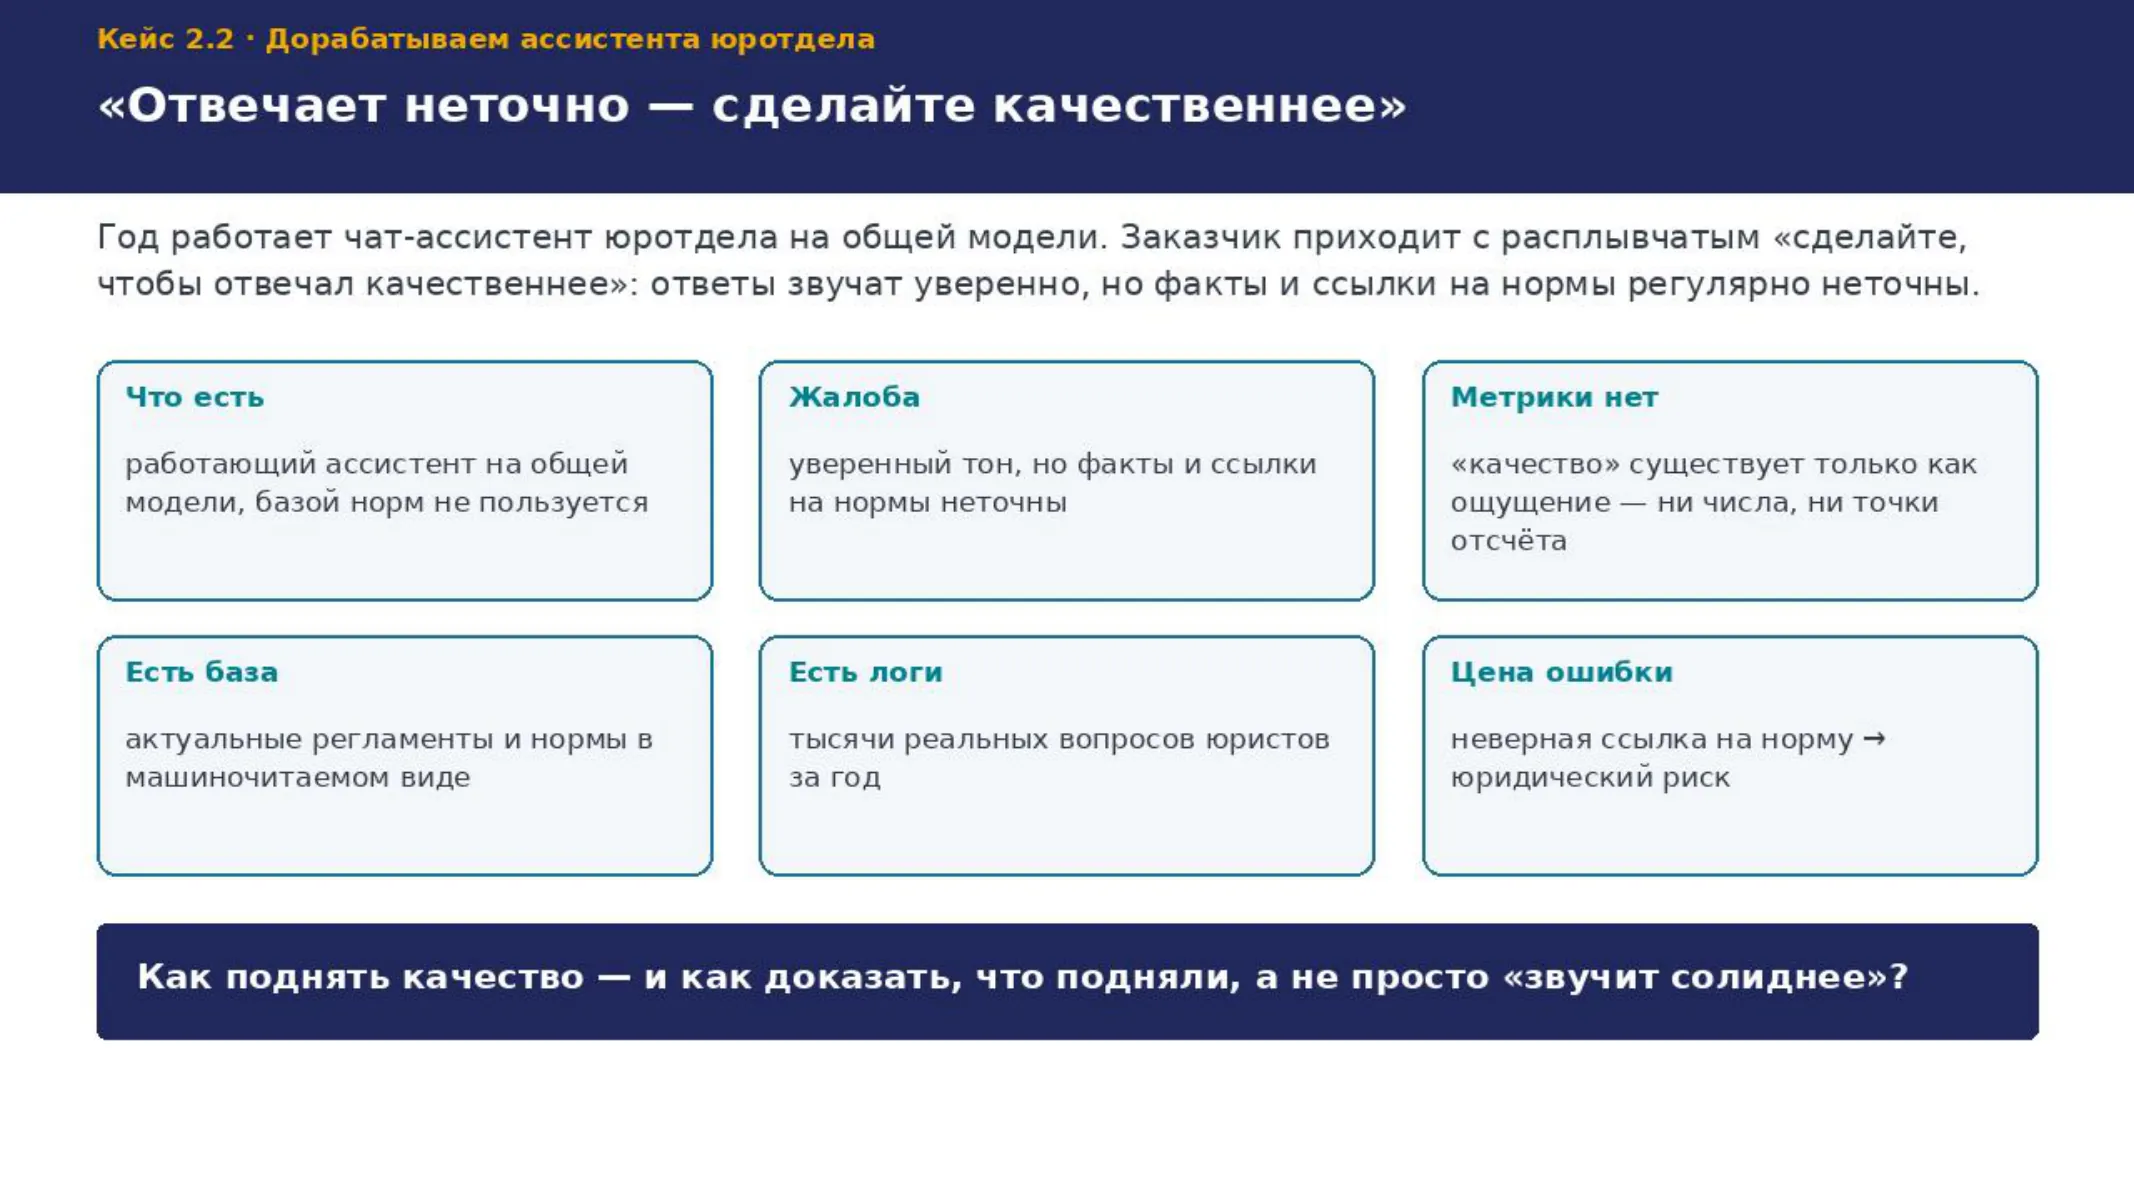
На слайде — постановка. Центральное ограничение — метрики качества нет: «качество» существует только как ощущение отдельных юристов, ни числа, ни воспроизводимой проверки, ни точки отсчёта; пока качества нет в цифрах, любое изменение принимается вслепую. Класс задачи — улучшение без определённой метрики. Два напрашивающихся хода: сразу «улучшать промпт» (роль, тон) — типичная первая попытка, двигает форму, не суть; или сначала завести метрику и базлайн, потом менять по одной вещи и мерить — единственный способ отличить реальное улучшение от «звучит солиднее». Ловушка новичка — принять решение по впечатлению «стало лучше» без цифры. Правильный рефлекс инженера здесь — не «какой промпт написать покрасивее», а «как я вообще узнаю, что стало лучше». Вероятный вопрос: «что мерить, если эталонов нет?» — собрать golden set из реальных вопросов юристов с эталонными ответами и проверяемыми ссылками; 50-100 строк дают сигнал. Логи за год — золото: eval на реальном трафике меряет то, что действительно спрашивают. Дальше — как устроить eval, что реально двигает качество и почему первая напрашивающаяся идея (роль) не сработает.
25 · Сначала метрика и базлайн, потом изменения
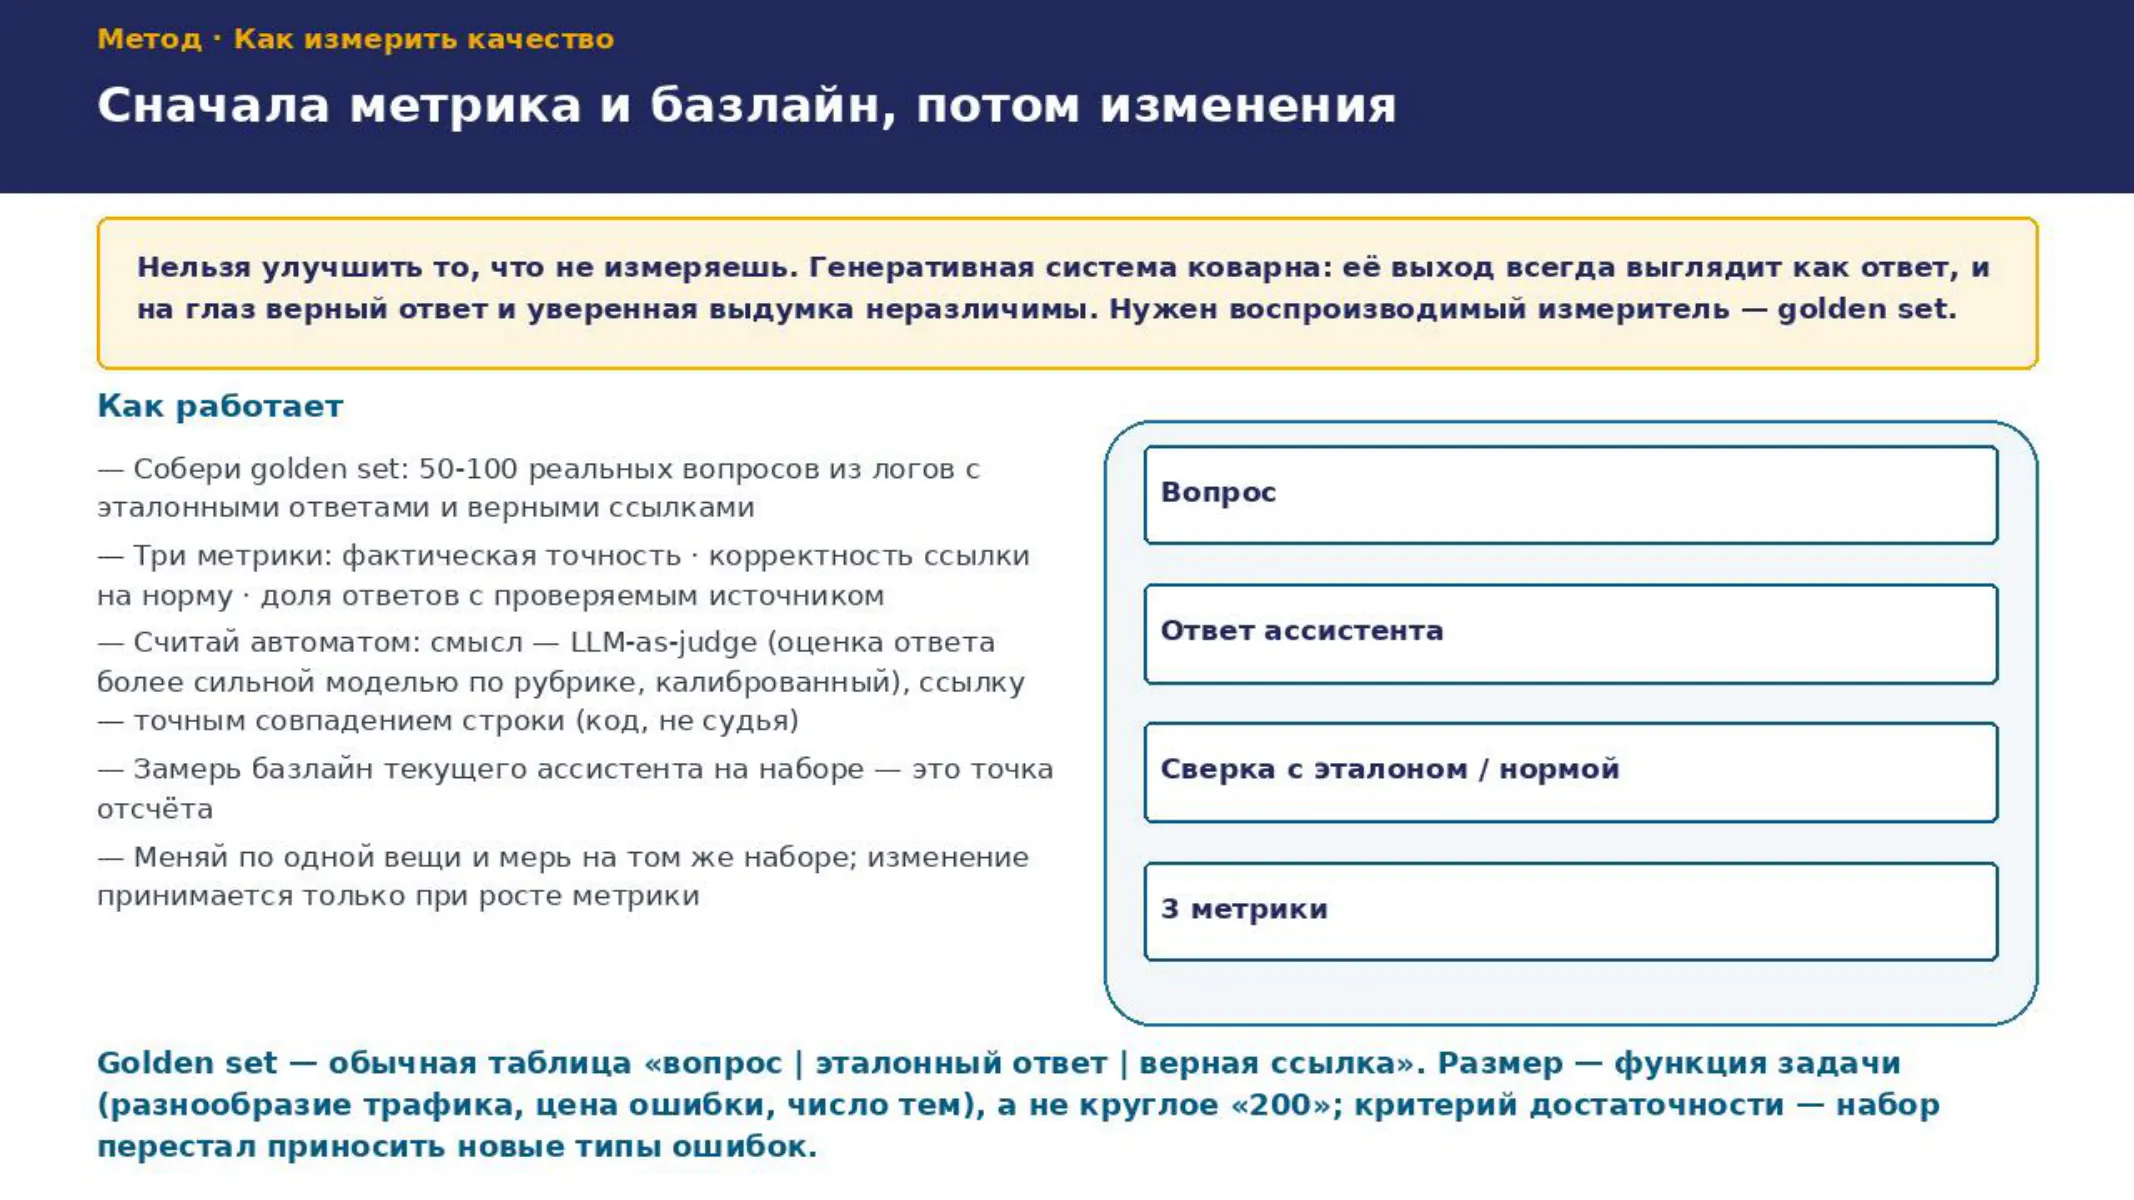
Здесь — метод измерения, ещё не сама ловушка роли. Классическая программа при ошибке падает; LLM при недостатке знаний не падает — обязана выбрать следующий токен и выбирает самый правдоподобный, оформляя уверенным тоном. Поэтому на глаз качество генеративной системы не измеряется: человек оценивает правдоподобие и гладкость, а не верность, которую без проверки не знает. Три метрики двигаются независимо, разделять обязательно: фактическая точность (правду ли говорит), корректность ссылки (та ли норма в актуальной редакции — отдельно, ответ бывает верным по сути со ссылкой «в молоко»), grounding rate (доля ответов с проверяемой опорой — для юридического риска часто важнее самой точности, заземлённый ответ проверяется за секунды). Как считать: детерминированная сверка кодом там, где эталон — строка (ссылка «ст. 196 ГК РФ» — сравнение строк с нормализацией, не работа для судьи); LLM-as-judge там, где эталон — смысл (но у судьи свои искажения — калибровать); ручная сверка — золотой эталон для калибровки судьи. Вероятный вопрос: «почему не спросить у юристов, стало ли лучше?» — пользовательское ощущение смещено формой ответа: уверенный тон читается как «точнее», даже когда факты те же; golden set меряет фактологию воспроизводимо.
26 · «Ты — опытный юрист» на метрике не двигается
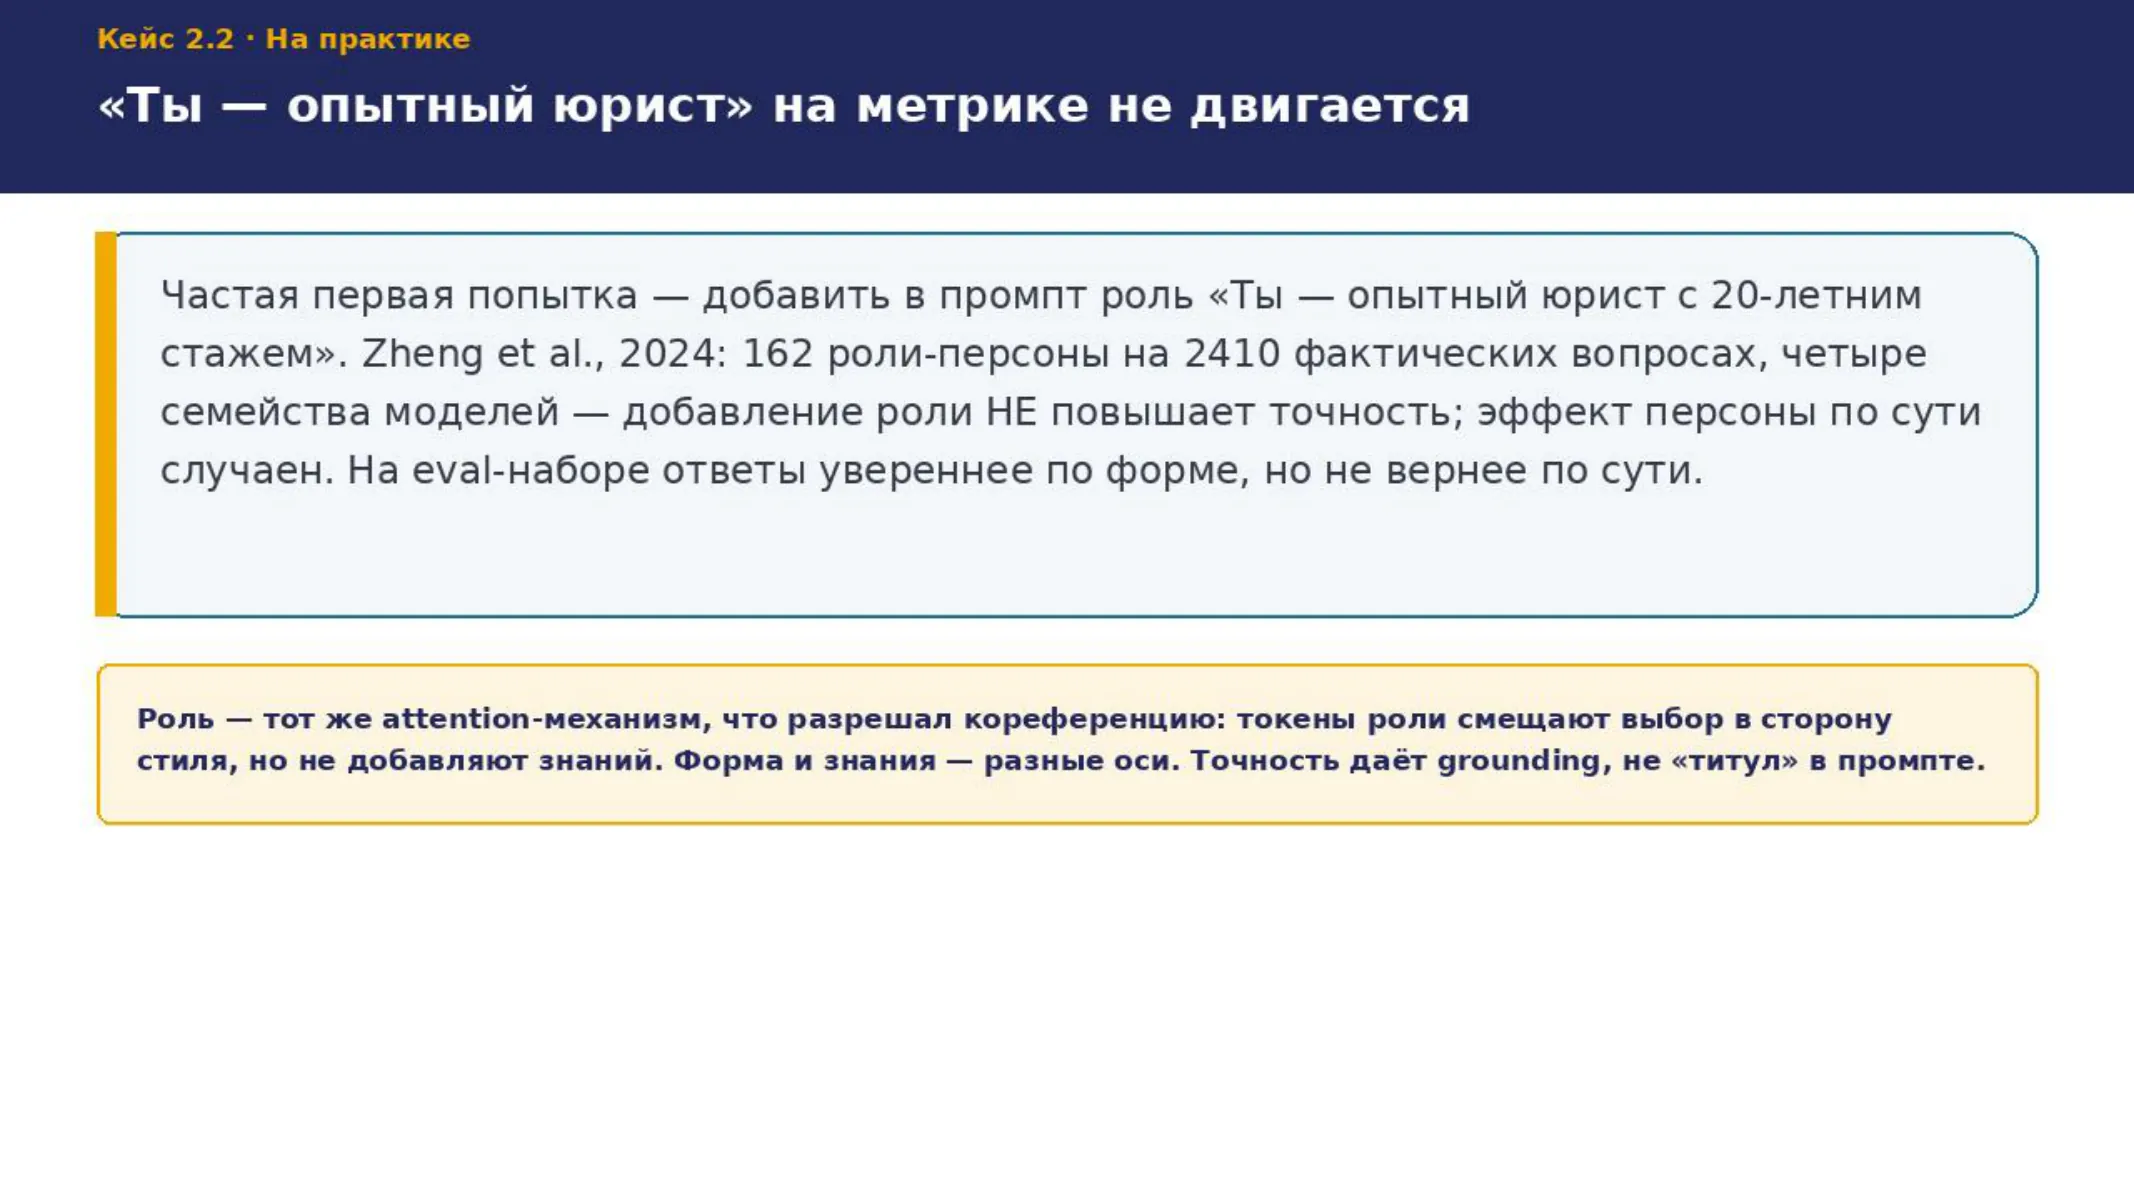
Ловушка вынесена сюда из постановки. Почему так, а не «промптинг не работает»: роль в системном промпте — тот же механизм attention-взвешивания, что разрешал «он» → «кот» в кейсе 2.1, только Query принадлежит позициям генерируемого ответа, а Key/Value — токенам роли. Токены «опытный», «юрист», «стаж» получают вес и смещают выбор следующих токенов в сторону лексики и уверенности, ассоциированных с ролью — ответ становится солиднее по форме. Но вес токенов роли не добавляет в модель ни одного факта, которого не было в весах или контексте: если нужного факта нет, никакая формулировка роли его не создаст, только заставит увереннее излагать то, что модель и так «знала», включая уверенно изложенные ошибки. Zheng et al. измерили это: ноль прироста точности, эффект персоны не лучше случайного выбора. Как детектировать: прогони eval с ролью и без — числа те же; наглядно показывает, что решение принимает метрика, а не ощущение. Роль полезна для формы (тон, структура, отказ отвечать вне компетенции), просто не для фактической точности — путать эти две оси и есть ошибка, которую ловит eval. Дальше — как поднять точность на самом деле (grounding) и зафиксировать это цифрой.
27 · Кейс 2.2 · Разбор
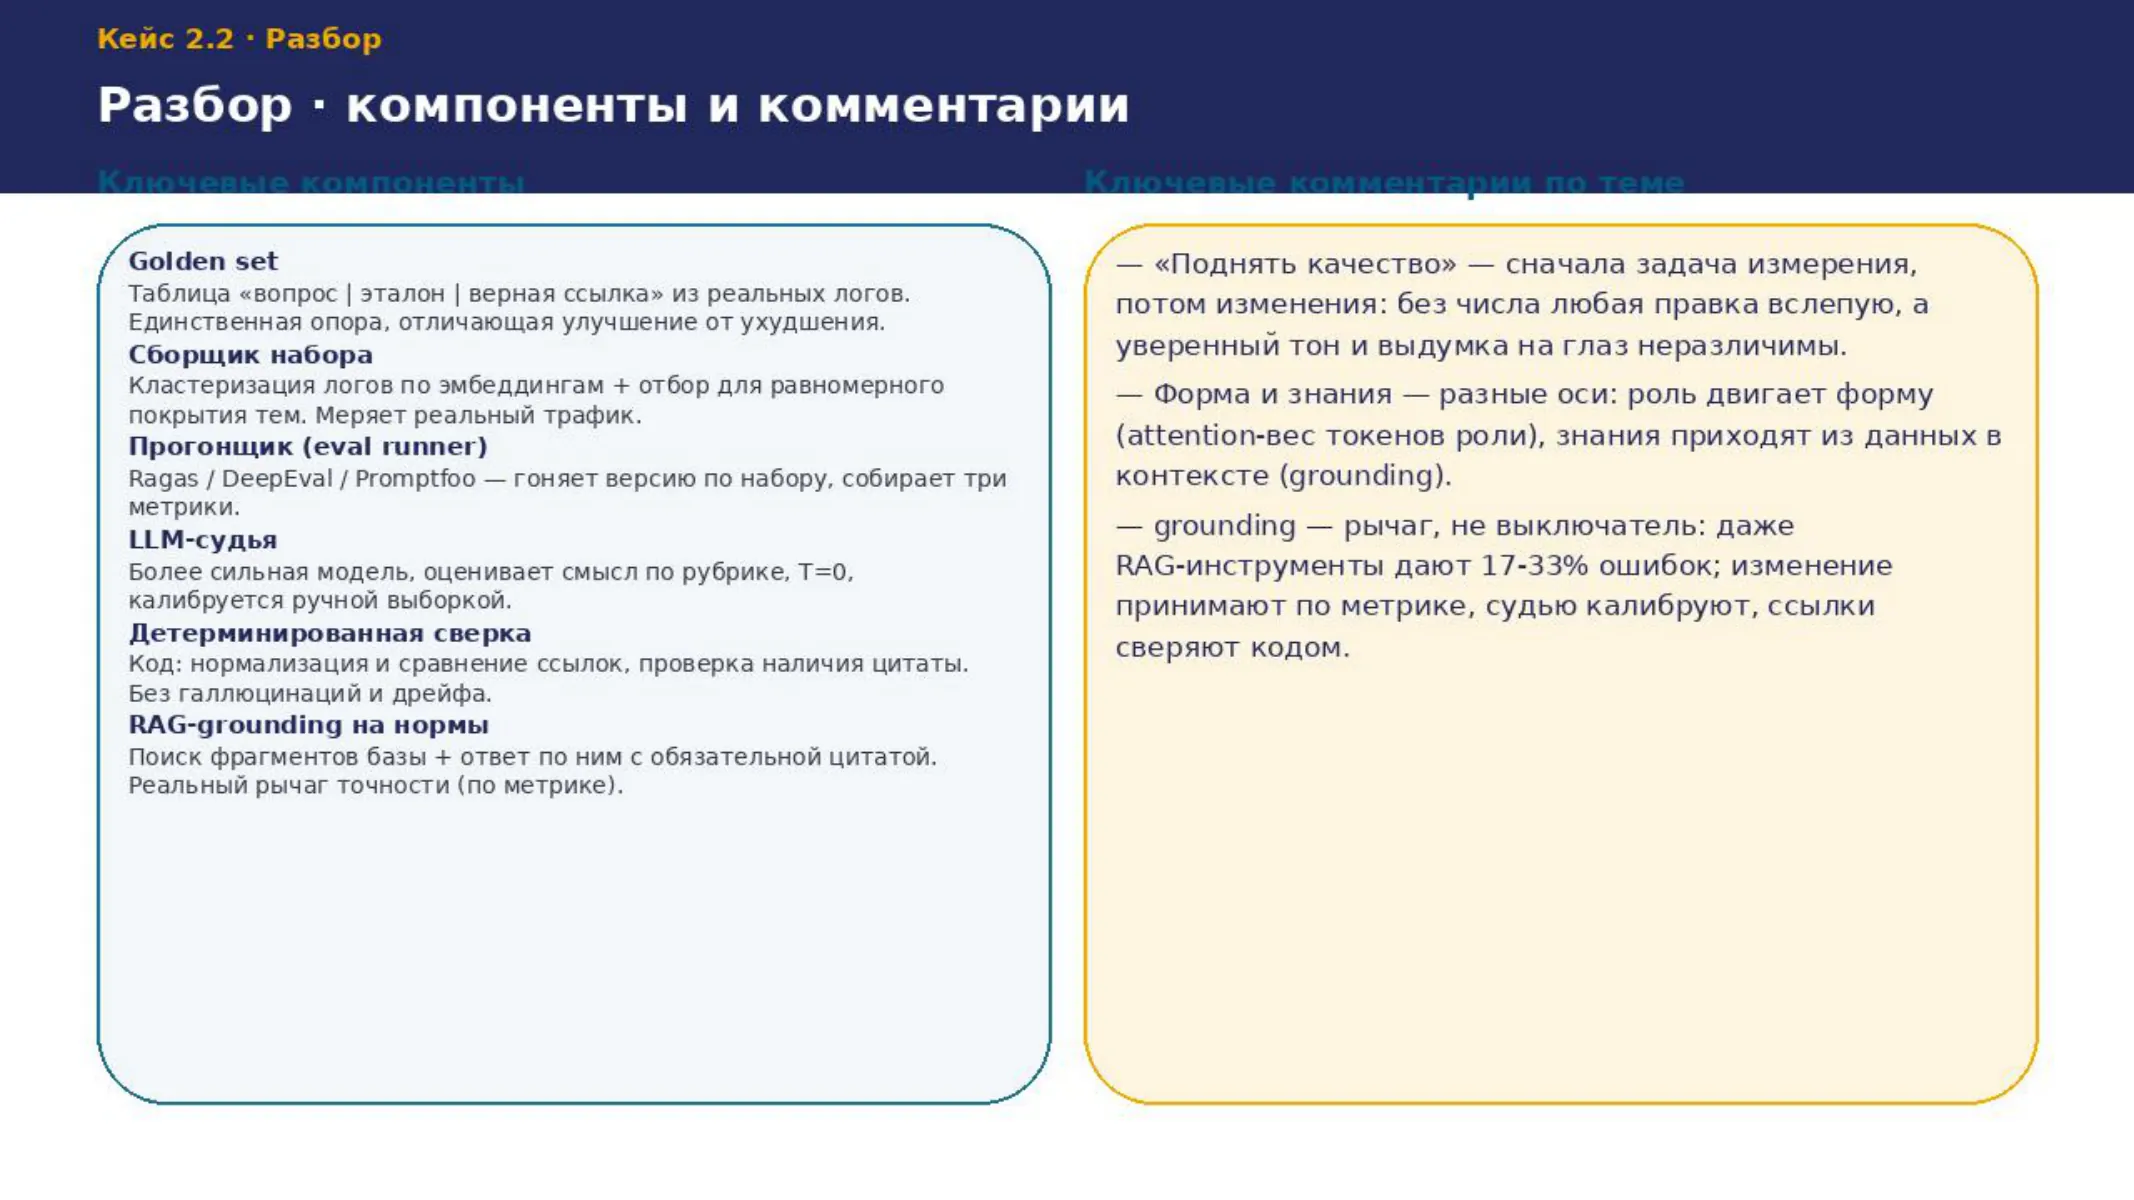
Разбор из разделов 6.1-6.4 файла-кейса (для этого кейса — один разбор-слайд, как задано: context→concept→complication→разбор). Главный тезис: «поднять качество» — в первую очередь задача измерения, и только во вторую — задача изменения. Где граница эффекта роли: роль в промпте — тот же механизм attention-взвешивания, что разрешал кореференцию; токены роли получают вес и смещают выбор следующих токенов в сторону стиля, но не добавляют ни одного факта — форма и знания разные оси. Почему grounding, а не «магическая фраза»: точность двигают данные в контексте, не эпитеты в роли; но grounding не выключатель галлюцинаций (стэнфордские 17-33% даже с RAG), это изменение, которое принимают по метрике. Почему измеритель тоже надо проверять: LLM-судья несёт искажения — позиционное смещение (выбирает первый/последний по порядку), смещение к многословию (длинный ответ кажется лучше — прямо опасно, «солидную» роль судья может оценить выше), самопредпочтение; что детерминируемо (ссылки) — сверяй кодом, что требует смысла — судьёй, но калиброванным. Грабли: решение по впечатлению «стало солиднее» без числа; «улучшать» ролью; менять несколько вещей разом; считать судью оракулом; принять grounding за выключатель галлюцинаций и снять проверку человека на критичных документах. Вероятный вопрос: «метрика выросла — выкатывать и забыть?» — рост необходим, но не достаточен; расширяй набор провалами из прода, гоняй eval на каждом релизе включая тихие обновления модели вендором.
28 · Кейс 2.2
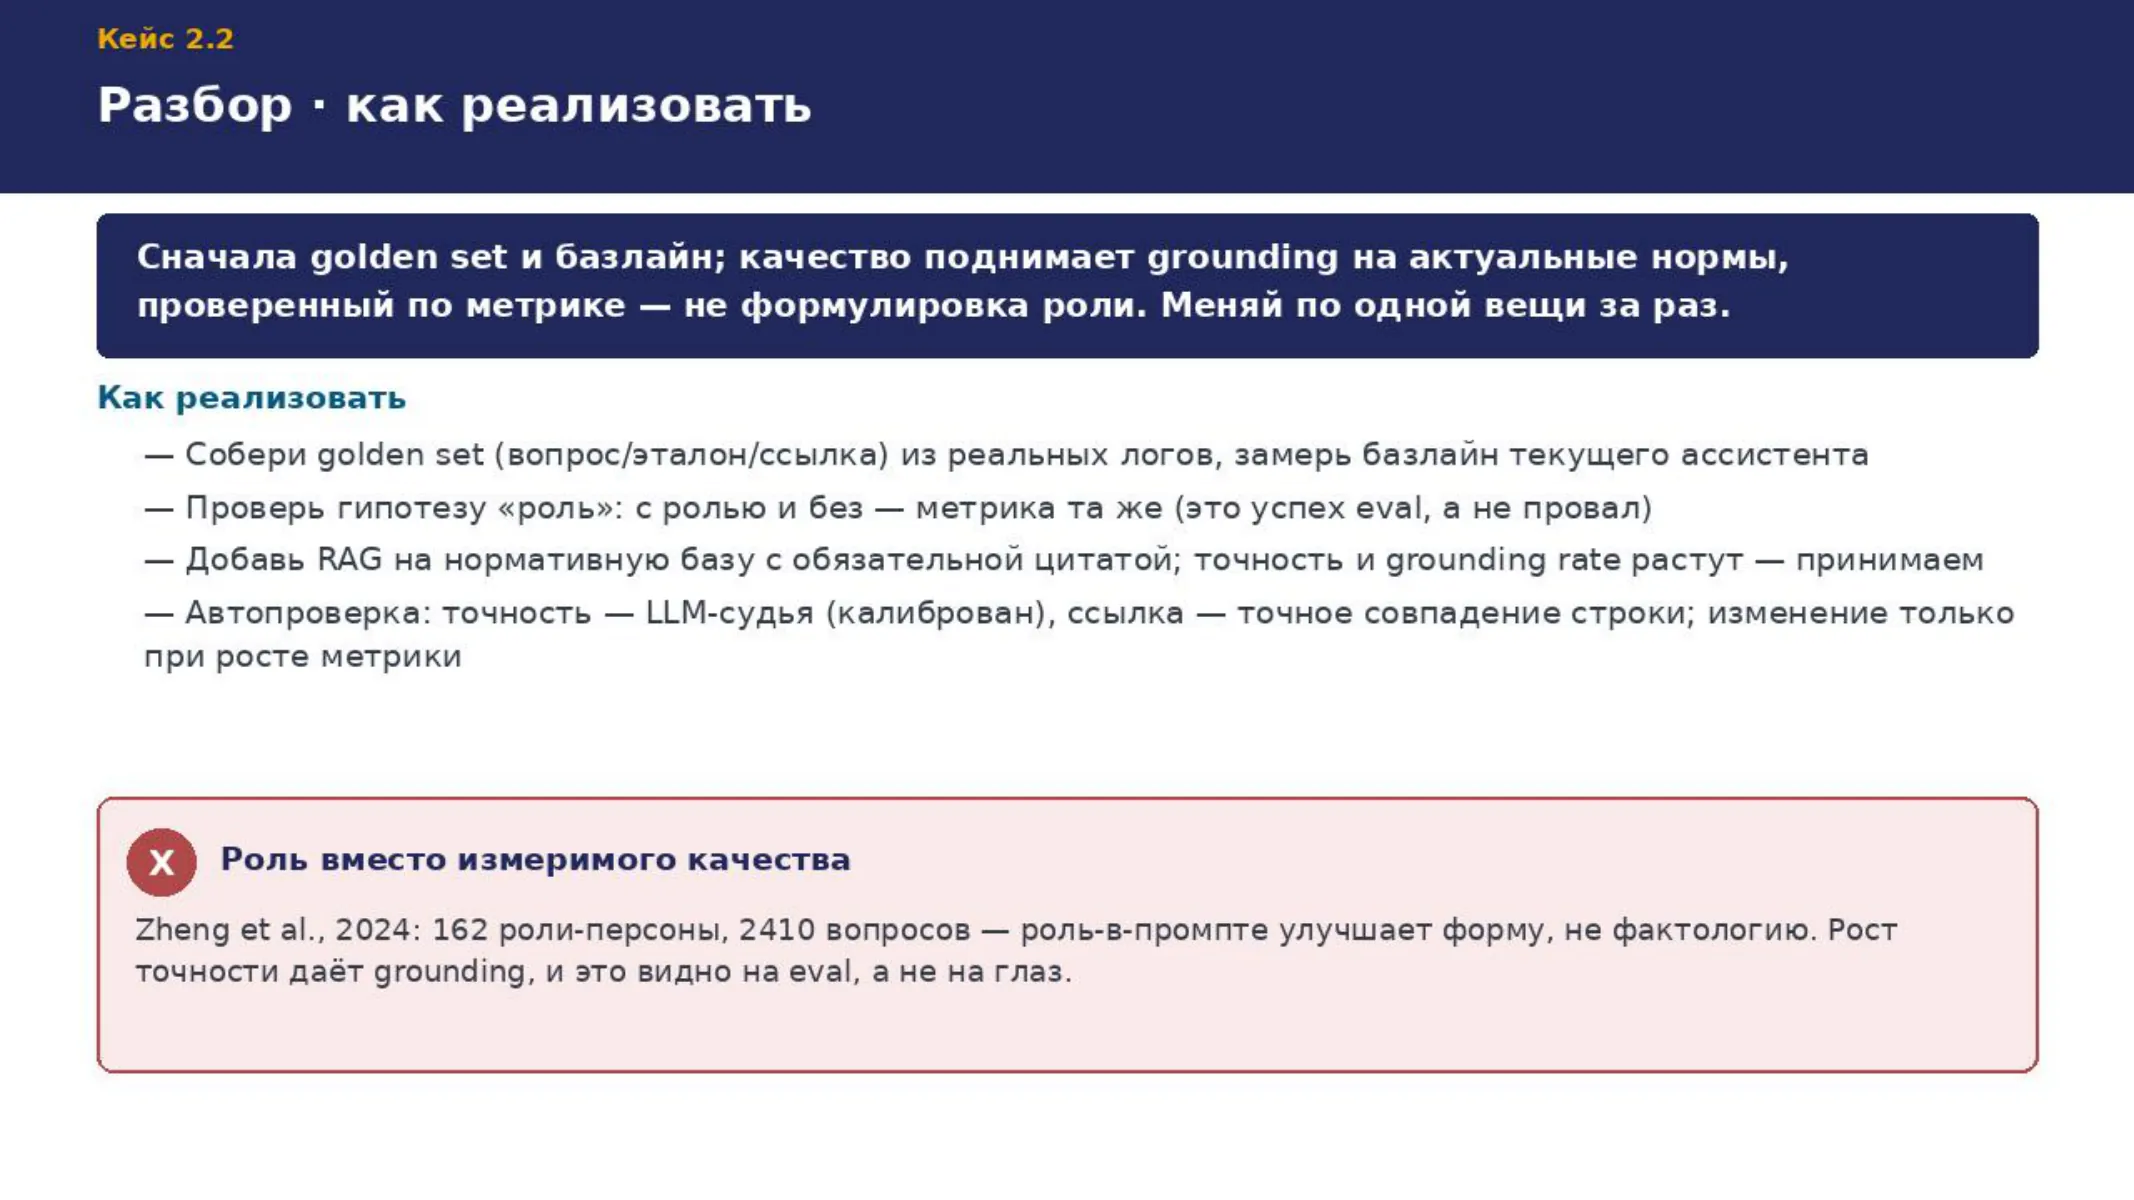
На карточке-примере вывод: тот, у кого есть golden set, за месяц обгонит того, кто год «улучшает на глаз». Пошаговый how-to из разбора и Q&A файла-кейса. «Поднять качество» превращаем в цикл: измерь → измени одну вещь → измерь снова. (1) golden set: возьми реальные вопросы из логов (можно кластеризовать по эмбеддингам для равномерного покрытия тем), юрист один раз пишет эталон и верную ссылку; 50-100 строк, критерий достаточности — набор перестал приносить новые типы ошибок. (2) базлайн: прогони текущего ассистента, запиши три числа. (3) первая же гипотеза — роль — на метрике проваливается: это не провал эксперимента, а его успех, eval за пять минут закрыл неделю бесплодных переписываний промпта. (4) первый работающий кандидат — grounding (RAG на нормативную базу с обязательной цитатой), принимается по росту метрики. Меняй по одной вещи за раз — иначе не поймёшь, что сработало. Автопроверка: LLM-судья на смысл (калибруй долей ручной сверки, при парном сравнении меняй порядок ответов и усредняй — гасит позиционное смещение), ссылку сверяй кодом. Версионируй связку «версия промпта/модели/RAG → версия набора → три числа». Вероятный вопрос: «если LLM-судья сам ошибается?» — держи долю на ручной сверке как калибровку и сверяй ссылки детерминированно, не судьёй.
29 · Сэмплинг и токенизация: как модель порождает и видит текст
30 · Карточки товара: описание и структурные параметры
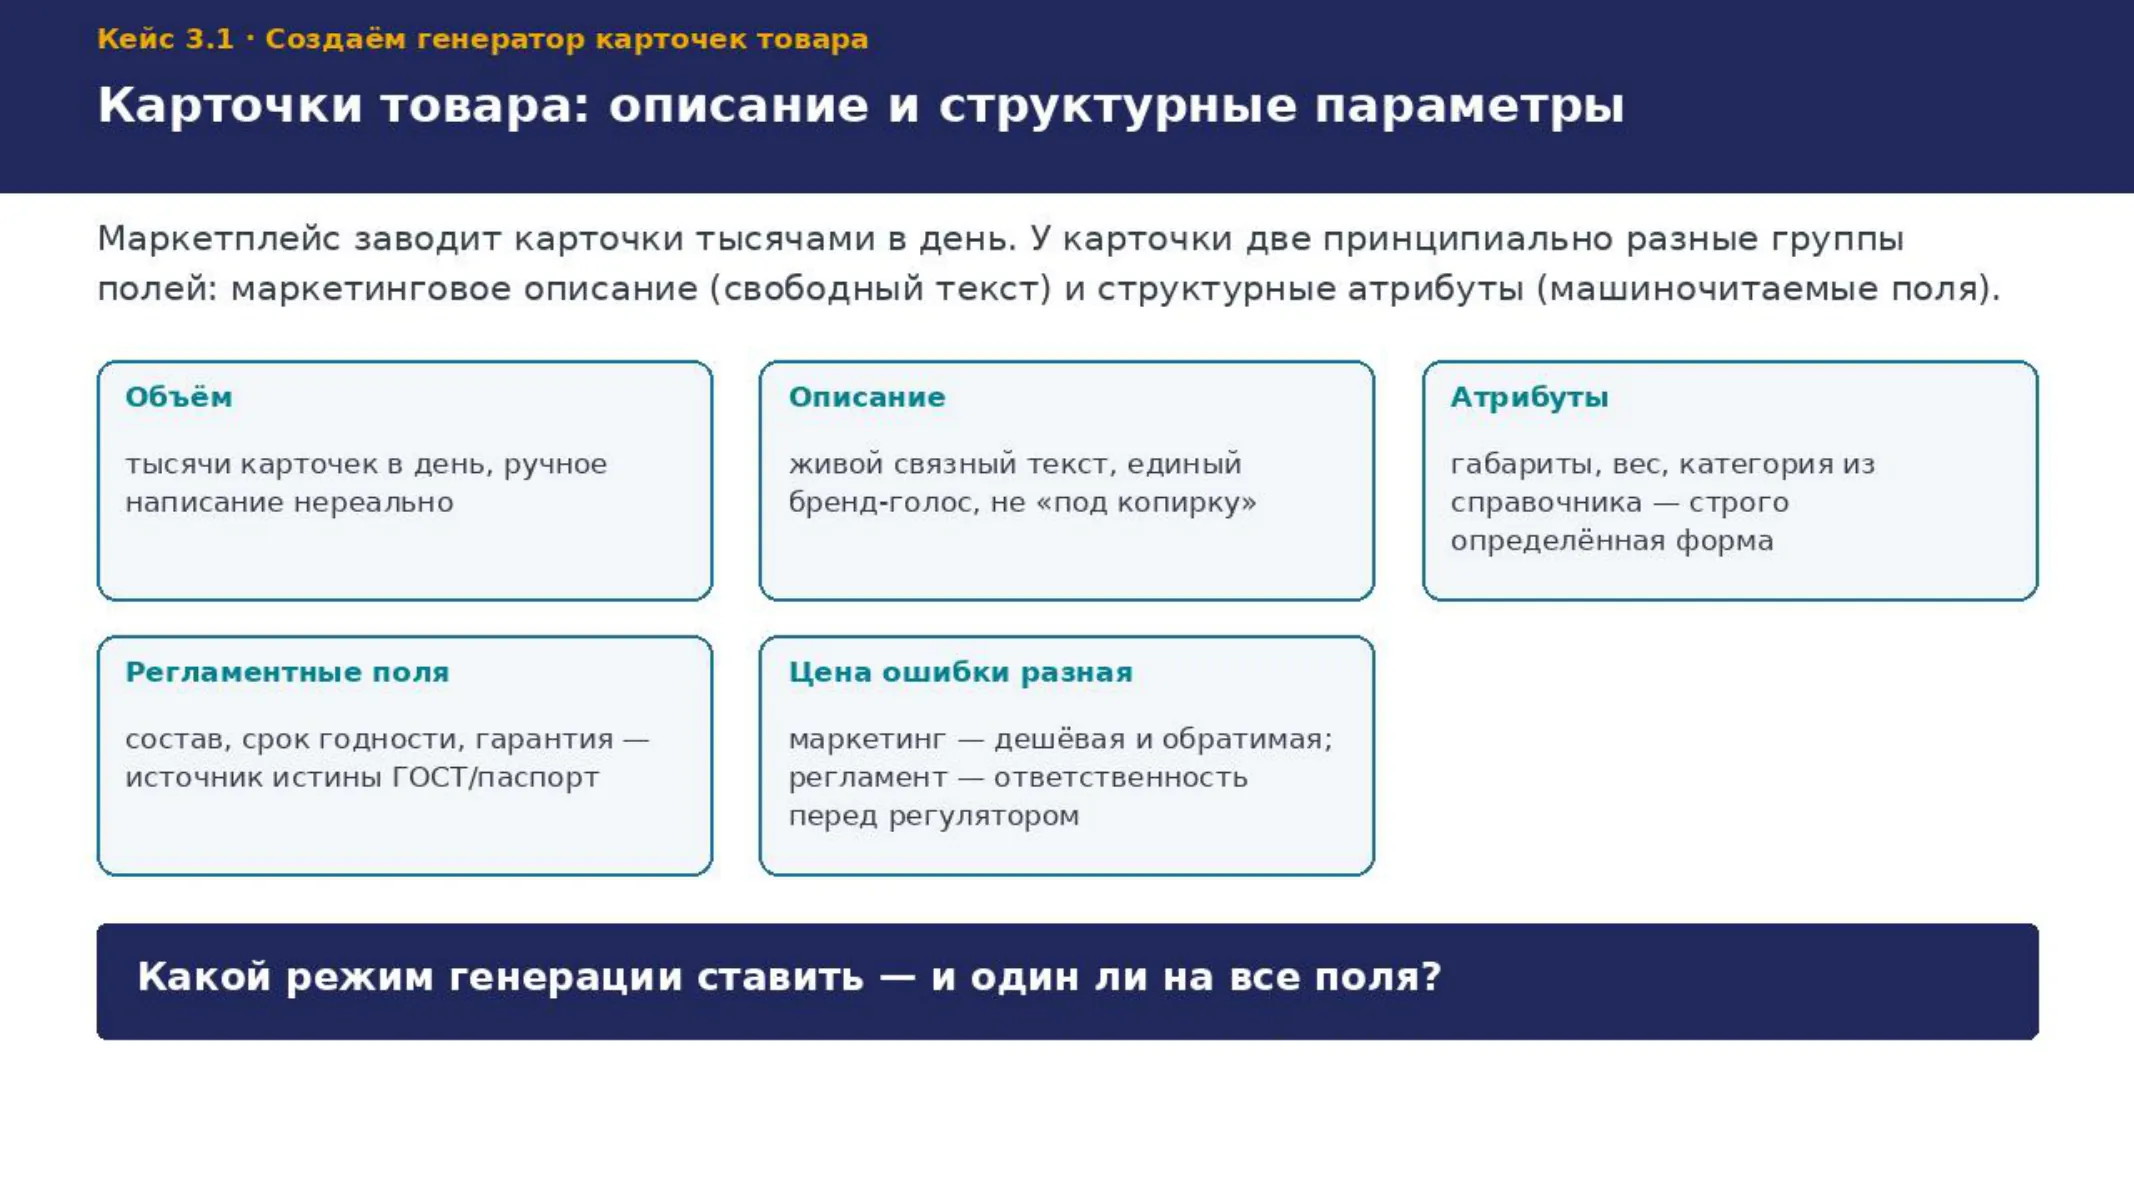
На слайде — постановка. Две группы полей живут по противоположным законам: маркетинговое описание ценит живость и разнообразие (тысяча карточек «под копирку» = спам, не продаёт); структурные атрибуты ценят повторяемую строгую форму (каталог принимает числа числами, категорию из справочника — «примерно 5 кг» вместо 5.0 не загрузится). Часть структурных полей регламентная: состав, срок годности, гарантия — их значение задаёт не фантазия, а источник (паспорт, ГОСТ). Цена ошибки разная: в описании низкая и обратимая, в структурных полях высокая (неверный габарит ломает расчёт доставки, неверное регламентное поле — ответственность перед регулятором). Соблазн — прогнать всё через одну модель одним запросом с одной температурой; именно этот путь даёт самые дорогие ошибки, потому что одна настройка сэмплинга обслуживает хорошо в лучшем случае одну из двух групп. Класс задачи — генерация с двумя разными режимами вывода в одном пайплайне. Дальше — как разводить поля по режимам: подбор температуры для описаний, structured output для атрибутов, подстановка из источника для регламента.
31 · Один промпт, три температуры: ось разброса, не «цветистост軶
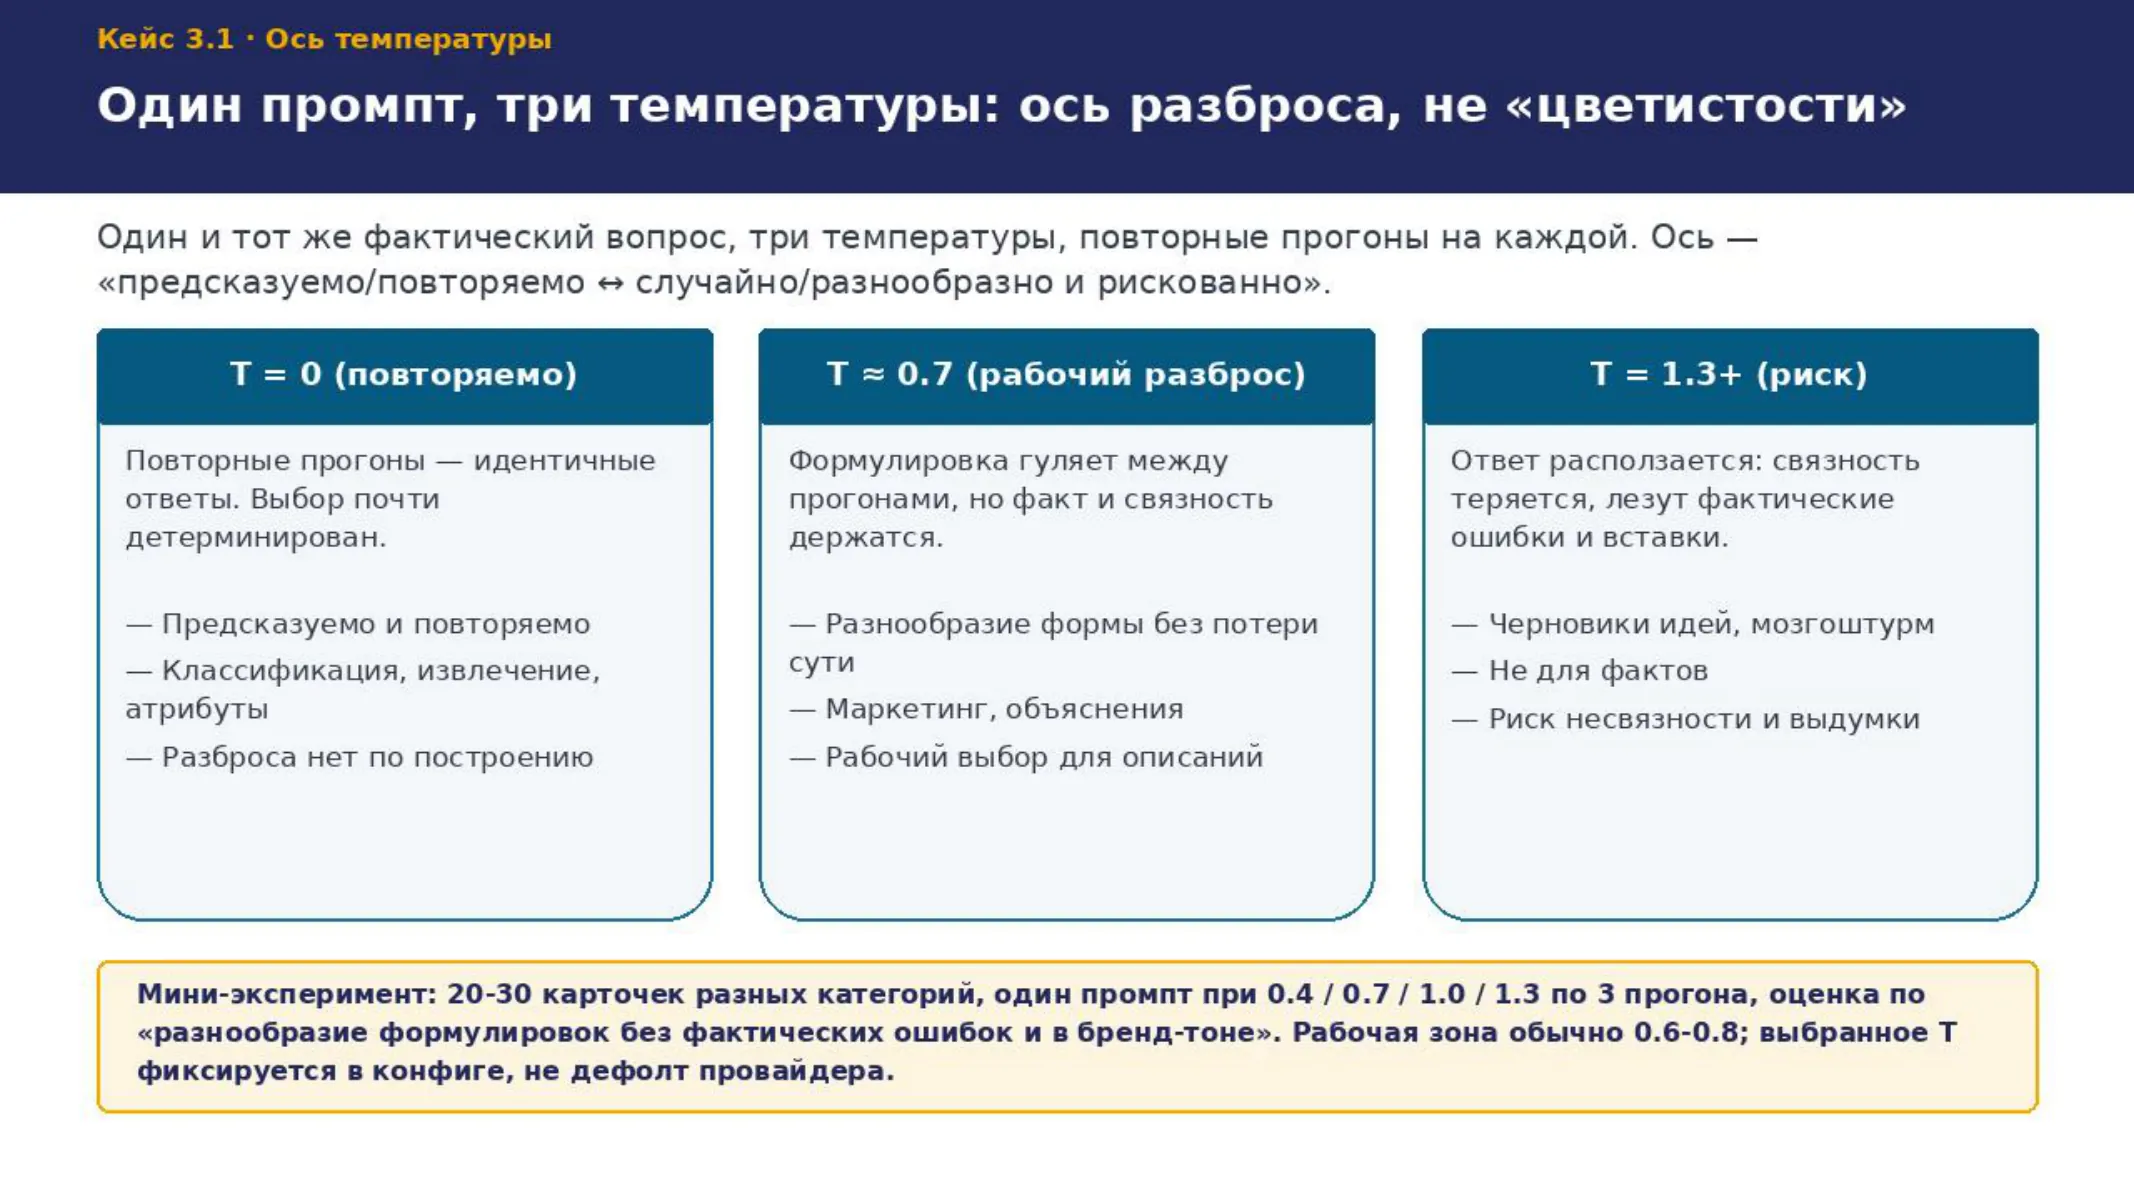
Ось температуры вынесена в заголовки колонок; наглядный эксперимент идёт ПЕРЕД механикой (concept), чтобы ось «предсказуемо ↔ случайно» была видна до объяснения устройства. Не бери температуру наугад и не путай со «стилем». Механика: при T→0 вероятность топ-кандидата → 1, выбор совпадает с argmax (детерминирован); при T>1 вероятности выравниваются, низкоранговые токены хвоста получают реальный шанс — отсюда разброс и риск несвязности. Порядок кандидатов T не меняет никогда — меняет, насколько уверенно выборка держится порядка. То, что на умеренной T читается как «живее», — это разнообразие формулировок МЕЖДУ прогонами, а не смена стиля внутри одного ответа; на высокой T то же разнообразие переходит в шум. Как читать батч-эксперимент двумя грубыми числами на каждое T: доля уникальных формулировок (чем выше, тем живее каталог) и доля прогонов с фактической ошибкой/выпадением из тона (чем ниже, тем безопаснее); идёшь по возрастанию T и ищешь точку, где первое высокое, а второе ещё близко к нулю — обычно 0.6-0.8, но зависит от модели и промпта, поэтому подбор повторяют при смене модели. Тон бренда задаётся промптом и few-shot-примерами, не температурой — «хочу другой стиль, подниму T» типичная путаница: стиль так не меняется, меняется разброс. Проверь дефолт провайдера: не задаёшь temperature явно — работаешь на его умолчании, выбранном за тебя случайно. Вероятный вопрос: «высокая T = креативнее?» — нет, разнообразнее и рискованнее; «креатив» без связности это шум.
32 · Температура задаёт разброс; схема задаёт форму, не истину
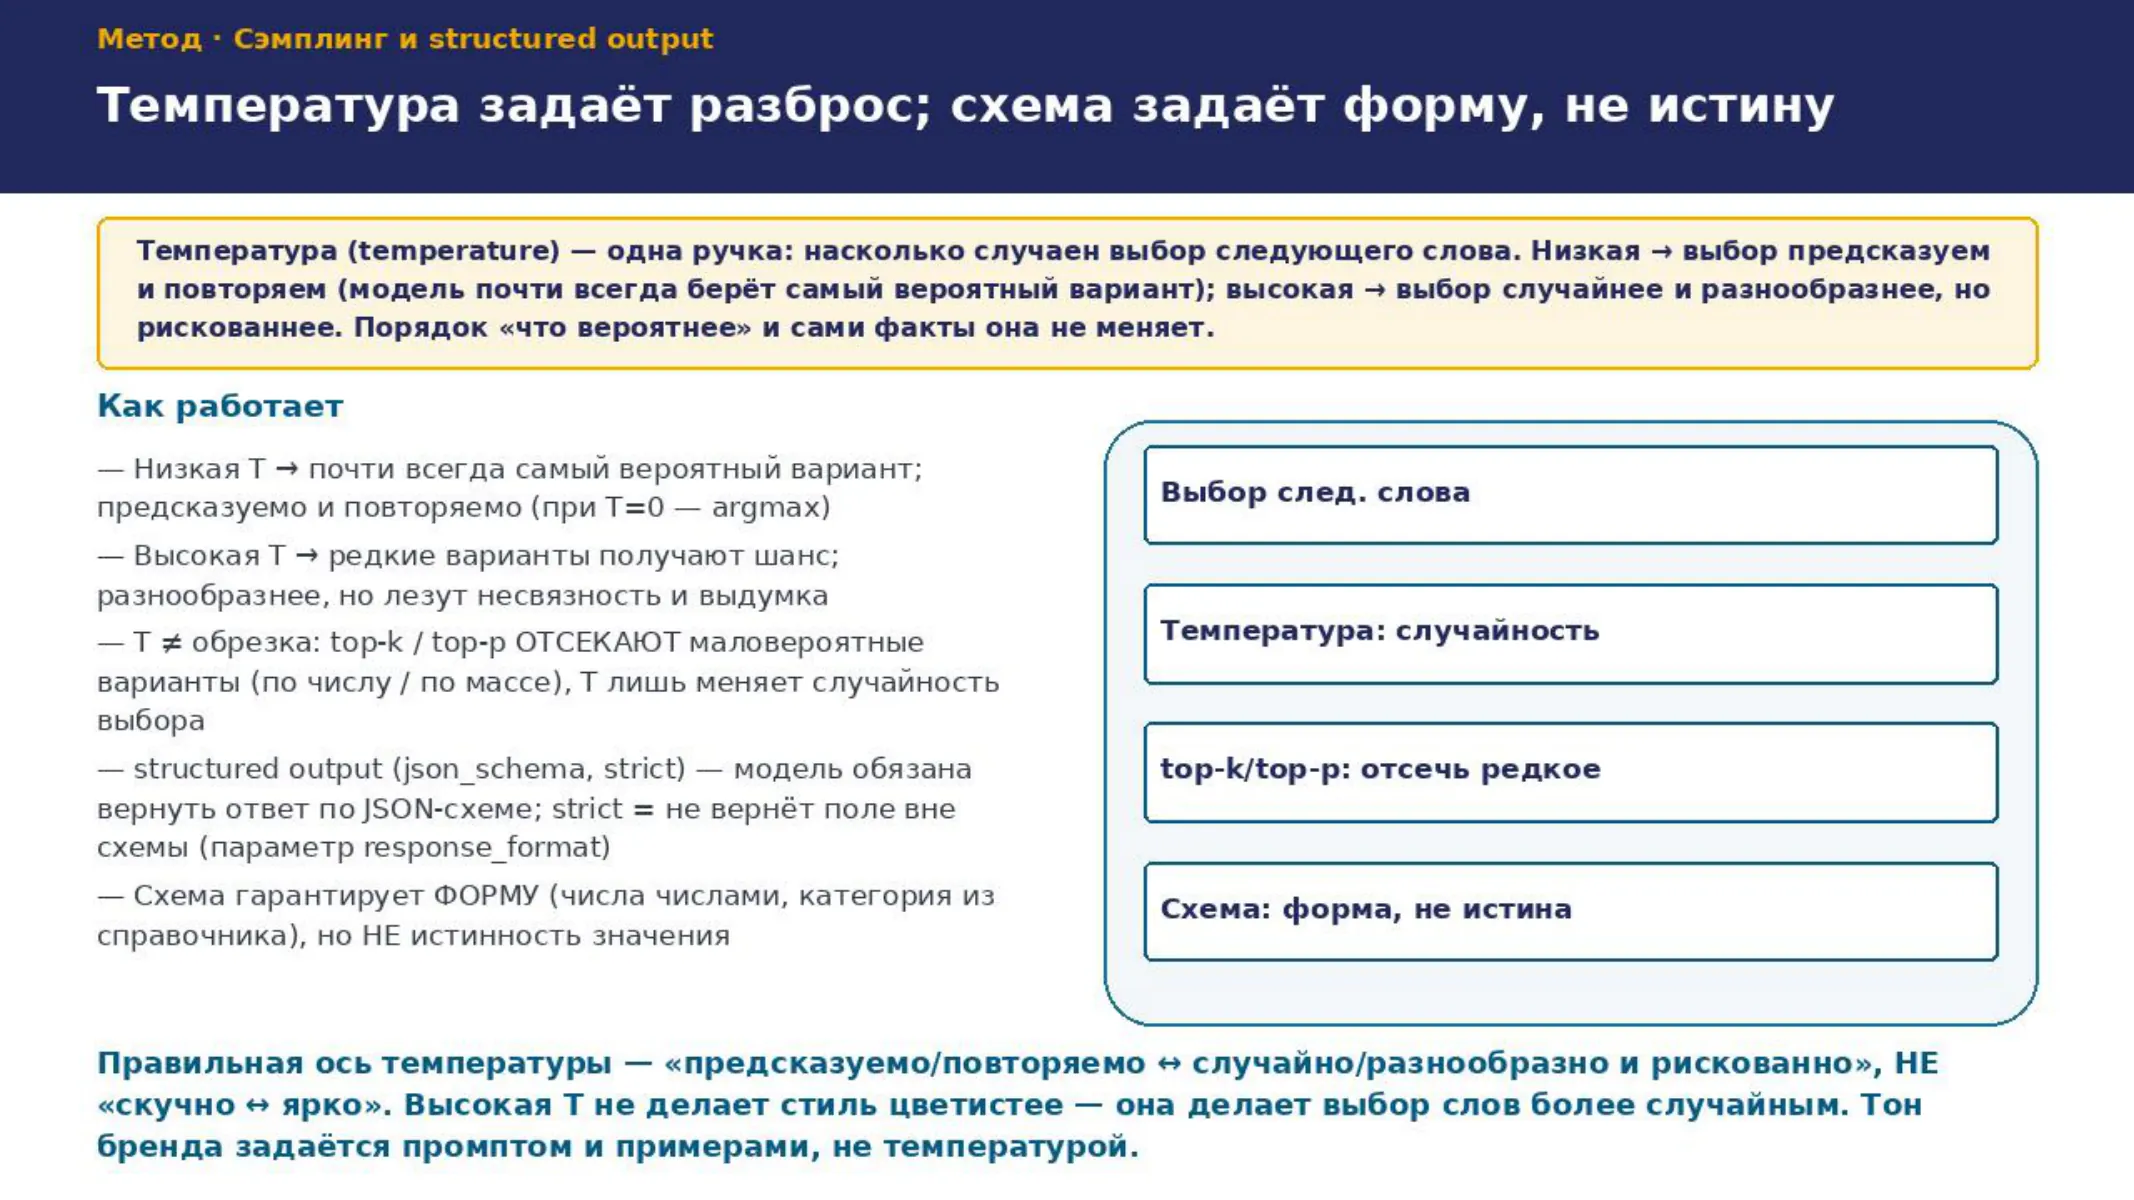
Здесь — механика уже показанной оси. Механически (для Q&A, не на слайд): истинный выход модели на каждом шаге — распределение вероятностей на весь словарь; температура делит логиты (сырые оценки) на T перед softmax (нормировкой в вероятности), меняя остроту распределения, но не порядок кандидатов. Всё «творчество» и вся «случайность» модели живут не в распределении, а в правиле выбора токена из него — это сэмплинг, единственная часть, которой инженер управляет ручками API. Деление на положительное T НЕ меняет порядок кандидатов — самый вероятный остаётся самым вероятным; меняется острота распределения, то есть насколько уверенно выборка держится порядка. Арифметика на трёх токенах: логиты 2.0/1.0/0.0 при T=1 дают вероятности 0.67/0.24/0.09; при T=0.5 (делим на 0.5 = удваиваем) 0.87/0.12/0.02 — острее; при T=2 дают 0.51/0.31/0.18 — сгладилось, порядок ни разу не менялся. top-k обрезает по числу кандидатов, top-p (nucleus) — по накопленной массе; температура масштабирует высоты, не выкидывая токенов — разные оси. Как увидеть ось — повторные прогоны одного промпта, а не один ответ: на одном прогоне не отличишь «модель уверена» от «повезло». Structured output работает не уговорами промпта («ответь в JSON» даёт валидный JSON ~в 80%), а constrained decoding: схема компилируется в автомат над токенами, невалидные обнуляются, режим strict у OpenAI — 100% соответствия схеме. Вероятный вопрос: «top-p/top-k — это то же, что температура?» — нет, они обрезают хвост, температура масштабирует высоты.
33 · Регламентные поля: ни одна температура не спасает
Ловушка вынесена сюда. Почему даже T=0 не спасает: низкая температура делает выбор стабильным (повторяемым), но не гарантирует, что факт верный — модель может стабильно повторять неверное. Air Canada (Moffatt v. Air Canada, февраль 2024) — самый цитируемый прецедент: чат-бот на сайте авиакомпании сообщил пассажиру несуществующую политику тарифа для скорбящих, пассажир купил билет и получил отказ; трибунал Британской Колумбии признал negligent misrepresentation, аргумент «бот — отдельное лицо» отклонён; сумма мала ($812), принцип велик — за сгенерированное моделью утверждение о факте отвечает компания. Регламентное поле карточки (состав, гарантия, «соответствует ГОСТ») — ровно такое утверждение о факте перед покупателем и регулятором. Как детектировать регламентное поле: если у поля есть внешний нормативный источник истины (ГОСТ, инструкция, гарантийный талон) — оно регламентное, генерации там не место, оно подставляется из источника шаблоном. Отдельный документированный класс — «одна температура на всё»: поставишь высокую ради живости описаний — получишь выдуманные атрибуты; низкую ради стабильности атрибутов — скучные описания и всё равно без гарантии истинности. Вероятный вопрос: «можно T=0 и просто скопировать из источника промптом?» — надёжнее подстановка шаблоном: T=0 не мешает модели перефразировать или пропустить пункт, шаблон гарантирует дословность.
34 · Пайплайн с тремя ветками: два запуска + подстановка
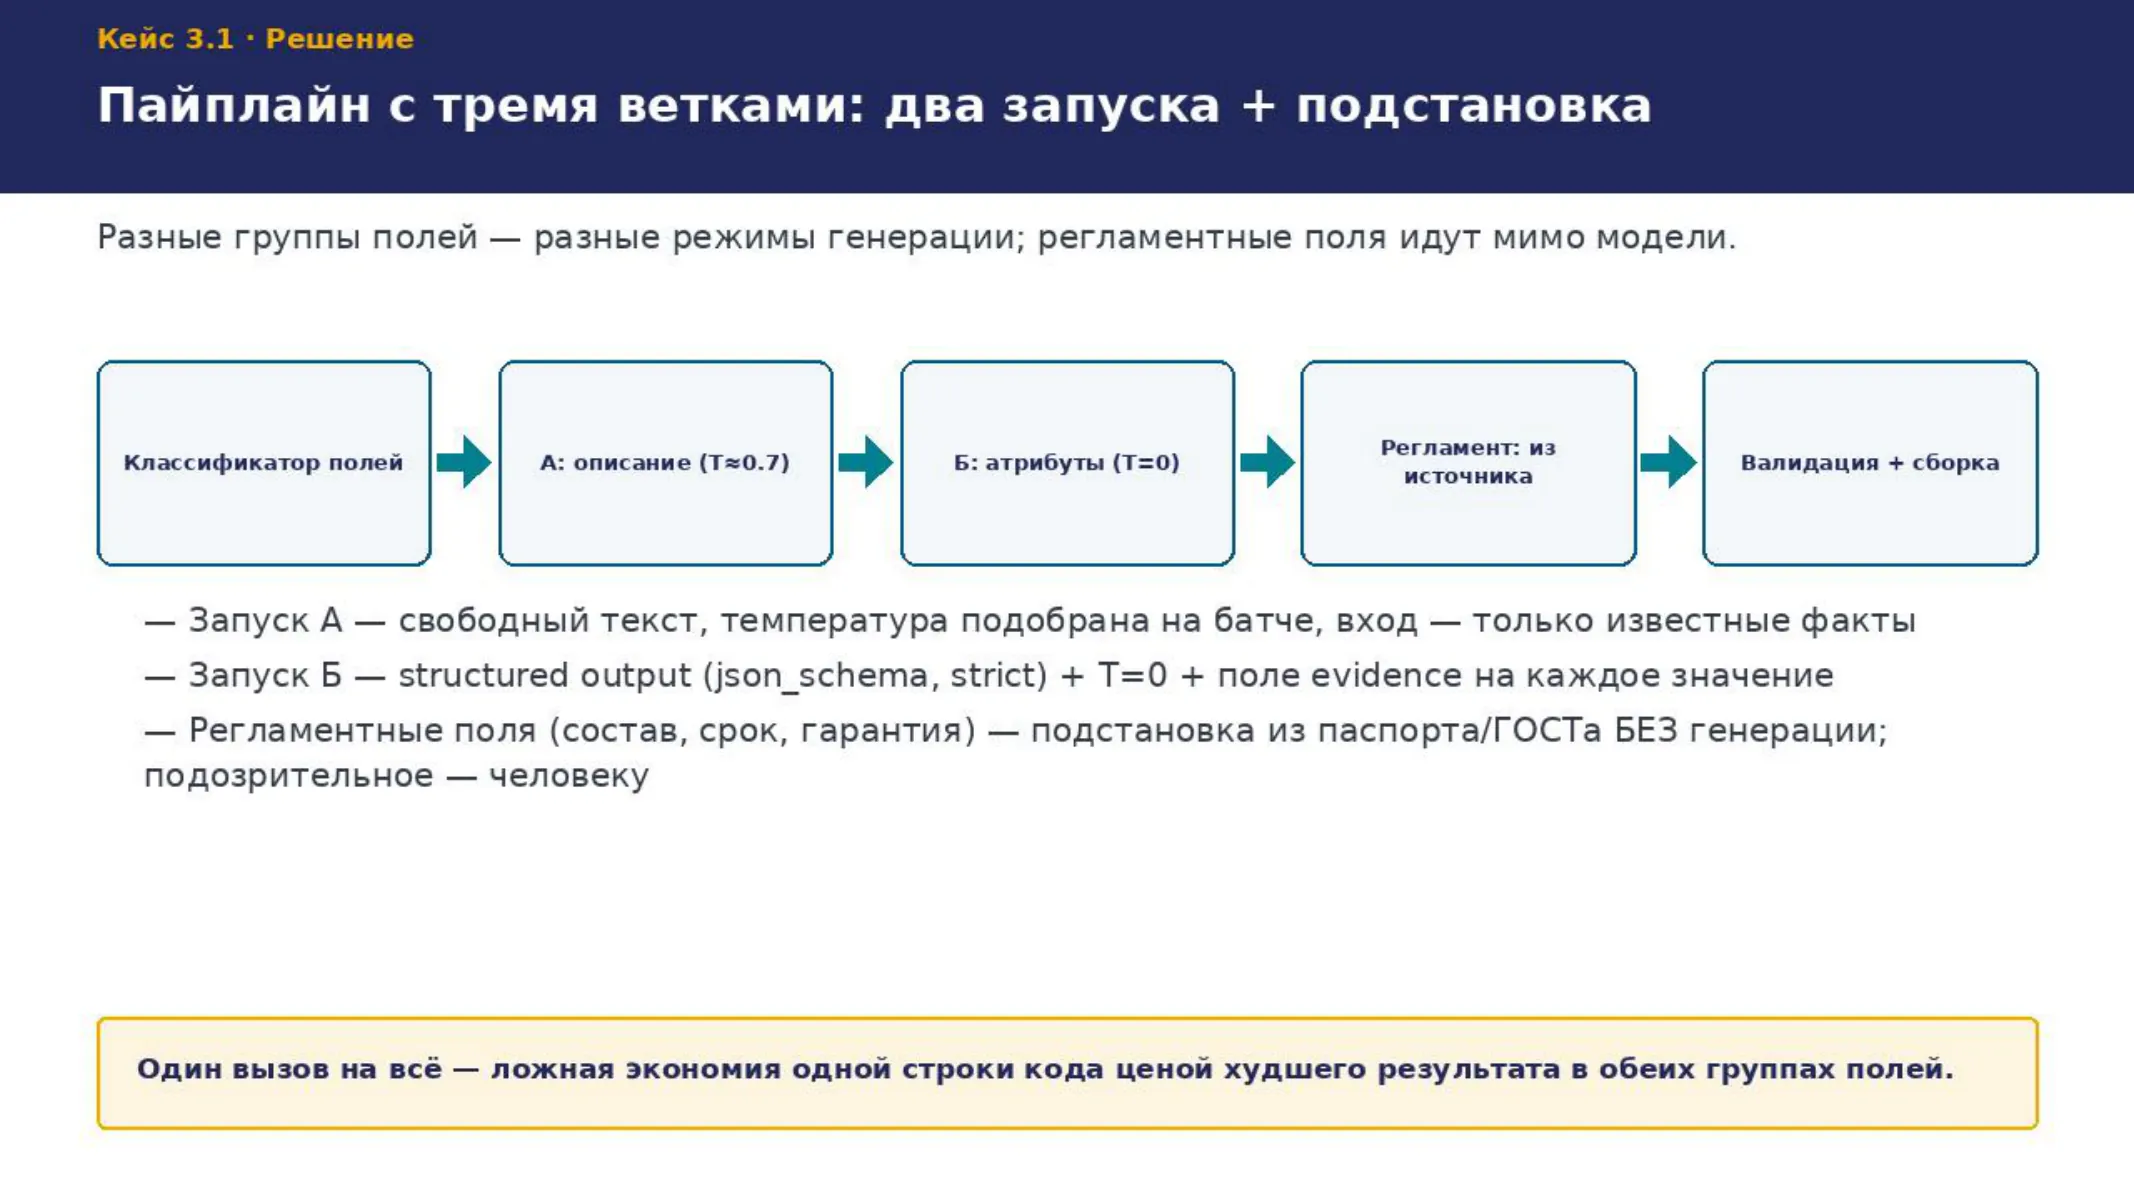
Схема из раздела 6.1 файла-кейса — три ветки, не одна. Входные данные о товаре сначала раскладываются по типу поля: что можно сгенерировать свободно (маркетинг), что структурно (нерегламентные атрибуты), что нельзя генерировать вовсе (регламентные). Дальше два разных запуска модели с противоположными настройками сэмплинга: запуск А даёт живой текст на умеренной, подобранной на батче температуре (вход — только известные факты, промпт запрещает выдумывать характеристики); запуск Б даёт валидные атрибуты через structured output при T=0 и требует к каждому значению обоснование-источник (поле evidence). Регламентные поля идут мимо модели — подстановкой из паспорта/шаблона. После запуска Б обязательна детерминированная валидация значений — именно она даёт истинность, которую схема не гарантирует: диапазоны (вес не 0 и не 10000 кг), категория из справочника, и главное — evidence реально есть во входных данных (грубая проверка вхождения подстроки ловит самый частый провал: безупречно оформленное, но выдуманное значение). Цена разделения на два запуска пренебрежима: запуск Б короткий (десятки токенов), а единый вызов с жёсткой схемой на всю карточку заставляет модель «тратить» распределение на форму даже там, где нужен живой текст. Вероятный вопрос: «положить описание строковым полем в ту же схему?» — наследуешь худшее: единая T испортит либо описание, либо атрибуты.
35 · Кейс 3.1 · Разбор
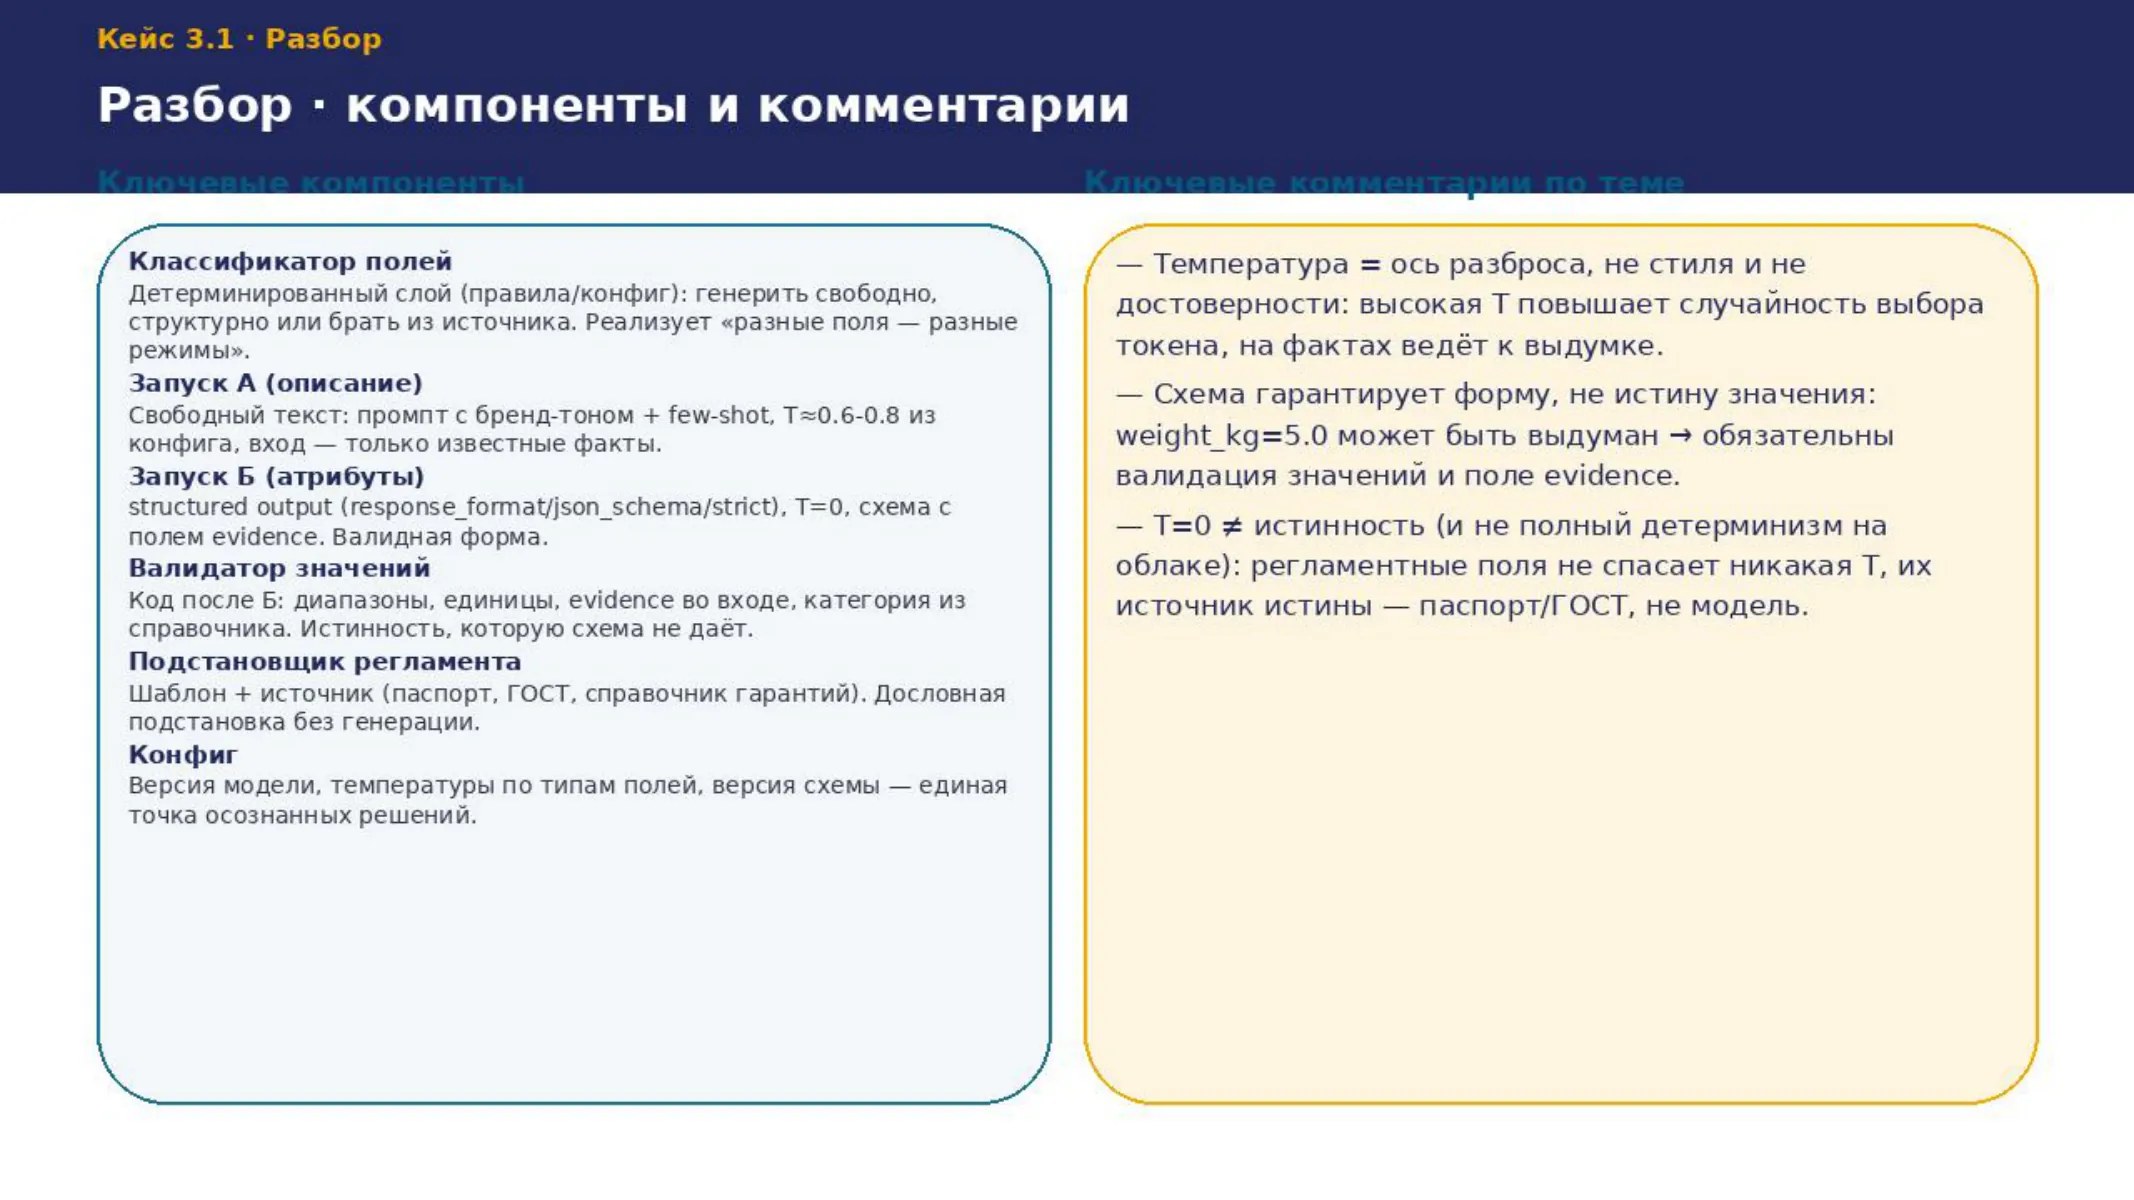
Разбор из разделов 6.2-6.4 файла-кейса. Температура = ось разброса, не стиля и не достоверности: запуск А работает на умеренной T ради разнообразия формулировок между карточками; высокая T не «украшает стиль», она повышает случайность выбора токена, и на фактах ведёт к выдумке. Грабля новичка: поднять T «чтобы было креативнее» и получить выдуманные характеристики; правильная формулировка — «поднять T, чтобы описания меньше повторялись, но не настолько, чтобы поехали факты», порог находится батч-экспериментом. Схема гарантирует форму, а не истину значения: запуск Б всегда вернёт валидный JSON нужной формы, но weight_kg=5.0 может быть выдуман; грабля — поверить, что раз JSON валиден, значение верно; отсюда обязательные валидация значений и поле evidence (форму даёт схема, истинность — код и источник). T=0 ≠ истинность и не полный детерминизм: низкая температура делает вывод повторяемым, но модель может стабильно повторять неверное, а на облаке даже T=0 не даёт побитового детерминизма (провайдер группирует запросы в батчи переменного размера, порядок суммирования в ядрах разный); регламентные поля не спасает никакая температура. Один вызов на всё — ложная экономия одной строки кода ценой того, что ни одна из двух групп не обслужена правильно. Вероятный вопрос: «100% соответствия схеме — зачем ещё валидировать значения?» — 100% это про форму, не про истину; плюс отдельный путь отказа (refusal) надо ловить кодом.
36 · Кейс 3.1
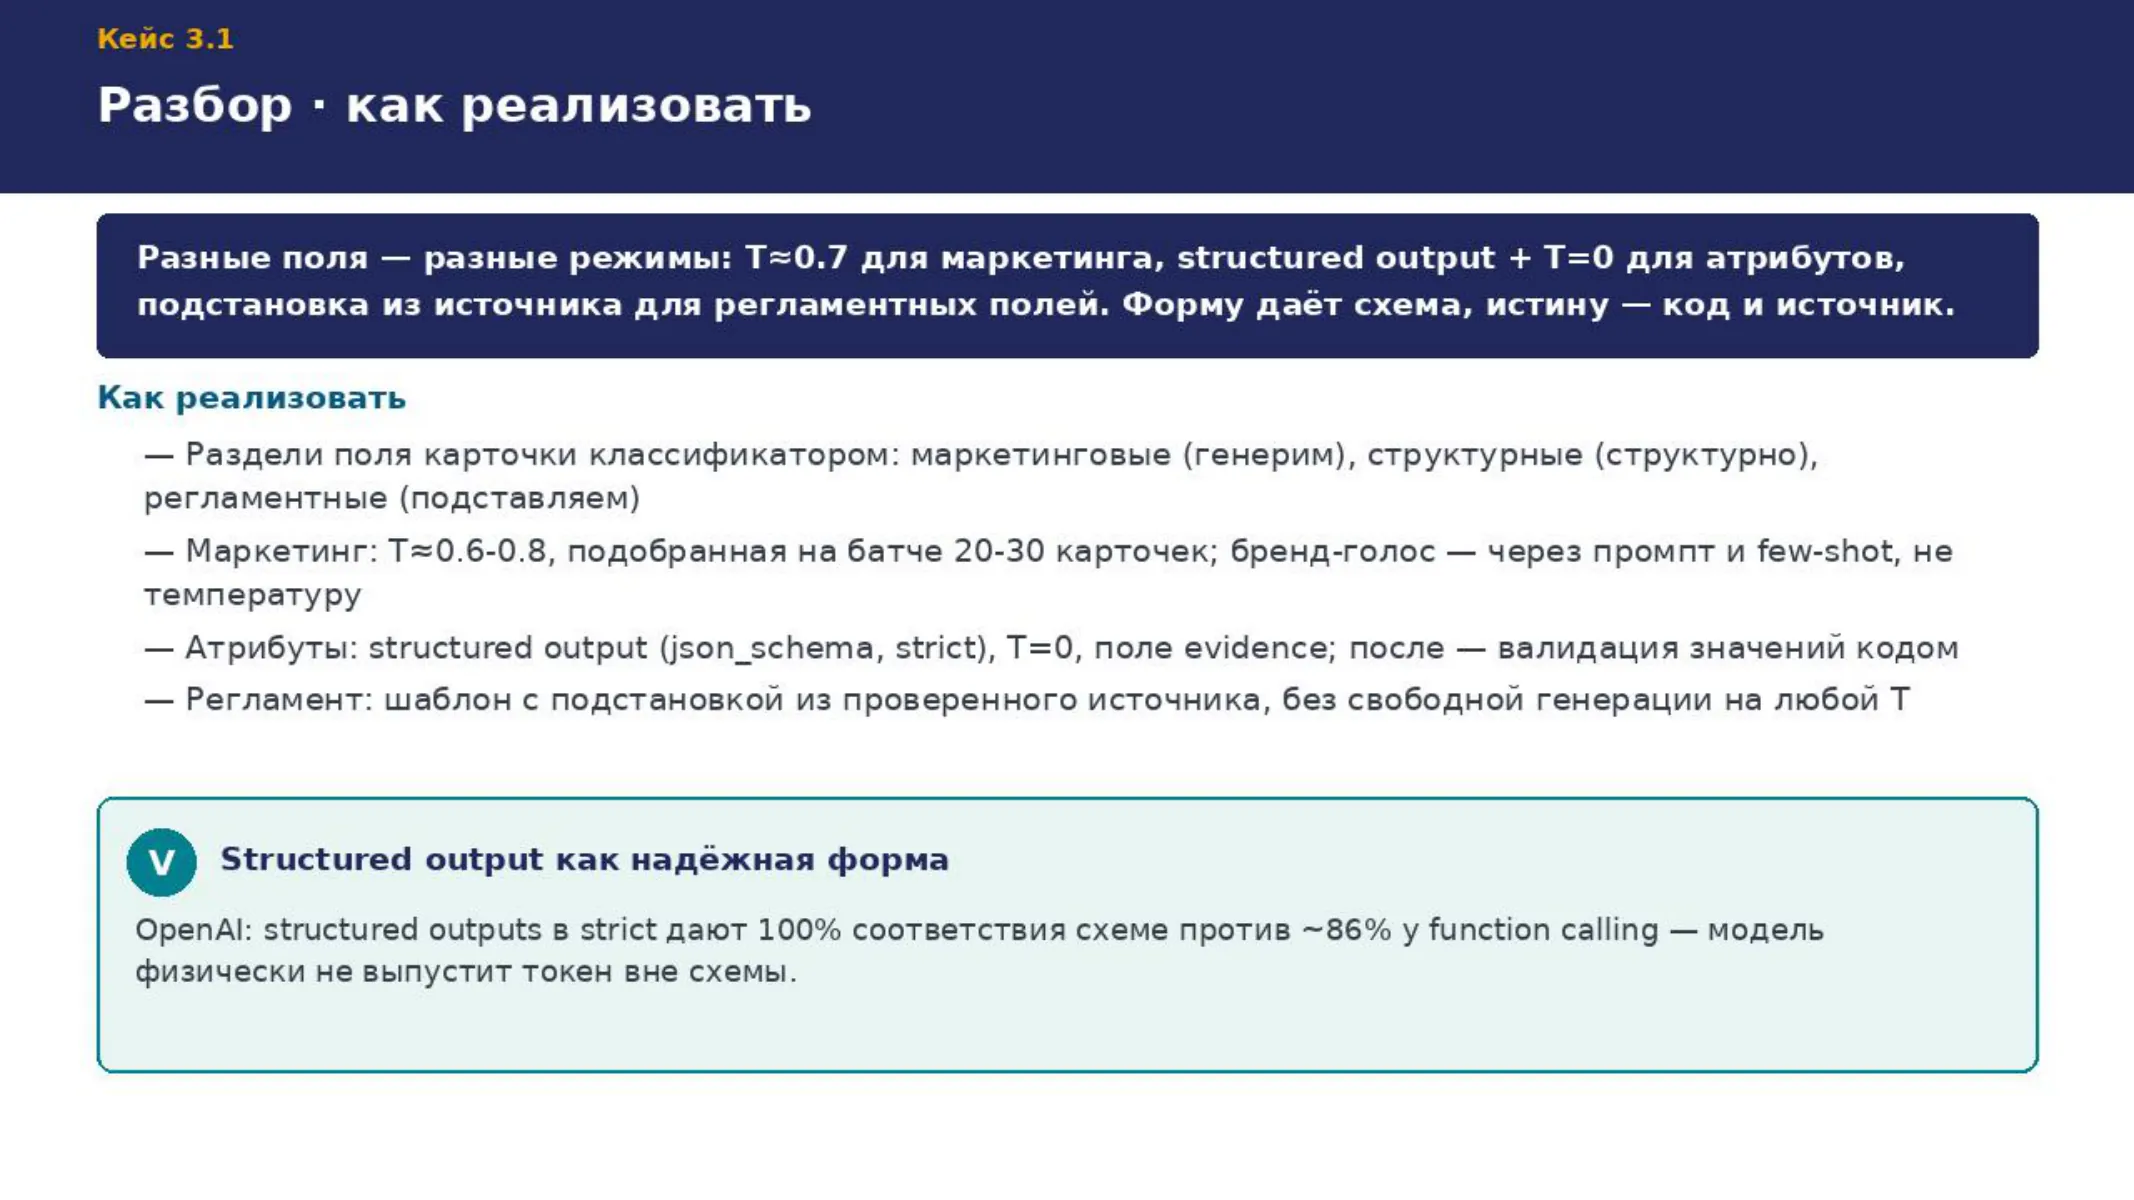
На карточке-примере оговорка: 100% формы ≠ 100% истины — валидацию значений и генерацию регламента structured output не отменяет; strict работает через constrained decoding. Пошаговый how-to из разбора и Q&A файла-кейса. Решение по полю: «это про красоту или про факт/право?». Красота — умеренное T (0.6-0.8), подобранное на батче 20-30 карточек разных категорий по критерию «разнообразие без вранья», по 3 прогона на значение. Факт/право — подстановка из источника: шаблон с плейсхолдерами, значения из карточки-источника или проверенной базы, генерации там не место ни на какой T. Атрибуты — structured output (strict) + T=0 + поле evidence, после генерации обязательная валидация кодом: диапазоны, единицы, проверка что evidence реально есть во входных данных (грубое вхождение подстроки ловит выдуманное значение — модель может вернуть material: «нержавеющая сталь», evidence: «нержавеющая сталь», хотя слова «сталь» в исходнике нет). Грабли: не полагайся на T=0 как на «страховку от вранья» — стабильность ≠ истинность; начинай со схемы проще, чем хочется (глубокая вложенность приближает к границам компилятора грамматик); не генерируй схему динамически на каждый запрос (холодная компиляция). Вероятный вопрос: «тон бренда — это температура?» — нет, тон задаётся промптом и few-shot, температура только управляет разбросом вокруг этого тона. Отсутствует поле во входе — разреши null в схеме и потребуй null, а не угадывание.
37 · Посимвольные фичи: пароль, карта, лимит, подсчёт
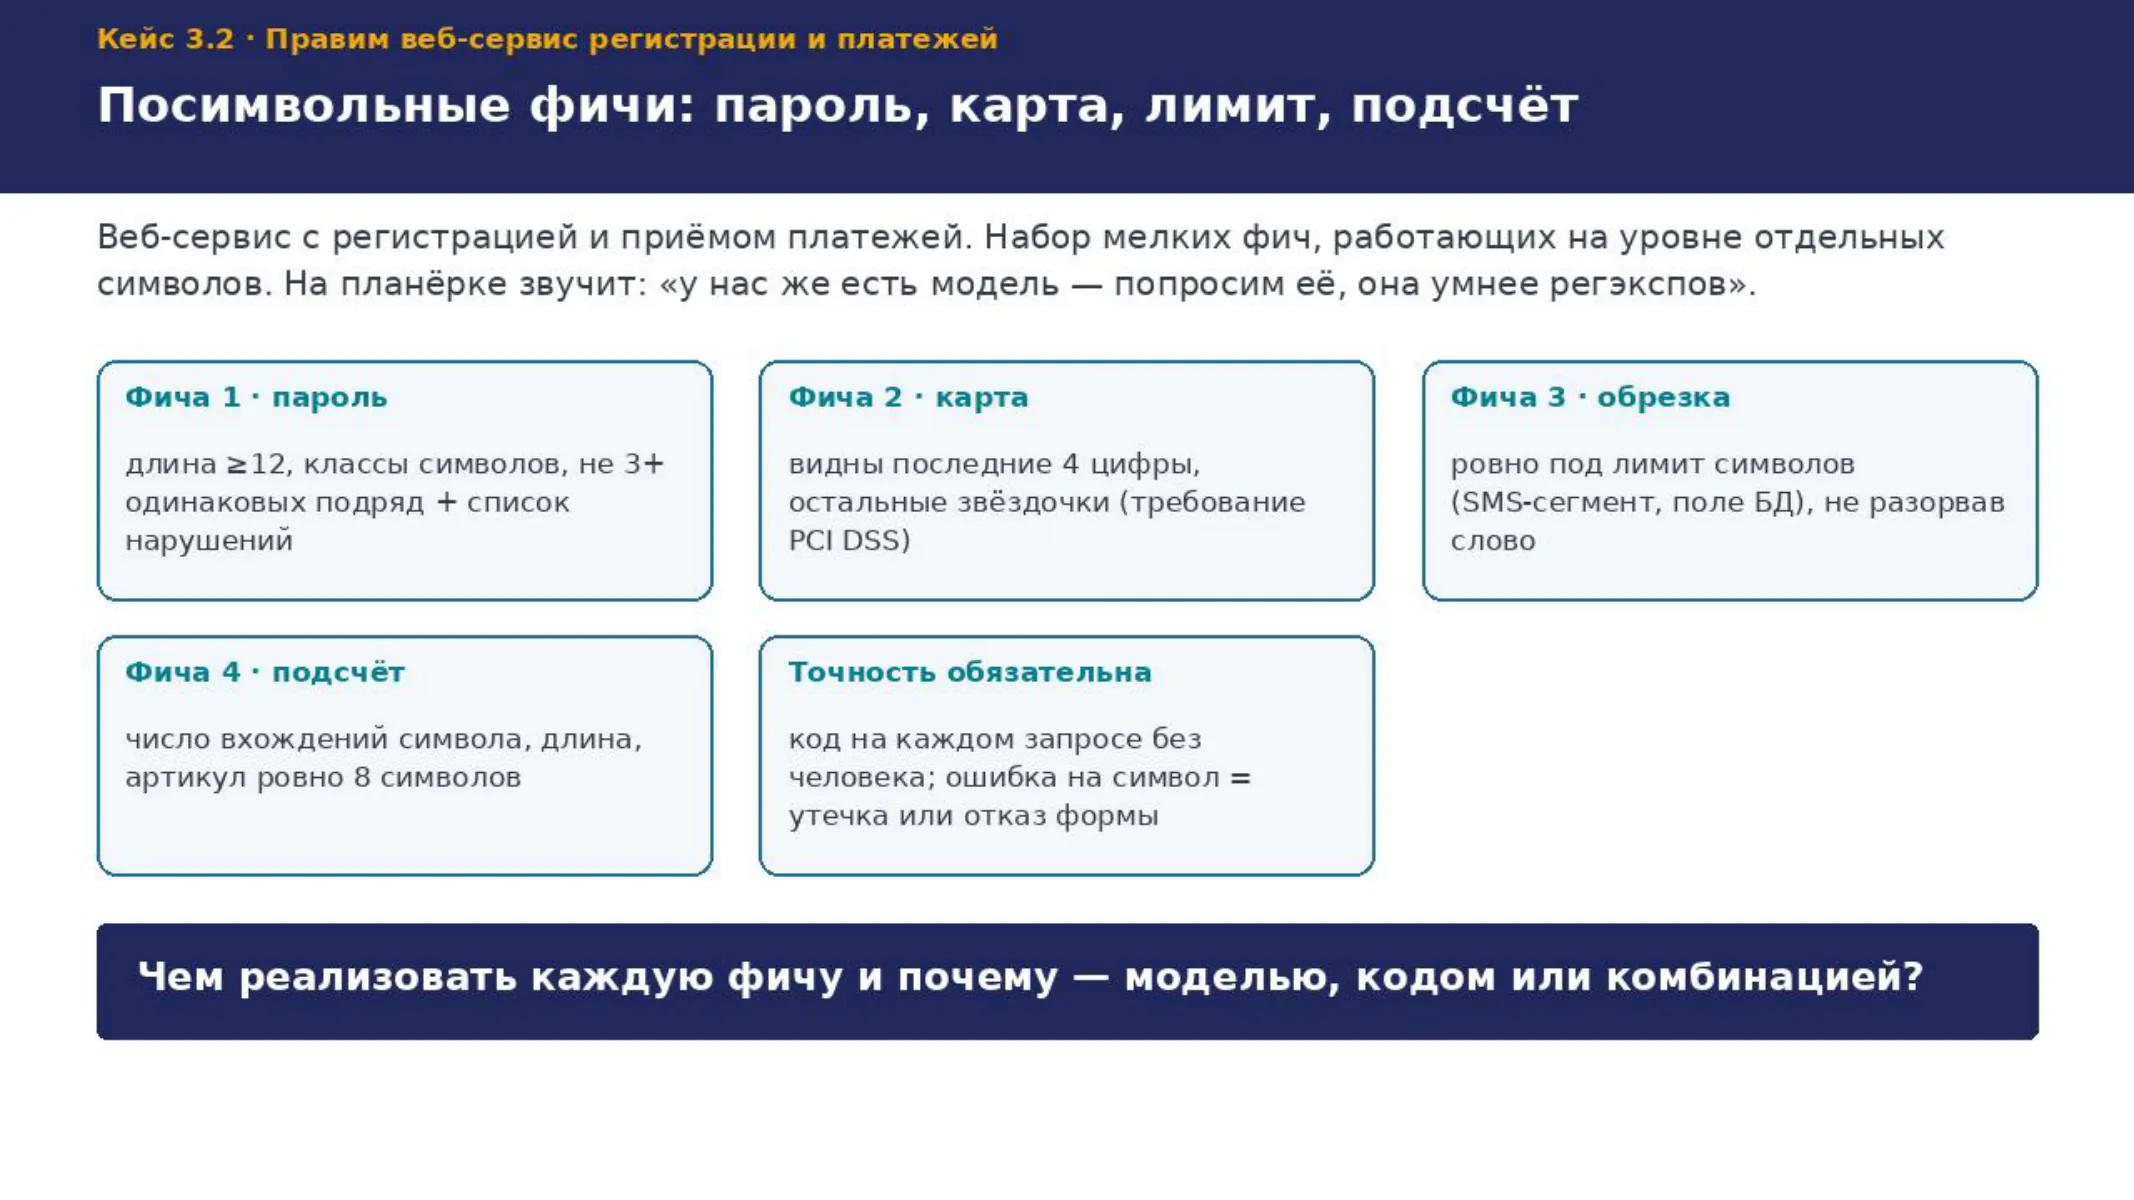
На слайде — постановка. Все фичи работают на уровне отдельных символов, точность обязательна, ошибок быть не должно: код выполняется на каждом запросе без человека в цикле — проверка длины ошиблась на символ, форма пропустит невалидное или отклонит валидное; маскирование пропустило цифру — утечка. Объём и латентность: миллисекунды, а не «сходить в API и подождать». Регуляторика: для маскирования карты есть внешнее требование (PCI DSS — свод правил защиты данных банковских карт); отправка полного номера карты в чужой облачный API ради «замаскируй» — сама по себе проблема, отдельно от вопроса «справится ли модель». Постановка не утверждает «модель сломается» — лишь описывает набор посимвольных задач и фиксирует, что кто-то в команде предлагает сделать их через LLM; чем реализовать — решение студентов. Контраст с кейсом 3.1: там генерация текста и атрибутов — модель на своём месте, работа с токенами её сильная сторона; здесь задача обратная — посимвольная проверка и подсчёт не ниша модели. Тот же механизм (работа с токенами, а не буквами), что делает LLM хорошим генератором, делает её плохим счётчиком символов. Дальше — почему токен ≠ символ, где именно ломается и как то же надёжно делает код.
38 · Почему модель структурно не считает символы
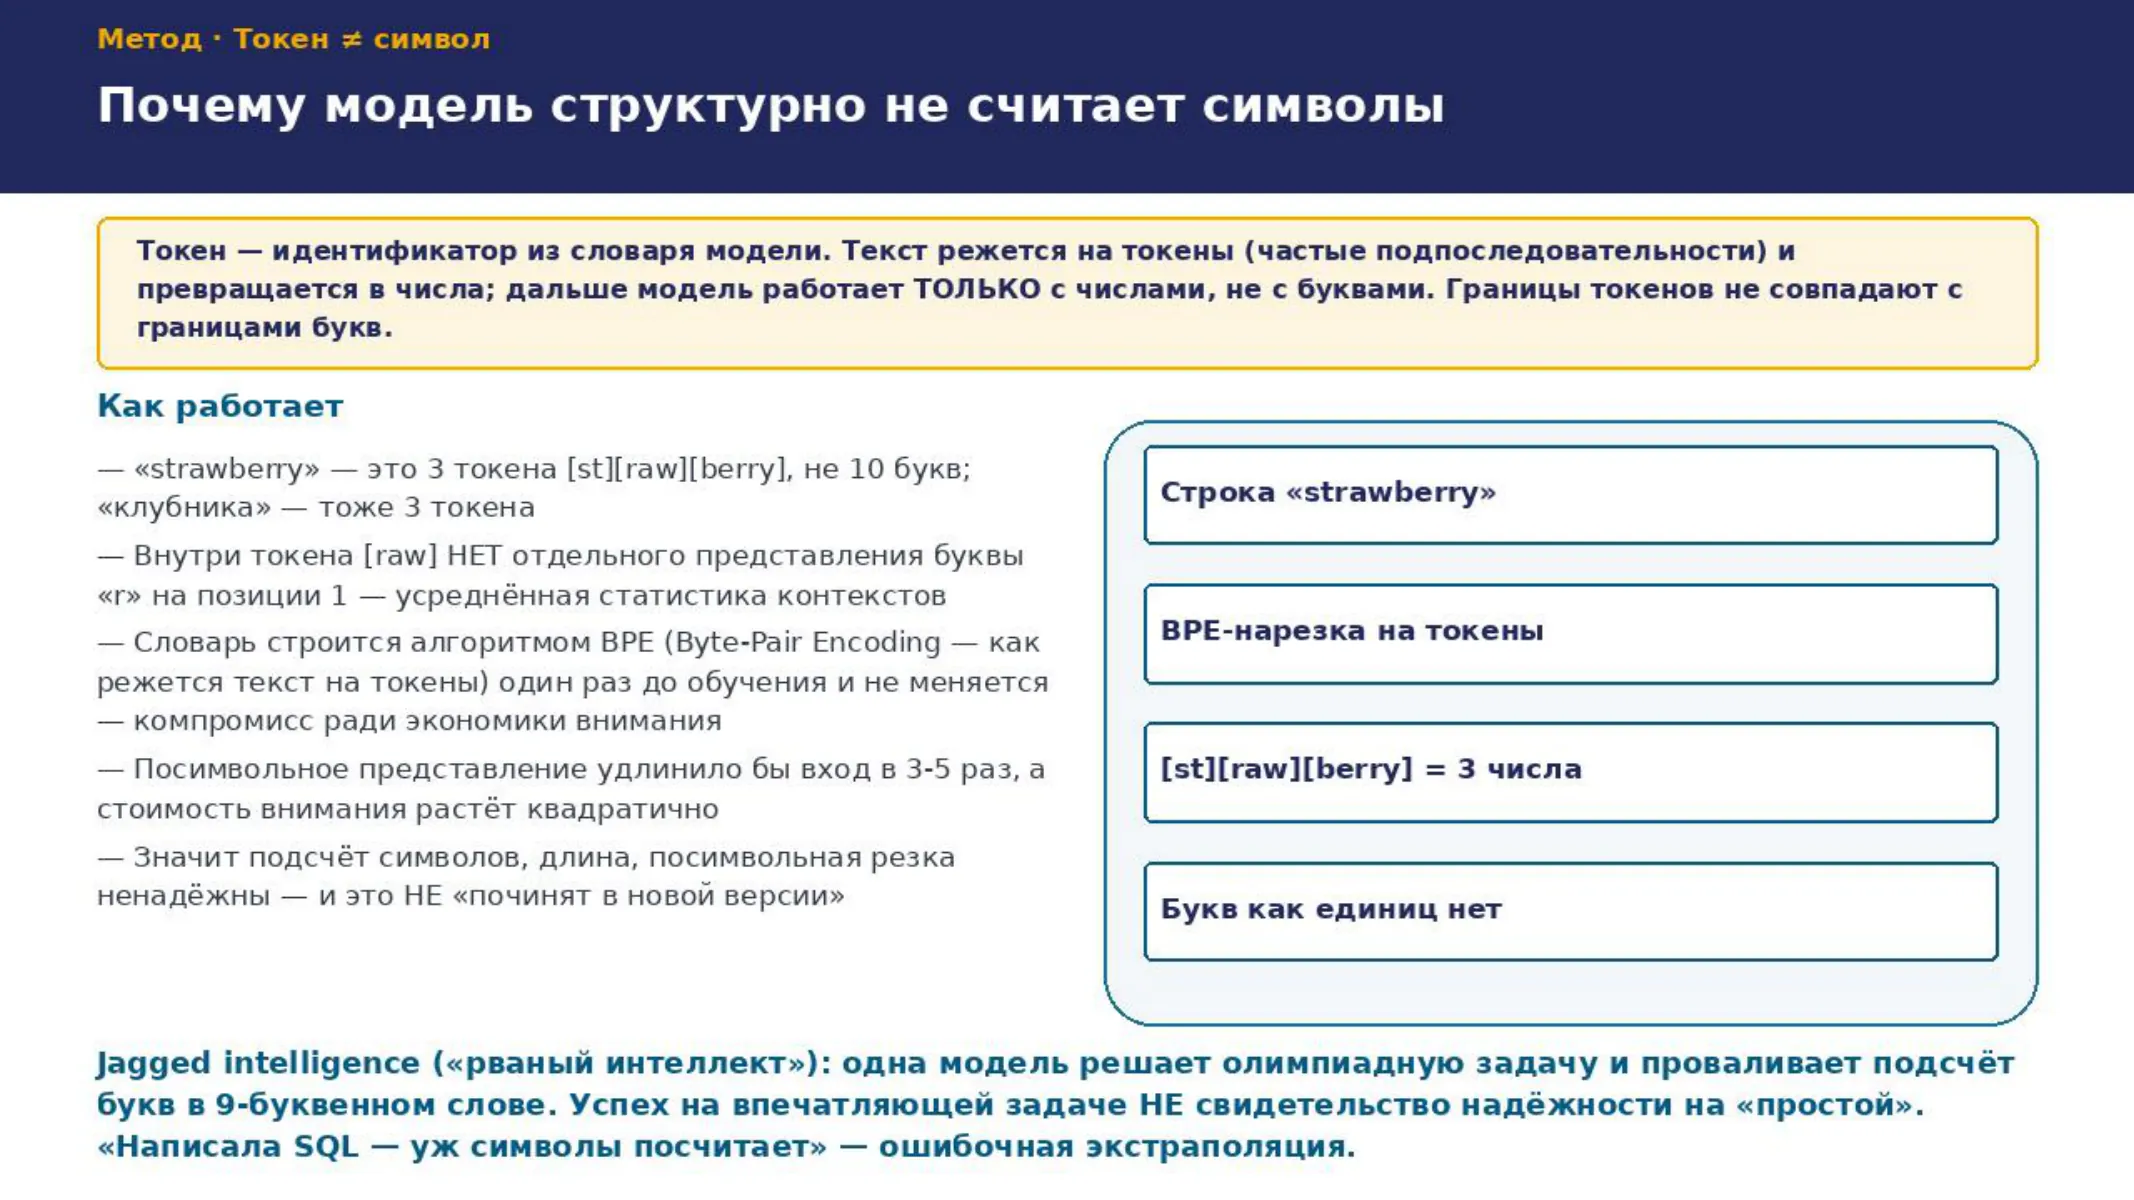
Здесь — механика, ещё не сами демонстрации. Токен — идентификатор (целое число) из словаря; текст не попадает в модель побуквенно, сначала режется на токены (статистически частые подпоследовательности, выученные при обучении) и превращается в числа. Границы токенов не совпадают с границами букв, слогов или морфем — токенизатор режет по частотной статистике корпуса. Внутри токена нет разложения на буквы как на отдельные адресуемые единицы: вектор токена — выученное представление того, в каких контекстах он встречается; спросить у него «какая третья буква» всё равно что спросить у усреднённого портрета толпы про цвет глаз третьего слева. Модель может реконструировать буквы окольным путём (если слово часто писали по буквам), но это реконструкция по памяти, а не чтение позиции, и потому ненадёжна. Словарь строится BPE (Byte-Pair Encoding — склеивание частых пар) один раз до обучения; это компромисс, а не баг: посимвольное представление удлинило бы вход в 3-5 раз, а стоимость внимания растёт квадратично (в 4 раза длиннее — в 16 раз дороже). Не стоит ждать, что «починят»: идеального словаря, где токен одновременно «частый кусок для экономики» и «отдельная буква для подсчёта», не существует — это взаимоисключающие требования. Для русского хуже: около 0.5 токена на символ против 0.25 у английского. Вероятный вопрос: «chain-of-thought решает?» — иногда, если модель развернёт по буквам или вызовет код, но дороже и без гарантии; для точного результата надёжнее len/регэксп.
39 · Патч ≠ навык: strawberry чинят, cranberry ломается
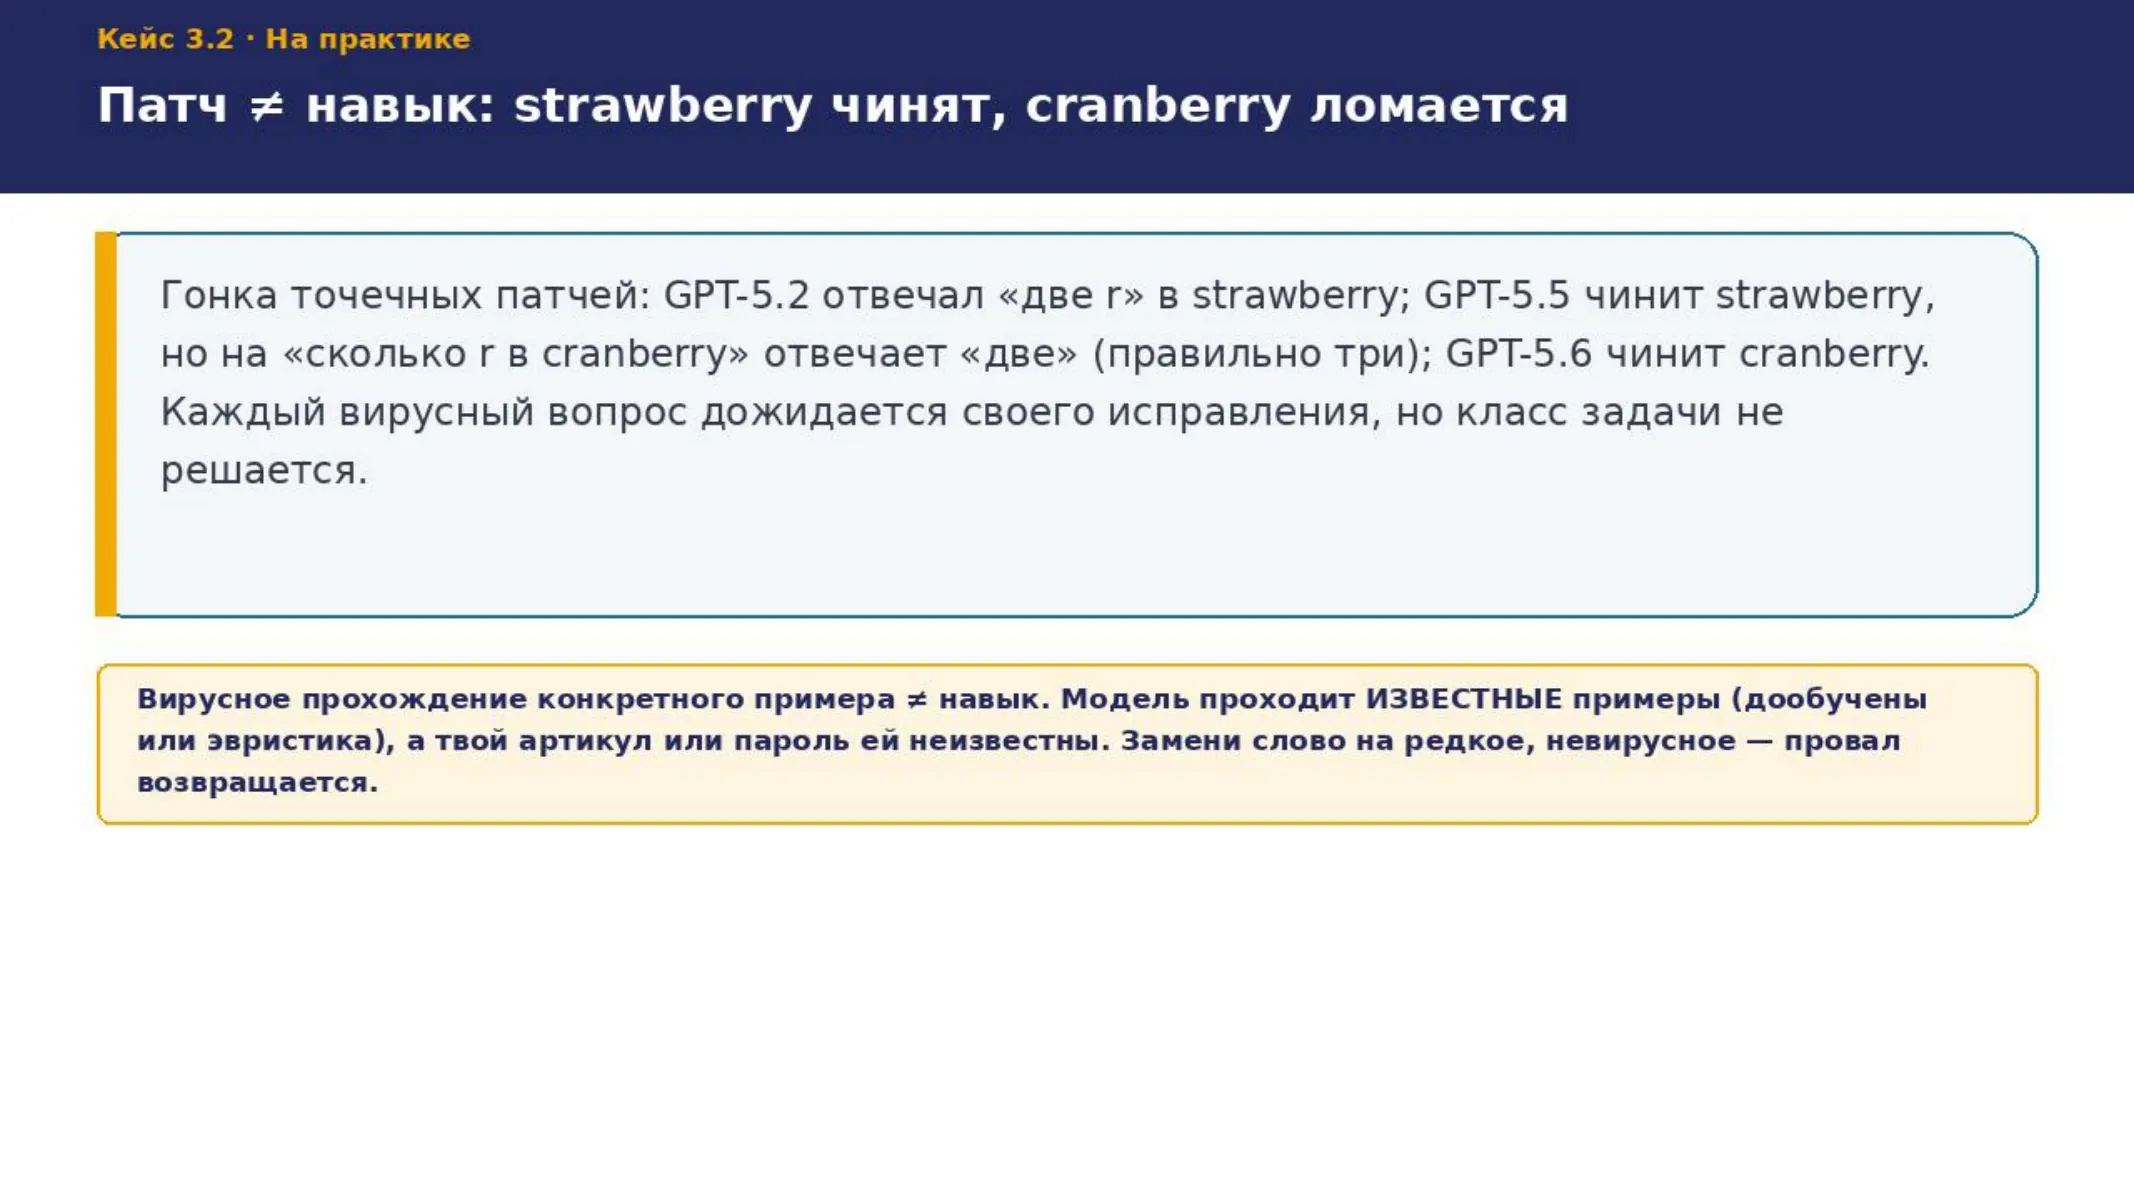
Мем «сколько r в strawberry» стал каноническим примером слепоты LLM к буквам; механизм тот самый — слово приходит как , а не десять букв. Интересна не ошибка, а её эволюция: она показывает природу проблемы — это гонка точечных патчей, каждый вирусный вопрос дожидается исправления (дообучением на нём или эвристикой), но класс задачи не решается, посимвольный подсчёт остаётся проблемным на словах, ещё не ставших вирусными. Появился даже специализированный бенчмарк StrawberryBench (847 вопросов, семь уровней сложности на подсчёт произвольной буквы). Выученный урок: вирусное прохождение конкретного примера ≠ навык — проверяй свои редкие, никому не известные кейсы отдельно; не полагайся на «модель теперь считает буквы» — она проходит известные примеры, а твой артикул или пароль ей неизвестны. Смежный провал — арифметика: без внешних инструментов точность умножения падает с ~59% на 3-значных числах до 4% на 4-значных и 0% на 5-значных (Dziri et al., 2023, «Faith and Fate»); обвальность падения — надёжный признак структурной, а не «интеллектуальной» проблемы. Мини-эксперимент для скептика в команде: спроси модель, сколько заданной буквы в списке слов (частые + редкие + выдуманные + артикулы), сравни с word.count из кода — на вирусных модель права, на редких ошибается, код даёт 100% на любом. Ключ демонстрации — включить именно невирусные слова: тестируешь только strawberry — измеряешь не навык, а покрытие патчами.
40 · Детерминированное — коду, смысловое — модели
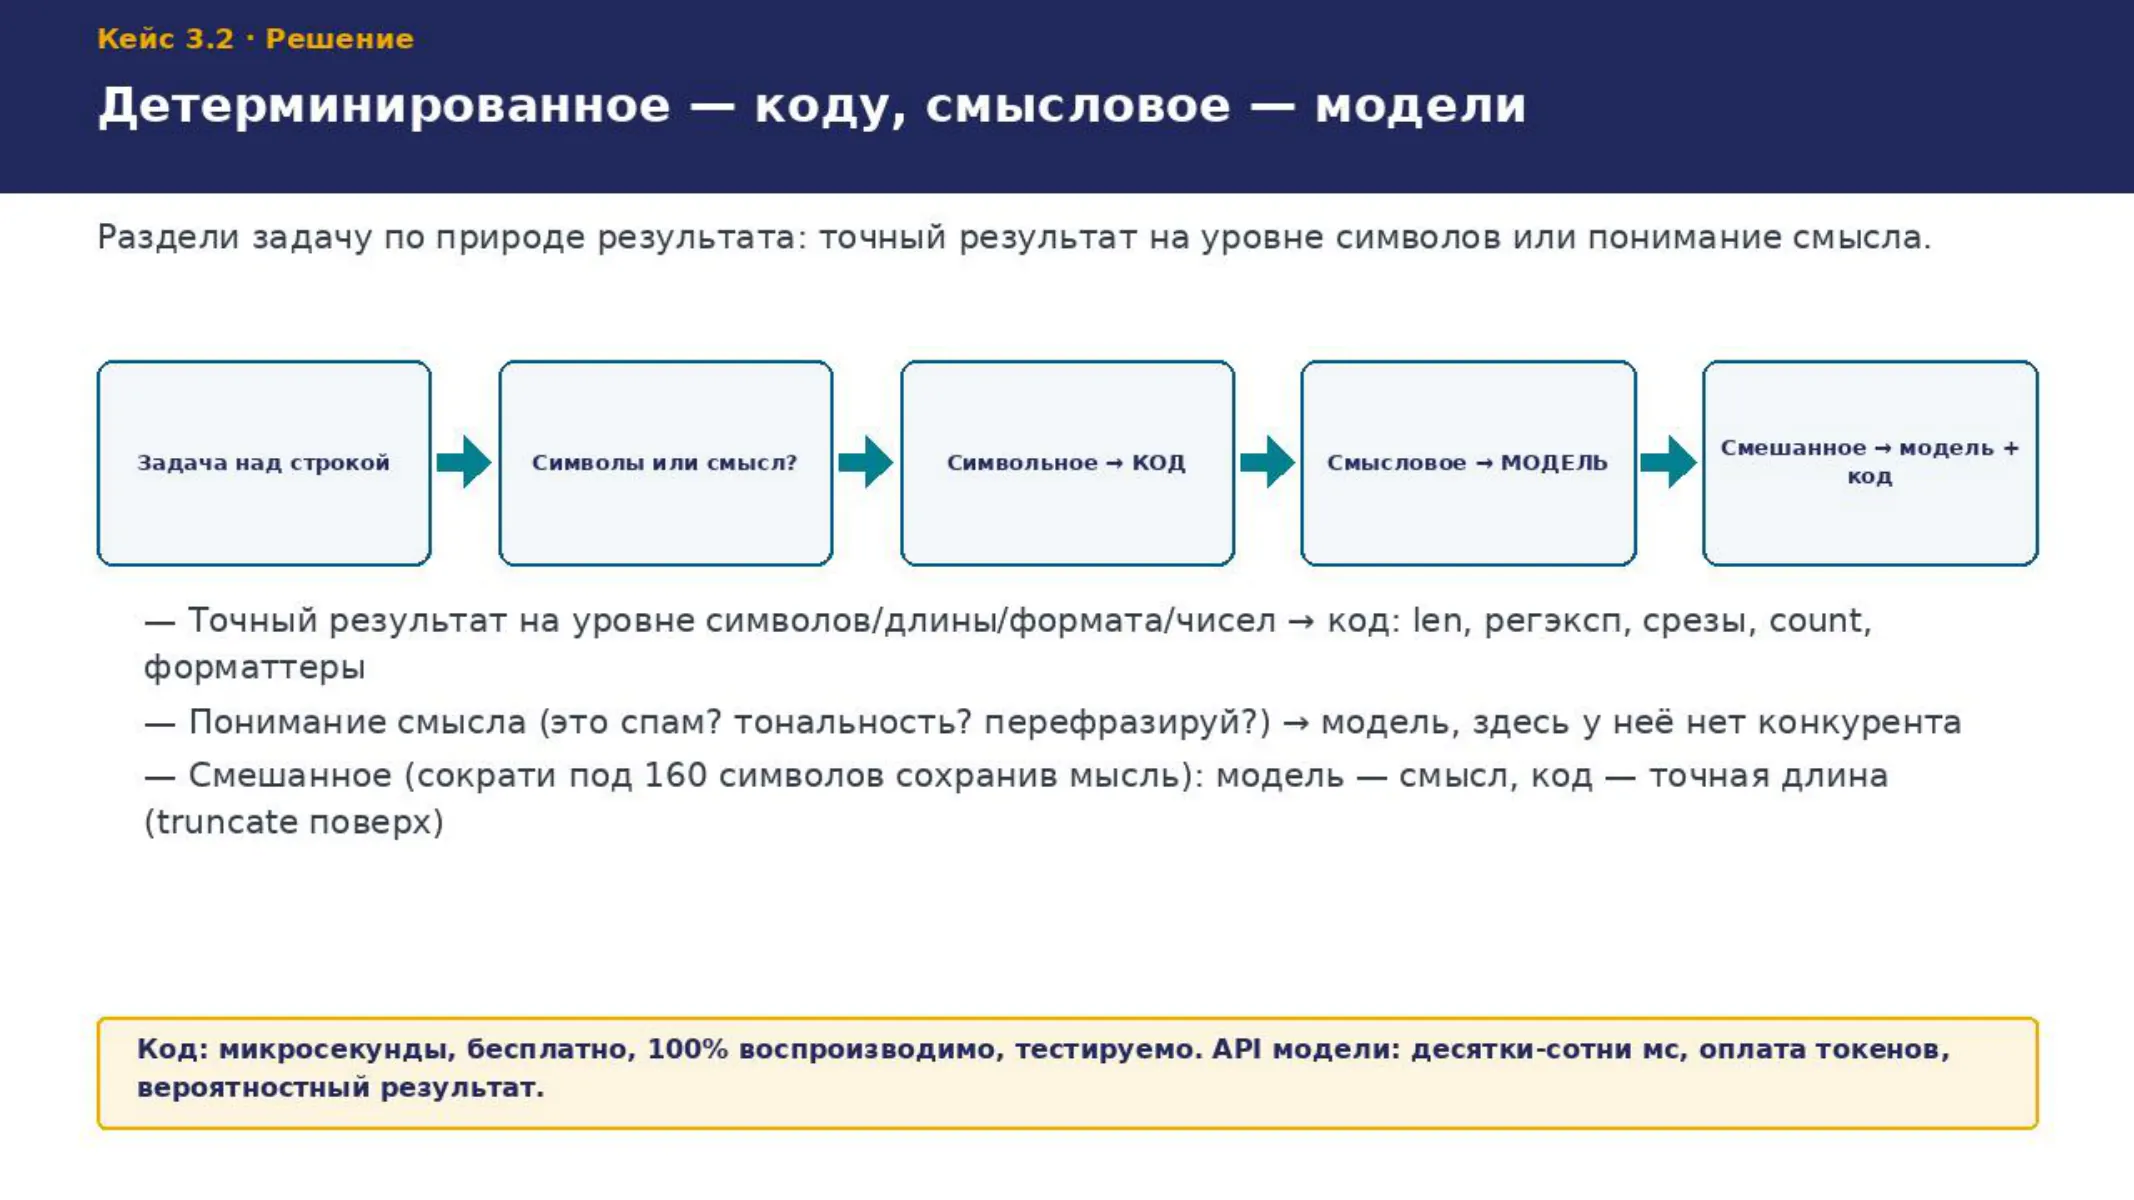
Схема из раздела 6.1 файла-кейса. Каждая входящая задача над строкой сначала классифицируется по природе результата: нужен ли точный результат на уровне символов, позиций, длины или чисел — или нужно понимание смысла. Символьное/детерминированное уходит в код (len, регэксп, срезы, count, форматтеры, обычная арифметика) — там результат точный, мгновенный, бесплатный и воспроизводимый. Смысловое (это спам? тональность? извлеки суть? перефразируй?) уходит в модель — здесь у неё нет конкурента среди обычного кода. Если задача смешана (нужен и смысл, и точная форма — например «сократи описание до 160 символов, сохранив мысль»): модель делает смысловую часть без жёсткого требования к длине, код гарантирует посимвольную часть (truncate(вывод_модели, 160)) — финальная детерминированная обрезка поверх. Никогда не поручай модели быть последней инстанцией по точному символьному ограничению, последнее слово за кодом. Количественная сторона делает выбор очевидным: символьная операция кодом — микросекунды на локальном процессоре, нулевая стоимость, стопроцентная воспроизводимость; та же операция через API — десятки-сотни мс, оплата за токены на каждом обращении, зависимость от доступности сервиса и вероятностный результат. Даже если бы модель считала символы идеально, отдавать ей эту работу было бы дороже, медленнее и хрупче. Вероятный вопрос: «разные модели токенизируют по-разному, может у какой-то токен = символ?» — ни у одной массовой модели токен не равен символу, это противоречит цели токенизации; решение — код.
41 · Кейс 3.2 · Разбор
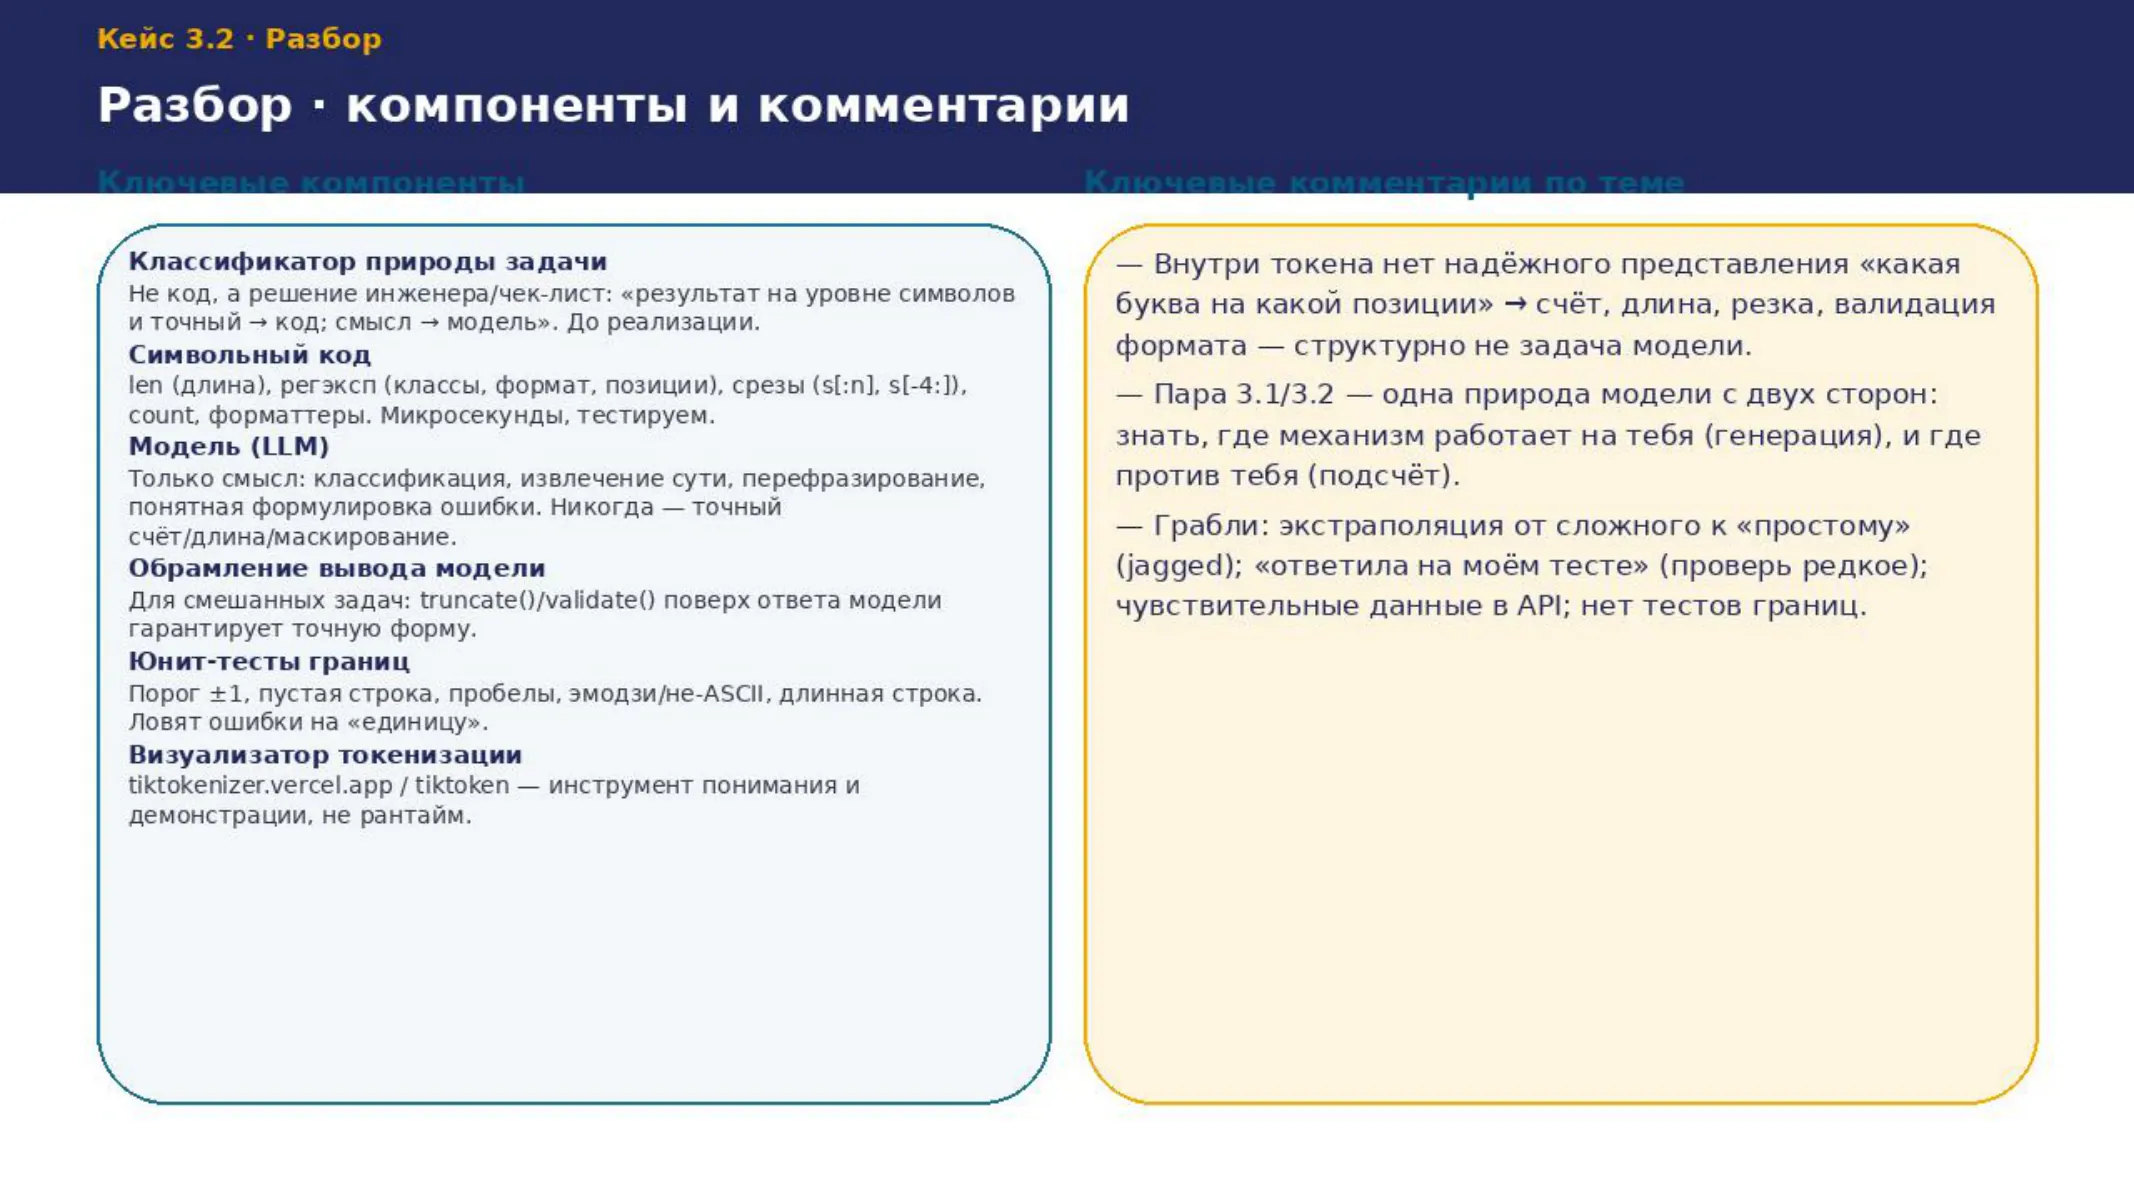
Разбор из разделов 6.2-6.4 файла-кейса. Что иллюстрирует кейс из механизма токенизации: модель работает с последовательностью токенов (чисел), а не с буквами; внутри токена нет надёжного представления «какая буква на какой позиции», поэтому подсчёт символов, контроль длины, посимвольная резка и валидация формата — операции, для которых у модели структурно нет нужного представления. Это не лечится дообучением или новой версией: причина — купленный компромисс токенизации ради экономики внимания. Центральный вывод: посимвольные и детерминированные операции — не задача модели, их делает код. Контраст с кейсом 3.1 (тот же механизм — разные ниши): в 3.1 задача — генерация, там модель на своём месте, работа с токенами её сильная сторона; здесь задача обратная — точный счёт и валидация, тот же токенный механизм делает модель непригодной. Пара 3.1/3.2 — одна природа модели с двух сторон: знать, где механизм работает на тебя (генерация) и где против тебя (подсчёт); умение сказать «здесь LLM не нужен» — навык, которому учит курс. Грабли: «модель умная, справится и с мелочью» (экстраполяция от сложного к простому — ловушка jagged intelligence, успех на SQL не предсказывает успех на подсчёте запятых); «ответила правильно на моём тесте» (проверь на редком невирусном примере); обрезка текста моделью до N символов («примерно N» = баг для жёсткого лимита); отправка чувствительных данных в API ради символьной операции (нарушение PCI DSS); экзотические строки на входе (риск glitch-токена — недообученной записи словаря, ~4% словаря, аномальное поведение); отсутствие тестов границ. Вероятный вопрос: «где в этих фичах уместна модель?» — только в смысловых надстройках: понятное объяснение почему пароль слабый, определение языка, классификация обращения по теме.
42 · Кейс 3.2
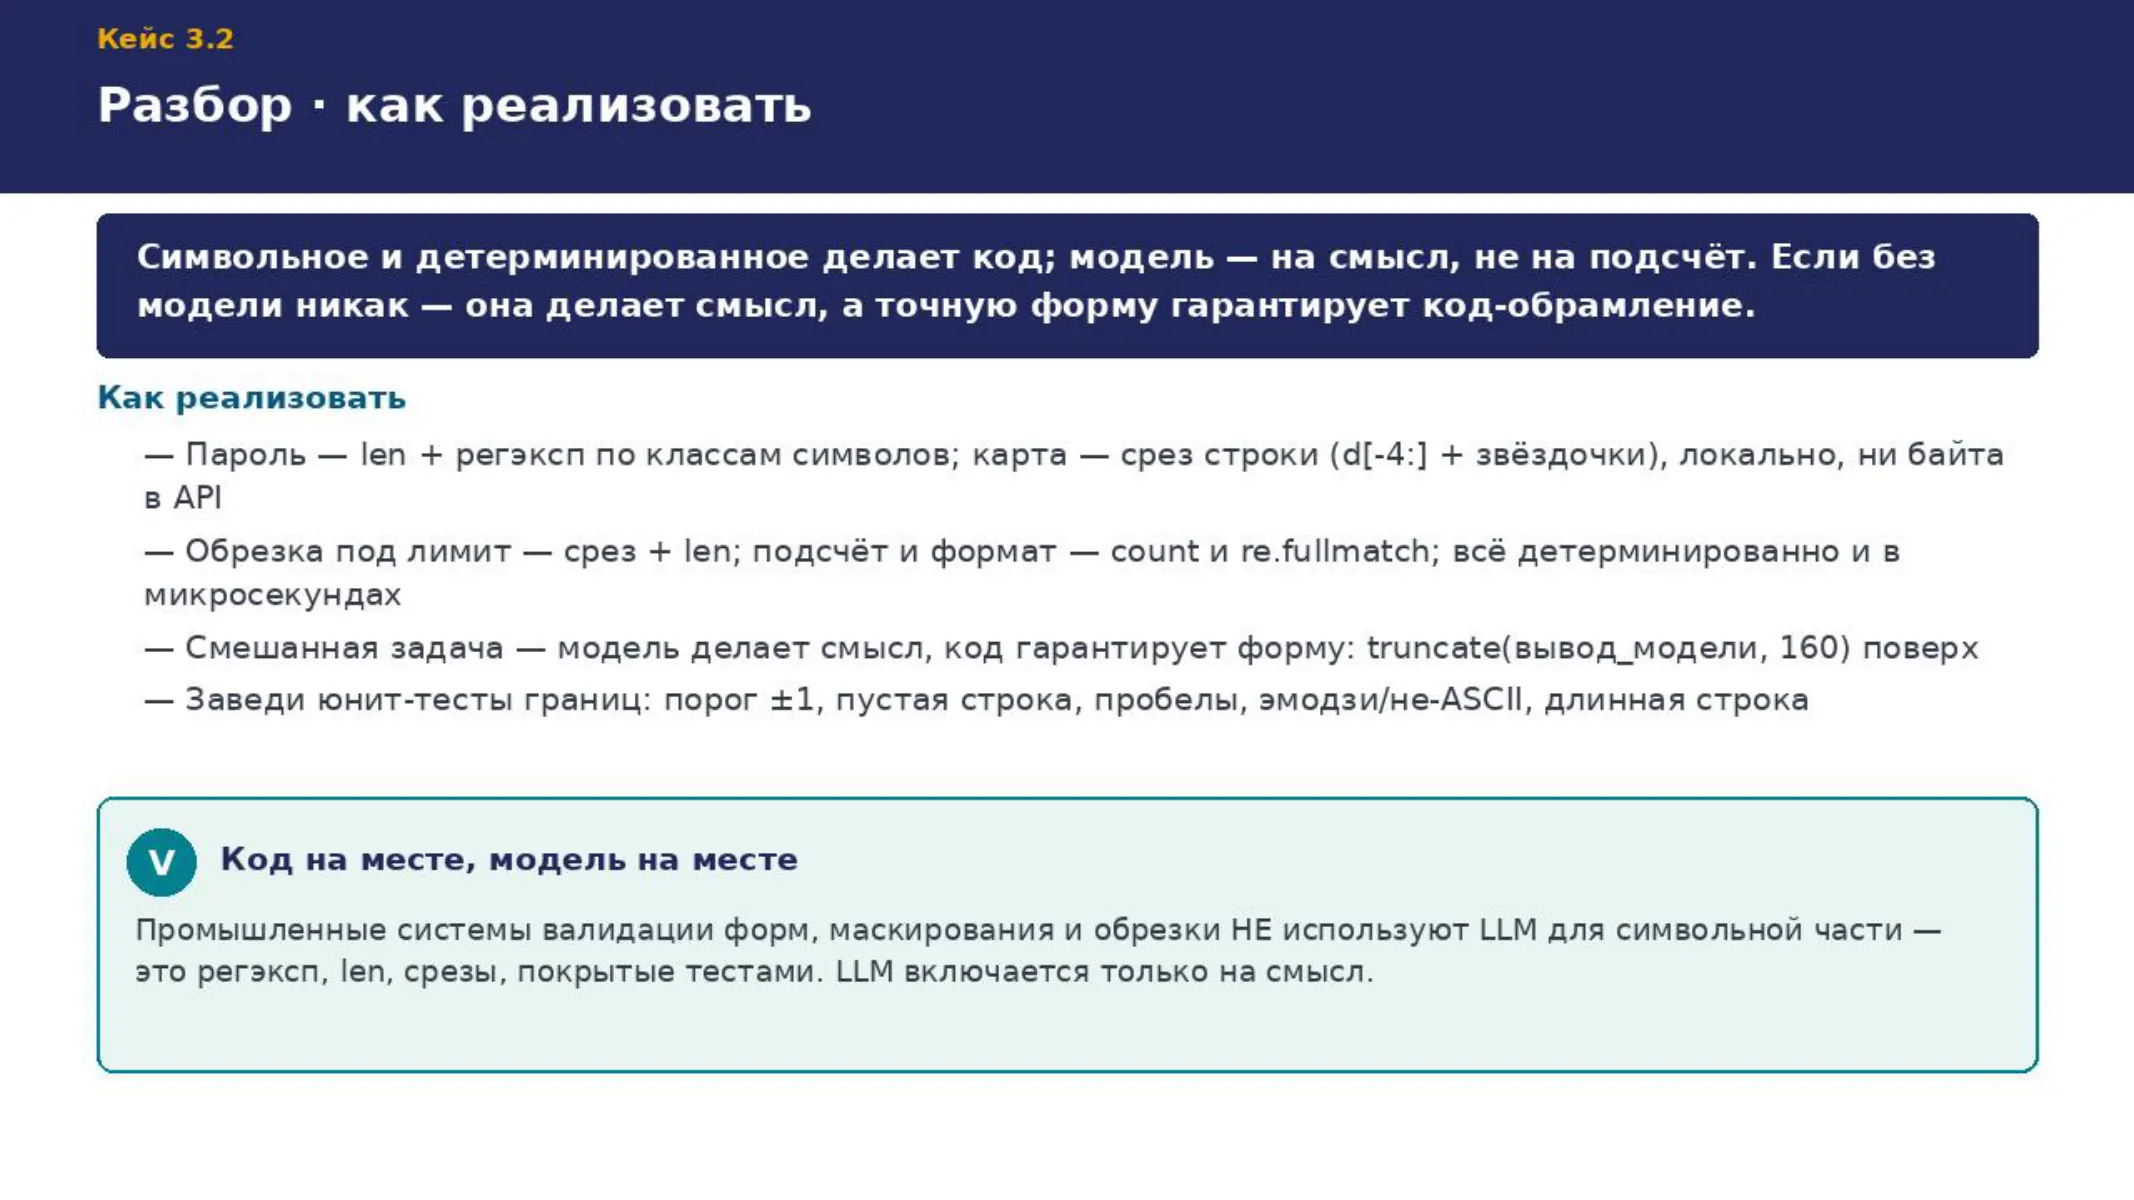
На карточке-примере вывод: «скучное» решение кодом — не «не используем ИИ», а инженерная зрелость, инструмент выбран по природе задачи. Пошаговый how-to из разбора и Q&A файла-кейса. Каждая из четырёх фич решается детерминированным кодом на уровне символов. Пароль: len(pw)<12 и re.search по классам (, \d, спецсимволы), (.)\1{3,} на повторы — len считает символы точно и мгновенно, результат воспроизводим. Карта: убрать не-цифры, срез d[-4:], остальное звёздочки, группировка по 4 — операция локальная, ни байта данных карты в чужой API (это и требование PCI DSS, и здравый смысл), гарантия проверяется тестом, а не «доверием модели». Обрезка: len(text)<=limit иначе срез с местом под многоточие, не рвать слово по последнему пробелу — len(result)<=limit гарантировано конструкцией и проверяется ассертом. Подсчёт/формат: str.count, re.fullmatch по шаблону {8} на артикул, re.finditer на позиции. Тонкость про длину в символах: в Python len считает кодовые точки Unicode — для эмодзи и составных символов используй графемную сегментацию (regex \X), но это тонкость КОДА, решается инструментами кода, а не передачей модели. Если задача смешана — модель делает смысловую часть, код гарантирует посимвольную поверх; модель никогда не последняя инстанция по символьному ограничению. Юнит-тесты границ (порог ±1, пусто, пробелы, эмодзи, длинная строка) ловят подавляющее большинство ошибок; модель на них «плавала» бы недетерминированно, провал даже не зафиксировать воспроизводимым тестом. Вероятный вопрос: «зачем код, если LLM умнее?» — «умнее» не по всем осям; забивать гвозди микроскопом.
43 · Что унести
- Эмбеддинги: выбор модели решает мини-eval на своих данных (recall@k/MRR), не место в бенчмарке; «похоже» ≠ «то же» → структурные ключи.
- Внимание: корреляция, не причинность → модель извлекает + обосновывает span, правила и человек проверяют критичное; качество двигает grounding, не роль.
- Сэмплинг и токенизация: температура задаёт разброс (не стиль, не истину), схема — форму (не истину); подсчёт символов — не ниша модели, его делает код.
Один принцип на все три: механизм — не «фича модели», а граница, которую инженер знает в обе стороны — использует силу и страхует слабость. Дальше — Лекция 3: как из этих механизмов собираются архитектуры (RAG, агент).