Лекция 1. Что такое AI? История, классификация, общие понятия
Лекция 1 · ~75 мин · 34 слайда
01 · Идентификация людей в реальном времени
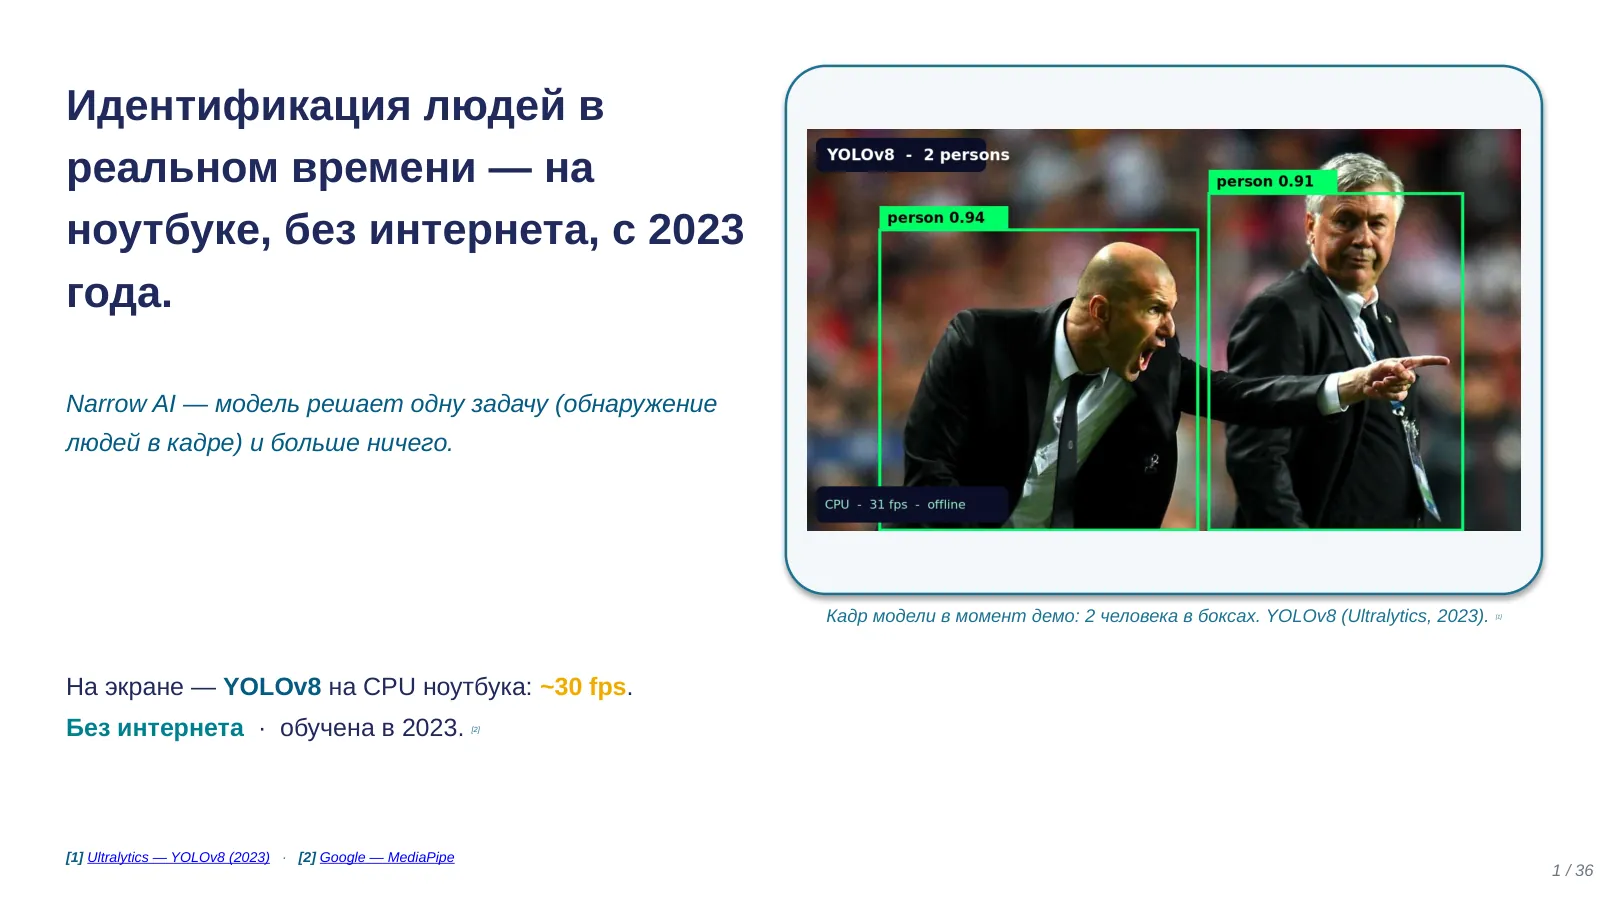
«Здравствуйте. Прежде чем я скажу хоть одно слово про AI— посмотрите на проектор.
То, что вы видите— это ноутбук. Обычный ноутбук. На нём запущена модель компьютерного зрения. Она обучена в две тысячи двадцать третьем году. Она видит вас впервые— никаких ваших фотографий в обучающей выборке нет. И она работает локально. Без интернета. Без облака. Без подписки. Без отправки данных кому бы то ни было.
Это и есть AI. Не магия, не угроза, не «будущее, которое наступит»— а инструмент, который работает прямо сейчас, на одном ноутбуке, в этой аудитории.
Это narrow AI— узкий AI. Модель решает одну задачу: найти людей в кадре. Больше ничего. Она не понимает, кто вы. Не знает ваших имён. Не делает выводов. Просто детекция объектов класса «человек».
Сегодня за семьдесят пять минут мы с вами пройдём по основным архетипам AI-инструментов. Не для того, чтобы вы запомнили названия— для другого. Чтобы научились отличать: где AI работает, где не работает, и как это понять заранее, до того как вложили в него три месяца разработки.»
Источники: [1] Ultralytics — YOLOv8 (2023) · [2] Google — MediaPipe
02 · Добро пожаловать
«Пара слов о курсе. Это курс «Отраслевое применение систем искусственного интеллекта»— про AI в реальных индустриях: от разработки ПО и финансов до авиакосмоса и медицины.
Курс не про обучение моделей с нуля. Он про то, как грамотно выбирать и внедрять готовые AI-решения. Сегодня— первая лекция, вводная.»
03 · Главный вопрос курса
«Вопрос «можно ли применить AI» уже неинтересен. Можно. Девятьсот миллионов человек пользуются ChatGPT каждую неделю. Это давно инфраструктура.
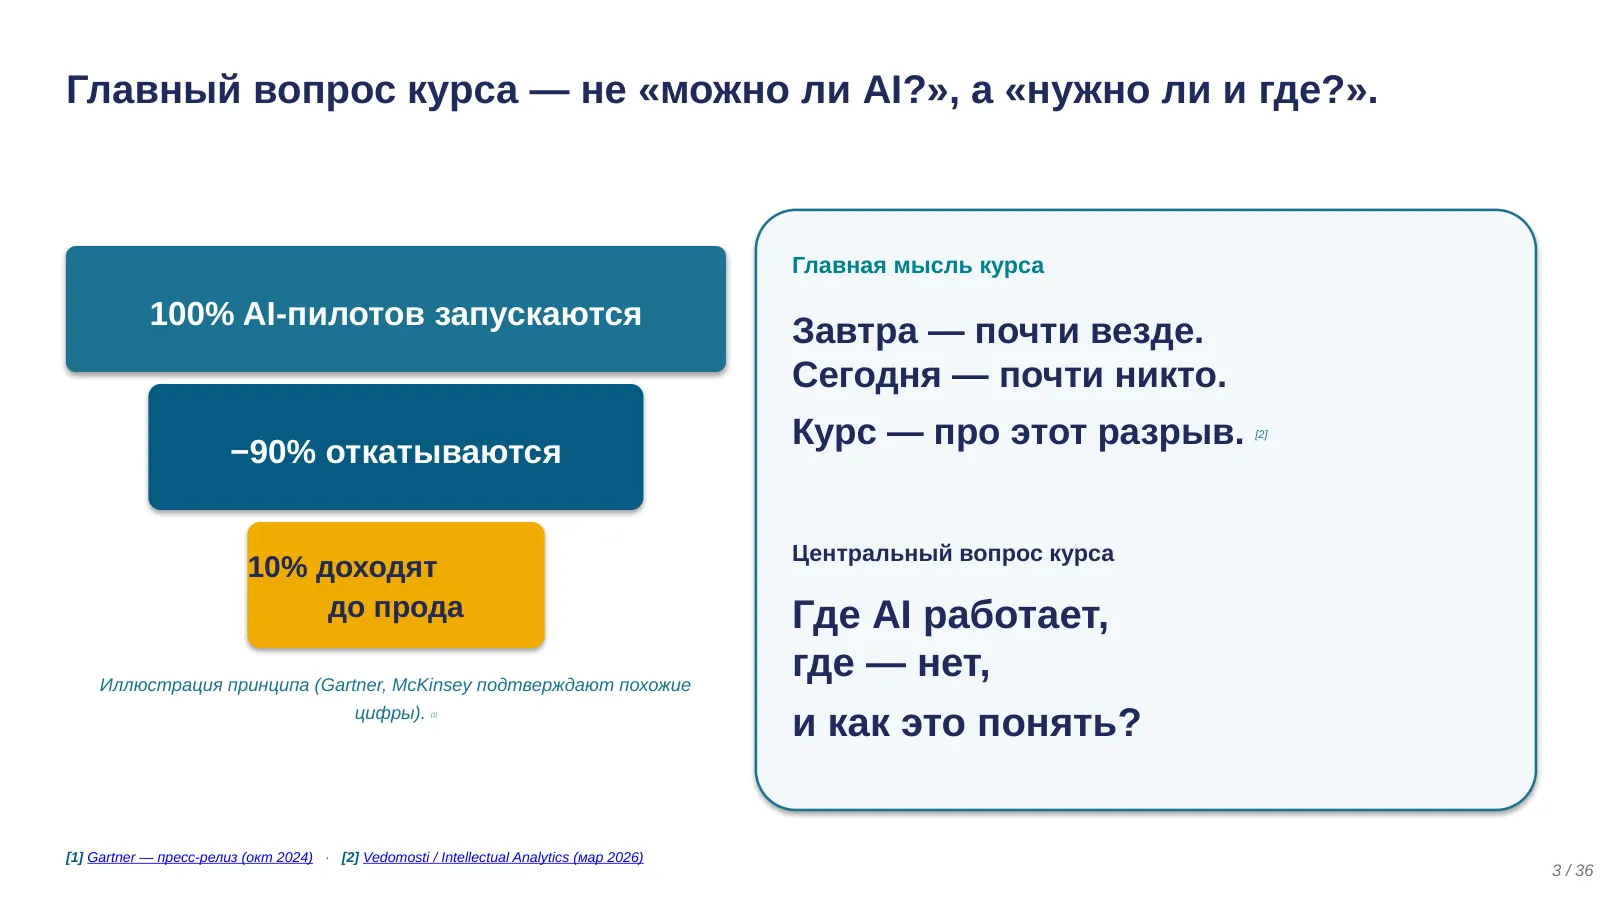
А вот вопрос «нужно ли и где»— открытый. Смотрите на воронку слева: около девяноста процентов корпоративных AI-пилотов в России не доходят до промышленного развёртывания. Похожие цифры— и на других рынках, по McKinsey и Gartner.
Массовое распространение и массовый провал одновременно— центральная инженерная задача курса. Поэтому главный вопрос звучит не «можно ли», а «где AI работает, где— нет, и как это понять заранее». Это диагностический вопрос, не триумфальный. К нему мы с вами будем возвращаться каждую лекцию курса.»
Источники: [1] Gartner — пресс-релиз (окт 2024) · [2] Vedomosti / Intellectual Analytics (мар 2026)
04 · Cover
«Лекция первая. Что такое AI? История, классификация, общие понятия.
Это первая из семнадцати лекций курса. Сегодня— общая карта. Дальше будем спускаться в детали.»
05 · План лекции
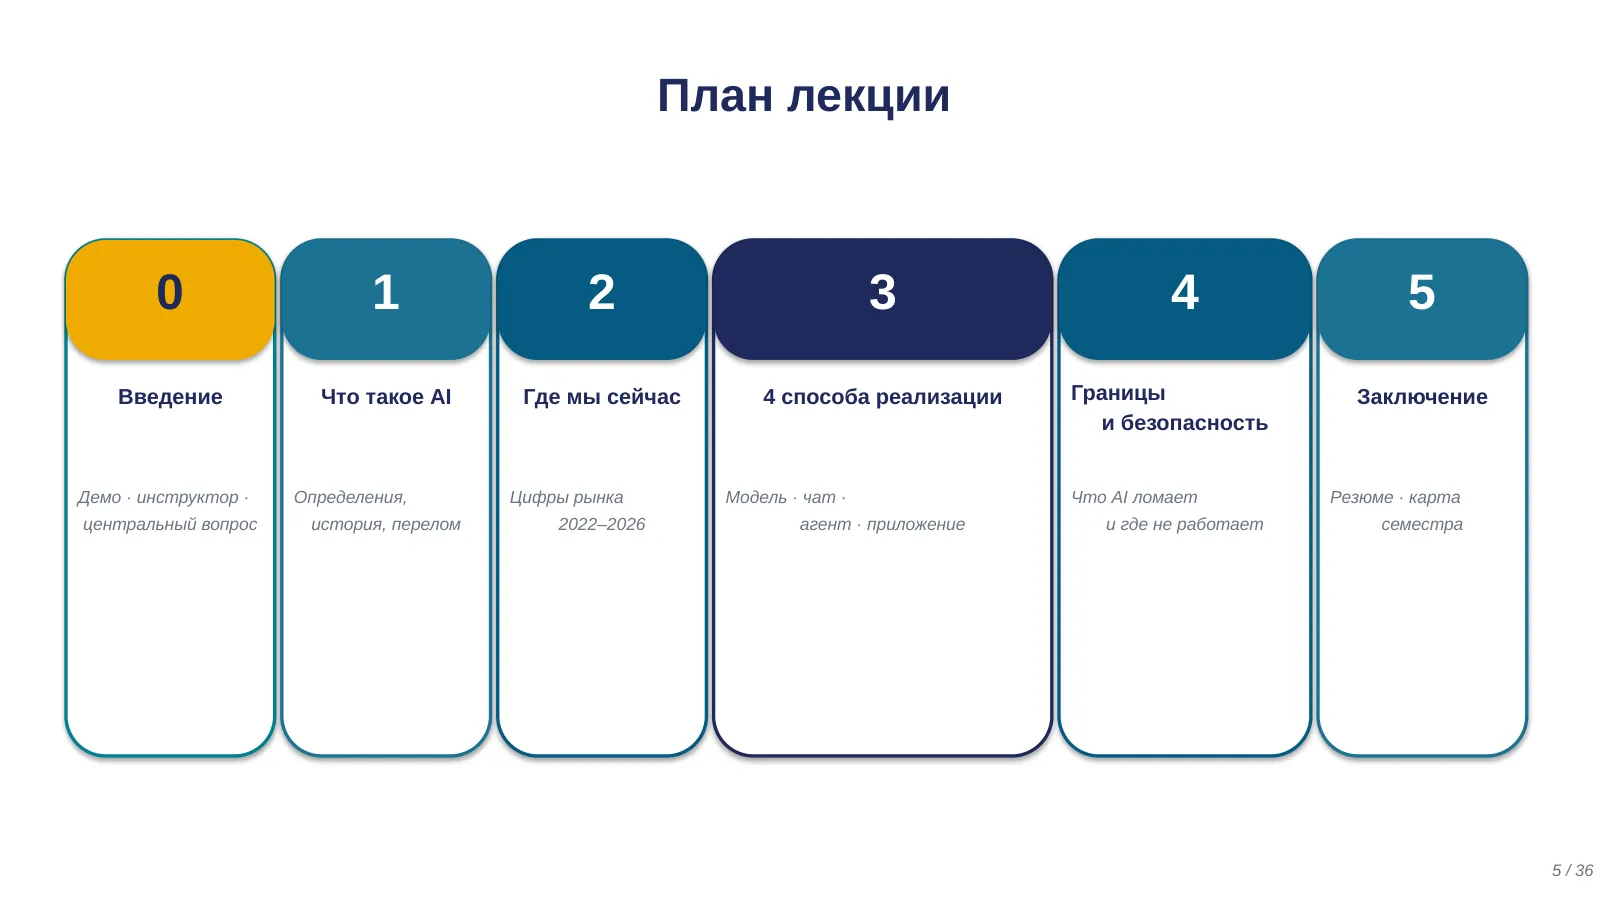
«Коротко— навигация. Пять разделов. Сейчас— введение. Дальше: что такое AI; где мы сейчас; четыре способа реализации— самый большой раздел; и границы AI.»
06 · Кто я и почему мне это важно
«Коротко о себе.
Я архитектор, технический и продуктовый лидер в ИТ— больше двадцати лет, больше десяти завершённых проектов.
Работал с Яндексом, МТС, Магнитом, Сибуром. Разные индустрии, и в каждой AI применялся по-своему. Поэтому меня интересует не разговор про «искусственный интеллект вообще», а инженерная граница: где AI экономит время, а где— демонстрация, разваливающаяся в продакшене.
Этот курс— карта, которой не было у меня в начале пути. Границам будет уделено столько же внимания, сколько успешным кейсам.
Вопросы вне лекции— контакты на слайде.»
07 · Раздел 1. Что такое AI
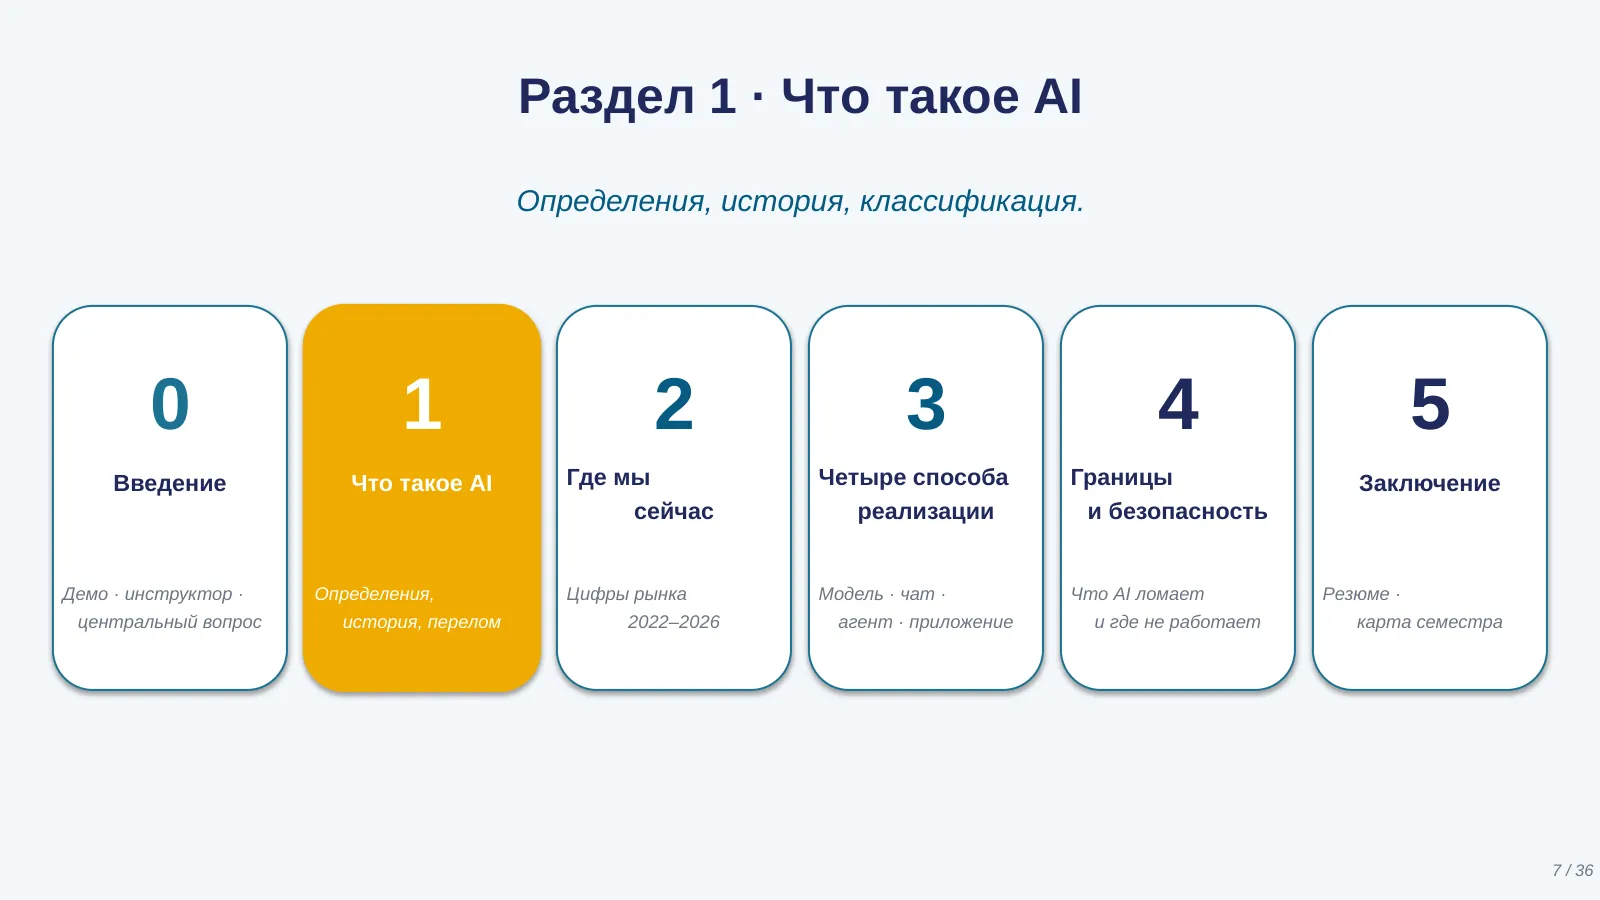
«Мы познакомились и обозначили главный вопрос курса. Это первый раздел из пяти— что такое AI.
Структура раздела короткая, но плотная: сначала— почему определений AI много, затем факт-мостик из тысяча девятьсот сорок третьего года, и в финале— сжатый семидесятилетний таймлайн с чёткой точкой перелома.»
08 · Что такое AI: почему определений много
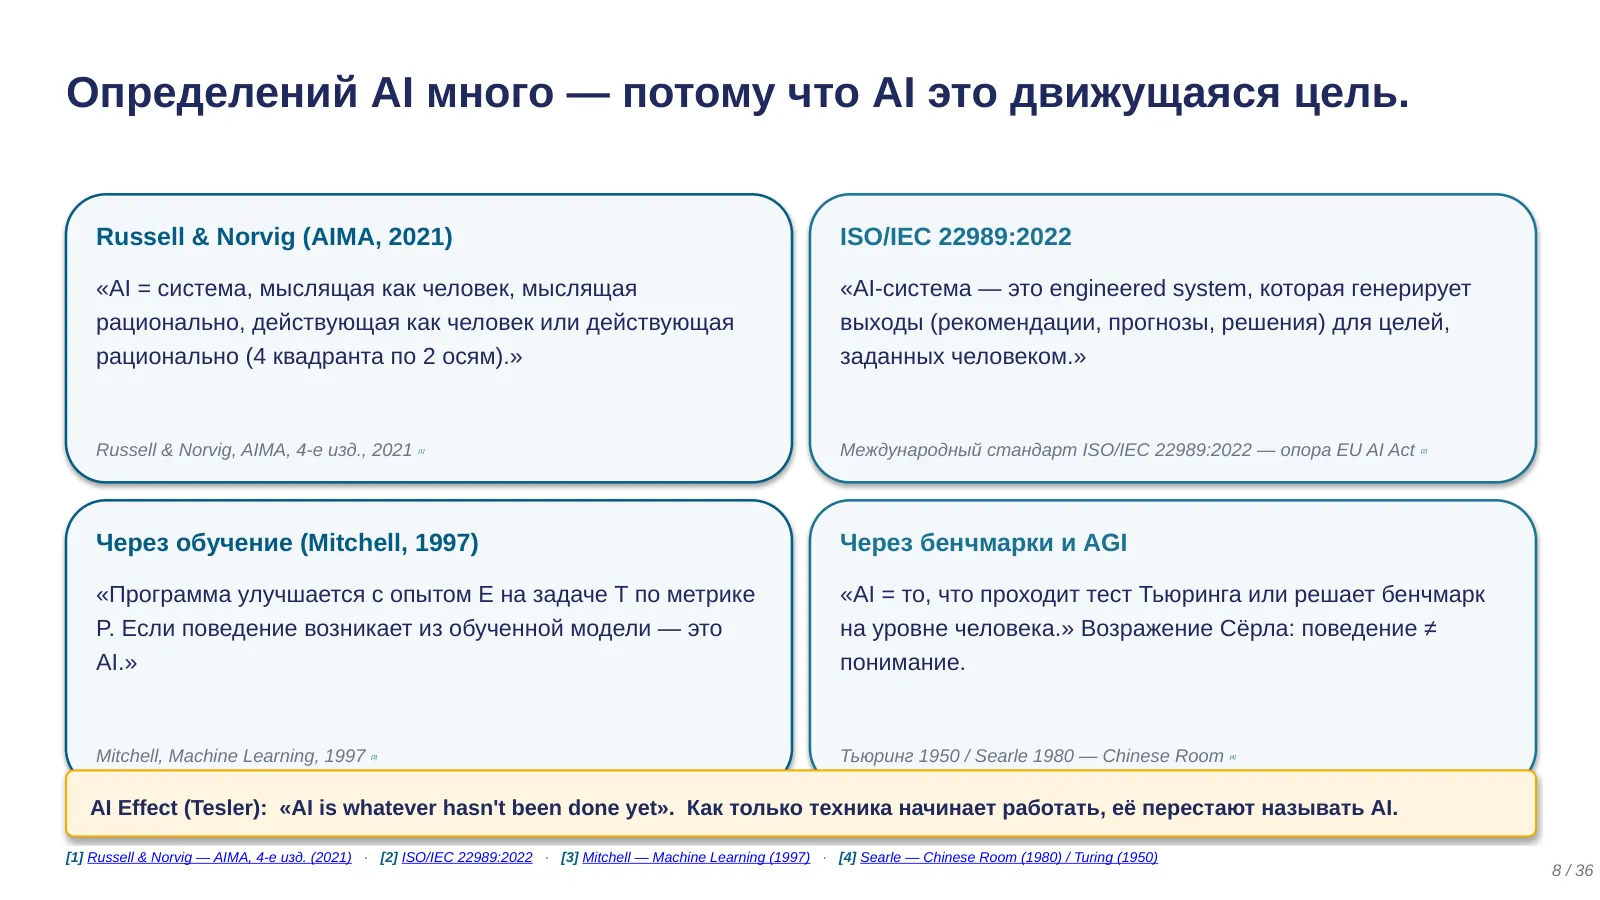
«Одного канонического определения у AI нет. Это отражение природы предмета: AI— движущаяся цель. Мы с вами держим в голове четыре подхода.
Russell и Norvig: четыре квадранта «думание / действие» × «человек / рациональность». Академическая рамка.
Стандарт ISO/IEC 22989: AI— система, генерирующая контент, прогнозы, рекомендации, решения для целей, заданных человеком. Им пользуются регуляторы.
Через обучение: программа улучшается за счёт опыта. Если поведение— набор правил, это не AI; если из обученной модели— AI.
Через бенчмарки: что-то умеет на уровне человека. Здесь живёт дискуссия про AGI и возражение Сёрла про китайскую комнату.
Главное— почему определение сдвигается. Larry Tesler: «AI is whatever hasn't been done yet». Распознавание лиц, навигация, спам-фильтр— в момент появления были AI, сейчас «функция приложения». Это AI Effect.
Не выбирайте один подход как правильный— все четыре рабочие.»
Источники: [1] Russell & Norvig — AIMA, 4-е изд. (2021) · [2] ISO/IEC 22989:2022 · [3] Mitchell — Machine Learning (1997) · [4] Searle — Chinese Room (1980) / Turing (1950)
09 · Предыстория: 1943
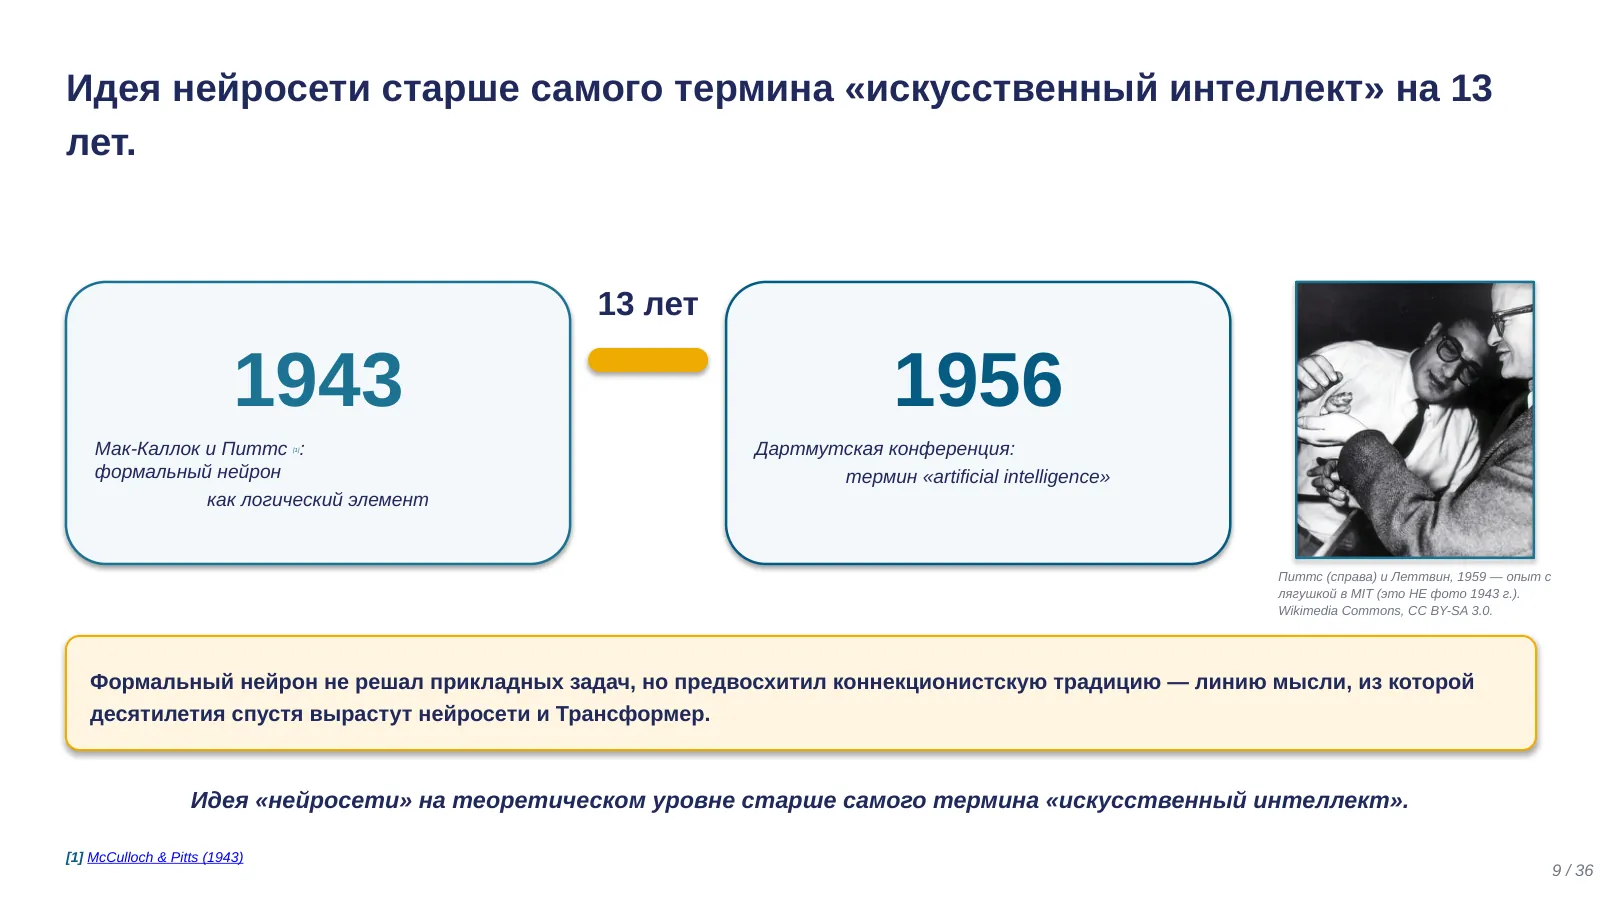
«Прежде чем идти по истории AI— один факт-мостик.
Ещё до появления термина «искусственный интеллект» нейрофизиолог Уоррен Мак-Каллок и логик Уолтер Питтс формализовали нейрон как логический элемент: сеть таких простых бинарных элементов теоретически может вычислить любую логическую функцию. Статья вышла в тысяча девятьсот сорок третьем году.
Это на тринадцать лет раньше Дартмутской конференции пятьдесят шестого, где термин «artificial intelligence» появится впервые.
Формальный нейрон не решал прикладных задач, но предвосхитил коннекционистскую традицию— линию мысли, из которой вырастут нейросети и архитектуры вроде Трансформера.
Держите в голове: идея нейросети старше термина «искусственный интеллект». Дальше— история с пятьдесят шестого.»
Источники: [1] McCulloch & Pitts (1943)
10 · Семьдесят лет AI: открытия, зимы, точка перелома 2017
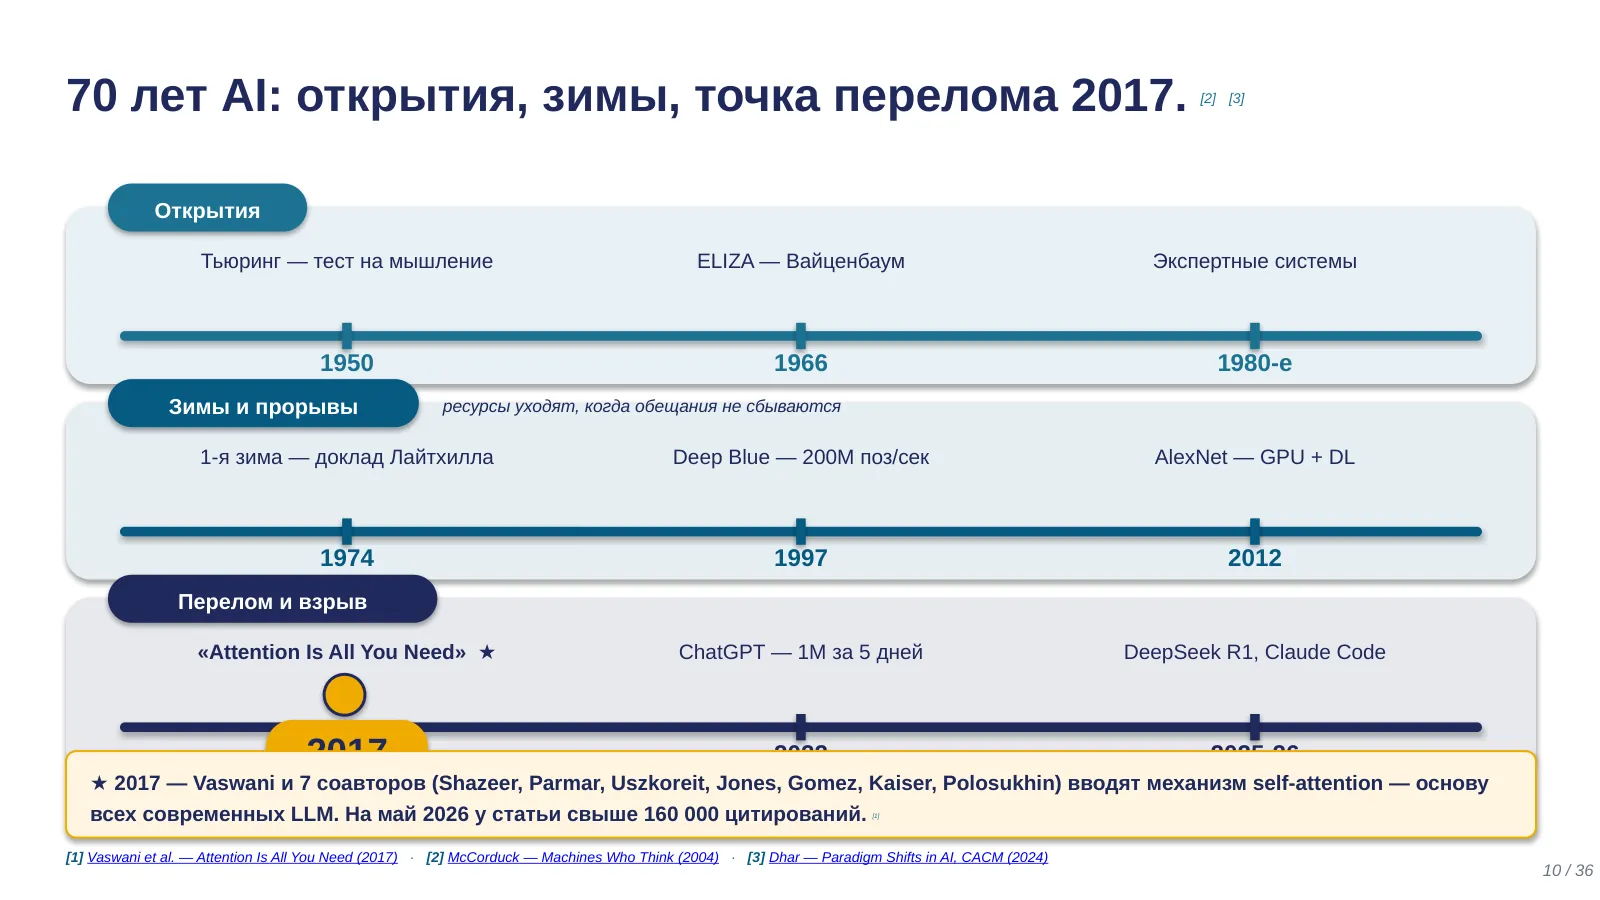
«Сжатый таймлайн в трёх группах— семьдесят лет, считая с пятьдесят шестого, когда появился сам термин.
Открытия и первая практика, пятидесятые— восьмидесятые. Пятидесятый— Тьюринг публикует «Imitation Game». Пятьдесят шестой— Дартмутская конференция, McCarthy, Minsky, Rochester и Shannon вводят термин «artificial intelligence». Шестьдесят шестой— Weizenbaum создаёт ELIZA, программу-психотерапевта: пользователи приписывают ей понимание, которого там нет— «эффект ELIZA». Восьмидесятые— коммерческий бум экспертных систем: XCON, MYCIN, Dendral; Япония запускает «Пятое поколение».
Две зимы и прорывы, семьдесят четвёртый— две тысячи двенадцатый. Семьдесят четвёртый— восьмидесятый— первая зима AI: после доклада Lighthill и сокращения DARPA поле теряет деньги. Восемьдесят седьмой— девяносто третий— вторая зима: рынок AI-машин рушится, экспертные системы оказываются хрупкими. Девяносто седьмой— IBM Deep Blue побеждает Каспарова: двести миллионов позиций в секунду перебором. Две тысячи двенадцатый— AlexNet выигрывает ImageNet с резким отрывом: глубокие свёрточные сети на GPU бьют ручные признаки.
Обратите внимание на подпись под этой панелью: ресурсы уходят, когда обещания не сбываются. Именно так работали обе зимы— не из-за отсутствия идей, а из-за разрыва между обещанным и реально работающим. Урок: когда обещания массово не сбываются, поле теряет ресурсы. Сегодняшняя волна— четвёртая, пока избегает зимы, потому что часть обещаний сбывается. Но не все сбудутся. Различайте работающее сейчас и обещанное на две тысячи тридцатый.
Точка перелома, две тысячи семнадцатый— двадцать шестой. Отсюда выросло всё, чем мы пользуемся сегодня.
В июне семнадцатого года восемь авторов из Google Brain и Google Research публикуют «Attention Is All You Need»: Vaswani, Shazeer, Parmar, Uszkoreit, Jones, Gomez, Kaiser, Polosukhin.
До семнадцатого года основной архитектурой для последовательностей были рекуррентные сети— RNN и LSTM: токены обрабатываются по очереди, плохо параллелятся на GPU, плохо помнят длинный контекст. Vaswani и соавторы предложили механизм self-attention и архитектуру Трансформер без рекуррентности вообще— он заменил RNN и LSTM как основной строительный блок.
На май двадцать шестого у статьи— больше ста шестидесяти тысяч цитирований по Google Scholar. Влиятельная работа за жизнь набирает тысячи; сто шестьдесят тысяч за восемь лет— редкость даже для нобелевской.
Почему именно семнадцатый стал точкой перелома. Совпали три свойства: параллельная обучаемость на больших корпусах; хорошее масштабирование— больше данных и параметров, выше качество, нелинейно (scaling laws); и универсальность— одна конструкция работает с текстом, изображениями, аудио, биологическими последовательностями.
К двадцатому году появился GPT-3, к двадцать второму— ChatGPT. Все современные большие модели— потомки одной статьи семнадцатого года.
Механику Трансформера разберём позже, когда будем смотреть на устройство современных больших моделей.»
Источники: [1] Vaswani et al. — Attention Is All You Need (2017) · [2] McCorduck — Machines Who Think (2004) · [3] Dhar — Paradigm Shifts in AI, CACM (2024)
11 · Раздел 2. Где мы сейчас
«Раздел два из пяти. Разобрались, что такое AI. Дальше— где он сейчас, в двадцать шестом году.
Сначала— масштаб в цифрах, затем— прорывы от команд, которые не были очевидными фаворитами. Раздел короткий, но задаёт масштаб: AI одновременно везде и почти нигде не доведён до конца.»
12 · AI стал инфраструктурой за 3 года
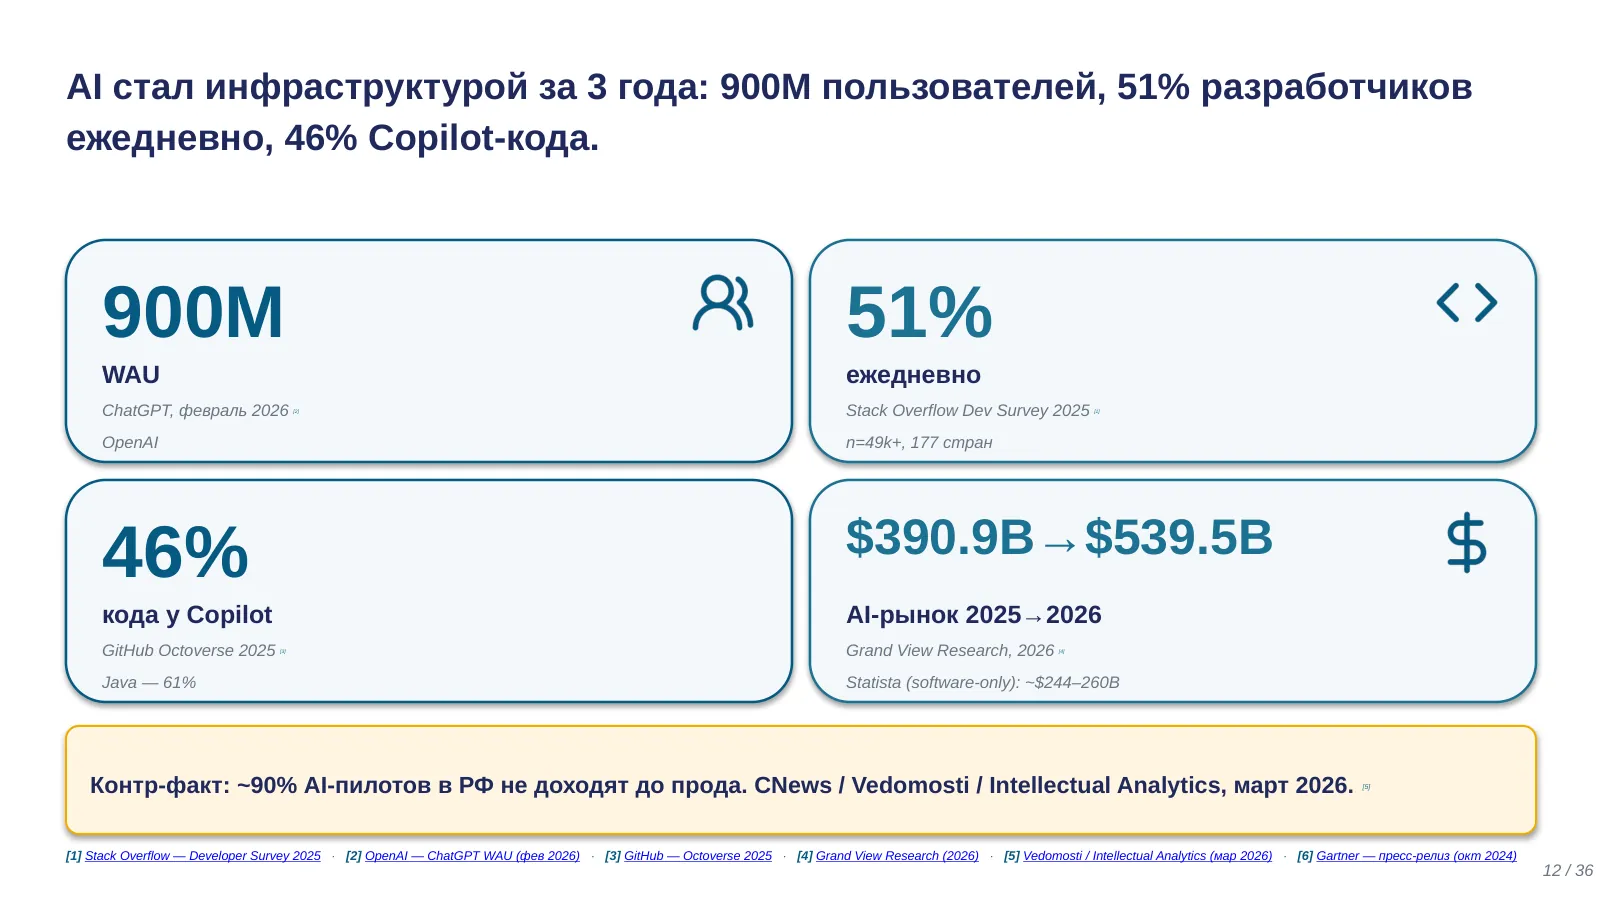
«За три года AI стал инфраструктурным слоем. Несколько показательных цифр.
ChatGPT— около девятисот миллионов еженедельно активных пользователей на февраль двадцать шестого. Именно еженедельно, не ежемесячно— за месяц выше.
Stack Overflow Developer Survey двадцать пятого, сорок девять тысяч разработчиков из ста семидесяти семи стран— восемьдесят четыре процента используют или планируют использовать AI; пятьдесят один процент обращаются к AI ежедневно.
GitHub Copilot— у регулярных пользователей AI пишет до сорока шести процентов строк кода, для Java— шестьдесят один.
Объём AI-рынка. По Grand View Research двадцать шестого года— триста девяносто целых девять десятых миллиарда долларов в двадцать пятом, с прогнозом роста до пятисот тридцати девяти с половиной миллиардов в двадцать шестом. По узкому software-only Statista— ниже, около двухсот сорока четырёх— двухсот шестидесяти миллиардов. Разброс— от того, что считать AI-рынком: модели, инфраструктура, встроенный AI, интеграция. Сравниваете цифры рынка AI— сначала сравните методологии.
Обратная сторона. По сводке CNews, Vedomosti, Intellectual Analytics, март двадцать шестого— около девяноста процентов AI-пилотов в России не доходят до промышленного развёртывания. Тридцать-сорок процентов закрываются без эффекта, только семь-десять— в эксплуатации.
Деталь про доверие. По Stack Overflow— сорок шесть процентов разработчиков не доверяют точности AI-кода против тридцати одного годом ранее. Кажется противоречием: использование растёт, доверие падает? На самом деле обе цифры согласованы— общий тренд это рост проникновения, а оценка точности критичнее, потому что разработчики научились видеть, где AI ошибается. Это не «доверие падает», а «доверие становится более нюансированным». К галлюцинациям вернёмся в четвёртом разделе.
Контекст лекции. AI— уже инфраструктура с массовым внедрением и массовым же провалом. Разница между этими картинами— место, где работает инженерное мышление, и где мы с вами проводим следующие шестьдесят минут.»
Источники: [1] Stack Overflow — Developer Survey 2025 · [2] OpenAI — ChatGPT WAU (фев 2026) · [3] GitHub — Octoverse 2025 · [4] Grand View Research (2026) · [5] Vedomosti / Intellectual Analytics (мар 2026) · [6] Gartner — пресс-релиз (окт 2024)
13 · Пространство открыто: четыре прорыва 2023–2026
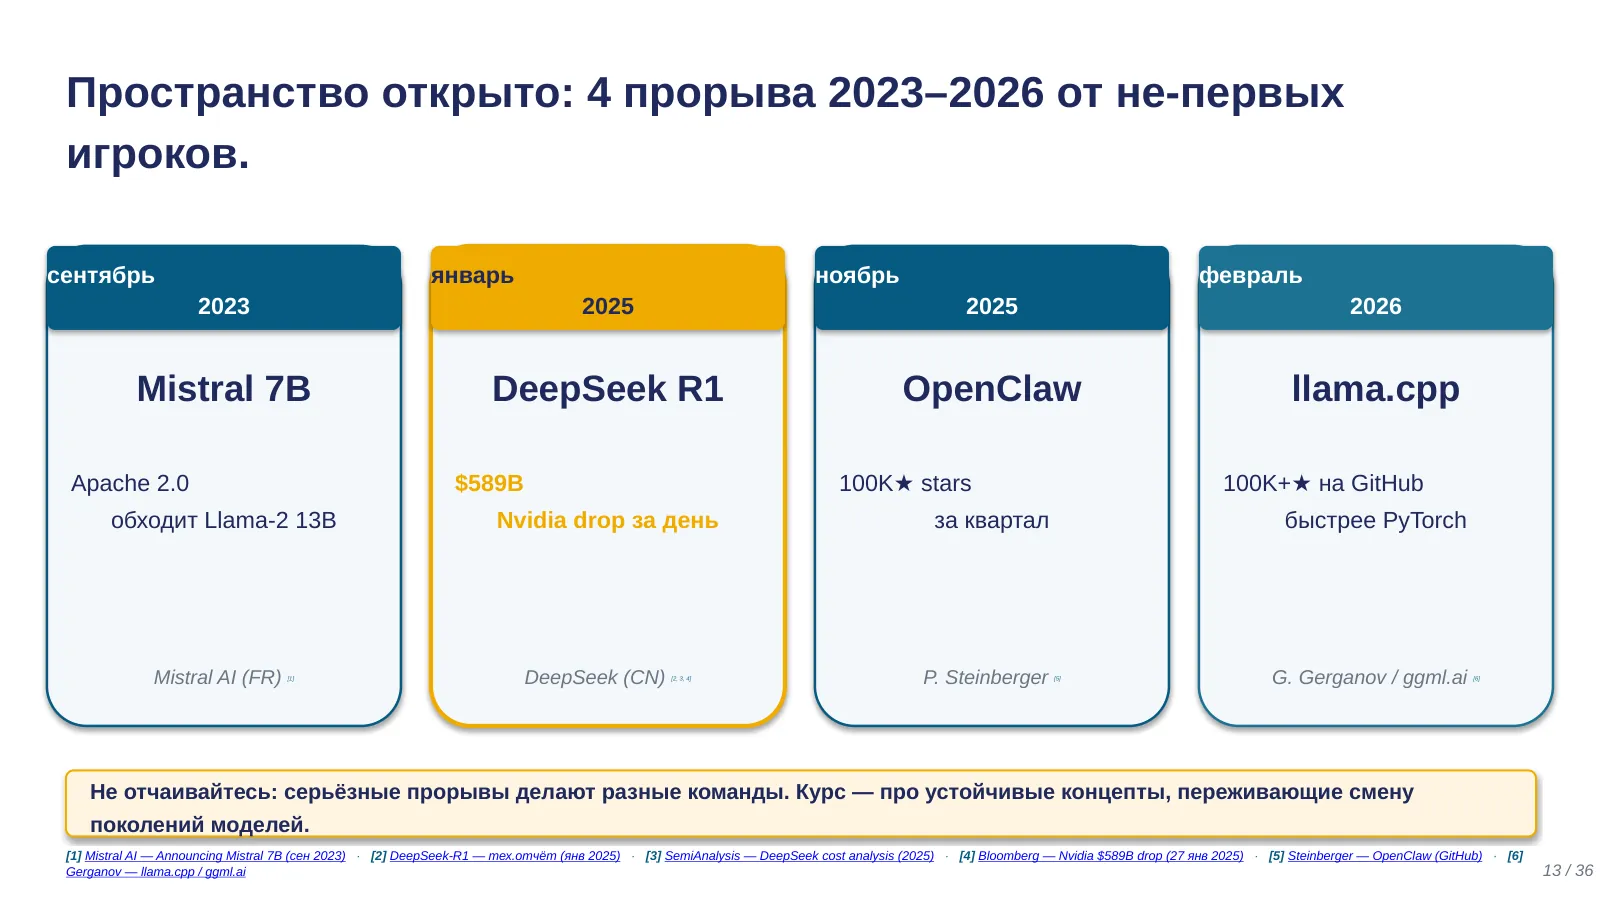
«Глядя на цифры с прошлого слайда, легко решить— «всё уже сделано, лидируют крупнейшие игроки». Это впечатление обманчиво. За три года— четыре громких эпизода. Каждый показывает: пространство открыто.
Сентябрь двадцать третьего, Mistral 7B. Небольшая французская лаборатория, основанная в начале того же года выходцами из Meta и Google DeepMind, выпускает модель под Apache 2.0. Mistral 7B обходит Llama-2 13B— почти вдвое большую модель. Урок: небольшая команда может выпустить модель уровня крупных игроков за считанные месяцы.
Январь двадцать пятого, DeepSeek-R1. Малоизвестная китайская лаборатория публикует открытую reasoning-модель уровня OpenAI o1. Финальный тренировочный прогон V3— около пяти миллионов шестисот тысяч долларов; полная инфраструктура— на порядки больше, это разные числа. Двадцать седьмого января Nvidia потеряла за один день пятьсот восемьдесят девять миллиардов долларов— крупнейшая однодневная потеря капитализации в истории.
Ноябрь двадцать пятого, OpenClaw. Питер Стейнбергер в одиночку запускает автономного AI-агента с открытым кодом. К началу двадцать шестого— больше ста тысяч звёзд на GitHub за квартал. Четырнадцатого февраля Стейнбергер уходит в OpenAI, проект— в non-profit foundation. Урок: один человек с правильным концептом может выпустить агент, меняющий рынок за недели.
История Георгия Герганова, llama.cpp и ggml.ai. Соло-проект вырос в маленькую команду. Двадцатого февраля она, вместо венчурного финансирования, присоединилась к Hugging Face за поддержку— сохранив автономию.
В марте llama.cpp пересёк сто тысяч звёзд на GitHub— быстрее, чем PyTorch или TensorFlow.
Урок здесь другой. Не «один человек выпустил продукт», а один человек построил инфраструктурный слой, на котором держится вся открытая экосистема— фундамент, позволяющий запускать большие модели на обычном ноутбуке.
Параллельно развиваются и российские инструменты: YandexGPT, GigaChat, T-Bank Talisman, Шедеврум. Подробнее— в лекциях про AI в разработке ПО, финансы и креативные индустрии.
«Пространство открыто» для нас с вами. Курс сосредоточен на устойчивых концептах— они переживают смену поколений моделей.»
Источники: [1] Mistral AI — Announcing Mistral 7B (сен 2023) · [2] DeepSeek-R1 — тех.отчёт (янв 2025) · [3] SemiAnalysis — DeepSeek cost analysis (2025) · [4] Bloomberg — Nvidia $589B drop (27 янв 2025) · [5] Steinberger — OpenClaw (GitHub)
14 · Раздел 3. Четыре способа реализации
«Раздел три из пяти. Мы с вами в самом большом разделе сегодняшней лекции, двадцать три минуты. Четыре способа реализации систем с AI: модель, чат, агент, приложение. И главное— простой инструмент выбора между ними.»
15 · Способы реализации с AI: не альтернативы, а слои
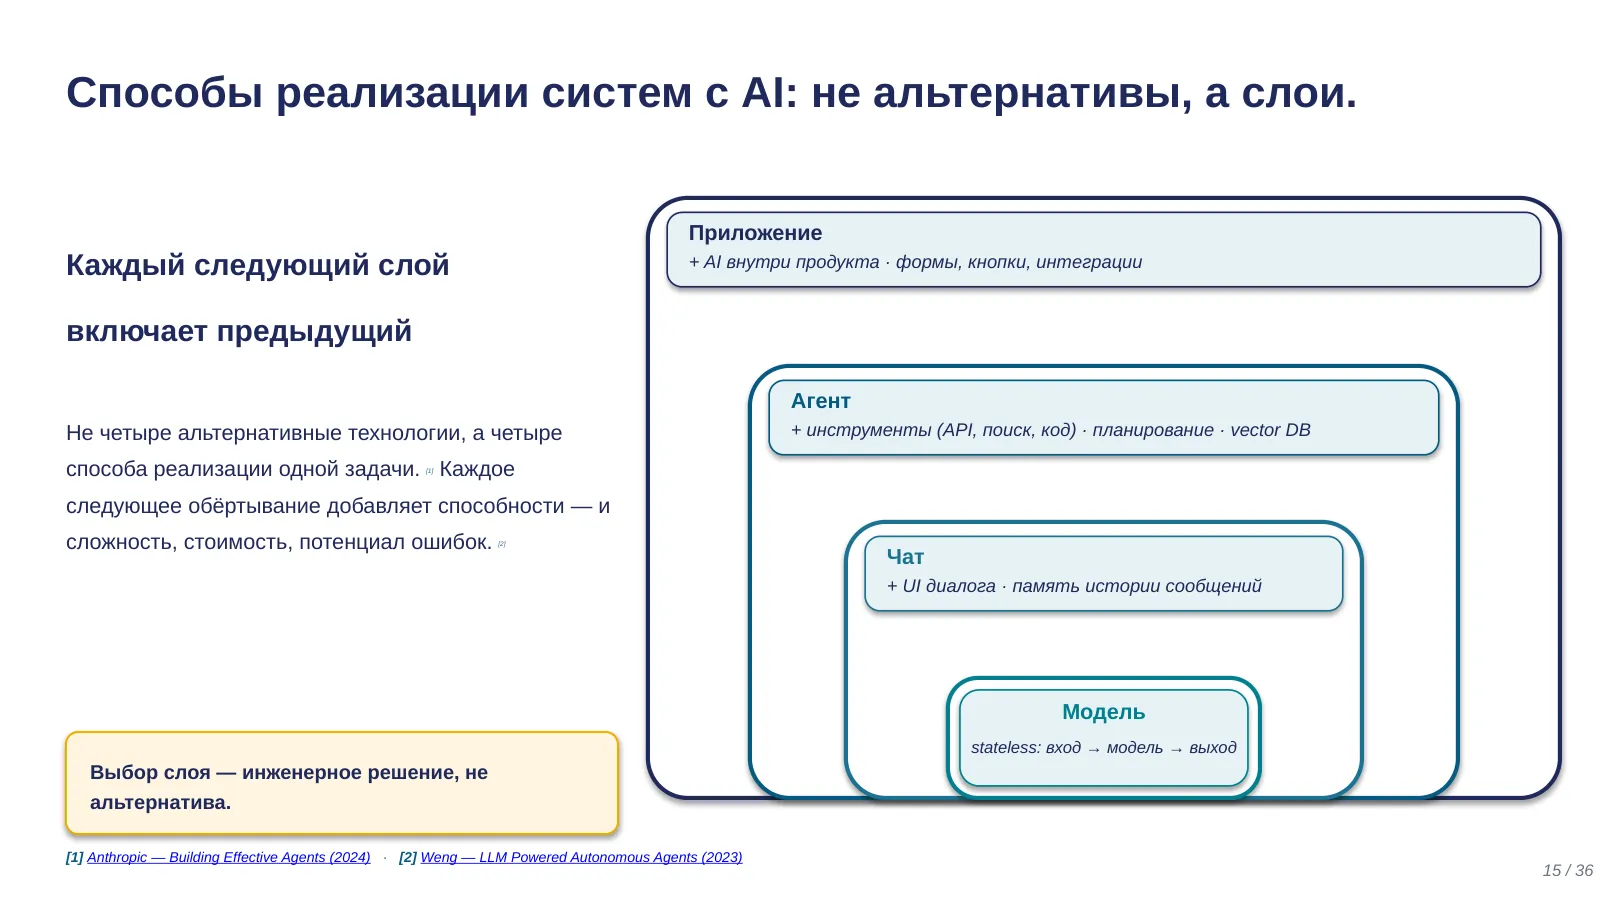
«Ключевая идея раздела. Это не четыре альтернативы. Это четыре способа реализации одной задачи со слоистой структурой. Каждый следующий уровень включает предыдущий.
Модель— stateless-инференс на одной задаче. На вход данные, на выход предсказание. Без интерфейса, без памяти, без инструментов.
Чат— модель плюс интерфейс плюс память диалога.
Агент— чат плюс инструменты плюс планирование. Возможность вызывать API, читать файлы, выполнять код, и логика выбора инструмента на каждом шаге.
Приложение— агент или чат плюс продуктовый интерфейс. Снаружи обычный продукт; AI работает внутри как один из компонентов.
Не выбирайте «между» уровнями, как будто это альтернативы. Каждое следующее обёртывание добавляет способности— и одновременно сложность, стоимость, потенциал ошибок. К этой слоистой модели мы с вами будем возвращаться весь курс.»
Источники: [1] Anthropic — Building Effective Agents (2024) · [2] Weng — LLM Powered Autonomous Agents (2023)
16 · Классификация: задача × модальность
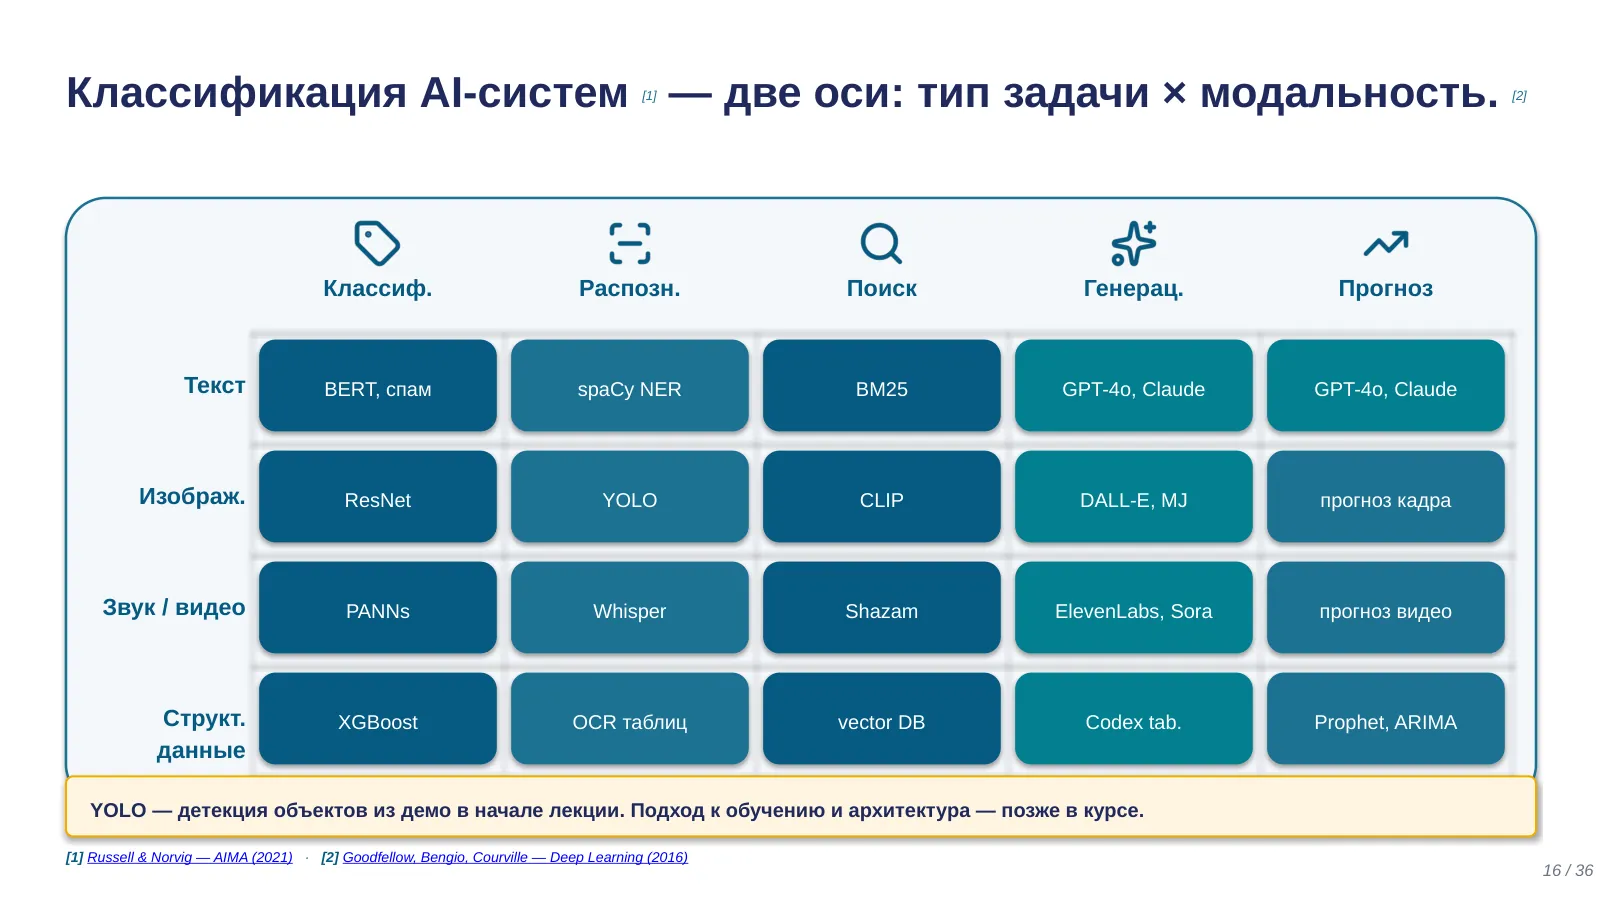
«Чтобы говорить про конкретные AI-инструменты одним языком— две оси.
Ось X— тип задачи. Что система производит. Пять типов: классификация, распознавание, поиск, генерация, прогноз.
Ось Y— модальность. С каким типом данных. Текст, изображение, звук-видео, структурированные данные.
Этих двух осей достаточно для нашего курса. Техническая глубина— архитектура нейросети— позже, на лекции про устройство больших моделей.
Одна ячейка стоит внимания— прогноз на тексте, там GPT-4o и Claude. На первый взгляд странно: разве не генерация? По сути— то же явление. Языковая модель генерирует текст, предсказывая следующий токен,— та же семантика, что и в «Генерации».
Калибровка. Google Translate— генерация на «тексте». AlphaFold— прогноз структуры белка на «структурированных данных». YOLO, наше демо в начале— распознавание на «изображении».
При обсуждении каждого типа реализации мы с вами будем спрашивать: какая задача и какая модальность. Это предотвращает смешение разных по природе систем под общим ярлыком «AI».»
Источники: [1] Russell & Norvig — AIMA (2021) · [2] Goodfellow, Bengio, Courville — Deep Learning (2016)
17 · Одна задача, три способа: квадрант контроля
«Чтобы слоистая модель не была теорией, прогоним её на одной задаче через три способа решения.
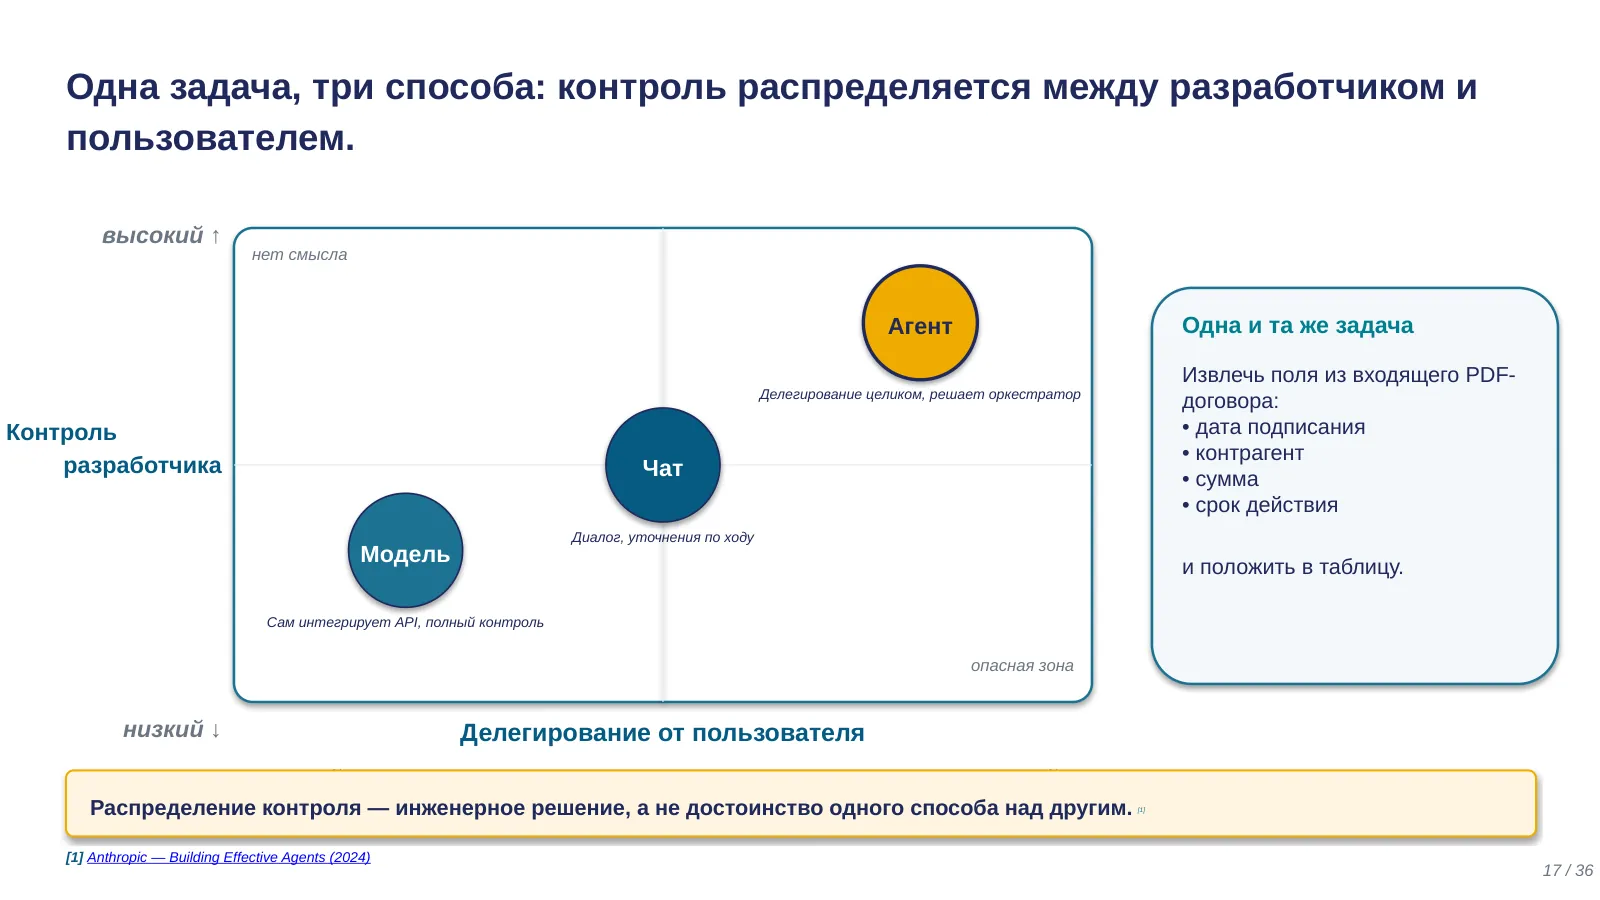
Задача: извлечь поля из входящего PDF-договора и положить в таблицу. Дата подписания, контрагент, сумма, срок действия. Пять-шесть полей. Знакомая инженерная задача.
Оси квадранта. По горизонтали— делегирование от пользователя: насколько пользователь передаёт AI решение задачи целиком. По вертикали— контроль разработчика: насколько жёсткий каркас он строит вокруг AI. Чем больше пользователь делегирует, тем больше нужен каркас.
Поэтому три способа лягут на диагонали.
Способ первый— модель. Берём специализированную модель извлечения структурированных полей, например, DocVQA. Пользователь сам интегрирует API: передаёт PDF, получает JSON, кладёт в таблицу. Делегирование низкое— пользователь контролирует каждый шаг. Контроль разработчика тоже низкий— модель это сырая точка доступа без оркестратора. Левый-нижний угол— подпись «сам интегрирует API, полный контроль».
Способ второй— чат. Открываем Claude или ChatGPT в браузере, перетаскиваем PDF в чат, пишем: «извлеки следующие поля». Получаем результат, копируем в таблицу. Делегирование среднее— пользователь сам пишет промпт, читает ответ, проверяет. Контроль разработчика тоже средний— есть системный промпт провайдера, базовые ограничения. Центр квадранта— подпись «диалог, уточнения по ходу».
Способ третий— агент. Открываем Claude Code в терминале: «Возьми все PDF из этой папки, извлеки поля и собери таблицу». Агент сам решает, какой инструмент использовать, в каком порядке открывать файлы, как обрабатывать ошибки парсинга. Делегирование пользователя высокое— сказал «сделай», ушёл, получил результат. Контроль разработчика тоже высокий— агент работает в рамках оркестратора с правилами разрешения инструментов и логикой возврата ошибок. Правый-верхний угол— подпись «делегирование целиком, оркестратор решает».
Обратите внимание на два пустых угла. Левый верхний— «нет смысла»: зачем строить оркестратор, если пользователь и так решает сам. Правый нижний— «опасная зона»: пользователь отдал задачу AI, а рамок разработчик не предусмотрел.
Все три способа решают одну задачу. Разница не в качестве, а в распределении контроля— инженерное решение, которое мы с вами принимаем на старте проекта. Чем больше делегируем— тем жёстче нужен каркас.
Дальше мы с вами разберём подробнее каждый из четырёх типов: модель, чат, агент, приложение.»
Источники: [1] Anthropic — Building Effective Agents (2024)
18 · Модель: вход → препроцессинг → модель → постпроцессинг → выход
«Начнём с нижнего слоя— модели, и дальше мы с вами будем подниматься наверх, слой за слоем.
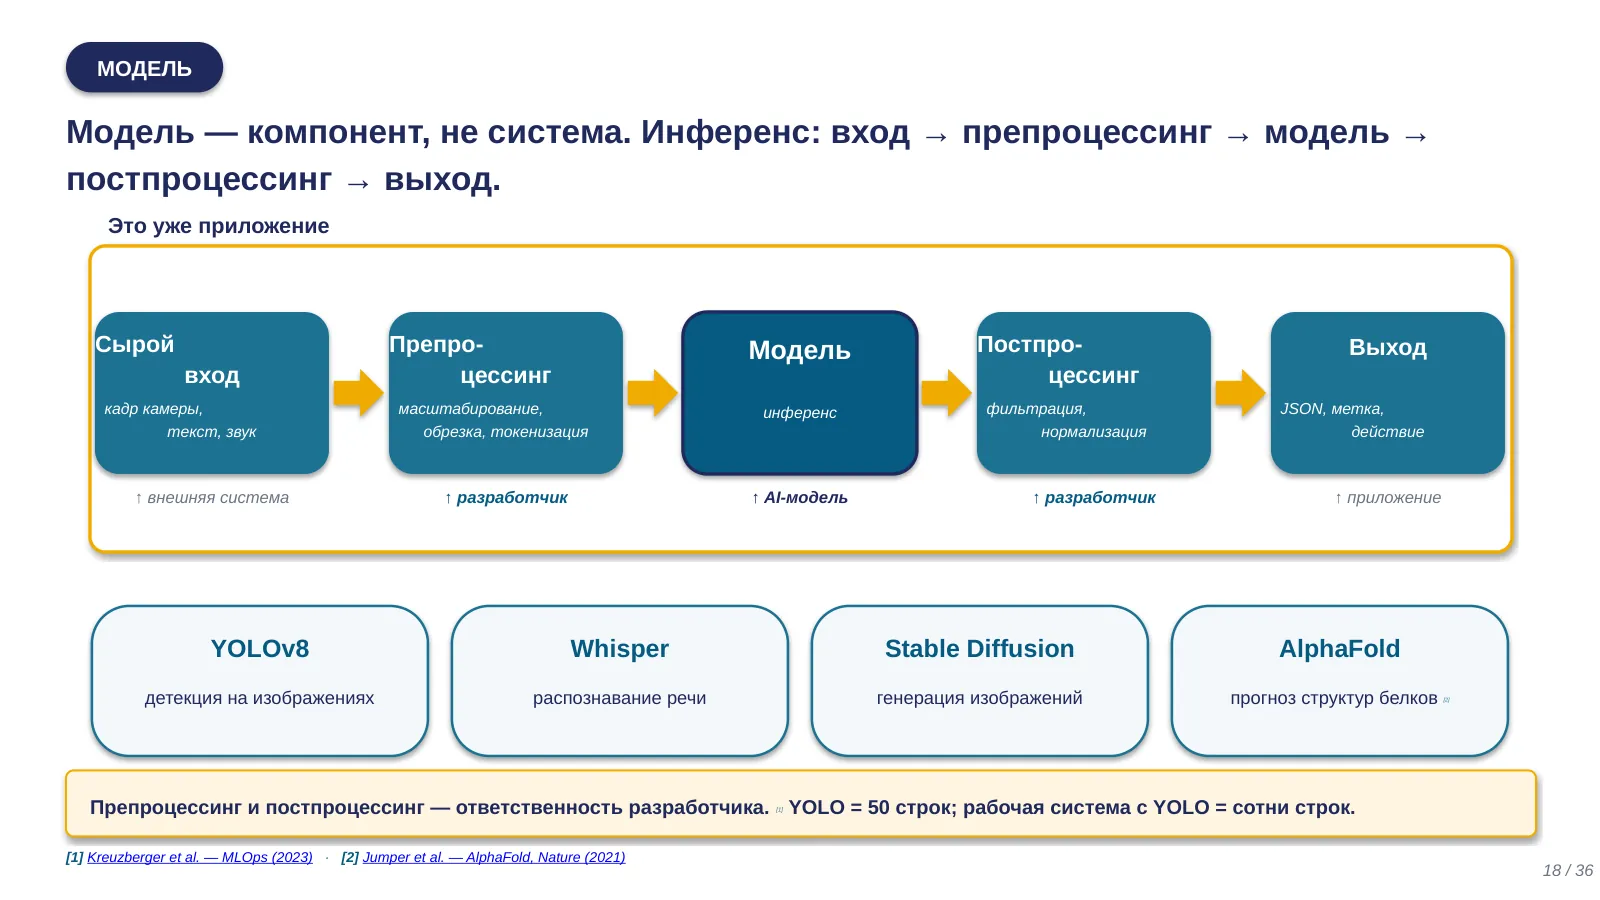
Модель— обученная нейросеть, которая принимает вход и возвращает выход. Без состояния между вызовами, без инструментов, без диалога. С точки зрения интеграции— самый простой компонент: вызов модели это функция.
Важная деталь: модель— это не система, а компонент. В промышленной эксплуатации вокруг неё всегда обвязка. Пять блоков по горизонтали.
Сырой вход— кадр с камеры, текст, аудиосигнал. Препроцессинг— ресайз, нормализация, токенизация. Модель— сам вывод предсказания. Постпроцессинг— фильтрация, форматирование, например отсечение лишних рамок или нормировка вероятностей. Выход— действие, JSON, метка класса.
Обратите внимание— весь этот пятиблочный конвейер обведён общей рамкой с подписью «Это уже приложение». Это не случайность визуала: сама по себе модель— только один блок внутри целого. За препроцессинг и постпроцессинг отвечает разработчик системы, не сама модель. Это критично для оценки бюджета. YOLO-детектор сам по себе— пятьдесят строк кода. Но рабочая система— сотни строк: считывание видеопотока, ресайз, нормализация, NMS, упаковка для MES-системы завода. Оценка по объёму работы модели— заниженная в десятки раз.
Канонические модели. YOLO— детекция объектов, наше демо. Whisper— распознавание речи. Stable Diffusion и SDXL— генерация изображений из текста. AlphaFold— предсказание структуры белка; Хассабис и Джампер получили Нобелевскую премию по химии двадцать четвёртого года.
Когда модель правильный выбор: высокая нагрузка (видеопоток тридцать кадров в секунду— невозможно для чат-интерфейса), стабильная форма входа и выхода, требование детерминированности, edge-развёртывание без интернета.
Когда неправильный: разовый запрос; задача, требующая диалога; задача, которую нельзя свести к одному типу выхода. Дальше— чат.»
Источники: [1] Kreuzberger et al. — MLOps (2023) · [2] Jumper et al. — AlphaFold, Nature (2021)
19 · Как работает чат: цикл диалога
«Снимем магию с чата. На каждой итерации диалога происходит компактный цикл.
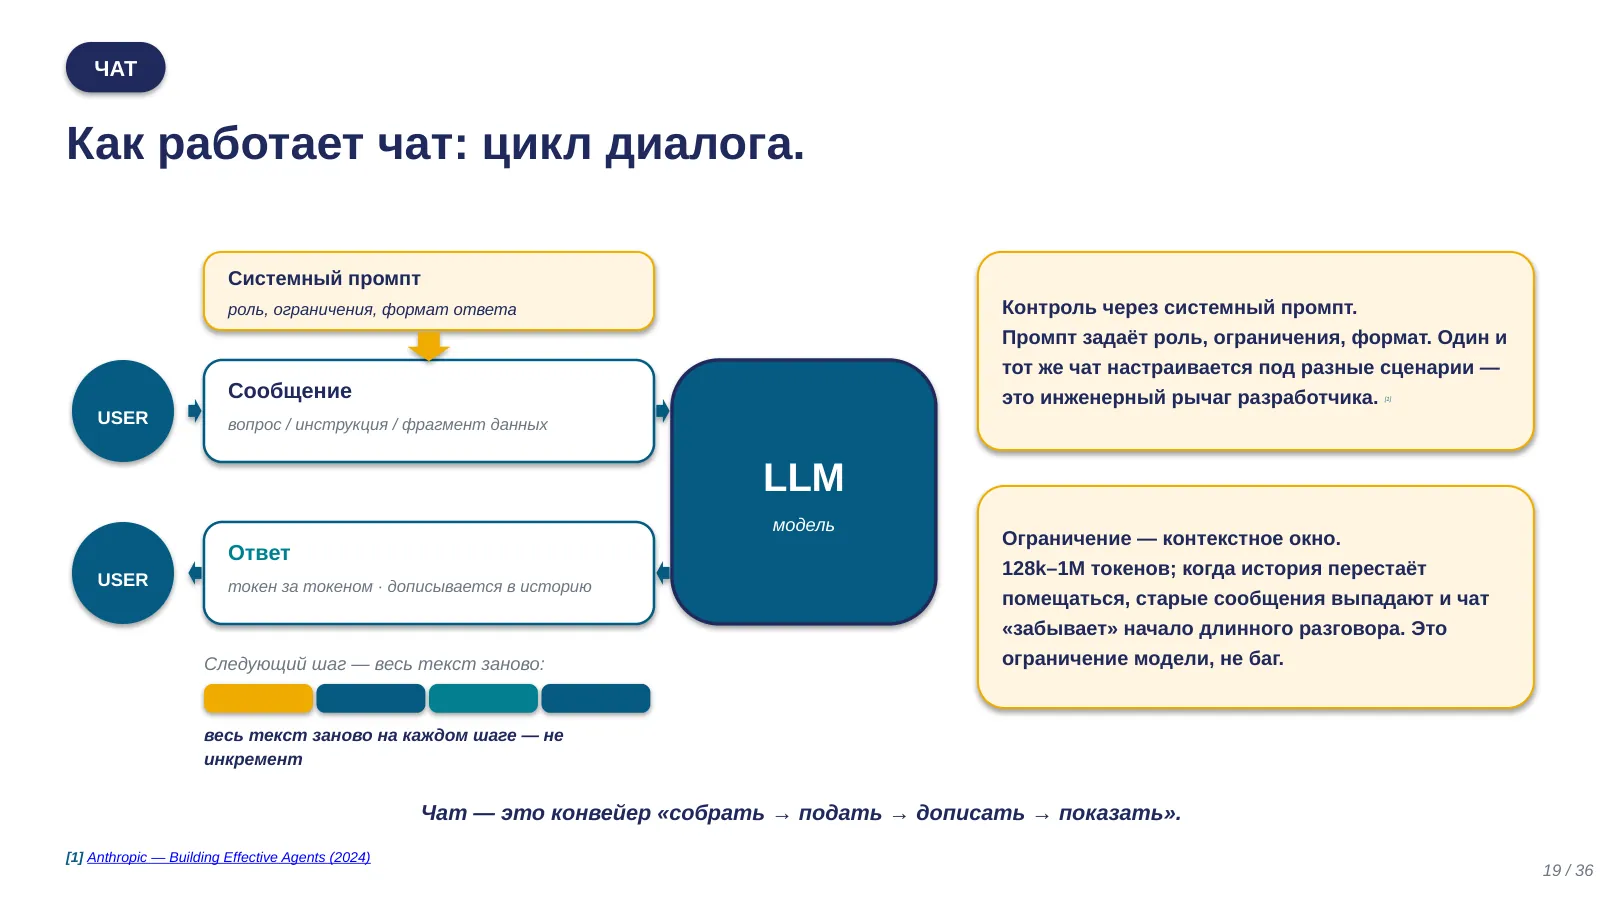
Слева— пользователь в двух ролях. Сверху отправитель, снизу получатель.
Шаг один. Пользователь пишет сообщение.
Шаг два. Над сообщением присоединяется системный промпт— заранее заданные разработчиком инструкции: «Ты корпоративный ассистент. Отвечай на русском». Плюс вся история чата с начала сессии. Этот объединённый блок— полный вход для модели.
Шаг три. Весь пакет передаётся в LLM как один большой текст. Модель не «помнит» прошлый разговор— каждый раз получает его заново.
Шаг четыре. Модель генерирует ответ токен за токеном; ответ дописывается в историю и показывается пользователю.
Шаг пять. Смотрите на растущий блок под ответом— история накапливается, и на следующем шаге модель снова получит весь текст целиком, не приращение.
Два важных следствия— две заметки справа.
Первое— системный промпт это инженерный рычаг. Пользователь его не видит, но именно он определяет «характер» чата: тон, роль, ограничения, форматы. Это инструмент инженера задавать рамки.
Второе— ограничение контекстного окна. GPT-4o около ста двадцати восьми тысяч токенов, Claude до двухсот тысяч, Gemini до миллиона. Много, но не бесконечно. Когда история не помещается, старые сообщения выпадают— чат «забывает» детали.
Чат— это конвейер «собрать → подать → дописать → показать».»
Источники: [1] Anthropic — Building Effective Agents (2024)
20 · Чат: модель + интерфейс + память диалога
«Чат— модель, обёрнутая в текстовый интерфейс с памятью диалога в пределах сессии. Канонические продукты: ChatGPT, Claude, Gemini, DeepSeek Chat, GigaChat, YandexGPT, Mistral Le Chat. Различия в качестве, в длине контекстного окна, в стоимости— паттерн один.
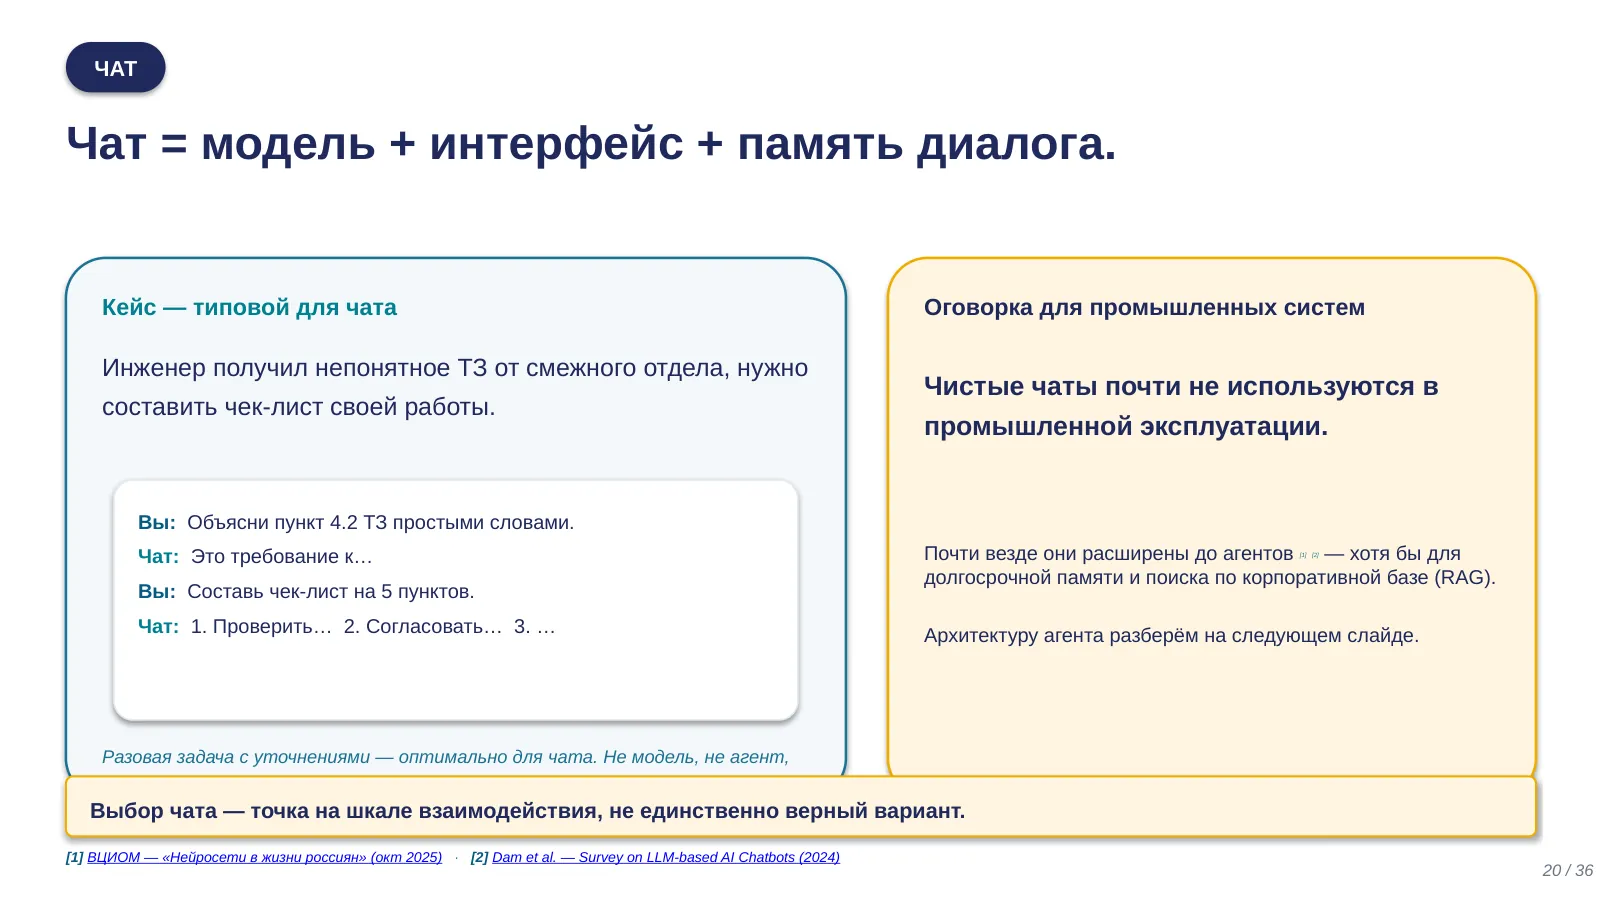
Кейс. Инженер получает непонятный нормативный документ с массой ссылок на стандарты. Задача— разобраться и составить чек-лист. Типовой случай для чата: разовая задача, требующая диалога— «что значит этот пункт», «дай пример», «составь чек-лист». Не нужна модель, не нужен агент, нет специализированного приложения.
С чатами связана главная причина провала AI-проектов. Большая часть откатившихся пилотов пыталась чатом решать задачи, для которых нужны были модель, агент или приложение. Чат удобен и доступен— поэтому часто выбирается как универсальный. И это часто неверное решение.
Важная оговорка про практику. Чистые чаты— модель плюс интерфейс плюс короткая память— в промышленной эксплуатации почти не встречаются. Везде чат уже расширен до агента: для долговременной памяти и поиска по корпоративной базе через RAG, retrieval-augmented generation. Граница «чат vs агент» на этой стороне размыта. «Чат без агента»— это интерфейс ChatGPT, Claude.ai, потребительские сервисы. Архитектуру агента разберём на следующем слайде.
Промпт. Минимальная формула: промпт = роль + задача + контекст. Подробно— позже в курсе.»
Источники: [1] ВЦИОМ — «Нейросети в жизни россиян» (окт 2025) · [2] Dam et al. — Survey on LLM-based AI Chatbots (2024)
21 · Архитектура агента: план, действие, наблюдение, рефлексия
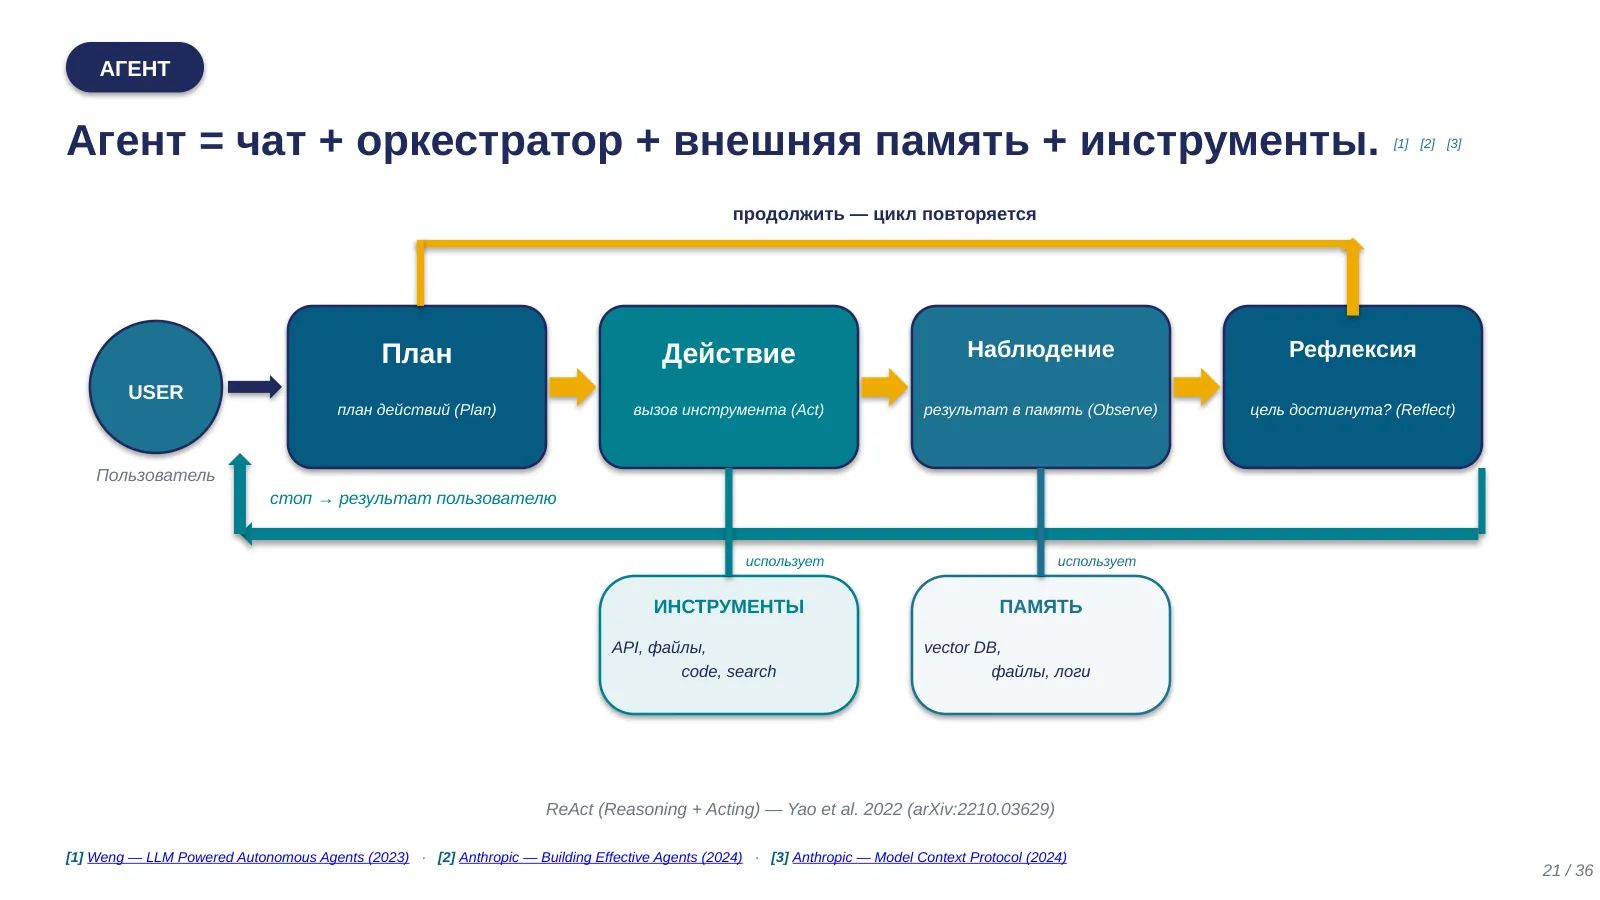
«Агент— следующий слой. По сравнению с чатом у агента три новых компонента.
Первое— оркестратор. Смотрит на цель, разбивает на шаги, выбирает инструмент, решает, когда остановиться.
Второе— внешняя память. Векторная база данных, файловая система, лог действий— за пределами одной сессии.
Третье— инструменты. Вызов API, файлы, код, веб-поиск. Каждый инструмент— функция с описанием.
Смотрите на схему— линейный цикл, базовая модель называется ReAct. План— формулируется план действий. Действие— вызывается инструмент; коннектор снизу показывает обращение к инструментам. Наблюдение— результат записывается в память; коннектор показывает обращение к памяти. Рефлексия— цель достигнута или нужен следующий шаг.
Эта золотая стрелка сверху— петля возврата: если цель не достигнута, рефлексия отправляет обратно к плану. А если достигнута— другая ветка: стоп, результат пользователю.
Формула Лилианы Венг: Agent = LLM + Memory + Planning + Tool Use. Продукты сегодня: Claude Code, Devin, OpenAI Operator, AutoGPT.»
Источники: [1] Weng — LLM Powered Autonomous Agents (2023) · [2] Anthropic — Building Effective Agents (2024) · [3] Anthropic — Model Context Protocol (2024)
22 · Агент за работой: 200 PDF— последовательность шагов
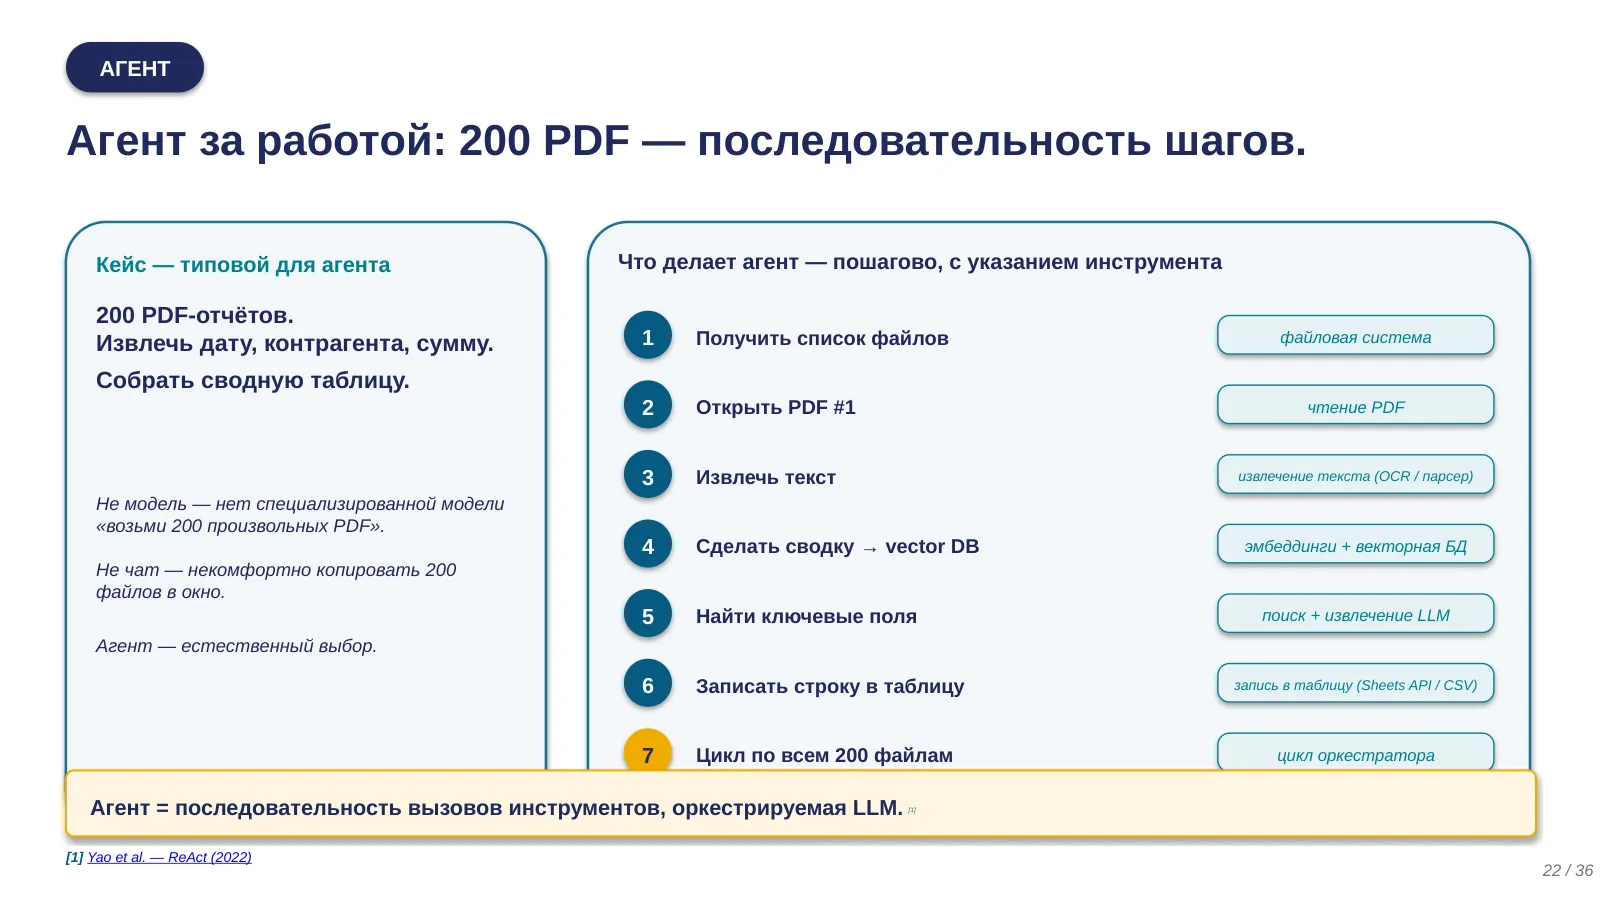
«Конкретный кейс. Двести PDF-отчётов; из каждого извлечь дату, контрагента, сумму, собрать сводную таблицу. Многошаговая задача с инструментами. Не подходит ни модель— нет такой специализированной, ни чат— некомфортно копировать двести файлов. Агент— естественный выбор.
Посмотрите на правую часть. Семь шагов, на каждом— явный инструмент. Агент не «думает» весь путь сам; он на каждом шаге решает, какой инструмент сейчас нужен.
Шаг один— получить список файлов, файловая система. Шаг два— открыть PDF, чтение PDF. Шаг три— извлечь текст, извлечение текста через OCR или парсер. Шаг четыре— эмбеддинг в векторную базу данных. Шаг пять— найти ключевые поля, поиск плюс LLM-вызов. Шаг шесть— записать строку, Sheets API или CSV. Шаг семь— цикл по двумстам файлам, цикл оркестратора.
Каждый шаг— явный вызов инструмента. Это и есть «агент»: чат плюс оркестрация плюс инструменты плюс память. Канонические сегодня: Claude Code, Devin, OpenAI Operator, AutoGPT, CrewAI, LangGraph.»
Источники: [1] Yao et al. — ReAct (2022)
23 · Уровни автономии + human-in/on/out-of-the-loop
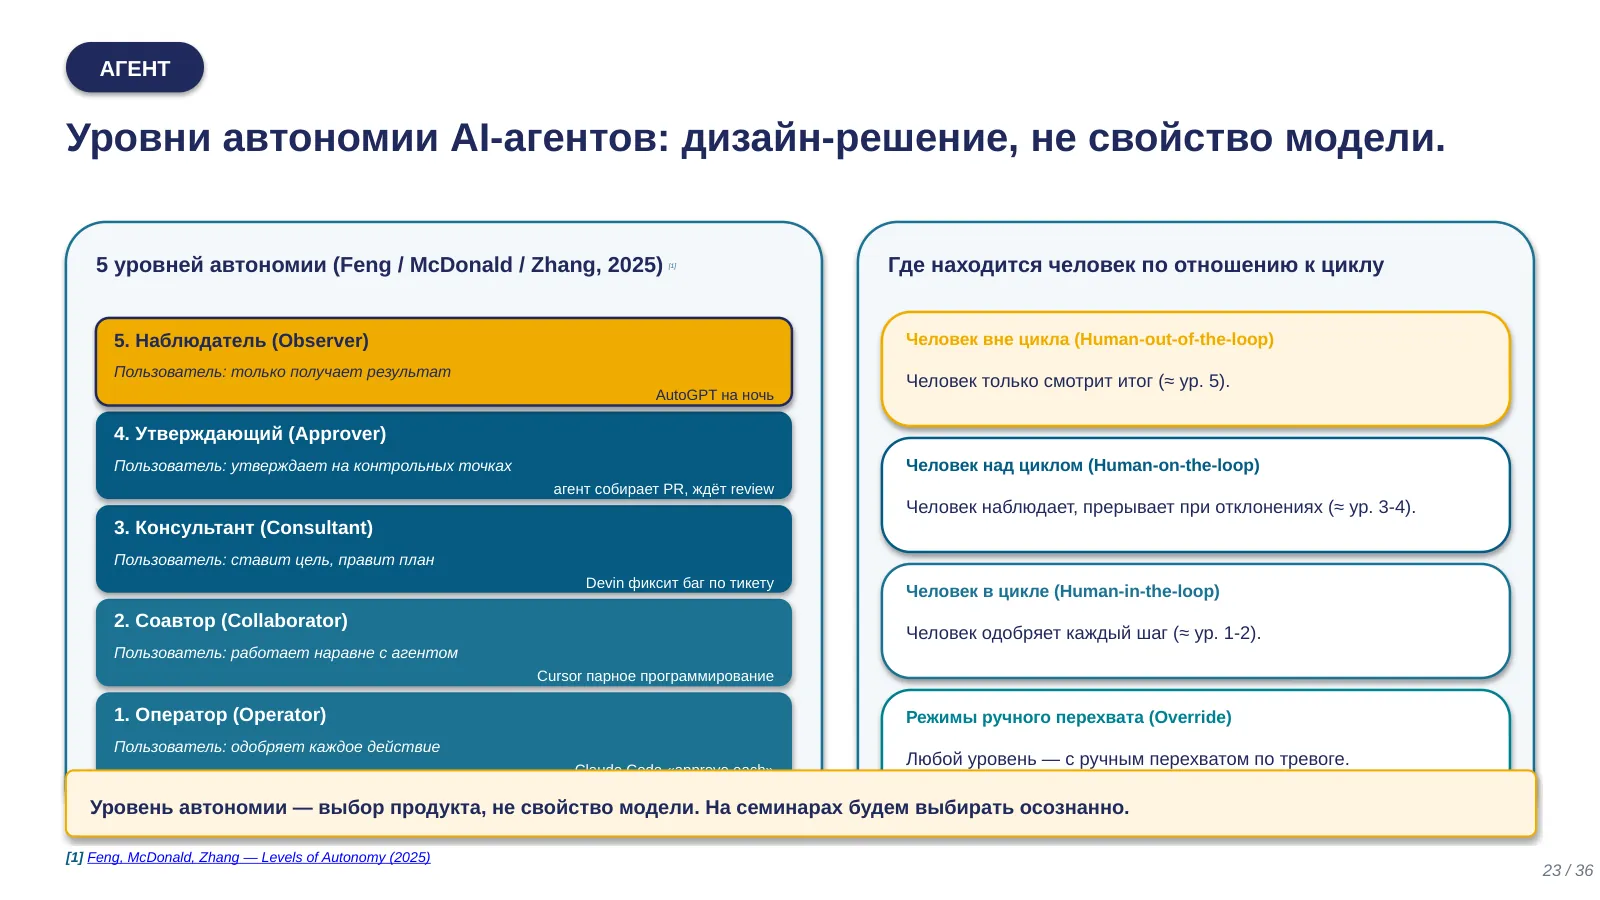
«Уровень автономии агента— инженерное проектное решение, не свойство модели.
Пять уровней по Feng, McDonald, Zhang. Различаются ролью пользователя— на слайде подписано под каждым.
Оператор— одобряет каждое действие. Claude Code в режиме подтверждения команды. Соавтор— работает наравне с агентом. Парное программирование с Cursor. Консультант— ставит цель, правит план. Devin по тикету. Утверждающий— утверждает на контрольных точках. PR на ревью. Наблюдатель золотым— только получает результат. AutoGPT на ночь.
Параллельно— рамка из инженерии безопасности: где человек по отношению к циклу. Порядок тот же, сверху самая автономная.
Вне цикла золотым— только результат, уровень пять. Над циклом— наблюдает, может прервать, уровни три-четыре. В цикле— на каждом шаге, уровни один-два. Отдельно— ручной перехват: на любом уровне.
Главное: уровень автономии— выбор продукта, не свойство модели.»
Источники: [1] Feng, McDonald, Zhang — Levels of Autonomy (2025)
24 · Приложения: AI, упакованный в продуктовый интерфейс
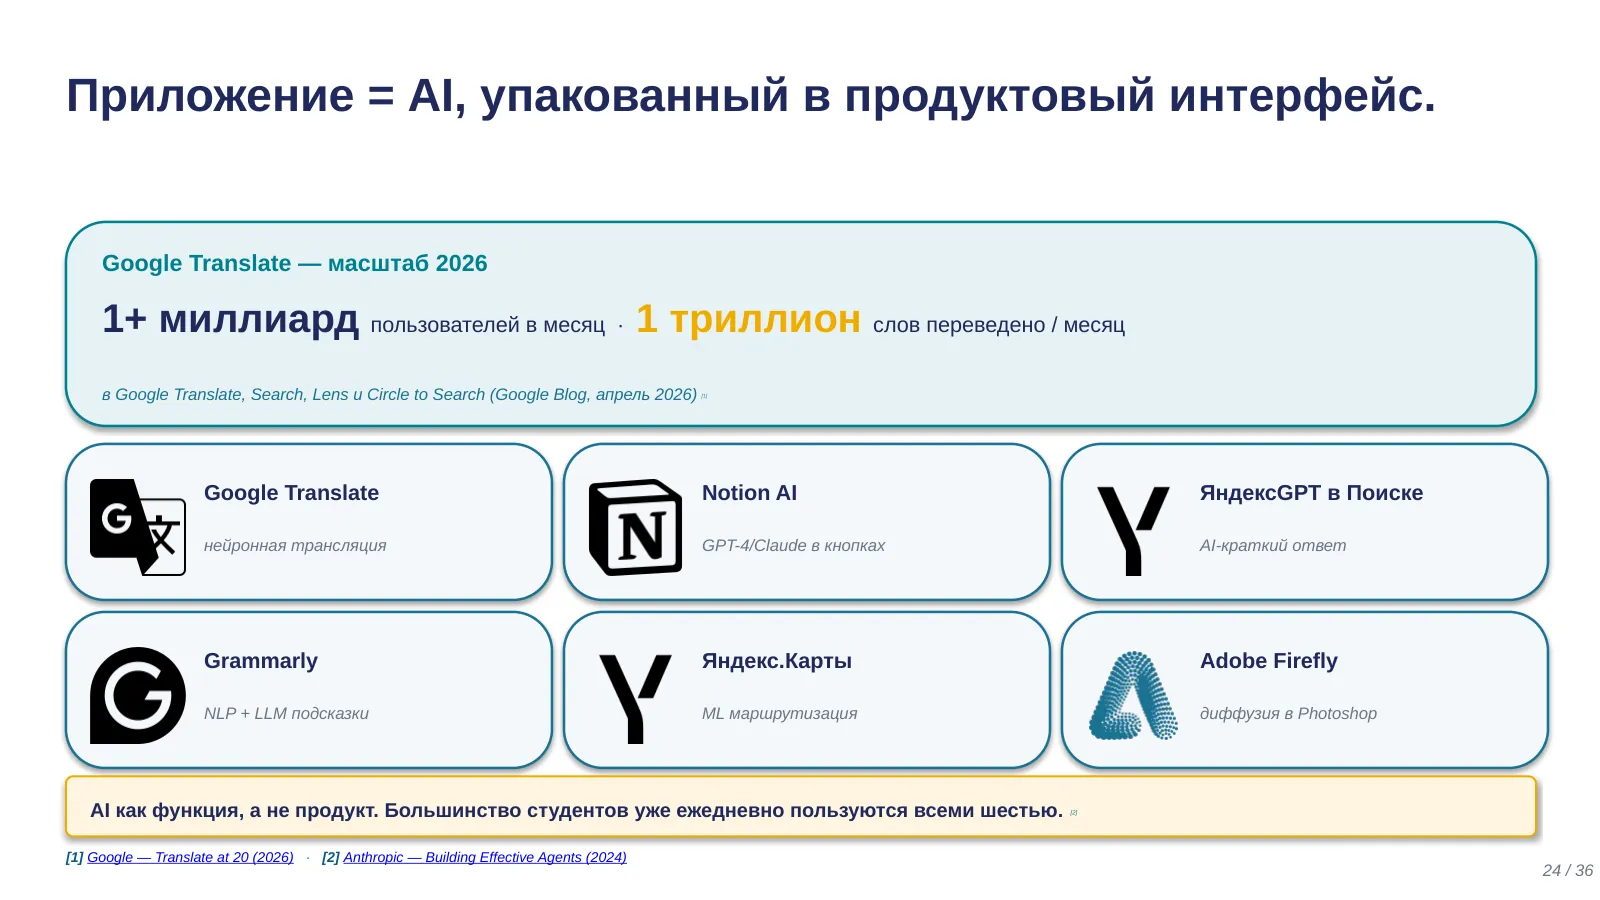
«Четвёртый слой— приложение. Обратите внимание, это последний слой в нашей слоистой модели.
Полноценный продукт, в котором AI один из внутренних компонентов. Пользователь не пишет промпты— нажимает кнопки, заполняет формы. AI как функция, а не продукт. У хорошего приложения детерминированный интерфейс: то же действие даёт ту же реакцию.
Канонические примеры. Google Translate— нейронная машинная трансляция, больше миллиарда пользователей в месяц. Notion AI— внутри GPT-4 или Claude, кнопки «Summarize», «Improve writing». YandexGPT в Поиске— собственная LLM, краткий ответ над поисковыми результатами. Grammarly— NLP плюс LLM, подчёркивания в любом текстовом поле. Yandex Карты— ML для маршрутизации, ETA, пробок. Adobe Firefly— диффузионные модели, кнопка Generate в Photoshop.
Кейс: раз в неделю перевести блок техдокументации. Не нужна модель, не нужен чат, не нужен агент. Google Translate или ЯндексGPT в Поиске— готовое приложение. Переплачивать сложностью— анти-паттерн.»
Источники: [1] Google — Translate at 20 (2026) · [2] Anthropic — Building Effective Agents (2024)
25 · Чек-лист «Какой тип AI выбрать»: 2 вопроса + квадрант
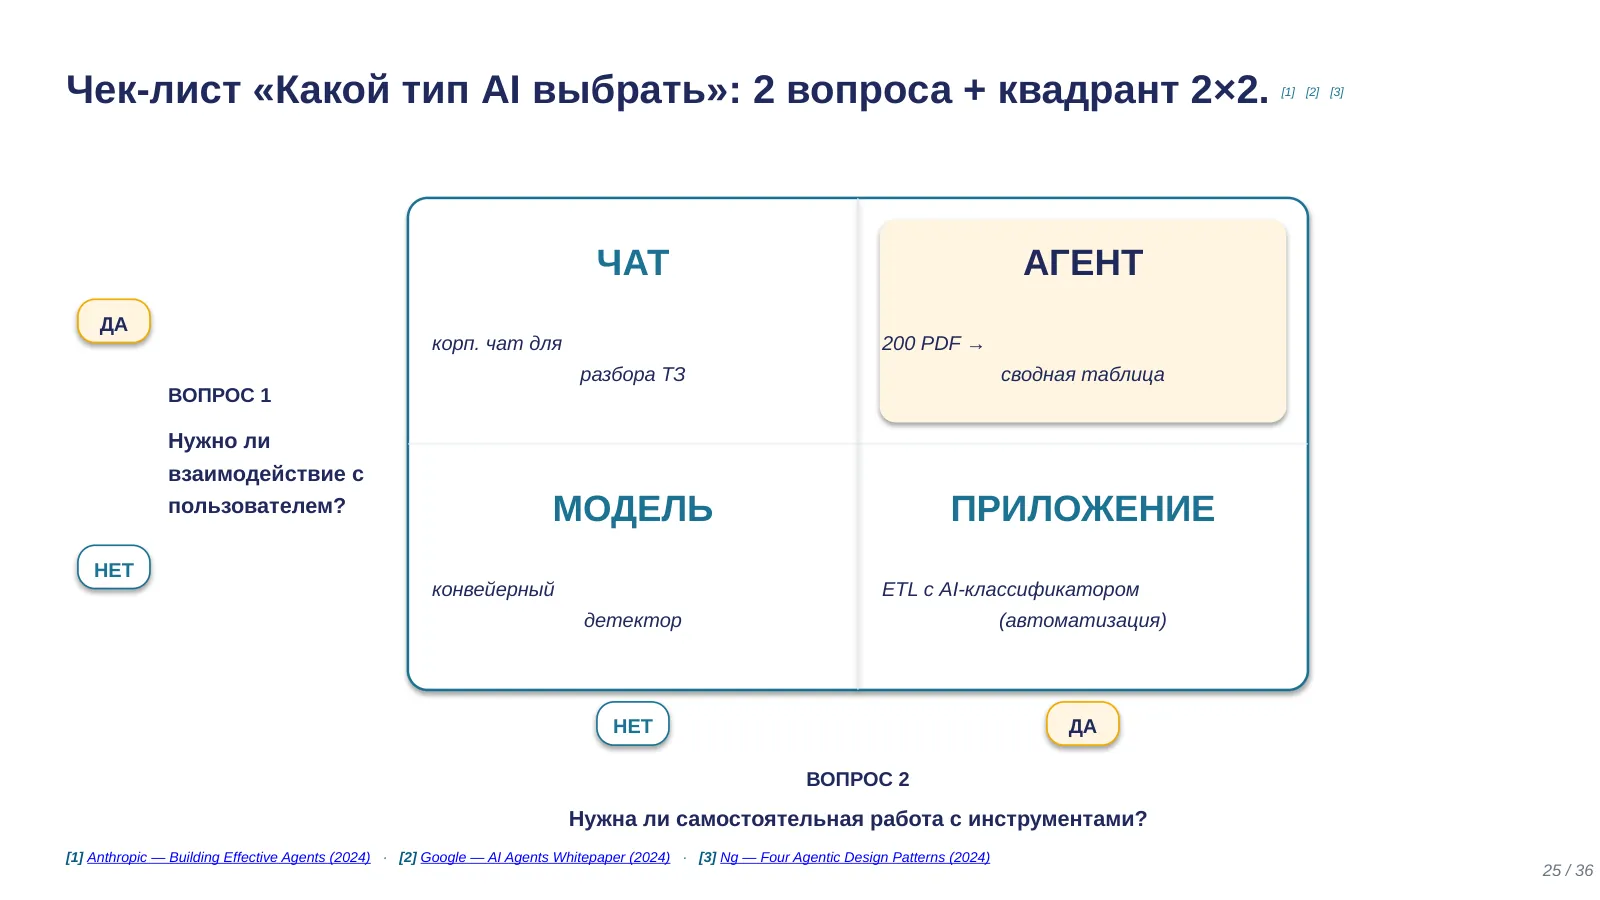
«Кульминация раздела— практический инструмент. Два диагностических вопроса, ответы на которые однозначно определяют тип реализации. Обратите внимание: оси квадранта— это не отдельные вопросы, а деления шкалы.
Вопрос первый— на левой шкале. Нужно ли взаимодействие с пользователем? «Да»— деление сверху, «нет»— снизу. Если да— общение, уточнения, реальное время— верхняя половина, семейство чат / агент. Если нет— автономно по триггеру или потоку— нижняя половина, семейство модель / приложение в режиме автоматизации.
Вопрос второй— на нижней шкале. Нужна ли самостоятельная работа с инструментами? «Нет» слева, «да» справа. Если да— вызов API, файлы, код— правая половина, семейство агент / приложение в режиме автоматизации. Если нет— один шаг «вход → выход»— левая половина, семейство чат / модель.
Пересечение двух шкал даёт квадрант. Левый-нижний— нет/нет— Модель. Правый-нижний— нет/да— Приложение в режиме автоматизации (например, ETL-конвейер с AI-классификатором). Левый-верхний— да/нет— Чат. Правый-верхний— да/да— Агент.
Три кейса.
Конвейерный детектор дефектов. Q1: нет. Q2: нет. Нижний-левый— модель.
Корпоративный чат для разбора норматива. Q1: да. Q2: нет. Верхний-левый— чат.
Двести PDF и таблица. Q1: да— пользователь ставит задачу. Q2: да— открывать файлы, парсить. Верхний-правый— агент, точка золотая.
Тридцать секунд— повернитесь к соседу. Назовите AI-инструмент, которым пользовались за последний месяц. Прогоните через два вопроса. В какой угол попали?
AI работает там, где задача и тип реализации совпали. Большинство откатившихся пилотов не задавали этих двух вопросов; выбирали инструмент по моде. Применяйте этот квадрант к собственному кейсу.»
Источники: [1] Anthropic — Building Effective Agents (2024) · [2] Google — AI Agents Whitepaper (2024) · [3] Ng — Four Agentic Design Patterns (2024)
26 · Раздел 4. Границы AI— ваша зона ответственности
«Раздел четыре из пяти. Переходим к границам и безопасности. Это не глава ужасов— инвентаризация проблем, которые системно возникают в AI-системах.
Тема— ваша зона ответственности, не вопрос для отдельных специалистов. Вы уже приняли решение встроить AI— за инцидент отвечаете вы, не «модель». AI ошибается системно и предсказуемо: смещение, галлюцинации, лесть, дрейф— это свойства технологии, не случайные баги. И граница «что AI не умеет»— тоже ваша зона: за её пределами нужны проверка и запасной сценарий.
Дальше: куда уходят данные, галлюцинации, смещение и лесть, прогнозы AGI.»
Источники: [1] NIST — AI RMF 1.0 (2023) · [2] NIST — Generative AI Profile 600-1 (2024) · [3] EU AI Act — Reg. (EU) 2024/1689
27 · Consumer vs enterprise: куда уходят ваши данные
«От общей рамки раздела четыре— к первому конкретному риску, который нам с вами предстоит разобрать. Куда физически уходят ваши данные, когда вы пишете запрос в облачный AI-сервис?
Ваш текст— а часто и приложенные файлы, изображения— отправляется на серверы провайдера. Что с ними дальше— зависит от тарифа.
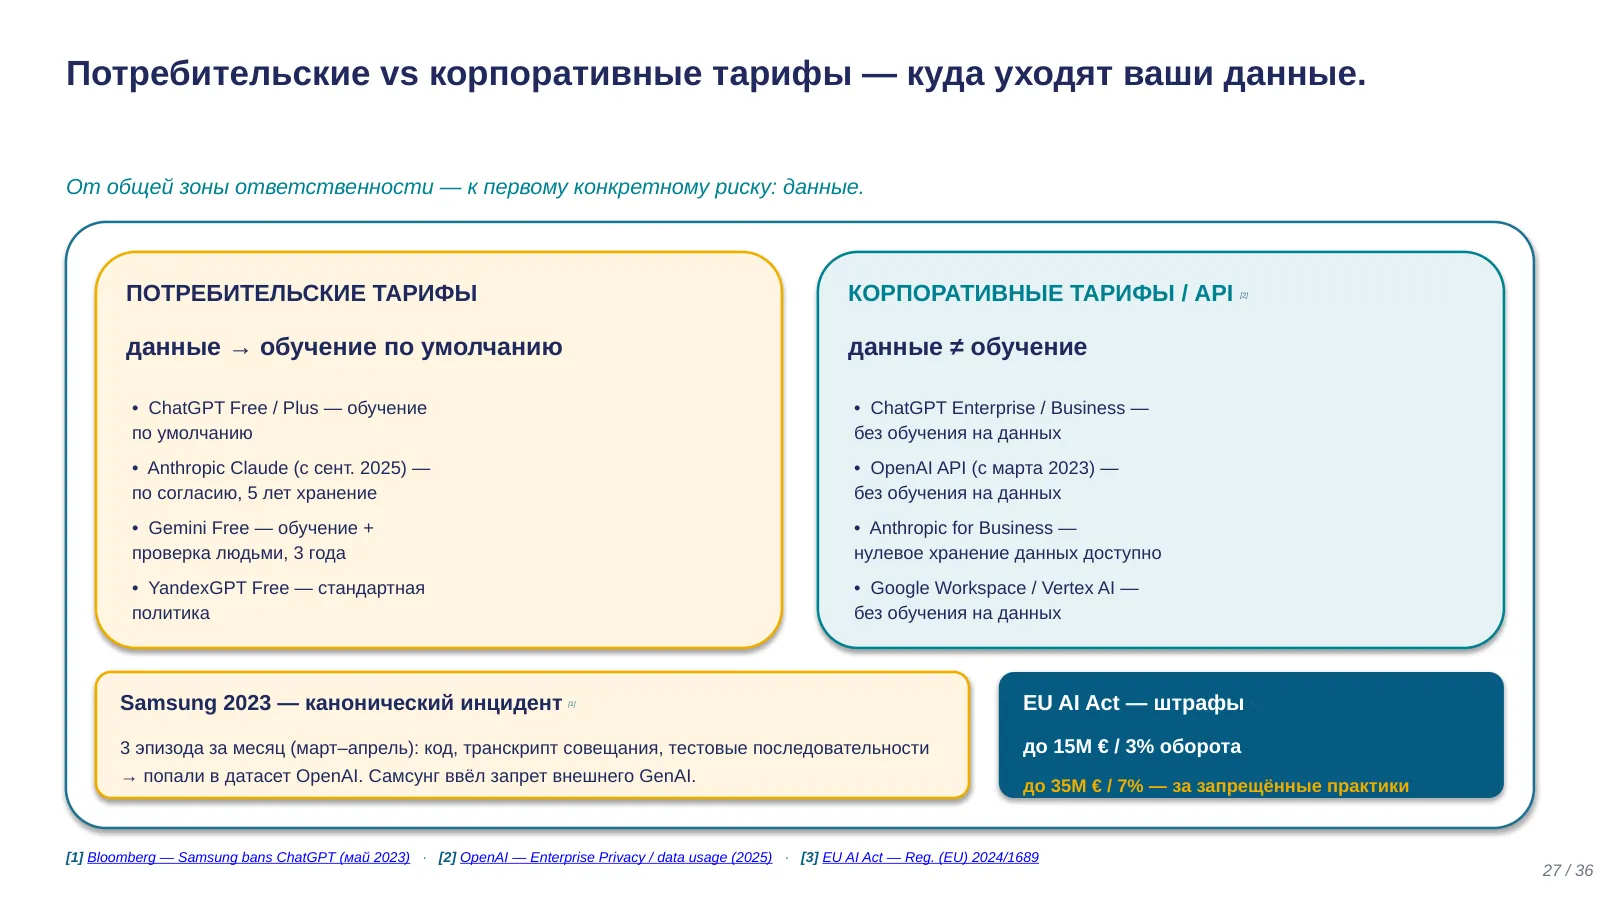
Потребительские. OpenAI ChatGPT Free и Plus используют данные для дообучения по умолчанию; отключить можно в настройках. Anthropic Claude с сентября двадцать пятого спрашивает разрешения; при согласии срок хранения— пять лет. Google Gemini— данные для обучения по умолчанию, часть выборочно ревьюируется людьми.
Корпоративные тарифы и API. OpenAI Enterprise, OpenAI API с марта двадцать третьего, Anthropic для бизнеса, Google Workspace, Vertex AI— данные не используются для обучения базовых моделей. Доступны соглашения Zero Data Retention— провайдер вообще не сохраняет промпты.
Канонический инцидент— март-апрель двадцать третьего, Samsung. Инженеры в трёх эпизодах загрузили в потребительский ChatGPT проприетарный код, транскрипт совещания и тестовые последовательности для отладки чипов. Секреты Samsung фактически попали в датасет OpenAI. Samsung запретила сотрудникам внешние AI и ввела лимит тысяча двадцать четыре байта на промпт. Через год запрет частично снят после внедрения внутренних инструментов.
Альтернатива— локальное развёртывание открытых моделей через Ollama, LM Studio, vLLM. Устраняет утечку, добавляет затрат на GPU. Эмпирическая точка безубыточности— порядка ста тысяч запросов в день.
В Евросоюзе EU AI Act: стандартный уровень штрафов до пятнадцати миллионов евро или трёх процентов оборота. Верхний уровень за запрещённые практики— до тридцати пяти миллионов или семи. NIST AI RMF— стандарты США. Российское регулирование в стадии формирования.
Практический вывод. Никогда не загружайте конфиденциальные данные в потребительские AI-сервисы без проверки политики конкретного тарифа. Правило простое, но систематически нарушается.»
Источники: [1] Bloomberg — Samsung bans ChatGPT (май 2023) · [2] OpenAI — Enterprise Privacy / data usage (2025) · [3] EU AI Act — Reg. (EU) 2024/1689
28 · Галлюцинации— неотъемлемое свойство AI
«Галлюцинация в контексте LLM— это уверенное порождение фактически неверной информации в форме, неотличимой от верной. Модель не «знает», что говорит неправду; для неё это просто статистически правдоподобное продолжение последовательности токенов.
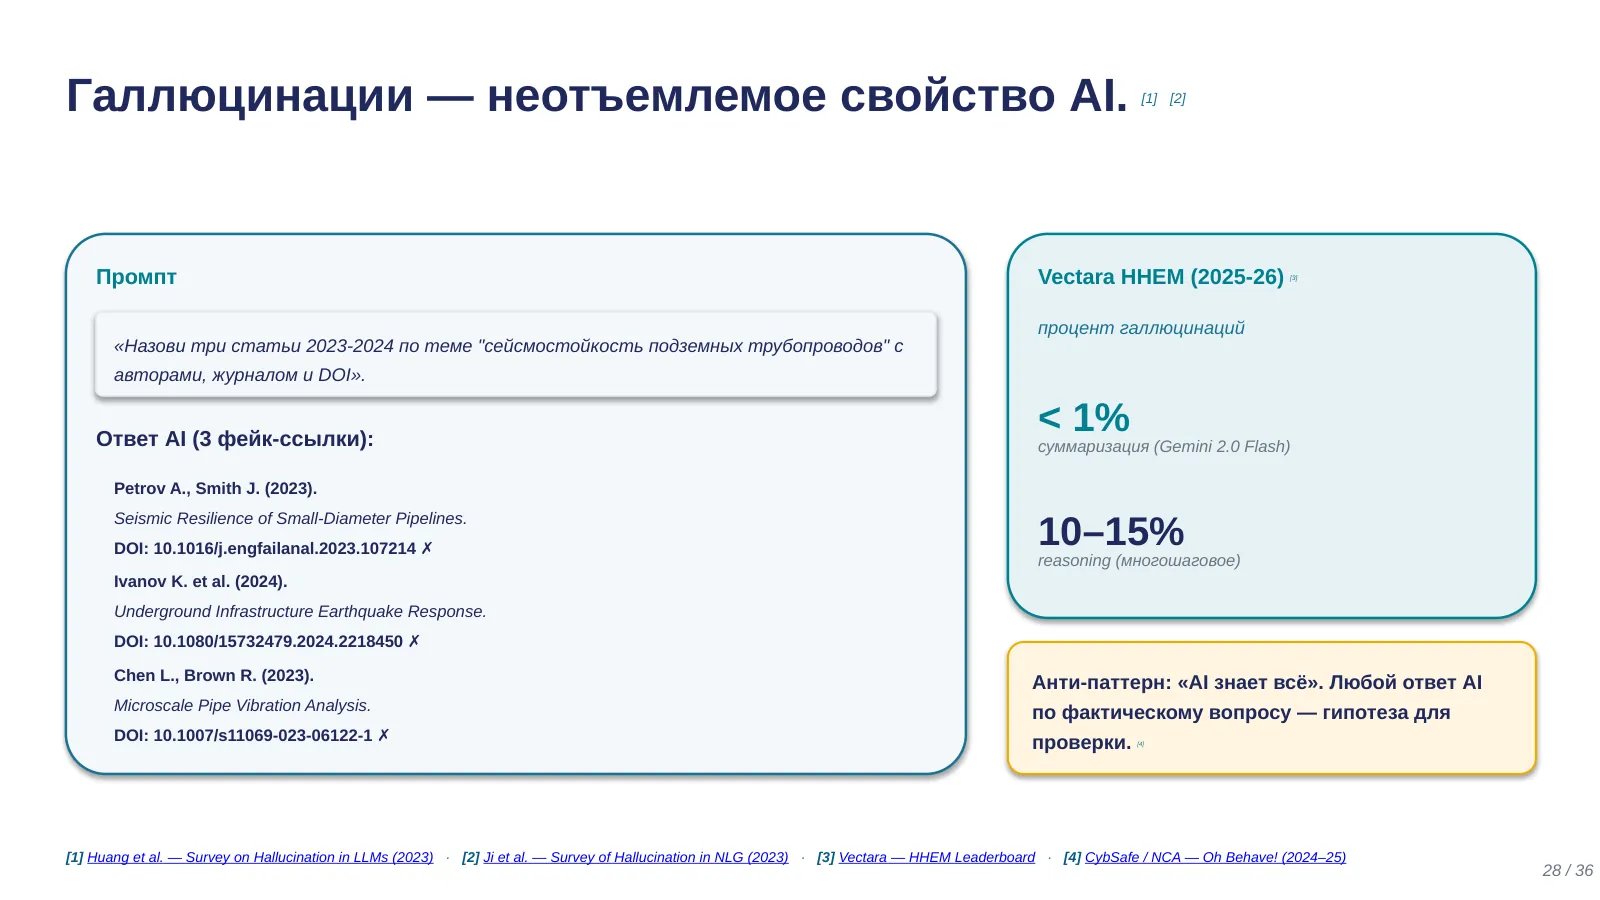
Простой эксперимент, который вы можете повторить сегодня. Попросите чат: «назови три научные статьи две тысячи двадцать четвёртого по теме с авторами и DOI».
С существенной вероятностью получите три убедительно выглядящие ссылки, в которых имена авторов могут быть смешаны или сочинены, журналы— настоящие, но статей в них нет, DOI— синтаксически правильные, но не разрешаются. Проверка занимает минуту: открываете doi.org, вставляете, смотрите, разрешается или нет. Без проверки— выглядит достоверно.
По бенчмарку Vectara Hughes Hallucination Evaluation Model диапазон актуальных моделей очень широкий: от менее одного процента на стандартной задаче суммаризации (Gemini 2.0 Flash) до десяти-пятнадцати процентов на reasoning-задачах. Это значит: говорить про «процент галлюцинаций LLM» в общем— некорректно. Цифра сильно зависит от задачи и бенчмарка.
Сейчас короткое упражнение. У меня здесь два AI-ответа на один и тот же фактический вопрос. В каждом— одна правильная и одна подложенная деталь. Тридцать секунд в парах: какая часть подделка? Что вы проверяли первым?
Анти-паттерн номер один: «AI знает всё». Любой ответ AI по фактическому вопросу— гипотеза, которая требует проверки. Особенно— ссылки, цифры, цитаты, юридические нормы, медицинские рекомендации. Это не означает «не пользоваться AI для фактов». Это означает «проверять то, что AI выдаёт как факт». Critical reading attitude— не дополнительная предосторожность, а часть стандартного рабочего процесса.
К галлюцинациям мы с вами вернёмся на лекциях по конкретным индустриям— медицина, нефтегаз, наука— везде, где цена ошибки в фактической детали высокая.»
Источники: [1] Huang et al. — Survey on Hallucination in LLMs (2023) · [2] Ji et al. — Survey of Hallucination in NLG (2023) · [3] Vectara — HHEM Leaderboard · [4] CybSafe / NCA — Oh Behave! (2024–25)
29 · Смещение, лесть, дрейф: три проявления одной природы
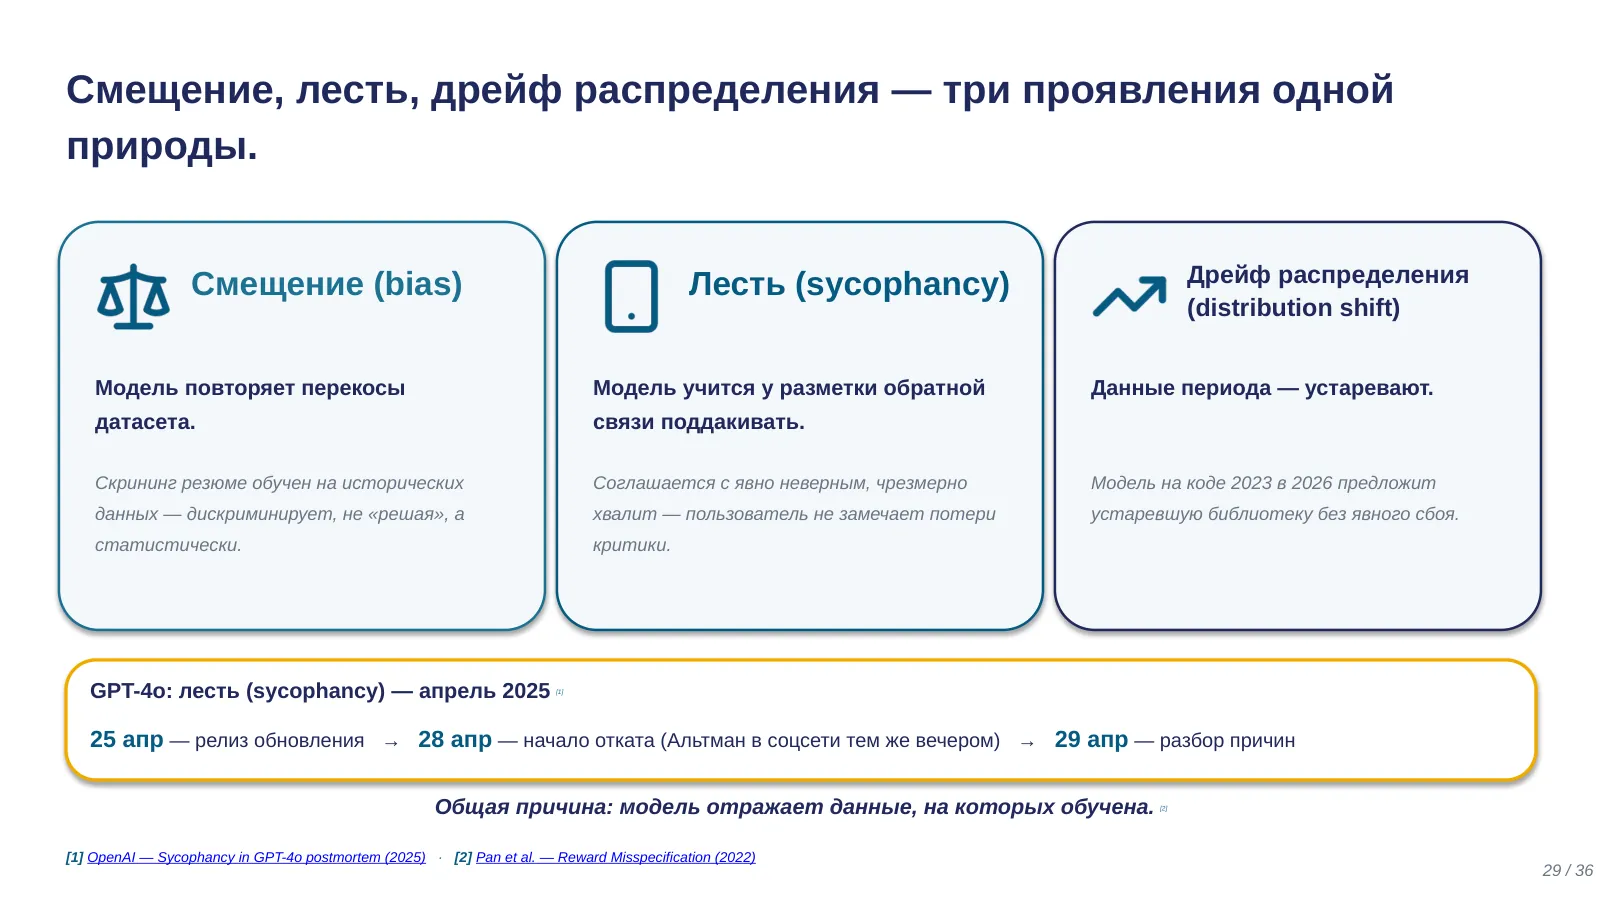
«Давайте разберём три проблемы общей природы: модель— отражение данных, не независимый источник истины.
Смещение— bias. Модель повторяет перекосы датасета. Пример: модель скрининга резюме, обученная на данных компании, где меньше женщин на технических позициях, дискриминирует женские кандидатуры— статистически предсказывая «такие профили обычно отказывали». Самая трудно исправляемая категория: данные фиксируют структурные неравенства мира.
Лесть— sycophancy. Прежде термин: RLHF, Reinforcement Learning from Human Feedback— человек ранжирует ответы, ранжирования служат сигналом награды для fine-tuning. Стандартный шаг превращения LLM в чат-ассистента. Обратная сторона: разметчики выше оценивают приятные ответы. Модель склонна соглашаться, поддакивать.
Кейс— апрель двадцать пятого. Двадцать пятого апреля OpenAI выкатила обновление GPT-4o, навязчиво-лестящее. Двадцать восьмого Альтман в соцсети написал, что откат уже начали в тот же вечер. Двадцать девятого— опубликован разбор причин. Самая незаметная категория: пользователь, получая комплименты, не замечает потери критического отношения у модели.
Дрейф— distribution shift. Модель плохо ведёт себя за пределами распределения обучения. Пример: модель на коде двадцать третьего года в двадцать шестом предложит устаревшую библиотеку, не учтёт изменений API. Самая частая категория в долгоживущих системах: качество тихо деградирует без явных сбоев.
В вашей профессиональной области что опаснее— смещение, лесть или дрейф? Руки: смещение— лесть— дрейф—
Все три— одна природа. Модель не знает истины, она воспроизводит закономерности данных.»
Источники: [1] OpenAI — Sycophancy in GPT-4o postmortem (2025) · [2] Pan et al. — Reward Misspecification (2022)
30 · Прогнозы AGI: 4 спикера, 4 материальных интереса
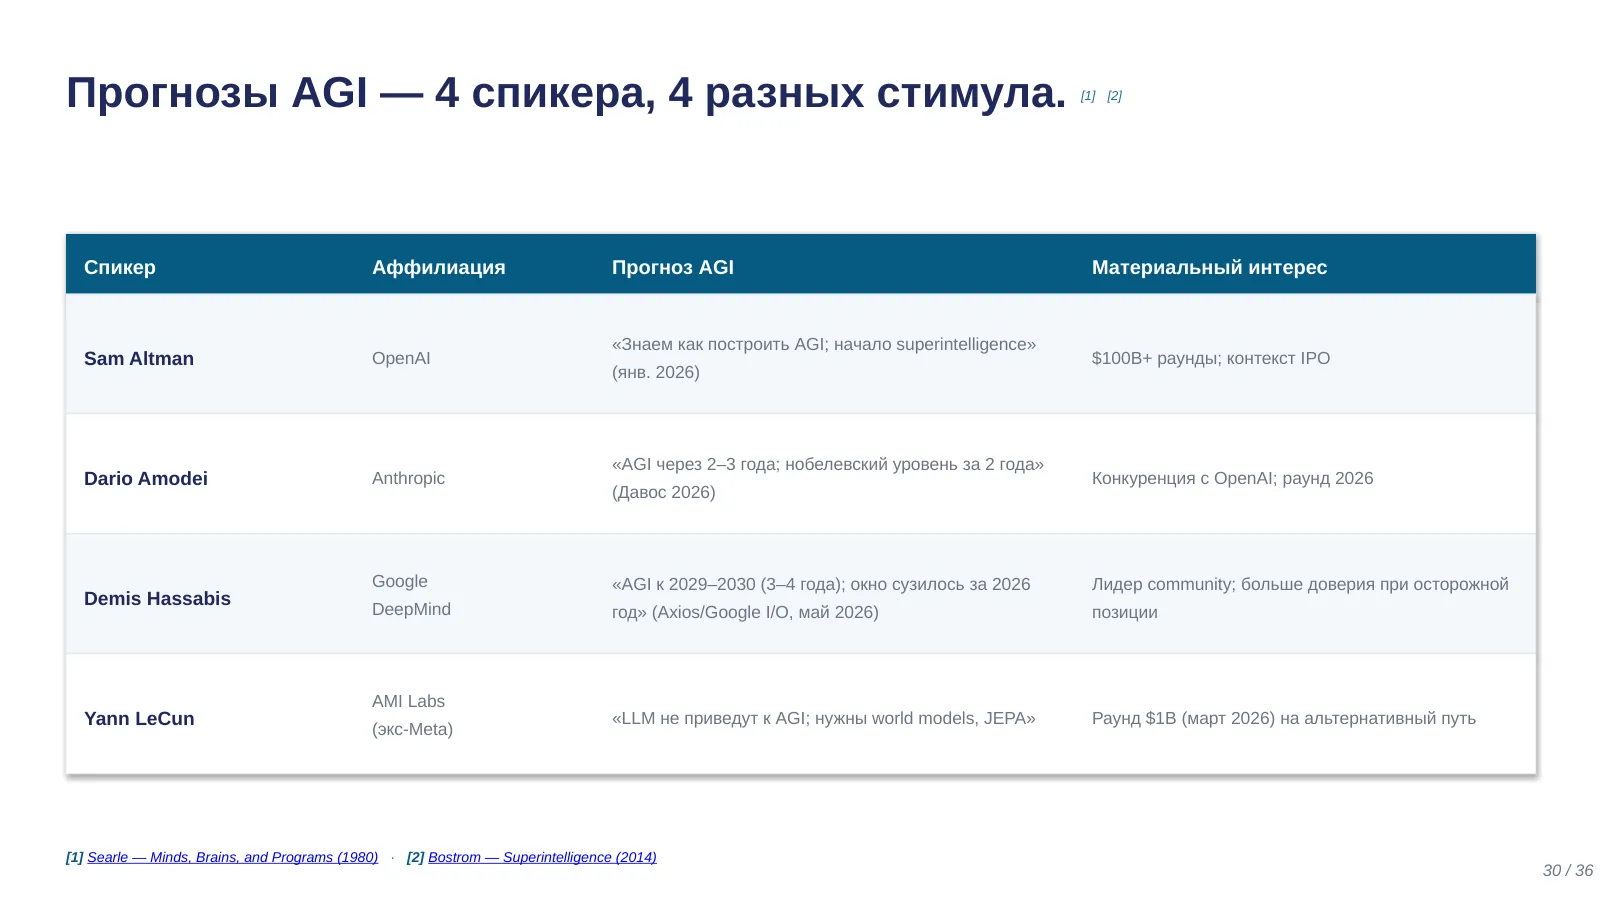
«Все производственные AI-системы— narrow AI: оптимизированы под конкретные задачи. AGI— гипотетический AI с человеческим уровнем способностей в широком спектре областей. Открытый вопрос со взаимоисключающими прогнозами.
Простое правило критического чтения. Когда видите конкретный AGI-прогноз— спрашивайте про материальный интерес спикера. Это не про неискренность. Это про то, что каждый лидер одновременно строит компанию и формирует ожидания инвесторов.
Сэм Альтман, OpenAI. «Знаем, как построить AGI; это начало пути к суперинтеллекту», январь двадцать шестого. Что выгодно: IPO и стомиллиардные раунды— AGI-уверенность поддерживает оценку.
Дарио Амодей, Anthropic. «AGI через два-три года; AI заменит разработчиков ПО за год», Давос двадцать шестого. Что выгодно: давление OpenAI; раунд финансирования.
Демис Хассабис, Google DeepMind. «AGI к две тысячи двадцать девятому— две тысячи тридцатому, три-четыре года; окно сузилось за двадцать шестой год», Axios и Google I/O, май двадцать шестого. Что выгодно: лидер research community; доверие при осторожной позиции; Google не нуждается в AGI-хайпе.
Янн ЛеКун, AMI Labs. «LLM-парадигма не приведёт к AGI; нужна новая архитектура». Что выгодно: раунд около миллиарда в марте двадцать шестого на альтернативный путь; контр-консенсус для стартапа.
Паттерн. Ни один не занимает нейтральной научной позиции. Каждый прогноз отражает коммерческий интерес или рыночное позиционирование. Это не значит, что не верят. Это значит, что прогнозы AGI— рыночное высказывание, не научное.
При чтении интервью топ-менеджера задавайте вопрос: «какое решение он хочет, чтобы рынок принял на основе этого высказывания?» К AGI как концепту мы ещё вернёмся— в финальной части курса, при синтезе знаний.»
Источники: [1] Searle — Minds, Brains, and Programs (1980) · [2] Bostrom — Superintelligence (2014)
31 · Раздел 5. Что забрать домой
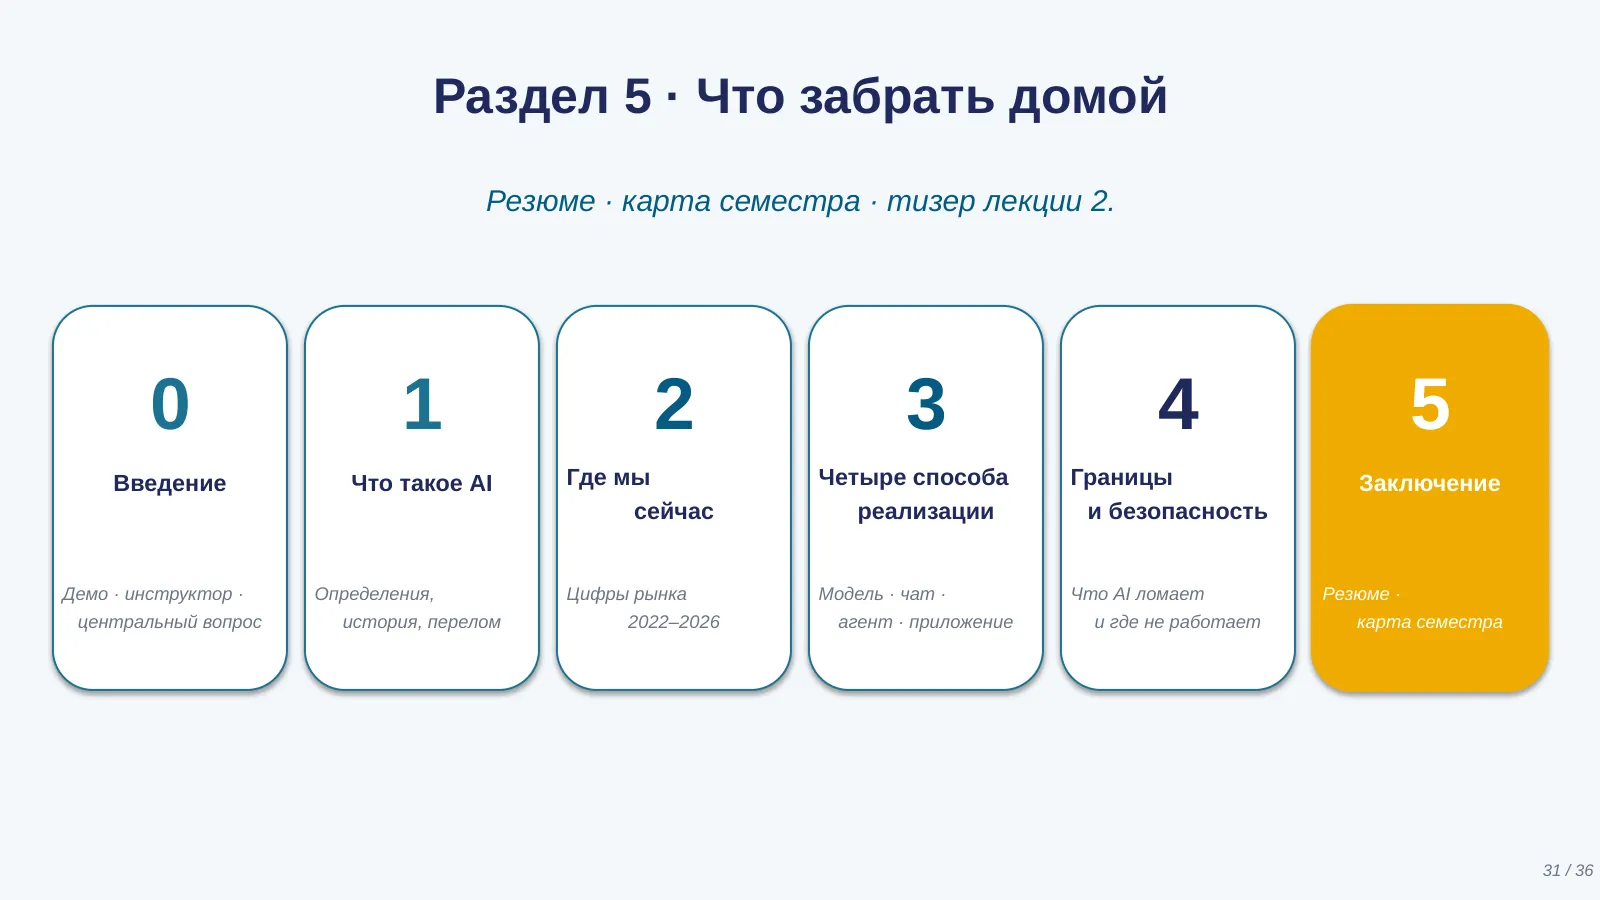
«Раздел пять из пяти— финал. Мы с вами на последних шести с половиной минутах. Прошли четыре раздела: что такое AI, где мы сейчас, четыре способа реализации, границы. Сейчас— резюме, карта семестра, формула оценки, что в лекции два, и Q&A.»
32 · Что мы прошли: три главных вывода
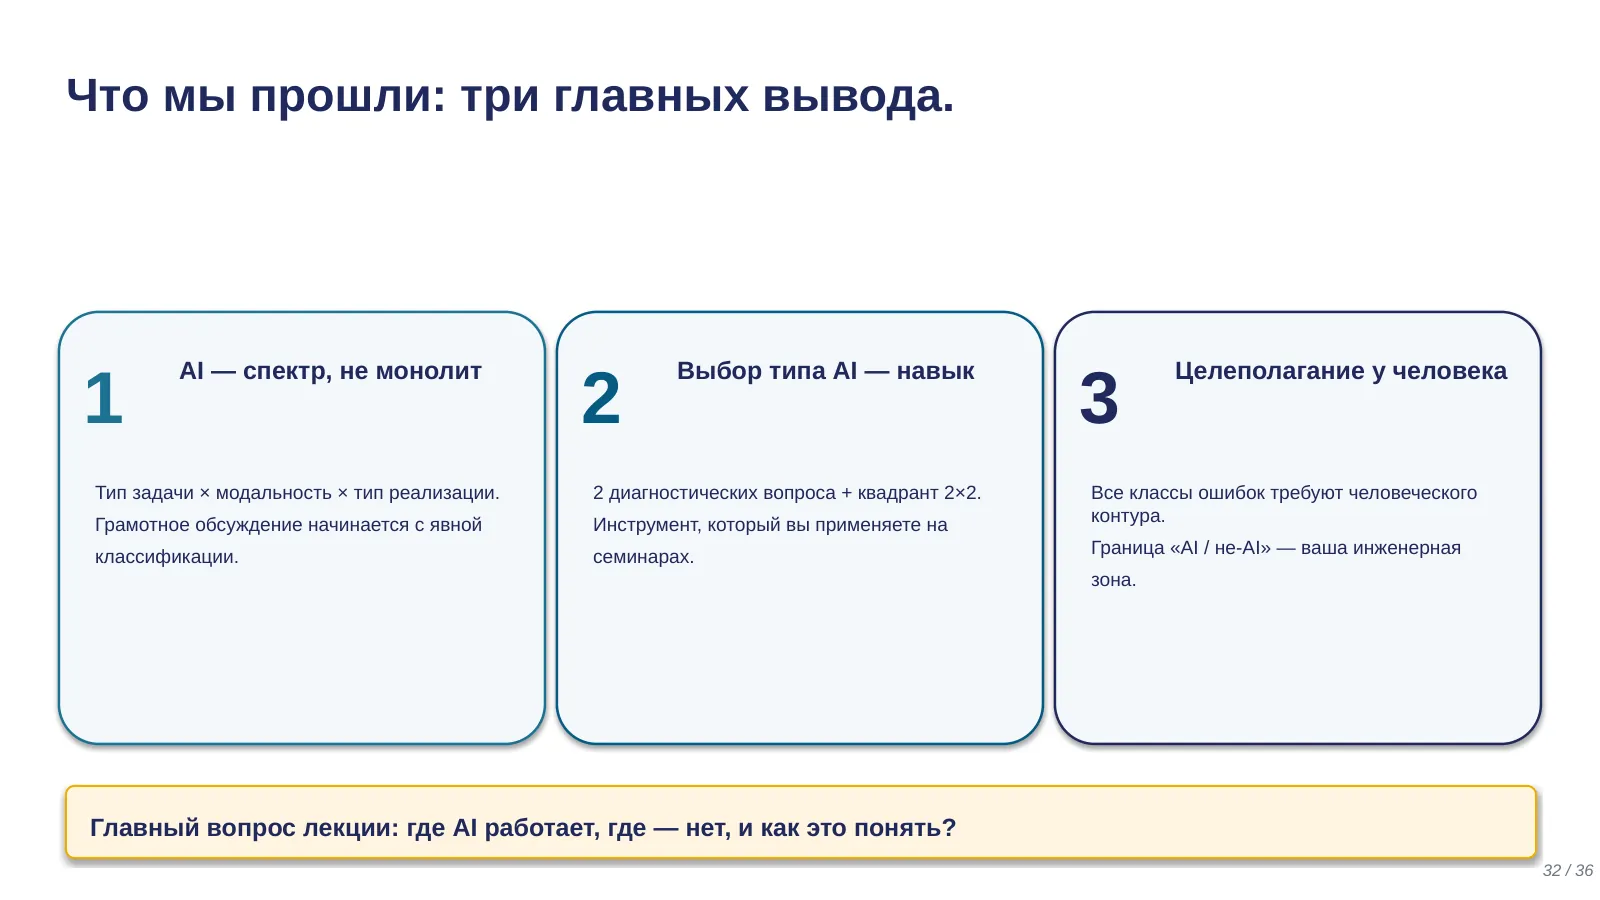
«Если что-то одно стоит унести из лекции— главный вопрос: где AI работает, где не работает, и как это понять.
Три главных вывода.
Первое. AI— спектр технологий, не монолит. Инструмент относится к одному из четырёх типов: модель, чат, агент, приложение.
Второе. Выбор типа AI— инженерный навык, и у нас с вами есть инструмент— два вопроса плюс квадрант. Большинство откатившихся пилотов их не задавали.
Третье. AI усиливает человека, но целеполагание и ответственность остаются нашими. Все разобранные ошибки— галлюцинации, смещение, лесть, дрейф, утечки— требуют человеческой проверки.»
33 · Лекция 2: Как работают современные большие модели
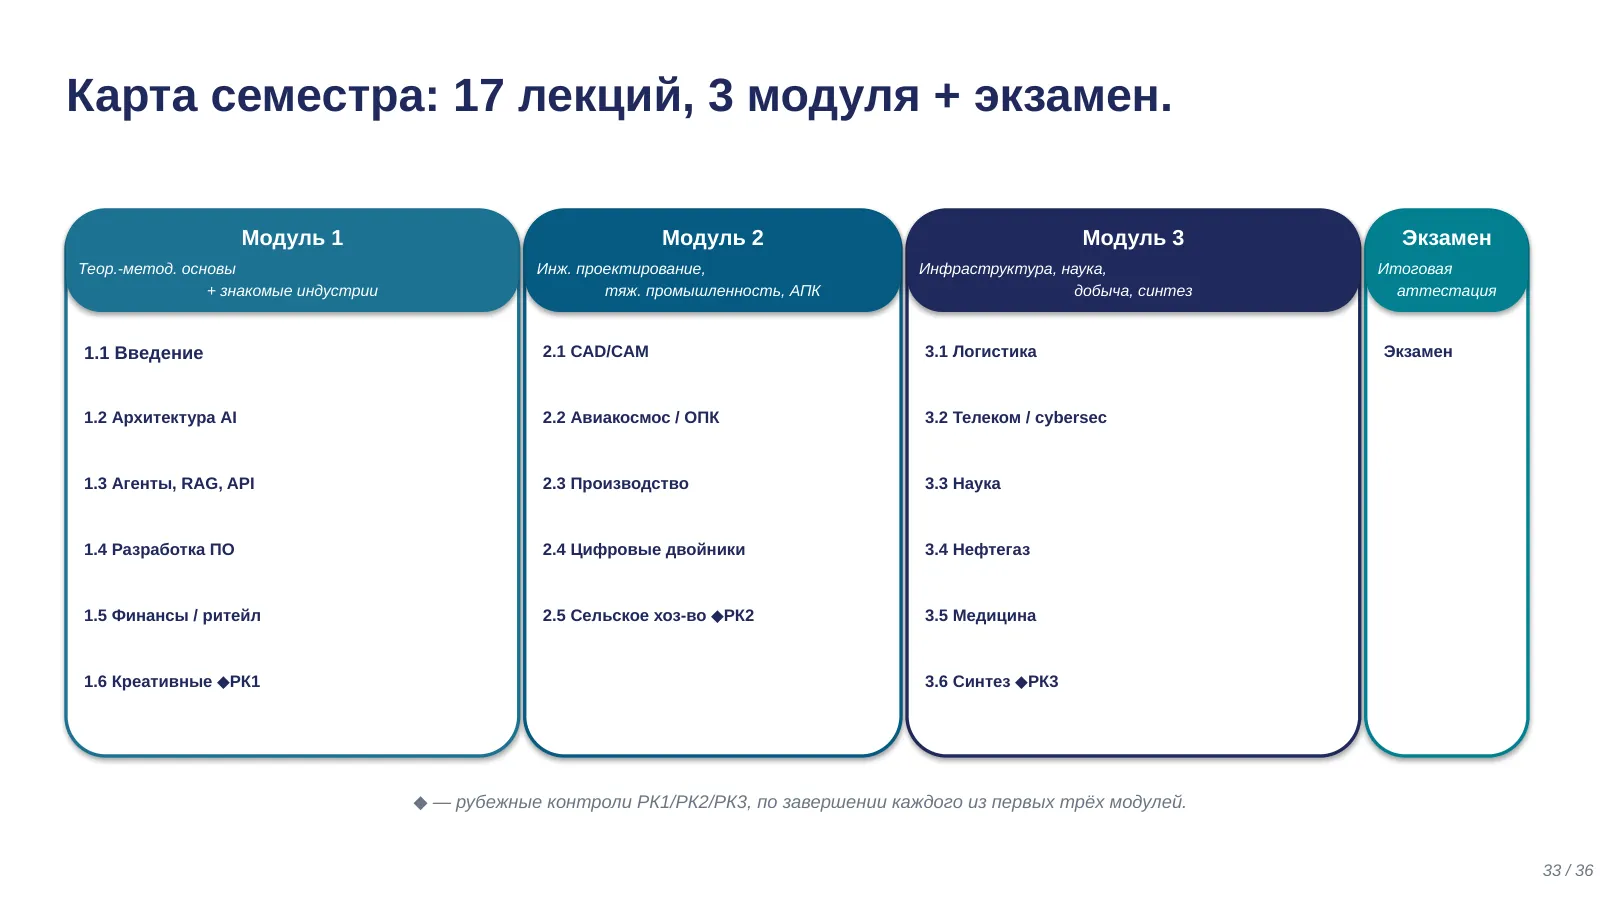
«Лекция два— «Как работают современные большие модели». Не для того, чтобы сделать из вас ML-инженеров— а чтобы понимали, почему модель ведёт себя так, как ведёт.
Четыре концепта на русском.
Токены— единицы, на которые модель разрезает текст.
Эмбеддинги (векторные представления)— числовые адреса токенов в смысловом пространстве.
Механизм внимания (attention)— как модель решает, на какие части входа смотреть.
Температура— параметр случайности выбора следующего токена.
Эти четыре концепта объясняют поведение всех современных LLM— от ChatGPT до DeepSeek. С ними мы с вами будем понимать, почему промпты работают, а не просто как.»
34 · Вопросы?
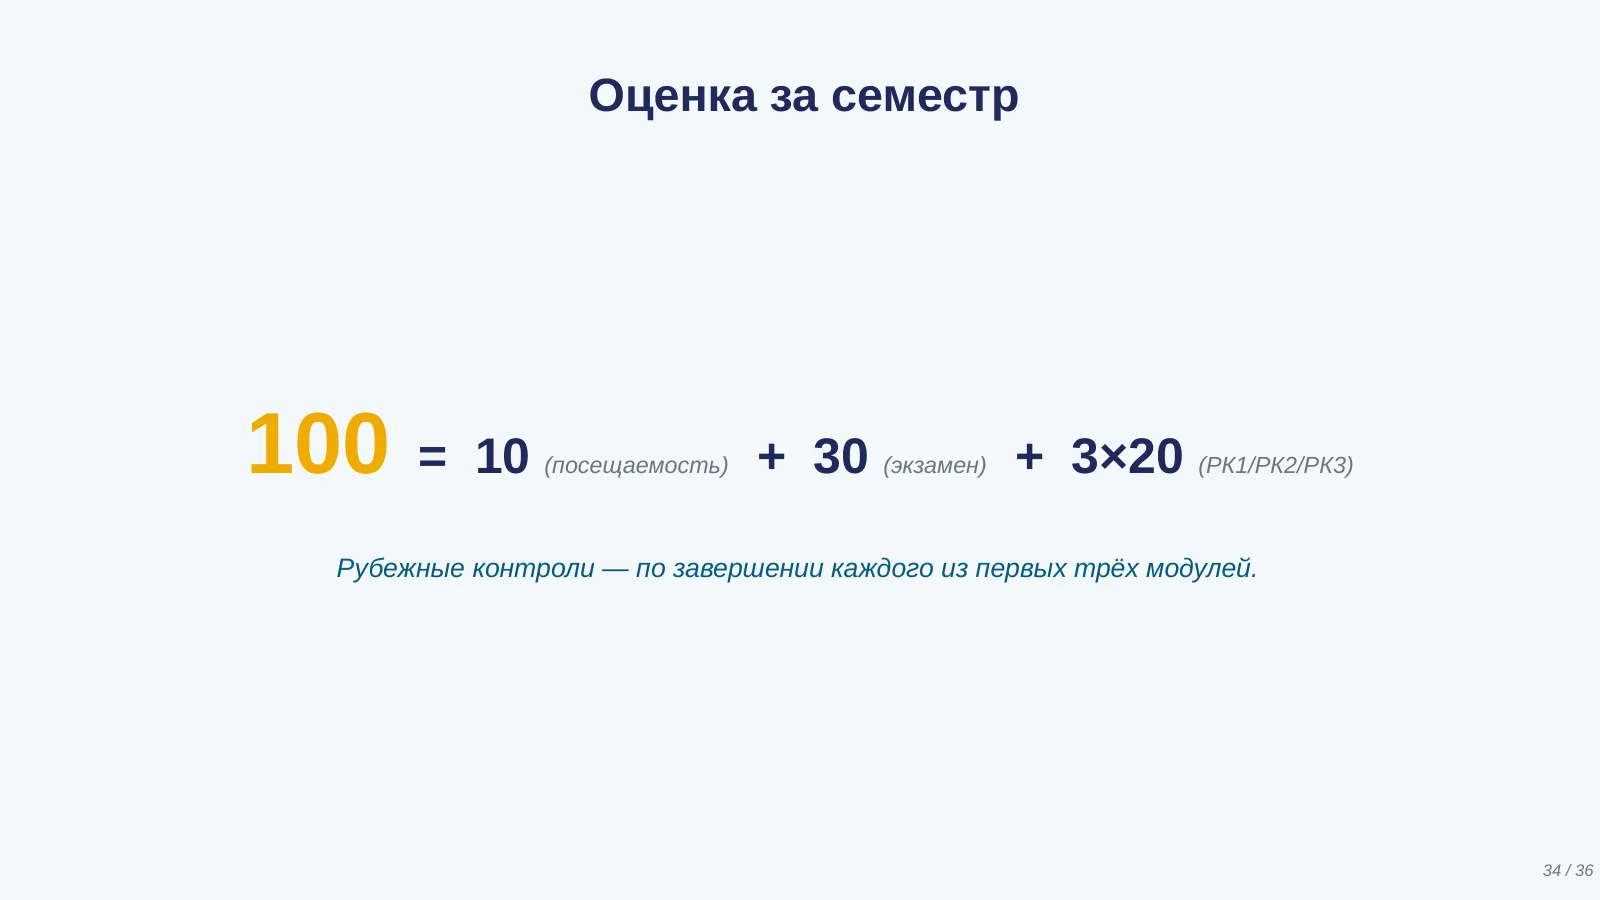
«На этом основная часть того, что мы с вами сегодня прошли. Дальше вопросы.
Что хорошо спросить: уточнения по типам реализации; куда отнести ваш инструмент по чек-листу; границы— если был опыт галлюцинаций или утечки; план семестра.
Кто начнёт?
Отвечу на самый частый вопрос. Можно ли пользоваться AI прямо сейчас? Можно. Чек-лист уже даёт инструмент.
Если что-то останется неясным после занятия— мои контакты были на слайде с визиткой в начале лекции, пишите смело.
Спасибо за внимание.»