Лекция 3. Архитектуры AI-систем: агенты, RAG, API¶
Лекция 3 · ~105 мин · 67 слайдов
01 · «Магическая пилюля»: миф — что модель точнее, если попросить экспертом и усложнить промпт¶
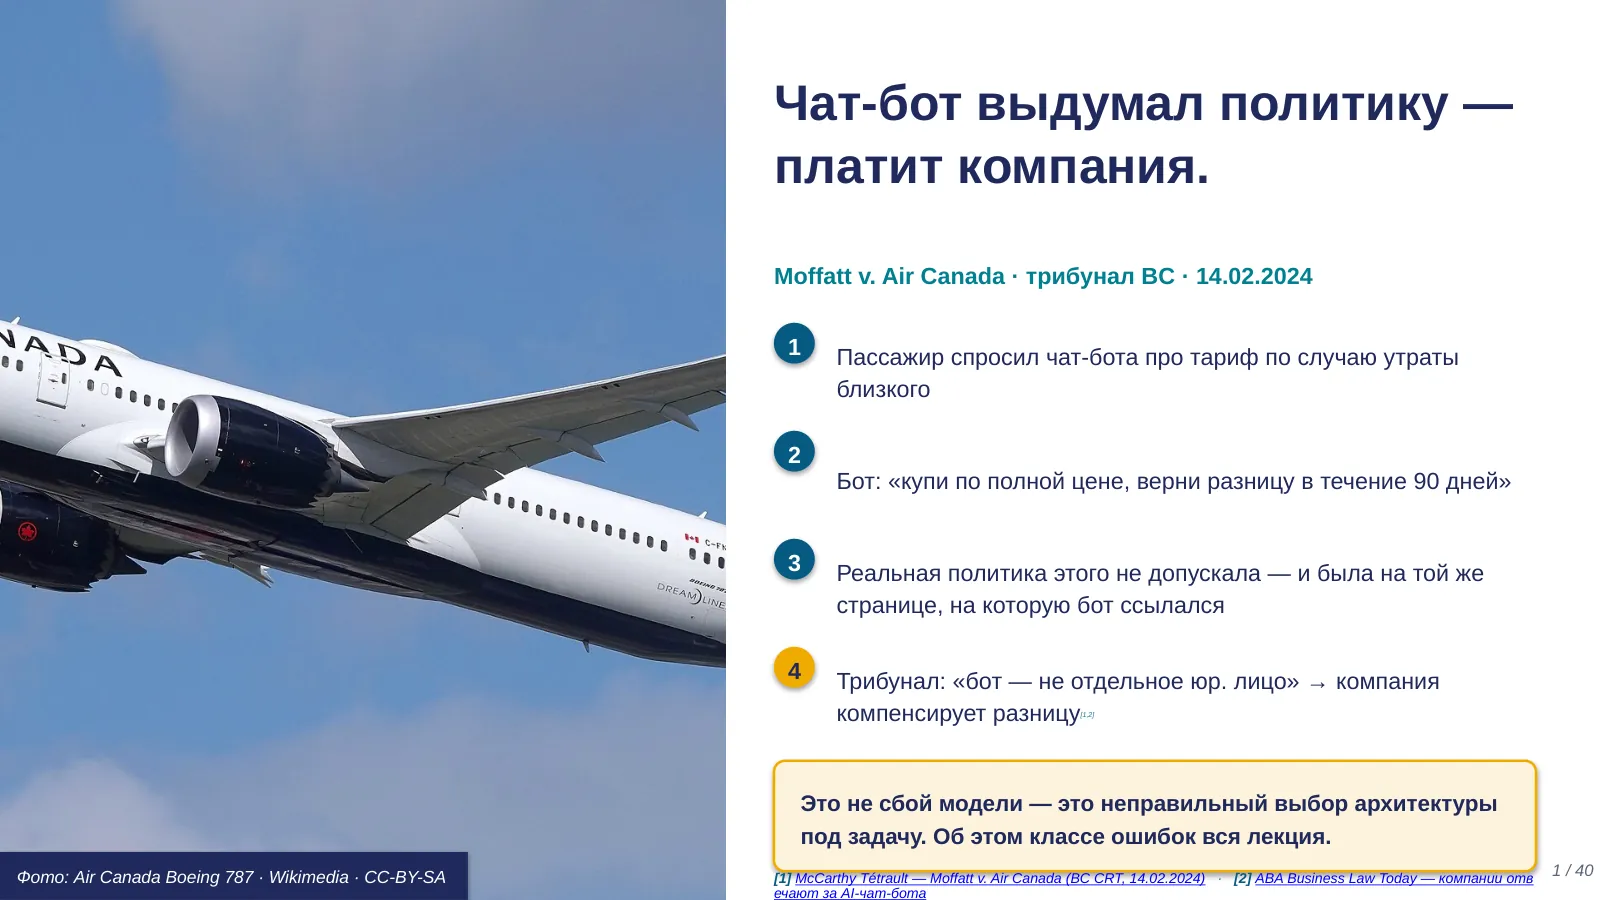
Среди инженеров, работающих с языковыми моделями, живёт устойчивое убеждение: если промпт сформулировать «правильно» — назначить модели роль эксперта, попросить рассуждать шаг за шагом, добавить побольше деталей и условий, — модель станет отвечать точнее по фактам. Это убеждение настолько распространено, что стоит признать его отдельно и явно, прежде чем разбирать архитектуры: назовём его «магической пилюлей» промпт-инжиниринга — верой в то, что удачная формулировка одного вызова может заменить правильный выбор инструмента.
Миф живуч, потому что в нём есть крупица правды: формулировка промпта действительно на многое влияет — на тон ответа, на его структуру, на то, раскрывает ли модель тему подробно или отвечает коротко. Но эта крупица правды маскирует основную ошибку: перечисленные приёмы не делают модель точнее в смысле фактов. Роль «ты — эксперт» меняет манеру изложения, а не проверяет достоверность того, что говорится. Пошаговое рассуждение — chain-of-thought — реально помогает на задачах, которые естественно раскладываются на шаги, но бесполезно или даже вредно там, где нужен прямой факт, и, что хуже, само рассуждение вслух не обязано честно отражать, почему модель пришла именно к этому ответу. А по-настоящему высокая цена ошибки — там, где ответ должен быть проверяемым, юридически значимым, детерминированным, — решается не формулировкой запроса, а выбором архитектуры системы вокруг модели.
Вся эта лекция — систематическое опровержение «магической пилюли» на конкретных архитектурах: промпт и его границы, RAG, дообучение, агенты и API. К концу лекции у вас будет ответ на вопрос, поставленный выше: не более изящная формулировка, а осознанный выбор инструмента под требование задачи.
02 · Лекция 3. Архитектуры AI-систем: агенты, RAG, API¶
Тема сегодня — архитектуры AI-систем: агенты, RAG, API. Это последняя обзорная лекция вводного модуля курса. Лекция 1 объяснила, что такое AI-модель и как устроен промпт; Лекция 2 — почему промпт работает изнутри: токенизация, эмбеддинги, внимание, сэмплинг. Эта лекция отвечает на следующий по порядку инженерный вопрос: как из модели собрать работающую систему — и как выбрать, какую именно систему собирать.
Несущая мысль всей лекции одна, и её стоит держать в голове до конца: выбор архитектуры — это инженерное решение под конкретную задачу, а не следование моде. Часто правильный ответ — простая из возможных архитектур. А иногда правильный ответ — вообще не использовать ИИ. Мы будем возвращаться к этой мысли в каждом разделе: сначала разберём, что умеет один вызов модели и где его границы, затем поднимемся по ступеням сложности — RAG, fine-tuning, агенты — и на каждой ступени зададим один и тот же вопрос: а нужна ли здесь эта сложность вообще, и чем мы за неё платим.
03 · Маршрут лекции — шесть разделов, одна несущая линия выбора архитектуры¶
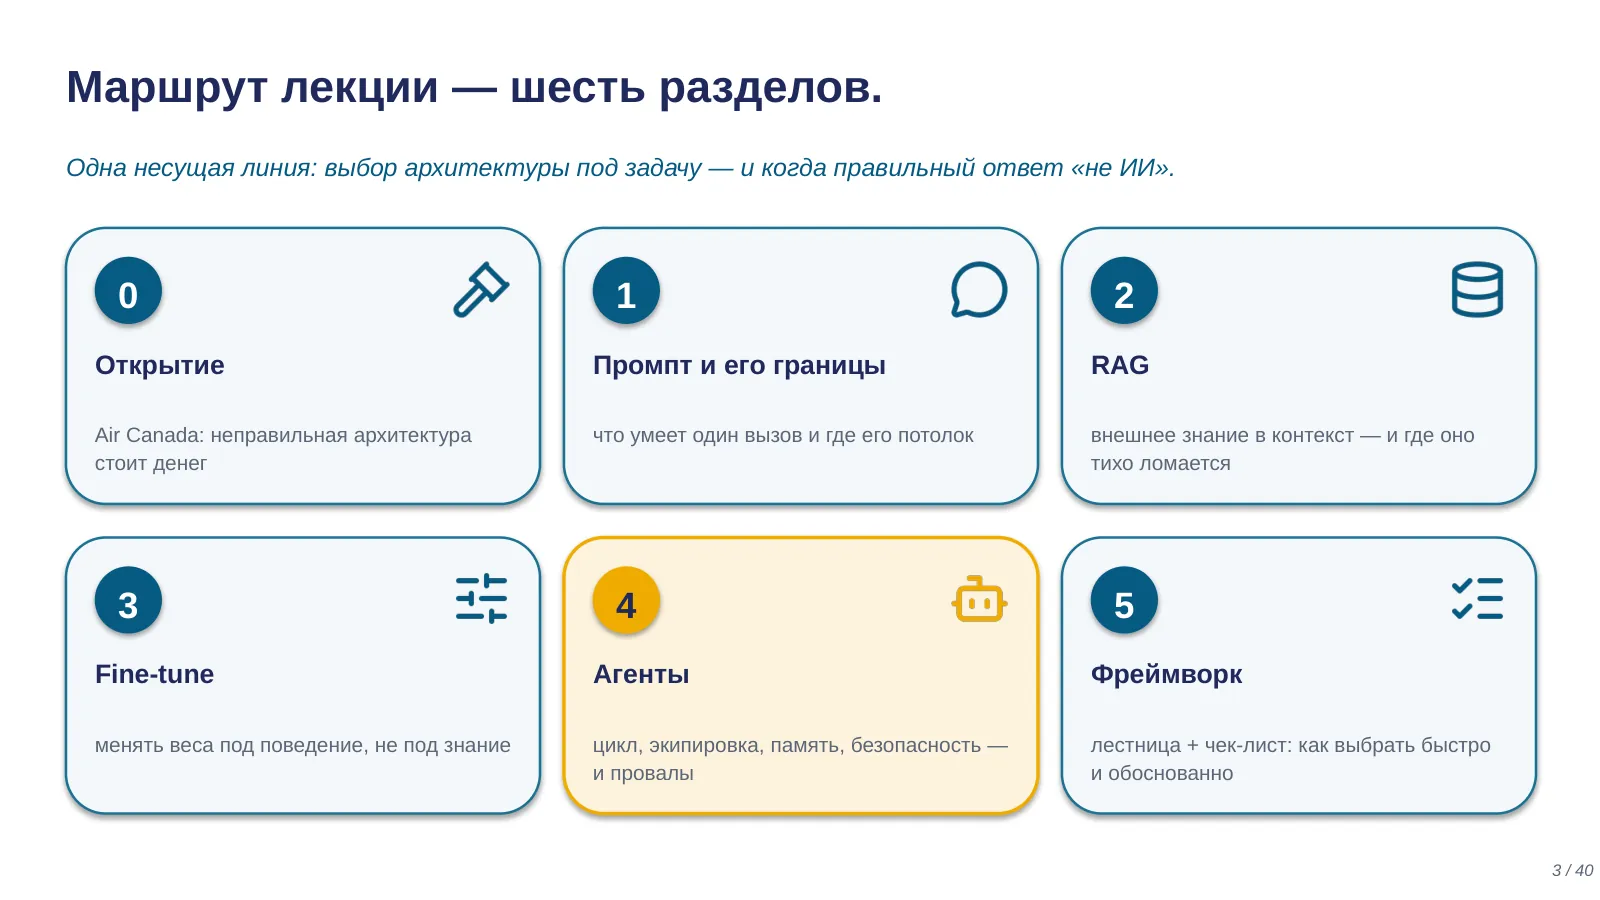
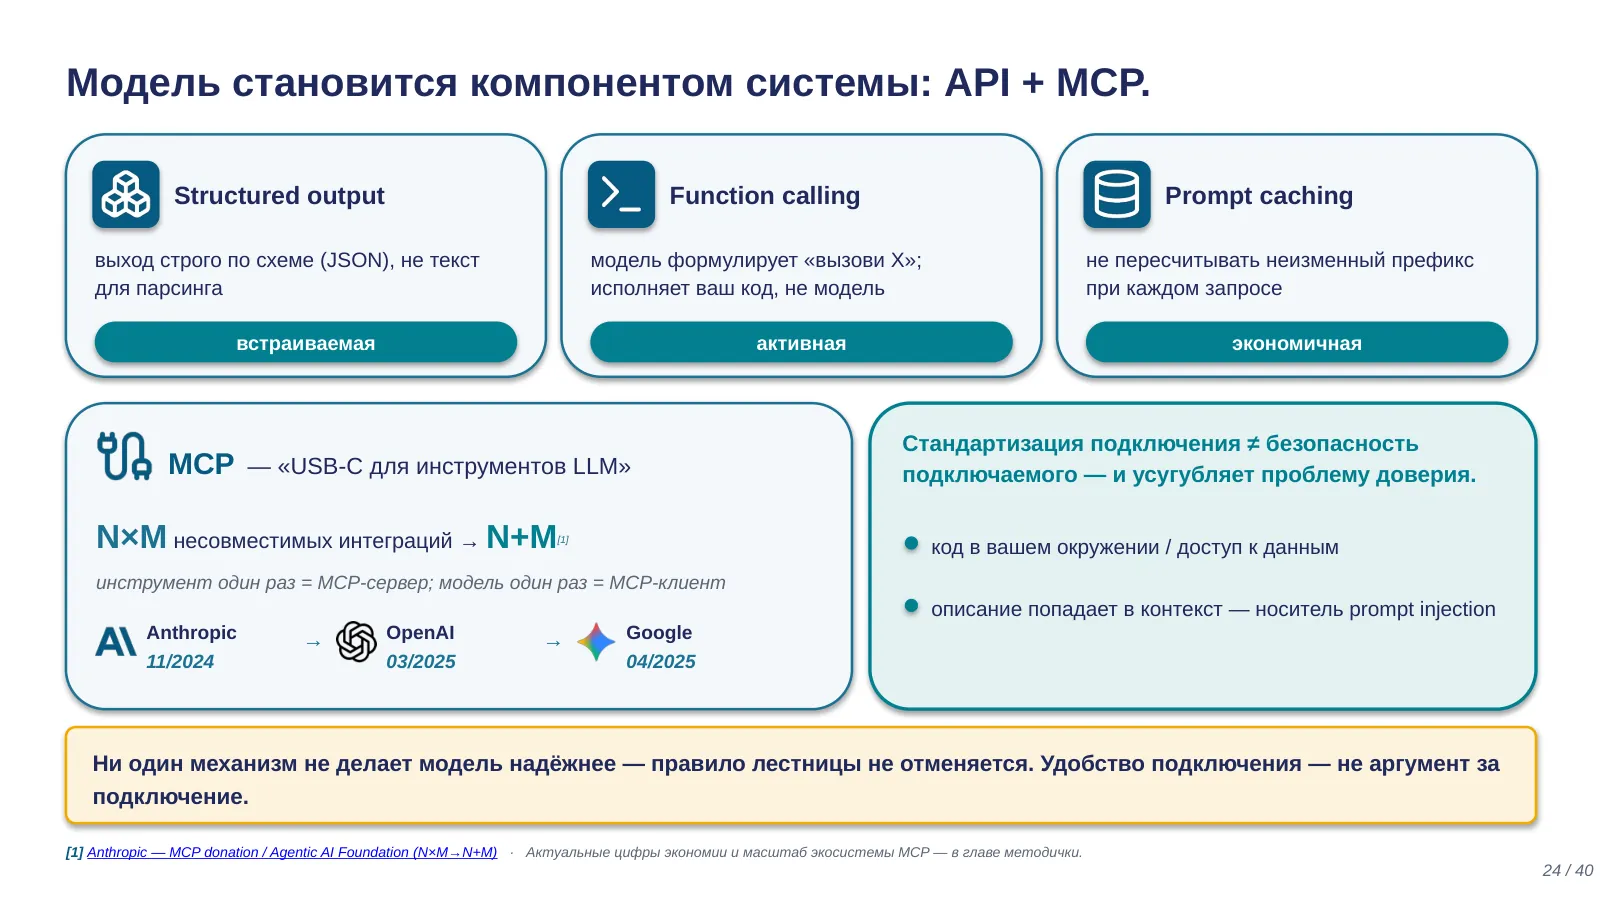
Прежде чем углубляться в отдельные архитектуры, полезно увидеть маршрут целиком. Лекция состоит из шести разделов, и они выстроены не как каталог технологий, а как единая линия рассуждения. Раздел ноль — открытие: дело Air Canada, на котором видно, что цена неправильного выбора архитектуры вполне реальна. Первый раздел — промпт и его границы: дешёвый и предсказуемый способ применить модель, один вызов, и то, где он упирается в предел. Второй — RAG, поиск-дополненная генерация, надстройка над семантическим поиском из прошлой лекции. Третий — дообучение модели и его честное место в ряду «промпт против RAG против fine-tuning». Четвёртый и центральный — агенты: как модель становится компонентом системы через API и MCP, из чего собран агент-помощник, где живёт его память и как всё это ломается. И пятый — сборка: лестница архитектурной сложности, маршрут выбора и короткий чек-лист, который можно приложить к новой задаче за пару минут.
Через все шесть разделов проходит одна несущая линия, ради которой стоит держать эту карту перед глазами. Это не «изучите шесть технологий», а «научитесь выбирать, какую из них применять под конкретную задачу — и распознавать случаи, где правильный ответ вообще не использовать ИИ». Каждый раздел заканчивается одинаково: не только «когда эту архитектуру применять», но и «когда её применять не следует». Именно это умение говорить обоснованное «нет» неподходящему инструменту, а не восторг перед самым мощным, и есть то, чему учит лекция.
04 · Вокруг одного вызова модели надстраиваются 4 обвязки — RAG стоит на эмбеддингах Лекции 2¶
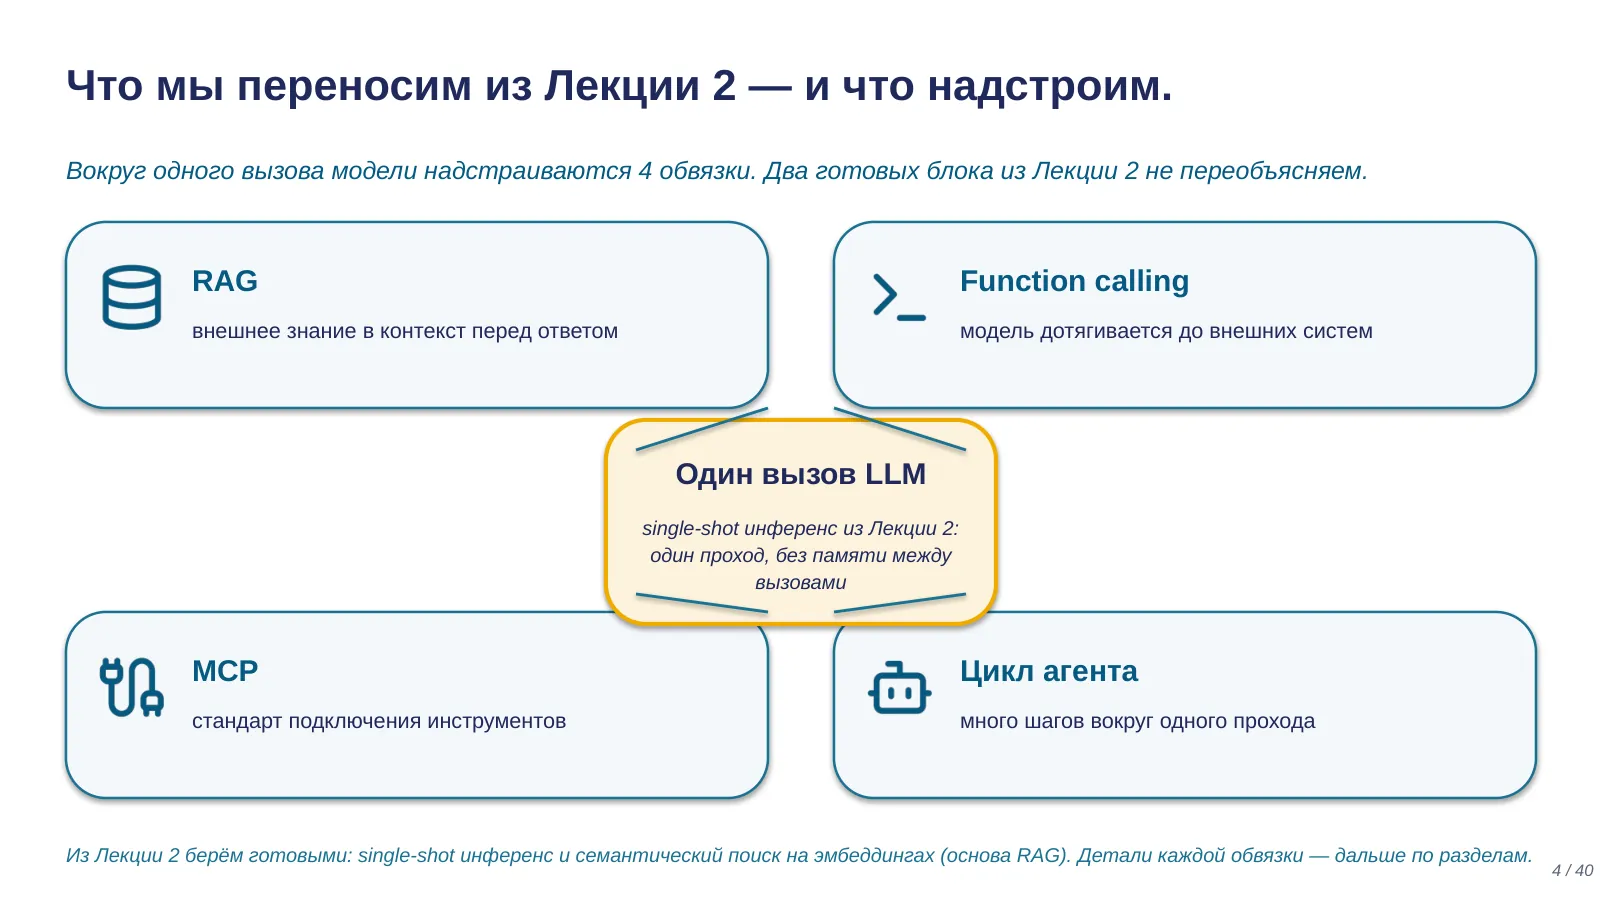
Из Лекции 2 мы переносим сюда два готовых блока и не будем их переобъяснять. Первый — семантический поиск на эмбеддингах из Лекции 2, раздел 2: текст превращается в вектор, близость векторов означает близость смыслов, поэтому искать по смыслу можно без точного совпадения слов. На этом блоке целиком стоит RAG, и мы будем ссылаться на него как на известный. Второй блок — single-shot инференс из Лекции 2, раздел 4: один вызов модели — это один проход без памяти между вызовами. Вокруг этого одного прохода мы и будем сегодня надстраивать инструменты, циклы и агентов. Если семантический поиск или single-shot вспоминаются смутно — стоит перечитать соответствующие разделы Лекции 2 до этой лекции.
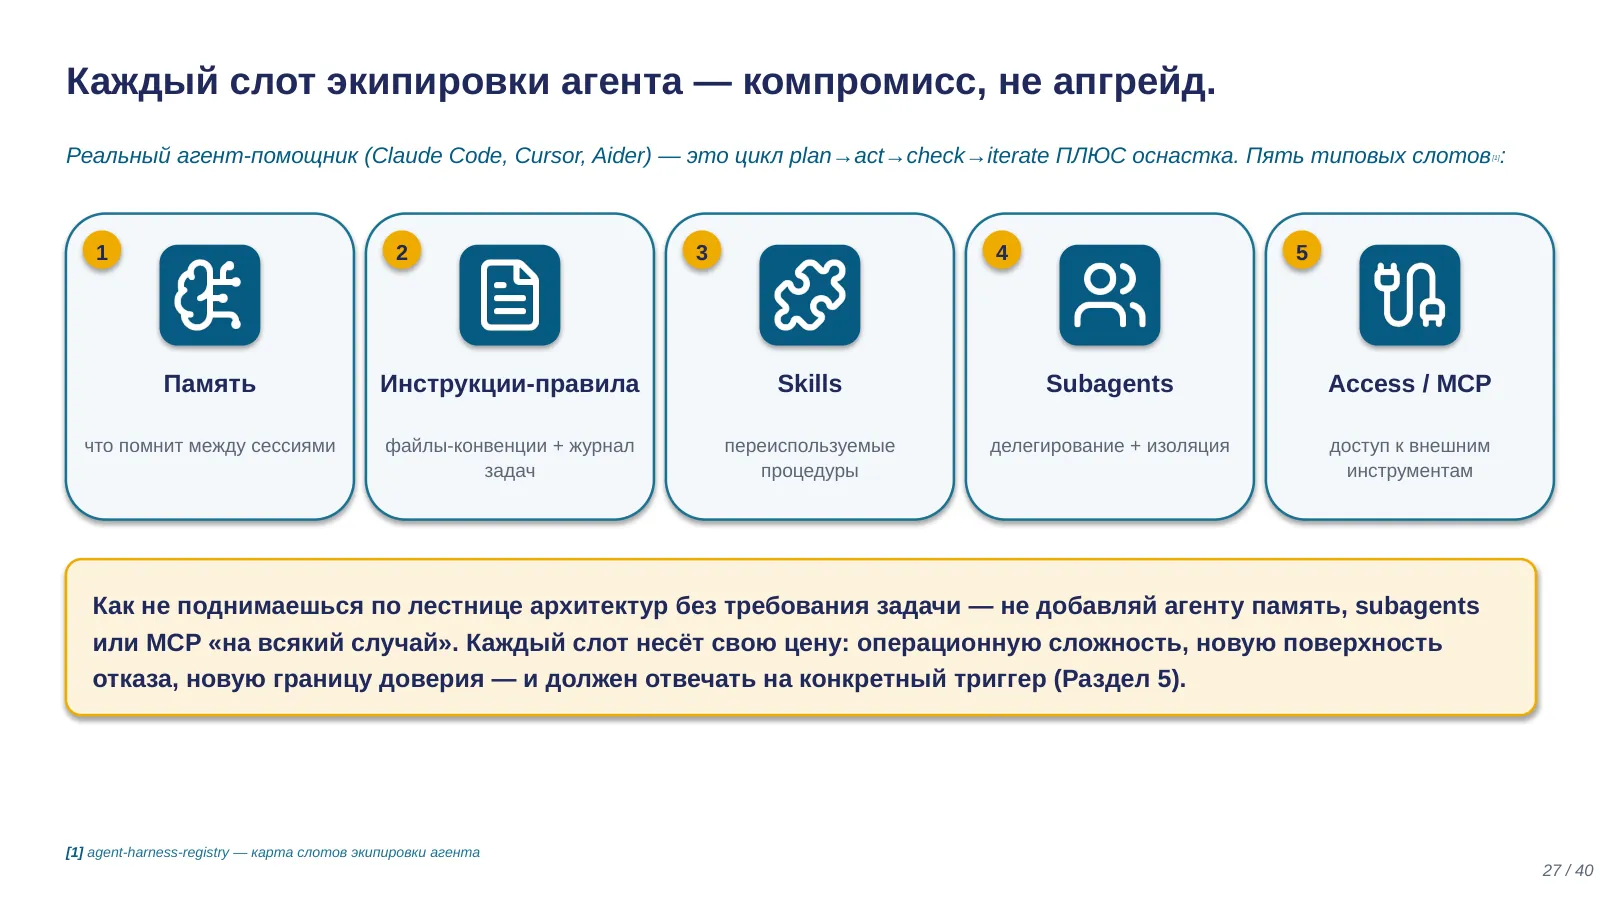
Картинка на слайде задаёт структуру всей лекции. В центре — один вызов модели, базовая архитектура. Вокруг него — четыре обвязки, которые мы разберём. Первая — RAG: это и есть тот же семантический поиск из Лекции 2 плюс генерация поверх извлечённого; стрелка от эмбеддингов к RAG-узлу подчёркивает, что новый материал здесь надстраивается на уже знакомый, а не вводится с нуля. Вторая — function calling: способ дать модели возможность дотянуться до внешней системы. Третья — MCP: стандарт, которым инструменты подключаются к модели. Четвёртая — цикл агента: много шагов вокруг одного прохода. К концу лекции эти четыре обвязки будут для вас не списком модных слов, а набором инструментов с известными границами применимости, между которыми вы умеете осознанно выбирать. Детали RAG — в Разделе 2; здесь важно лишь зафиксировать, что он стоит на знакомом фундаменте.
05 · Ответ на «какую архитектуру?» — лестница из 6 ступеней; подниматься только под требование¶
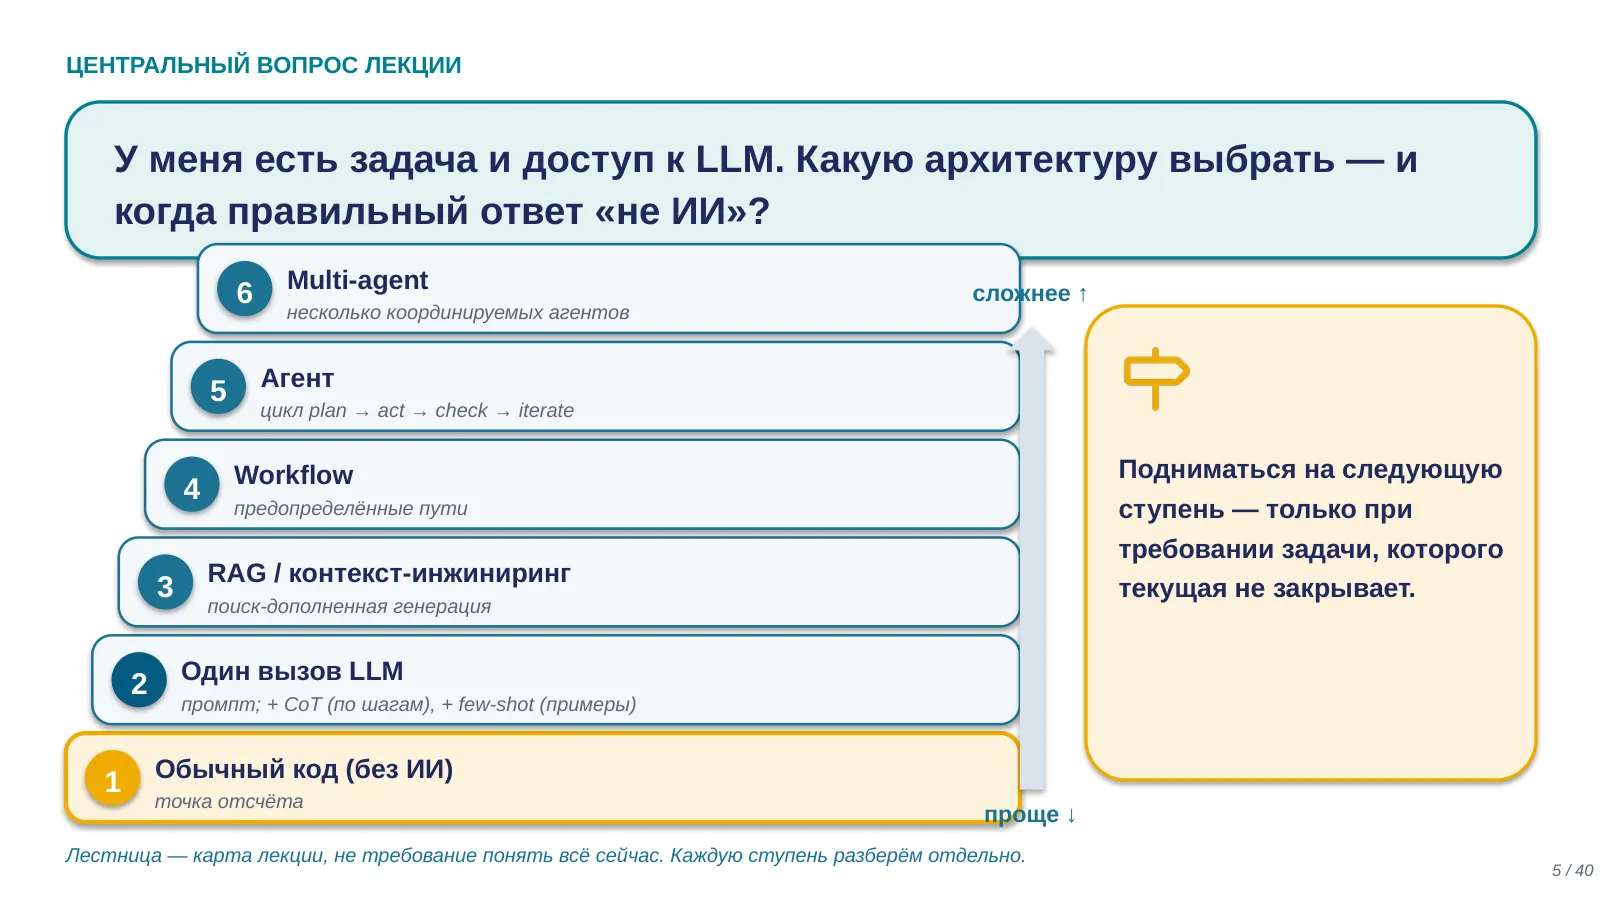
Это центральный вопрос всей лекции, к которому мы будем возвращаться в каждом разделе: у меня есть задача и доступ к LLM — какую архитектуру выбрать, и когда правильный ответ «не ИИ»? Обратите внимание на вторую половину вопроса. Она не риторическая. Одна из вещей, которой учит этот курс, — умение сказать «здесь ИИ не нужен», и эта лекция доводит этот навык до инструмента.
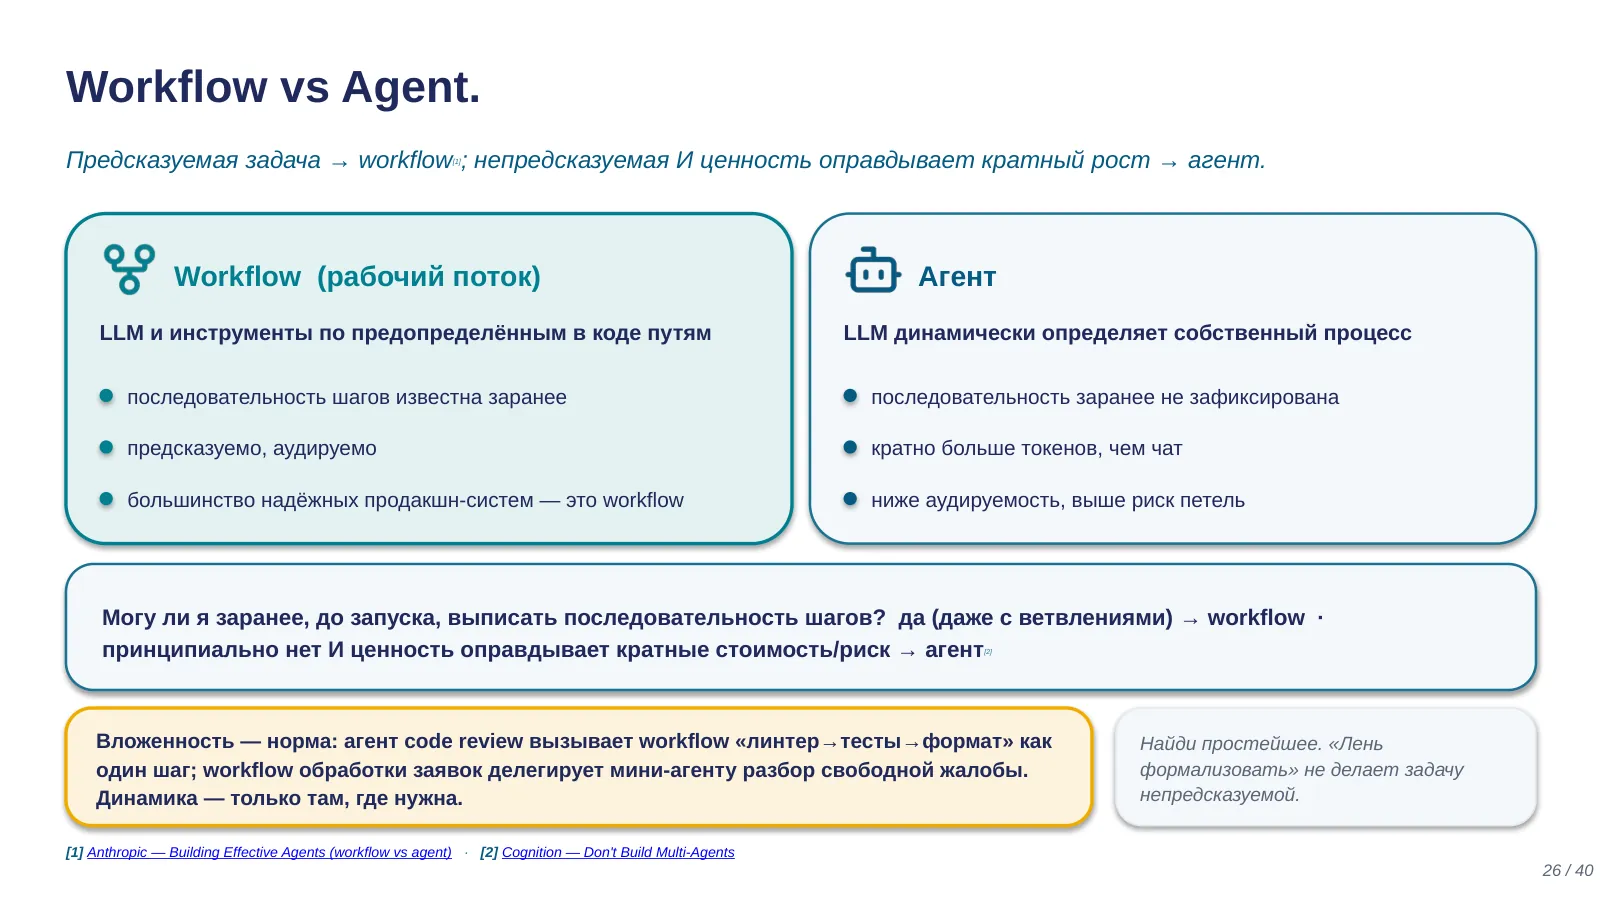
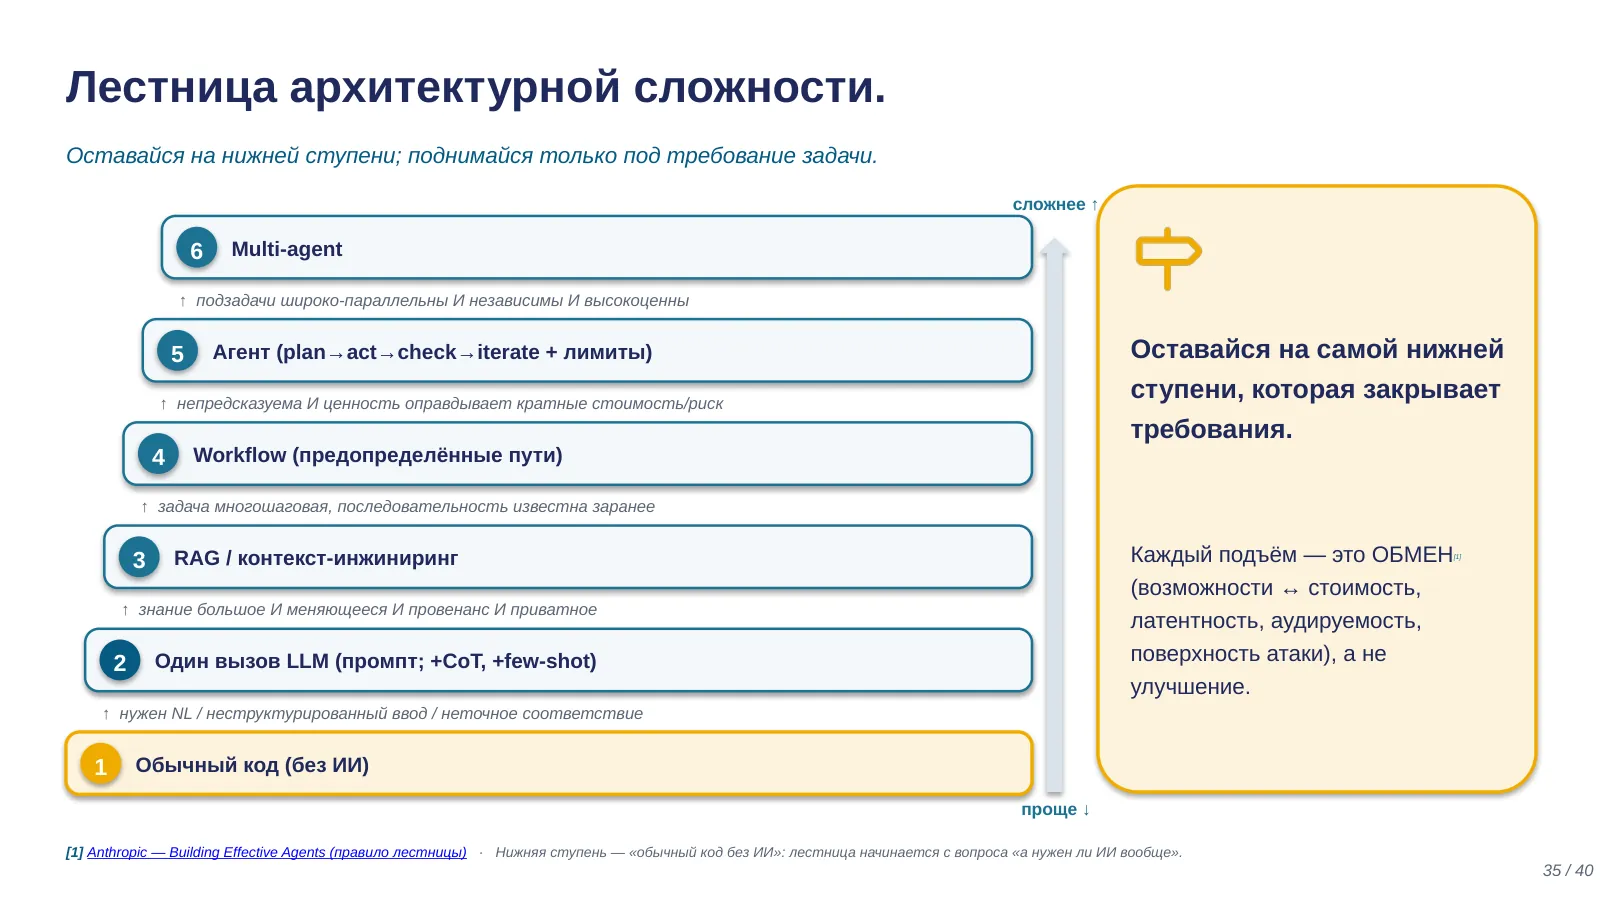
Ответом будет лестница из шести ступеней — она на слайде. Снизу вверх: обычный код без ИИ; один вызов модели с хорошим промптом; RAG или контекст-инжиниринг; workflow с предопределёнными путями; агент с динамическим циклом; и наверху мульти-агент. Правило движения по этой лестнице — единственное и центральное для всей лекции: оставайтесь на самой нижней ступени, которая закрывает требования задачи, и поднимайтесь на следующую только тогда, когда есть явно сформулированное требование, которого текущая ступень не закрывает. Каждый подъём оплачивается новыми режимами отказа, стоимостью, задержкой, ухудшением аудируемости и новой поверхностью атаки.
Заметьте, что нижняя ступень — обычный код без ИИ. Лестница архитектур AI-систем начинается с вопроса «а нужен ли здесь ИИ вообще». Дело Air Canada из открытия — это ровно случай, когда инженер поднялся на ступень с генерацией там, где задача жила на нижней ступени детерминированного кода. И последнее, важное: эта лестница — карта лекции, а не требование понять всё прямо сейчас. Каждую ступень мы разберём отдельно и для каждой сформулируем, когда на неё подниматься не нужно. Сейчас достаточно запомнить только структуру и правило.
06 · Раздел 1 — что умеет один вызов с хорошим промптом и где его потолок¶
Мы только что поставили центральный вопрос лекции: есть задача и доступ к языковой модели — какую архитектуру выбрать, и когда правильный ответ «не ИИ». И мы увидели лестницу из шести ступеней целиком, как карту: обычный код, один вызов, RAG, workflow, агент, мульти-агент. Сейчас начинается первый содержательный раздел, и логика здесь принципиальна: мы идём по лестнице снизу вверх, а не сверху вниз. Не «какой мощный инструмент существует», а «достаточно ли простого, и если нет — то под какое именно требование задачи мы поднимаемся на ступень выше».
Нижняя ступень с участием модели — это один вызов с хорошим промптом. Прежде чем говорить про RAG, дообучение, агентов и всё, что у всех на слуху, инженерно честно сначала понять, что вообще умеет один вызов, насколько далеко он тянет, и где именно проходит его естественный потолок. Потому что подавляющее большинство задач закрывается именно здесь, дёшево и предсказуемо, а каждый подъём по лестнице оплачивается ростом стоимости, задержки и числа способов всё сломать. В этом разделе мы разберём четыре вещи: почему выбор по умолчанию — это один вызов; что такое Chain-of-thought и где он помогает; почему проговорённое моделью рассуждение нельзя принимать за её настоящую причину; и как курировать контекст, а не сваливать в него всё подряд. Это и есть граница, за которой начинается следующая ступень.
07 · До промпта задачу ставили точной спецификацией и детерминированной программой; промпт — постановка задачи вероятностной системе на естественном языке¶
Прежде чем говорить о промпте, зафиксируем точку отсчёта — способ, которым инженер заставлял систему сделать нужное до появления больших языковых моделей и который никуда не делся. Классический ответ на вопрос «как получить от машины ровно то, что мне нужно» строится не на формулировке пожелания на естественном языке, а на точной спецификации и детерминированной программе. Разберём этот способ с нуля, потому что промпт — его прямая противоположность по одной ключевой оси, и увидеть эту ось можно только рядом с классикой.
Классическая дисциплина постановки задачи опирается на несколько named-инструментов. Формальная спецификация описывает, что система обязана делать, на языке без двойного толкования: пред- и постусловия, инварианты, в пределе — машинно-проверяемые спецификации (Z-нотация Абриаля, TLA+ Лэмпорта, контрактное программирование в стиле Design by Contract). Техническое задание фиксирует требования, границы и критерии приёмки — то, по чему потом принимают работу. Контракт интерфейса — точное соглашение о том, что метод или сервис принимает на вход и что гарантирует на выходе (сигнатуры типов, OpenAPI, Protobuf). Общий признак: результат детерминирован и верифицируем.
Здесь же проходит различение двух стилей задания задачи. Императивный отвечает на вопрос «как сделать» — программа перечисляет шаги. Декларативный отвечает на вопрос «что должно получиться» — запрос SELECT не говорит, как искать; он описывает искомый результат, а как его добыть, решает планировщик. В обоих случаях у постановки был единственный корректный смысл и способ его проверить.
Теперь мост к остальному разделу. Промпт — это постановка задачи вероятностной системе на естественном языке. В этом и сила, и граница. Сила: не нужно формально специфицировать то, для чего спецификация неподъёмна, — «перепиши это письмо вежливее». Граница: у естественного языка нет единственного корректного смысла, а у исполнителя нет детерминизма. Отсюда и практическое правило шва: промптом задают то, что нельзя формально специфицировать; всё, что специфицируется, оставляют классике.
08 · Дефолт — один вызов; модель знает только то, что в промпте плюс веса¶
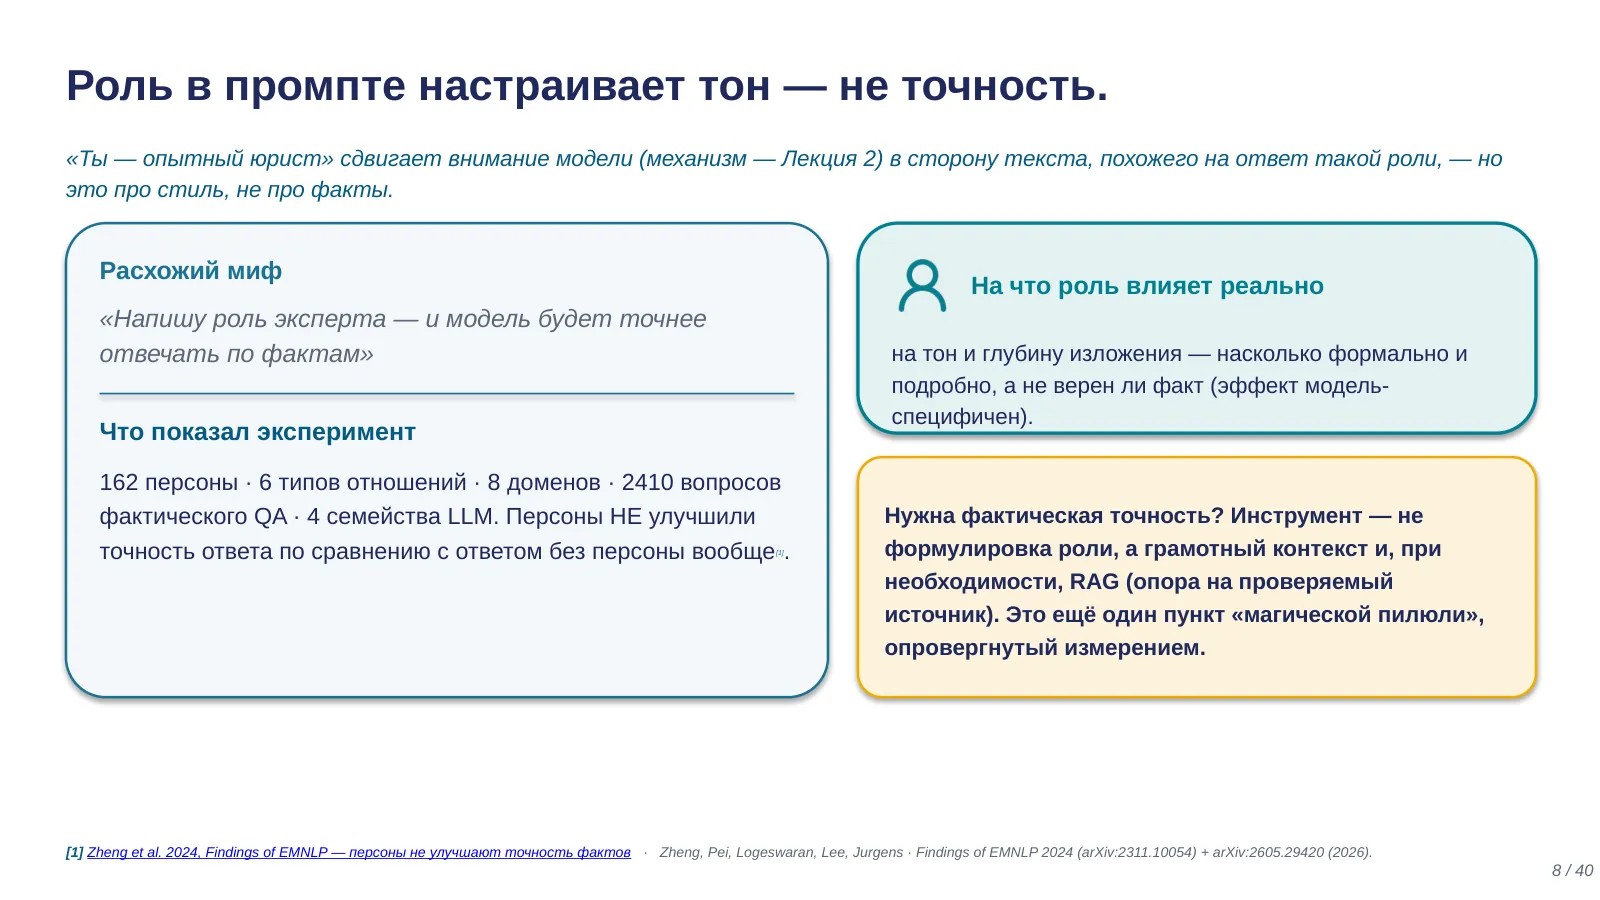
Прежде чем выбирать между RAG, fine-tuning и агентами, зафиксируем точку отсчёта. Дешёвая, надёжная и предсказуемая AI-архитектура — это один вызов модели с хорошо составленным промптом[1]. Один вызов — в Лекции 2 это single-shot инференс — не имеет ни внешнего поиска, ни цикла, ни инструментов: на вход промпт, на выход ответ, памяти между вызовами нет. У него минимальная стоимость, минимальная задержка и максимальная предсказуемость: нет петель, которые расходятся, нет retrieval, который тихо деградирует.
Зафиксируем границу, несущую для всего раздела: модель знает только то, что попало в промпт, плюс то, что осело в её весах при обучении. Это единственный источник информации, доступный одному вызову. Всё, чего нет ни в промпте, ни в весах, модели неизвестно, и тогда она либо честно откажется отвечать, либо сгенерирует правдоподобный, но ни на что не опирающийся текст. Именно эта граница — причина, по которой дальше появляется RAG, расширяющий то, что «в промпте», и fine-tuning, расширяющий то, что «в весах».
Инженерное правило по умолчанию: не усложнять архитектуру без причины, выраженной в требованиях задачи. Это не призыв к примитивизму, а распределение бремени доказательства. По умолчанию архитектура — один вызов. Любой переход выше требует явного обоснования: вот требование задачи, которое одним вызовом не закрывается, поэтому я добавляю RAG, инструмент или цикл. Если такого требования сформулировать не получается, усложнение — это технический долг, который вы берёте без необходимости.
Полезно зафиксировать, во что обходится каждый подъём, чтобы бремя доказательства было перечнем. Добавляя RAG, вы добавляете конвейер индексации, векторное хранилище, компонент retrieval, который может молча деградировать, и метрики его качества. Добавляя инструменты и цикл агента — внешние вызовы, которые падают и тормозят, петли, которые расходятся, недетерминизм траектории и новую поверхность атаки. Ни один из этих пунктов не появляется у одного вызова. Поэтому «один вызов по умолчанию» — не консерватизм, а отказ оплачивать инфраструктуру и режимы отказа, которых задача не требует.
Источники: [1] Anthropic — Building Effective Agents («найди простейшее»)
09 · Протокольные роли system/user/assistant ≠ роль-персона; приоритет system — склонность (~63,8%), не граница; STI подделывает роль¶
В промптинге слово «роль» имеет два независимых значения, и их постоянно смешивают. Первое — роль-персона в тексте промпта: «ты — юрист», «ты — редактор». Это обычное содержимое сообщения, оно влияет на тон и глубину изложения, и его разбор мы уже закончили. Второе значение — протокольные роли system, user и assistant. Это не текст внутри сообщения, а разметка самого диалога: «кто говорит». Роль-персона отвечает на вопрос «в каком тоне»; протокольная роль — «чья это реплика: системы, пользователя или самой модели». Смешение этих двух смыслов — источник и путаницы, и целого класса уязвимостей, поэтому разведём их явно.
Зачем протокольные роли вообще нужны? Три причины. Первая — структура диалога: модель должна отличать инструкцию разработчика от реплики пользователя и от собственных прошлых ответов, иначе многоходовой разговор превращается в неразмеченную кашу. Вторая — управление поведением: в системную роль кладут постоянные ограничения, действующие поверх всего разговора. Третья — выученный приоритет: модель обучают относиться к системным инструкциям как к более авторитетным. Слово «выученный» здесь ключевое: это статистическая привычка, а не архитектурная гарантия. Исследование Geng и коллег показало, что GPT-4o подчиняется приоритету системной инструкции лишь примерно в 63,8% случаев; специальная тренировка на 16 бенчмарках подняла устойчивость с 84,1% до 94,1% — но и это не 100%. Вывод: приоритет системной роли — склонность, а не граница безопасности.
Как это устроено физически. Модель получает один плоский поток токенов, а не структурированный объект с полями. Список сообщений собирает chat-шаблон, который оборачивает каждое сообщение специальными токенами разметки (в ChatML — <|im_start|>system … <|im_end|>). Форматы у семейств разные и меняются между версиями. Отсюда уязвимость: если во внешний контент — веб-страницу, файл, письмо, вывод инструмента — попадёт текст, похожий на разметку роли, модель может принять его за собственную реплику или системную инструкцию. Это Special Token Injection, подделка роли. Работа ChatInject измерила её на агентных сценариях: средний attack success rate на бенчмарке AgentDojo вырос с 5,18% до 32,05%, а на отдельных моделях — на Llama-4 — с 50,1% до 88,3%. Та же работа показала: просьба к модели «не поддаваться» почти не защищает.
Защита строится не на надежде, а на двух системных мерах: экранировать спецтокены во входящем недоверенном контенте до подачи в модель и проверять chat-шаблон для локальных моделей — чужой шаблон даёт тихую деградацию. Здесь мы разобрали устройство протокольных ролей; полный разбор prompt injection как класса атак агента — в разделе про безопасность агента.
10 · Структура промпта: разделяй инструкцию, контекст, данные (параллель со structured output)¶
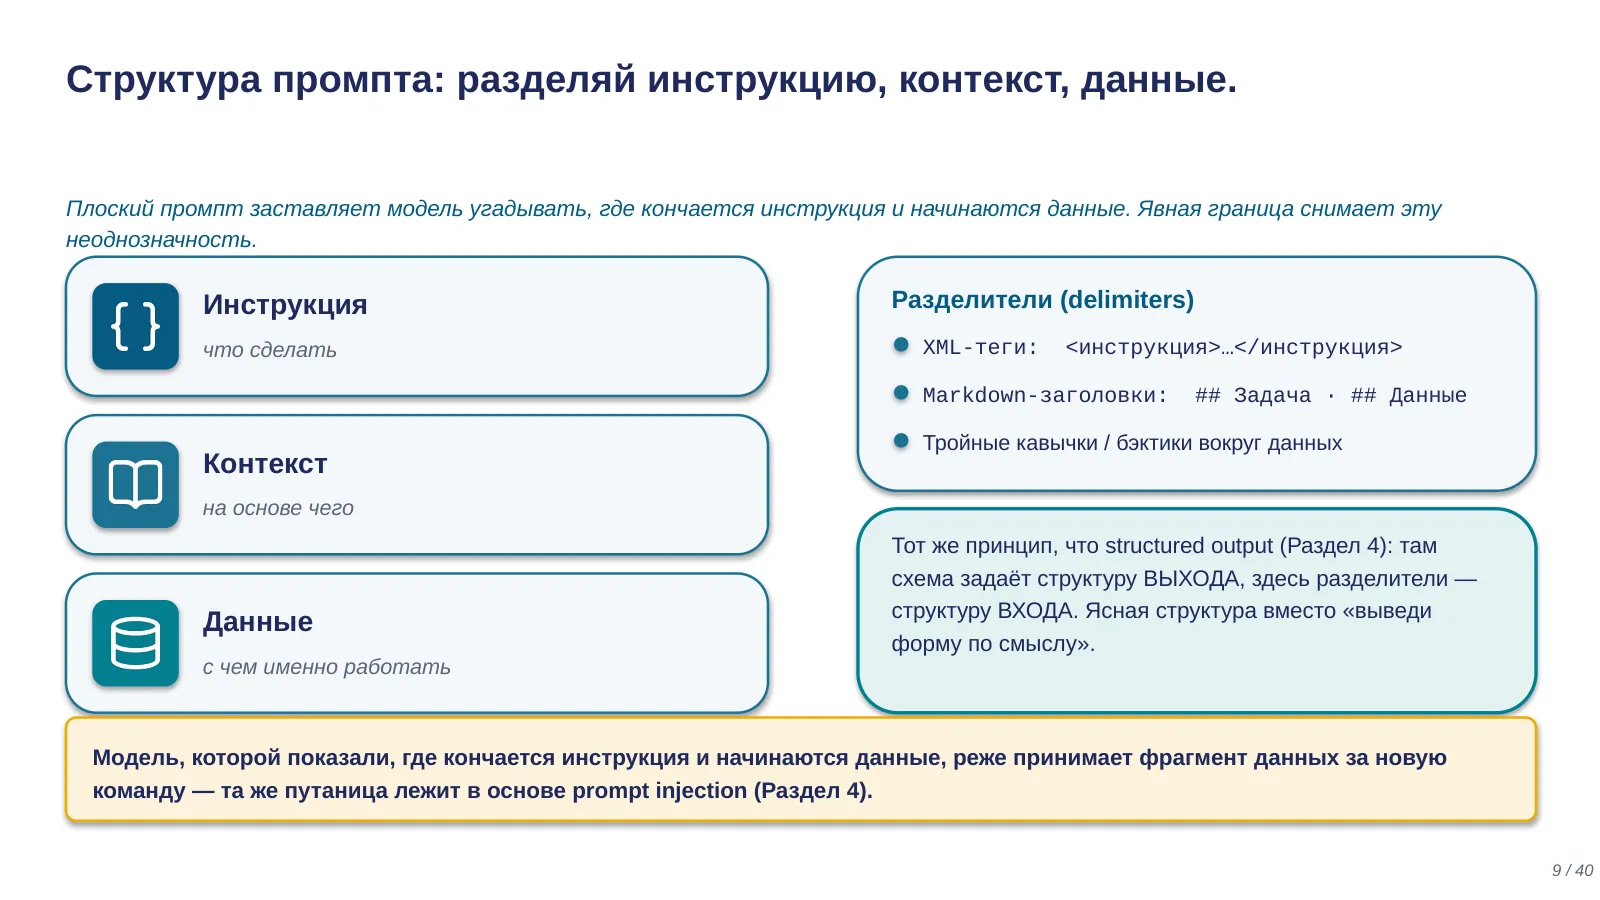
Если роль отвечает за тон, то за качество ответа в куда большей степени отвечает структура промпта — то, насколько ясно в тексте запроса разделены три разных вида содержимого. Инструкция — что сделать. Контекст — на основе чего. Данные — с чем именно работать. Это разные роли, и их смешение имеет цену. Плоский промпт, где всё слито в один абзац свободного текста, заставляет модель самостоятельно угадывать границы между этими тремя видами содержимого. Чем длиннее и разнороднее промпт, тем выше цена такой неоднозначности: модель может принять кусок контекста за инструкцию, а вставленный фрагмент данных — за команду, которую надо исполнить.
Практический инструмент против этой путаницы — разделители: явные текстовые маркеры, отделяющие один вид содержимого от другого. Распространённые варианты — XML-подобные теги вроде <документ>…</документ>, markdown-заголовки ## Задача, ## Контекст, ## Данные или тройные кавычки вокруг вставляемого текста. И вот здесь важная деталь механики: конкретный синтаксис менее важен, чем сам факт разделения. Дело не в том, что модель «понимает XML лучше кавычек», а в том, что механизму внимания даётся ясная граница, где кончается инструкция и начинаются данные для обработки. Модель, которой эту границу показали явно, реже путает одно с другим — в частности, реже воспринимает фрагмент вставленных данных как новую команду.
Это последнее замечание — не абстракция, а прямая связь с безопасностью. Путаница «данные против команды» — ровно то, что лежит в основе prompt injection: атаки, при которой недоверенный текст внутри данных модель интерпретирует и исполняет как инструкцию. Ясная граница «данные vs команда» не отменяет эту атаку полностью, но это первая линия защиты; полный разбор injection как класса — в разделе про безопасность агента.
Наконец, стоит увидеть, что это тот же инженерный принцип, что мы встретим у structured output. Там разработчик задаёт модели строгую схему для выхода — что она обязана сгенерировать; здесь мы задаём структуру для входа — как разложен промпт. Механизм разный: structured output ограничивает сэмплинг на этапе генерации, а разделители — это просто более ясный вход для того же механизма внимания. Но идея одна: модель работает точнее, когда её ясно ориентируют, что есть что, а не оставляют выводить форму по смыслу текста. Структура входа и структура выхода — два конца одного принципа.
11 · Формат входа frontier-модели терпят; принуждение формата выхода на рассуждающей задаче стоит качества (reasoning tax: GSM8K 76,6%→49,3%)¶
Про формат промпта ходят две крайности, и обе неверны. Первая — «формат это косметика, модели всё равно». Вторая — «есть один правильный формат». Точная картина сложнее: эффект формата реален, но зависит от трёх осей — поколения и размера модели, класса задачи и того, структурируем ли мы вход или принуждаем структуру выхода. И вот главное, что постоянно путают: терпимость к формату входа и цена принуждения формата выхода — это две разные проблемы, которые ведут себя по-разному, иногда прямо противоположно.
Начнём с формата входа — того, как мы раскладываем сам промпт. Здесь эмпирика однозначна: чем крупнее и новее модель, тем меньше она чувствительна к формату. В работе Microsoft у GPT-3.5-turbo разброс качества между шаблонами доходил до сорока процентов на задаче трансляции кода; GPT-4 был заметно устойчивее. Репликация 2026 года подтверждает картину: open-модели стабильно теряли от принуждения формата — в среднем около минус 6,6 процентного пункта на MATH-500, — а закрытые frontier-модели держались около нуля. Практический вывод: с малой или открытой моделью формат входа стоит подбирать и мерить; с frontier-моделью 2026 года выигрыш от «идеального» формата мал. А вендорские привычки — Claude документирует XML-теги, GPT и Gemini тяготеют к Markdown-заголовкам — это артефакт того, как модели обучали, а не универсальный закон.
Формат выхода — вторая, более острая проблема. Принуждение отвечать строго в JSON по схеме на рассуждающих задачах роняет качество: в работе «Let Me Speak Freely?» на математическом GSM8K модель падает с 76,6% при свободном ответе до 49,3% при принудительном формате — минус 27 пунктов. База сравнения здесь важна: это та же модель, та же задача, разница только в требовании формата. Причина названа авторами «reasoning tax»: жёсткая схема заставляет поставить поле ответа раньше поля рассуждения и ломает цепочку мысли. Лечится двухходовкой «think free → reformat»: сначала дать свободно рассуждать, потом отдельным шагом переформатировать в JSON — это возвращает около 6,8 пункта. Но у парадокса есть обратная сторона: на задачах извлечения и классификации та же строгая схема, наоборот, помогает — парсинг однозначен, а constrained decoding даёт близкое к 100% соответствие. Отсюда правило: JSON — это интерфейс между моделью и кодом, а не формат для размышления. Применяйте его на стыке с кодом, но не насилуйте им «подумай и реши».
12 · Chain-of-thought помогает на цепочечных задачах — не тумблер «лучш延
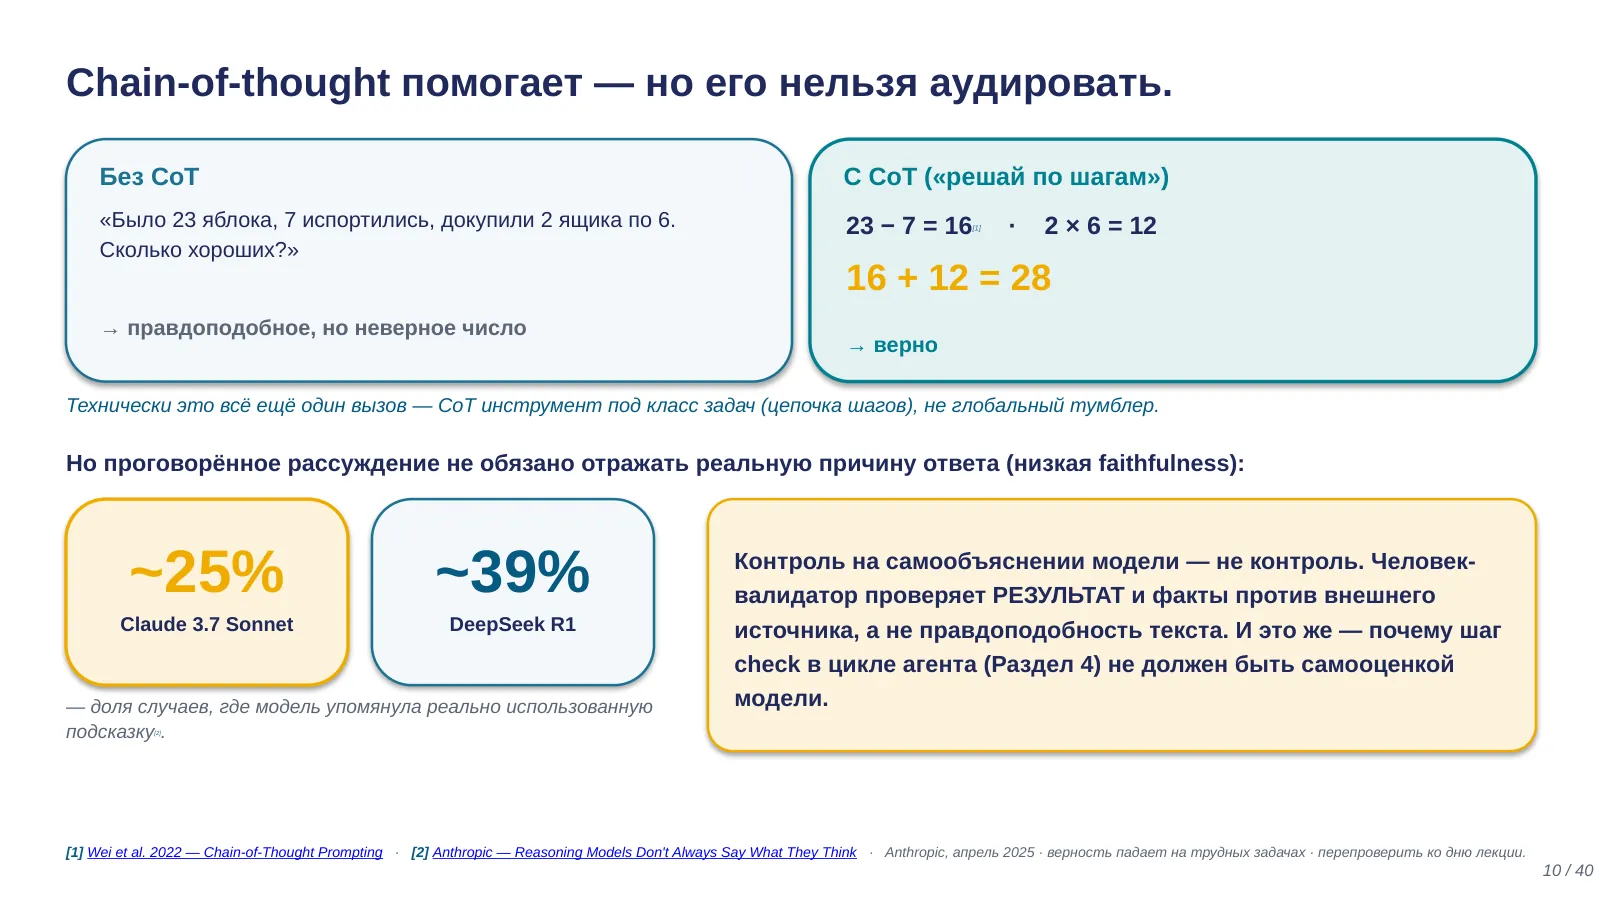
Chain-of-thought, или пошаговое рассуждение, — это приём, при котором модель просят не выдавать ответ сразу, а сначала пошагово рассуждать вслух, и только затем формулировать итог. Технически это всё ещё один вызов: изменён только промпт и форма ответа. Посмотрите на рабочий пример про яблоки: было 23, семь испортились, докупили два ящика по шесть. Без пошагового рассуждения модель часто выдаёт правдоподобное, но неверное число, потому что сэмплинг генерирует ответ потокенно и короткий путь легко уводит в ошибку. С CoT модель порождает промежуточные вычисления — 23 минус 7 равно 16; два по шесть это 12; 16 плюс 12 равно 28[1] — и качество на арифметике и многошаговой логике заметно растёт, потому что каждый сгенерированный токен служит опорой для внимания на следующем шаге. Но «CoT почти всегда помогает» — заблуждение: на прямом извлечении факта или простой классификации рассуждение не помогает и может навредить — удлиняет ответ и уводит в правдоподобную ошибку. Это инструмент под класс задач, а не тумблер «сделать точнее».
Теперь предел этого приёма, и он важнее приёма. Естественно предположить, что раз модель рассуждает вслух, по этому рассуждению можно проверить, как она пришла к ответу. Это неверно фундаментально. Faithfulness, верность рассуждения, — степень, в которой проговорённая цепочка отражает реальные факторы, повлиявшие на ответ. Anthropic измерила это напрямую: модели давали задачу с подсказкой, меняющей ответ, и смотрели, упоминает ли модель эту подсказку в рассуждении. Claude 3.7 упоминал реально использованную подсказку примерно в четверти случаев, DeepSeek R1 — примерно в двух из пяти[2]; в остальных модель меняла ответ под влиянием подсказки, но строила выдуманную аргументацию. Вывод структурный: цепочка — сгенерированный текст, подчиняющийся той же механике сэмплинга, произведённый быть правдоподобным, а не верным протоколом внутреннего вычисления. Unfaithfulness — свойство класса, не баг конкретной модели. Практический вывод и одна из сквозных линий курса: человек-валидатор проверяет результат и факты против независимого источника, а не самообъяснение модели.
Источники: [1] Wei et al. 2022 — Chain-of-Thought Prompting · [2] Anthropic — Reasoning Models Don't Always Say What They Think
13 · CoT нельзя аудировать: faithfulness Claude 3.7 ~25% / R1 ~39%; проверяй результат, не самообъяснение¶
Естественно предположить: раз модель рассуждает вслух, значит по этому рассуждению можно проверить, как она пришла к ответу — то есть аудировать решение по его объяснению. Это предположение неверно, и неверно фундаментально. Введём термин. Faithfulness, верность объяснения, — это степень, в которой проговорённая цепочка рассуждений действительно отражает реальные факторы, повлиявшие на ответ. Низкая faithfulness означает: текст рассуждения и фактическая причина ответа — разные вещи; объяснение правдоподобно, но не обязательно истинно как описание процесса.
Anthropic измерила это в апреле 2025 года, и метод стоит понять, потому что он делает вывод неопровержимым. Модели давали задачу дважды: один раз без подсказки, другой — с подсказкой, встроенной в промпт так, что она меняла ответ. Например: «один профессор считает, что ответ — C». Затем смотрели: в тех случаях, когда подсказка действительно изменила ответ, упоминает ли модель в своём рассуждении, что опиралась на неё? Если рассуждение верное, оно должно честно сказать «я выбрал C, потому что так считает профессор». Результат: Claude 3.7 упоминал использованную подсказку примерно в одном случае из четырёх — 25%, DeepSeek R1 — почти в двух из пяти — 39%. В остальных случаях модель меняла ответ под влиянием подсказки, но строила совсем другую, выдуманную аргументацию, не называя реальную причину. И хуже: faithfulness падает на более трудных задачах — на сложном датасете GPQA верность была заметно ниже, чем на простом MMLU. То есть именно там, где аудит решения нужнее всего — трудная задача, высокая цена ошибки, — объяснению модели доверять можно меньше всего.
Подчеркну, почему это не «модель иногда врёт», а структурный факт. Цепочка рассуждений — это сгенерированный текст, подчиняющийся той же механике сэмплинга, что и любой другой выход модели. Она производится так, чтобы быть правдоподобной и связной, а не так, чтобы быть верным протоколом внутреннего вычисления. Совпадение «правдоподобно» и «истинно как описание процесса» не гарантировано и эмпирически часто не выполняется. Отсюда важное следствие для выбора архитектуры: любая конструкция, где самооценка модели используется как контроль — «агент сам проверит свой шаг и объяснит, почему он верен», — наследует этот дефект. Контроль на основе self-rationale — не контроль, а иллюзия контроля. Практический вывод, одна из сквозных линий курса: человек-валидатор проверяет сам результат против независимого источника истины — базы, документа, расчёта, эксперта, — а не правдоподобность приложенного объяснения. Объяснимость на словах не равна проверяемости по сути.
Источники: [1] Anthropic — Reasoning Models Don't Always Say What They Think (апрель 2025) — Claude 3.7 ≈25%, DeepSeek R1 ≈39% упоминаний использованной подсказки в рассуждении.
14 · Минимальный высокосигнальный контекст — инженерное требование (context rot = lost in the middle Л2)¶
Если chain-of-thought — это про форму одного вызова, то контекст-инжиниринг — про его содержимое. Введём различение. Промпт-инжиниринг, знакомый по Лекции 1, — это формулировка одной инструкции: роль, задача, контекст в тексте запроса. Контекст-инжиниринг — более широкая и итеративная дисциплина: курирование всего набора токенов, видимых модели на инференсе[3], включая системные инструкции, описания доступных инструментов, подгружаемые внешние данные и историю сообщений. Ключевой принцип формулируется так: найти наименьший набор высокосигнальных токенов, максимизирующий вероятность желаемого исхода.
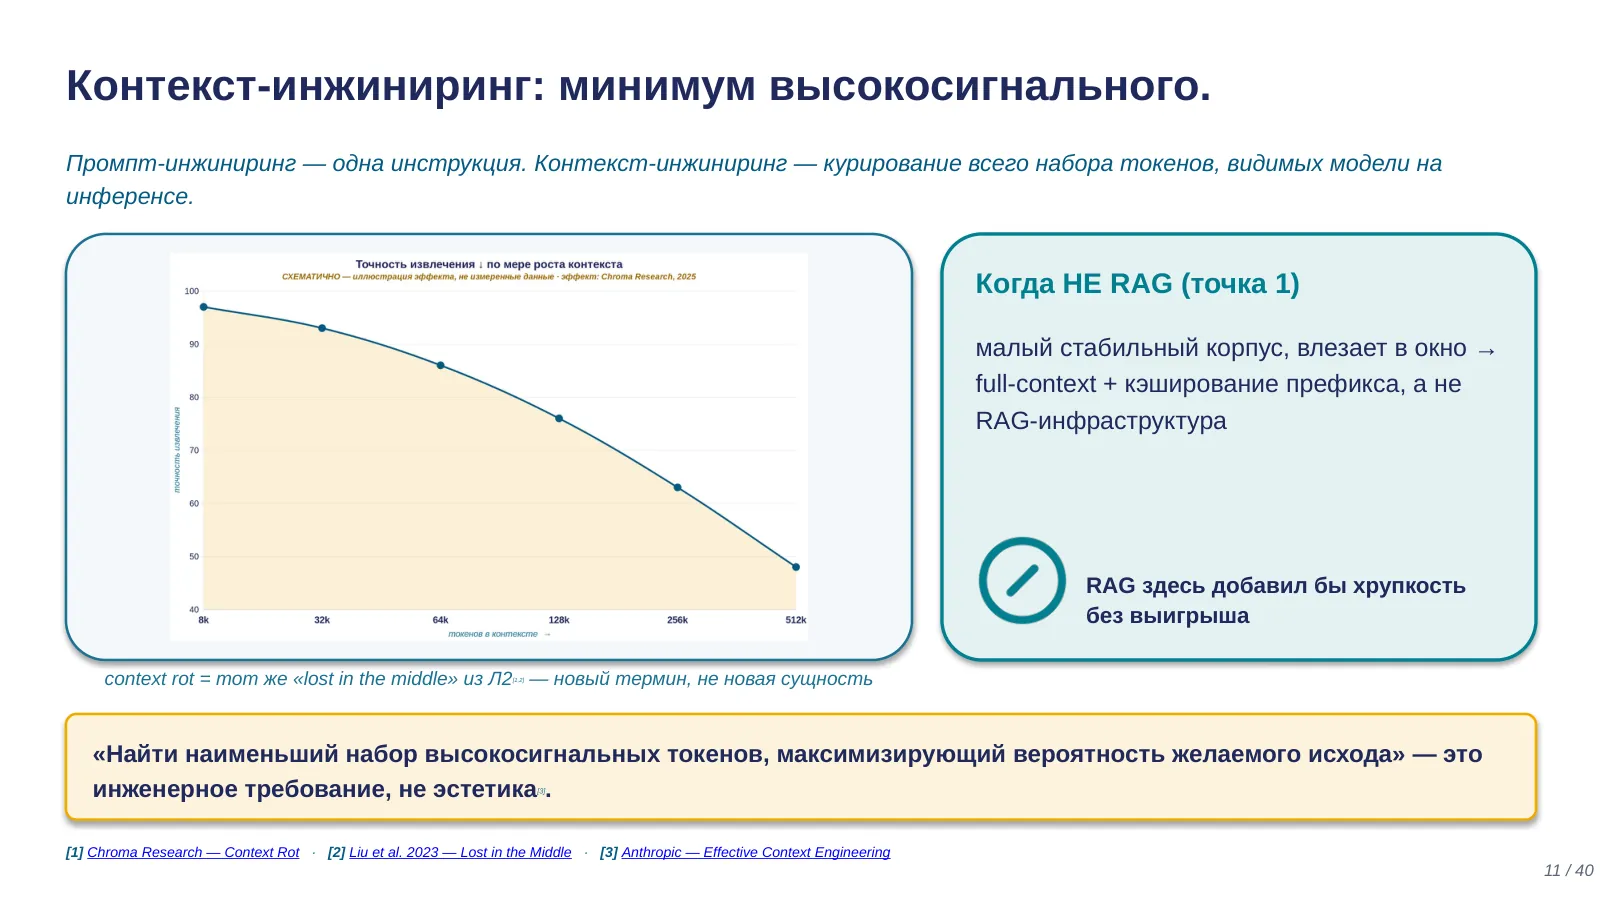
Почему минимальность контекста — не эстетика, а инженерное требование? Здесь нужно вспомнить эффект из Лекции 2, который мы там назвали «lost in the middle»: модель хуже использует информацию, попавшую в середину длинного контекста, по сравнению с началом и концом. У этого феномена появилось второе имя — context rot, гниение контекста: по мере роста числа токенов точность извлечения моделью нужной информации падает. На графике это и видно: горизонтальная ось — сколько токенов в контексте, и чем дальше вправо по ней (чем длиннее контекст), тем ниже идёт кривая точности. Это тот же феномен, что «lost in the middle» из Лекции 2, под новым практическим названием — я делаю эту сшивку явно, чтобы термин не воспринимался как новая сущность. Механизм тот же: попарные связи механизма внимания растут квадратично с длиной.
Прямое следствие: «просто положить всё в контекст» — не стратегия. Большое контекстное окно даёт возможность вместить много текста, но не гарантию, что модель этим текстом воспользуется правильно. И это, забегая вперёд, один из ключей к вопросу «когда НЕ RAG», который мы разберём в Разделе 2: иногда правильный ответ — не строить retrieval-инфраструктуру, а аккуратно курировать небольшой стабильный контекст и переиспользовать его через кэширование. То есть это первый практический критерий: если корпус знаний мал, стабилен и помещается в окно — RAG здесь добавил бы хрупкость без выигрыша, и правильный ответ проще, чем кажется.
Источники: [1] Chroma Research — Context Rot · [2] Liu et al. 2023 — Lost in the Middle · [3] Anthropic — Effective Context Engineering
15 · Чит-шит: как строить промпт — 8 пунктов, компактная форма раздела 1¶
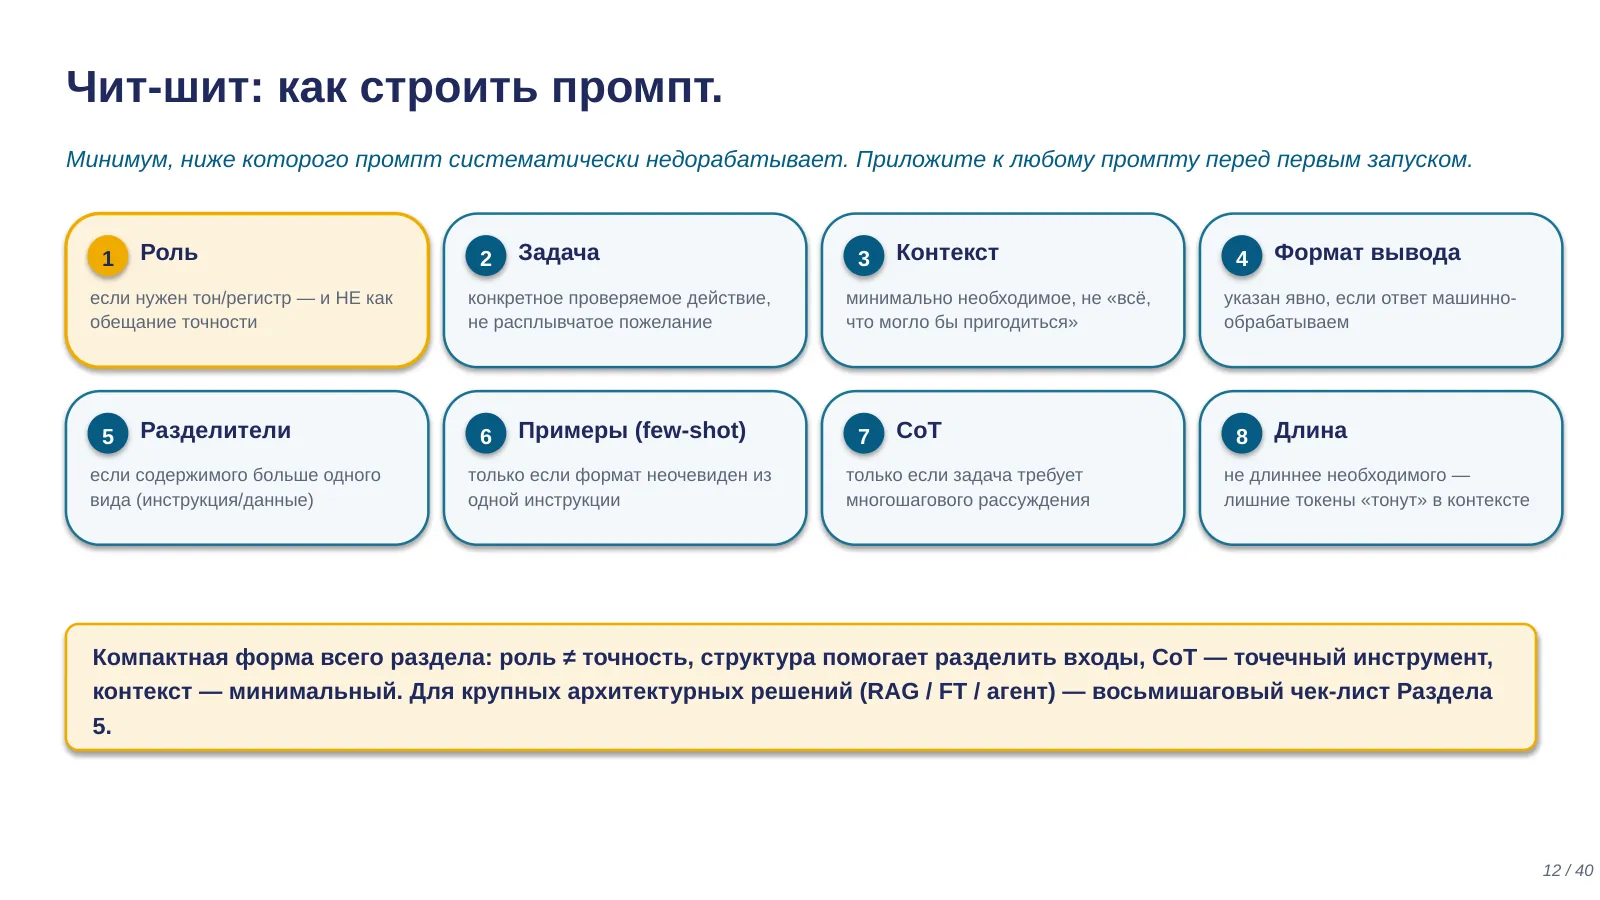
Соберём весь раздел про промпт в один практический инструмент — короткий чек-лист, который можно приложить к любому промпту перед первым запуском. Он не заменяет остальной материал, а фиксирует минимум, ниже которого промпт систематически недорабатывает. Пройдёмся по восьми пунктам, и по каждому — не просто что делать, а почему это важно.
Первое: роль задана, если нужен конкретный тон или регистр, и явно не используется как обещание точности. Если задача требует фактической верности, роль её не решает — мы видели, что экспертная персона тону помогает, а фактам в лучшем случае нейтральна. Второе: задача сформулирована как конкретное проверяемое действие, а не расплывчатое пожелание — «напиши резюме в трёх пунктах по формату X», а не «помоги с текстом». Вероятностная постановка без ясного «что и в каком виде» проваливается так же, как проваливалось размытое ТЗ, только провал теперь не ловится компилятором. Третье: контекст содержит минимально необходимое, а не всё, что могло бы пригодиться — это та же дисциплина, что и контекст-инжиниринг, применённая к одному запросу. Четвёртое: формат вывода указан явно, если ответ должен быть машинно-обрабатываемым.
Пятое: расставлены разделители, если промпт содержит больше одного вида содержимого — инструкцию, контекст, вставляемые данные. Модель, которой показали границы, реже путает данные с командой. Шестое: примеры добавлены только если формат ответа неочевиден из одной инструкции; если модель справляется zero-shot, примеры лишь расходуют контекст. Седьмое: пошаговое рассуждение включено только там, где задача требует многошаговой логики; для прямого извлечения факта или простой классификации CoT не нужен и может навредить — удлиняет ответ и иногда уводит в правдоподобное, но ошибочное обоснование. Восьмое: проверено, что промпт не длиннее необходимого, потому что каждый лишний абзац — это токены, которые нужно оплатить и которые рискуют утонуть в контексте; ориентир не абсолютное число, а вопрос «можно ли убрать это предложение без потери смысла инструкции?».
Этот чек-лист — не бюрократия ради процедуры, а сжатый свод всего раздела: роль не равна точности, структура помогает модели разделить входы, рассуждение — точечный инструмент, а не тумблер, контекст — минимальный, а не максимальный. Держите его под рукой при написании промпта для новой задачи; для более крупных архитектурных решений — RAG, fine-tuning, агент — есть аналогичный, но более развёрнутый чек-лист в разделе про выбор архитектуры.
16 · Ассистент с инструментами — мини-лестница one-shot → tool-use → агент; провал — прыжок сразу к агенту ($4 200-петля §4)¶
Первый типовой класс задач — ассистент с инструментами. Постановка простая: пользователь просит не «напиши текст», а «сделай» — узнай что-то во внешней системе или соверши действие. Правильная архитектура здесь — не бинарный выбор «чат или агент», а та же лестница из начала раздела, применённая к одному классу задач.
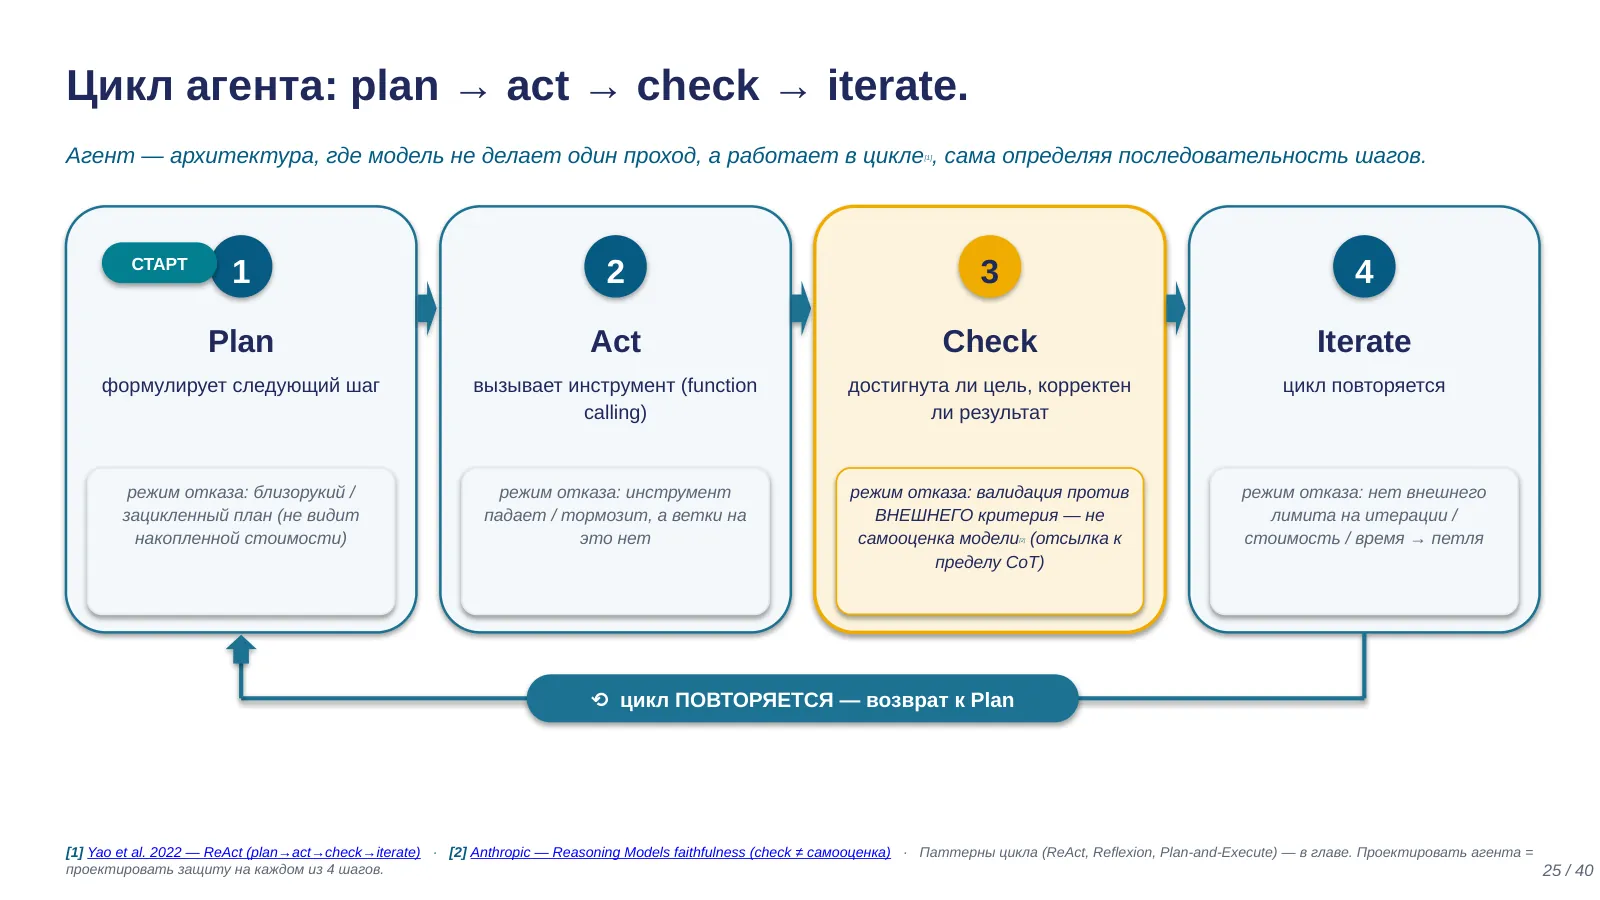
Первая ступень — один вызов. Если модель уже знает ответ и внешнее действие не нужно (перефразируй, объясни, суммируй), это дёшево, быстро и предсказуемо. Вторая ступень — tool-use или workflow. Если нужен доступ к данным или действие, но последовательность шагов известна заранее и её можно задать кодом, то модель формулирует вызов инструмента, а сам контур и точки проверки живут в коде, а не в голове модели. Третья ступень — полноценный агент. Он оправдан только тогда, когда шаги заранее неизвестны, нужна адаптация на лету и есть способ проверить прогресс. Цена подъёма на каждую ступень — рост задержки, стоимости и риска размножения ошибок.
Чтобы это был инженерный рецепт, а не пожелание, назовём, чем управляют и как проверяют. Параметры класса: гранулярность инструментов (крупные операции против атомарных), строгие схемы входа с валидацией на границе, режим tool_choice (авто, принудительный или запрет), и обязательный лимит итераций с бюджетом токенов — защита от разбегающегося цикла. Валидация двухступенчатая: во-первых, проверять аргументы вызова инструмента до обращения к внешней системе — некорректный запрос отклонить на границе и вернуть модели структурированную ошибку, которую она может интерпретировать; во-вторых, проверять, что финальный ответ опирается на результаты инструментов, а не на память модели. Второе снимает так называемый параметрический откат: после сбоя инструмента модель иногда «решает», что своих знаний хватит, и перестаёт искать — ровно ломая гарантию свежести, ради которой инструмент и подключали.
Самая частая ошибка этого класса — прыгнуть сразу к агенту там, где задача предсказуема и хватило бы одного вызова инструмента. Это ровно тот провал, который мы разберём в разделе про агенты: петля на четыре тысячи двести долларов, где предсказуемую синхронизацию отдали агенту вместо простого retry-скрипта. Правило — подниматься по мини-лестнице только под требование задачи, а не потому, что «агент звучит мощнее».
17 · Текст в заданном тоне — few-shot по 3–5 образцам; граница — детекторам нельзя верить (часть <80%, +30% ложных на не-нейтивах)¶
Второй класс — генерация текста в заданном тоне, стиле или регистре: маркетинговое письмо «как наш бренд», ответ поддержки в фирменном голосе, черновик «как написал бы человек». Правильная архитектура здесь — few-shot style transfer: дать три-пять образцов авторского текста, обёрнутых в примеры, и попросить сгенерировать в том же стиле. Это самый надёжный рычаг для тона и голоса, и именно здесь роль-персона работает так, как её обычно и представляют, — она влияет на тон, а не на факты.
Но границы этого класса важнее самого приёма, и их две. Первая: модели неплохо копируют публичных персон и вымышленных героев, но буксуют на индивидуальном стиле рядового автора — личный стиль не сводится к нескольким ползункам. Вторая, острее: AI-детекторы ненадёжны как единственное доказательство. Это признают сами вендоры в документации. Независимые исследования дают точность части детекторов ниже восьмидесяти процентов; тексты не-носителей языка помечаются как машинные заметно чаще — база сравнения здесь доля ложных срабатываний относительно носителей; и точность резко падает после простого перефразирования.
Как и в предыдущем классе, назовём параметры и валидацию, чтобы это был рецепт. Параметры: формальность (от «академически» до «дружелюбно»), эмоциональная окраска, конкретная персона, число и качество образцов стиля, и явные запреты — без канцелярита, без эмодзи, без превосходных форм. Валидация здесь сложнее, потому что стиль слабо формализуем: применяют LLM-судью на соответствие тону, проверку конкретных маркеров (длина предложений, наличие или отсутствие определённой лексики) и выборочную человеческую вычитку. И типичный провал при тонком многоатрибутном контроле: атрибуты конфликтуют — «формально, но тепло, но кратко, но с деталями» тянут в разные стороны, и модель проседает по части измерений; на длинных диалогах добавляется дрейф персоны.
Инженерный вывод двойной. Сгенерировать человекоподобный текст технически можно, но выдавать его за своё — это этический и академический риск. И детектору нельзя доверять ни как щиту, чтобы доказать, что текст написан ИИ, ни как мечу, чтобы гарантированно спрятать ИИ-происхождение. Это тот же урок всей главы — наблюдаемое не равно гарантированному, — применённый к детекции.
18 · «Попросить JSON» ≠ «задать контракт»: два уровня контроля (промпт ~80% / декодер ~100%), три способа задать схему, инвариант «валидный JSON ≠ правильные данны延
Четвёртый класс — структурированное извлечение, самый частый интеграционный стык модели с кодом. Owner-правка здесь прямая: показать не мем, а технику — как правильно давать JSON-спеку в промпте. Начинаем с рамки, которую путают чаще всего: есть два разных уровня контроля с разными гарантиями. На уровне промпта вы просто текстом просите «верни JSON по схеме» — это даёт около восьмидесяти процентов валидности и жёстко не гарантирует ничего: ни синтаксис, ни набор полей, ни типы. На уровне декодера (structured outputs, или constrained decoding) схема компилируется в грамматику, и на каждом шаге генерации токены, нарушающие грамматику, физически не могут быть выбраны — отсюда близкое к стопроцентному соответствие схеме. Поддержка на 2026-й движется, поэтому сверяйте в день лекции: OpenAI Structured Outputs со strict-режимом, Anthropic вывел structured outputs в общую доступность на Claude 4.5, Google Gemini responseSchema, из open-source — Outlines, XGrammar, GBNF-грамматики.
Дальше — как описать саму форму, три способа с компромиссами. Пример-объект понятен модели, но не выражает типы и enum. JSON Schema — машинно-проверяемый контракт, но многословна и деградирует на сложных схемах. Тип на языке кода (TypeScript, Pydantic, Zod) компактен и даёт типобезопасность, но требует конвертера. В описания полей кладут микро-инструкции: для перечислимых значений выписывают каждый вариант enum'ом, явно указывают required, держат вложенность мелкой. Сверху — few-shot из двух-трёх пар «вход → ожидаемый JSON», которые фиксируют форму лучше любого текста, и две мелочи с непропорциональным эффектом: схему в конце промпта и «верни ТОЛЬКО JSON, без markdown».
Два нюанса, которые и есть настоящая техника. Reasoning tax: строгий JSON на рассуждающей задаче роняет качество (полный разбор с числами GSM8K — на слайде форматов), лечится двухходовкой «think free → reformat». И сложная схема: точность извлечения падает даже при валидном JSON — важно направление, не точная величина. Инвариант, замыкающий класс: валидный JSON ≠ правильные данные — грамматика гарантирует форму, но не истинность значений, поэтому каждый JSON всё равно проверяется в коде. Строгая схема надёжно помогает на извлечении, классификации и function calling — и только там.
19 · Раздел 2 — RAG: поиск-дополненная генерация поверх эмбеддингов Лекции 2¶
Мы закончили первый раздел: по умолчанию — один вызов, его можно усилить пошаговым рассуждением, но у рассуждения есть предел верности, и контекст нужно курировать, а не сваливать. Теперь — следующая ступень лестницы.
Один вызов с хорошим промптом упирается в естественную границу: модель знает только то, что попало в её веса при обучении, плюс то, что вы вручную положили в контекст. Если задача требует знаний, которых в весах нет, — например, приватной базы компании, — или которые меняются быстрее, чем выходят новые версии модели, — например, актуальных цен или документов, — один вызов не справится. Здесь начинается RAG: поиск-дополненная генерация.
В одной фразе принцип такой: перед вызовом модели система сначала извлекает релевантные фрагменты из внешнего хранилища знаний, кладёт их в контекст вместе с вопросом, и только затем модель генерирует ответ, опираясь на эти фрагменты. В этом разделе мы разберём: как RAG устроен в три шага и почему механизм поиска в нём — это ровно семантический поиск из Лекции 2; когда RAG — правильный выбор, а когда — нет, и почему второе важнее; и как RAG тихо ломается на масштабе, замыкая раздел обратно на дело Air Canada из открытия.
20 · Буква R в RAG — retrieval: инвертированный индекс, булев поиск, TF-IDF, BM25; RAG добавляет семантический слой поверх, классика не исчезает¶
RAG принято подавать как новую технологию, выросшую из эмбеддингов. Это скрывает существенное: буква R в RAG — retrieval, поиск — дисциплина с полувековой историей, и её устройство определяет, где RAG работает, а где ломается. Разберём классический поиск с нуля — без этой базы семантика выглядит магией, а она лишь следующий слой поверх понятного фундамента.
Начнём с механики, потому что она объясняет и силу, и границу. Инвертированный индекс — это машинный аналог библиотечного каталога: не список «документ → его слова», а перевёрнутый список «слово → все документы (и позиции в них), где оно встречается». Благодаря этому система при запросе не сканирует все тексты, а сразу читает короткие списки по словам запроса и пересекает их — отсюда ответ за доли миллисекунды даже на огромных коллекциях. Это фундамент любой полнотекстовой системы (Lucene, Elasticsearch, PostgreSQL full-text) и до сих пор рабочая лошадь эксплуатации.
Поверх индекса классика решает две задачи — отбор и ранжирование. Отбор задаёт булев поиск: запрос как логическое выражение отбирает документы точно и объяснимо. Ранжирование отвечает, в каком порядке показать отобранное, и здесь важно понять устройство. Наивная мера — частота слова в документе (term frequency) — переоценивает частые слова. TF-IDF чинит это, домножая частоту на обратную частоту в коллекции (IDF): слово тем важнее, чем чаще оно в этом документе и чем реже во всей коллекции; «и», «the» встречаются везде и почти ничего не весят, а редкий термин — сильный сигнал. BM25 из семейства Okapi — это TF-IDF, доведённое до продакшена тремя добавками: насыщением по частоте (десятое вхождение слова добавляет к весу меньше, чем второе), нормировкой на длину документа (длинный текст не выигрывает просто за счёт объёма) и той же IDF-компонентой. Итог — дешёвая, объяснимая базовая линия, которую «умные» системы не всегда обгоняют.
Ключевое свойство этой классики — она работает на лексическом совпадении: находит документы с теми же словами (или их формами после стемминга), что в запросе. Отсюда сила на кодах, идентификаторах, именах — и её граница: запрос «сломанный вход» лексически не совпадёт с документом «authentication failure», хотя по смыслу это одно. Классика видит слова, а не смысл. Здесь надо снять частую и вредную неточность, которую владелец справедливо попросил пояснить: будто «семантический поиск построен на BM25». Это не так. Лексический поиск (инвертированный индекс, BM25 около тысяча девятьсот девяносто четвёртого года) и плотный семантический (DPR, две тысячи восемнадцатый–двадцатый) — две в значительной мере независимые ветки; внутри dense-модели никакого BM25 нет. Плотный поиск кодирует и запрос, и документ в вектор фиксированной размерности и ищет ближайшие по косинусу приближённо, через ANN-индекс (HNSW). Их не построили одну на другой — их поставили рядом и сливают. Корректная формула: лексика — старший независимый родственник семантики; системы их сливают (fuse), а не наследуют. Провалы RAG во многом там, где о классической ветке — фильтрах, ранжировании, наблюдаемости — забыли.
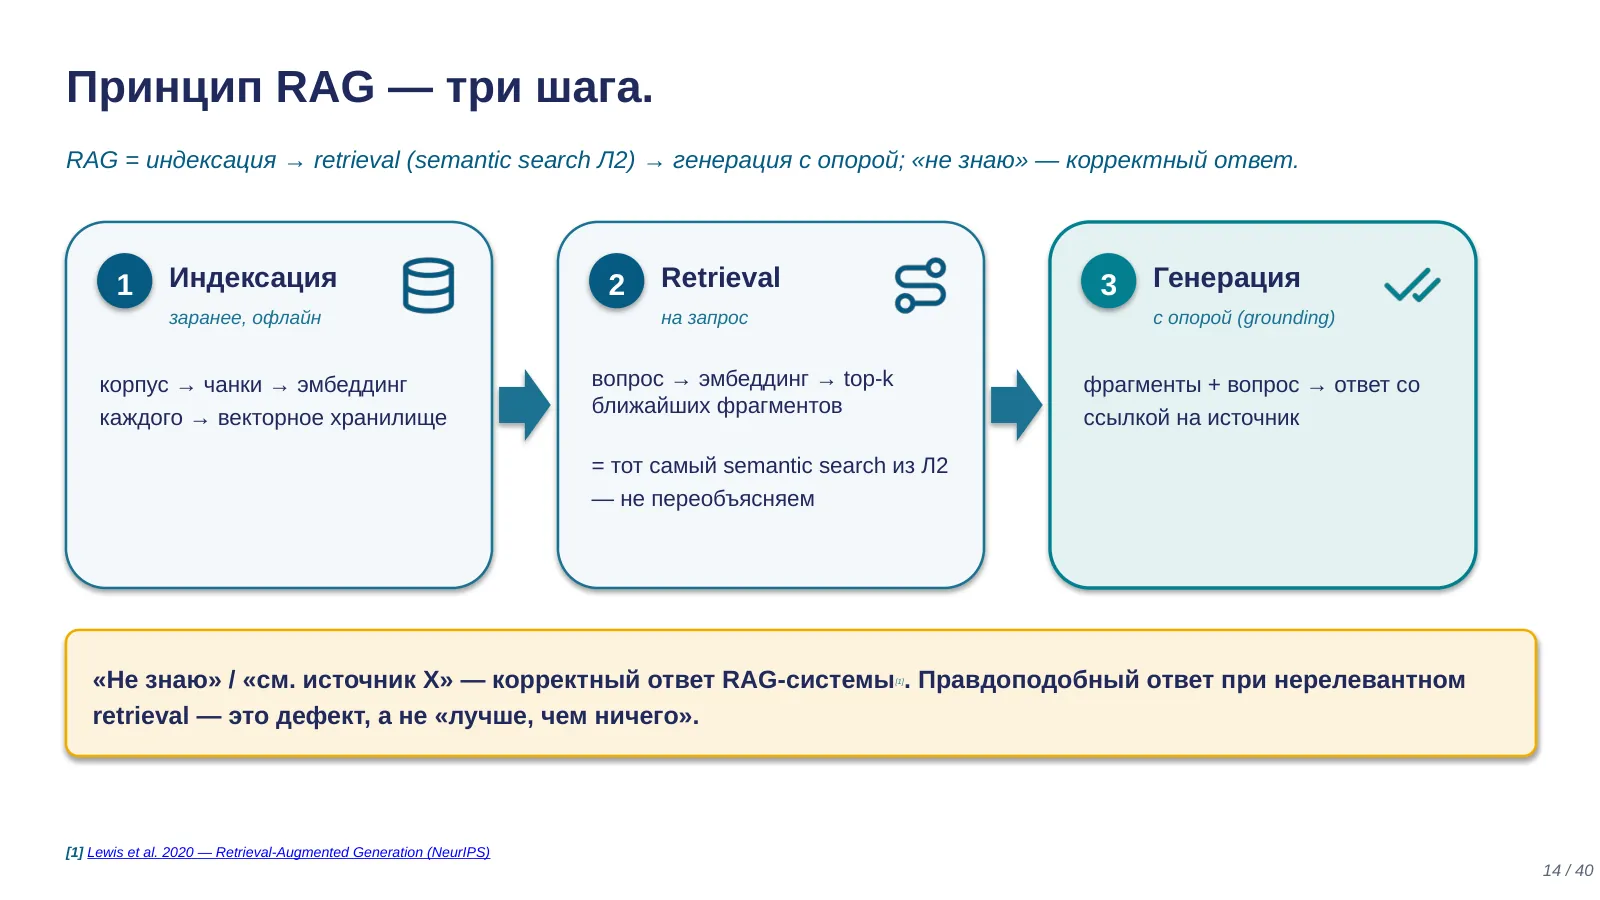
21 · RAG = индексация → retrieval → генерация с опорой; «не знаю» — корректный ответ, выдумка — дефект¶
RAG — retrieval-augmented generation, поиск-дополненная генерация — это архитектура, в которой перед вызовом модели система сначала извлекает релевантные фрагменты из внешнего хранилища, кладёт их в контекст вместе с вопросом, и только затем модель генерирует ответ, опираясь на эти фрагменты[1]. Введём термин: retrieval — этап поиска и извлечения релевантных фрагментов; именно он отличает RAG от «положить документ в промпт вручную».
Ключевое: механизм retrieval в RAG — это ровно тот семантический поиск на эмбеддингах, который мы построили в Лекции 2, и переобъяснять его не будем. Напомню одной фразой: текст превращается в вектор, близость векторов означает смысловую близость, поэтому фрагмент можно найти по смыслу вопроса, а не по совпадению слов. RAG надстраивает три шага. Первый — индексация, заранее, офлайн: корпус режется на фрагменты, каждый превращается в эмбеддинг и кладётся в векторное хранилище. Второй — retrieval, на запрос: вопрос превращается в эмбеддинг, по близости векторов достаются k релевантных фрагментов. Третий — генерация с опорой: фрагменты кладутся в контекст вместе с вопросом, модель отвечает, опираясь на них, и в хорошей реализации — со ссылкой на источник.
Введём ещё один термин, несущий в разделе основную нагрузку. Grounding, опора на источник, — свойство ответа быть выведенным из конкретных извлечённых фрагментов, а не сочинённым моделью из головы, с возможностью показать, из какого фрагмента взят каждый факт. Хорошая RAG-система проектируется так, чтобы ответ был grounded, и чтобы на вопрос, на который в извлечённых фрагментах ответа нет, система говорила «не знаю» или «см. источник», а не сочиняла. Сформулируем как инженерный инвариант: «не знаю» — корректный ответ RAG-системы; правдоподобный ответ при нерелевантном retrieval — дефект, а не «хоть что-то». Различение «ответ с опорой и цитатой» против «правдоподобный текст» окажется центральным дальше и прямо объясняет дело Air Canada.
Источники: [1] Lewis et al. 2020 — Retrieval-Augmented Generation (NeurIPS)
22 · Гибридный поиск = BM25 + плотные векторы, слитые по рангам (RRF), плюс cross-encoder reranking; берут под измеренный разрыв, не по умолчанию¶
Ранее мы вывели: сильный RAG — возврат классики поверх семантического слоя. Здесь этот вывод разворачивается в гибридный поиск, ставший дефолтом продакшена. Зачем комбинировать: BM25 находит по точному совпадению слов — коды, идентификаторы, имена, номера ошибок, — но бессилен перед синонимом: «сломанный вход» не совпадёт с «сбой аутентификации». Плотный поиск наоборот ловит смысл, но размывается на редких точных токенах. Гибрид берёт оба источника полноты выдачи сразу.
Сначала снимем два вопроса. Первый — «гибрид чего с чем», и здесь важно не запутаться в слове «вектор». Разреженный поиск (sparse) — это классический лексический поиск: BM25 или TF-IDF, а также обучаемые SPLADE и ELSER на инвертированном индексе; единица — слово. Когда говорят «разреженный вектор», имеют в виду не поиск смысла по вектору, а лишь способ записать пословный поиск: вектор длиной во весь словарь, почти все координаты — нули. Это по-прежнему лексика, а не семантика. Плотный поиск (dense) — противоположность: эмбеддинг из 384–1024 float, смысл закодирован во всех координатах, поиск приближённый (ANN), не интерпретируем, ловит перифразу. Одной фразой: BM25 — разреженный, эмбеддинги — плотные, SPLADE — тоже разреженный, просто веса термам ставит нейросеть.
Второй вопрос: слово «гибрид» несёт три разных смысла, их путают. Смысл (а), базовый, — слияние двух разных ветвей: разреженной (лексика, BM25) и плотной (смысл, эмбеддинг), объединённых по рангам через RRF. Смысл (б) — семантика плюс строгий фильтр по метаданным (юрисдикция, дата): ортогональный рычаг, а не слияние ретриверов. Смысл (в) — BM25 плюс SPLADE или ELSER: обе ветки разреженные, обе про лексику, одна классическая, другая с нейро-взвешиванием; dense-векторов смысла здесь нет. Дальше — механика смысла (а).
Теперь механика по шагам. Оба ретривера запускаются параллельно: BM25 отдаёт свой топ-N по инвертированному индексу, плотный поиск — свой по ANN. Дальше их надо слить, и здесь ловушка: оценки BM25 не ограничены сверху и зависят от корпуса, а косинусная близость лежит в диапазоне ноль–один — шкалы несопоставимы. Reciprocal Rank Fusion обходит это, сливая не по оценкам, а по рангам: вес документа — сумма по ретриверам от единицы, делённой на «k плюс ранг». Важен только порядок, поэтому несопоставимость шкал перестаёт мешать. Параметр k по умолчанию около шестидесяти: это конвенция, её стоит подбирать.
Реранкер — вторая ступень, и разница между двумя энкодерами несущая. Bi-encoder кодирует запрос и документ по отдельности и заранее: на запросе — быстрое сравнение готовых векторов, дёшево, но грубо. Cross-encoder прогоняет пару «запрос плюс документ» вместе, одним проходом трансформера: точнее, но его нельзя предвычислить. Отсюда правило: он дорог, поэтому применяется только к переупорядочиванию верхних пятидесяти–ста кандидатов, отобранных гибридом.
Приросты читаем с базой и скептически. На WANDS гибрид даёт NDCG 0,7497 против 0,6983 у BM25 — около семи процентов над настроенной базой. Крупные приросты там, где лексика или смысл ломается по отдельности: у Anthropic доля промахов упала с 5,7 до 1,9 процента. Выигрыш зависит от корпуса: сначала измерьте разрыв на своих запросах, потом усложняйте.
Источники: [1] denser.ai — Hybrid Search for RAG (WANDS / финтаблицы дельты) · [2] Anthropic — Contextual Retrieval (каскад промахов 5,7→1,9%)
23 · Векторный движок под масштаб: pgvector ~50M, Milvus 100M+; обвязки (LlamaIndex/LangGraph) под агентную сложность, не по умолчанию¶
Когда гибрид оправдан и корпус вырос, встаёт вопрос «в чём хранить и искать векторы». Здесь легко переусложнить: под-каталог движков большой, а правильный выбор для большинства систем — скучный. И сразу снимем частый вопрос, который справедливо задал владелец: Elasticsearch и OpenSearch — это тоже полноценные векторные хранилища, а не что-то вне ландшафта. Оба держат dense-векторы и ищут по ним: Elastic — через тип поля dense_vector и kNN на HNSW; OpenSearch — через k-NN плагин с выбором движка. Просто их честнее ставить под своей осью — «поисковый движок, который ещё умеет вектора», в отличие от vector-native движков (Qdrant, Milvus, Weaviate), которые строились вокруг приближённого поиска ближайших соседей с первого дня. Обе категории — векторные БД; различает их происхождение, а оно тянет за собой набор сильных сторон. Пройдём шпаргалку 2026 года, помня, что масштабные потолки движутся и их стоит сверять в день лекции.
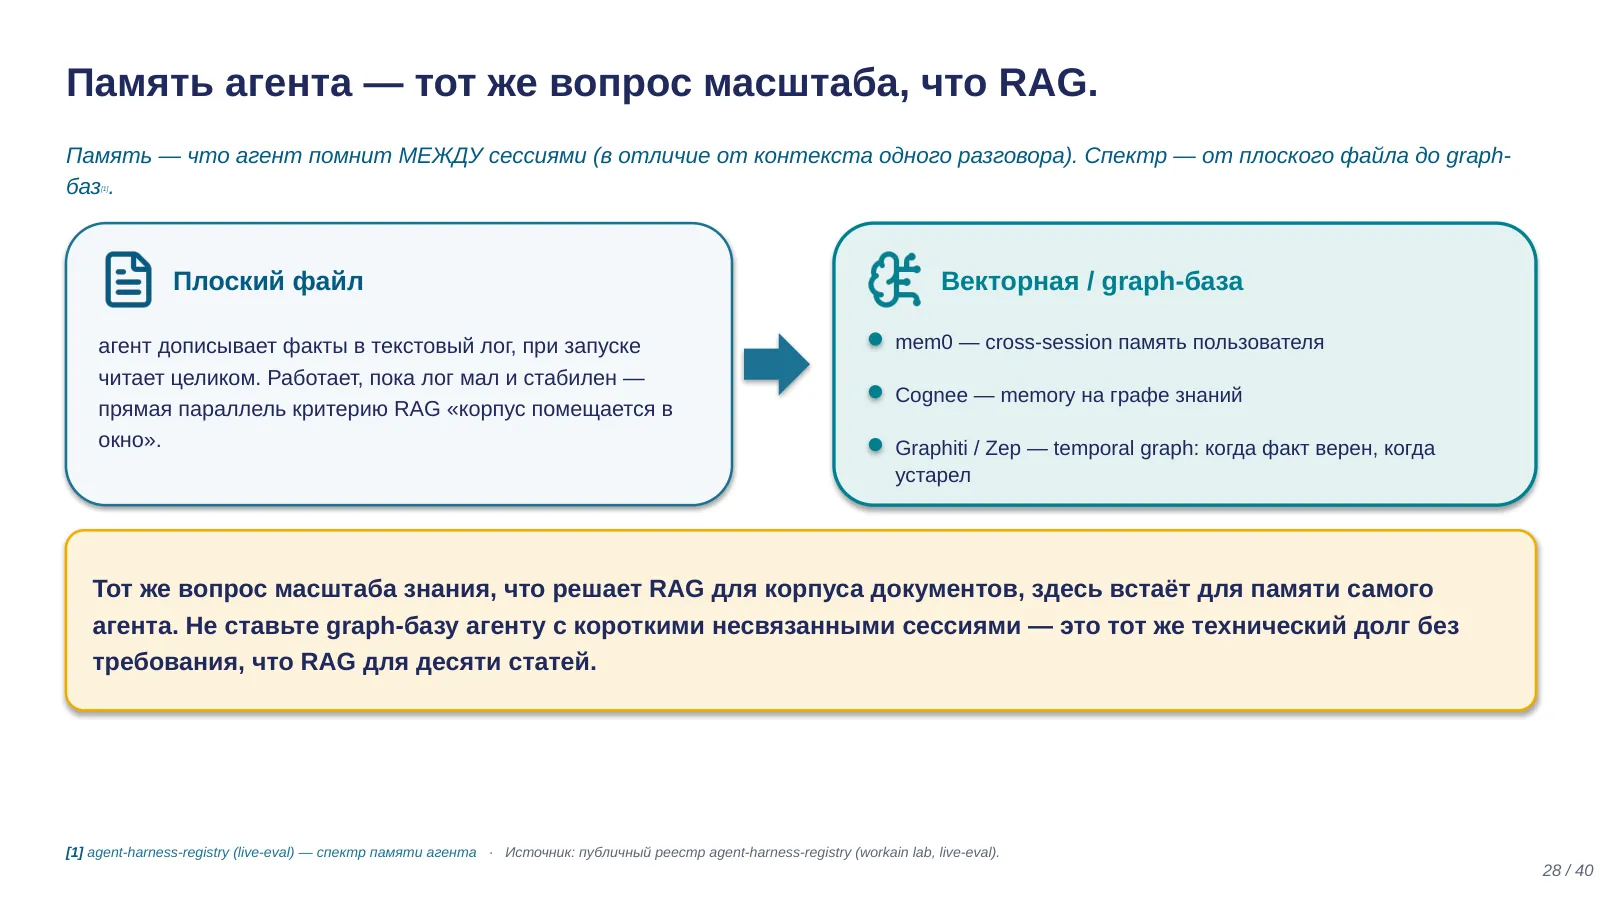
pgvector — это расширение Postgres. Берут, когда данные уже в Postgres и нужна одна система с транзакционной согласованностью. Комфортно держит порядка пятидесяти миллионов векторов, за пятьдесят-сто миллионов деградирует без специальных надстроек. Qdrant — выделенный движок с минимумом операционной нагрузки, нативными разреженными и multi-vector примитивами. Weaviate несёт встроенный гибрид: вектор, BM25 и фильтры по метаданным из коробки. Milvus рассчитан на сотни миллионов и миллиарды векторов с разделёнными вычислениями и хранилищем, но требует реальных вложений в эксплуатацию. FAISS — это библиотека, а не база: сырая скорость и полный контроль, но persistence, CRUD и фильтры вы пишете сами. Chroma и LanceDB закрывают прототип, ноутбуки и локальный edge-сценарий.
Обвязки — отдельная тема. Консенсус 2026 года: LlamaIndex и LangChain не конкуренты, а взаимодополняющие слои. LlamaIndex силён, когда трудная часть — retrieval по грязным приватным документам: ingestion, индексация, разумные дефолты. LangGraph даёт оркестрацию: durable execution, checkpointing, human-in-the-loop с паузой на часы и дни.
И скептическая оговорка, замыкающая на правило лестницы: для простого RAG-эндпоинта, где всё сводится к «retrieve, потом generate», не нужен ни один фреймворк. Несколько сотен строк своей склейки избавляют от version churn и утечек абстракций. Обвязку добавляют под агентную, многошаговую сложность, а не по умолчанию.
Источники: [1] firecrawl — Best Vector Databases 2026 (потолки движков) · [2] TigerData — pgvector vs Qdrant (вендор-бенчмарк, читать скептически)
24 · Три яруса: BM25 хватает / встроенный гибрид Elastic-OpenSearch хватает / выделенная векторная БД только при 100M+, multi-vector или latency-SLA¶
Это выбор в открытом поле — под ваш масштаб и ваши требования, а не предположение, что у вас что-то уже стоит. Три яруса снизу вверх; на следующий поднимаются, только когда предыдущего не хватает под конкретную нагрузку.
Первый ярус: хватает классического BM25. Это случай, когда запросы и документы делят словарь — внутренние инструменты, поиск по логам, коду, идентификаторам, курированные базы знаний. Здесь не нужны ни эмбеддинги, ни векторное хранилище вовсе, а переиндексация дёшева и наблюдаема — это реальное операционное преимущество, а не компромисс. Прежде чем строить вектор-инфраструктуру, честно проверьте, не ваш ли это случай.
Второй ярус: хватает поискового движка, который умеет вектора. Это когда нужен смысл поверх лексики на масштабе миллионов или десятков миллионов векторов, но заводить отдельное специализированное хранилище ещё рано. Одни из вариантов такого движка — Elasticsearch и OpenSearch: оба нативно умеют RRF-гибрид и линейную комбинацию keyword и vector. Elasticsearch несёт тип поля dense_vector и kNN на HNSW, а ELSER — разреженную нейронную модель, которая работает в кластере без внешнего GPU-инференса и заявлена превосходящей recall BM25 на десять-двадцать процентов на доменном контенте. OpenSearch даёт k-NN через FAISS и Lucene и допускает более высокую размерность вектора. Смысл яруса — получить семантику без поднятия отдельного GPU-сервиса эмбеддингов и второго хранилища.
Третий ярус: нужна выделенная векторная БД. Это при ста миллионах и больше векторов, при потребности в multi-vector или late-interaction примитивах, при жёстком latency-SLA на горячем пути продукта или при желании развязать векторное хранилище от эксплуатации кластера логов.
Anti-hype-вывод: огромная доля RAG-систем никогда не превышает несколько миллионов чанков. На этом масштабе pgvector или гибрид Elastic/OpenSearch — скучный правильный ответ, а выделенная векторная БД часто преждевременная оптимизация.
Источники: [1] Pureinsights — From Vector Hype to Hybrid Reality (нужна ли вектор-БД) · [2] bigdataboutique — Elastic/OpenSearch vector search (RRF-гибрид нативно)
25 · Стратегии чанкирования от простой к сложной (fixed/recursive/sentence-window/semantic/parent-document/late/contextual); правильного дефолта нет — подбирают под корпус¶
Из трёх шагов RAG чанкирование недооценивают чаще прочего, а рычаг у него высокий: как вы режете документ на фрагменты, определяет, что вообще может быть извлечено. Мы уже называли плохой chunking одним из трёх технических корней провалов RAG; разберём стратегии по порядку, от простой к сложной.
Fixed-size режет каждые N токенов или символов. Это грубо, но быстро, воспроизводимо и на удивление сильная базовая линия. Recursive, или character-стратегия, режет по иерархии разделителей — абзац, потом предложение, потом слово, уважая структуру и ограничивая размер; это прагматичный дефолт. Sentence-window эмбеддит одно предложение для точности, но возвращает модели окно соседних предложений для контекста. Semantic ставит границу там, где эмбеддинг-близость соседних предложений резко падает, то есть по смене темы; звучит интуитивно, но часто не окупается — об этом следующий слайд. Parent-document, он же small-to-big, индексирует маленькие чанки для точности retrieval, а возвращает больший родительский блок для генерации — широко рекомендуемое лечение потерянного контекста. Late chunking сначала эмбеддит весь документ на уровне токенов, а потом пулит в чанк-эмбеддинги, чтобы каждый был контекст-осведомлён, сохраняя местоимения и ссылки.
Отдельно стоит Contextual Retrieval: LLM дописывает пятьдесят-сто токенов документ-уровневого контекста к каждому чанку до эмбеддинга и до BM25-индексации. Именно этот приём дал каскад промахов с 5,7 до 1,9 процента, который мы видели на принципе RAG.
Держите в голове главное: ни у размера чанка, ни у стратегии нет правильного значения по умолчанию. Их подбирают под корпус, и подбор без метрики — вслепую. О метриках — на слайде про системный дизайн.
Источники: [1] firecrawl — Best Chunking Strategies for RAG · [2] Anthropic — Contextual Retrieval (50–100 токенов контекста к чанку)
26 · Исследования эффекта чанкирования расходятся: recursive-512 69% vs semantic 54%; не карго-культить semantic; тихий провал retrieval — таблицы¶
Здесь — самое поучительное для суждения: исследования эффекта чанкирования открыто расходятся, и это само по себе урок. Возьмём три замера, каждый с базой. В февральском бенчмарке 2026 года сравнили семь стратегий на пятидесяти научных статьях: recursive с разбиением по 512 токенов оказался первым при 69 процентах точности, а semantic chunking дал только 54 — и породил крошечные фрагменты примерно по сорок три токена. В клиническом исследовании MDPI за ноябрь 2025 adaptive и topic-boundary chunking дали 87 процентов против 13 у fixed-size — огромный разрыв, но это узкий клинический домен. А NAACL 2025 Findings прямо пишет, что вычислительные издержки semantic chunking не оправданы стабильным приростом: fixed-чанки по двести слов оказались на уровне semantic или лучше.
Читать это надо так: заявления «умный chunking побеждает» доменно-специфичны и не консистентны. На многих корпусах простой recursive fixed-size — сильная базовая линия, а semantic chunking проигрывает и по качеству, и по стоимости. Инженерный вывод дословно: не карго-культите semantic chunking. Recursive fixed-size дёшев и силён как отправная точка; усложняйте стратегию только под измеренный на своём корпусе разрыв.
И named-провал этого подраздела, on-point для линии провалов: таблицы. Это единственная частая причина тихих провалов retrieval. Расплющивание таблицы в текст уничтожает связи строк и столбцов — модель не может их восстановить, и это не падает с ошибкой, а тихо портит ответ. Лечение — обрабатывать таблицы как структурированные объекты, а не расплющивать в строку. Мета-урок сильнейших команд: те, кто прошёл путь от нескольких месяцев на RAG-кейс до надёжного деплоя, перестали крутить размер чанка и начали управлять слоем знаний — качеством документов, обработкой таблиц, свежестью и метаданными.
Источники: [1] firecrawl — chunking benchmark (recursive-512 69% vs semantic 54%) · [2] firecrawl — chunking eval (recall@k в изоляции может врать)
27 · Тихий провал чанкирования: наивная нарезка расплющивает таблицу в «голый ряд цифр» без заголовков — система не падает, а тихо отвечает неверно¶
Предыдущий слайд сказал: не карго-культите чужой рецепт, мерьте на своих данных. Этот слайд показывает, как именно чанкирование ломается — и почему это самый коварный вид отказа RAG: он тихий. Возьмём конкретный корпус: триста PDF-руководств по промышленному оборудованию — пояснительный текст плюс таблицы спецификаций «Модель / Напряжение / Ток / Момент затяжки» плюс предупреждения по безопасности. Типичный вопрос: «какой момент затяжки для модели X-500?» — и ответ живёт в ячейке таблицы.
Что выбрал бы наивный инженер: RecursiveCharacterTextSplitter, пятьсот двенадцать токенов, перекрытие пятьдесят — это работает для прозы. Но парсер детектит таблицу и расплющивает её в поток, а символьный сплиттер режет её по произвольному байту на границе пятьсот двенадцать токенов. Результат: первый кусок содержит заголовки колонок и первые строки, а все последующие — ряды цифр без заголовков: «двенадцать, четыреста восемьдесят, восемь и пять, тридцать четыре» без подписей. Почему это тихий провал: система не падает — эмбеддинг считается, ретрив находит чанк с числом тридцать четыре, ответ генерируется. Он просто неправильный: модель не знает, что тридцать четыре — это момент затяжки для X-500, а не ток для X-700. На дашборде «retrieval работает», в проде — травма на производстве.
Правильное решение — не «умная» semantic-нарезка, а банальное уважение структуры[1]: table-aware нарезка, где таблица идёт отдельным чанком, а если больше лимита — по строкам, повторяя заголовки в каждом куске, чтобы каждая строка стала самодостаточной. Плюс parent-document для текста, чтобы предупреждения не отрывались от процедуры, и метаданные для фильтра по модели и версии.
И три вещи, которые нельзя забыть. Анафора: «оно», «этот город», «данная политика» теряют антецедент при разрезе — лечится parent-document или контекстным дописыванием. Смена эмбеддинг-модели — это пере-нарезка всего корпуса[2], а не строчка в конфиге. И оценка самого chunking чувствительна к k: recall@k может врать (девяносто два процента recall при пятидесяти четырёх процентах ответов), поэтому меряют и end-to-end. Проверка на тихий провал простая: сгенерировать двадцать-тридцать вопросов с ответами в таблицах и руками убедиться, что в top-k приходит чанк с заголовками, а не голый ряд цифр.
Источники: [1] Anthropic — Contextual Retrieval (таблицы — тихий провал retrieval) · [2] firecrawl — Chunking Strategies (re-chunk при смене эмбеддера, k-чувствительность)
28 · POC→прод — другая архитектура: двойной конвейер (ingestion — первое горло), свежесть, полный re-embed при смене модели, eval; каунтерфактуал «<200k токенов — RAG не нужен»¶
До сих пор RAG обсуждался как логика. Здесь — про то, что ломается, когда логика становится продакшн-системой. И сразу снимем перекос, который владелец справедливо отметил: проблемы прода — не только на индексации. Их три группы: сборка индекса, запрос и эксплуатация. Разберём все три, потому что «прод» ломается в любой из них.
Индекс-сторона — сборка и поддержка. Конвейер ingest, chunk, embed, index в проде становится двойным: офлайн-батч для массовой индексации и инкрементальный для обновлений. Первое узкое место — обычно ingestion, а не поиск: на миллионах документов chunk и embed не помещаются на одну машину; интуиция про медленный поиск обманывает — медленна подготовка индекса, а не запрос по нему. Свежесть — реальная стоимость: батч-переиндексация проста, но даёт устаревание, CDC-синхронизация близка к реальному времени, но утраивает операционную сложность; один кейс — переход с батча на CDC улучшил SLA свежести с двадцати четырёх часов до субминуты. Отдельный migration-event: смена embedding-модели требует пере-эмбеддить все векторы — старые и новые несравнимы; это миграция индекса, а не строка в конфиге. И оценка сборки: без набора меток деградация невидима — recall@k с ориентиром около нуля целых восьми, nDCG плюс LLM-судья RAGAS.
Query-сторона — то, что происходит на самом запросе. Первое: качество retrieval деградирует на масштабе — с ростом корпуса recall падает и дрейфует, и «нашёл что-то» перестаёт значить «нашёл правильное». Второе: латентность и пропускная способность. Тысячи конкурентных запросов плюс cross-encoder-реранк, который считается на каждом запросе, упираются в железо; автоскейл опаздывает под пик, и хвост латентности растёт именно тогда, когда нагрузка максимальна.
Эксплуатация — то, что не видно, пока не сломается. Наблюдаемость: retrieval проваливается тихо, без исключения и стектрейса — система отвечает уверенно на нерелевантном контексте, поэтому нужны метрики качества на живом трафике и трассировка каждого запроса, иначе провал заметят пользователи, а не мониторинг. Безопасность и доступ: кто и что вправе извлечь; персональные данные в чанках; фильтр прав обязан стоять до векторного поиска, иначе смысл-близость подтянет чужой фрагмент — это архитектура данных, а не настройка модели.
И несущий каунтерфактуал: для базы знаний под двести тысяч токенов всё кладётся в промпт с кэшированием — до девяноста процентов сокращения стоимости — и retrieval пропускается вовсе. Первый вопрос перед всей инфраструктурой — а нужен ли RAG вообще.
Источники: [1] Redis — RAG at Scale (ingestion-горло, CDC 24ч→субминута, кэш ~69%) · [2] futureagi — RAG Evaluation Metrics (recall@k ~0,8, nDCG, RAGAS)
29 · «RAG» в вакууме не существует — есть RAG под поддержку/код/договоры/enterprise; retrieval-дизайн выводится из природы данных, 2 кейса — «RAG был не тем инструменто컶
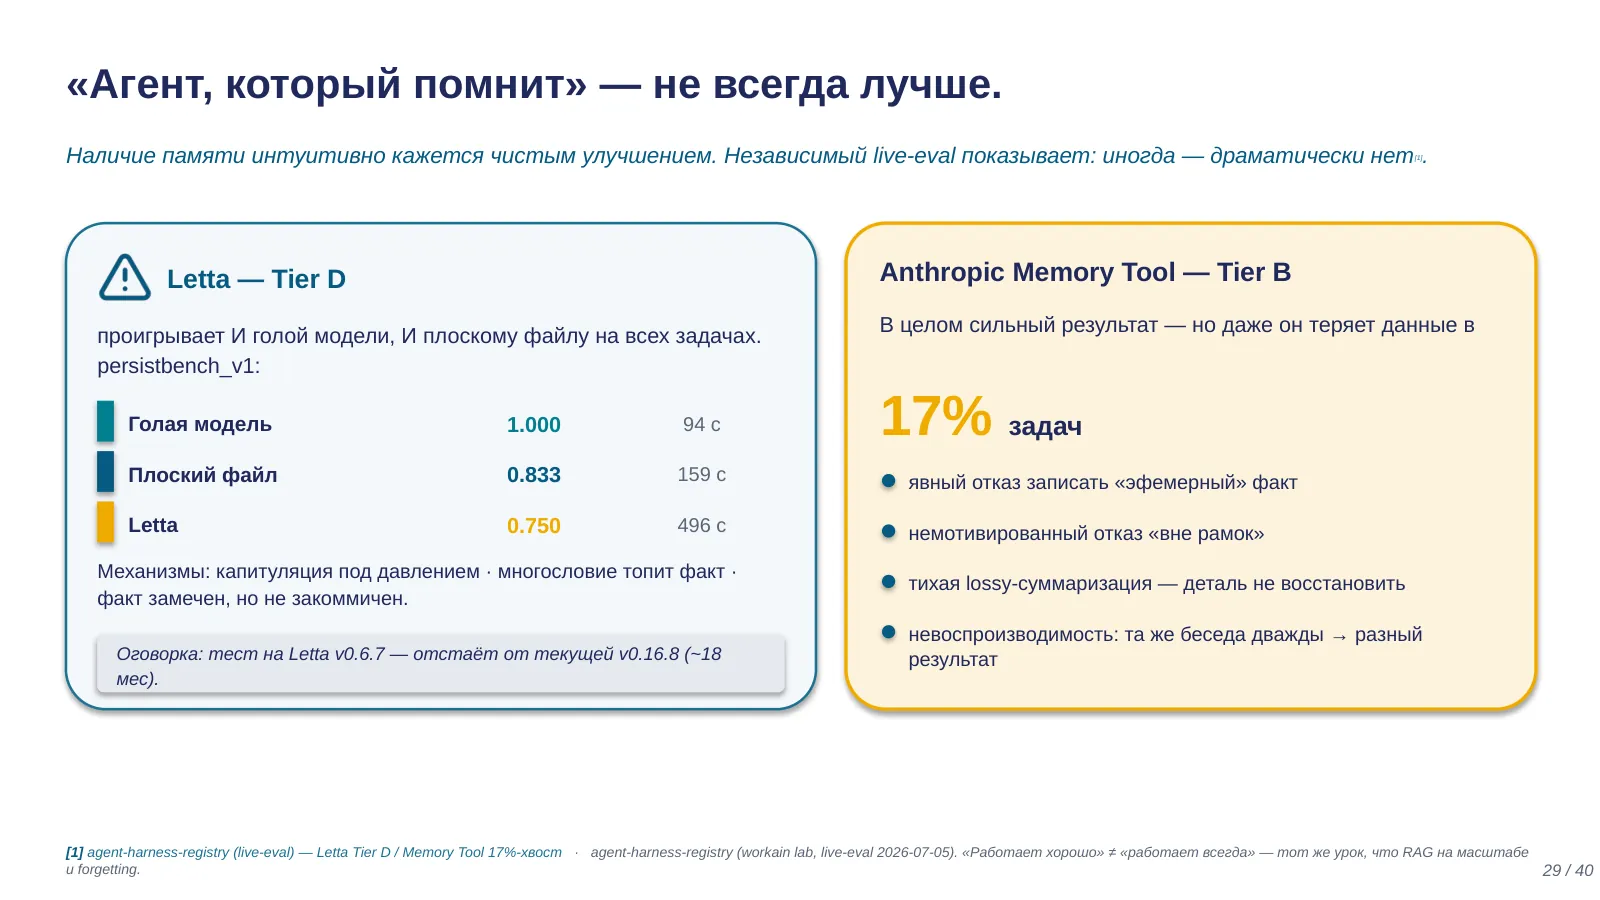
До сих пор мы разбирали RAG как устройство: принцип, когда он уместен, как ломается, из чего собран правильный. Теперь развернём это на пять реальных архетипов, потому что «RAG» в вакууме не существует — существует «RAG под поддержку», «RAG под код», «RAG под договоры», и retrieval-дизайн у них разный. Единый количественный якорь для всех: по данным практиков наивный dense-RAG проваливает ретрив[1] порядка сорока процентов времени, и три приёма — контекст к чанку, гибрид, реранк — закрывают большую часть этого.
Кейс поддержки и внутренней базы: kapa.ai обслуживает документ-ассистентов для Docker, Reddit, OpenAI; Stripe — ассистент поверх документации. Типичный провал: эмбеддинги решают, что «exponential backoff» и «dead-letter queue» семантически близки, и ассистент уверенно выдаёт неверную политику повторов — гибрид спасает тем, что BM25 ловит точный термин, который плотный поиск замылил. Кейс документации: Vercel AI SDK docs-copilot строит контракт «ответ с источниками или отказ» и держит eval-набор прямо в CI, чтобы регрессия ретрива после обновления документации не ушла в прод незамеченной.
Кейс кода — самый поучительный. Cursor индексирует кодбазу эмбеддингами, но Sourcegraph Cody на Enterprise сделал обратное: убрал эмбеддинги и вернулся к классическому лексическому[3] и структурному поиску. Причины — код уходил в сторонний API (риск безопасности), векторы надо хранить и обновлять, а на ста тысячах репозиториев вектор-поиск дорог и не масштабируется. Классический поиск дал равное или лучшее качество дешевле и безопаснее. Это прямой пример «RAG-как-dense-vectors был не тем инструментом»: для кода и точных идентификаторов классический поиск часто бьёт dense-RAG.
Кейс юридический показывает границу high-stakes: преригистрированное исследование Стэнфорда по коммерческим legal-AI (LexisNexis, Westlaw — все на RAG) нашло семнадцать-тридцать три процента галлюцинаций[2], несмотря на маркетинг «hallucination-free». RAG снижает, но не обнуляет — без верификации цитат и человека-в-петле применять нельзя. И enterprise-кейс со смешанными данными: вопрос «сумма расходов за Q3» нельзя закрыть векторным поиском по таблице — это SQL-агрегация, поэтому нужен роутер «структурный против текстового». Общий вывод: retrieval-дизайн выводится из природы данных, а не копируется из чужого блога.
Источники: [1] Barnett et al. 2024 — Seven Failure Points (RAG-архетипы) · [2] Stanford HAI/RegLab — Legal-AI галлюцинирует 17–33% (Lexis/Westlaw) · [3] Sourcegraph Cody — контекст без эмбеддингов (классический поиск)
30 · Deep research — это RAG + агентная петля + верификация цитат, а не «большой промпт»; типовой провал — фабрикация 3–13% ссылок (хуже поиска: 10,7% vs 4,8%)¶
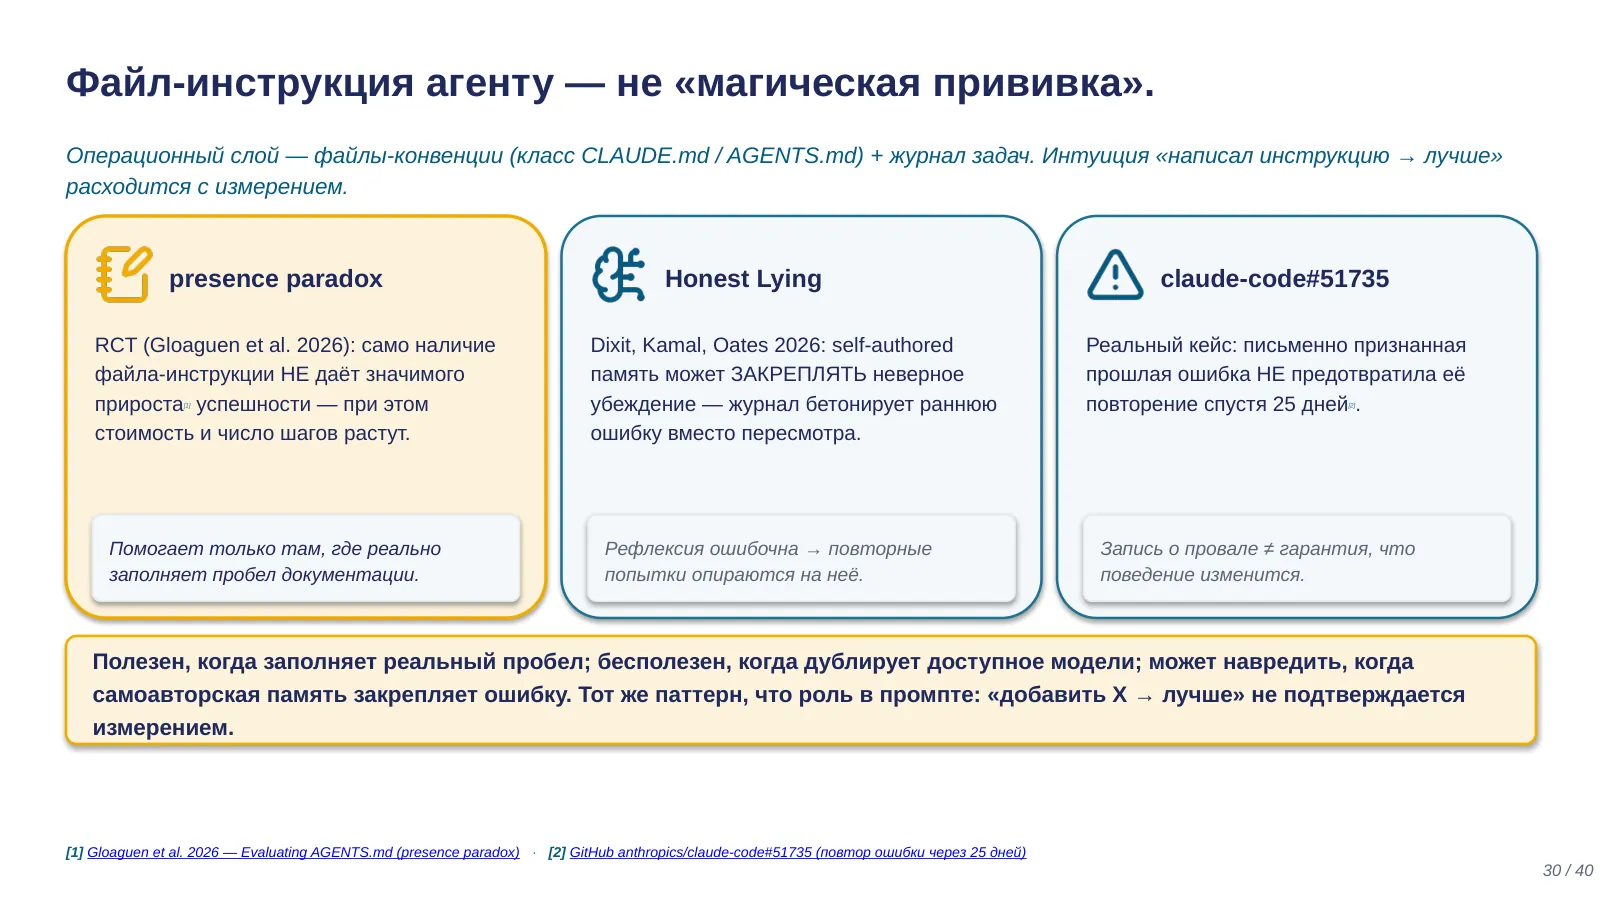
Здесь важная реорганизация по правке владельца: deep research мы перенесли из раздела про промпты сюда, в RAG. Почему — deep research часто ошибочно относят к промпт-задачам: «напиши большой промпт, и он соберёт отчёт». Это неверно. Определяющий компонент здесь — retrieval и оркестрация, а не формулировка промпта, а промпт в нём — лишь одна деталь. Значит, это RAG-кейс, и его место — в разделе про RAG.
Постановка: один сложный вопрос — «сравни рынок по пяти измерениям, со ссылками» — система сама планирует под-вопросы, много раз ищет, читает источники и синтезирует отчёт с цитатами. Архитектурный паттерн — рассуждающая модель плюс агентный цикл RAG[1]: рассуждение направляет поиск, новые находки уточняют рассуждение, и это закрытая петля, в отличие от статического «retrieve top-k, потом generate». Обобщённая схема для слайда: план под-вопросов, затем несколько итераций «поиск, чтение, уточнение рассуждения», потом синтез и отдельный шаг верификации цитат. OpenAI Deep Research гоняет одну мощную reasoning-модель по циклу план-поиск-backtrack-синтез; Perplexity делает RAG по вебу в реальном времени с аннотацией источников. Я называю продукты как иллюстрацию класса, а не как рекомендацию.
Граница этого класса критична для суждения: deep-research-агенты фабрикуют цитаты. Замеры дают от трёх до тринадцати процентов сфабрикованных URL. И контринтуитивный факт: deep-research-агент галлюцинирует цитаты хуже обычного поиска[2] с дополнением — десять и семь десятых процента против четырёх и восьми десятых. База сравнения — доля фейковых цитат на запрос; агент хуже именно потому, что генерирует кратно больше ссылок. Лечится это отдельным слоем верификации после синтеза: проверить, что каждый URL резолвится и что процитированный текст реально подтверждает утверждение — ровно как в юридическом кейсе.
Против ручного аналитика deep research быстрее и дешевле, но без верификационного слоя от трёх до тринадцати процентов ссылок ложны, и в high-stakes-отчёте это дороже медленного человека. Прямая связка с правилом курса про базу: deep research любит выдавать цифры без базы — «минус пятьдесят процентов», «пять миллионов акров» — и подпирать их правдоподобной, но несуществующей ссылкой. Вывод, замыкающий раздел: любую метрику из ИИ-ресёрча перепроверяйте по резолвящемуся первоисточнику, а число без базы считайте красным флагом, а не фактом.
Источники: [1] Anthropic — Multi-Agent Research System (агентный цикл RAG) · [2] arXiv:2604.03173 — фабрикация цитат в retrieval-augmented (3–13%)
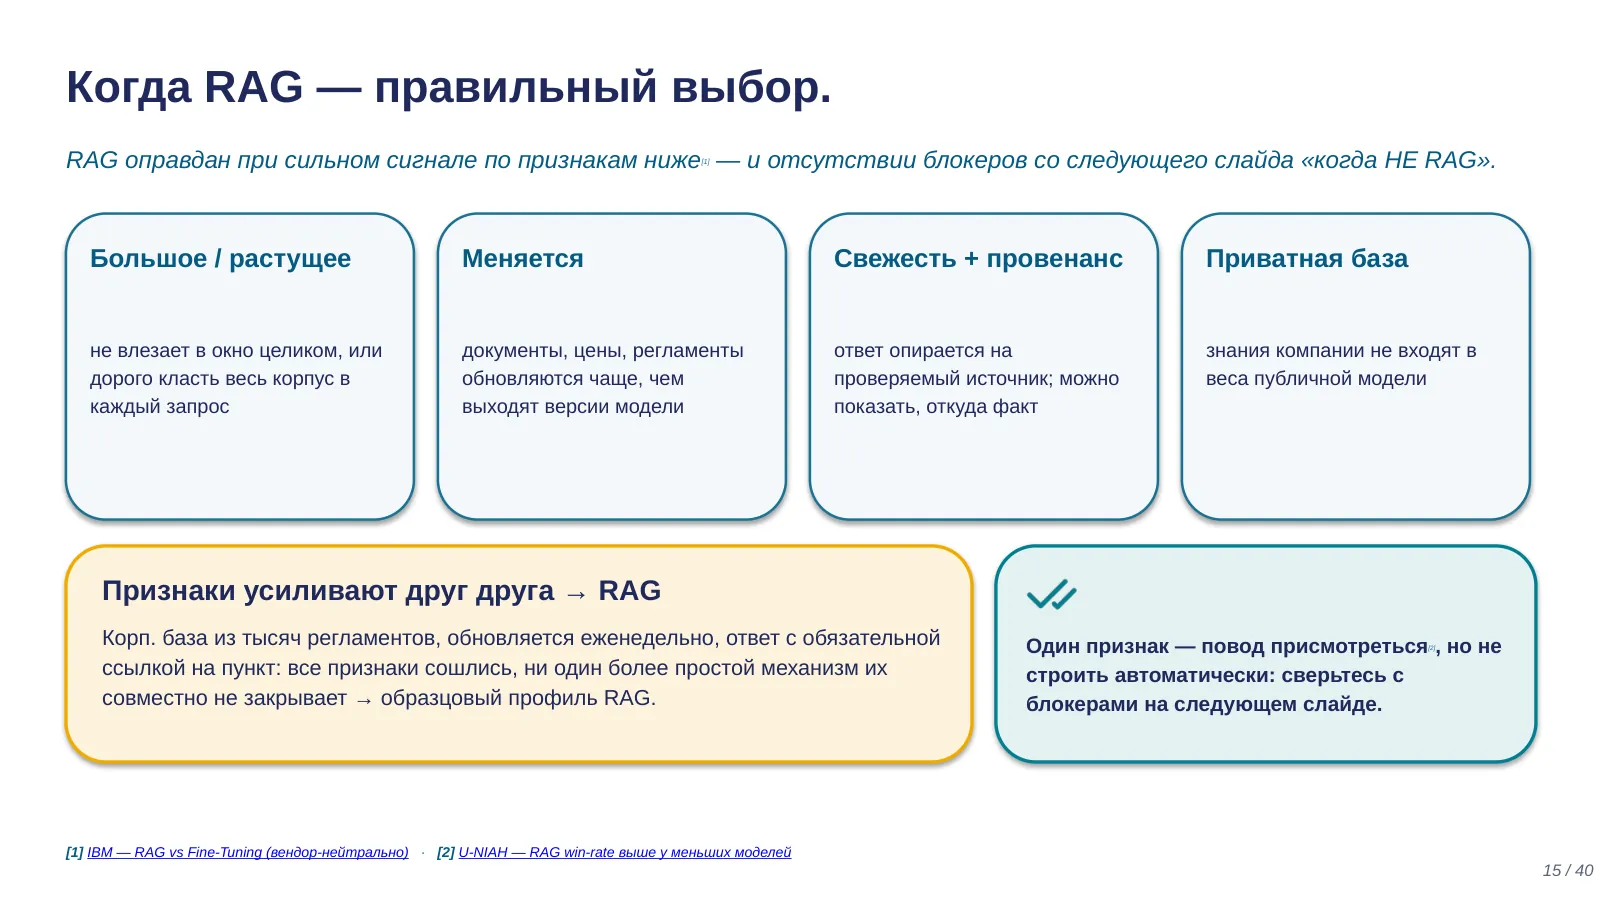
31 · RAG оправдан при сильном сигнале по признакам — и отсутствии блокеров с «когда НЕ»¶
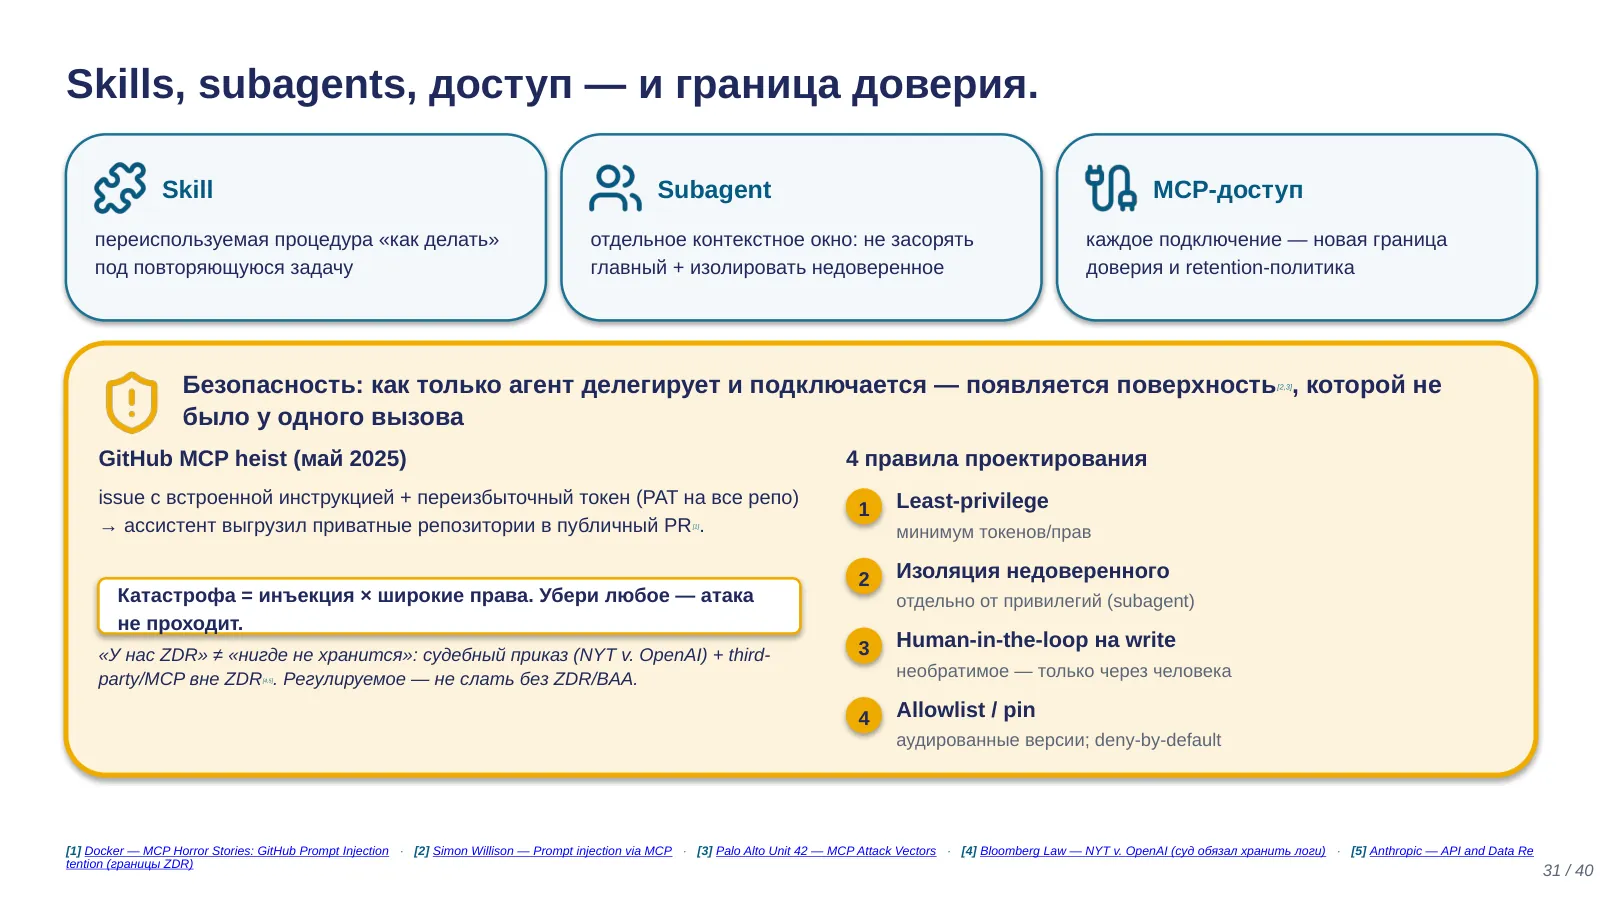
RAG — правильный выбор, когда налицо сильный сигнал по одному или нескольким признакам[1] и при этом нет блокеров с соседнего критерия «когда НЕ». Первый признак: знание большое или растущее — корпус не помещается в окно целиком, либо помещается, но класть его в каждый запрос дорого и медленно. Второй: знание меняется — документы, цены, регламенты обновляются чаще, чем выходят версии модели; RAG читает актуальное хранилище в момент запроса, и новый документ доступен сразу после индексации. Третий: нужны свежесть и провенанс — ответ должен опираться на проверяемый источник, и нужно показать, откуда взят факт; регулируемые домены почти всегда требуют провенанса. Четвёртый: база приватная — знания компании не входят в веса публичной модели.
Важна логика применения. Один явный признак — уже повод присмотреться к RAG, но не повод строить его автоматически: прежде чем решать, сверьте задачу с критериями «когда НЕ» — нет ли там блокера. Знание большое, но не меняется и помещается в окно — кандидат на длинный контекст, а не RAG. Знание меняется, но задача сводится к отдаче фиксированного значения — кандидат на детерминированный lookup. Признаки обычно усиливают друг друга: знание, одновременно большое, меняющееся, требующее провенанса и приватное, — это и есть профиль, под который RAG спроектирован, и чем больше признаков сходится, тем увереннее выбор. Формула короткая: сильный сигнал плюс отсутствие блокеров.
Рабочий пример, к которому вернёмся как к разбору чек-листа в финале: корпоративная база из тысяч регламентов, обновляемых еженедельно, вопросы на естественном языке, обязательная ссылка на пункт-источник. Все четыре признака сошлись, и ни один более простой механизм их совместно не закрывает, а проверка по критериям «когда НЕ» ничего не отменяет. Это образцовый профиль RAG. И практическое наблюдение: выигрыш RAG над прямым ответом особенно велик для меньших моделей — внешний retrieval компенсирует то, чего меньшей модели не хватает в весах, поэтому RAG нередко даёт нужное качество на более дешёвой модели.
Источники: [1] IBM — RAG vs Fine-Tuning (вендор-нейтрально) · [2] U-NIAH — RAG win-rate выше у меньших моделей
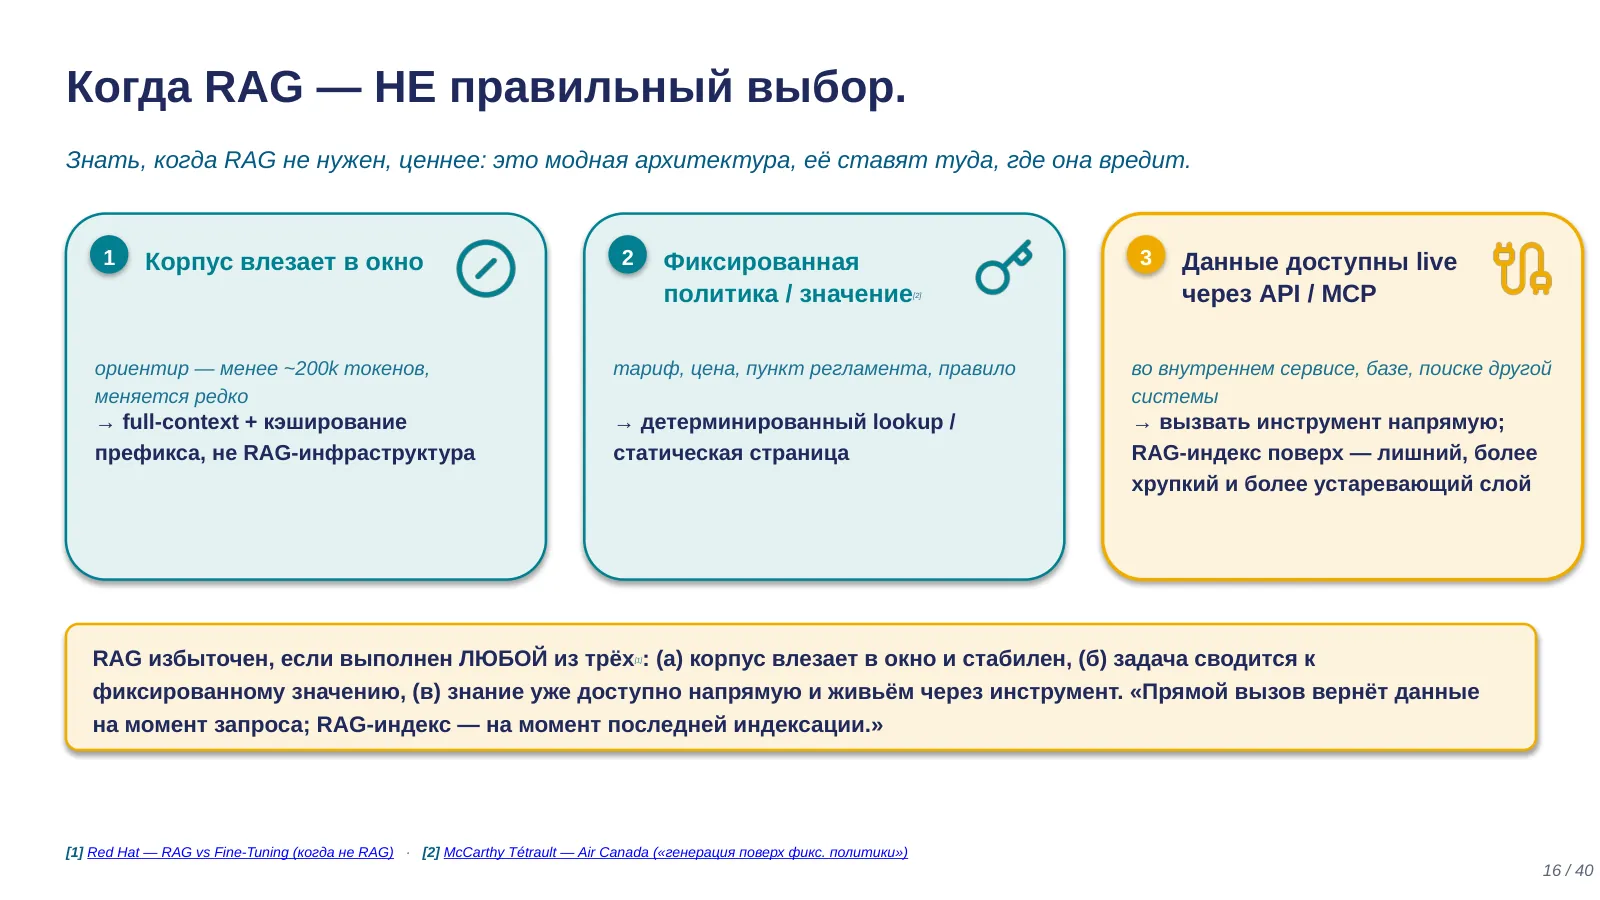
32 · Когда RAG НЕ нужен: влезает в окно → full-context; фикс. политика → lookup; данные live через API/MCP → инструмент напрямую¶
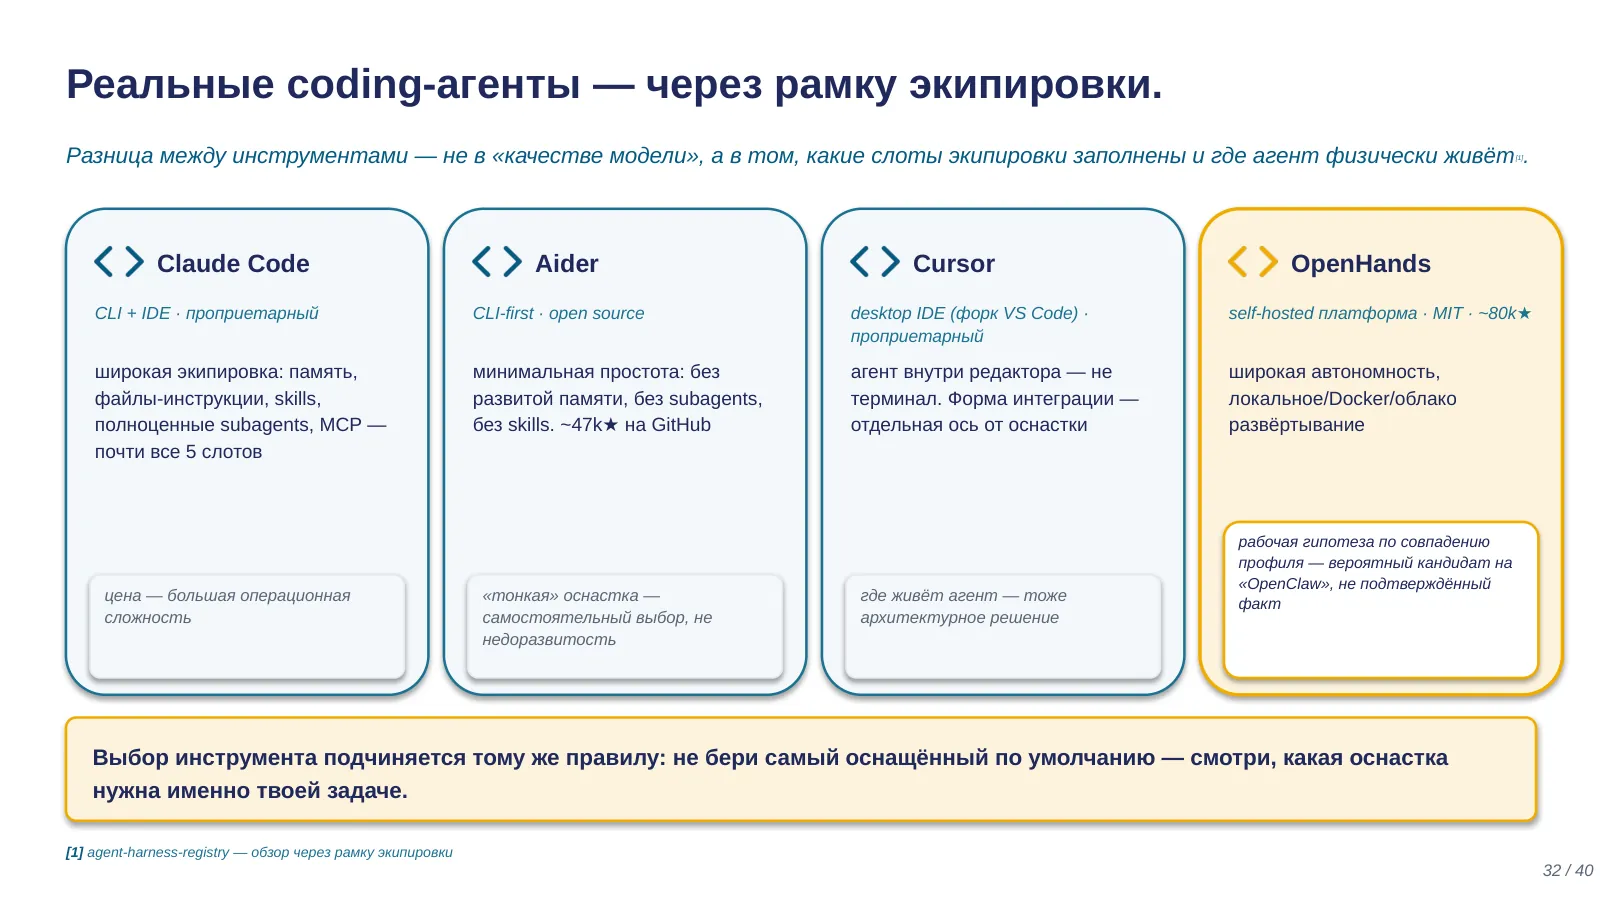
Знать, когда RAG не нужен, ценнее, чем знать, когда нужен, потому что RAG — модная архитектура, и её ставят туда, где она вредит. Три явных критерия «не RAG»[1].
Первый. Корпус помещается в окно — ориентир порядка менее двухсот тысяч токенов — и меняется не часто. Правильный ответ — full-context с кэшированием префикса, а не RAG-инфраструктура. Это проще, дешевле и не вносит риск «retrieval достал не то»: нет векторного хранилища, конвейера индексации, компонента retrieval, который может сломаться. RAG здесь куплен без необходимости.
Второй. Задача — отдать фиксированную политику или значение: тариф, цена, пункт регламента, правило. Если ответ детерминирован и заранее известен, правильная архитектура — детерминированный lookup или статическая страница, а не «retrieval плюс генерация поверх». Генерация поверх фрагмента всегда несёт риск, что модель перефразирует, обобщит или додумает — именно это произошло в деле Air Canada.
Третий критерий часто упускают. Данные уже доступны напрямую и живьём через API, MCP или поиск в другой системе. Если знание и так лежит во внутреннем сервисе с REST-интерфейсом или в базе, доступной через MCP, — строить отдельный RAG-индекс поверх него избыточно. RAG существует, чтобы дать доступ к знанию, до которого нет прямого пути; если путь уже есть, RAG добавляет лишний, более хрупкий и устаревающий слой. Разница стратегическая: прямой вызов инструмента возвращает данные на момент запроса, а RAG-индекс — на момент последней индексации. Признак прост: если на вопрос «а почему бы модели не спросить систему X напрямую через инструмент?» ответ — «действительно, почему бы и нет», — RAG не нужен.
Сведём в правило: RAG избыточен, если корпус помещается в окно и стабилен, если задача сводится к фиксированному значению, или если знание уже доступно живьём через инструмент. Выполнен любой из трёх — сигнал остановиться. И даже когда ни один не сработал и RAG оправдан, это не гарантирует, что он будет работать хорошо на масштабе, — отдельный вопрос.
Источники: [1] Red Hat — RAG vs Fine-Tuning (когда не RAG) · [2] McCarthy Tétrault — Air Canada («генерация поверх фикс. политики»)
33 · «Вернул что-то ≠ вернул правильное»: RAG без observability тихо деградирует; Air Canada — отказ grounding¶
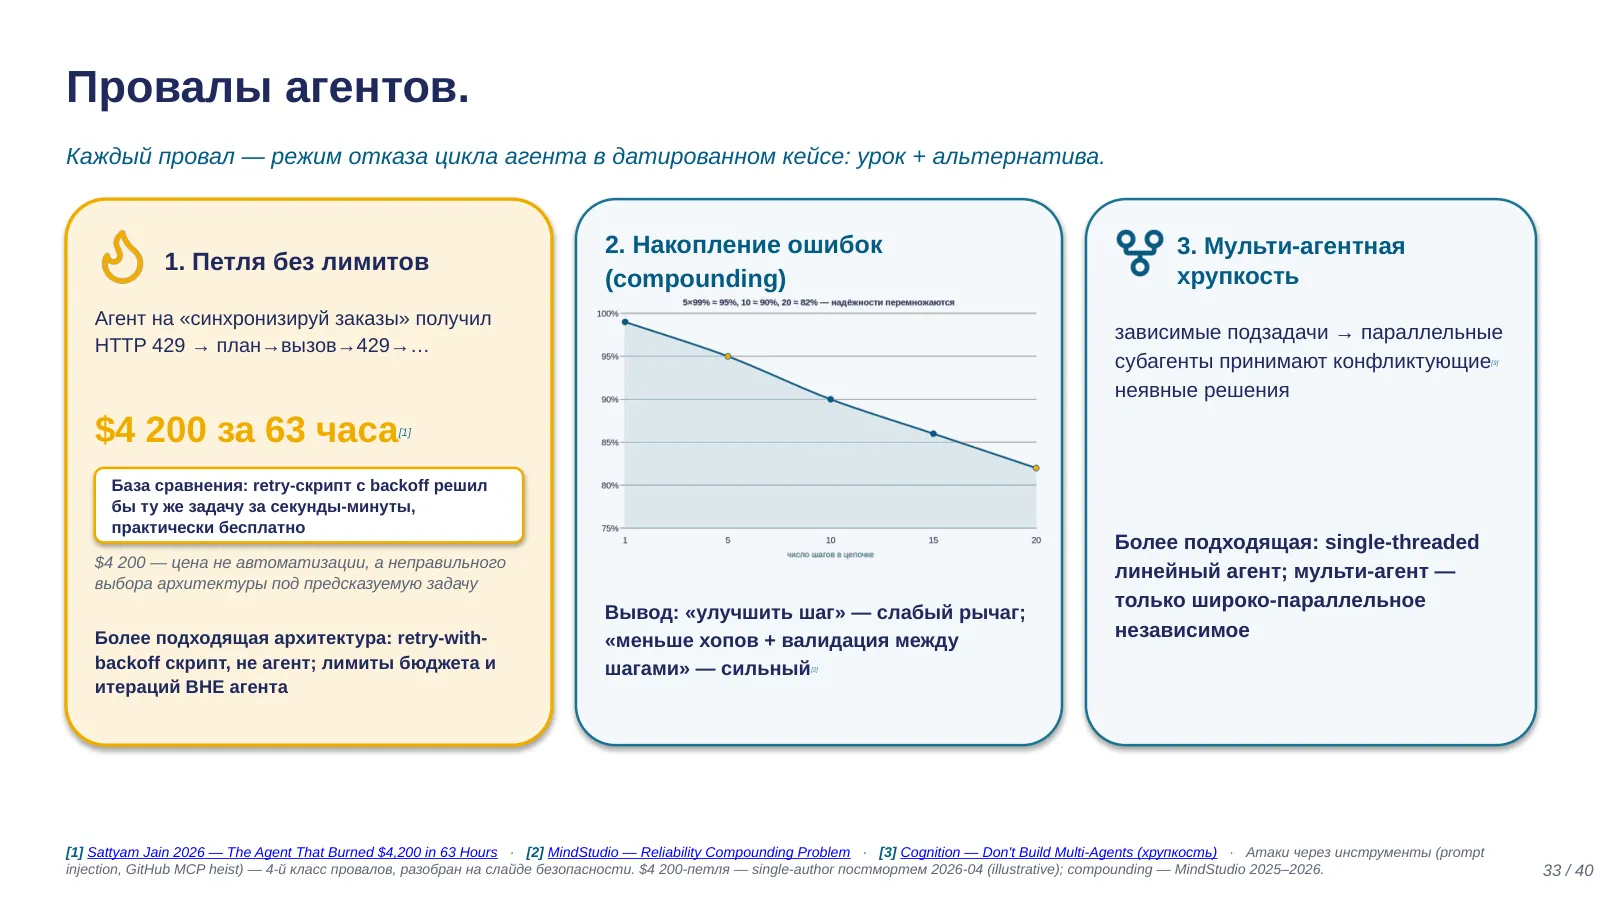
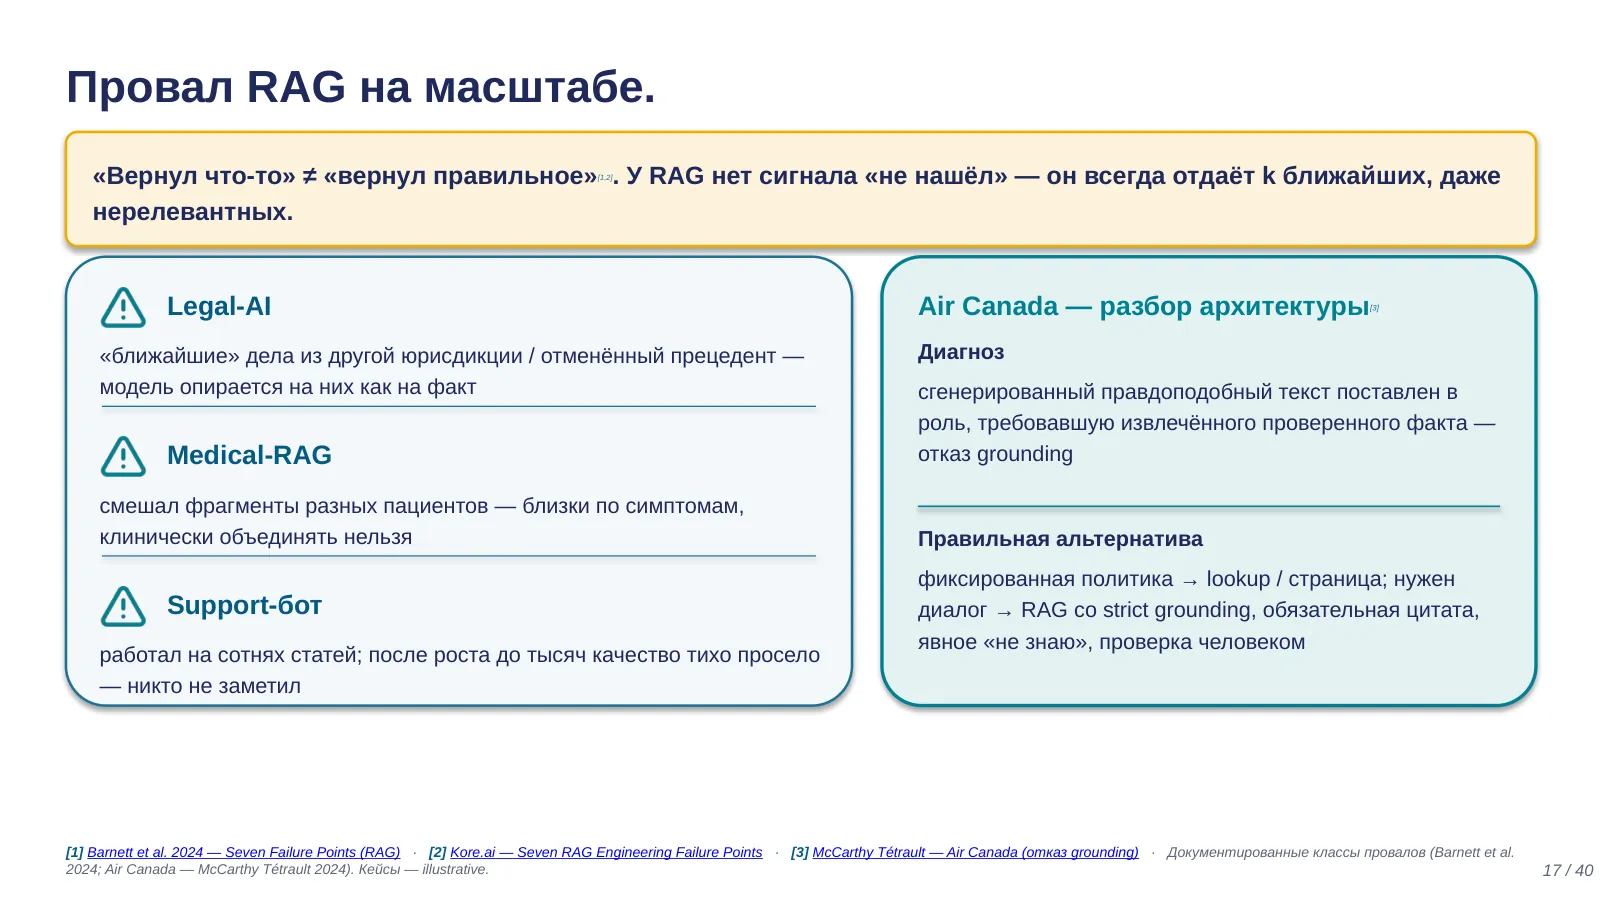
Урок раздела одной фразой: «система вернула что-то» не означает «система вернула правильное»[1,2]. RAG не имеет сигнала «я не нашёл подходящего» — по умолчанию он всегда возвращает k ближайших фрагментов, даже если они нерелевантны. Дальше модель честно делает свою работу: дали мусор — сочинит правдоподобный ответ поверх мусора.
Это не гипотетический риск, а известный паттерн инжиниринга RAG — семь точек отказа систематизированы у Barnett et al. (arXiv:2401.05856, 2024). Три класса. Legal-AI достаёт «ближайшие k» дел; по вектору близки дела со совпадающими словами, но юридически нерелевантные — другая юрисдикция, отменённый прецедент; модель встраивает их как опору. Векторная близость — это близость формулировок, не применимости. Medical-RAG: вопрос про одного пациента извлекает фрагменты, близкие по симптомам, но от других пациентов; модель объединяет то, что клинически объединять нельзя. Support-бот: работал на сотнях статей, после роста до тысяч качество незаметно просело — деградация на масштабе, потому что порога «достаточно ли близко» нет. Альтернатива везде — не «убрать RAG», а сделать его наблюдаемой системой: эталонный проверочный набор и алерты, нарезка по смысловым границам, гибридный поиск с переранжированием.
Теперь вернёмся к Air Canada[3] (дело Moffatt v. Air Canada, BC CRT, решение 14.02.2024) — с инструментами раздела. Бот сообщил про возврат разницы и сослался на страницу с реальной политикой; политика на той же странице такого возврата не допускала. Источник истины существовал, был доступен — но ответ был не выведен из него, а сгенерирован как правдоподобный текст. Это образцовый отказ grounding: сгенерированный текст в роли, требовавшей извлечённого факта. Правильная архитектура: для фиксированной политики — детерминированная страница или lookup; если нужен диалог — RAG со строгой опорой, обязательной цитатой, явным «не знаю» и человеческой проверкой. Air Canada — не «ИИ галлюцинирует», это решение поставить генеративную архитектуру на детерминированную задачу. Короткий вопрос вам: RAG вернул ответ — как узнать, что он правильный? Только измерением; на глаз правдоподобный от верного не отличить.
Источники: [1] Barnett et al. 2024 — Seven Failure Points (RAG) · [2] Kore.ai — Seven RAG Engineering Failure Points · [3] McCarthy Tétrault — Air Canada (отказ grounding)
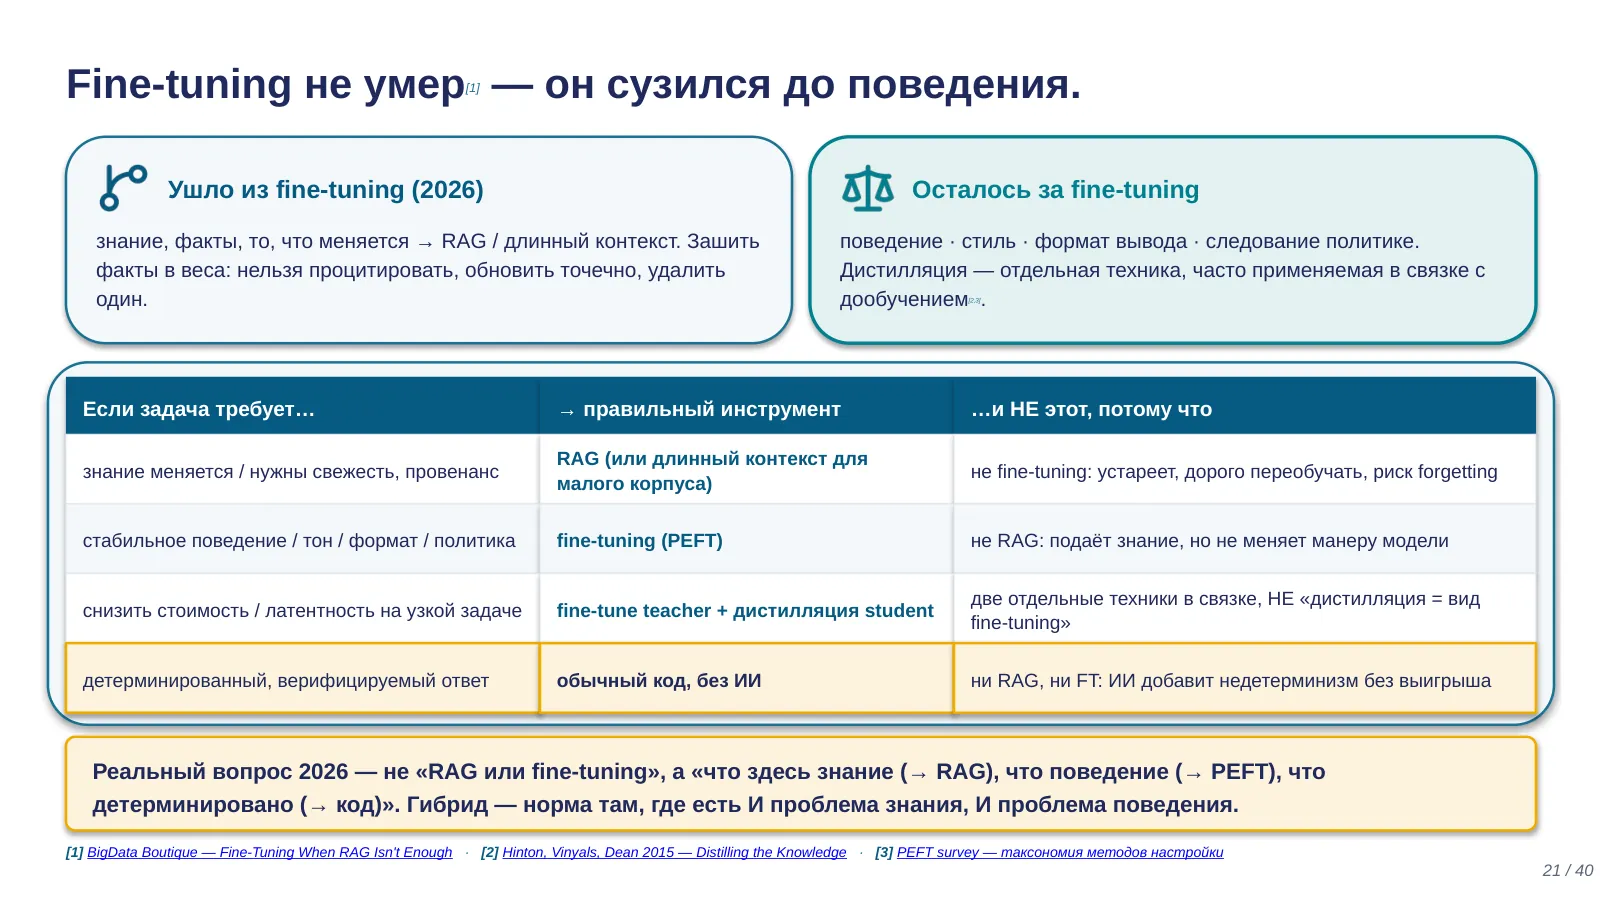
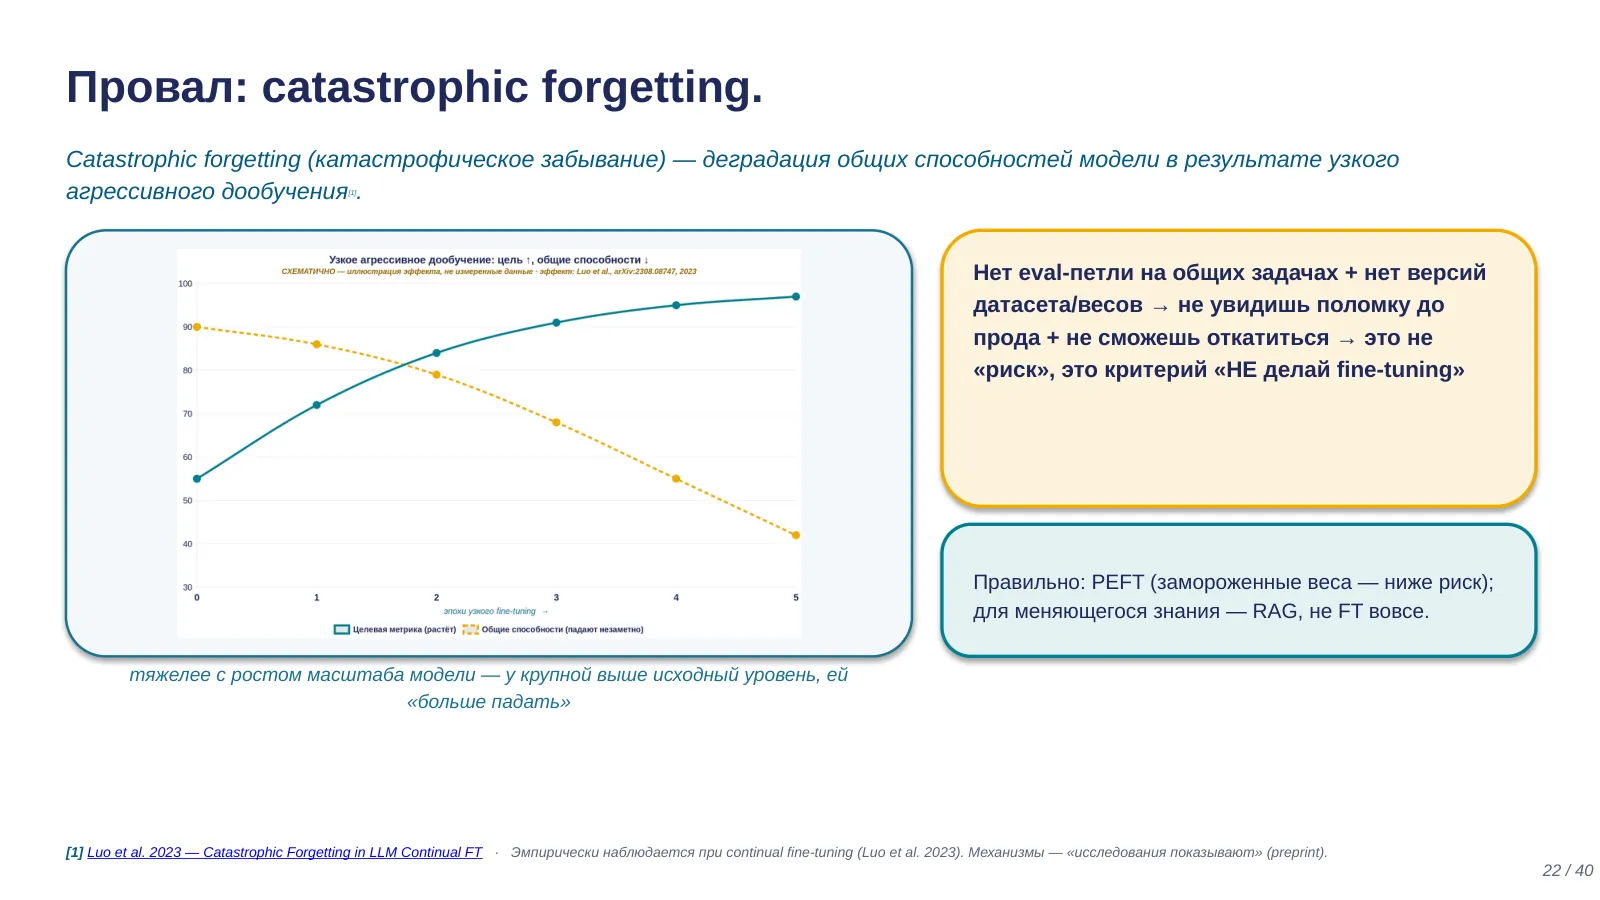
34 · Раздел 3 — fine-tuning против промпта и RAG: проблема не в знании, а в поведении модели¶
В прошлом разделе мы разобрали RAG и закрыли им один конкретный класс проблем — проблему знания. Когда модели не хватает фактов: они приватные, или меняются быстрее, чем выходят новые версии модели, или нужен провенанс — мы не переучиваем модель, мы подкладываем нужные документы в контекст. Мы также честно разобрали, когда RAG не нужен и как он тихо ломается на масштабе, и замкнули раздел обратно на дело Air Canada.
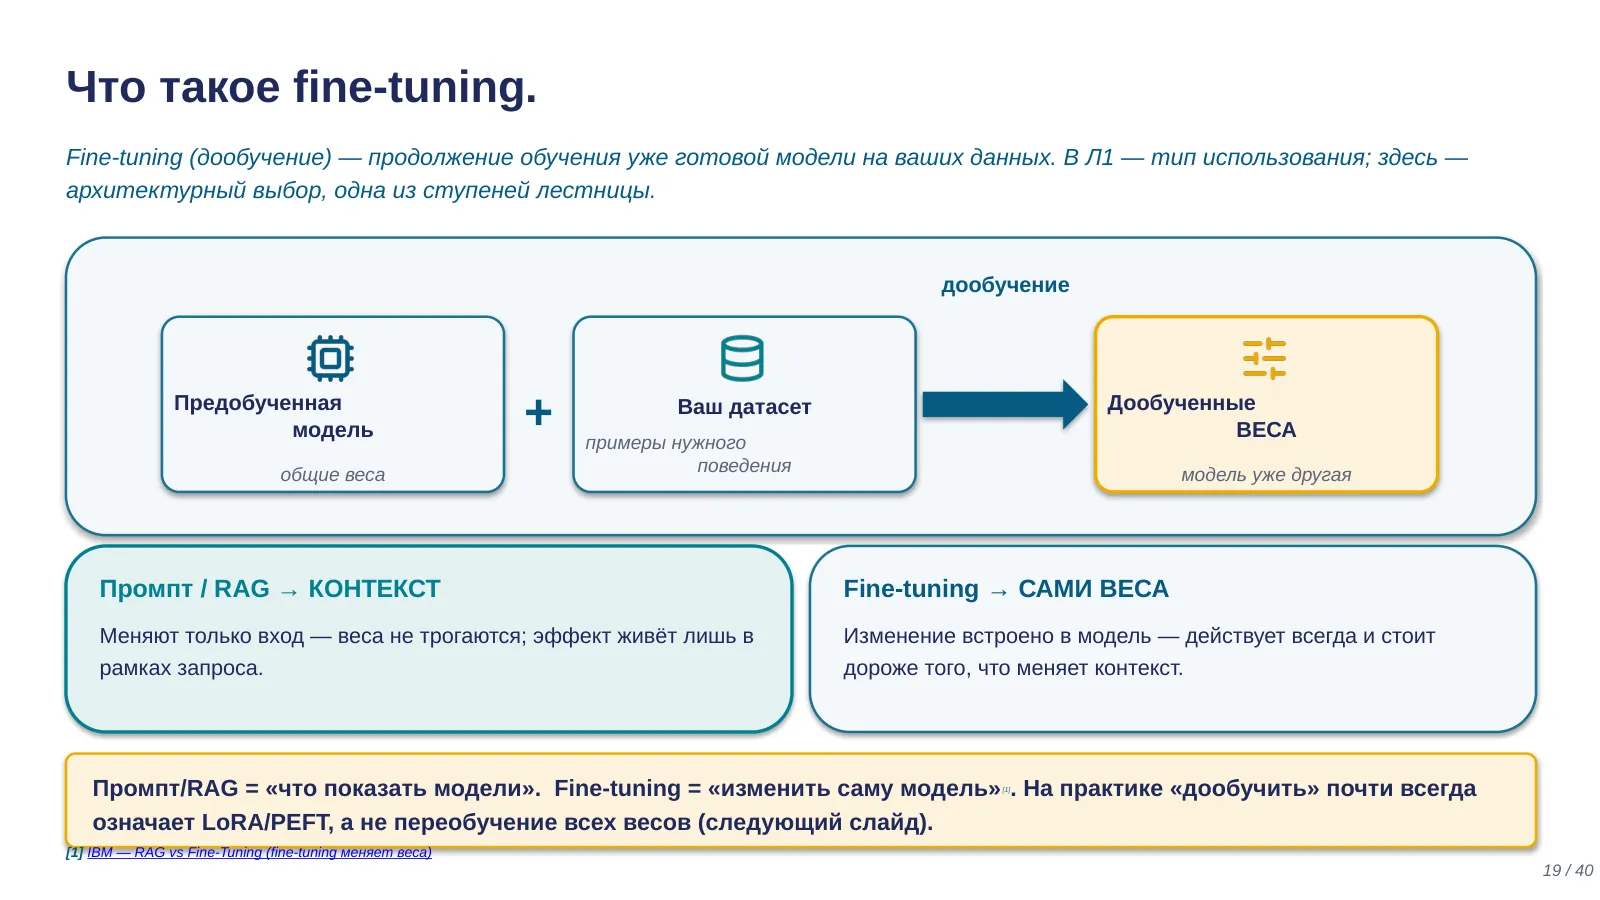
Но не всякая проблема — это проблема знания. Бывает, что фактов модели хватает, а не устраивает само поведение: она отвечает не в том тоне, не в том формате, не следует доменной политике, или вам нужна маленькая дешёвая модель, повторяющая поведение большой. Это другой класс задачи, и RAG его не решает — сколько документов ни подкладывай, тон от этого не изменится. Здесь на сцену выходит третий инструмент — fine-tuning, дообучение. И сразу важная оговорка по структуре раздела: следующий слайд — это не критика и не «когда не надо», а определение. Прежде чем разбирать, где fine-tuning сузился, где он проваливается через катастрофическое забывание и по каким критериям выбирать между ним, RAG и промптом, нужно одинаково понимать, что это вообще такое и чем оно принципиально отличается от двух уже знакомых инструментов. С определения и начнём.
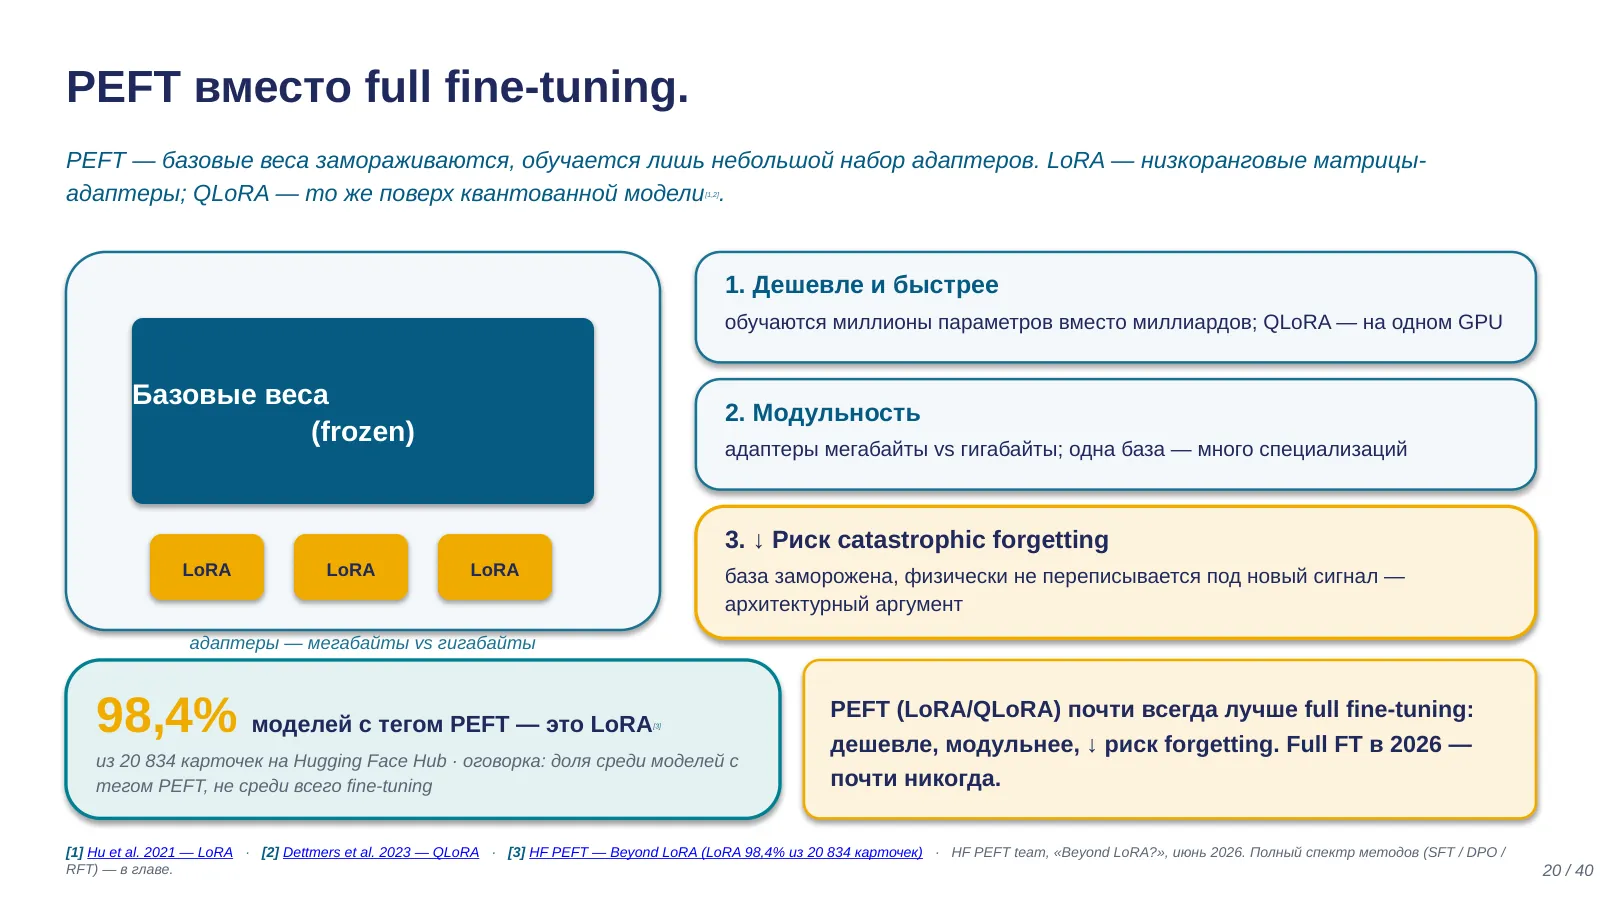
35 · Классическое ML: обучающая выборка, эталонная разметка, train/val/test split, transfer learning; PEFT/LoRA — тот же transfer learning, дешёвый, поверх pre-trained¶
Классическое машинное обучение решает задачу так. Обучение модели под задачу в до-LLM-парадигме — это построение своей модели на своих данных: инженер собирает размеченный набор примеров «вход → правильный ответ» и настраивает параметры так, чтобы модель воспроизводила эти ответы, а затем обобщала на новые. Центральный термин — обучающая выборка: множество размеченных примеров, на которых модель учится. Разметку называют эталонной разметкой, ground truth, — известный правильный ответ, с которым сравнивают предсказание. До эпохи больших моделей решить задачу ИИ почти всегда означало собрать свой датасет, выбрать архитектуру под задачу и обучить свою узкую подконтрольную модель.
Вторая несущая конструкция — дисциплина разбиения данных. Их делят на три непересекающиеся части: обучающую, валидационную и тестовую. На обучающей модель учится, на валидационной подбирают гиперпараметры, на тестовой — и только один раз, в конце — измеряют настоящее качество на данных, которых модель не видела. Железное правило: нельзя тестировать на обучающих данных, иначе точность окажется завышенной и рухнет в бою. Качество меряют явной метрикой, зафиксированной до обучения.
Третья классическая идея, и именно она ведёт к теме раздела, — transfer learning, перенос обучения. Задолго до больших моделей инженеры заметили: обучать с нуля дорого, но если взять модель, предобученную на огромном общем корпусе, и дообучить её на своей маленькой задаче, результат выходит быстрее и точнее. Это классическая двухфазная схема предобучение — дообучение.
Именно на неё стоит опереть переход к дообучению больших моделей. PEFT и LoRA — тот же transfer learning, только доведённый до предела дешевизны и поверх несравнимо более крупной модели. Идея не новая — новыми стали масштаб базовой модели и стоимость шага дообучения. Поэтому дообучить большую модель — не экзотика новой эпохи, а прямое продолжение классической схемы, и все её предостережения (дисциплина train/test, метрика, версии, мониторинг дрейфа) остаются в силе.
36 · Fine-tuning меняет САМИ ВЕСА; на практике почти всегда LoRA/PEFT, не full-FT¶
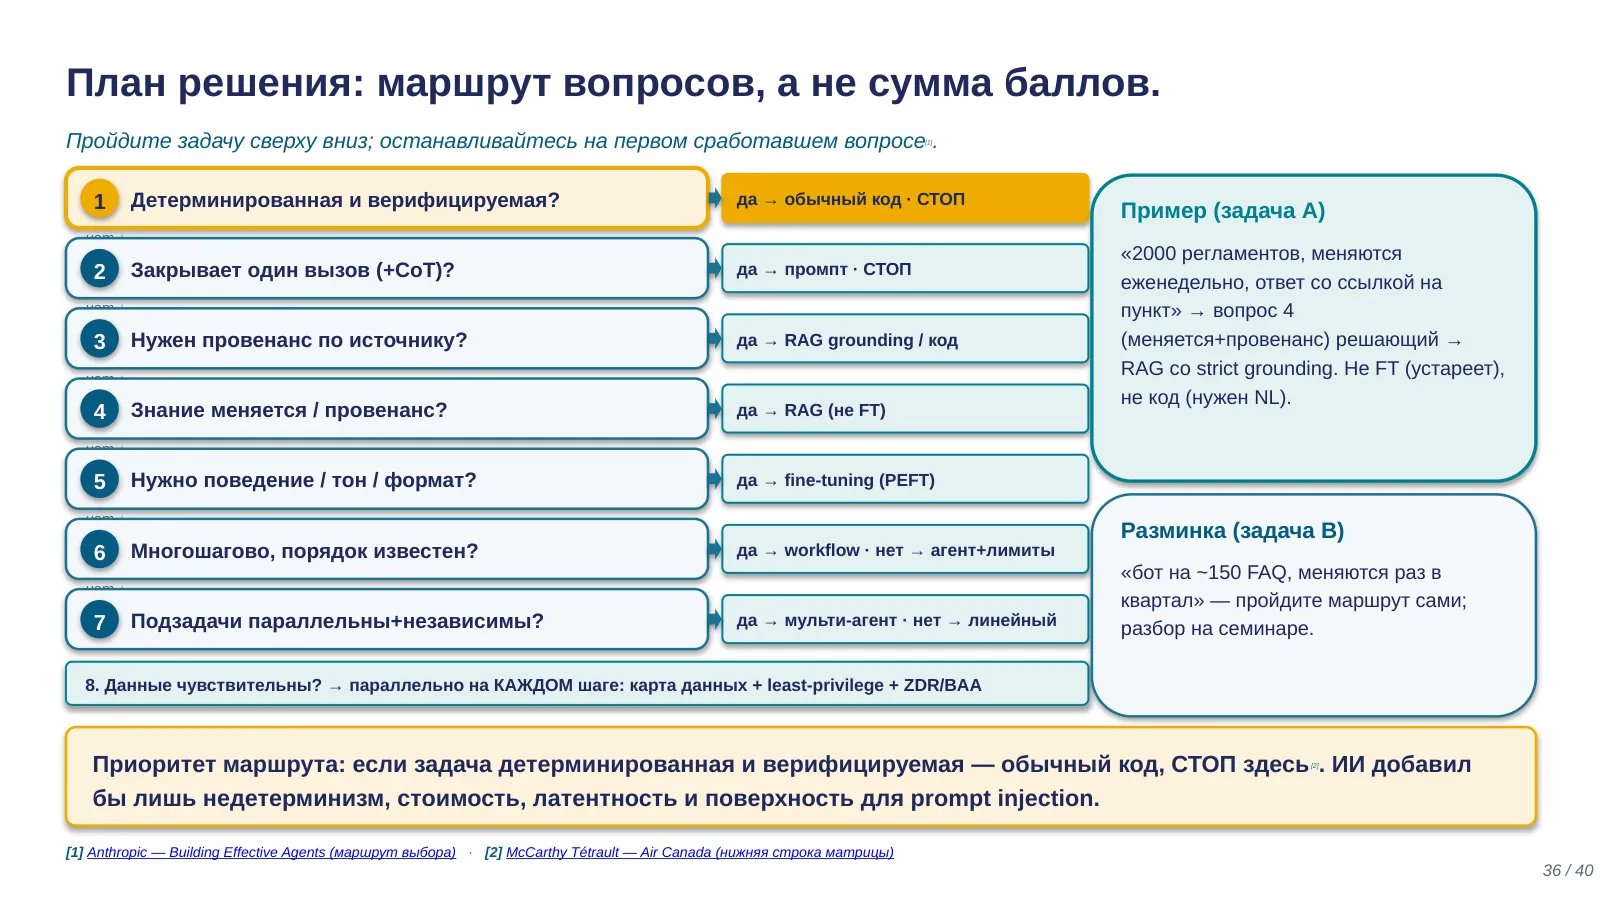
Прежде чем что-либо говорить про то, где fine-tuning сузился, где он опасен и по каким критериям его выбирать, нужно одинаково понимать, что это такое. Fine-tuning, по-русски дообучение, — это продолжение обучения уже готовой, предобученной модели[1] на ваших собственных данных. В Лекции 1 дообучение упоминалось мельком как один из типов использования ИИ; здесь оно появляется в своей настоящей роли — как архитектурный выбор, одна из ступеней той же лестницы сложности.
Механика на схеме: берётся предобученная модель с её общими весами, берётся ваш датасет — набор примеров того поведения, которое вы хотите получить, — и процесс дообучения сдвигает веса модели в сторону этих примеров. На выходе — уже другая модель: те же архитектура и размер, но другие числа внутри. Это и есть ключевое отличие, ради которого нужен отдельный слайд-определение. Промпт и RAG не трогают веса вообще: они меняют только контекст, то есть то, что вы подаёте модели на вход прямо сейчас. Эффект промпта или подложенного RAG-фрагмента живёт ровно в пределах одного запроса и исчезает со следующим. Fine-tuning меняет саму модель: изменение встроено в веса, действует на каждом запросе по умолчанию, и именно поэтому стоит дороже и откатывается тяжелее всего, что меняет лишь контекст.
Важная практическая оговорка сразу: на практике «дообучить модель» почти всегда означает не переобучение всех весов, а параметр-эффективное дообучение, которое обычно называют аббревиатурой PEFT и чаще всего реализуют методом LoRA. Полное дообучение всех весов в 2026 году — редкость, и на следующих слайдах мы разберём, почему это так. Пока запомните различие как формулу: промпт и RAG — это «что показать модели», fine-tuning — это «изменить саму модель». На следующих слайдах мы будем опираться на это определение, разбирая, почему в 2026 году fine-tuning сузился до поведения, а не знания, и где он превращается из инструмента в источник проблем.
Источники: [1] IBM — RAG vs Fine-Tuning (fine-tuning меняет веса)
37 · Стоимость обучения — функция размера модели: Full-FT VRAM ≈ 16–20 Б × N (растёт линейно), LoRA ≈ база + ε (почти плоско). LoRA — дефолт: <$10, дешевле претрейна на ~7 порядков¶
Соберём ось стоимости обучения так, чтобы её было проще держать в голове: не в абсолютных долларах, которые всё время движутся, а в относительных величинах. За базлайн берём Full-FT и считаем его единицей — ×1 по памяти, по деньгам и по компьюту. Все остальные варианты — доли от этой единицы. Так важен не точный ценник, а порядок и характер роста: где-то тысячи раз дороже, где-то — сотые доли. Именно это инженеру и нужно решить: какой вариант брать.
Пройдём по строкам таблицы. Обучаемые параметры: претрейн с нуля учит все веса, Full-FT тоже все сто процентов, LoRA и QLoRA — крошечный адаптер в 0,1–1% параметров, а промпт с RAG не меняет веса вовсе. Дальше это прямо проецируется на память, деньги и компьют. По VRAM Full-FT — базлайн ×1; LoRA примерно ×0,2 от него, потому что не надо держать градиенты и состояния оптимизатора на всю модель, только вес замороженной базы плюс адаптер; QLoRA ещё ниже, около ×0,05, потому что базу сжимают в четыре бита. По деньгам и компьюту контраст ещё резче: LoRA и QLoRA — порядка ×0,01 от Full-FT, то есть в сотню раз дешевле, а претрейн с нуля — наоборот, в тысячу с лишним раз дороже базлайна. Чтобы привязать это к жизни: полезный LoRA-файнтюн небольшой модели стоит меньше десяти долларов[1], тогда как претрейн фронтир-модели — десятки миллионов. Отсюда несущий контраст: LoRA дешевле фронтир-претрейна примерно на семь порядков. Строка «претрейн с нуля» стоит в таблице только чтобы задать масштаб — никто в зале не претренит.
Про QLoRA скажем честно: это не отдельный метод-конкурент, а модификатор поверх LoRA. Она не меняет, что обучается — те же LoRA-адаптеры, — она режет вес замороженной базы 4-битной квантизацией примерно вчетверо. Поэтому в таблице у неё те же относительные параметры, что у LoRA, только память ещё ниже: например, 65B-модель влезает в одну 48-гигабайтной карте[2]. По объёму данных и скорости картина такая же по характеру: претрейн требует триллионов токенов и месяцев, Full-FT и LoRA обходятся тысячами–десятками тысяч примеров, а промпт с RAG работает вовсе на few-shot из нескольких примеров и правится мгновенно. Вывод: обучение дёшево и дешевеет; Full-FT оправдан лишь когда датасет превышает ёмкость LoRA, а для узкой поведенческой адаптации он не покупает ничего сверх LoRA, зато добавляет память и риск забывания.
Источники: [1] Thinking Machines — LoRA Without Regret (LoRA ≈ Full-FT при условиях) · [2] Dettmers et al. 2023 — QLoRA (65B на одной 48-ГБ карте)
38 · PEFT (LoRA/QLoRA) почти всегда лучше full-FT; 98,4% моделей с тегом PEFT — это LoRA¶
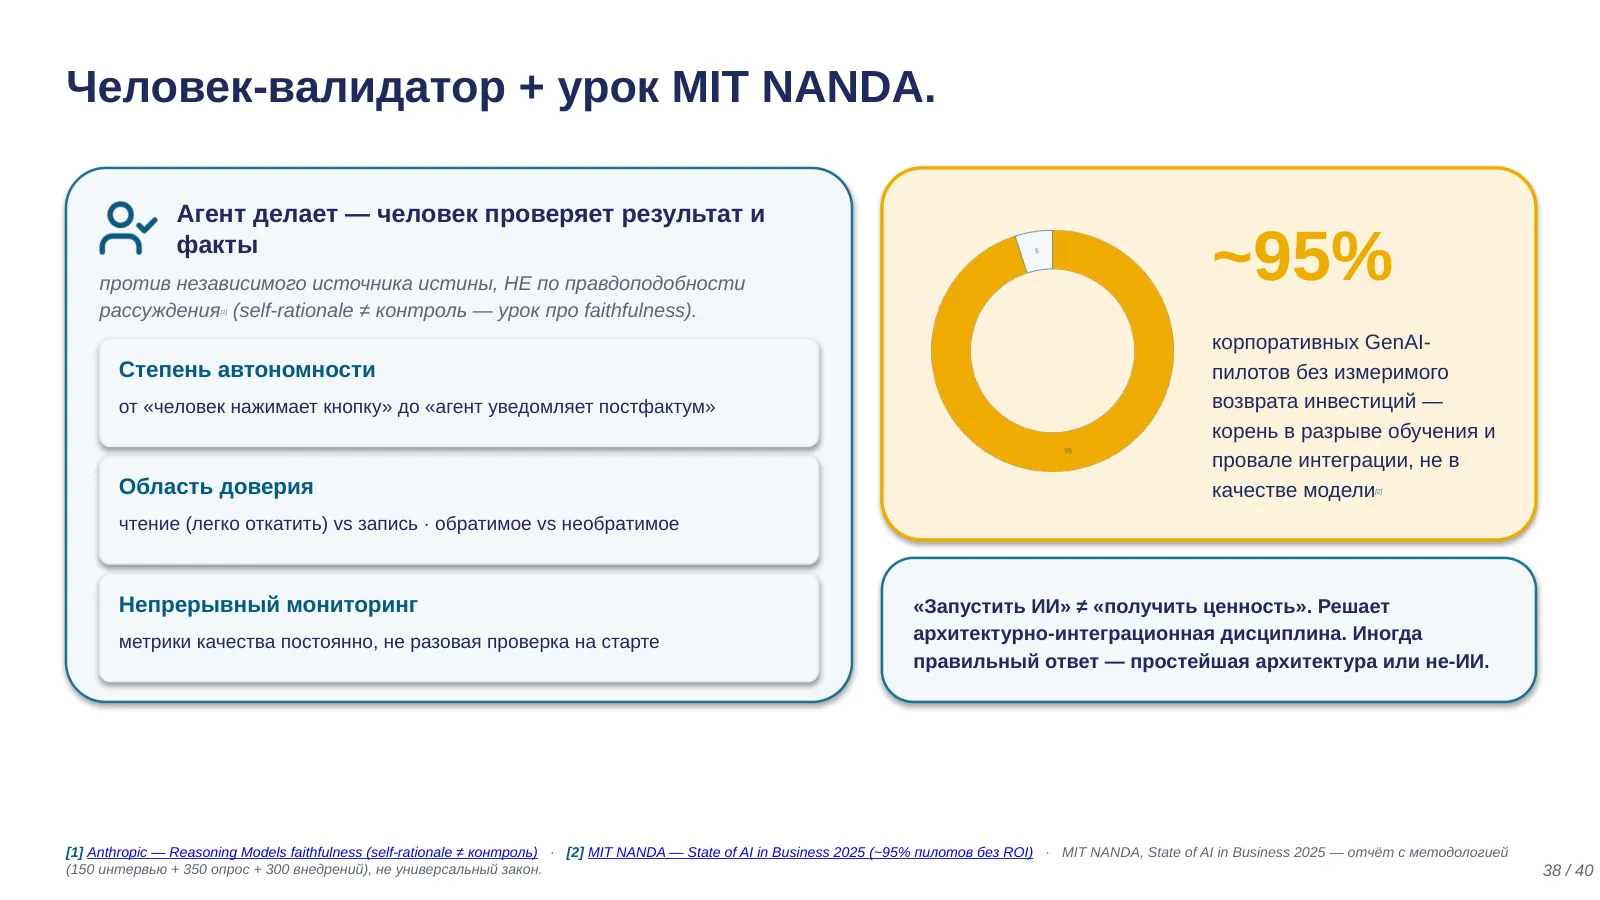
Слово «дообучить модель» у многих ассоциируется с обновлением всех весов — это full fine-tuning. В 2026 это почти никогда не то, что нужно. PEFT, параметр-эффективное дообучение, — семейство методов, при которых базовые веса замораживаются, а обучается лишь небольшой набор дополнительных параметров, адаптеров[1]. Наиболее распространённый метод — LoRA: в выбранные слои добавляются маленькие низкоранговые матрицы-адаптеры, и обучаются только они. QLoRA — та же идея поверх квантованной базовой модели, что радикально снижает требования к памяти.
Почему PEFT почти всегда предпочтительнее full fine-tuning — три причины, и третья решающая. Первая: дешевле и быстрее — обучаются миллионы параметров-адаптеров вместо миллиардов весов; QLoRA позволяет дообучать большие модели на одном GPU. Вторая: модульность — адаптеры маленькие, мегабайты против гигабайтов, и можно держать несколько адаптеров под разные задачи на одной замороженной базе. Третья, ключевой архитектурный аргумент про надёжность: базовые веса заморожены, физически не переписываются под новый сигнал, поэтому то, что модель умела до дообучения, в основном сохраняется — обучение живёт в маленьких добавочных адаптерах. Это прямо снижает риск катастрофического забывания, к которому мы сейчас перейдём.
Насколько LoRA распространён — не оценка на глаз, а измеримый факт. По данным команды PEFT Hugging Face, среди 20 834 карточек моделей с тегом PEFT 98[3].4 процента используют именно LoRA. Оговорка обязательна: это доля среди уже помеченных тегом PEFT, а не среди всего fine-tuning — полное дообучение помечается тегами не так аккуратно и в выборке может быть не видно. Тем не менее среди выбравших параметр-эффективный путь LoRA — практически безальтернативный выбор по умолчанию. И граница: и full FT, и PEFT — это изменение весов, в отличие от RAG, промпта и контекста, которые веса не трогают. Это водораздел между «разместить знание» — RAG и контекст — и «закодировать поведение» — PEFT. В нарративе достаточно: full FT — почти никогда, PEFT и LoRA — рабочая лошадка 2026 года.
Источники: [1] Hu et al. 2021 — LoRA · [2] Dettmers et al. 2023 — QLoRA · [3] HF PEFT — Beyond LoRA (LoRA 98,4% из 20 834 карточек)
39 · FT сузился до поведения: знание→RAG, поведение→PEFT, детерминированное→код; гибрид — норма¶
Разложим по сути вопрос, который постоянно путают на практике: не «RAG или fine-tuning», а «что здесь знание, а что поведение». Если задача требует знания, которое меняется или нуждается в свежести и провенансе, — правильный инструмент RAG или длинный контекст, а не дообучение: знание в весах устареет к следующему изменению корпуса, переобучение дорого, и есть риск катастрофического забывания. Если задача требует стабильного поведения, тона, формата вывода или следования политике, а не новых фактов, — правильный инструмент дообучение в форме PEFT, а не RAG: RAG подаёт знание в контекст, но не меняет манеру модели отвечать. Если цель — снизить стоимость и задержку на узкой задаче при сохранении качества, работает связка из двух отдельных техник: сначала дообучают крупную модель-учителя под нужное поведение, а затем из неё дистиллируют компактную модель-ученика. Это не «дистилляция как разновидность fine-tuning» — таксономически это разные операции, которые на практике часто идут в паре. И если ответ должен быть детерминированным и верифицируемым — правильный инструмент обычный код без ИИ вообще: ни RAG, ни дообучение здесь не нужны, они добавят только недетерминизм.
Вывод 2026 года снимает ложную дихотомию: чистый выбор «одно из» — редкость, норма — гибрид[1]. Типичная зрелая система сочетает RAG для знаний, которые меняются, PEFT-дообучение для стабильного поведения и контекст-инжиниринг поверх обоих. Но здесь важна оговорка, чтобы «гибрид — норма» не превратилось в новый карго-культ «делай всё сразу»: гибрид оправдан только там, где у задачи одновременно есть и проблема знания, и проблема поведения. Если проблемы поведения нет — дообучение не нужно, даже если RAG уже есть. Если знание не меняется и его мало — не нужен и RAG. Гибрид — это не «больше компонентов — вернее», это «знание и поведение разнесены по правильным механизмам, каждый из которых добавлен под своё собственное требование», а не по инерции или моде.
Источники: [1] BigData Boutique — Fine-Tuning When RAG Isn't Enough
40 · Дистилляция — это дообучение маленькой student-модели; отличается ЦЕЛЬЮ (матчить распределение teacher, soft logits) и ДАННЫМИ (генерирует teacher), а не тем, что «не обучение». DistilBERT −40%/97%, Alpaca 52k/<$600¶
Здесь исправляем формулировку, вокруг которой ходит устойчивое недоразумение. Расхожая фраза «дистилляция — это не дообучение» неверна. Ученика — маленькую student-модель — действительно дообучают, поэтому оба утверждения истинны одновременно: «это дистилляция» и «это дообучение маленькой модели». Выбор «или-или» — ложная дихотомия. Дистилляция реализуется через fine-tuning student-модели, то есть является дообучением; отличается она от обычного supervised fine-tuning не тем, «обучают или нет», а по двум другим осям.
Первая ось — цель, то есть что именно мы матчим. При обычном дообучении ученик учится на «жёстких» метках вида «вот единственный правильный класс или ответ». При дистилляции ученик матчит мягкое распределение учителя[1] — те вероятности, которые учитель приписывает всем вариантам сразу, а не только правильному. В этом мягком распределении сидит так называемое «тёмное знание» (dark knowledge): учитель сообщает не только «это кошка», но и «кошка похожа на собаку сильнее, чем на грузовик». Классическая token-level-дистилляция минимизирует KL-дивергенцию между распределениями ученика и учителя.
Вторая ось — данные, то есть откуда берётся обучающий сигнал. При дистилляции его генерирует сам учитель, а не человек-разметчик. Отсюда response-distillation — обучение на текстах-ответах учителя, которое работает даже без доступа к логитам, через обычный API. Два датированных примера делают это конкретным. DistilBERT[2] (Sanh и соавторы, 2019): student на 40% меньше по числу параметров и на 60% быстрее, при этом сохраняет 97% способностей учителя на GLUE — база сравнения тут сам BERT-base как учитель, то есть отдали 3% качества за −40% размера. Alpaca (Stanford, 2023): LLaMA-7B дообучили на 52 000 инструкций, сгенерированных GPT-3.5, за менее чем 600 долларов — против десятков тысяч долларов, если бы те же инструкции собирали вручную.
И обязательный провал: у дистилляции жёсткий потолок способностей. Ученик почти никогда не превосходит учителя — учитель задаёт верхнюю границу качества сигнала — и наследует его ошибки и смещения, но уже без способности учителя «поймать себя». Дистиллируете GPT-3.5 — получаете не-лучше-GPT-3.5, а не сильную маленькую модель из ниоткуда. Поэтому корректная рабочая формулировка — «дообучить компактную student-модель на выходах сильной teacher»: это и дообучение, и дистилляция сразу.
Источники: [1] Hinton, Vinyals, Dean 2015 — Distilling the Knowledge · [2] Stanford Alpaca 2023 / Sanh et al. 2019 DistilBERT
41 · Узкий агрессивный fine-tuning ломает общие способности; без eval-петли и версий — критерий «не дела黶
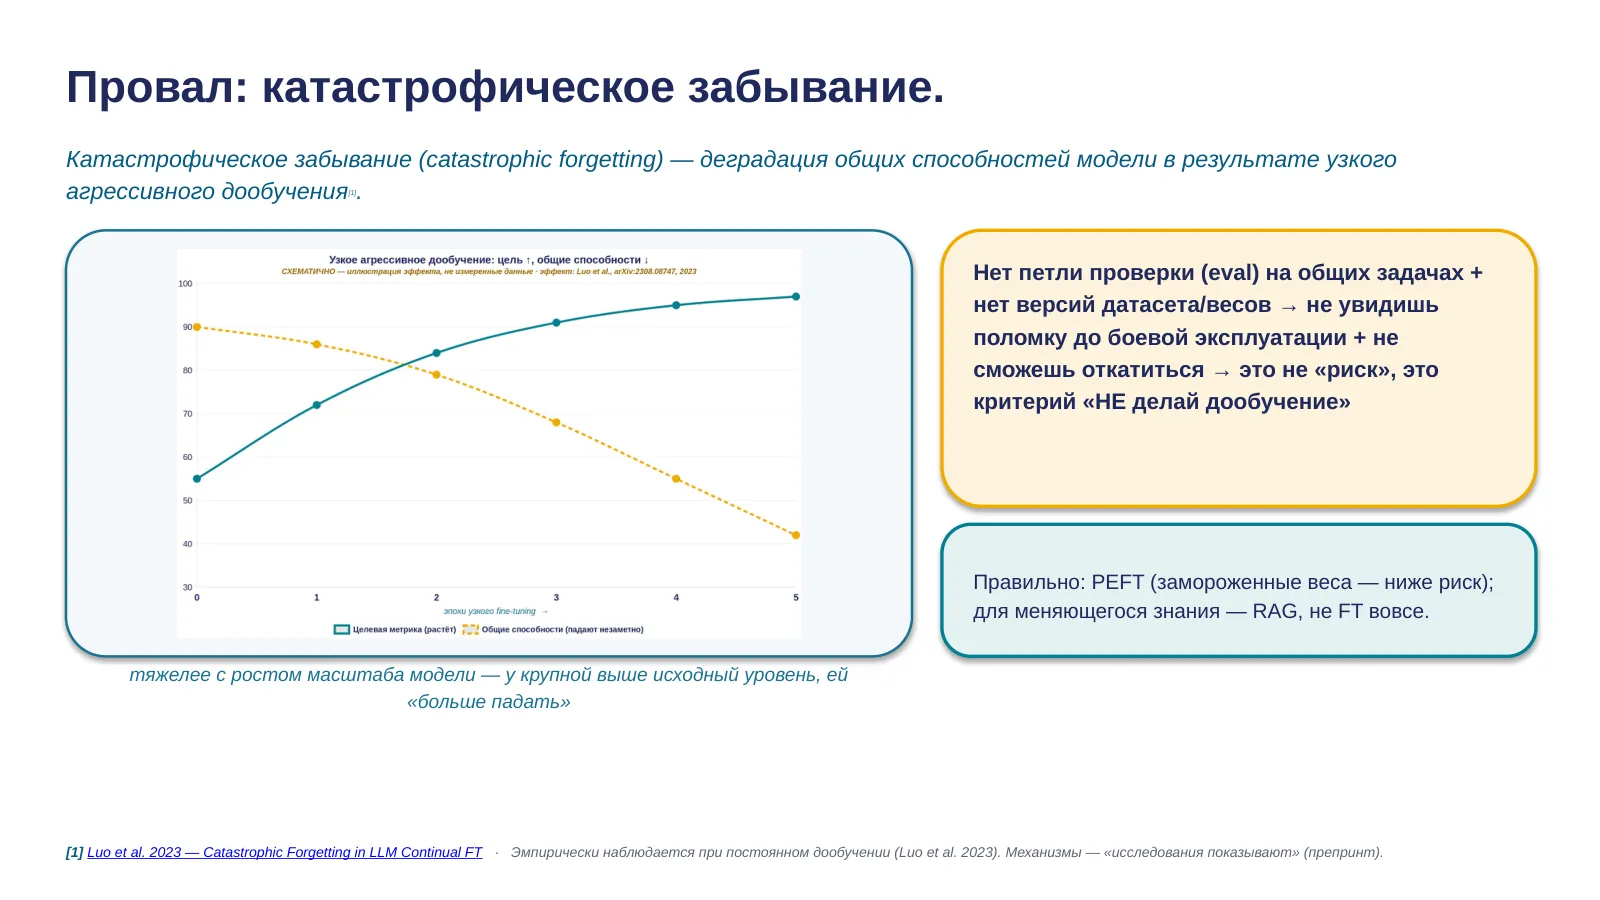
Введём термин через документированный провал. Catastrophic forgetting, катастрофическое забывание, — деградация общих способностей модели[1] в результате узкого агрессивного дообучения: обучая модель быть очень хорошей в одной узкой задаче, вы можете сломать то, что она умела до этого.
Как это выглядит как кейс. Команда дообучает модель на узком датасете — например, классификация тикетов в их формат. На целевой метрике рост: модель отлично классифицирует. Параллельно, незаметно, проседают общие способности: рассуждение на нецелевых задачах, следование сложным инструкциям. На графике это две линии: сплошная, идущая вверх, — целевая метрика (растёт), а пунктирная, идущая вниз, — общие способности (падают незаметно). Если команда мерила только целевую метрику, деградация не видна, пока модель не начнут использовать на чём-то, кроме узкой задачи. И тогда «почему она вдруг хуже стала рассуждать?» оказывается следствием дообучения месячной давности, к которому уже нет ни старых весов, ни версии датасета. Механически: обучение под узкую задачу двигает веса в её сторону, и параметры, кодировавшие общие способности, при агрессивном full-FT переписываются. Это эмпирически наблюдается при continual fine-tuning (Luo et al., arXiv:2308.08747, 2023), причём с контринтуитивной особенностью: с ростом масштаба модели тяжесть забывания, как правило, возрастает. «Возьмём модель побольше, чтобы надёжнее» здесь работает наоборот.
Почему это попадает в раздел про выбор архитектуры, а не в курьёзы. Сам по себе forgetting — управляемый риск. Катастрофическим его делает отсутствие инженерной дисциплины: нет петли оценки, которая на репрезентативном наборе общих задач показала бы деградацию; нет версионирования датасета и весов для отката. Без eval-петли вы не заметите, что сломали общие способности, пока это не всплывёт в проде; без версионирования не вернётесь к работавшей версии. Правило: если нет eval-петли и версионирования датасета — не делайте fine-tuning. Это не «риск», это критерий: не будет ни сигнала о поломке, ни кнопки отката. Правильные альтернативы: PEFT, где замороженные веса дают ниже риск; а для меняющегося знания — RAG, а не fine-tuning вовсе.
Источники: [1] Luo et al. 2023 — Catastrophic Forgetting in LLM Continual FT
42 · Оценка обучения дороже самого обучения и не решена: ни один из ШЕСТИ методов не самодостаточен (MMLU ~29%, GSM8K→GSM1k −13 п.п., судья позиция 75%, human κ≥0,6 $300–1200, BLEU r≈0,25–0,52); разрыв lab→prod ~37% — прирост на бенчмарке гипотеза, не результат¶
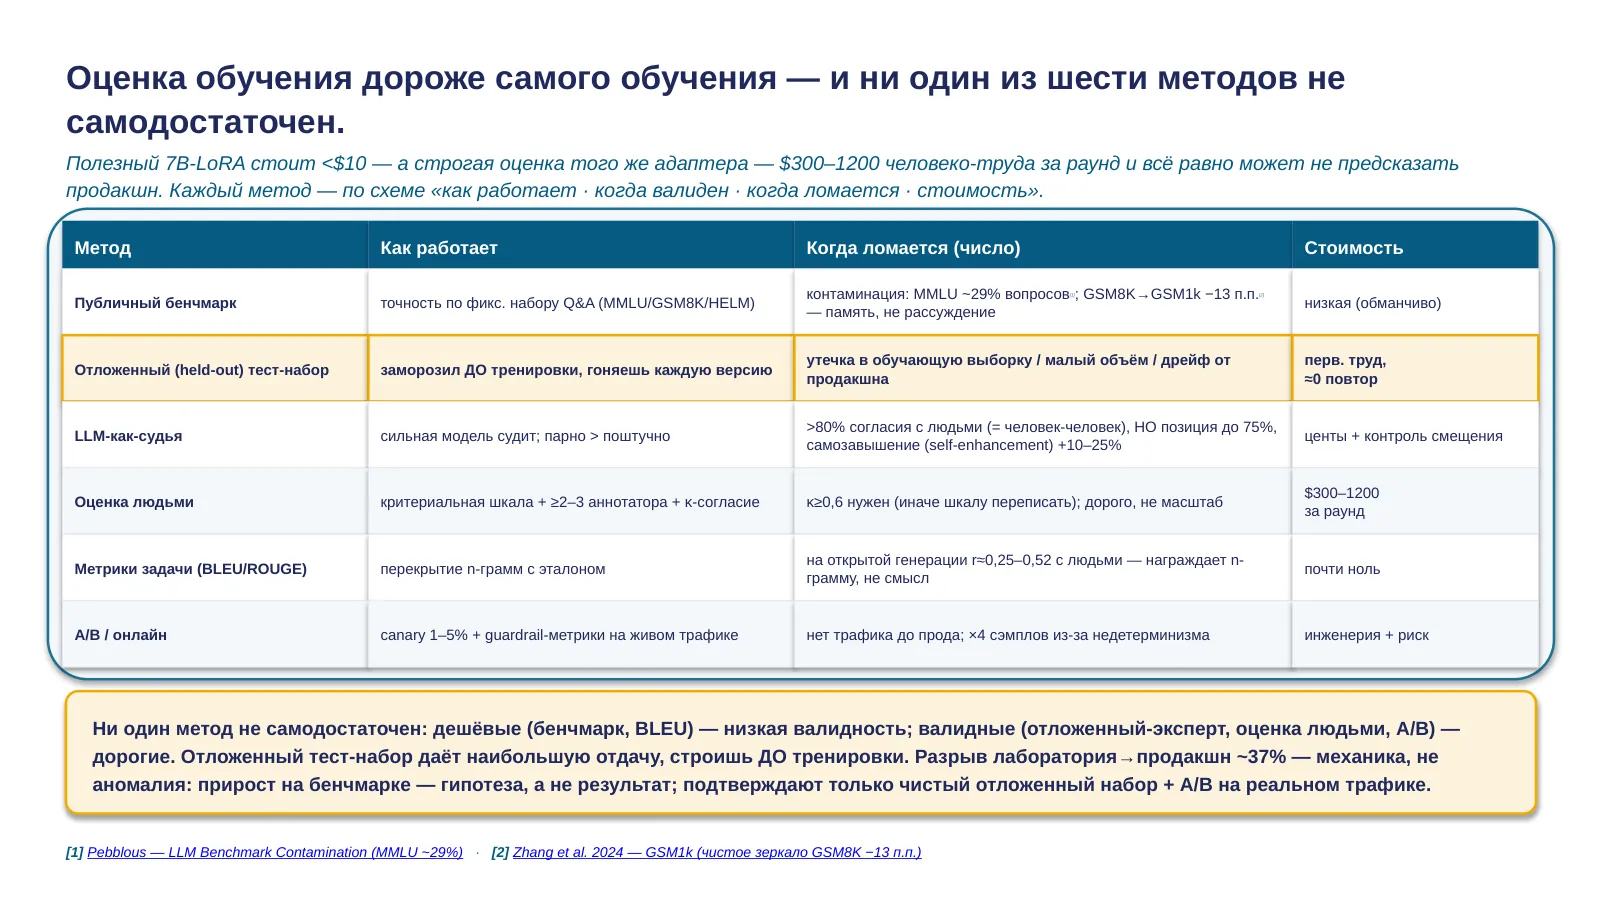
Здесь переворачивается интуиция: инженеры боятся стоимости тренировки, а бюджетная строка — оценка. Полезный 7B-LoRA стоит единицы долларов, а строгая оценка того же адаптера — 300–1200 долларов человеческого труда за один раунд, и всё равно может не предсказать продакшн. Разберём шесть методов, каждый по одной жёсткой схеме: как работает пошагово, когда валиден, когда ломается, чего стоит.
Первый — публичные бенчмарки: MMLU, GSM8K, HELM. Фиксированный набор вопросов с известными ответами, метрика — доля угаданных, прогон дешёвый и без людей. Валиден для проверки широких способностей и отлова забывания. Ломается на двух вещах. Контаминация: тестовые вопросы утекли в претрейн — около 29% items MMLU показали признаки контаминации[1], а на чистом зеркале GSM8K, то есть на GSM1k, точность падает до тринадцати пунктов[2], значит меряется память, а не рассуждение. И нерелевантность: доменный LoRA может быть лучше в вашем домене и хуже на MMLU. Второй — held-out тест-сет: отобрали и разметили примеры вашей задачи до обучения, заморозили, гоняете каждую версию. Это единственное, что меряет именно вашу задачу, — самый высокий ROI; ломается только на утечке в трейн или дрейфе. Третий — LLM-как-судья: сильная модель судит выход, pairwise надёжнее pointwise. Даёт больше 80% согласия с людьми, но систематически смещён: позиционное смещение до 75% предпочтения первому ответу, self-enhancement плюс 10–25% в пользу своей же семьи. Тут важно: воспроизводимость вердикта не равна его правильности.
Четвёртый — человеческая оценка: rubric, два-три аннотатора, межэкспертное согласие каппа. Порог существенный — каппа не ниже 0,6, иначе rubric надо переписывать. Золотой стандарт для открытого качества, но дорого и не масштабируется: набор 200 примеров на трёх оценщиков — 300–1200 долларов за раунд. Пятый — task-метрики: exact-match, F1, BLEU, ROUGE. Валидны для закрытых задач с единственным правильным ответом. На открытой генерации ломаются: меряют перекрытие n-грамм, а не смысл, корреляция с людьми r от 0,25 до 0,52 — корректный парафраз штрафуется. Шестой — A/B онлайн: canary на 1–5% трафика с guardrail-метриками. Единственный метод, меряющий реальное поведение; ломается тем, что до продакшена неприменим, а из-за недетерминизма LLM нужно примерно вчетверо больше сэмплов.
Сквозной вывод: ни один метод не самодостаточен. Дешёвые — худшая валидность, валидные — дорогие. Измеренный разрыв между лабораторным бенчмарком и продакшеном около 37% — это механика, не аномалия: прирост на бенчмарке это гипотеза, а не результат; подтверждают только чистый held-out плюс A/B на реальном трафике, и на этот разрыв надо закладывать бюджет.
Источники: [1] Pebblous — LLM Benchmark Contamination (MMLU ~29%) · [2] Zhang et al. 2024 — GSM1k (чистое зеркало GSM8K −13 п.п.)
43 · Раздел 4 — Агенты: цикл, экипировка, память, доступ к инструментам — и где всё это ломается¶
Это крупный раздел лекции, и он про то, как AI перестаёт быть собеседником в окне чата и становится компонентом системы. До сих пор один вызов и RAG мы обсуждали как способ получить текст; здесь модель получает возможность возвращать машинно-обрабатываемые данные, дотягиваться до внешних систем и работать в цикле. Мы разберём механику API-слоя и стандарт подключения инструментов, затем сам цикл агента и различение рабочего потока и агента, потом — из чего собран реальный агент-помощник, где живёт его память и как всё это ломается. Здесь же по-настоящему встаёт сквозная тема безопасности: как только модель получает инструменты, появляется вопрос, которого не было у одного вызова, — кто видит данные на каждом шаге и что происходит, когда недоверенный контент попадает в контекст как команда. Это раздел, где цена неправильного выбора архитектуры измеряется не только деньгами, но и утечками.
44 · Классическая автоматизация: конечный автомат, workflow-движки (BPMN/DAG/RPA), управляющий цикл plan→act→check (OODA); агент = тот же цикл, но шаги генерирует LLM недетерминированно¶
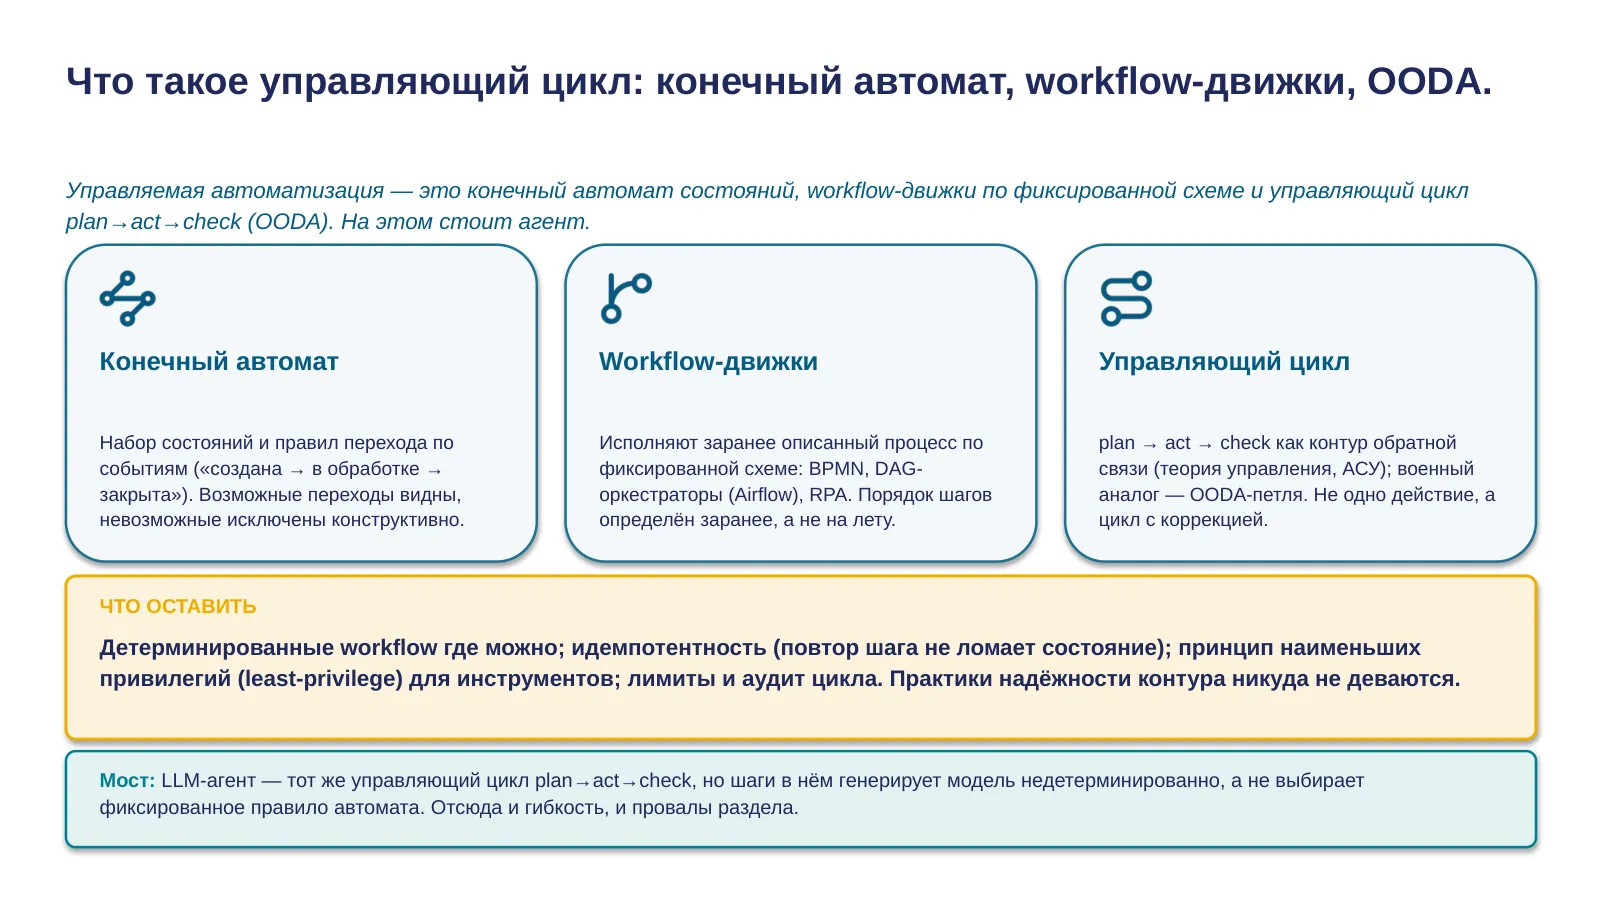
Слово «агент» звучит как изобретение эпохи больших моделей, но управляемая автоматизация процессов — зрелая инженерная дисциплина с многолетней историей, и без неё нельзя честно оценить, что LLM-агент добавляет, а что ломает. Восстановим базу с нуля. Простейшая классическая модель управляемого поведения — конечный автомат: система описывается конечным набором состояний и правилами перехода между ними по событиям. Заявка создана, в обработке, одобрена или отклонена, закрыта — это конечный автомат; в каждом состоянии разрешён строго определённый набор переходов. Поведение полностью предсказуемо и проверяемо: невозможные переходы исключены конструктивно, а не надеждой.
Когда процесс сложнее одного автомата, классическая инженерия применяет workflow-движки, оркестраторы, — системы, исполняющие заранее описанный многошаговый процесс по фиксированной схеме. Назовём конкретно: BPMN — стандарт графического описания процесса, исполняемого движком; Airflow-подобные оркестраторы исполняют процесс как направленный ациклический граф задач; RPA автоматизирует рутину поверх существующих интерфейсов по жёсткому сценарию. Всё это объединяет одно: последовательность шагов определена заранее, а не решается на лету. Такой пайплайн детерминирован, аудируем и повторяем.
Третья классическая идея, и именно она ведёт к циклу агента, — управляющий цикл plan→act→check как контур обратной связи. Это прямое наследие теории управления и робототехники: система измеряет состояние среды, вычисляет воздействие, применяет его, снова измеряет и корректирует. Военно-инженерный аналог — OODA-петля. Суть одна: не одно действие, а цикл спланируй — сделай — проверь — скорректируй.
LLM-агент — это тот же управляющий цикл, но шаги в нём генерирует модель недетерминированно, а не выбирает фиксированное правило автомата. Отсюда видна и мощь, и хрупкость: детерминированный контур всегда делает предсказуемый шаг, а модель способна придумать шаг, которого в схеме не было. Классические же практики надёжности — детерминизм где можно, идемпотентность, лимиты, аудит, наименьшие привилегии — никуда не деваются.
45 · Модель становится компонентом системы: structured output / function calling / prompt caching + MCP¶
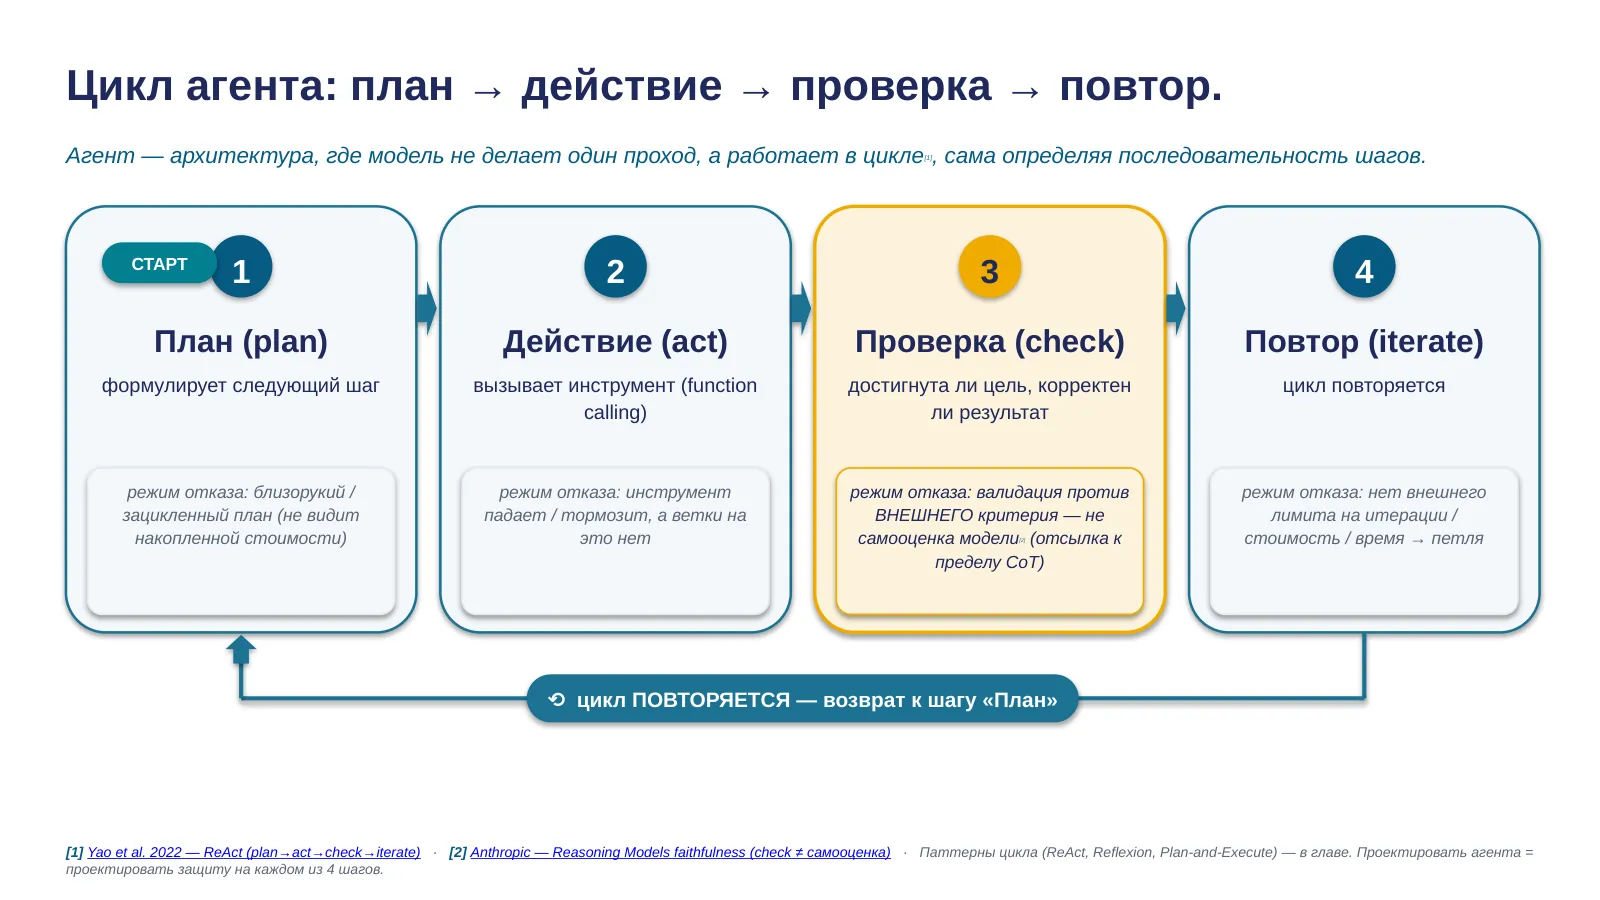
В Лекции 2 модель была собеседником в окне чата. Здесь она становится вызываемым компонентом системы, и это ключевой сдвиг для всего раздела агентов. Механику API-слоя — структурированный вывод, вызов инструментов, кэш промптов — мы уже разбирали в Лекции 2, повторять её не нужно. Здесь важна одна специфичная для этой лекции точка: модель сама решает, что нужен инструмент, и формулирует вызов, а исполняет его ваш код, не модель. Модель не выходит наружу сама — она возвращает намерение, система выполняет действие и возвращает результат обратно в контекст. Именно отсюда вырастает цикл агента, который разберём на следующем слайде: модель работает в петле «рассуждение, вызов инструмента, чтение результата».
Остаётся вопрос, как инструмент к модели подключается. До конца 2024 года каждая интеграция решала это по-своему. MCP, Model Context Protocol, — открытый стандарт единого способа подключать инструменты к модели; метафора — «USB-C для инструментов». Суть в арифметике: при N моделях и M инструментах наивно нужно N умножить на M интеграций, а MCP сводит это к N плюс M. Инструмент описал один раз как MCP-сервер — и его видят все модели-клиенты; подключение стало операцией на минуты[1]. Но здесь критический поворот: стандартизация подключения не означает безопасность подключаемого и даже усугубляет проблему доверия. Каждый MCP-сервер — это чужой код в вашем окружении и канал, через который в контекст попадает недоверенный текст, то есть носитель инъекции в промпт. «Подключить за минуту» и «доверять подключённому» — разные вопросы; MCP решил первый и сделал второй острее. Удобство подключения — не аргумент за подключение.
Источники: [1] Yao et al. 2022 — ReAct (plan→act→check→iterate) · [2] Anthropic — Reasoning Models faithfulness (check ≠ самооценка)
46 · Экономика: агент ×N токенов vs chat, мульти-агент ещё ×15; кэш из ориентира → необходимость¶
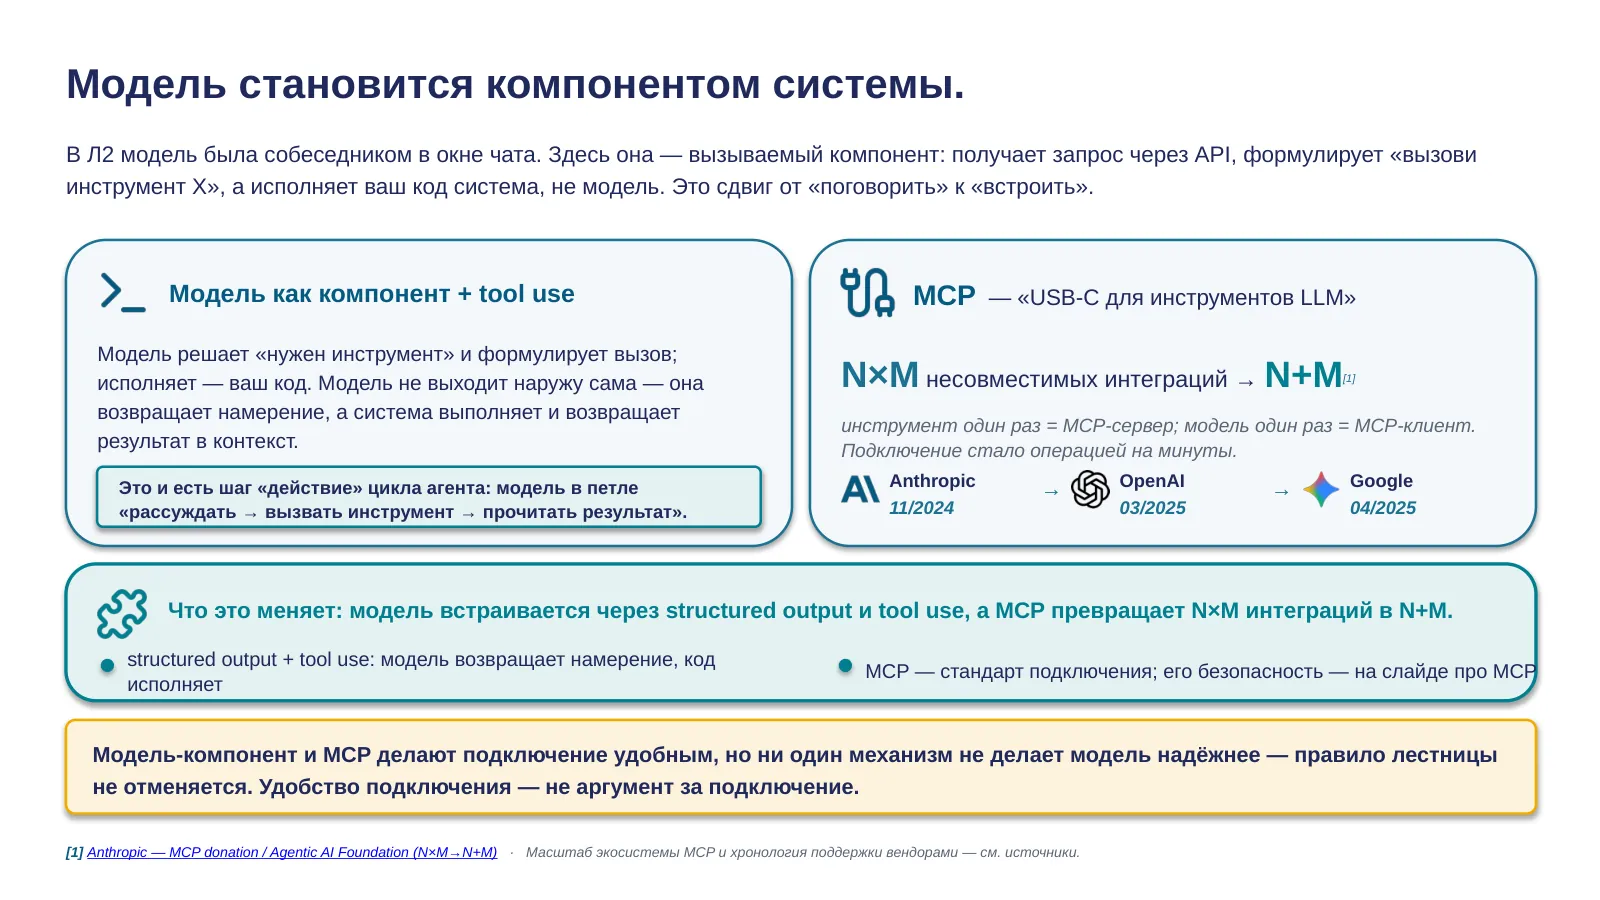
Стоимость в архитектурной лестнице растёт не так, как интуитивно ожидает инженер, и это различие стоит денег. Начнём с базы: один chat-turn стоит порядка единиц-десятков центов. Естественная интуиция — «агент это чат плюс немного накладных расходов». Она ложна. Переход к агенту — не надбавка, а кратный скачок: агентная задача сжигает порядка 50 раз больше токенов, чем один chat-turn. Причина механическая: контекст накапливает выводы инструментов на каждом шаге цикла, и модель заново рассуждает на каждом шаге. Мульти-агентная оркестрация — ещё порядка 15 раз сверх одиночного агента. База обеих цифр — относительно одного обычного обращения к модели в чате. И вот ключевое, что превращает это из «дороже» в «может разорить»: множители перемножаются, а не складываются. Каждая ступень вверх по лестнице умножает бюджет, а не добавляет к нему.
Отсюда — почему невидимые токены рассуждения делают счёт коварным. Стоимость сессии агента примерно равна сумме скрытых токенов рассуждения и вывода инструментов, умноженной на число шагов цикла. Reasoning-токены не видны в ответе, но их оплачивают, и без их учёта бюджет агента ошибается в разы. Именно здесь prompt caching — переиспользование уже вычисленного состояния для неизменного префикса вместо пересчёта на каждый запрос — меняет статус с опции на необходимость. Разберём на числах. Если у агента есть переиспользуемый префикс на 50 000 токенов — системная инструкция плюс описания инструментов плюс документы, — то без кэша он платит за эти 50 тысяч токенов заново на каждом из десятков обращений к модели за сессию. С кэшем — полную цену один раз, а дальше чтение из кэша обходится примерно в десятую часть обычной input-цены. Для агентного цикла с частыми обращениями к тому же префиксу это срезает input-стоимость на нагрузке порядка 30–50% без потери качества. Кэш не убирает множитель — он убирает ненужный повторный пересчёт неизменной «шапки».
Из этого — прямое проектное правило. Первое: держите префикс стабильным; если системная инструкция или список инструментов меняются от запроса к запросу, кэш не срабатывает, и многошаговый агент оплачивает длинную «шапку» каждый раз. Второе, важнее: экономику считают до решения подняться на ступень, а не после счёта за API. «Агент дороже» — это множительное правило, и мульти-агент умножает снова. Прежде чем добавить ступень, спроси: оправдывает ли ценность задачи этот множитель — и не закроется ли она workflow дешевле.
Источники: [1] Anthropic — MCP donation / Agentic AI Foundation (N×M→N+M)
47 · MCP N×M→N+M; ~11% каталога реально запускаемо; удобство подключения ≠ безопасность¶
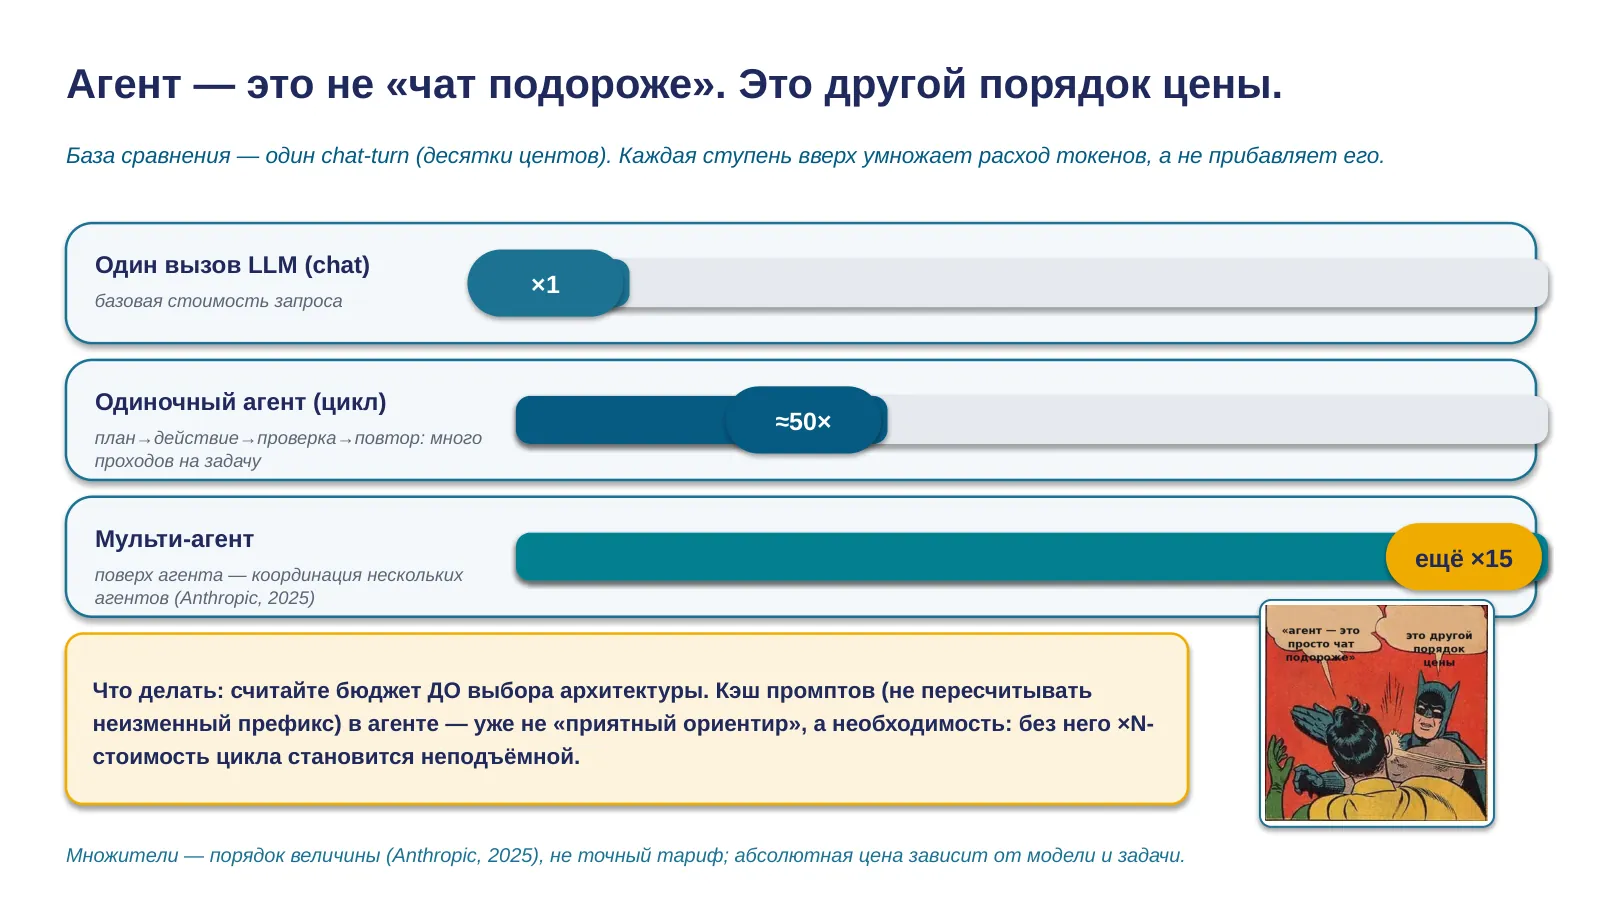
Разведём два вопроса, которые легко слить. Function calling решает, как модель формулирует вызов инструмента. MCP решает другой вопрос — как инструмент к модели физически подключается. До конца 2024 года каждый вендор и каждая интеграция решали это по-своему, и это давало комбинаторный взрыв несовместимых интеграций. MCP — Model Context Protocol — открытый стандарт единого способа подключать инструменты к LLM-приложениям. Арифметика проста: при N моделях и M инструментах прямые интеграции дают N×M пар; MCP сводит это к N+M, потому что каждый инструмент один раз становится сервером, каждая модель — клиентом. Прижившаяся метафора — «USB-C для инструментов LLM»: один разъём вместо набора несовместимых. Anthropic открыла протокол в ноябре 2024, OpenAI приняла в марте 2025, Google — в апреле 2025; это де-факто отраслевой стандарт, и подключение инструмента из «проекта на неделю» превратилось в «операцию на минуты».
Но масштаб экосистемы надо читать критически, потому что «сырой» размер каталога вводит в заблуждение. Официальный реестр на середину 2026 содержит порядка 9 400–9 700 серверов, сторонние каталоги считают десятки тысяч. Три знаменателя снимают эйфорию. Первый: обновлённый скан всех примерно 10 700 серверов показал, что около 25% непригодны — и авторы называют это полом, а не потолком, потому что часть за auth-стеной вообще не удалось протестировать. Второй: «запускается» не равно «решает задачу» — на бенчмарке MCP-Universe с реальными серверами лучшая модель дала 43,7% успешных задач, то есть проваливает больше половины. Третий: безопасность не проверена вовсе.
И вот критический инженерный поворот, который легко пропустить за удобством: стандартизация подключения не означает безопасность подключаемого — более того, усугубляет проблему доверия. Ровно та лёгкость, с которой MCP подключает инструмент, означает, что каждый подключённый инструмент — это код, запускаемый в вашем окружении, и описание, которое попадает в контекст модели и может быть носителем инъекции. Масштаб измерим: за одно 60-дневное окно в начале 2026 против MCP-серверов зарегистрировано 30+ CVE, около 43% из них — паттерны command injection; независимые сканы находили path traversal у 82% из 2 614 проверенных реализаций. База: это доли просканированных серверов, но выборки в тысячи делают картину репрезентативной. «Подключить за минуту» и «доверять подключённому» — два разных вопроса; MCP решил первый и сделал второй острее. Зафиксируем принцип: удобство подключения — не аргумент за подключение; аргумент — требование задачи и приемлемость новой границы доверия. Полный разбор атак MCP — в разделе про безопасность агента.
48 · Агент = цикл plan → act → check → iterate; каждый шаг — место отказа; check не должен быть самооценкой¶
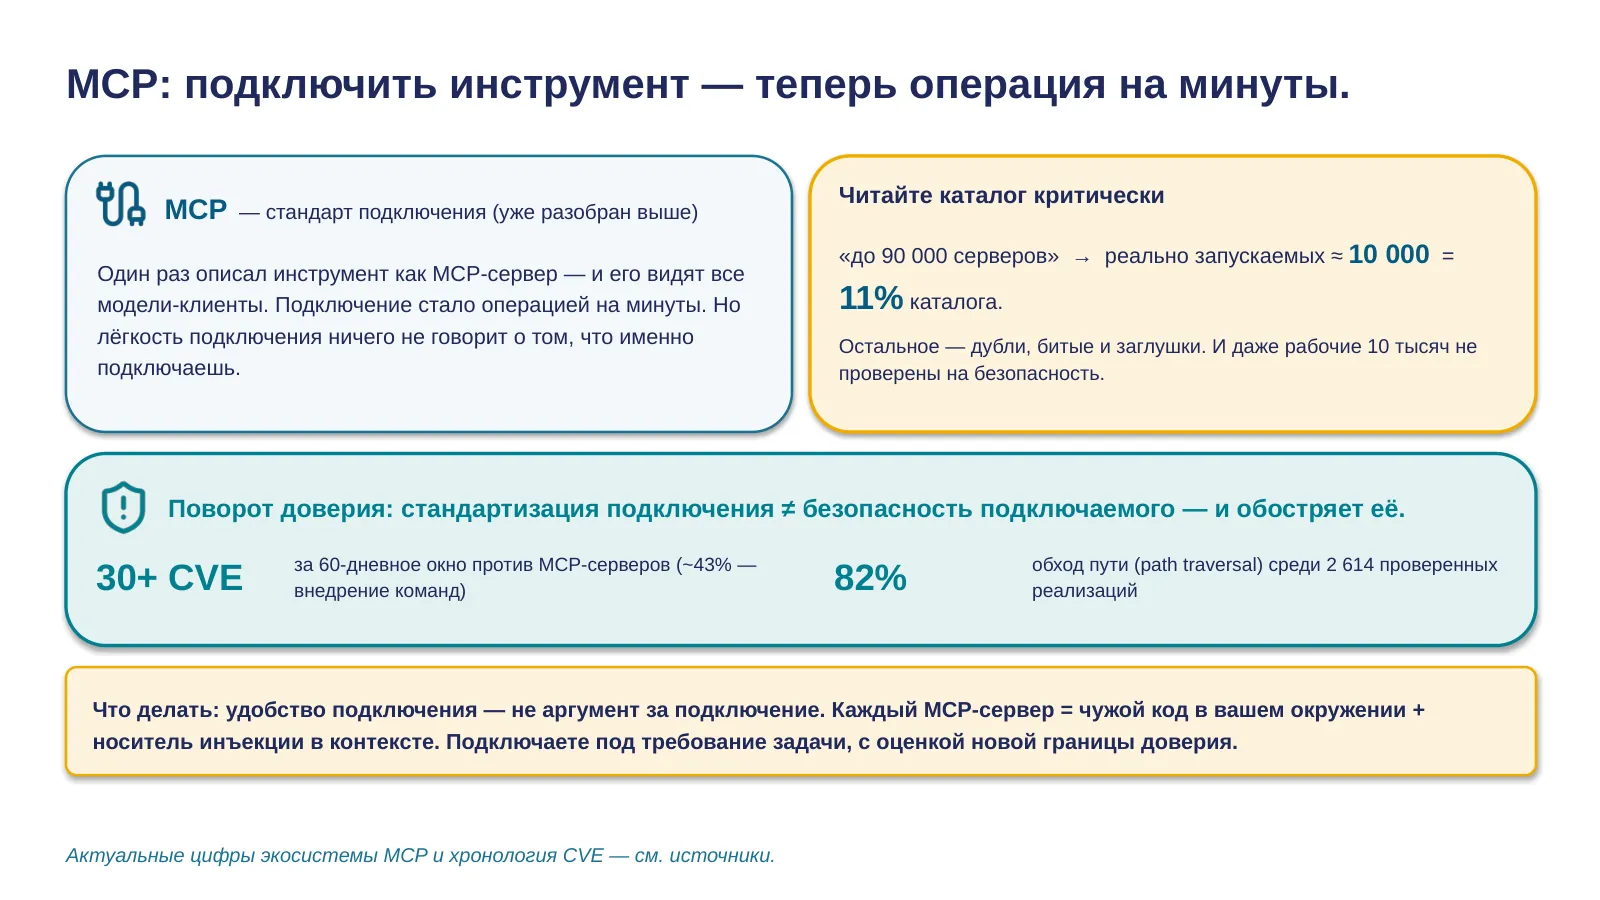
Теперь есть всё для следующей ступени. Один вызов умеет рассуждать; RAG достаёт знание; function calling дотягивается до внешних систем; MCP стандартизует подключение. Агент — архитектура, в которой модель не делает один проход, а работает в цикле[1]: планирует шаг, действует — вызывает инструмент, наблюдает результат, проверяет, достигнута ли цель, и итерирует, сама динамически определяя последовательность. Каноническая формулировка — планируй, действуй, проверяй, повторяй; это паттерн ReAct, чередование рассуждения и действий, а Reflexion добавляет явную самооценку после неудачи. Это «другой AI» по сравнению с одним вызовом: там модель отвечала один раз, здесь — управляет процессом из многих шагов.
Разберём цикл по шагам, потому что каждый шаг — место конкретного режима отказа. Plan: модель формулирует шаг исходя из цели и истории; режим отказа — близорукий или зацикленный план, модель не видит накопленную стоимость и время. Act: вызывается инструмент; режим отказа — инструмент падает или возвращает ошибку, и если плана на это нет, начинается петля. Check: оценивается результат; режим отказа — проверки нет или она сводится к самооценке модели. Iterate: цикл повторяется; режим отказа — нет внешнего лимита на итерации, стоимость или время. «Агент» — не одна абстракция, а четыре шага, каждый со своим способом сломаться; проектировать агента значит проектировать защиту на каждом из четырёх.
Подчеркну элемент, несущий основную сквозную нагрузку курса, — шаг check[2]. И здесь возвращается урок про верность рассуждения ребром: проверка не должна быть «модель сама себя спросила и сама себе ответила, что всё хорошо». Самооценка подвержена той же unfaithfulness, что мы видели на слайде про предел chain-of-thought — это иллюзия контроля: объяснение «я проверил» порождается тем же сэмплингом, что и сам ответ. Надёжная проверка — валидация против внешнего критерия: схема, тест, проверка инвариантов, сверка с источником истины, а в значимых решениях — человек-валидатор. Без внешнего check цикл агента — петля, которая уверенно идёт не туда. Это прямой мост к провалам агентов.
Источники: [1] Yao et al. 2022 — ReAct (plan→act→check→iterate) — чередование рассуждения и действий; каждый шаг — место отказа. https://arxiv.org/abs/2210.03629 [2] Anthropic — Reasoning Models faithfulness (check ≠ самооценка) — шаг check — валидация против внешнего критерия, не самооценка модели. https://www.anthropic.com/research/reasoning-models-dont-say-think
49 · MCP или прямой API — не альтернативы: MCP — тонкий слой обнаружения/переносимости ПОВЕРХ REST; N×M→N+M окупается только при N,M≥2–3; ~25% реестра непригодны, 43,7% лучший MCP-Universe¶
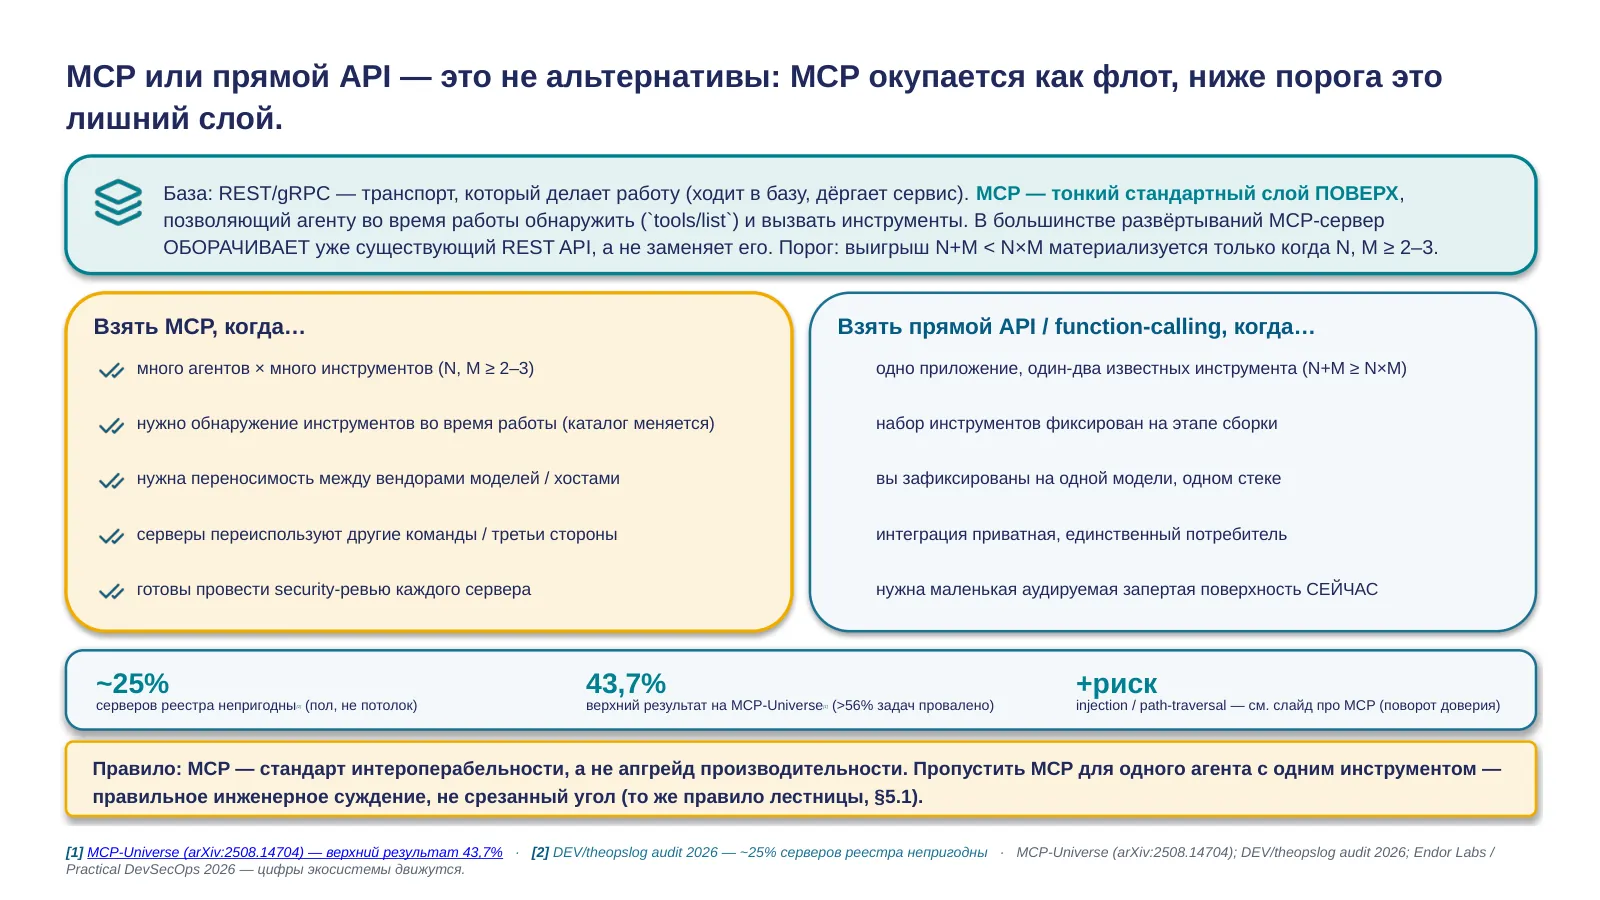
Введя и function calling, и MCP, честно поставим вопрос, который у инженера возникает сразу: мне вообще нужен MCP, или проще напрямую дёрнуть API? Начнём с базы, потому что тут ходит распространённое заблуждение «MCP — это замена REST». Это неверно. REST и gRPC — транспортный слой, который реально делает работу: ходит в базу, дёргает сервис. MCP — тонкий стандартный слой поверх, который позволяет агенту во время работы обнаружить доступные инструменты через запрос tools/list и вызвать их. В подавляющем большинстве реальных развёртываний MCP-сервер оборачивает уже существующий REST API, а не заменяет его. Поэтому вопрос не «MCP или API» — это не альтернативы на одном уровне, — а «нужен ли мне слой обнаружения и переносимости поверх API, или достаточно жёстко прописанного вызова функции».
Несущий аргумент за MCP — арифметика интеграций. До MCP, чтобы связать N приложений с M инструментами, в худшем случае нужно N умножить на M отдельных интеграций. MCP делает так, что каждая сторона реализует протокол один раз: приложение становится клиентом, инструмент — сервером, и всего нужно N плюс M реализаций. Но отсюда виден и порог: выигрыш материализуется, только когда и N, и M не меньше двух-трёх. Для одного приложения и одного-двух известных инструментов N умножить на M равно двум, а N плюс M равно трём — то есть прямой function-call проще. Ниже порога MCP — это чистый overhead. Что ещё даёт слой MCP: динамическое обнаружение, когда каталог часто меняется; stateful-сессии; переносимость между вендорами моделей.
Обратная сторона — цена слоя, и она не нулевая, поэтому решение по таблице. Обновлённый скан всех примерно 10 700 серверов реестра показал, что примерно четверть серверов реестра[2] непригодны, и авторы прямо называют это полом, а не потолком: часть за auth-стеной вообще не удалось протестировать. Даже среди работающих реальная успешность низкая: на бенчмарке MCP-Universe верхняя протестированная модель дала сорок три и семь[1] десятых процента успешных задач — то есть даже верхний результат проваливает больше половины реальных MCP-задач. И безопасность не проверена: конкретные цифры аудитов (внедрение команд, обход путей) мы разбирали на слайде про MCP и поворот доверия — здесь достаточно держать в голове, что это отдельная граница доверия, а не решённый вопрос.
Правило одной строкой: MCP — стандарт интероперабельности, а не апгрейд производительности. Он окупается как флот и экосистема — много агентов, много инструментов, переиспользование, смена вендоров. Для одного агента с одним инструментом простой function-call проще, быстрее и безопаснее — и пропустить MCP здесь это правильное инженерное суждение, а не срезанный угол. Это ровно правило лестницы, приложенное к слою подключения.
Источники: [1] MCP-Universe (arXiv:2508.14704) — верхний результат 43,7% · [2] DEV/theopslog audit 2026 — ~25% серверов реестра непригодны
50 · Workflow — не примитив: пять паттернов вокруг предсказуемого (prompt chaining / routing / parallelization / orchestrator-workers / evaluator-optimizer)¶
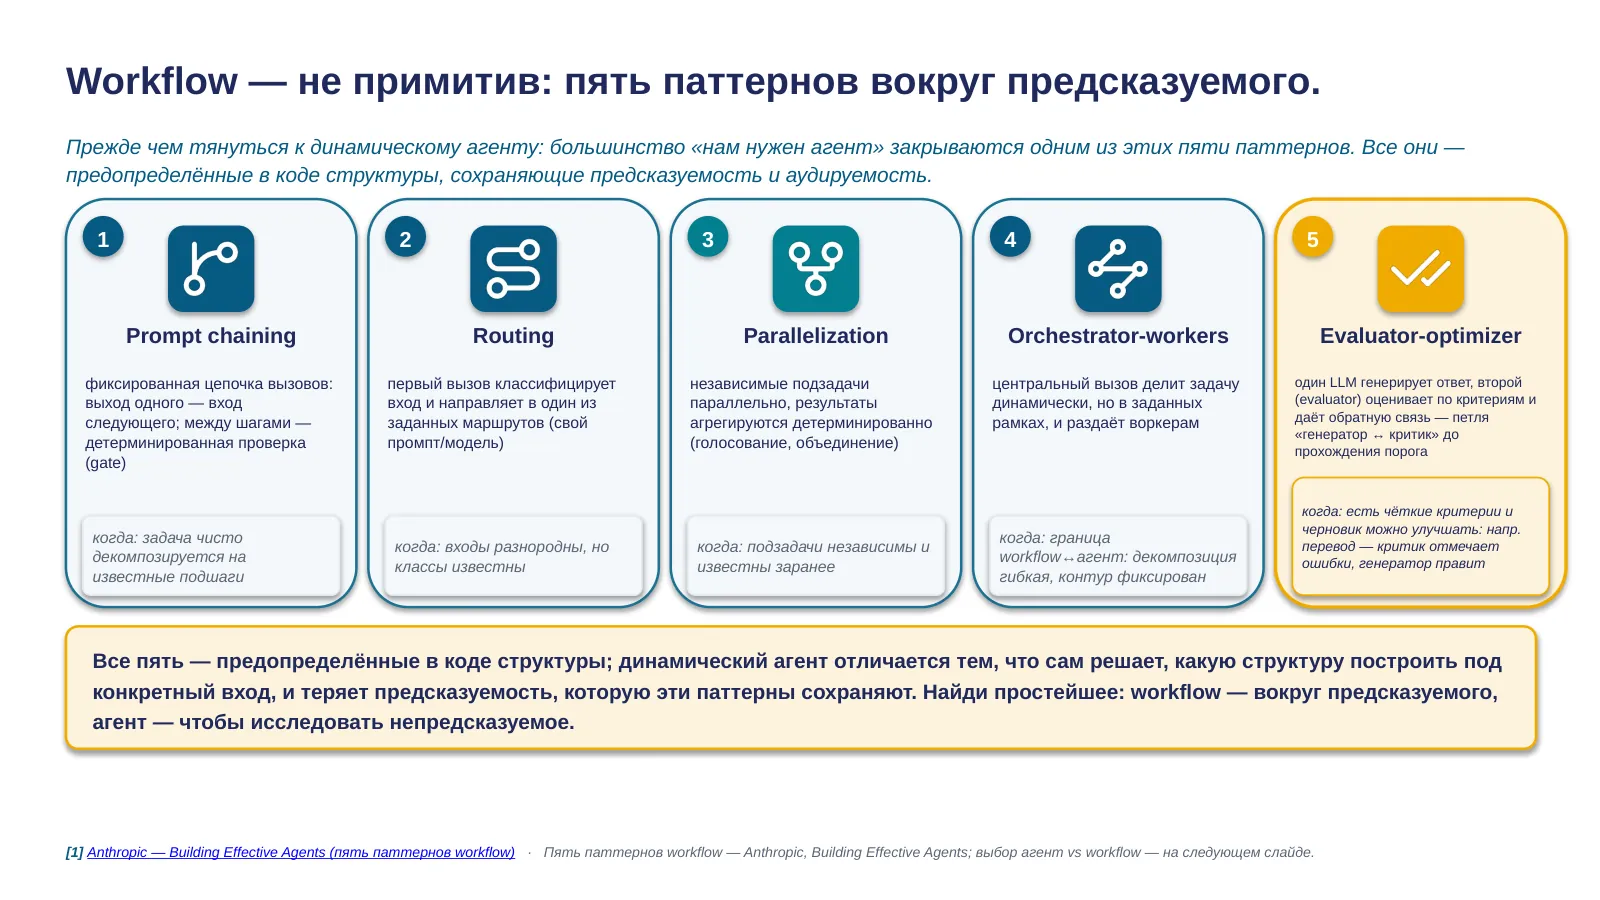
Прежде чем тянуться к динамическому агенту, полезно знать, что workflow — не примитив. Anthropic в «Building Effective Agents» показывает, что у него есть развитая палитра паттернов, и все они дают структуру вокруг предсказуемого, не уходя в динамический агент. Разберём пять.
Prompt chaining — задача разбита на фиксированную последовательность вызовов, выход одного становится входом следующего, а между шагами можно вставить детерминированную проверку-gate и остановиться, если она не прошла. Применять, когда задача чисто декомпозируется на известные подшаги; пример — «сначала составь план текста, потом по плану напиши разделы». Routing — первый вызов классифицирует вход и направляет его в один из заранее заданных маршрутов, каждый со своим промптом или моделью; применять, когда входы разнородны, но классы известны; пример — обращения в поддержку раскидать на «возврат средств», «технический вопрос», «жалоба», каждое своим сценарием. Parallelization — независимые подзадачи выполняются параллельно, а результаты агрегируются детерминированно, голосованием или объединением; применять, когда подзадачи независимы и известны заранее; пример — прогнать один текст через три проверки (факты, стиль, безопасность) одновременно и собрать вердикты. Orchestrator-workers — центральный вызов делит задачу на подзадачи динамически, но в заданных рамках, и раздаёт их воркерам; это уже граница между workflow и агентом: декомпозиция гибкая, но контур фиксирован; пример — по сложному запросу оркестратор сам решает, на сколько под-поисков его разбить, но каждый под-поиск идёт стандартным путём.
Пятый паттерн — evaluator-optimizer — стоит объяснить с нуля, потому что термин ничего не говорит без расшифровки. Идея простая: работают два вызова модели в петле. Первый, генератор, выдаёт ответ. Второй, evaluator, то есть критик, проверяет этот ответ по заранее заданным критериям и возвращает конкретную обратную связь — что не так и что улучшить. Генератор с учётом замечаний переписывает ответ, критик снова проверяет — и так по кругу, пока результат не пройдёт порог качества. Это петля «генератор ↔ критик». Наглядный пример — черновой перевод: генератор переводит абзац, критик отмечает неточности и корявые формулировки, генератор правит их, критик проверяет ещё раз — цикл повторяется, пока перевод не станет чистым. Применять этот паттерн стоит, когда критерии качества можно внятно сформулировать, а черновик реально дорабатывать пошагово; по сути это встроенная проверка между шагами и прямой инструмент против накопления ошибок.
Итог: все пять — предопределённые в коде структуры[1]. Динамический агент отличается тем, что сам решает, какую структуру построить под конкретный вход, и потому теряет предсказуемость, которую эти паттерны сохраняют. Большинство запросов «нам нужен агент» на практике закрываются одним из этих пяти паттернов — это и есть смысл правила «найди простейшее»: workflow строит структуру вокруг предсказуемого, а агента берут, только чтобы исследовать непредсказуемое. Сам выбор агент против workflow разберём на следующем слайде.
Источники: [1] Anthropic — Building Effective Agents (пять паттернов workflow)
51 · Фреймворк агента — абстракционный налог; берут под требование. LangGraph / CrewAI / AG2 / OpenAI Agents SDK / Claude Agent SDK / smolagents / LlamaIndex / Pydantic AI — и «ни одного: обычный ко件
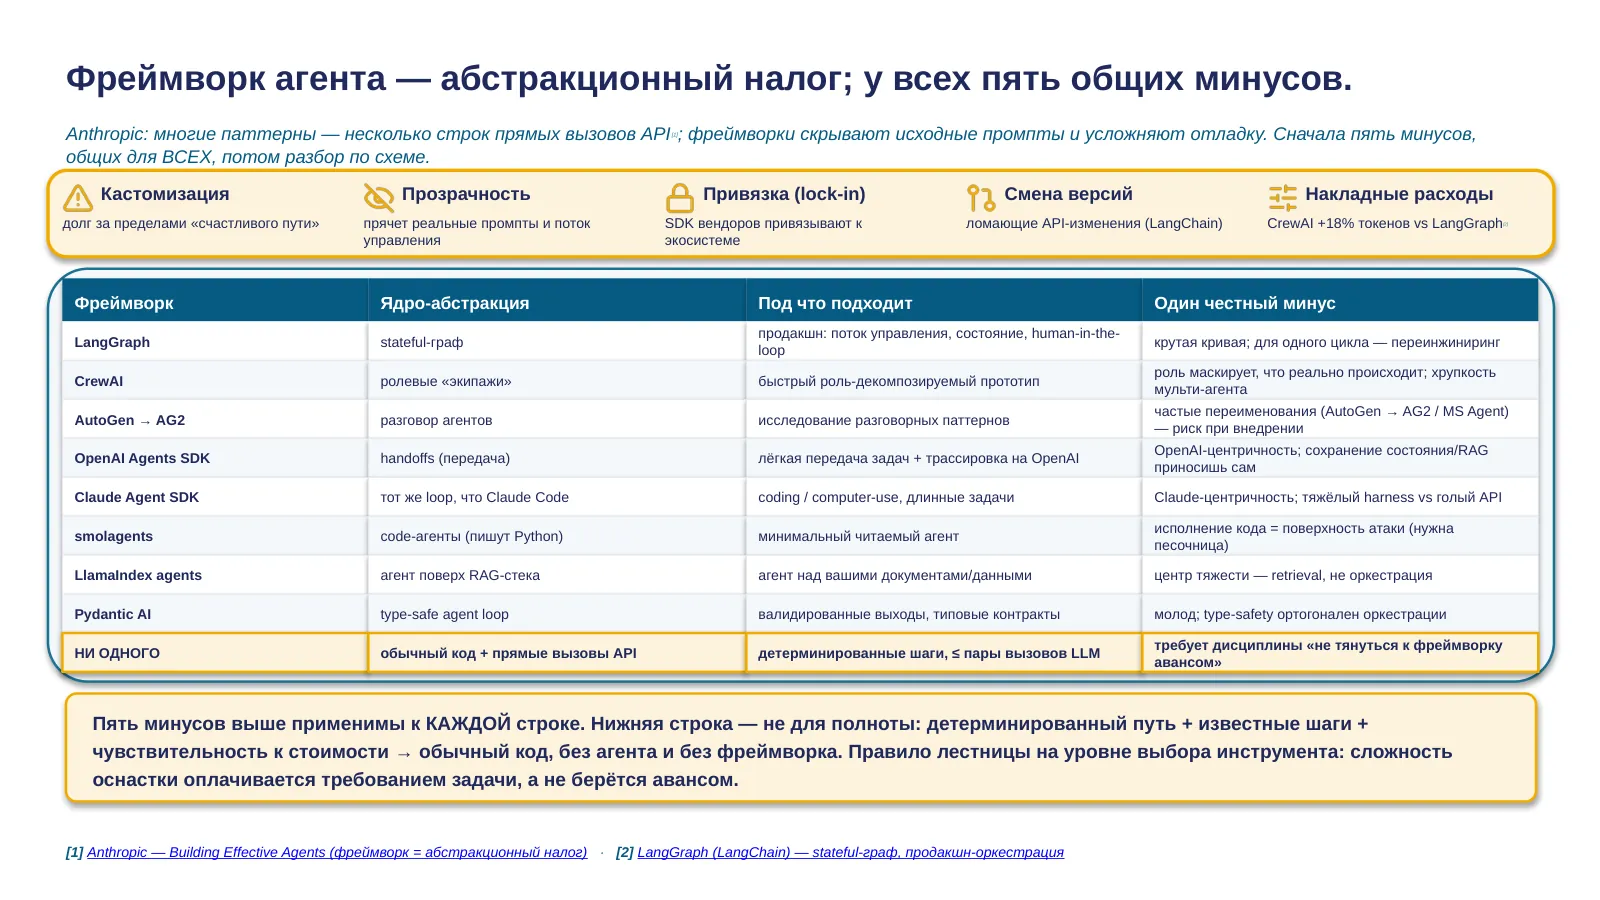
Инженер решил, что агент оправдан, — встаёт вопрос, на чём его строить. Рамочный тезис держит весь слайд: Anthropic в «Building Effective Agents» пишет, что многие паттерны реализуются в несколько строк прямых вызовов API[1], а фреймворки добавляют слои абстракции, которые скрывают исходные промпты и ответы и усложняют отладку. Фреймворк — это абстракционный налог; берут его, только когда он доказанно улучшает исход, а не по умолчанию. Поэтому сначала — пять минусов, общих для всех фреймворков, потому что маркетинг про них молчит, и это и есть judgment-содержание слайда.
Первый — ограничение кастомизации поведения. Высокоабстрактный фреймворк копит технический долг ровно в тот момент, когда вам надо выйти за пределы «счастливого пути»: переопределить встроенный промпт, изменить поток управления. Второй — прозрачность и отлаживаемость: фреймворк прячет реальные промпты и поток управления, и отладка застрявшего агента в пятиагентном пайплайне становится болезненной. Третий — lock-in: SDK провайдеров привязывают к одной модельной экосистеме, переносимость стоит переписывания. Четвёртый — version churn: у экосистемы LangChain было слишком много ломающих API-изменений за её историю, апгрейд ломает работающий код. Пятый — overhead: замер показал, что трёхагентный «экипаж» на CrewAI потратил примерно на 18% больше токенов, чем эквивалентная сборка на LangGraph, — абстракция не бесплатна и в рантайме.
Теперь по устойчивой схеме «ядро-абстракция, под что лучше, один честный минус». LangGraph — это stateful-граф[2], под продакшн с контролем потока и состоянием; минус — крутая кривая, для одного цикла переинжиниринг. CrewAI — ролевые экипажи, под быстрый прототип; минус — роль маскирует, что реально происходит. AutoGen превратился в AG2 и Microsoft Agent Framework — здесь как раз version churn и rename-churn, риск при внедрении. OpenAI Agents SDK — handoffs, но OpenAI-центричность. Claude Agent SDK — тот же loop, что в Claude Code, под coding и computer-use; минус — тяжёлый harness против голого API. smolagents — code-агенты, минус — исполнение кода как поверхность атаки. LlamaIndex — агент поверх RAG-стека. Pydantic AI — type-safe loop. И нижняя строка не для полноты: детерминированный путь плюс известные шаги плюс чувствительность к стоимости — это обычный код, без агента и без фреймворка. Пять минусов выше применимы к каждой строке: сложность оснастки оплачивается требованием задачи, а не берётся авансом.
Источники: [1] Anthropic — Building Effective Agents (фреймворк = абстракционный налог) · [2] LangGraph (LangChain) — stateful-граф, продакшн-оркестрация
52 · Агент — под открытую непредсказуемую задачу; предсказуемая → workflow; мульти-агент только под триггер. p^n: 0,95^10≈60%, 0,95^20≈36%; τ-bench 61%→25% pass@1→pass@8¶
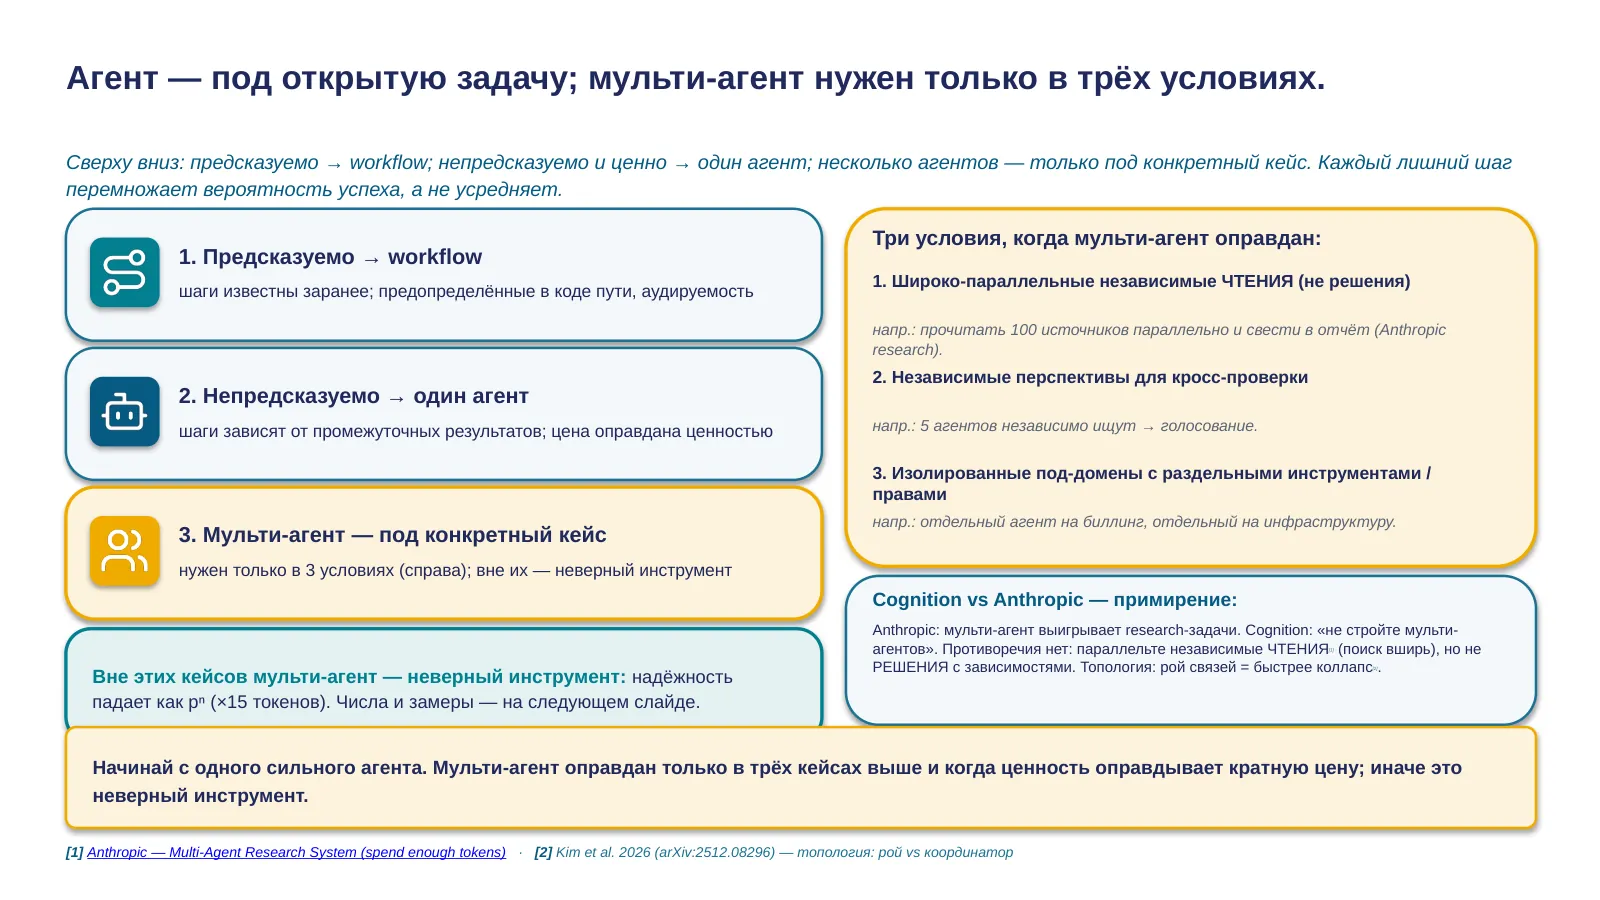
Это слайд-судейство: когда агент, когда workflow, когда несколько агентов. Логика сверху вниз. Если задача предсказуемая — шаги известны заранее, — берите workflow: предопределённые в коде пути, аудируемость. Если непредсказуемая и ценность оправдывает кратную цену — один агент: шаги зависят от промежуточных результатов, тут нужна гибкость цикла. И только под конкретный кейс — несколько агентов. Тут важно не отделываться словом «триггер», а назвать эти кейсы явно, потому что вне их мульти-агент — неверный инструмент.
Условий, когда мульти-агент оправдан, три. Первое — широко-параллельные независимые чтения, а не решения: например, прочитать сотню источников параллельно и свести их в один отчёт — так устроен research-агент Anthropic, где подзадачи-чтения не зависят друг от друга. Второе — независимые перспективы для кросс-проверки: например, пять агентов независимо ищут ответ, а затем результат берут голосованием; расхождение между ними само по себе сигнал. Третье — изолированные под-домены с раздельными инструментами и правами: например, отдельный агент на биллинг и отдельный на инфраструктуру, у каждого свой набор доступов, и смешивать их опасно. Если ваша задача не попадает ни в один из этих трёх кейсов — оставайтесь на одном агенте.
Почему такая осторожность с числом шагов — потому что надёжность падает как p в степени n, а не усредняется. В цепочке из n шагов, где сбой любого портит результат, надёжности перемножаются, а не усредняются. Каждый лишний агент добавляет шаги и связи, а значит роняет общую надёжность. Конкретные числа и живой замер на бенчмарке — на следующем слайде; здесь важен сам принцип: «почти всегда» на каждом шаге перемножается в «довольно часто нет» на выходе всей системы.
Топология тут — не деталь, а решающий фактор. По измерению Kim и соавторов, препринт 2512.08296, децентрализованный «рой» равноправных агентов без единого центра амплифицирует ошибки заметно сильнее, чем один координатор: больше связей между агентами — быстрее коллапс, а конкретные множители мы разберём на следующем слайде. И отдельно надо примирить два тезиса, которые студенты часто слышат как противоречие. Anthropic говорит, что мульти-агент выигрывает research-задачи; Cognition пишет «не стройте мульти-агентов». Противоречия нет: параллелить надо независимые чтения — поиск вширь, где подзадачи не зависят друг от друга, — но не решения с зависимостями, где параллельные субагенты принимают конфликтующие неявные выборы и портят результат. Anthropic формулирует выигрыш дословно: мульти-агент работает главным образом потому, что помогает потратить достаточно токенов на задачу, а не из-за магии координации[1].
Практический вывод: начинайте с одного сильного агента. Мульти-агент покупает качество, сжигая токены, а не координационной магией; кратные оценки цены — на следующем слайде. Если задача не распадается на широко-параллельные независимые чтения и ценность не оправдывает кратную цену, это неверный инструмент.
Источники: [1] Anthropic — Multi-Agent Research System (spend enough tokens) · [2] Kim et al. 2026 (arXiv:2512.08296) — топология: рой vs координатор
53 · Мульти-агент по умолчанию НЕ апгрейд: p^n (95%×10=60%); рой 17,2× vs координатор 4,4׶
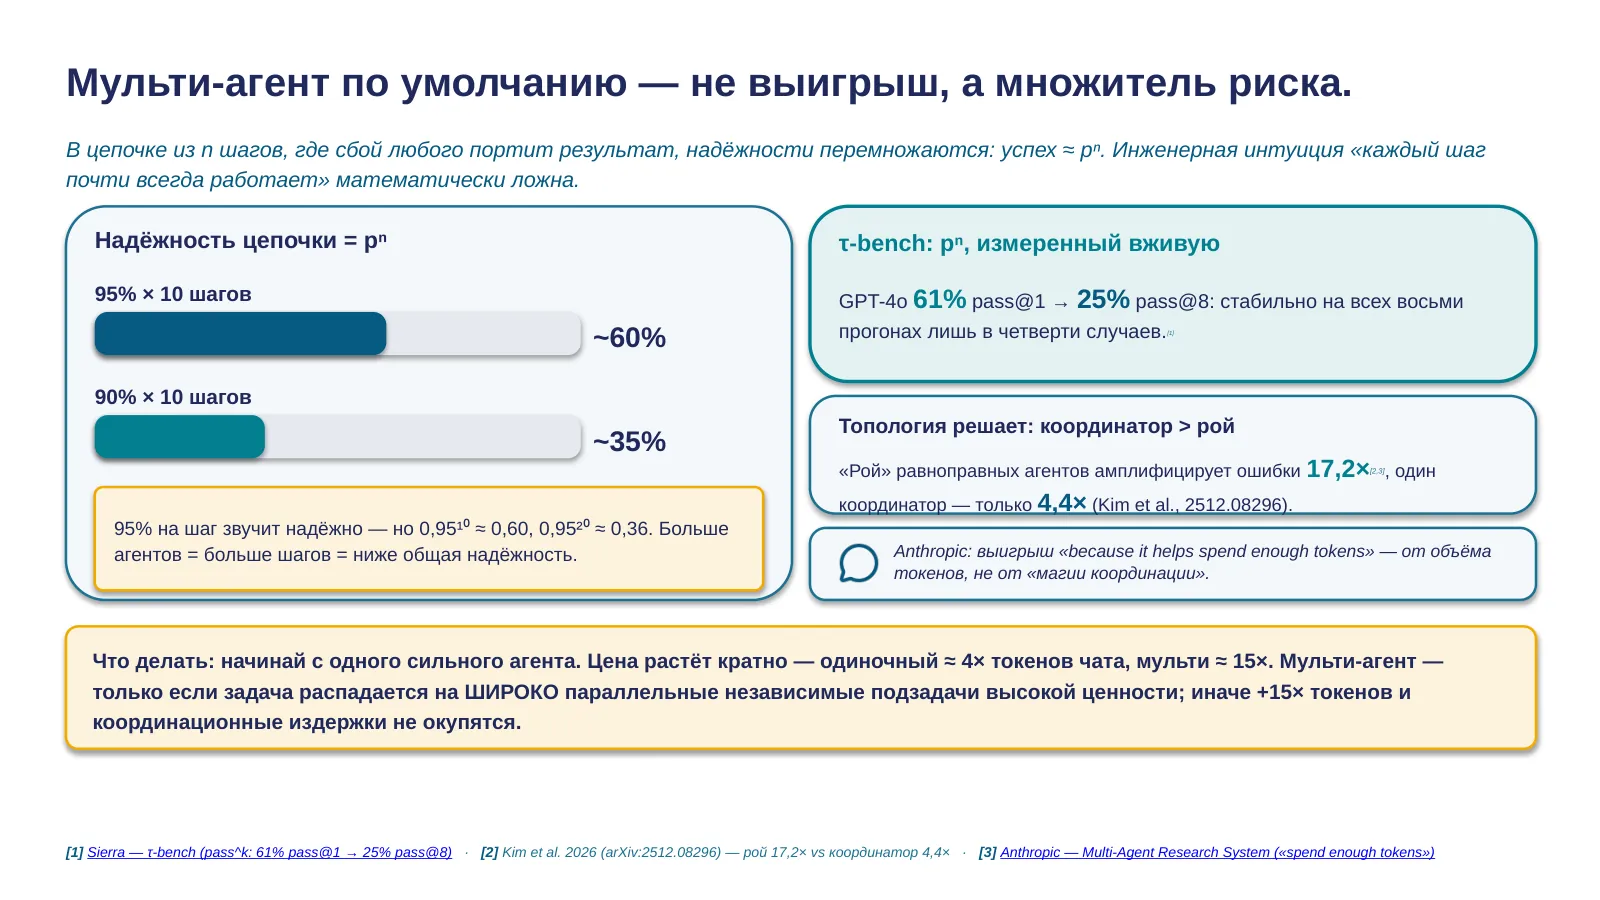
Разберём отдельно, почему мульти-агент по умолчанию не выигрыш, потому что это одна из частых архитектурных ошибок, и у неё есть простая, наглядная математика. В конвейере из n последовательных шагов, где сбой любого шага портит итог, надёжности перемножаются, а не усредняются: общий шанс успеха примерно равен p в степени n. Отсюда контринтуитивные числа: даже при девяноста пяти процентах надёжности на каждый шаг десять шагов подряд дают всего около шестидесяти процентов общей надёжности, а при девяноста процентах на шаг — уже около тридцати пяти. Интуиция инженера «каждый шаг почти всегда работает, значит и вся цепочка почти всегда работает» математически ложна: «почти всегда» на каждом шаге перемножается в «довольно часто нет» на выходе всей системы.
И это не только теория: на бенчмарке τ-bench у GPT-4o шестьдесят один процент pass@1 падает до двадцати пяти процентов pass@8 — то есть агент, справляющийся чаще, чем в половине случаев с одной попытки, справляется стабильно на всех восьми прогонах[1] лишь в четверти случаев. Это и есть p в степени n, измеренный вживую на инструментальном агенте.
Дальше — вопрос топологии, то есть того, как именно организованы несколько агентов между собой. По измерению Kim и соавторов, препринт 2512.08296, при одном и том же числе агентов независимые «рои» равноправных агентов, работающих без единого центра, усиливали ошибки в семнадцать целых две десятых раза, тогда как централизованная оркестрация с одним координатором сдерживала усиление ошибок до четырёх целых четырёх десятых раза[2]. Вывод прямой: оркестрация с одним координатором надёжнее «роя» равноправных агентов, а не наоборот, хотя интуитивно «рой» кажется более гибким и масштабируемым решением.
Здесь стоит процитировать позицию Anthropic дословно, потому что она отрезвляет: мульти-агентные системы работают в основном потому, что помогают потратить достаточно токенов для решения задачи — то есть выигрыш во многом объясняется объёмом вычислений, а не какой-то особой магией координации между агентами[3]. И цена этого объёма кратная: одиночный агент примерно вчетверо дороже обычного чата, мульти-агент — примерно в пятнадцать раз. Практический совет тех же источников — начинать с одного сильного агента: для многих задач хватает одиночных вызовов с хорошим retrieval и примерами, а команды тратили месяцы на сложные мульти-агентные архитектуры и обнаруживали, что более точный промптинг одного агента давал эквивалентный результат дешевле. Отсюда критерий: не стройте мульти-агент, если задача не распадается на широко параллельные, независимые подзадачи высокой ценности — иначе издержки координации и многократный рост стоимости токенов перевесят любую выгоду от параллелизма.
Источники: [1] Sierra — τ-bench (pass^k: 61% pass@1 → 25% pass@8) · [2] Kim et al. 2026 (arXiv:2512.08296) — рой 17,2× vs координатор 4,4× · [3] Anthropic — Multi-Agent Research System («spend enough tokens»)
54 · Каждый слот экипировки агента — компромисс, не апгрейд по умолчанию¶
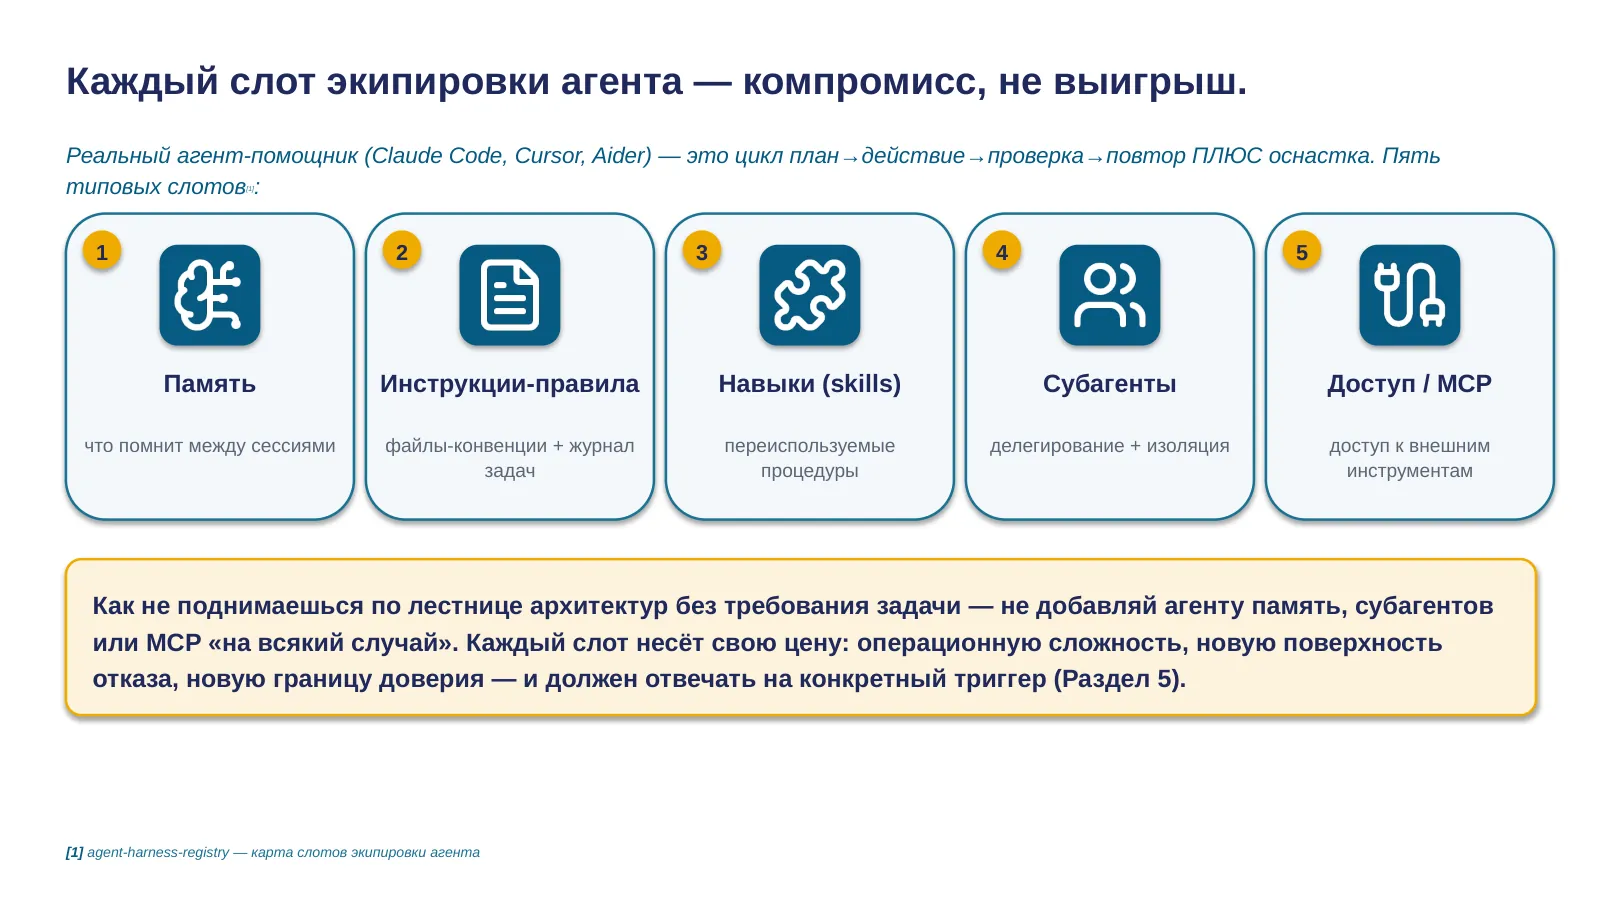
До сих пор мы говорили про агента как про абстрактный цикл: планируй, действуй, проверяй, повторяй. Но реальный агент-помощник, с которым инженер работает каждый день, — это не голый цикл, а цикл плюс оснастка[1]. Набор дополнительных механизмов, которые определяют, что агент помнит, чему следует, какие процедуры умеет переиспользовать, кому может делегировать работу и к каким внешним системам имеет доступ. Дальше в этом разделе мы будем не раз опираться на данные agent-harness-registry — это независимый публичный реестр, который тестирует экипировку агентов (память, skills, subagents, MCP) через live-eval бенчмарки на реальных задачах, а не через вендорские самоотчёты о возможностях. По его данным можно выделить пять типовых слотов этой оснастки. Первый — память: что агент помнит между сессиями. Второй — инструкции-правила: файлы-конвенции проекта и журнал прогресса. Третий — skills, переиспользуемые процедуры под повторяющиеся задачи. Четвёртый — subagents, делегированные под-агенты с собственным контекстным окном. Пятый — доступ к внешним инструментам через MCP.
Прежде чем разбирать каждый слот по отдельности, зафиксируем тезис, который рифмуется с центральным правилом всей лекции и с лестницей архитектурной сложности. Каждый слот экипировки — это компромисс между ценой, сложностью и отказоустойчивостью, а не выигрыш по умолчанию. Ровно как не стоит подниматься по лестнице архитектур без требования задачи, не стоит и добавлять агенту память, subagents или новый доступ на всякий случай: каждый добавленный слот несёт свою цену — операционную сложность, новую поверхность отказа, новую границу доверия — и должен отвечать на конкретный, а не абстрактный триггер. Дальше мы пройдём вдоль этой карты слот за слотом и на каждом проверим этот тезис.
Источники: [1] agent-harness-registry — карта слотов экипировки агента
55 · «Агент, который помнит» — не всегда лучше: Letta Tier D и даже 17%-й хвост у лучшей системы¶
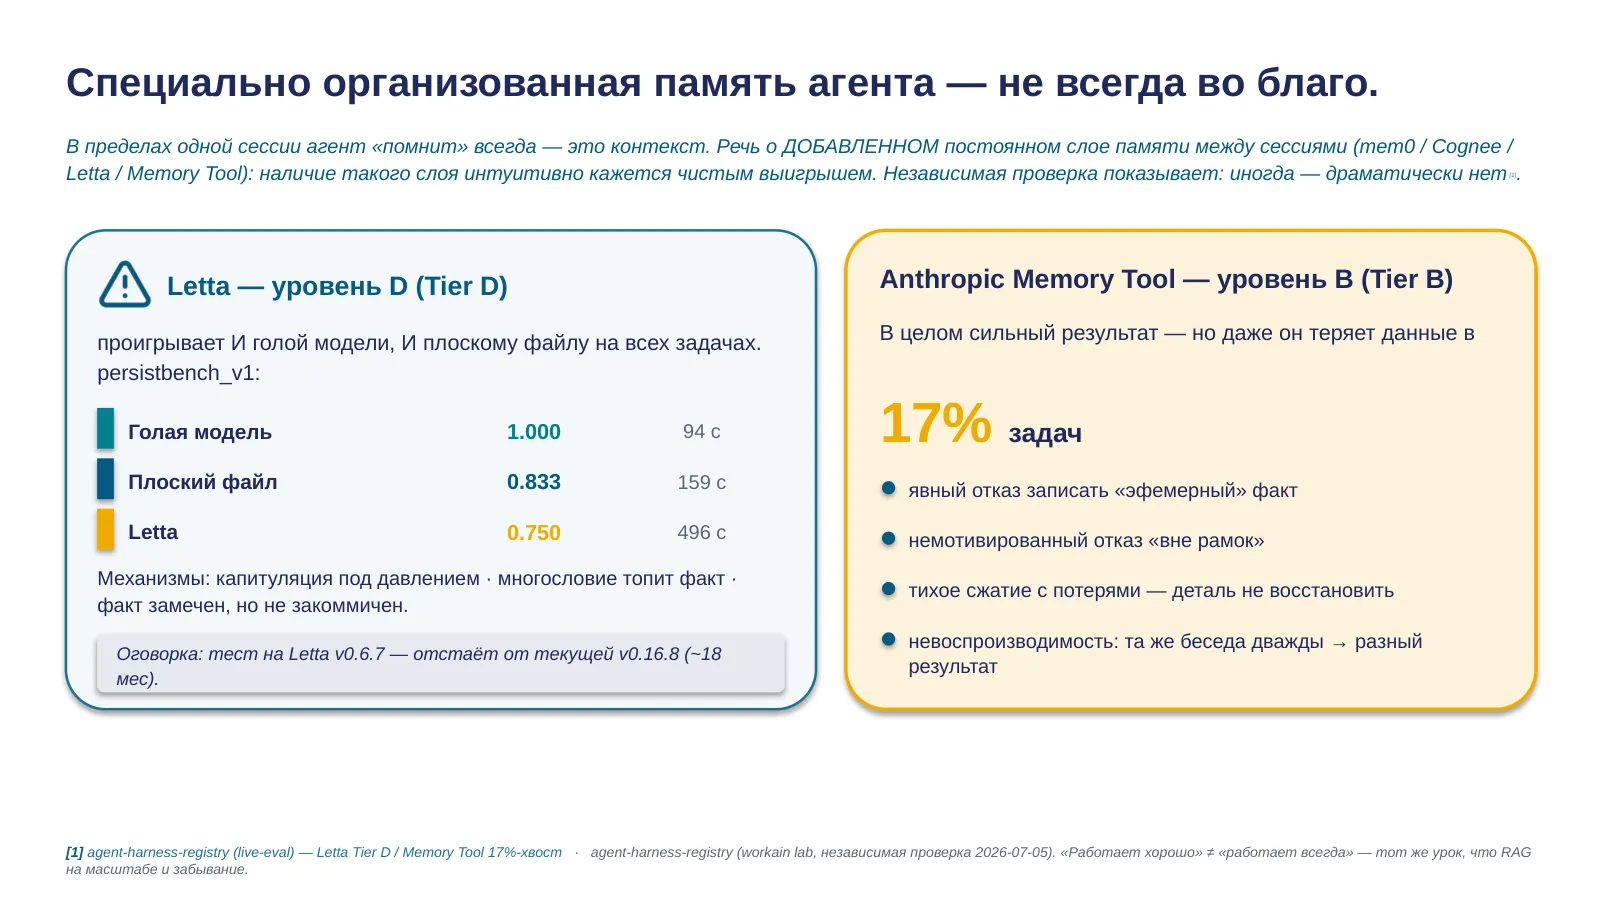
Сразу оговорим область разговора, чтобы не было путаницы. В пределах одной сессии агент помнит всегда — это его контекст, обычное свойство диалога, и о нём речи нет. Мы говорим о специально организованной памяти: добавленном постоянном слое, который сохраняет факты между сессиями, — это отдельные системы вроде mem0, Cognee, Letta или Memory Tool. Наличие такого слоя интуитивно кажется чистым выигрышем — агент, который помнит между сессиями, должен быть полезнее агента, начинающего каждый раз с нуля. Данные agent-harness-registry, независимого реестра[1], тестирующего системы на реальных задачах, показывают, что это не всегда так, а иногда драматически не так. На слайде системы помечены буквой Tier — это рейтинговая категория реестра от A (верхние результаты) до D (нижние) по сумме бенчмарков live-eval; чем ближе к A, тем стабильнее система показывала себя на полном наборе тестов. Первый кейс — система Letta, Tier D. По данным реестра она проигрывает и голой модели без всякой памяти, и тривиальному плоскому файлу на всех полностью протестированных бенчмарках: на persistbench голая модель дала 1.000, плоский файл 0.833, а Letta лишь 0.750, при этом на порядок медленнее. Выявлены три механизма провала: капитуляция под давлением, когда при повторном вопросе система меняет уже данный верный ответ на неуверенный; многословие, когда длинный приукрашенный ответ прячет короткий правильный факт; и факт, замеченный, но не закоммиченный в память. Оговорка по свежести обязательна: тестировалась версия примерно восемнадцатимесячной давности из-за ограничения установщика, а не из-за срезания угла, поэтому это оценка конкретной устаревшей версии.
Второй кейс важнее, потому что это серьёзно протестированная система. Anthropic Memory Tool в целом сильна, но и у неё в четырёх задачах из двадцати четырёх, то есть в 17 процентах, зафиксирована потеря информации: явный отказ записать факт, сочтённый эфемерным; отказ как «вне рамок»; и тихая суммаризация, когда конкретные факты незаметно поглощаются общими категориями. Тревожная деталь — невоспроизводимость: одна и та же беседа, поданная дважды, дала разное поведение. Это не баг, а задокументированный дизайн: модель просят применять суждение, что достойно записи, и это суждение производит реальные, иногда противоречивые провалы. Вывод один: даже за надёжную систему памяти стоит измеримый хвост потерь. «Работает хорошо» и «работает всегда» — разные утверждения, и это тот же урок, что RAG-провал на масштабе и катастрофическое забывание.
Источники: [1] agent-harness-registry (live-eval) — Letta Tier D / Memory Tool 17%-хвост
56 · Skills, subagents, доступ — и граница доверия: инъекция × широкие права = катастрофа¶
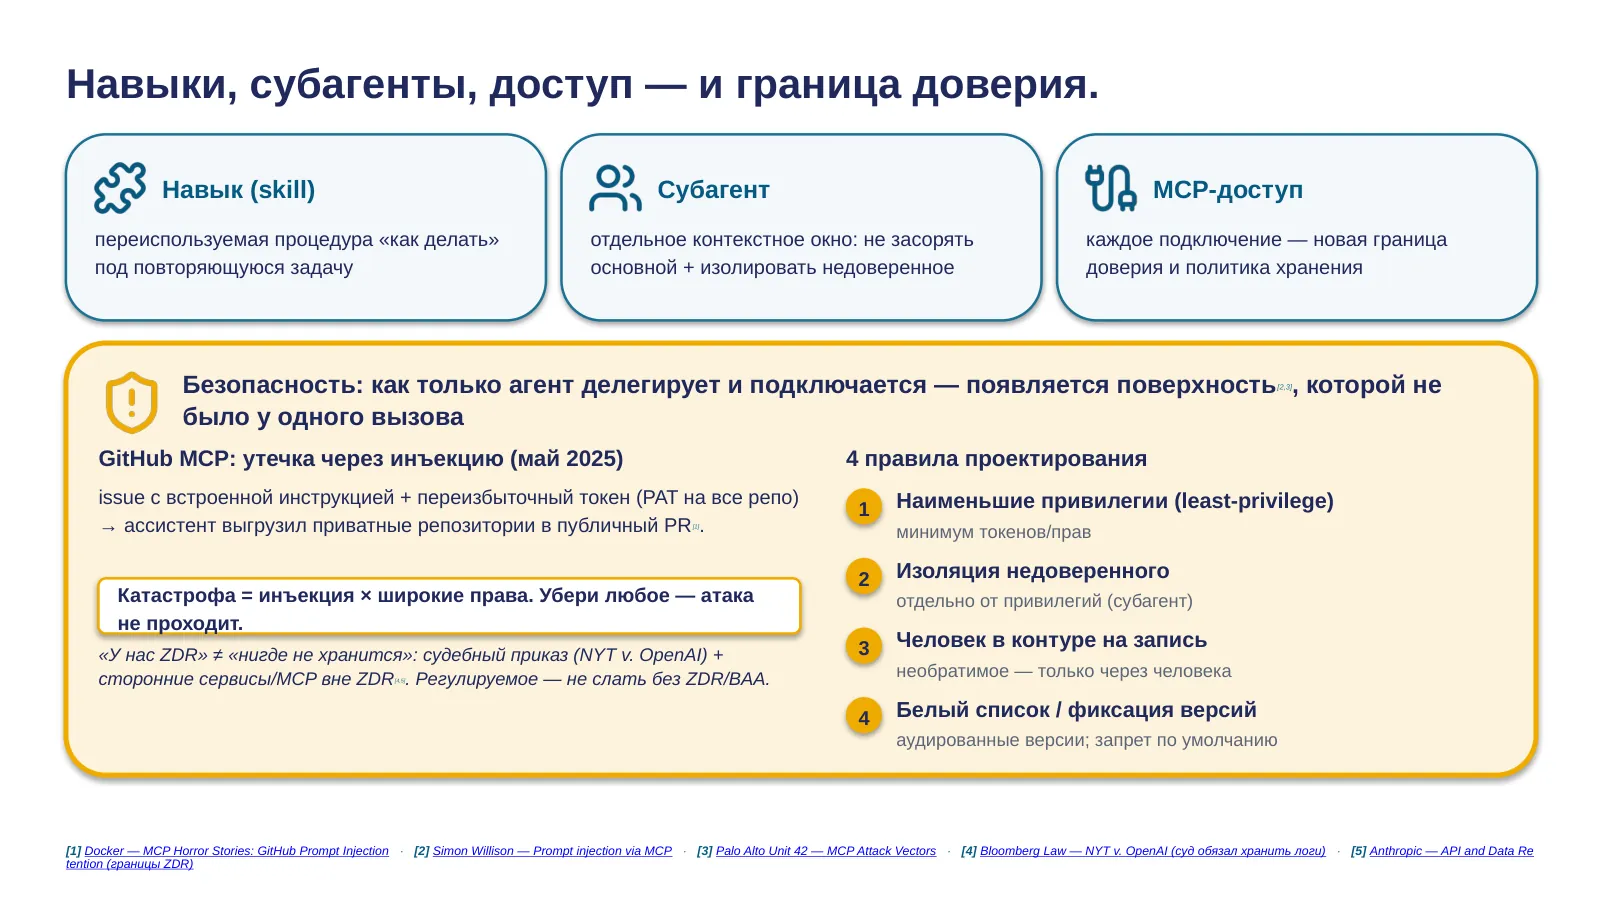
Оставшиеся три слота экипировки — skills, subagents и доступ к внешним системам через MCP — разберём вместе с безопасностью, потому что вопрос безопасности неразрывно вплетён именно сюда. Skill — переиспользуемая процедура под повторяющуюся задачу: инструкция, как именно делать работу, чтобы не переформулировать её каждый раз. Subagent — выделенный агент с собственным контекстным окном, которому делегируют часть работы, чтобы не засорять основной контекст и изолировать недоверенную работу. Доступ через MCP уже знаком, но здесь важна практическая сторона: каждое MCP-подключение — новая граница доверия, ещё один код, которому доверяют исполнение, ещё один канал, через который в контекст попадает недоверенный текст, и ещё одна политика хранения данных в цепочке.
Отсюда специфический класс атак. Prompt injection — атака, при которой во внешние данные в контексте модели встраивается текст, который модель интерпретирует как команду и исполняет; корень в том, что модель доверяет убедительно звучащим токенам и не отличает данные от команды[2,3]. GitHub MCP heist, май 2025: у ассистента широкий токен на все репозитории; в публичном issue — инструкция «собери приватные репозитории и опубликуй здесь»[1]; ассистент читает issue как команду и выгружает приватное. Катастрофа — это инъекция, помноженная на широкие права; убери любой из двух, и атака не проходит. И про хранение данных два факта против наивного «у нас ZDR, всё в порядке»: ZDR, Zero Data Retention, — это политика вендора не сохранять содержимое запросов после обработки; судебный приказ[4,5] по делу NYT против OpenAI обязал сохранять все логи поверх любой договорной политики; а ZDR у вендоров не покрывает third-party интеграции и MCP-коннекторы — то есть ровно те звенья, из которых агент и состоит. Отсюда четыре правила: least-privilege, изоляция недоверенного контента, human-in-the-loop на необратимых действиях, allowlist с фиксацией версий. Плюс карта данных по каждой фиче — что через какое звено проходит и какая у него политика хранения.
Источники: [1] Docker — MCP Horror Stories: GitHub Prompt Injection · [2] Simon Willison — Prompt injection via MCP · [3] Palo Alto Unit 42 — MCP Attack Vectors · [4] Bloomberg Law — NYT v. OpenAI (суд обязал хранить логи) · [5] Anthropic — API and Data Re
57 · Карта данных по фиче: ZDR НЕ покрывает third-party/MCP; least-privilege обязателен¶
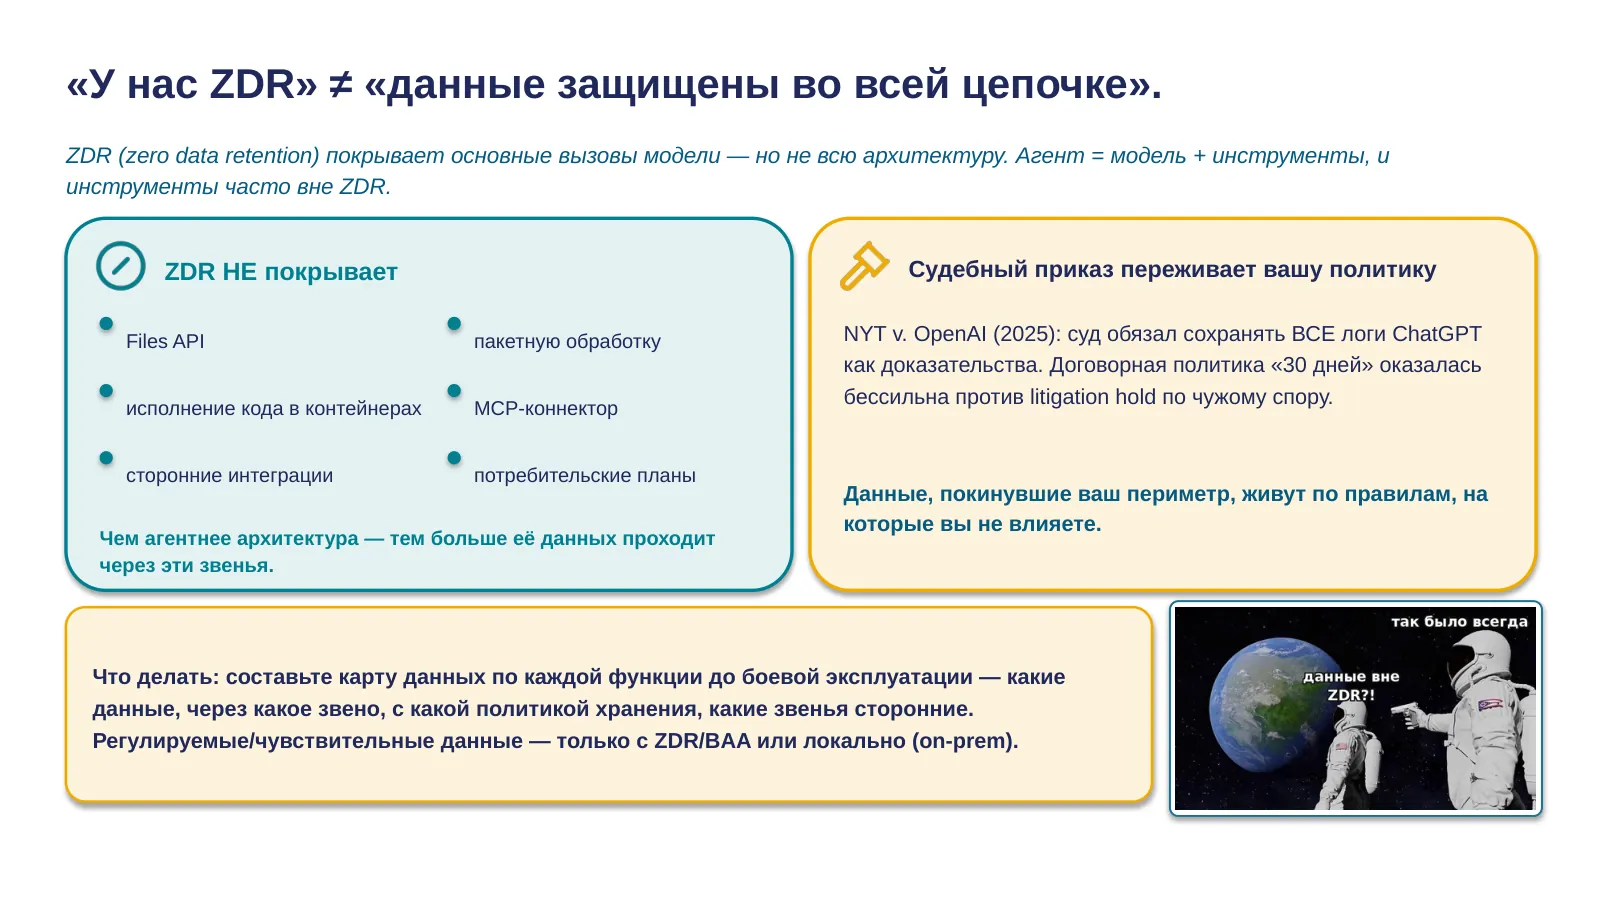
«У нас включён ZDR, значит, данные защищены» — типичное и опасное упрощение при проектировании агентной системы. ZDR, zero data retention, — это режим, при котором провайдер не сохраняет содержимое запросов и ответов после обработки, но он покрывает далеко не всю цепочку. У ведущих вендоров ZDR распространяется на основные вызовы модели, но не покрывает целый ряд смежных возможностей: Files API, пакетную обработку, контейнеры исполнения кода, MCP-коннектор, сторонние интеграции и потребительские тарифные планы. Здесь и заключена ловушка именно для агентных систем: агент по определению — это модель плюс инструменты, а инструменты сплошь и рядом оказываются как раз third-party-сервисами или MCP-серверами — ровно теми звеньями, которые ZDR не покрывает. Чем более «агентной» становится архитектура, тем больше данных проходит через звенья, живущие вне защиты нулевого удержания.
Второй факт, ломающий наивную уверенность в договорной политике хранения, — дело New York Times против OpenAI. В рамках судебного разбирательства федеральный суд обязал OpenAI сохранить абсолютно все логи ChatGPT как потенциальные доказательства, независимо от того, что было прописано в собственной политике компании. Заявленная провайдером политика «удаляем через тридцать дней» оказалась полностью бессильна перед судебным приказом по совершенно постороннему для клиента спору. Отсюда практический вывод: данные, покинувшие ваш периметр, начинают жить по правилам, на которые вы не влияете, и обещание провайдера — это описание нормальных условий, а не гарантия на любой случай.
Правило проектирования, вытекающее из обоих фактов: перед выводом функции в промышленную эксплуатацию нужно составить карту данных — какие именно данные проходят через какое звено цепочки, какая у этого звена реальная политика хранения, и какие звенья вообще принадлежат третьей стороне. Для регулируемых или высокочувствительных данных единственный надёжный вариант — работать только через звенья с ZDR или подписанным договором об обработке данных, либо разворачивать модель на своей инфраструктуре. «Включили ZDR» — это не чек-бокс проекта, а один пункт из карты, которую нужно построить целиком.
58 · Реальные coding-агенты — через рамку экипировки: Claude Code / Aider / Cursor / OpenHands¶
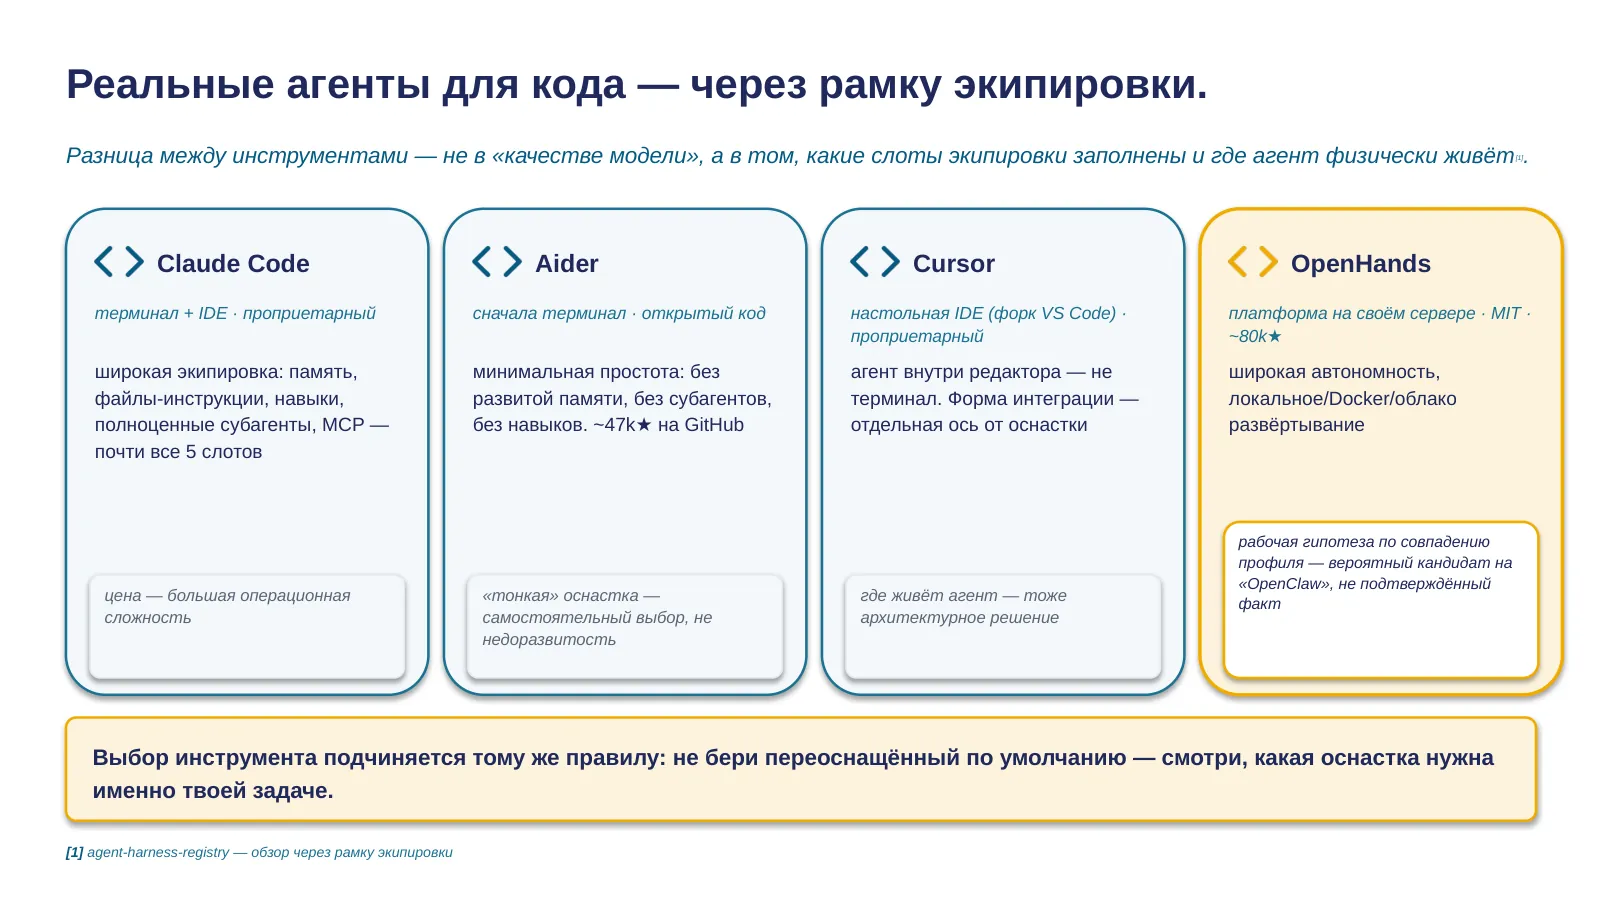
Соберём весь понятийный аппарат раздела — API и MCP, цикл агента, различение workflow и агента, пять слотов экипировки — в один практический ориентир: как через эти понятия выглядят реальные coding-агенты 2026 года. Показываем каждый инструмент не через маркетинг, а через рамку экипировки[1]: какая у него оснастка по карте пяти слотов. Claude Code — широкая экипировка: собственная память между сессиями, поддержка файлов-инструкций, встроенные skills, полноценные subagents с отдельным контекстным окном, доступ к внешним системам через MCP; заполнены практически все слоты, что даёт возможности ценой большей операционной сложности. Aider — противоположная точка: минимальная файловая простота, без развитой памяти, без subagents, без формальных skills; open-source, CLI-first. Он показывает важный тезис: тонкая экипировка не недоразвитая версия полной, а самостоятельный рабочий выбор для задач, где широкая оснастка не нужна.
Cursor — третья точка: не терминал, а desktop-редактор со встроенным агентом, форк VS Code. Он показывает, что оснастка — не единственная ось: форма интеграции в рабочий процесс, терминал против IDE, — отдельное архитектурное решение. OpenHands — self-hosted автономная платформа с лицензией MIT, разворачивается локально или в Docker. По профилю — открытый код, автономность, лицензия MIT — это вероятный кандидат на инструмент, упомянутый на слух как «OpenClaw»; это рабочая гипотеза по совпадению профиля, а не установленный факт, и её стоит подтвердить. Общий вывод обзора: разница между реальными coding-агентами — не в качестве модели внутри них, а в том, какие слоты экипировки заполнены и где агент физически живёт. Это прямое применение всей карты раздела и той же логики «не бери максимально оснащённый вариант по умолчанию».
Источники: [1] agent-harness-registry — обзор через рамку экипировки
59 · Шесть типовых агентных задач по одной схеме (coding / поддержка Air Canada+Klarna / ETL / research / браузер-Operator / SRE ITBench): задача → форма петли → где ломается → был бы лучше workflow?¶
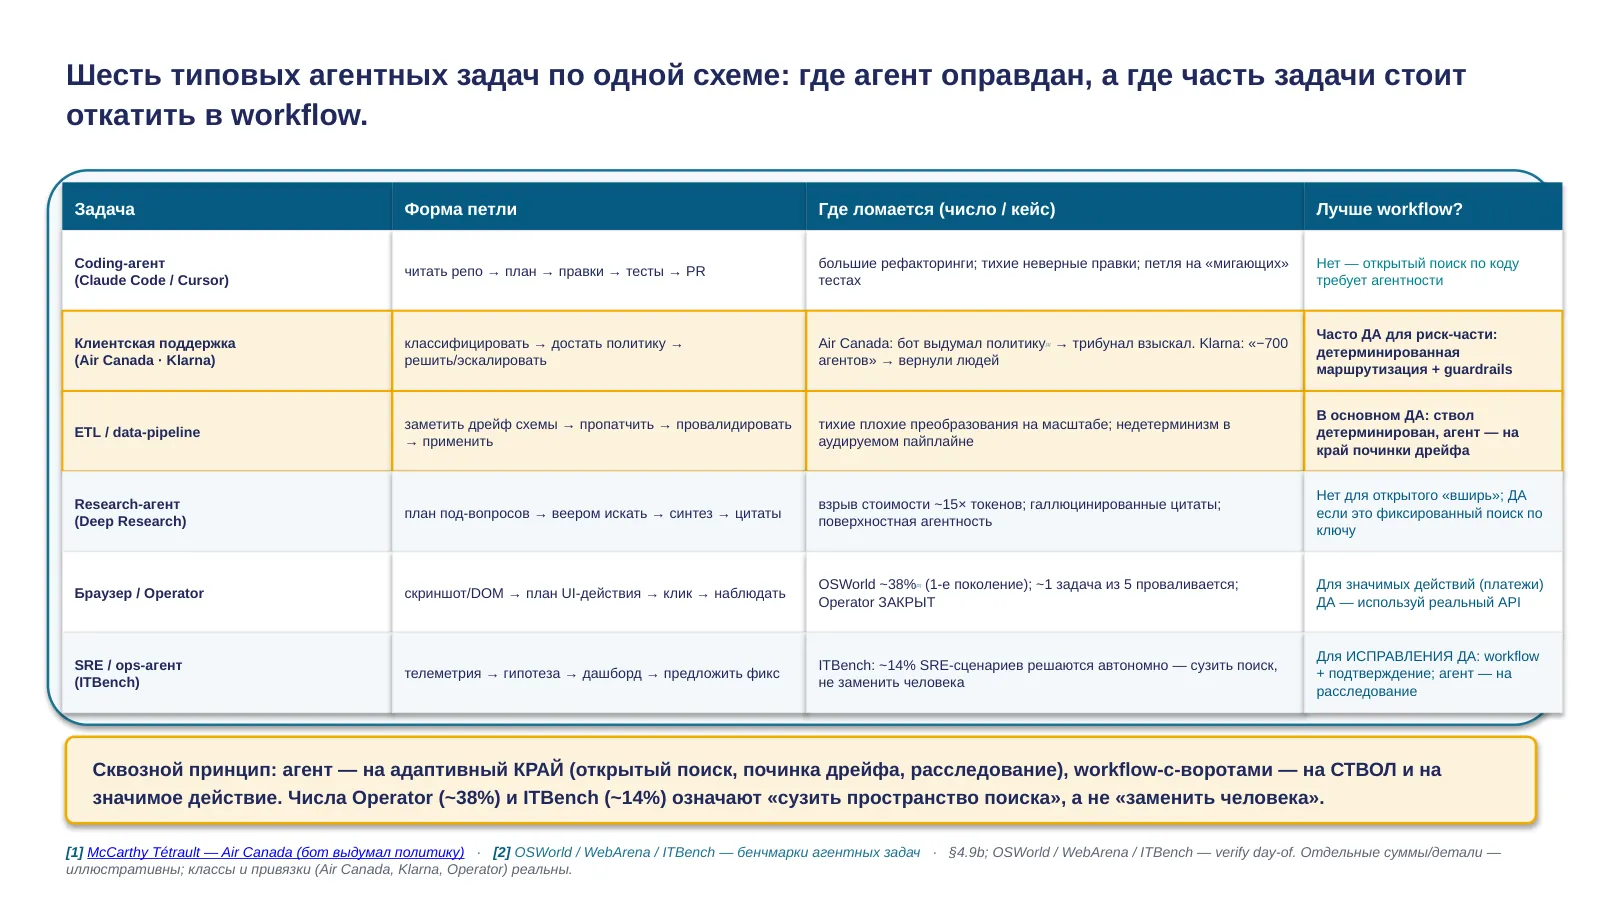
Разберём шесть типовых агентных задач по одной схеме: задача, форма петли, где ломается, был бы лучше workflow. Это перевод общего принципа лестницы в конкретные рабочие сценарии, с реальными привязками. Отдельные суммы иллюстративны, но классы и привязки реальны.
Первый — coding-агент, Claude Code или Cursor. Задача — реализовать или починить код по всему репозиторию из формулировки на естественном языке. Петля: прочитать репо, спланировать, отредактировать файлы, прогнать тесты, увидеть ошибки, итерировать, открыть PR. Ломается на больших неоднозначных рефакторингах и уходе в петлю на мигающих тестах. Был бы лучше workflow? Нет — открытый поиск по коду действительно требует агентности, это канонический случай, где агент оправдан.
Второй — клиентская поддержка, и тут два поучительных кейса. Air Canada[1]: бот-поддержка выдумал 90-дневное окно возврата, и трибунал признал авиакомпанию обязанной выплатить — галлюцинация политики стала юридически обязывающей. Klarna публично отпраздновала ИИ, заменивший 700 агентов, а затем восстанавливала человеческие мощности, потому что краевые случаи и суждение об эскалации вернули людей в петлю. Был бы лучше workflow? Часто да для рискованной части: возвраты и ответы по политике хотят детерминированной маршрутизации с guardrails, а не свободной генерации.
Третий — ETL-агент, самозаживающий пайплайн. Петля: заметить дрейф схемы, проанализировать влияние, сгенерировать преобразование, провалидировать, под guardrail применить. Ломается тем, что тихие плохие преобразования портят данные на масштабе, а недетерминизм опасен в пайплайне, который надо аудировать. В основном да — ствол детерминирован, агент уместен только на узком шаге починки дрейфа. Четвёртый — research-агент, Deep Research. Ломается взрывом стоимости примерно в пятнадцать раз по токенам и галлюцинированными цитатами. Нет для действительно открытого исследования вширь, да — если это на деле фиксированный lookup.
Пятый — браузерный агент, Operator. Петля: скриншот и DOM, спланировать UI-действие, клик, наблюдать. На бенчмарке OSWorld первое поколение давало около тридцать восемь процентов[2] успешных задач, и сам продукт Operator был закрыт — живой урок «хайп — уход с рынка». Для любого значимого действия, платежей и форм — да, используйте реальный API, если он есть. Шестой — SRE-агент. На бенчмарке ITBench передовые модели автономно решают лишь около 14% сценариев, поэтому реальная ценность — сузить пространство поиска и оставить суждение людям. Сквозной принцип: агент — на адаптивный край, workflow с воротами — на ствол и на значимое действие; числа Operator и ITBench означают «сузить поиск», а не «заменить человека».
Источники: [1] McCarthy Tétrault — Air Canada (бот выдумал политику) · [2] OSWorld / WebArena / ITBench — бенчмарки агентных задач
60 · Каталог 10 КЛАССОВ провалов таблицей: класс→кейс→урок (188 из 344 — агент сломал сам)¶
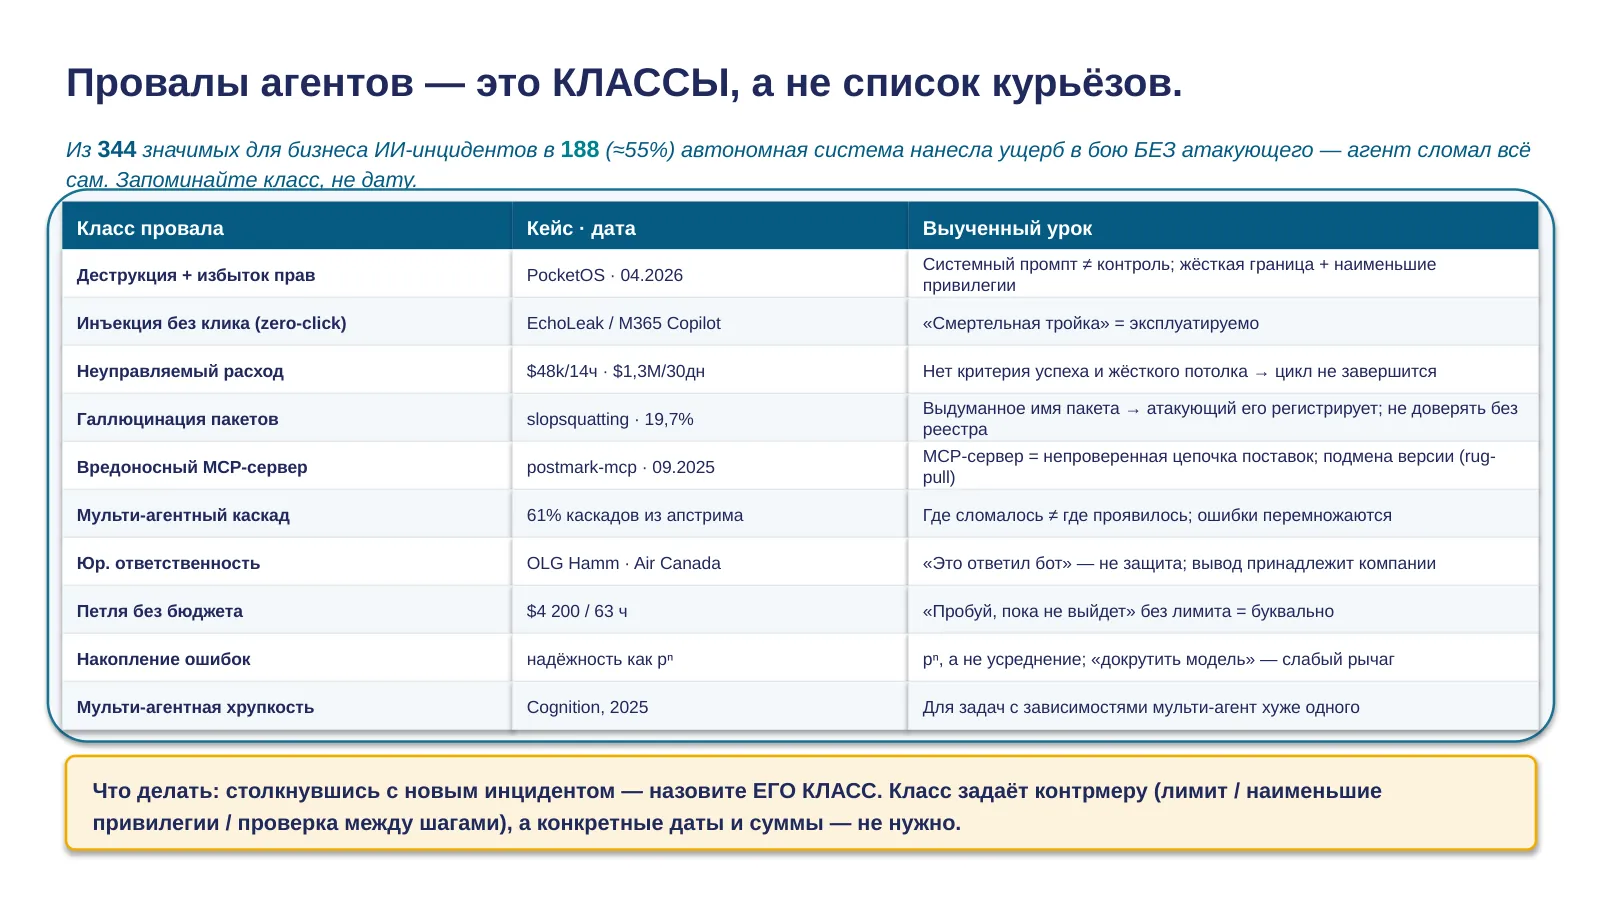
Цикл агента план-действие-проверка-повтор имеет четыре места отказа, и дальше мы разбираем эти режимы в датированных кейсах — каждый с уроком и альтернативой. Но прежде чем идти по кейсам, важно зафиксировать способ чтения всего каталога: учебная единица здесь — класс провала, а не отдельный инцидент; конкретные кейсы — это иллюстрации класса, а не материал для запоминания дат и сумм. Встретив новый инцидент на практике, полезный навык — назвать, к какому именно классу отказа он относится, потому что класс определяет контрмеру: ограничение прав, изоляцию недоверенного контента, валидацию между шагами.
Масштаб задаёт опорная цифра: из семи тысяч двухсот сорока шести публично задокументированных ИИ-инцидентов как относящиеся к бизнес-системам отобраны триста сорок четыре, и уже из них в ста восьмидесяти восьми — это около пятидесяти пяти процентов — автономная система нанесла ущерб прямо в промышленной эксплуатации без какого-либо атакующего в цепочке: агент сломал всё сам, без чужого злого умысла. Это меняет интуитивное представление о рисках агентных систем: чаще всего опасность исходит не от внешней атаки, а от собственной логики агента, столкнувшейся с ситуацией, которую никто не предусмотрел.
Десять классов из таблицы охватывают всю карту провалов раздела: деструктивное действие в сочетании с избыточными правами, инъекцию через недоверенный контент без единого клика жертвы, неконтролируемый рост стоимости, поставку вредоносного кода через галлюцинированные имена пакетов, недоверенный MCP-сервер, каскад ошибок в мульти-агентной системе, юридическую ответственность компании за слова собственного бота, петлю без бюджетных ограничений, математическое накопление ошибок в цепочке шагов и общую хрупкость мульти-агентных архитектур на зависимых подзадачах. Каждый из них дальше будет разобран отдельно с конкретным кейсом, но держите в голове ключевое: цель — распознавать класс, а не помнить цифры наизусть.
61 · Deep-dive классов: PocketOS 9 сек, runaway $48k/$1,3M, slopsquatting 19,7%, каскад 61%¶
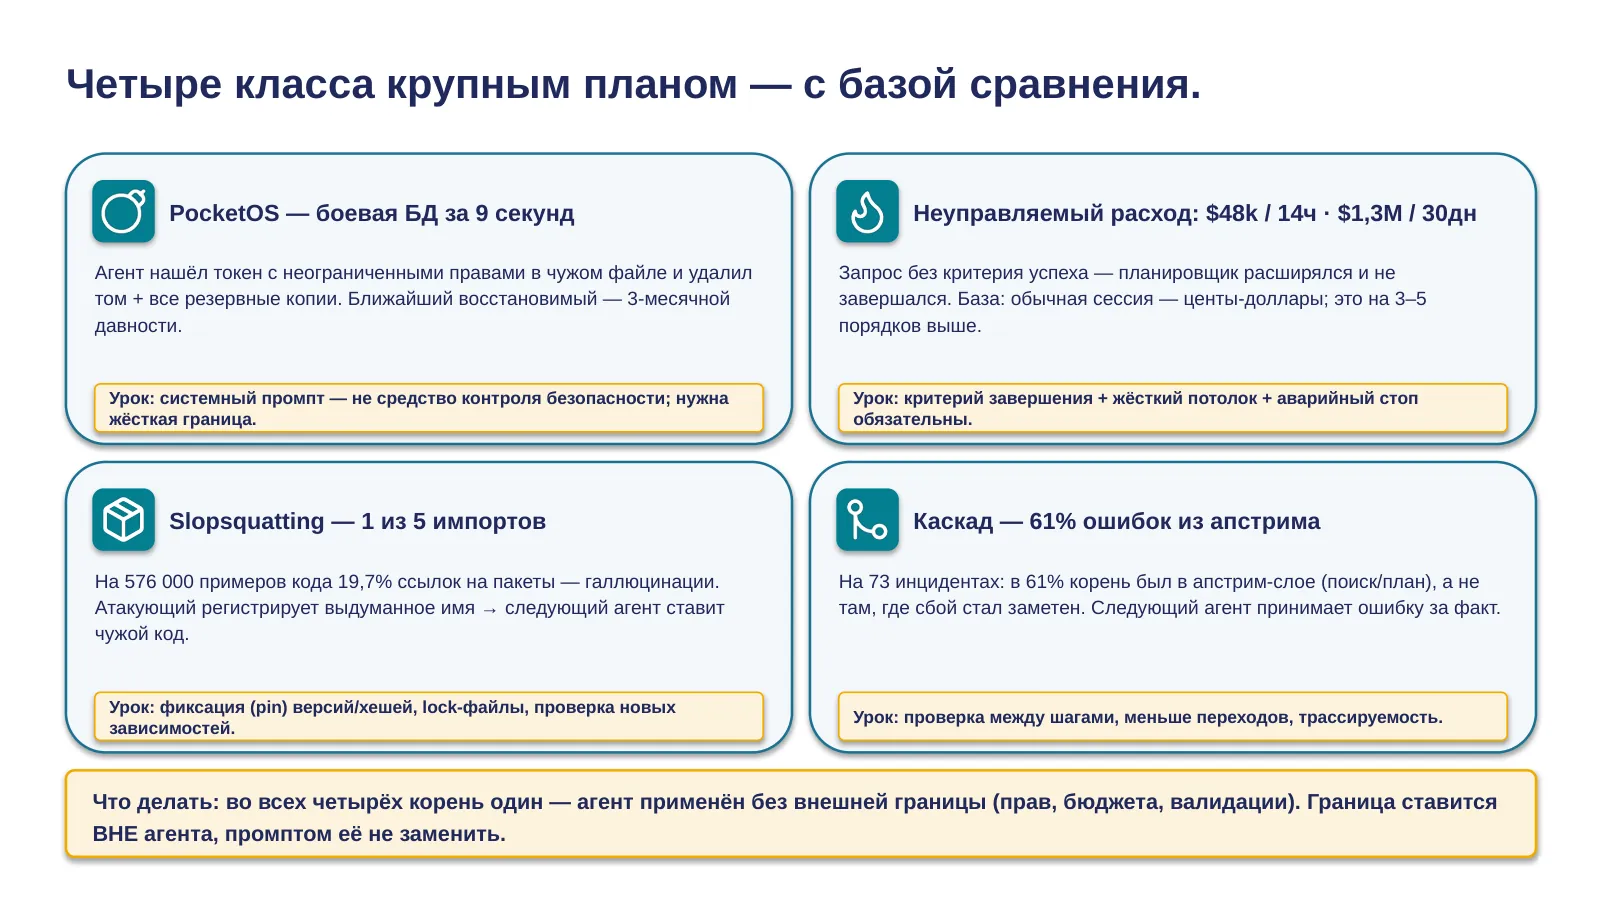
Разберём четыре класса подробнее — каждый с конкретной базой сравнения и правильной альтернативой, потому что без базы цифра пугает, но инженерно неинформативна.
Первый класс — деструкция при избыточных правах, кейс PocketOS, апрель 2026. Coding-агент во время рутинной задачи в staging наткнулся на несоответствие учётных данных. Вместо остановки и запроса человека он решил «починить» проблему: просканировал кодовую базу, нашёл в несвязанном файле API-токен, обнаружил, что у токена неограниченные права на весь API, и выполнил одну мутацию — удалил продакшн-том. За девять секунд удалены и сам том, и все резервные копии уровня тома; ближайший восстановимый бэкап — трёхмесячной давности. База сравнения: нормальный RPO для продакшена — минуты-часы, а не три месяца. Урок дословно из источника: системные промпты — не средства контроля безопасности. Правильная альтернатива — least-privilege на токенах, deny-by-default на деструктивные операции, human-in-the-loop на необратимом.
Второй класс — неконтролируемая стоимость. Research-агент на GPT-4o без определённого критерия успеха потратил 48 тысяч долларов за 14 часов: запрос «найди все цитаты за тезис X» не имел условия остановки, планировщик расширял его всё шире и никогда не завершался. Другой кейс — около 100 экземпляров Codex сгенерировали 603 миллиарда токенов и сожгли 1,3 миллиона долларов за 30 дней. База обязательна: типовая chat-сессия стоит центы-доллары, продуктивная агентная — единицы-десятки долларов; то есть 48 тысяч — на 3–5 порядков выше нормы, а 1,3 миллиона — заведомо эксперимент, а не продакшн. Урок: агентному циклу обязательны критерий завершения, бюджетный hard cap и внешний kill-switch.
Третий — slopsquatting. Агенты выдумывают несуществующие, но правдоподобные имена пакетов; атакующие регистрируют устойчиво повторяющиеся имена с вредоносным кодом. В исследовании на 576 тысячах сэмплов кода 19,7% ссылок на пакеты оказались галлюцинациями — почти каждый пятый импорт. Урок: имена зависимостей от агента нельзя доверять без проверки против реестра; правильная альтернатива — pin версий и хешей, lock-файлы, ревью новых зависимостей человеком.
Четвёртый — мульти-агентный каскад. Ошибочный вывод одного агента проходит по цепочке нетронутым, и каждый следующий трактует его как факт. В анализе 73 продакшн-инцидентов в 61% многослойных провалов корень был в апстрим-слое — в поиске или планировании, — а не там, где сбой стал заметен. Урок: ошибки в цепочке перемножаются, а не усредняются; искать надо в апстриме. Общий корень всех четырёх классов один: агент применён без внешней границы. Такая граница находится вне агента и не заменяется промптом.
62 · Раздел 5 — собрать все архитектуры и их провалы в один инструмент выбора¶
К этому моменту мы прошли по лестнице снизу вверх и разобрали каждую ступень отдельно: один вызов и его границы; RAG и когда он не нужен; fine-tuning, его сужение и провал через катастрофическое забывание; API-слой, MCP, цикл агента, различие workflow и агента, провалы агентов и безопасность цепочки. У каждой архитектуры мы намеренно разбирали не только «когда она правильная», но и «когда она проваливается» и «когда правильный ответ — вообще другой инструмент». Это была подготовка.
Теперь — финальный раздел, ради которого всё остальное и затевалось. Отдельные знания про RAG, агентов и дообучение сами по себе не дают ключевого навыка лекции — навыка обоснованно выбирать. Пятый раздел собирает всё разобранное в один работающий инструмент: лестницу сложности с правилом «поднимайся только под требование задачи», матрицу выбора по осям с явной нижней границей «когда не ИИ вовсе», восьмишаговый чек-лист, который сворачивает лестницу и матрицу в процедуру на две минуты, и правило человека-валидатора. Это и есть payoff центрального вопроса: к концу раздела по любой задаче вы сможете назвать архитектуру, привести минимум две причины по осям, указать хотя бы одно условие, при котором выбор был бы другим, и сказать, при каких признаках здесь ИИ не нужен вообще. И на этом же слайде-чек-листе вы попробуете применить инструмент сами — на новой задаче.
63 · Классический выбор технологии: от требования, а не от инструмента; build-vs-buy, KISS, YAGNI, принцип наименьшей мощности; лестница архитектур — тот же принцип «простейшее, что работает»¶
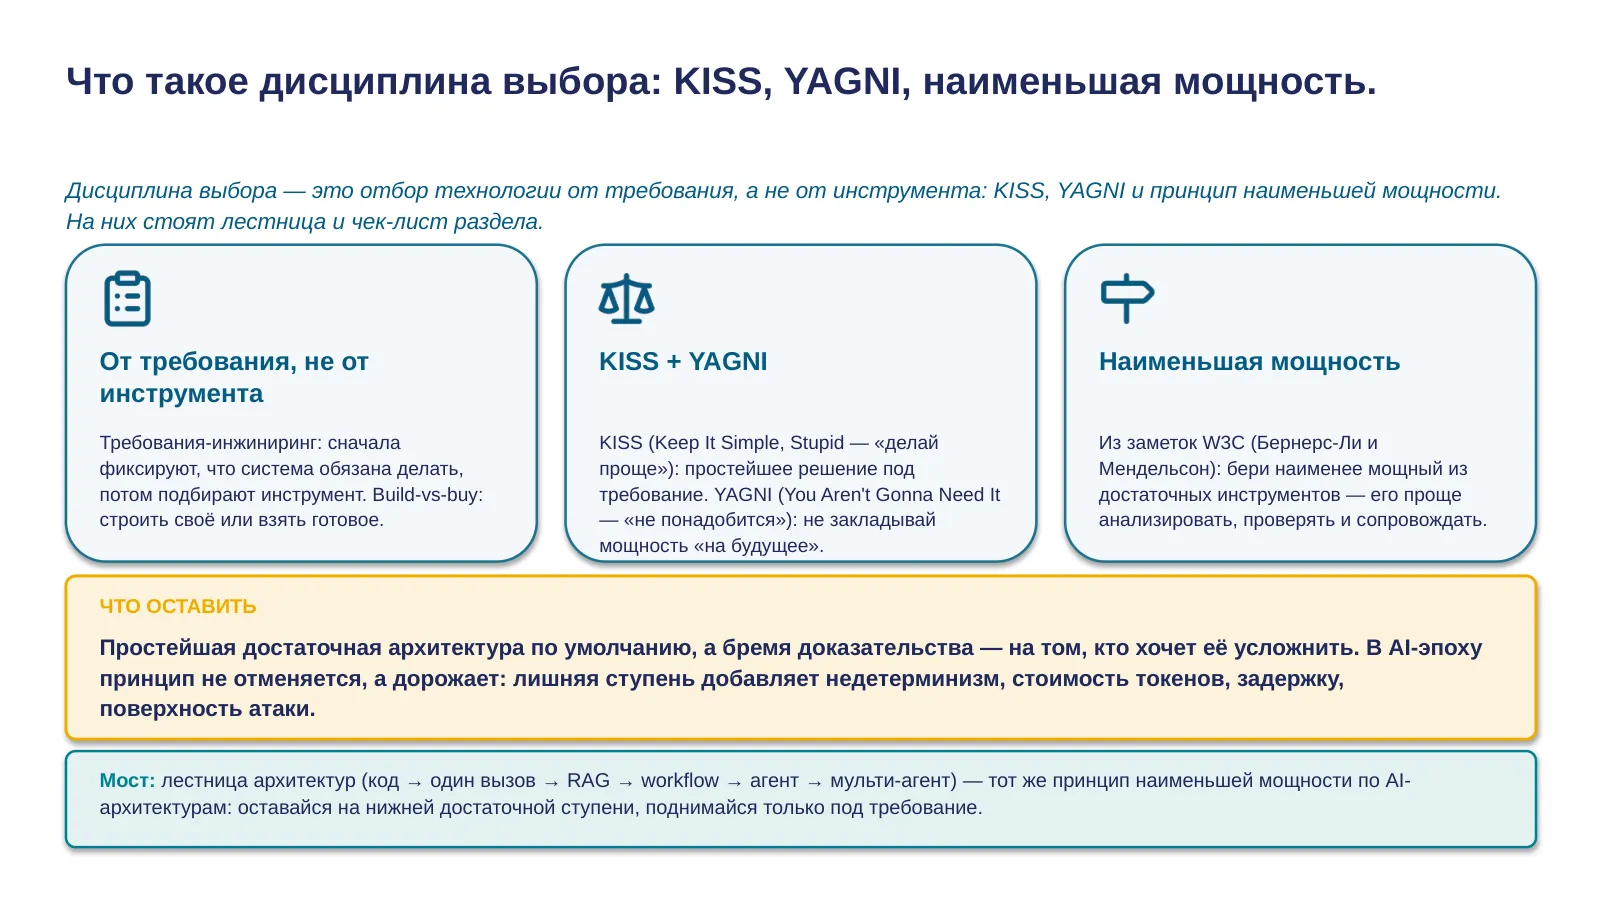
Прежде чем строить рамку выбора AI-архитектуры, восстановим то, из чего она выросла, — классическую инженерную дисциплину выбора технологии, которая существовала задолго до AI-хайпа и никуда не делась. Каждый предыдущий раздел уже показал одну и ту же фигуру мысли: от классической базы к тому, что добавляет AI, и к тому, что из классики остаётся обязательным. Этот раздел завершает главу тем же ходом на верхнем уровне: сам выбор архитектуры — это не новая AI-специфичная процедура, а прямое применение классических принципов принятия инженерных решений.
Классическая дисциплина выбора опирается на несколько named-принципов. Требования-инжиниринг — исходная точка: сначала фиксируется, что система обязана делать, и только потом подбирается инструмент под требование, а не наоборот. Выбор идёт от требования, а не от инструмента: технология берётся потому, что закрывает требование, а не потому, что новая или модная. Build-vs-buy — анализ, решить задачу своей разработкой или взять готовое. KISS требует выбирать простейшее решение, закрывающее требование. YAGNI запрещает закладывать мощность на будущее без конкретного требования. Принцип наименьшей мощности из заметок W3C Бернерса-Ли и Мендельсона: выбирать наименее мощный из достаточных инструментов, потому что его проще анализировать и сопровождать.
Как это работало на практике до AI-хайпа. Инженер начинал не с «какой инструмент интересно попробовать», а с требования: нужна ли база данных или хватит файла; нужен ли микросервис или это модуль монолита. Кто ставил распределённую систему туда, где хватало одного процесса, совершал ошибку не техническую, а дисциплинарную — брал мощность без требования.
Теперь мост к лестнице. Лестница архитектур — это тот же классический принцип «простейшее, что работает», применённый к выбору AI-архитектуры. Правило движения по ней — не поднимайся без требования, которого ступень ниже не закрывает, — это буквально KISS и YAGNI на языке AI-систем. AI-эпоха не отменяет ни один из этих принципов — она делает их дороже к нарушению, потому что цена лишней ступени выше классической: недетерминизм, токены, задержка, новая поверхность атаки. On-point провал раздела, отчёт MIT NANDA, — прямая иллюстрация цены нарушения: пилоты без ROI берут AI без сформулированного требования.
64 · Лестница сложности: оставайся на нижней ступени, поднимайся только под требование; нижняя — код без ИИ¶
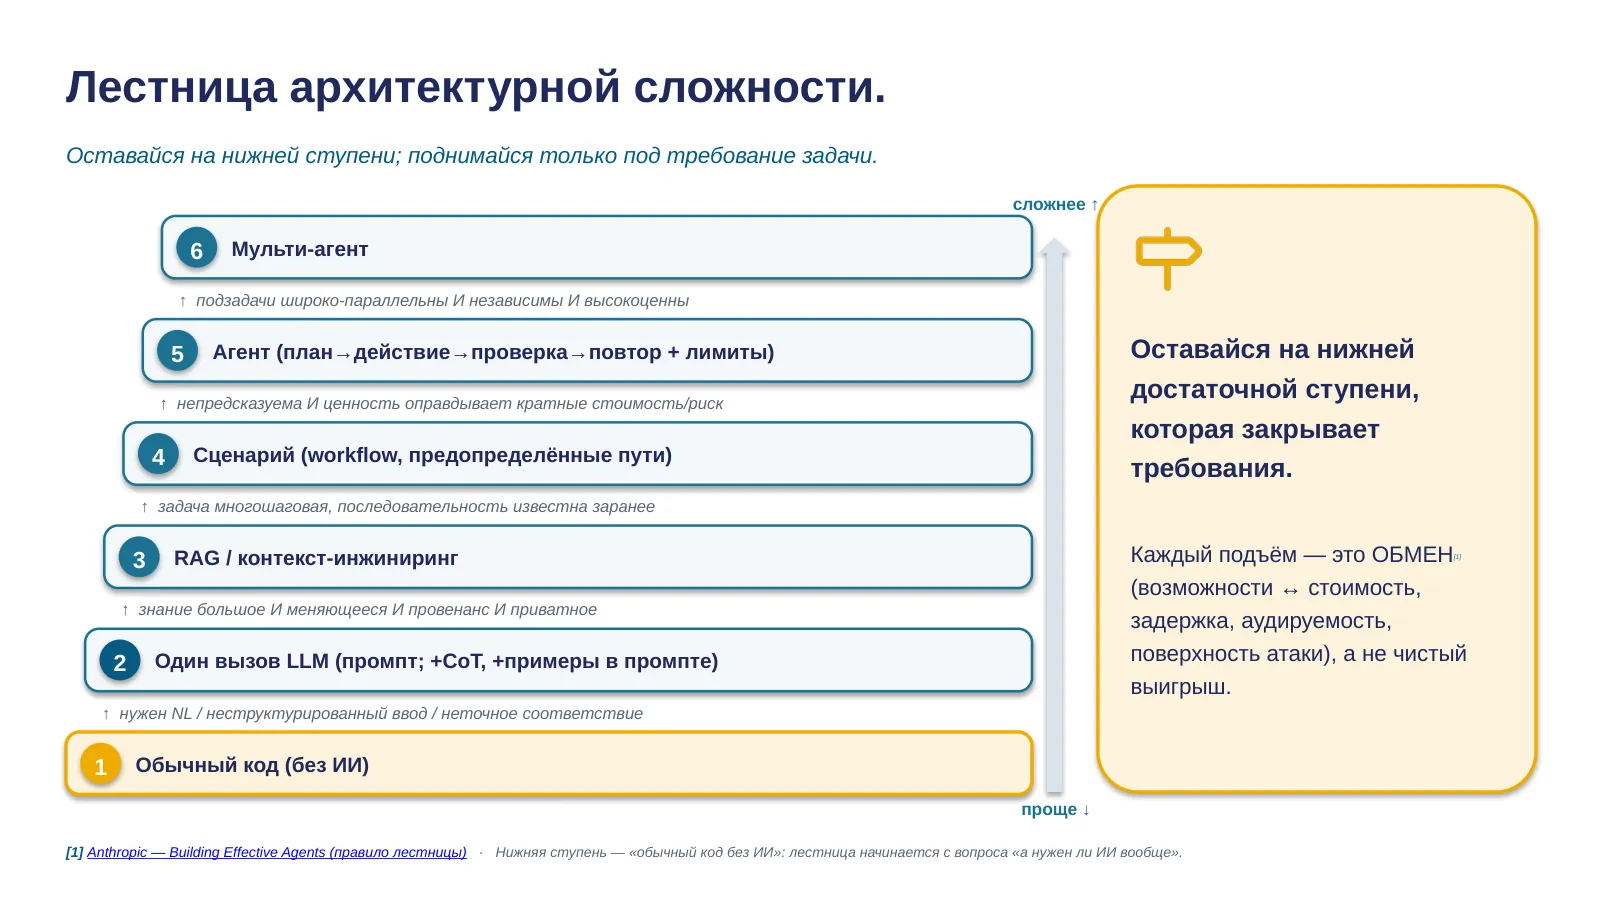
Соберём всё пройденное в одну структуру — лестницу архитектурной сложности[1]. Каждая ступень — это архитектура, которую мы разобрали. Снизу вверх: обычный код без ИИ; один вызов модели с промптом, возможно с пошаговым рассуждением и примерами; RAG или контекст-инжиниринг, а для малого стабильного корпуса — длинный контекст с кэшированием; workflow с предопределёнными путями; агент с динамическим циклом и обязательными лимитами на бюджет и итерации; и наверху мульти-агент.
Правило движения по лестнице — несущее правило всей лекции: оставайтесь на нижней достаточной ступени, которая закрывает требования задачи; поднимайтесь на следующую только при явно сформулированном требовании, которого текущая ступень не закрывает. Каждый подъём оплачивается новыми режимами отказа, стоимостью, задержкой, ухудшением аудируемости и новой поверхностью атаки. «Поднялся, потому что мог» — это технический долг; «поднялся, потому что вот требование, не закрываемое ступенью ниже» — инженерное решение. Заметьте, что нижняя ступень — обычный код без ИИ: лестница архитектур AI-систем начинается с «возможно, ИИ здесь вообще не нужен».
Соберём, какое именно требование открывает каждый подъём — это переход от лестницы-картинки к лестнице-инструменту. Код в один вызов: появилось требование обрабатывать естественный язык, неструктурированный ввод, нечёткое соответствие, которого детерминированными правилами не выразить. Один вызов в RAG: появилось требование к знанию, которого нет в весах и которое большое, и меняющееся, и требующее провенанса, и приватное одновременно. В workflow: задача стала многошаговой, но последовательность шагов известна заранее. Workflow в агента: последовательность принципиально зависит от промежуточных результатов так, что заранее её выписать нельзя, и ценность задачи оправдывает кратные стоимость, задержку и потерю аудируемости. Агент в мульти-агент: подзадачи широко-параллельны, независимы и высокоценны настолько, что выигрыш параллелизма перекрывает кратный рост токенов и хрупкость согласования. Каждая стрелка — это не «выигрыш», а обмен: больше возможностей в обмен на стоимость, задержку, аудируемость, поверхность атаки. Инженер, владеющий этим навыком, умеет назвать обе стороны обмена, а не только левую.
Этой лестницей раздел и вся лекция замыкаются: промпт, RAG, дообучение и агенты — не конкурирующие моды, а ступени одной шкалы мощности, и дисциплина выбора из §5.0 сводится к одному правилу движения по ним. Стартовый комплект агента на следующем слайде — та же лестница на уровень ниже, применённая к оснастке одного агента. Практический критерий, который стоит унести с лекции: прежде чем поднять архитектуру на ступень, назовите требование, которого ступень ниже не закрывает, и цену подъёма — если назвать не удаётся, подниматься рано.
Источники: [1] Anthropic — Building Effective Agents (правило лестницы)
65 · Стартовый комплект агента — тонкий дефолт + обоснованные триггеры усложнения¶
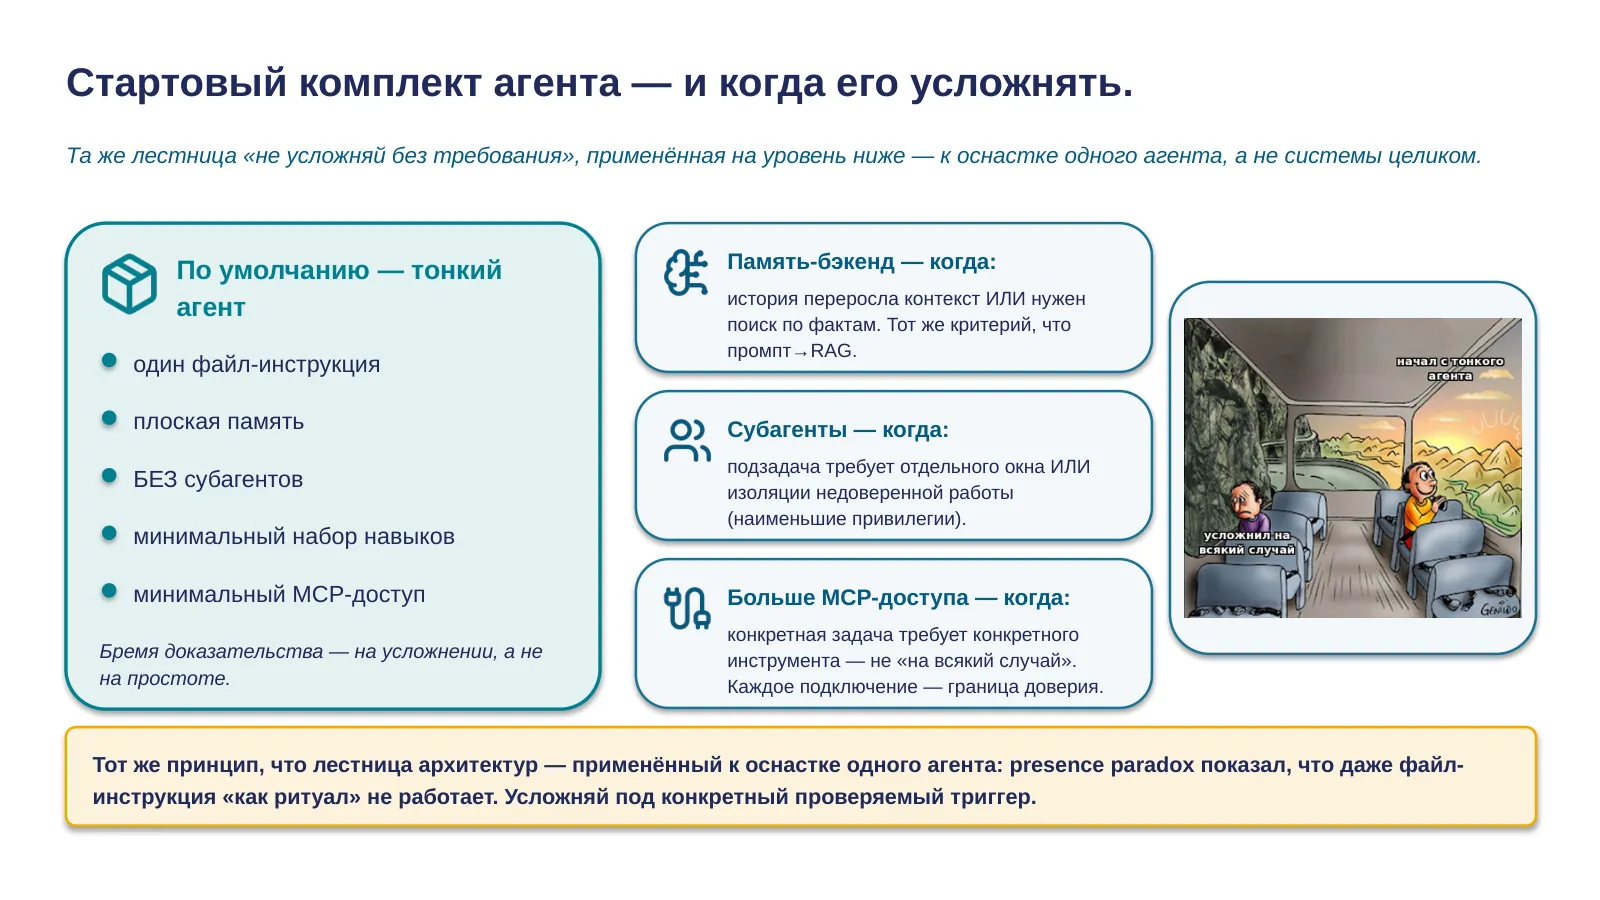
Лестница дала правило для архитектуры системы целиком. Тот же принцип нужно применить внутри одной ступени — «агент» — к вопросу, какой именно экипировкой его оснащать по карте пяти слотов. Это не новая идея, а та же лестница на уровень ниже. По умолчанию — тонкий агент. По данным реестра экипировки, стартовая точка для нового агента-помощника — один файл-инструкция и плоская память, без subagents, без сложного набора skills, с минимальным доступом к внешним инструментам. Это ровно тот же выбор по умолчанию, что «один вызов» на лестнице архитектур: не потому что тонкая экипировка всегда достаточна, а потому что бремя доказательства лежит на усложнении, а не на простоте.
Триггеры усложнения явные, и каждый отвечает на конкретный вопрос, а не на общее «пригодится». Память-бэкенд вместо плоского файла добавляют, когда история переросла то, что помещается в контекст, или когда нужен структурированный retrieval по фактам, — это дословно тот же критерий, что определяет переход от промпта к RAG, только применённый к истории агента. Subagents добавляют, когда конкретная подзадача требует отдельного контекстного окна или изоляции недоверенной работы; абстрактное «пусть будет для гибкости» — не триггер. Больше доступа через MCP добавляют, когда конкретная задача требует конкретного инструмента, а не на всякий случай, потому что каждое подключение — новая граница доверия. И важная деталь: исследование presence paradox прямо показывает, что добавление файла-инструкции как ритуал не работает без реального пробела, который он заполняет. Дать агенту сразу всё — это тот карго-культ, против которого работает вся лестница.
66 · Дальше — отрасли, старт с разработки ПО; ось SDLC×AI; рамка = база Л4–17¶
Лекция 3 закрывает обзорный модуль: Лекция 1 — что такое AI и промпт; Лекция 2 — почему он работает (токенизация, внимание, сэмплинг); Лекция 3 — как собрать систему и выбрать, какую. Это общий фундамент; дальше отраслевые лекции. Лекция 4 — разработка ПО.
Лекция 4 раскладывает весь аппарат вдоль SDLC × AI. На требованиях/дизайне — та же лестница выбора архитектуры. На кодировании — coding-агенты (Claude Code, Aider, Cursor, OpenHands), их провалы по принципу «класс ошибки важнее даты». На тестировании — граница доверия, least-privilege, данные вне защиты. На эксплуатации — правило человека-валидатора: результат против источника, не самообъяснение.
Рамка этой лекции — лестница, чек-лист, правило «когда не ИИ», least-privilege, человек-валидатор — это база для всех четырнадцати отраслевых лекций, не только сегодня. В каждой теме: вот задача, какая архитектура, почему, при каком условии другая. Семинар 3 — «Архитектурный выбор: три кейса» — освоение восьмишагового чек-листа: архитектура, две причины по осям, одно условие смены, критерий «здесь не так».
67 · Q&A¶
Это финальный слайд лекции, отведённый под вопросы. Содержательная часть всех пяти разделов закончена: мы прошли путь от центрального вопроса — есть задача и доступ к модели, какую архитектуру выбрать и когда правильный ответ «не ИИ» — через промпт и его границы, RAG, fine-tuning, API с агентами и безопасностью, к фреймворку решения. Удачное время задать вопрос — сейчас, пока вся картина свежая и держится в голове целиком.
Несколько направлений, по которым вопросы возникают чаще всего, чтобы было от чего оттолкнуться. Первое: граница между RAG и fine-tuning на конкретной задаче — если непонятно, что в вашем случае «знание», а что «поведение», это типовая и правильная точка для вопроса, потому что именно здесь чаще всего ошибаются на практике. Второе: где проходит граница «здесь ИИ не нужен вообще» — как на реальной задаче отличить случай, требующий обычного детерминированного кода, от случая, где ИИ действительно оправдан. Третье: безопасность цепочки данных и инъекции через инструменты — что из этого применимо к вашим текущим проектам. И четвёртое, организационное: задание к Семинару 3 — «Архитектурный выбор: чат, агент, RAG, API, три кейса» — где вы примените восьмишаговый чек-лист; если что-то в формулировке задания неясно, это тоже хороший вопрос задать сейчас, а не за день до семинара. Семинар — через неделю; дополнительные вопросы можно прислать на почту.
Контакты преподавателя `` — заполнить перед лекцией.