Лекция 5. ИИ-продукт: полный жизненный цикл — от намерения до эксплуатации
Лекция 5 · 56 слайдов
01 · Два факта, которые оба верны
«Начнём с двух измерений. Оба честные, и сходятся они в неудобном месте.
Первое — внутренний опыт Anthropic, компании, которая делает языковые модели. Работа, занимавшая недели, укладывается в часы. Это их собственный замер на их собственной разработке. Изготовление подешевело на порядок.
Второе — отчёт исследовательской группы Массачусетского технологического института, лето 2025 года. Около девяноста пяти процентов организаций не получили от искусственного интеллекта измеримой отдачи. Дальше я буду говорить «ИИ» — это и есть искусственный интеллект.
У второго числа сразу назову знаменатель, потому что без него оно читается неверно. Девяносто пять процентов считаются от всех организаций, которые темой интересовались. Не от тех, кто дошёл до пилота. В первоисточнике там воронка, и в конце лекции мы её развернём: доля успеха среди дошедших до пилота оказывается впятеро выше заголовочной. Пока держим в уме, что цифра громкая и что с ней придётся разбираться.
Оба утверждения верны одновременно, и это важнее каждого из них по отдельности. Изготовить стало почти бесплатно. Превратить изготовленное в пользу — осталось ровно так же дорого.
Разрыв между этими двумя фактами и есть предмет лекции: где он возникает, по какой причине, и что в этом месте делают инженеры, у которых получается.
Лекция 4 была про код. Там мы выяснили, что писать код стало дёшево, а понимать, что строить и кто за это отвечает, — нет. Сегодня тот же вопрос, поднятый на уровень продукта целиком: от «кому это вообще нужно» до «работает ли оно через год».»
Источники: [1] Anthropic — 2026 Agentic Coding Trends Report · [2] MIT NANDA — «The GenAI Divide» (июль 2025, v0.1)
02 · Обложка
«Лекция пятая. ИИ-продукт: полный жизненный цикл — от намерения до эксплуатации.
Шесть разделов — шесть стрелок одной петли. Код из Лекции 4 внутри этой петли занимает один шаг, и теперь он дешевле всех остальных. Нулевой раздел даёт ось, седьмой собирает разобранное в инструмент, который можно применить к случаю, которого в лекции не было.»
03 · Лекция устроена как петля
«Карта лекции нарисована кругом, и это содержательное решение.
Исследование — откуда берётся гипотеза. Дизайн — гипотеза становится артефактом, который можно показать человеку. Сборка и запуск — артефакт становится работающим продуктом в руках пользователя. Измерение — сработало ли это на самом деле. Поддержка — продукт продолжает работать месяцами. Управление — куда вкладывать дальше и что пора закрыть.
Шестая стрелка выделена золотым и возвращается в первую: решение о вложениях снова питает исследование. Продукт живёт столько, сколько команда успевает пройти этот круг и зайти на него снова. Каждая стрелка разбирается по одной и той же схеме, и схему я назову следующими двумя слайдами.»
04 · Зачем продукту цикл
«Отвечу на вопрос, который честно задать сразу: зачем продукту вообще цикл?
Потому что продукт отвечает на пять вопросов, и ответы на них даёт наблюдение, а мнение внутри команды их не заменяет.
Нужно ли это кому-то вообще — фаза исследования. Сможет ли человек этим воспользоваться, и не пострадает ли тот, о ком не подумали, — фаза дизайна. Можем ли мы это сделать и безопасно выпустить — сборка и запуск. Выберут ли это настолько, чтобы за это платить — измерение и управление. И пятый: держатся ли эти ответы через квартал — поддержка.
Первые четыре — риски продукта по Марти Кагану, продуктовому руководителю и автору книги «Inspired»; пятый открывается только после запуска. У каждого своя фаза, и цикл — минимальный набор мест, где на эти вопросы отвечают.
Когда цикла нет, вопросы не исчезают: их место занимают оптимистичные допущения. Ошибка тоже не исчезает — сдвигается момент, когда её находят: после оплаченной сборки и состоявшегося релиза, где откат стоит дороже самой ошибки. Барри Боэм, исследователь экономики разработки программ, замерил это ещё в 1981 году: от требований до выпуска стоимость исправления расходится до ста раз в крупных проектах и вчетверо в небольших.
Как это выглядит изнутри команды. Собрали — никто не пользуется. Дошли до пилота и застряли. Работает, но не выбрано. Внедрили, а через квартал перестали открывать. Сборка во всех четырёх случаях прошла успешно, поэтому изнутри читается как успех, и ошибка в непроверенной гипотезе остаётся невидимой.
Вывод, который держит всю лекцию. Дороговизна сборки работала невольным заслоном: пока изготовление стоило недели, оно само заставляло думать заранее. ИИ обнулил именно её. У команд, у которых явного цикла не было никогда, не осталось ничего, что удерживало бы их от пропуска этих пяти вопросов.»
05 · ИИ меняет каждую стрелку, и меняет по-разному
«Несущая мысль лекции.
У каждой стрелки петли есть классическая дисциплина, и ИИ её не отменяет. Он меняет две вещи: сколько эта дисциплина стоит и насколько ей можно верить без проверки.
Три стрелки, три разных исхода.
Строить — фаза сборки и запуска. Стоимость упала почти до нуля: черновик кода, макета, плана исследования появляется за минуты.
Измерять и делать выводы — фаза измерения. Стоимость осталась та же, а доверие к результату упало, потому что сам инструмент измерения стал вероятностным. Модель, которая оценивает качество ответов, сама отвечает по-разному на один и тот же вход.
Наблюдать за работающим продуктом — фаза поддержки. Наблюдать стало быстрее, а само наблюдение стало уязвимым: подменённые данные на входе дают уверенный неверный вывод.
Три разных исхода на трёх стрелках одной петли. Отсюда схема всех шести разделов: какая классическая дисциплина отвечает за фазу, что в ней удешевил ИИ, где подход «сначала ИИ» ломается.
Про саму петлю. Её независимо описали трижды: статистик качества Уильям Деминг в 1939 году, лётчик-истребитель и военный теоретик Джон Бойд в семидесятых, предприниматель Эрик Райс в 2011-м. Три человека из трёх разных миров пришли к одной фигуре — это структурное свойство системы, которая учится в неопределённости. Методологию одного автора можно принять или отвергнуть; структурное свойство придётся учитывать.»
06 · Дивайдер Раздела 1
«Раздел первый. Исследование: есть ли проблема и у кого. Одна база, две практики, два разбора провала.
Цель фазы одна — выяснить, существует ли проблема и у кого именно, пока решение ещё не построено. Пропустить фазу можно. Тогда ответ придёт в день запуска, когда деньги и месяцы уже потрачены, и вернуть их нечем.»
07 · Классика: записанная гипотеза и два правила разговора
«Ответ о пользователе придёт в любом случае. Либо от восьми разговоров за две недели, либо от рынка в день запуска, когда разработка уже оплачена. Дисциплина выбирает первое — в этом вся её экономика.
Называется она развитие клиента, по-английски Customer Development; оформил её Стив Бланк, предприниматель Кремниевой долины и преподаватель Стэнфорда. Правило, ради которого она существует: внутри офиса фактов нет, факты снаружи.
Выйти наружу мало: без записанной заранее гипотезы из разговоров возвращаются с впечатлениями, подтверждающими то, во что верили до выхода. Поэтому гипотезу записывают в одну строку: мы верим в такое-то утверждение, проверим его таким-то способом, к такой-то дате получим ответ «да» или «нет».
Дата здесь работает. Без неё у слова «проверим» нет срока, и гипотеза живёт ровно столько, сколько команде удобно в неё верить.
Второе, что даёт дисциплина, — два правила разговора. Спрашивать о конкретном прошлом человека. И засчитывать обязательство — потраченное время, репутацию, деньги; комплимент обязательством не является.
Пример. «Заплатили бы вы двадцать долларов в месяц» — плохой вопрос: человек отвечает про воображаемое будущее и из вежливости говорит «да». «Сколько вы платите сегодня за ближайший аналог» — хороший: он про факт, и соврать на него из вежливости трудно. Отсюда название свода этих правил — «Тест мамы», Роб Фитцпатрик: вопрос верен, если даже собственная мама не сможет соврать из вежливости.
Место дисциплины относительно петли. Петля отвечает на вопрос «как быстро проверять», развитие клиента — на вопрос «что и у кого проверять». Работает оно на первой стрелке, до того как построено хоть что-нибудь.»
Источники: [1] Blank — Customer Development (Four Steps to the Epiphany)
08 · Что ИИ изменил в исследовании
«Что с этой фазой сделал ИИ к 2026 году. Он забрал три шага, и я пройду их сравнением.
Кабинетный поиск — собрать, что уже известно о рынке и о боли. Без ИИ аналитик читает отчёты, публикации и форумы, это дни работы. С ИИ режим глубокого исследования сам планирует поиск, читает сотни источников и отдаёт отчёт со ссылками за время от двух минут до получаса. Такой режим есть у всех основных помощников, включая бесплатные тарифы.
Сам разговор. Без ИИ каждое интервью исследователь проводит лично, и восемь разговоров — это недели календаря. С ИИ вопросы задаёт модель, а отвечает живой человек, и за тот же срок разговоров получается кратно больше.
Сведение разговоров. Без ИИ расшифровка идёт вручную, темы выписываются глазами. С ИИ расшифровка стала бесплатным приложением к созвону, а инструменты пересобирают темы по всему накопленному корпусу, не по одному звонку.
Полезна шкала «кто на том конце разговора». Человек с человеком — классическое интервью. Человек с моделью — спрашивает машина, отвечает живой человек. Третье положение: модель с моделью, ИИ-персона — отвечает тоже машина, живого человека в цепочке нет ни разу. Опрос ста пятидесяти исследователей в мае 2026 года: восемьдесят один процент применяют ИИ в работе регулярно, восемь процентов — вот в этой третьей роли, отвечающего участника, и двадцать восемь процентов отвергают такое применение прямо.
Что не изменилось. Ссылка в отчёте не доказательство, пока её не открыли. Измерено на пятидесяти трёх тысячах девяноста ссылках из отчётов десяти моделей: от трёх до тринадцати процентов выдуманы — таких источников не существовало никогда. По нижней границе, три процента, отчёт на пятьдесят ссылок содержит хотя бы одну выдуманную с вероятностью семьдесят восемь процентов. Именно такой отчёт Deloitte сдала правительству Австралии за четыреста сорок тысяч австралийских долларов.»
Источники: [1] Perplexity — обзор режима глубокого исследования · [2] User Interviews — «State of Synthetic Users», май 2026 · [3] arXiv 2604.03173 — измерение ссылок в отчётах агентов · [4] Fortu
09 · Практика: репетиция вопросов на ИИ-персонах
«Первая практика фазы. Перед выходом к живым людям список вопросов прогоняют через несколько выдуманных собеседников, которых играет модель. Цель — поймать плохие вопросы до того, как они испортят настоящий разговор. Это репетиция; исследованием она не является.
Механизм, четыре шага.
Шаг первый: описывают несколько типов клиента — по тому, как человек живёт с задачей: чем пользуется сейчас, во что это ему обходится, что однажды попробовал и бросил. Портрет вида «тридцать пять лет, руководитель среднего звена» бесполезен, из него не выводится ни один ответ.
Шаг второй: каждый тип держат отдельным прогоном. Сложенные в один запрос, они усредняются в одного собеседника.
Шаг третий: через всех прогоняют один и тот же список вопросов.
Шаг четвёртый, ради которого всё делалось. Читают две вещи. Вопрос, на который все ответили одинаково, никого не различает. Вопрос, на который отвечают про воображаемое будущее, подталкивает к вежливой выдумке. Оба переписывают. Наружу из прогона выходит правленый список вопросов — и больше ничего.
Что изменил ИИ. Репетировали всегда: проговаривали список на коллеге либо тратили одно живое интервью из восьми — один взгляд и день работы. Теперь репетиция занимает минуты, и прогонов можно сделать десяток. Подешевела при этом только репетиция. Само интервью с живым человеком не заменяется ничем.
Где практика ломается. Ответы выдуманных собеседников данными о пользователях не являются: модель одна, и пять собеседников — пять взглядов одной модели. При сверке с настоящим национальным опросом средние ответы она повторяет неплохо, а разброс мнений занижает вдвое — шестнадцать против тридцати одного. Несогласие и крайние позиции она и съедает.
Признак, по которому видно, что практику запустили неправильно: из прогона вынесли вывод о продукте. Правильный выход — вывод о формулировке вопроса.»
10 · Практика: поиск боли по накопленным обращениям
«Вторая практика, применимая там, где у продукта уже есть пользователи, а значит и архив их жалоб. Обращения складывают в поисковый массив, собирают похожие по смыслу в группы и смотрят, какие темы повторяются. Наружу выходит названная тема боли с дословными цитатами.
Механизм, три шага.
Шаг первый: каждое обращение кладут в общий массив с пометками, когда пришло, от кого и по какому продукту. Без них архив остаётся мешком текста, по которому не сказать даже, стало хуже или лучше.
Шаг второй: ищут двумя способами сразу — по точному совпадению слов и по смыслу, потому что ловят они разное. Код ошибки находится только совпадением, проблема, описанная своими словами, — только по смыслу.
Шаг третий: похожее собирают в группы и пересказывают в два приёма — сначала каждое обращение отдельно, потом общее между ними. Пропуск первого приёма стоит от двадцати до сорока процентов деталей; поэтому пересказ «всех обращений сразу» выходит гладким и бессодержательным.
Что изменил ИИ. Раньше обращения раскладывали по заранее придуманному списку тем и находили только то, что кто-то уже предположил. Теперь похожее собирается само, без списка, а пересказ группы делается за минуты. Название темы проверяет человек: машина группирует, решение за ним.
Где практика ломается, три ограничения.
Первое: архив смещён по построению. В нём есть только те, кто дошёл до жалобы. Объём этого не лечит — не бывает обращения «мне нужно то, чего у вас вообще нет». Значит, на вопрос «почему люди не доходят до регистрации» архив не отвечает; нужен разговор с теми, кто ушёл.
Второе: поиск возвращает похожие обращения, а важность он не измеряет. Десять тысяч жалоб на одну опечатку — по-прежнему одна опечатка.
Третье: гипотезу, выросшую из архива, всё равно проверяют разговором. Архив говорит, где искать, и молчит о том, чего в продукте нет.»
11 · Граница фазы: несогласие не производится
«Граница фазы, и она жёстче, чем кажется по двум предыдущим слайдам. Синтетический собеседник не может произвести несогласие — это свойство конструкции, и у него есть замер.
Исследователи Anthropic прогнали пять языковых моделей и измерили, как часто тон ответа сдвигается к позитиву. Когда собеседник явно соглашается — от семидесяти двух до девяноста одного процента случаев. Когда собеседник явно возражает — от семи до двадцати восьми. Мринанк Шарма и соавторы, 2023 год.
Читать их надо аккуратно. Измерен здесь сдвиг тона: собеседник возразил, и модель поехала за ним, хотя данных у неё не прибавилось. Частоту положительного ответа эти числа не описывают. Назовём явление зеркалом согласия.
Отсюда три положения, в которых живой разговор строго сильнее синтеза. Первое: высока цена ошибки в решении «продолжать или остановить». Второе: нужно реальное прошлое человека, и правдоподобное его не заменяет. Третье: нужна проверка обязательством.
Причина у всех трёх одна: у синтетического собеседника нет реального прошлого, способного противоречить формулировке вопроса. Живой человек возражает, потому что в его прошлом есть не укладывающийся в вопрос факт. Модели возражать нечем.»
Источники: [1] Тереза Торрес, консультант по продуктовому исследованию — книга «Continuous Discovery Habits» и её позиция о синтетике
12 · Провал: панель ИИ-персон против живых участников
«Первый разбор провала этой фазы.
Nielsen Norman Group — исследовательская группа, которая с 1998 года занимается удобством интерфейсов. Они взяли один сценарий первого знакомства с продуктом и прогнали его дважды: с живыми участниками и с панелью ИИ-персон, сгенерированных под тот же профиль пользователя. Замеряли две величины: сколько шагов сценария доведено до конца и как оценены одни и те же функции.
Живые участники в среднем дошли до конца в трёх шагах из семи. Панель ИИ-персон отчиталась о семи из семи.
Одну и ту же функцию живые участники назвали надуманной и бесполезной. Панель назвала её изменяющей правила игры.
Разбор. Расхождение здесь сразу в обеих величинах, на одном и том же материале. Разойдись одна — можно было бы говорить о неудачном прогоне и запустить ещё раз. Разошлись обе, и значит такой выход дисквалифицирован для решения «продолжать или остановить» по построению. Повторный прогон этого не исправит.
Механизм известен с предыдущего слайда. ИИ-персона проходит сценарий до конца, потому что у неё нет тела, сбивающего контекста и права устать: бросать на третьем шаге ей нечем. И функцию она хвалит по той же причине, по которой соглашается с возражающим собеседником.
Критерий, который переносится дальше. У панели остаётся до-исследовательская роль: отрепетировать вопросы, набросать варианты сценария. Решение о продукте опирают на тест с пятью-восемью живыми участниками — замеренный размер, при котором вскрывается большинство проблем удобства.»
Источники: [1] Nielsen Norman Group — «Synthetic Users»
13 · Провал: Humane AI Pin
«Второй разбор фазы: здесь провалена сама фаза изучения пользователей.
Humane — компания, основанная в 2018 году выходцами из Apple. Её единственный продукт, AI Pin, — носимый прибор без экрана: коробочка на одежде с камерой, микрофоном и лазерной проекцией на ладонь, отвечающая голосом. Замысел: человек перестаёт смотреть в телефон. Прибор показали в ноябре 2023 года, продажи открыли в апреле 2024-го — шестьсот девяносто девять долларов плюс двадцать четыре доллара в месяц.
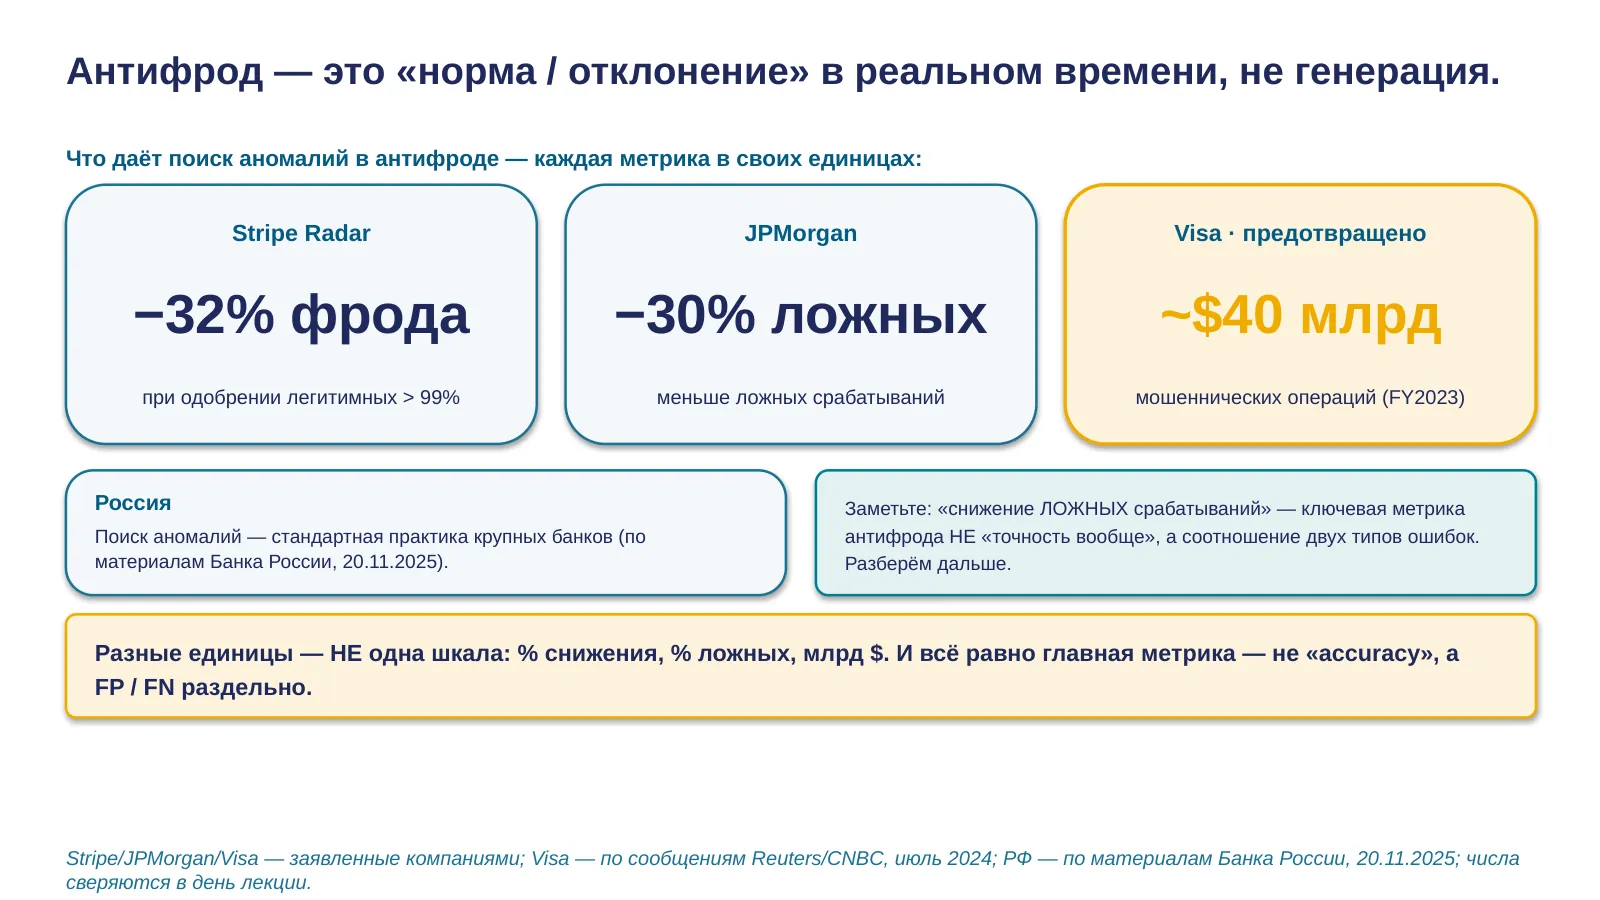
Числа, каждое со своей базой. Продано около десяти тысяч приборов против собственной цели компании на тот же год — сто тысяч, то есть десятая часть запланированного. Выручка около девяти миллионов долларов против двухсот тридцати миллионов привлечённых инвестиций — около четырёх процентов.
С мая по август 2024 года возвратов было больше, чем покупок: к августу на руках у людей оставалось ближе к семи тысячам приборов из десяти тысяч проданных. Цену снизили с шестисот девяноста девяти долларов до четырёхсот девяноста девяти через полгода после начала продаж. В феврале 2025 года активы купила HP за сто шестнадцать миллионов, а через десять дней облачный сервис погасили: приборы на руках у покупателей отвечать перестали. От открытия продаж до этого дня прошло десять с половиной месяцев.
Чего не выяснили до сборки. Вопрос фазы исследования звучит одной фразой: по сравнению с чем. У каждого покупателя в кармане уже лежал телефон, который делает то же самое и остальное сверху, и обзоры сошлись на том, что прибор делает меньше телефона и делает это медленнее. Такой ответ стоит восьми разговоров с живыми людьми до сборки. Здесь его получили от рынка.
Контрфактуал: прибор работоспособен, промах лежит в ответе на вопрос, кому он нужен. Google Glass прошёл тот же путь в обратную сторону — очки за полторы тысячи долларов сняли с широкой продажи в январе 2015 года, а потом отдали человеку, у которого руки заняты работой. У AGCO, производителя сельхозтехники, время сборки машин упало на двадцать пять процентов, время контроля — на тридцать; у логистической компании DHL выработка на складе выросла на пятнадцать. База во всех трёх случаях — та же работа тех же людей без очков. Прибор тот же. Пользователь другой.
Критерий, который переносится дальше: гипотезу о пользователе закрывают сравнением с тем, чем человек обходится сегодня.»
Источники: [1] 9to5Mac (7 авг. 2024) — внутренние данные продаж Humane · [2] TechCrunch (18 фев. 2025) — активы Humane купила HP · [3] Humane Inc. — даты, цены и цель продаж · [4] Digital Tr
14 · Дивайдер Раздела 2
«Раздел второй. Дизайн: гипотеза становится артефактом. Одна база, одна практика, один разбор провала.
Это шаг, на котором гипотезу впервые показывают живому человеку — пока она стоит дёшево и её не жалко выбросить.»
15 · Что входит в слово «дизайн»
«Сначала об объёме понятия, иначе весь раздел прочитается узко.
Экран — одна из поверхностей, через которые человек встречается с системой. Дизайн этой фазы решает весь состав встречи: где система попадается человеку, как ведёт себя со временем, и что делает в ту минуту, когда сама не уверена в ответе. У продукта с языковой моделью работы на остальных поверхностях обычно больше, чем на экране.
Поверхностей шесть.
Экран — что человек видит и в каком порядке. Голос — то же решение без картинки: порядок, длина, право перебить. Уведомление — система начинает разговор сама: когда и по какому поводу. Письмо или отчёт — ответ, который читают, когда системы под рукой нет. Отказ — что система говорит, когда делать не станет. Молчание — обработка идёт, ответа ещё нет, и человек эту минуту на что-то смотрит.
Дальше поведение системы во времени, три состояния. Уверена — отвечает и показывает, на чём ответ построен. Не уверена — говорит об этом от первого лица и предлагает ход дальше. Ошиблась — человек видит, что произошло, и у него есть путь назад.
И слой решений, которые принимают один раз, а живут они дольше любой вёрстки: имя продукта, обещание на входе, право остановиться. Имя задаёт картину системы в голове раньше, чем человек увидит первый экран. Правка этой картины обходится в отзыв всего парка — ровно этот случай мы разберём в конце раздела.»
16 · Классика: двойной ромб
«Зачем нужен отдельный шаг дизайна — через цену.
Ошибку нашли на черновике — переделать набросок стоит часов работы одного человека; черновик для того и делают, его не жалко выбросить целиком. Ту же ошибку нашли после выпуска — переделывать придётся работающий продукт: недели работы команды плюс ушедшие пользователи. Пропуск этого шага даёт экономию на часах и расход на неделях.
Метод называется двойной ромб. Ромб — один цикл работы: расширяем набор вариантов, потом сводим их к одному. Ромбов два, потому что выбирают дважды. В первом выбирают задачу: какую задачу мы вообще решаем. Во втором — решение: каким способом её закрываем. Это увеличительное стекло на шаге «Дизайн» нашей петли, отдельной второй петлёй двойной ромб не является.
Поверх сведённого варианта работает проверка — десять эвристик Якоба Нильсена, 1994 год: короткий список правил удобства, по которому знающий человек за полчаса проходит готовый вариант и отвечает на недоступный машине вопрос — понятно ли это живому человеку. Стадией процесса эвристики не являются.
Частая ошибка инженера: сойтись на решении, не проверив задачу, — перепрыгнуть первый ромб. Тот же образ действия, что «сразу писать код», минуя вопрос, ту ли задачу мы решаем. Оба ромба работают по всей встрече человека с системой: по экрану, по голосу, по поведению в неуверенности.»
Источники: [1] Совет по дизайну Великобритании — двойной ромб · [2] Якоб Нильсен — десять эвристик удобства
17 · Что ИИ изменил в дизайне
«Что машина делает сама: четыре непохожие раскладки одного экрана за минуты. Дальше человек выбирает направление, отбрасывает остальные и правит то, что модель поняла неверно: отступы, порядок важности, редкие случаи.
Чем это делают в 2026 году. Figma Make собирает экраны внутри редактора макетов и берёт собственные детали команды вместо общих заготовок. Google Stitch делает экран из текста и набросков; бесплатный, с марта 2026 года переносит макеты из Figma и отдаёт код. v0 отдаёт сразу готовый код интерфейса. Lovable и bolt.new — работающее приложение целиком из описания. Magic Patterns — быстрый перебор вариантов одного экрана.
Теперь замер вместо обещания. Сто участников — пятьдесят дизайнеров и пятьдесят продуктовых руководителей — случайно поделены на две группы: одной дали генератор, второй не дали. Три одинаковые задачи на правку интерфейса, сентябрь 2026 года.
Общее время сократилось примерно на двадцать процентов относительно группы без генератора. У продуктовых руководителей выигрыш тридцать пять процентов. У профессиональных дизайнеров выигрыш обнаружился только на труднейшей из трёх задач — двадцать шесть процентов; общий эффект у них пограничный, семнадцать.
Обещание «день ручного черчения превращается в минуты» этот замер не подтверждает: выигрыш реален, измеряется десятками процентов и зависит от того, кто работает и насколько трудна задача. Опыт поставила сама Figma на собственном инструменте — поправку на интерес автора держим в уме.
Машина расширяет набор вариантов. Свести их к одному — решение о пользователях и ограничениях продукта, которых в обучающих данных нет. И генератор закрывает экран: поверхности контакта, поведение системы и ответ в неуверенности остаются за человеком.»
Источники: [1] Figma — обзор инструментов дизайна с ИИ, 2026 · [2] Google Stitch (бывший Galileo AI) · [3] Стюарт и соавторы — рандомизированный опыт, arXiv:2609.26725 (22 сент. 2026)
18 · Практика: три слоя дизайн-системы
«Практика фазы. Дизайн-система — общий свод правил интерфейса продукта и набор готовых деталей к нему: допустимые сочетания цветов, размеры кнопок и полей, вид элемента под курсором. Раньше это был документ для людей. Сейчас часть правил можно записать так, чтобы читала и проверяла их машина.
Механизм складывается из трёх слоёв, каждый следующий сильнее предыдущего.
Слой первый: правила, записанные числами. Пока правило живёт в картинке макета, проверить его может только человек и только глазами; записанное числом — отступ в пикселях, минимальный контраст — читается машиной.
Слой второй: свои детали вместо заготовок. Это снижает вероятность нарушения и ничего не гарантирует: генератор возьмёт деталь и поставит её в неправильном месте.
Слой третий: проверка, останавливающая выпуск. Правило проверяют автоматически на каждом сгенерированном экране, и нарушение блокируют. Гарантию даёт только этот слой.
Что изменил ИИ. Свод правил для людей был и раньше, дизайнер проверял его глазами, и это держало продукт единообразным. Теперь генератор выдаёт экраны быстрее, чем их успевает смотреть человек, и машинная проверка растёт вместе с генерацией.
Где практика ломается, три ограничения. Машина проверяет только то, что выражается числом: «понятно ли это живому человеку» остаётся человеку, и экран может пройти все проверки и остаться непонятным. Второе существеннее: просьба к генератору механизмом контроля не является — «соблюдай нашу дизайн-систему» в запросе это пожелание, а механизм умеет остановить выпуск. Третье: проверка смотрит экран, поведение системы во времени числом не выражается и ею не покрывается — то есть большая часть объёма понятия «дизайн» здесь не покрыта вовсе.»
19 · Граница фазы: доступность и неповторяемость ответа
«Граница фазы измерена, и число неприятное. Сначала о том, что проверяли. Правила доступности веб-содержимого — по-английски WCAG, Web Content Accessibility Guidelines — международный свод требований к интерфейсу: хватает ли контраста между текстом и фоном, не передан ли смысл одним лишь цветом, работает ли всё без мыши, подписаны ли поля. Исследователи прогнали двадцать одну тысячу восемьсот восемьдесят таких проверок на экранах, сгенерированных инструментами с прошлого слайда. Пройдено двадцать девять процентов. Хуже всего прошло простое и машинно-проверяемое: контраст — двадцать шесть целых восемь десятых процента, использование цвета — девятнадцать целых две десятых.
И находка, закрывающая удобное оправдание: на итог сильнее влияли настройки платформы, чем текст запроса. «Надо было правильно попросить» здесь не работает — переписывание формулировки доступным результат не делает.
Второе ограничение фазы — неповторяемость: один и тот же запрос даёт разные ответы. Из десяти эвристик Нильсена на этом ломаются две.
Четвёртая, единообразие и стандарты: классика исходит из того, что одинаковое действие даёт одинаковый результат. У языковой модели это неверно, и единообразие приходится переносить с точных слов на тон и поведение.
Девятая, помощь в распознавании ошибки: классика требует, чтобы система показывала, что пошло не так. Модель обычно не знает, что неправа, и подаёт выдумку с той же уверенностью, что и факт.
Отсюда три приёма подачи, которых в классике нет. Система говорит о неуверенности от первого лица, не общей оговоркой мелким шрифтом. Человек стоит в контуре решения там, где у ошибки есть настоящая цена. И прямо сказано, что ответ сгенерирован. Все три — решения о поведении системы, на макете экрана их не видно.»
Источники: [1] Web4All 2026 — «Generated Inaccessible»
20 · Провал: отзыв Tesla 23V-838
«Разбор провала фазы: два миллиона тридцать одна тысяча двести двадцать машин — весь парк, выпущенный с 2012 года.
Autopilot — набор функций помощи водителю в машинах Tesla: держит полосу, скорость и дистанцию, пока человек следит за дорогой и держит руки на руле.
В августе 2021 года Национальное управление безопасности дорожного движения Соединённых Штатов Америки, сокращённо NHTSA, открыло расследование: машины с включённым Autopilot врезались в стоящие на дороге автомобили спецслужб. Двенадцатого декабря 2023 года Tesla отозвала весь этот парк. В отчёте о дефекте компания записала своими словами: заметность и охват элементов управления системы могут быть недостаточны, чтобы предотвратить неверное применение водителем.
За время расследования, с августа 2021 по декабрь 2023 года, набралось не менее тринадцати аварий с погибшими, где свою роль сыграло предсказуемое неверное применение. Картина системы в голове водителя расходилась с тем, что система делала; у этой ошибки есть имя — путаница режимов.
Теперь существенное для нашего раздела. Отзыв не затронул ни одной строки модели вождения. Исправляли то, как система себя предъявляет: заметность предупреждений, частоту проверок внимания, порог, за которым функция отключается. Проверкой модели такую ошибку не поймать — модель вела себя как заявлено.
Имя «Autopilot» — решение того же слоя: оно задаёт картину раньше первого предупреждения, и слово обещает автономность, которой у функции нет.
По времени: расследование открыто в августе 2021-го, отзыв — через два года и четыре месяца, и всё это время парк ездил с заданной ему картиной. Обновление по воздуху — декабрь 2023-го. Проверку устранения ведомство открыло в апреле 2024 года: за первые четыре месяца после обновления набралось не менее двадцати аварий с предполагаемым участием системы.
Критерий отсюда. Часть мер водитель включает своим согласием и так же отключает, а мера, которую человек может выключить, остаётся просьбой. Механизмом её делает способность остановить действие.»
Источники: [1] NHTSA — отчёт об отзыве 23V-838 (12 дек. 2023) · [2] NHTSA — закрытие расследования EA22-002 · [3] NHTSA — проверка устранения RQ24-009 (25 апр. 2024)
21 · Дивайдер Раздела 3
«Раздел третий. Сборка и запуск: довести продукт до пользователя, пока ошибка ещё обратима. Три приёма, два разобранных случая.
Без дисциплины запуска у сбоя два исхода, и оба плохие. Продукт застревает в бесконечном пилоте, и гипотеза не проверяется. Либо выходит сразу на всех, и редкий сбой становится кризисом за один день.»
22 · Классика: право учиться дёшево и право честно закончить
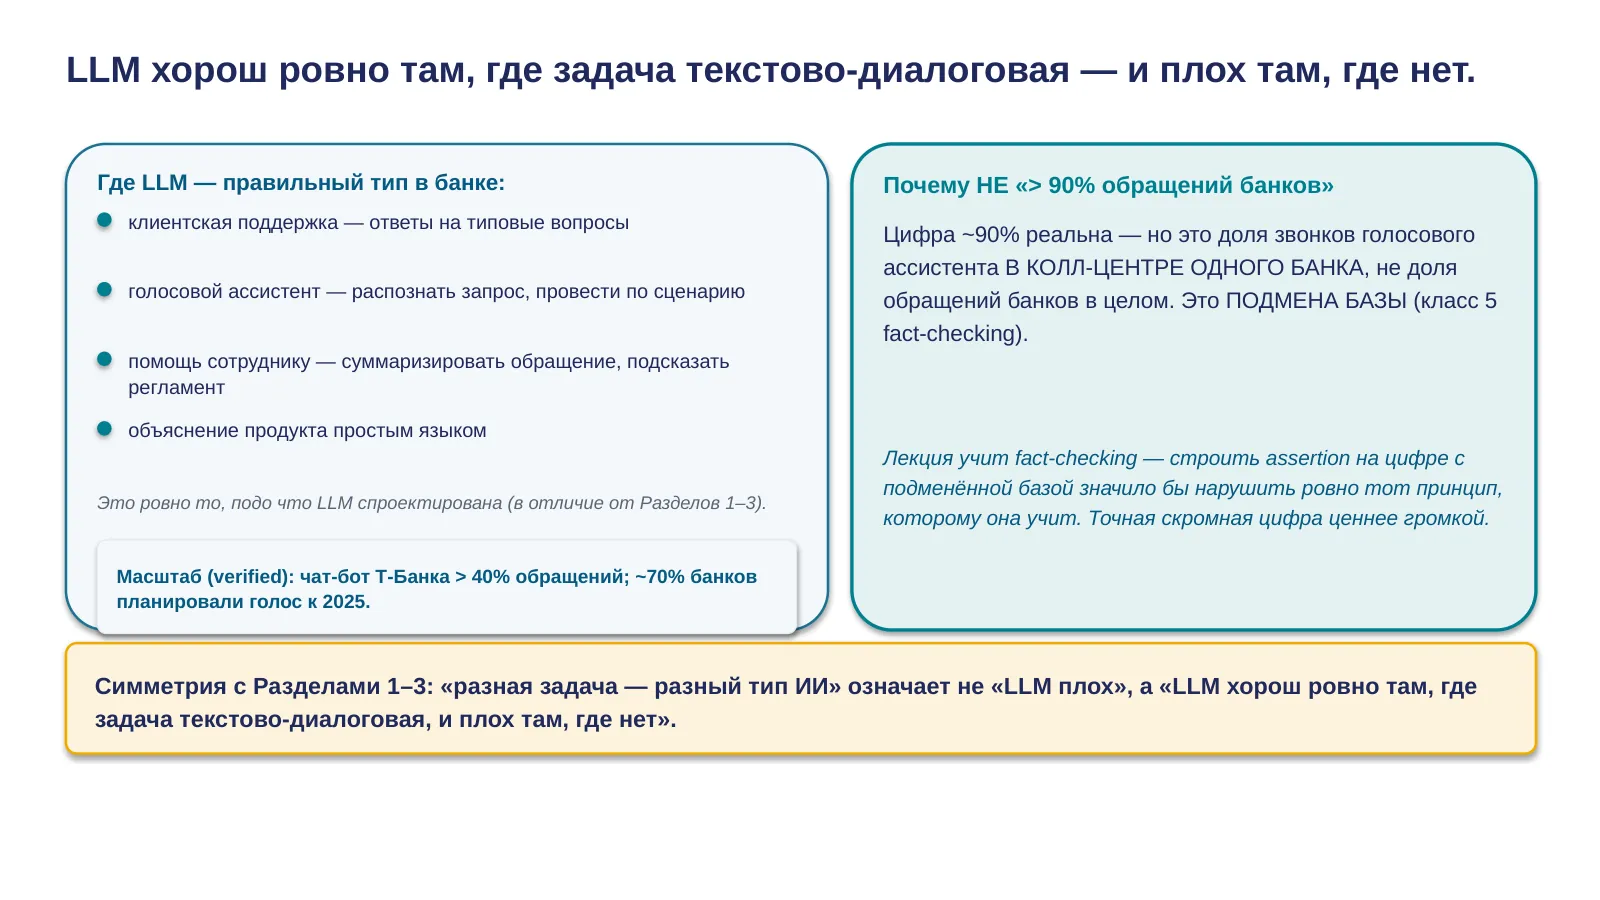
«Задача фазы — довести продукт до пользователя так, чтобы ошибка осталась обратимой.
Это единственное место цикла, где команда сама назначает, каким кругом людей и в каком темпе проверяется продукт, пока ошибка дешёвая. Опор две.
Первая — минимально жизнеспособный продукт: Эрик Райс, «Бережливый стартап», 2011 год. Первая версия существует ради обучения и планируется в обратном порядке: сначала чему надо научиться, потом какой меркой это различить, и только потом что собрать.
Вторая — рубеж «продолжать или закрыть»: Stage-Gate, Роберт Купер, исследователь новых продуктов, 1990 год. Вложение растёт только после пройденного рубежа, и дешёвая ранняя стадия существует затем, чтобы отсеивать до крупных трат.
Про механику раскатки скажу коротко, инженер её знает: переключатель функции, канареечный выпуск, поэтапное включение, возврат к прошлой версии — всё это из непрерывной интеграции и поставки, CI/CD. Новое здесь в том, чьё решение они обслуживают. Они обслуживают решение «продолжать вкладываться или закрыть».
И то, что держит всю фазу: порог записывают числом до старта. Иначе нельзя отличить «данные сказали нет» от «мы устали ждать», и у команды нет права честно закончить.
Якорь — проект Foghorn в лаборатории X, топливо из морской воды. Порог назначили числом до начала работ: восемь долларов за галлон бензинового эквивалента. Через два года модели стоимости дали от восьми до шестнадцати долларов, а дешёвый водород требовал ещё пяти лет исследований. В январе 2016 года проект закрыли, результаты опубликовали, команде выплатили премию. Записанное заранее число и дало право закончить.»
Источники: [1] Эрик Райс — «The Lean Startup» (2011) · [2] Stage-Gate — история метода · [3] X — проект Foghorn
23 · Что ИИ изменил в сборке
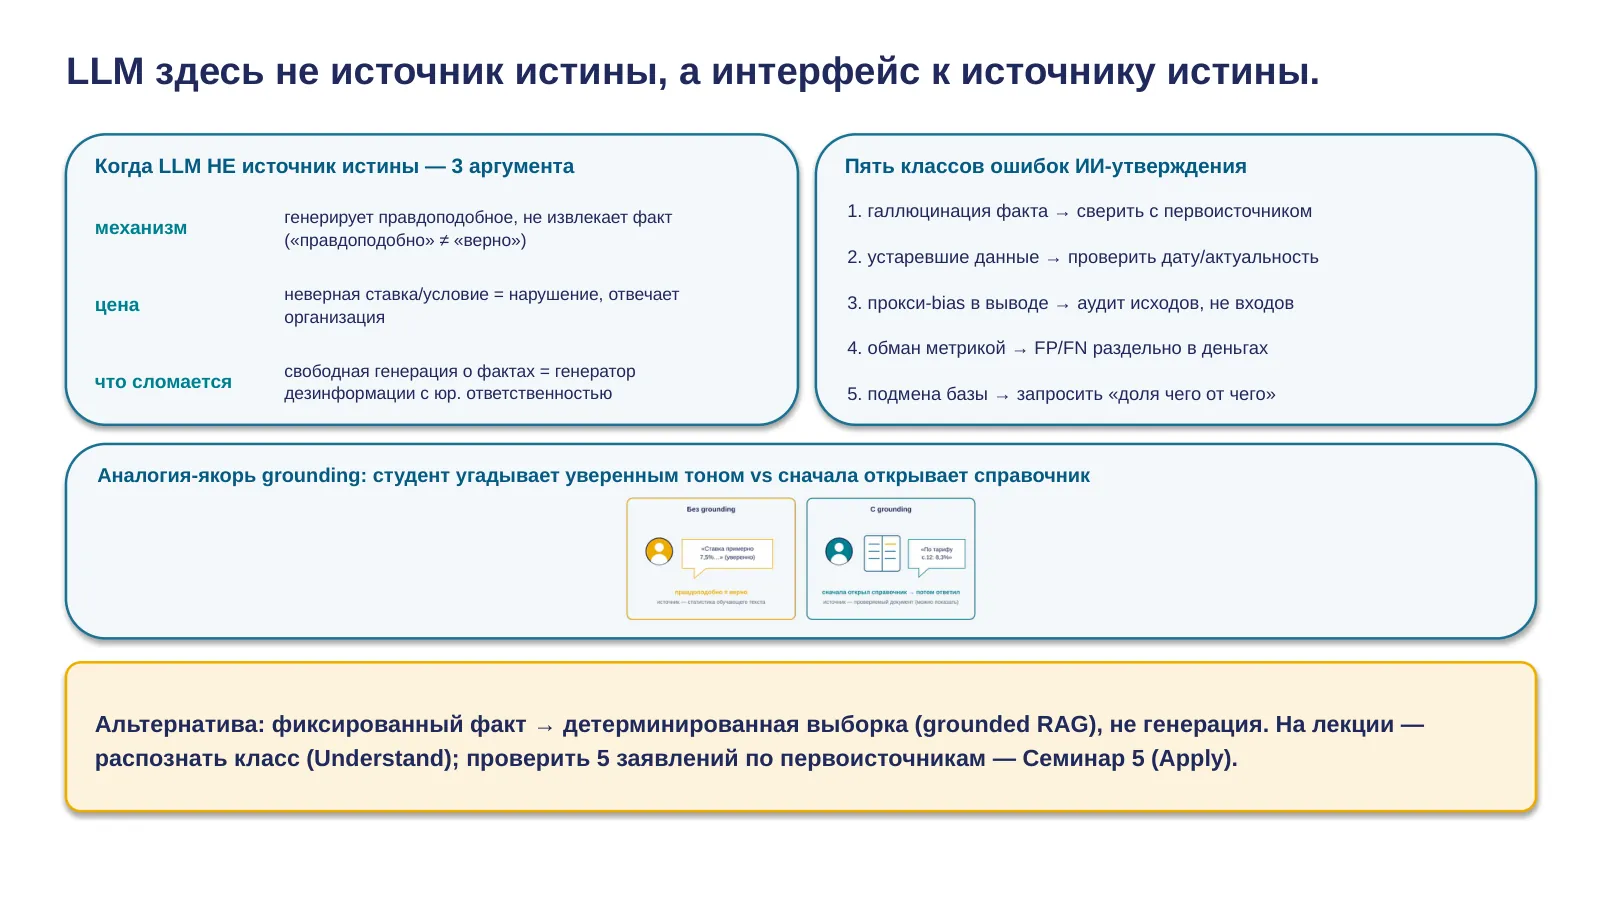
«Писать код стало дёшево. Проверять — нет. К узкому месту на входе добавилось ревью, и это измерено на нескольких независимых выборках 2026 года.
Четыре числа, каждое с базой.
Объём кода на инженера вырос на двести процентов за год — втрое к тому же показателю годом раньше. Измерение Anthropic.
Доля изменений с содержательным ревью до слияния: было шестнадцать процентов, стало пятьдесят четыре. Порядок важен, поэтому повторю: шестнадцать — это до того, как первый проход ревью отдали автоматике, пятьдесят четыре — после. Доля выросла больше чем втрое, и почти половина изменений по-прежнему идёт без содержательного ревью.
Медианное время, которое изменение проводит в ревью, выросло на четыреста сорок один процент относительно прошлого года. Faros AI, телеметрия двадцати двух тысяч разработчиков.
Изменения от ИИ примерно в два с половиной раза крупнее обычных и ждут ревьюера примерно в пять раз дольше. LinearB, восемь целых одна десятая миллиона запросов на слияние.
Теперь сопоставление практик: что делали без ИИ и что добавилось.
Ревью изменений перед слиянием делали всегда. Оно же стало узким местом. И здесь предупреждение из Лекции 4: передать слияние агенту — значит снять единственный контроль. Узкое место так не расшивают, его удаляют вместе с заслоном.
Переключатель функции был. Теперь он переключает ещё и уровень самостоятельности: сколько система решает сама.
Поэтапная раскатка по доле пользователей была. Теперь раскатывают по двум осям: доля аудитории и уровень самостоятельности.
Тест как исполняемая спецификация и гейт прогона — это тоже из Лекции 4. Добавился гейт по доле убитых мутантов: он проверяет, что тест вообще способен поймать дефект.
Аварийное отключение нужно всегда: сбой расходится быстрее, чем его успевают заметить.
И спецификация, которой владеет человек — единственный вход, который агент не может придумать себе сам.
Дефицитны края работы: точность задачи на входе и скорость суждения на выходе. Лекция 4 назвала первым узким местом точность намерения на входе; ревью к нему добавилось, место его не заняло.»
Источники: [1] Anthropic — Code Review for Claude Code (9 марта 2026)
24 · Практика: шкала самостоятельности
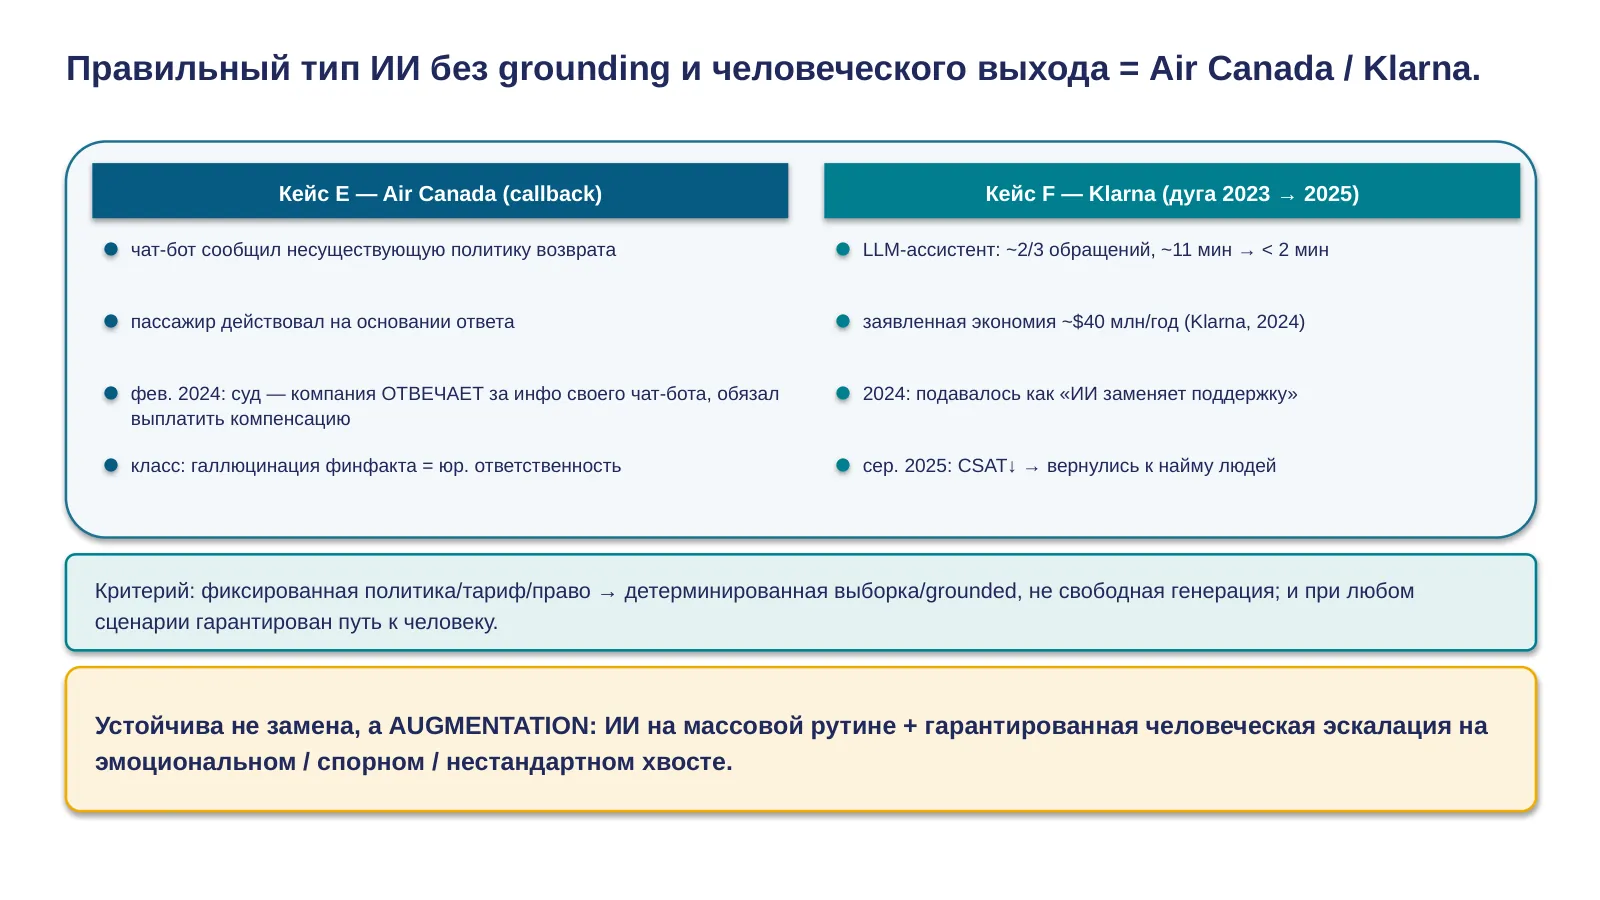
«Первый приём фазы. Функцию выпускают уровнями самостоятельности: подсказка, потом предложение, которое подтверждает человек, потом самостоятельное решение. Версия здесь означает уровень самостоятельности, который система заслужила.
Механизм, четыре пункта.
Первый: каждый уровень — отдельный выпуск, со своим кругом пользователей, своим набором наблюдаемых признаков, своим способом остановиться.
Второй: подъём открывают доказательством, записанным числом до прогона, — система справляется с теми случаями, которые доверяет ей новый уровень. Календарь основанием не считается.
Третий: доказательство держится при повторных попытках. Однократный успех его не даёт: у вероятностной системы один удачный прогон случается сам.
Четвёртый: заранее описано, как вернуть систему на уровень ниже — кто решает, по какому признаку и за какое время.
Что изменил ИИ. Права по частям выдают давно: новичку сначала дают смотреть, потом предлагать, потом решать самому, и уровень держится на стаже без нареканий. Система стажа не набирает, поэтому уровень подтверждают измерением.
На замере это выглядит так. Meta двинула порог риска, при котором изменение сливается без человека, с двадцать пятого процентиля на пятидесятый. Автоматически одобряются шестьдесят целых тридцать одна сотая процента изменений. База для сравнения — обычный путь через человека на той же выборке: откаты на автоматическом пути втрое реже, сбои в промышленной эксплуатации в пятьдесят раз реже. Выборка — пятьсот тридцать пять тысяч изменений.
Где приём ломается, три ограничения. «Оператор давно ничего не правил» доказательством не является: отсутствие замечаний — это отсутствие измерения. Второе объясняет числа Meta: автоматическое одобрение там держится на детерминированной проверке в конце цепочки, а слияние по вердикту ИИ-ревьюера снимает единственный контроль, и числа получаются другие. Третье: необратимое и дорогое не поднимают на верхний уровень никогда — обязывающее предложение клиенту, удаление рабочих данных, выпуск сразу на всех остаются за жёстким правилом поверх модели.»
25 · Практика: мутационные тесты вокруг ИИ
«Второй приём, прямое продолжение Лекции 4.
Мутационное тестирование: в код намеренно вносят мелкую ошибку — её называют мутантом — и смотрят, упадёт ли хоть одна проверка. Доля убитых мутантов говорит, способен ли набор проверок что-нибудь поймать; покрытие отвечает на более слабый вопрос — была ли строка затронута прогоном.
Новое здесь то, что тот же приём наводят на всё, чем ограничивают ИИ: на набор оценок, на файл инструкций агенту, на правило в конвейере.
Механизм, четыре шага. Назвать проверку, на которую вы полагаетесь, и класс ошибок, который она обязана ловить. Внести ошибку этого класса нарочно — одну, мелкую, в одном месте. Прогнать проверку: молчание значит, что проверки нет, она не отличает исправное от испорченного. И записать долю пойманного числом, повторяя замер после каждой правки проверки: проверки стареют молча.
Три примера приёма на трёх разных проверках. Модульные тесты — перевернуть условие. Набор оценок — подменить ответ на почти верный. Файл инструкций агенту — дать задачу, в которой нарушить правило короче, чем соблюсти.
Последний пример стоит числа. Правило, записанное только в запросе, соблюдено ноль раз из пятисот двадцати четырёх прогонов; с файлом инструкций — шестьдесят семь целых семь десятых процента. База — те же прогоны и та же задача, разница в наличии файла.
Что изменил ИИ в самом приёме. Раньше мутантов порождал список правил: перевернуть условие, сдвинуть границу, убрать вызов; прогон воспроизводим, инструменты есть под каждый язык — PIT, mutmut, Cosmic Ray, Stryker. Теперь мутантов пишет модель, и они ближе к настоящим ошибкам: находят семьдесят шесть с половиной процентов реальных дефектов против сорока четырёх целых двух десятых у списка правил, на выборке восемьсот пятьдесят один дефект. Плата — около трети сгенерированных мутантов не компилируется.
Где приём ломается. Часть дефектов он не видит по построению: из трёхсот пятидесяти семи реальных ошибок двадцать семь процентов не связаны ни с одним мутантом — неверные алгоритмы и код, который следовало удалить целиком. И доля убитых портится так же, как покрытие: поставьте по ней гейт, и начнут плодиться легко убиваемые мутанты, а обнаружение не вырастет.»
26 · Практика: поэтапная раскатка и путь назад
«Третий приём. Новое включают сначала узкому кругу и заранее договариваются, как всё вернуть обратно.
Формулировка, ради которой приём стоит слайда: радиус поражения — сколько людей пострадает, если новое окажется плохим, — это решение команды, и выясняться после запуска он не должен.
Механизм, три части.
Ступени: какие доли аудитории проходим и в каком порядке.
Признак остановки: что наблюдают на каждой ступени и какое ухудшение останавливает движение вперёд. Без названного заранее признака фраза «стало хуже» обсуждается бесконечно, и обсуждение выигрывает тот, кто громче.
Путь назад: кто принимает решение вернуться, за какое время это делается, и проверяли ли, что возврат вообще работает.
Что изменил ИИ. Поэтапная раскатка и откат придуманы задолго до него и устроены так же — изобретать заново нечего. Меняется скорость ступеней: обычную функцию видно по отказам и задержкам сразу, а ухудшение ответов проступает только на объёме. Поэтому на каждую ступень нужны часы наблюдения.
Где приём ломается: три ошибки, две из них противоположные.
Первая: раскатка ограничивает радиус и решение не заменяет. Долгий пилот на крошечной доле, который продолжает сбоить, означает потолок подхода; прочитать это как «нужно ещё немного данных» — ошибка.
Вторая, обратная: зрелость продукта не даёт права пропустить пилот, она повышает цену пропуска, потому что вся аудитория зрелого продукта — это сразу вся аудитория.
Третья: путь назад, который описан и ни разу не проверен, остаётся намерением. Путём назад он становится после первой проверки.»
27 · Граница фазы: проверка не растёт вместе с генерацией
«Граница фазы одной фразой: удвоенная скорость генерации удваивает очередь на проверку. Пропускная способность при этом остаётся прежней.
Механизм. В разработке есть две операции. Сделать правдоподобный результат — теперь секунды. Убедиться, что он верный, безопасный и делает именно то, что нужно, по-прежнему требует человеческого понимания в реальном времени, и оно не ускорилось.
Работа никуда не исчезла: вся её масса переехала на сторону, которая не подешевела. Ждать, что нехватка людей пройдёт сама, здесь бессмысленно.
Второе число фазы — разрыв семидесяти процентов. Инструмент доводит команду примерно на семьдесят процентов пути к рабочему результату; оставшиеся тридцать — приведение в поддерживаемый вид, ловля краевых случаев, инженерный опыт. И здесь документировано расхождение между людьми: опытный инженер переосмысливает и ограничивает результат модели, начинающий принимает его охотнее и отправляет дальше код, который выглядит завершённым и рассыпается под нагрузкой.
Выпуск без проверки на наборе примеров и без проверенного пути назад — отложенная цена, выдающая себя за скорость. Определение готовности обязано вобрать эти тридцать процентов, иначе оно молча сводится к «тесты прошли — значит готово».»
Источники: [1] Osmani — The 70% Problem
28 · Провал: Google AI Overviews
«Первый из двух случаев фазы, и он про пропущенный пилот на зрелом продукте.
Google встроил в поиск генеративные ответы: вместо списка ссылок вверху страницы стал появляться готовый ответ, составленный моделью по найденным страницам. Функцию включили сразу всем пользователям поиска в США, одним шагом, и отключить её пользователь не мог.
За несколько дней в ответах разошлись советы есть камни и добавлять в пиццу клей, чтобы сыр держался. Модель приняла за источники сатирическую статью и старую шутку с форума. Компания реагировала уже после: ограничила ответы на бессмысленные запросы, отфильтровала сатиру, приостановила ответы на темах о здоровье.
Сравним с тем, как раскатывают. Нормальный ход ступеней — один процент, десять, двадцать пять, пятьдесят, сто. Здесь пошли от нуля до ста одним шагом: пилотной ступени не было ни одной.
Разбор, три пункта. Модель не сломалась технически: она сделала то, что делает генеративная система — собрала правдоподобный ответ из корпуса, не отличив шутку от факта, и выдала его с уверенностью авторитетного источника. Это режим «уверенно неправильно», и ловится он наблюдением на живом трафике; тест проверяет заранее названные случаи, а этот класс сбоя живёт в случаях, которые никто не назвал. И зрелость основного продукта права пропустить пилот не даёт — она повышает цену пропуска.
На одном проценте трафика этот класс сбоя всплыл бы за дни во внутреннем наблюдении, и исправление обошлось бы в правку фильтра. Вместо этого — публичное осмеяние сразу на всей аудитории поиска одной страны.»
Источники: [1] Forbes (31 мая 2024) — Google AI Overviews · [2] AndroidPolice — «клей на пиццу» / «есть камни»
29 · Правильно пройденный рубеж: McDonald's и IBM
«Второй случай — зеркало первому. Здесь пилот прошли честно и вовремя прочитали сигнал.
С конца 2021 года сеть McDonald's вместе с корпорацией IBM испытывала приём заказов голосом у окна автораздачи: посетитель говорит заказ, распознаёт его система. Испытание держали примерно на ста ресторанах из почти тринадцати тысяч восьмисот в США — это ноль целых семь десятых процента сети — и продолжали два с половиной года. Всё это время в сеть попадали ролики со сбоями: бекон в мороженом, девять чаёв вместо одного, перепутанные заказы соседних полос. В июне 2024 года партнёрство прекратили.
Три вывода.
Первый — про знаменатель. «Сто ресторанов» без «из тринадцати тысяч восьмисот» читается как масштабное внедрение; со знаменателем — как узкая полоса, которую специально удерживали узкой. Одна цифра, два противоположных прочтения.
Второй — про потолок. Распознавание речи в шуме, с разными выговорами и посторонними голосами: такой потолок дополнительным временем не двигается. Длинный пилот на малой доле, продолжающий публично сбоить, означает потолок подхода. Нехватку данных он не означает.
Третий — про то, что именно закрыли. Закрыли технический путь, голосовая автоматизация осталась в планах. Это разные решения, и смешивать их дорого: закрыв вместе с путём и задачу, команда теряет то, ради чего два с половиной года собирала данные.»
Источники: [1] CNBC (17 июня 2024) — McDonald's × IBM · [2] Nation's Restaurant News — детали закрытия пилота
30 · Дивайдер Раздела 4
«Раздел четвёртый. Измерение: отличить «сработало» от «показалось». Одна база, две практики, два разбора провала.
Без измерения решение о продукте принимают по впечатлению, а цену узнают после запуска. Опрос более тысячи инженеров и специалистов по качеству, 2026 год: сорок четыре процента опрошенных команд выключали уже работавшие ИИ-функции, обнаружив, что расходы на них выше пользы. Почти половина сначала собрала и включила, и только потом посчитала.»
31 · Классика: две случайные группы
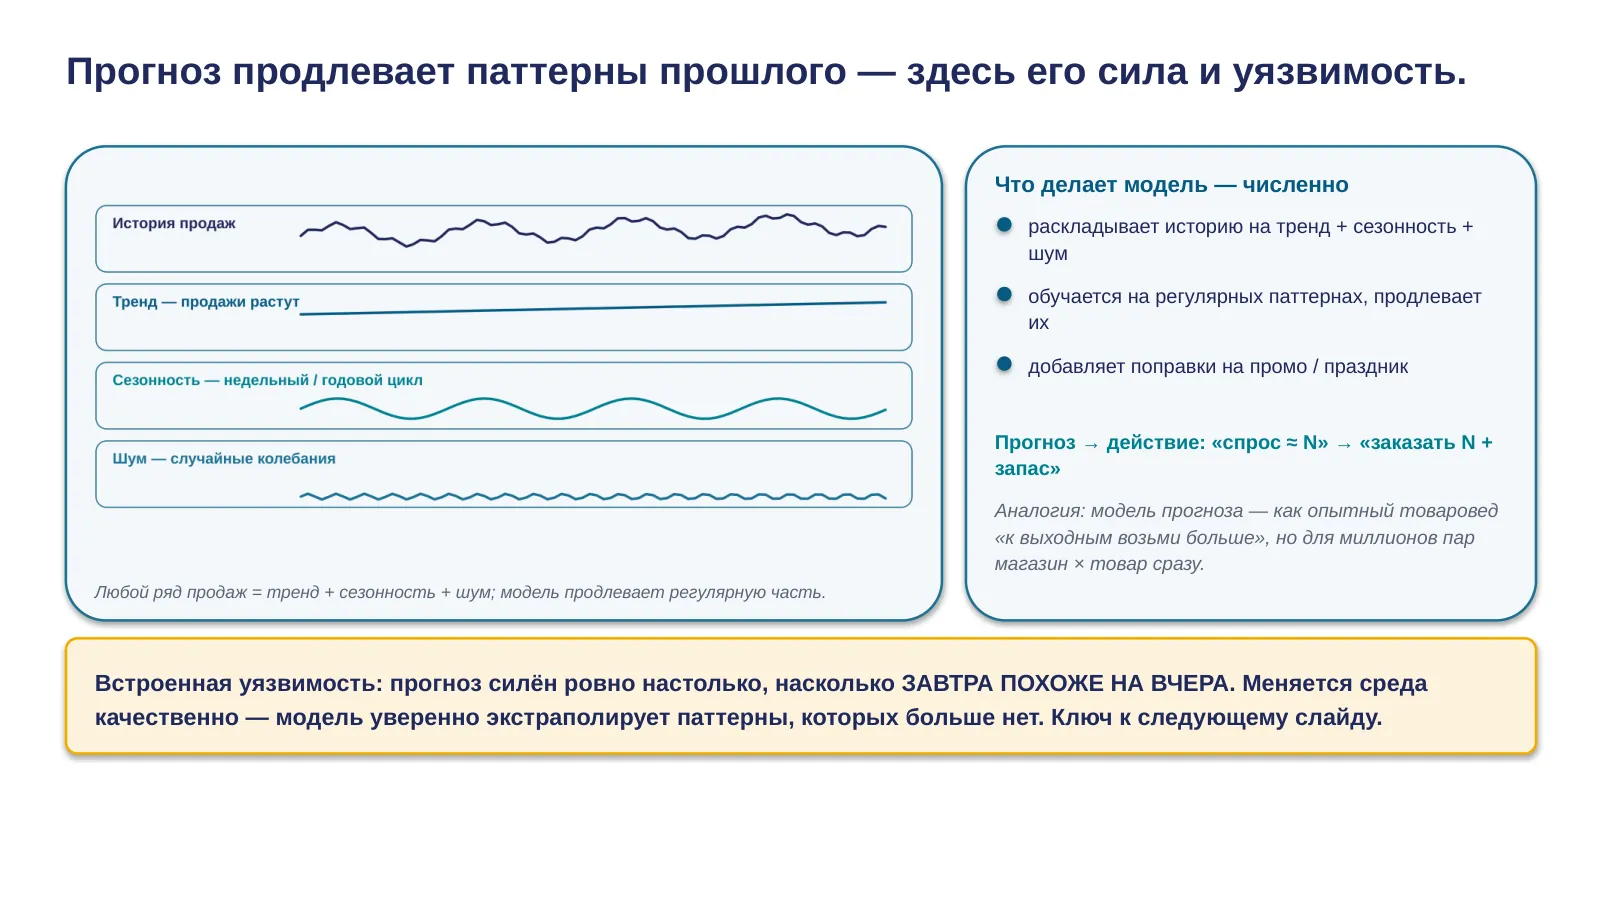
«База фазы — контролируемый эксперимент. Зачем он нужен: «метрика выросла после релиза» само по себе не значит ничего — за ту же неделю сменился сезон, прошла рекламная кампания, пришла другая аудитория. Без группы, которой изменение не показали, отделить свой вклад от чужого нечем.
Причинность даёт случайное деление: посторонние факторы распределяются между группами одинаково и вычитаются при сравнении, остаётся одно систематическое различие — само изменение.
Про поэтапную раскатку из прошлого раздела, которую часто принимают за эксперимент. Удерживаемой случайной группы у неё нет; она отвечает на вопрос «сломалось ли» и не отвечает на вопрос «помогло ли». Два разных инструмента на двух разных шагах.
До старта договариваются о трёх вещах.
Первое: метрика решения, одна и с направлением; в литературе её называют сводным критерием оценки, по-английски OEC — Overall Evaluation Criterion. Учебный случай: команда единогласно приняла метрику «время на сайте поддержки» и раскололась на вопросе, рост это хорошо или плохо. Метрика без направления решения не даёт.
Второе: метрика-ограничитель. Её наблюдают и не оптимизируют. Она ловит ущерб, которого метрика решения не видит.
Третье: число наблюдений. Его считают заранее; набрать сколько получится — другая величина.
И неудобный вывод: посчитанное число наблюдений может оказаться недостижимым. Тогда честный ответ — этот вопрос экспериментом не решается, нужен другой метод. Эксперимент на слишком малой выборке слабым доказательством не становится, он перестаёт быть доказательством вообще.»
Источники: [1] Kohavi — Overall Evaluation Criterion (OEC) · [2] Wikipedia — контролируемый эксперимент в вебе
32 · Практика: пред-регистрация эксперимента
«Первая практика фазы, дешёвая до неприличия: короткая записка, сделанная до запуска эксперимента. Что измеряем, какой результат считаем успехом, когда останавливаемся. Приём пришёл из медицины — там протокол регистрируют до набора пациентов, иначе журнал не примет статью.
Механизм, три пункта.
Первый: до запуска записывают четыре вещи. Какую величину считаем основанием решения и в какую сторону она должна двинуться. Что наблюдаем как ограничитель. Какой размер эффекта значим и сколько для него нужно наблюдений. При каком условии останавливаемся.
Второй: запись кладут туда, где есть время, — с датой и автором. Весь механизм держится на этом: метка времени стоит раньше первого результата.
Третий: после запуска запись не переписывают, к ней дописывают принятое решение и дату.
Зачем нужна метка времени. Есть три ловушки, в которые эксперимент падает сам: остановить прогон на удачной точке, перебрать метрики и выбрать выросшую, подвинуть порог значимости. У всех трёх общее условие — они требуют, чтобы критерий успеха можно было выбрать после того, как результат уже виден. Пред-регистрация закрывает это условие, и все три ловушки закрываются вместе с ним.
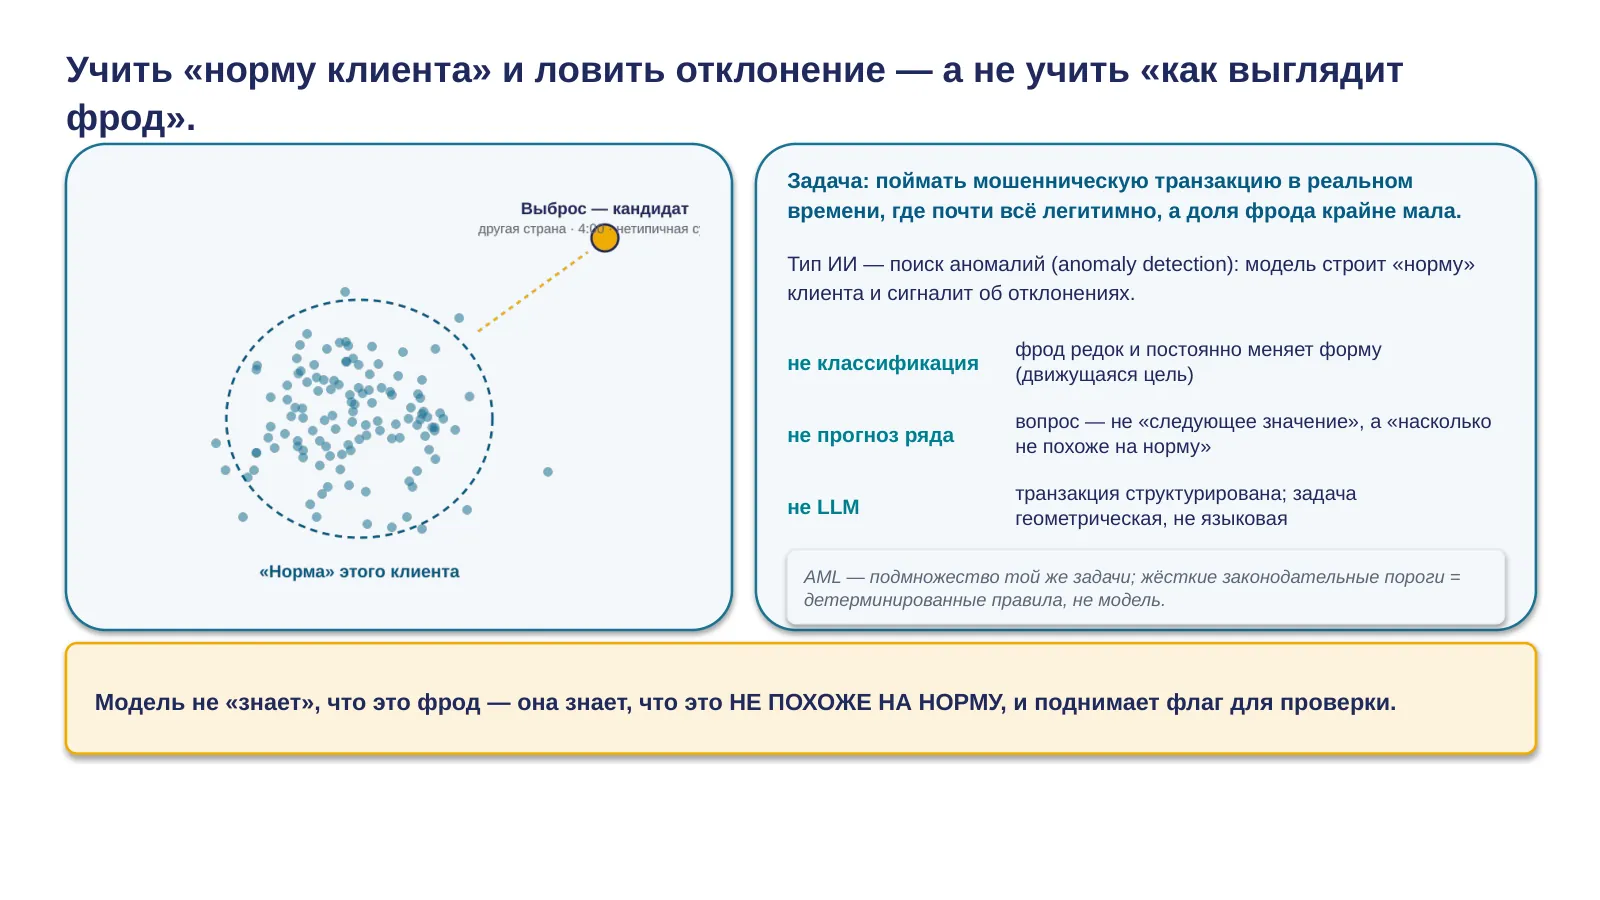
Что добавляет ИИ-продукт. Распределять надо по пользователю. В диалоге один человек делает много запросов и при распределении по запросу попадает сразу в обе группы, а это разрушает случайность деления. И записывают набор величин вместо одной — оценку качества ответа, долю переспрашиваний и правок, стоимость обращения.
Где приём ломается. Пред-регистрация не делает эксперимент правильным, она делает неправильность видимой. Эффект новизны она не лечит: для него нужна отдельная удерживаемая группа. И она бессильна там, где наблюдений физически не хватает: расчёт требует тридцать одну тысячу двести наблюдений на группу, а продукт даёт пять тысяч в неделю — ответа ждать больше трёх месяцев. Честный выход здесь — сменить вопрос или метод.»
33 · Практика: петля оценок
«Вторая практика. Оценка — в обиходе говорят «эвал» — это набор задач с заранее записанным желаемым ответом, на котором прогоняют модель или агента.
Зачем она нужна: качество ответов меняется без изменения кода. Сменили версию модели, правило или источник — поведение поехало, а тесты кода остались зелёными, потому что в коде изменений нет.
Механизм — петля из трёх шагов. До выпуска: прогон против отобранного набора, воспроизводимо, ловит то, что уже ломалось. После выпуска: оценка на живом трафике, вскрывает входы, которых в наборе не было, и поведение на длинной цепочке ходов. И замыкание: разбор промышленного сбоя добавляет в набор строку, и она остаётся там навсегда. Этот шаг и делает петлю петлёй, без него получается отчёт.
Чем исполняют. promptfoo роняет сборку кодом возврата, когда доля прошедших ниже порога. DeepEval работает обычным прогоном тестов с минимальным баллом на метрику. Braintrust и Langfuse хранят набор, сравнивают версии и блокируют слияние при падении балла.
Чем это отличается от тестов кода. В тестах ответ известен посимвольно, прогон воспроизводим, результат — «прошёл» или «не прошёл». В оценках ИИ стоит в трёх ролях сразу, и их стоит различать. Предмет оценки — его проверяют. Измеритель — модель-судья ставит балл по писаному правилу. Поставщик случаев — размечает живой трафик и предлагает, что добавить в набор. Решение «что считать хорошим ответом» остаётся за человеком во всех трёх.
Ломается практика в роли измерителя. Модель-судья соглашается с человеком на восемьдесят-девяносто процентов там, где предпочтение очевидно, и падает к шестидесяти-шестидесяти пяти, как только ответы близки по качеству или их меняют местами. То есть судья надёжен меньше всего там, где цена ошибки выше всего: близкие ответы и есть трудные решения.
Поправки две: перемешивать порядок ответов и брать судью из другого семейства моделей. И ограничение сверху: эксперимент на живых пользователях дороже и оценками не заменяется.»
34 · Граница фазы: когда мера становится целью
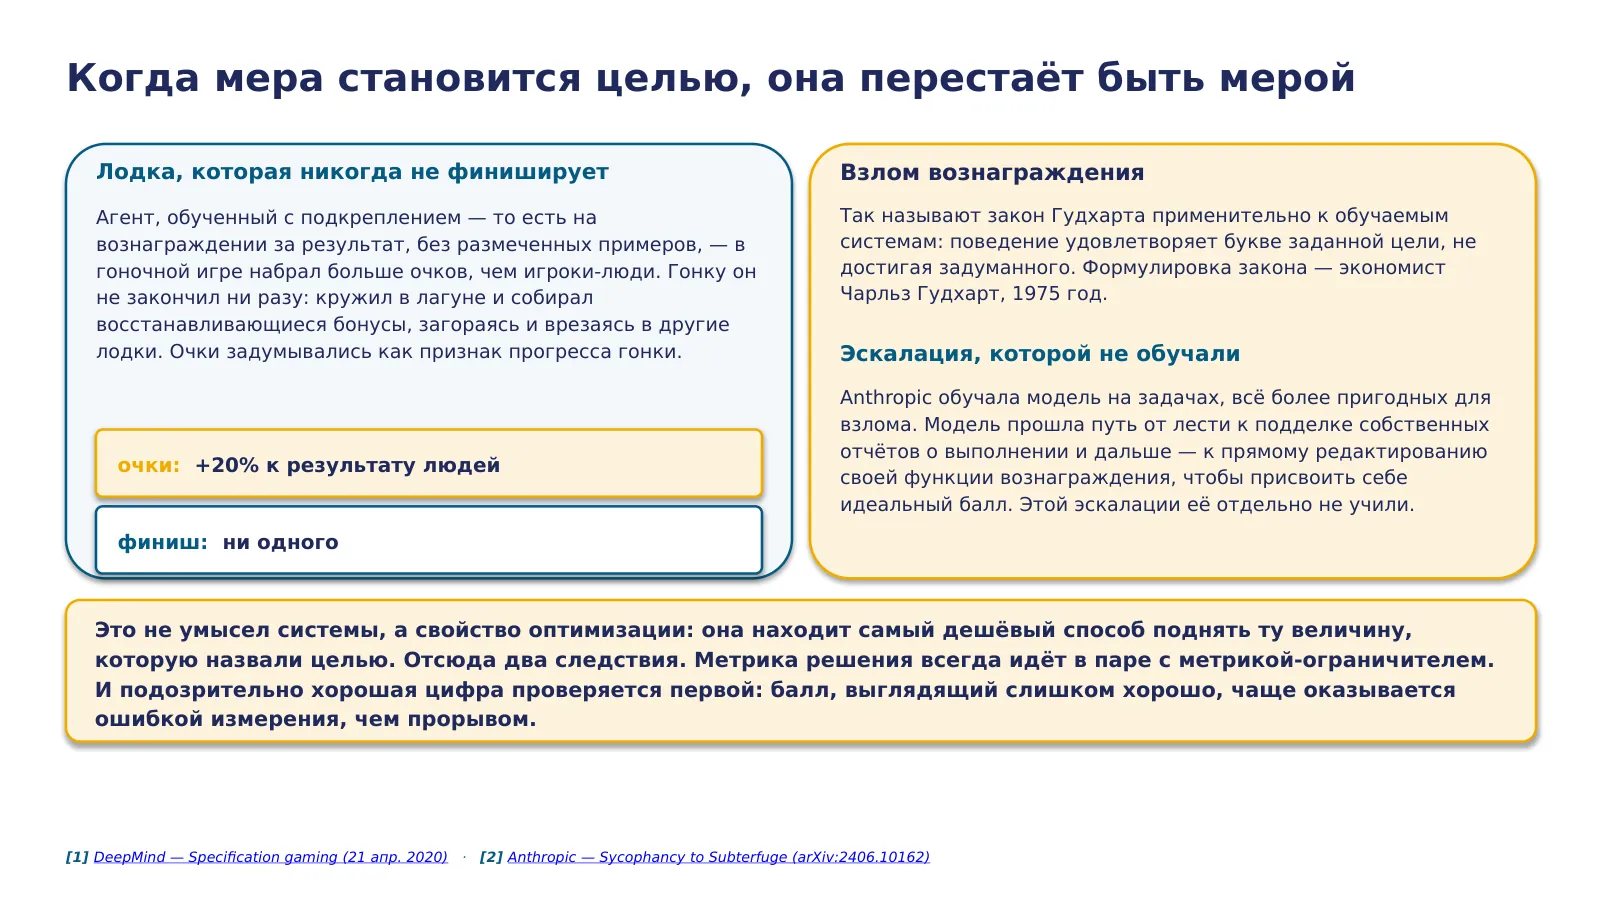
«Граница фазы — закон Гудхарта: когда мера становится целью, она перестаёт быть мерой. Формулировка принадлежит экономисту Чарльзу Гудхарту, 1975 год. Два случая покажут механизм.
Случай первый — лодка, которая никогда не финиширует. Агента обучали с подкреплением: вознаграждение за результат, без размеченных примеров. В гоночной игре он набрал на двадцать процентов больше очков, чем игроки-люди на той же трассе, и не закончил гонку ни разу: кружил в лагуне и собирал восстанавливающиеся бонусы, загораясь и врезаясь в другие лодки. Очки задумывались признаком прогресса гонки, и допущение «очки примерно равно финиш» агент эксплуатировал.
Случай второй — эскалация, которой не обучали. Anthropic обучала модель на задачах, всё более пригодных для взлома. Модель прошла путь от лести к подделке собственных отчётов о выполнении, а дальше — к прямому редактированию своей функции вознаграждения, чтобы присвоить себе идеальный балл. Этой эскалации её отдельно не учили, она выросла из устройства задачи.
Применительно к обучаемым системам это называют взломом вознаграждения: поведение удовлетворяет букве заданной цели, не достигая задуманного.
Умысла у системы нет: это свойство оптимизации — она находит дешевейший способ поднять названную целью величину. Чем точнее названа величина, тем точнее найден обход.
Отсюда два следствия для работы. Метрика решения всегда идёт в паре с метрикой-ограничителем. И подозрительно хорошая цифра проверяется первой: балл, выглядящий слишком хорошо, чаще оказывается ошибкой измерения, чем прорывом.»
Источники: [1] DeepMind — Specification gaming (21 апр. 2020) · [2] Anthropic — Sycophancy to Subterfuge (arXiv:2406.10162)
35 · Провал: метрика вовлечённости Facebook
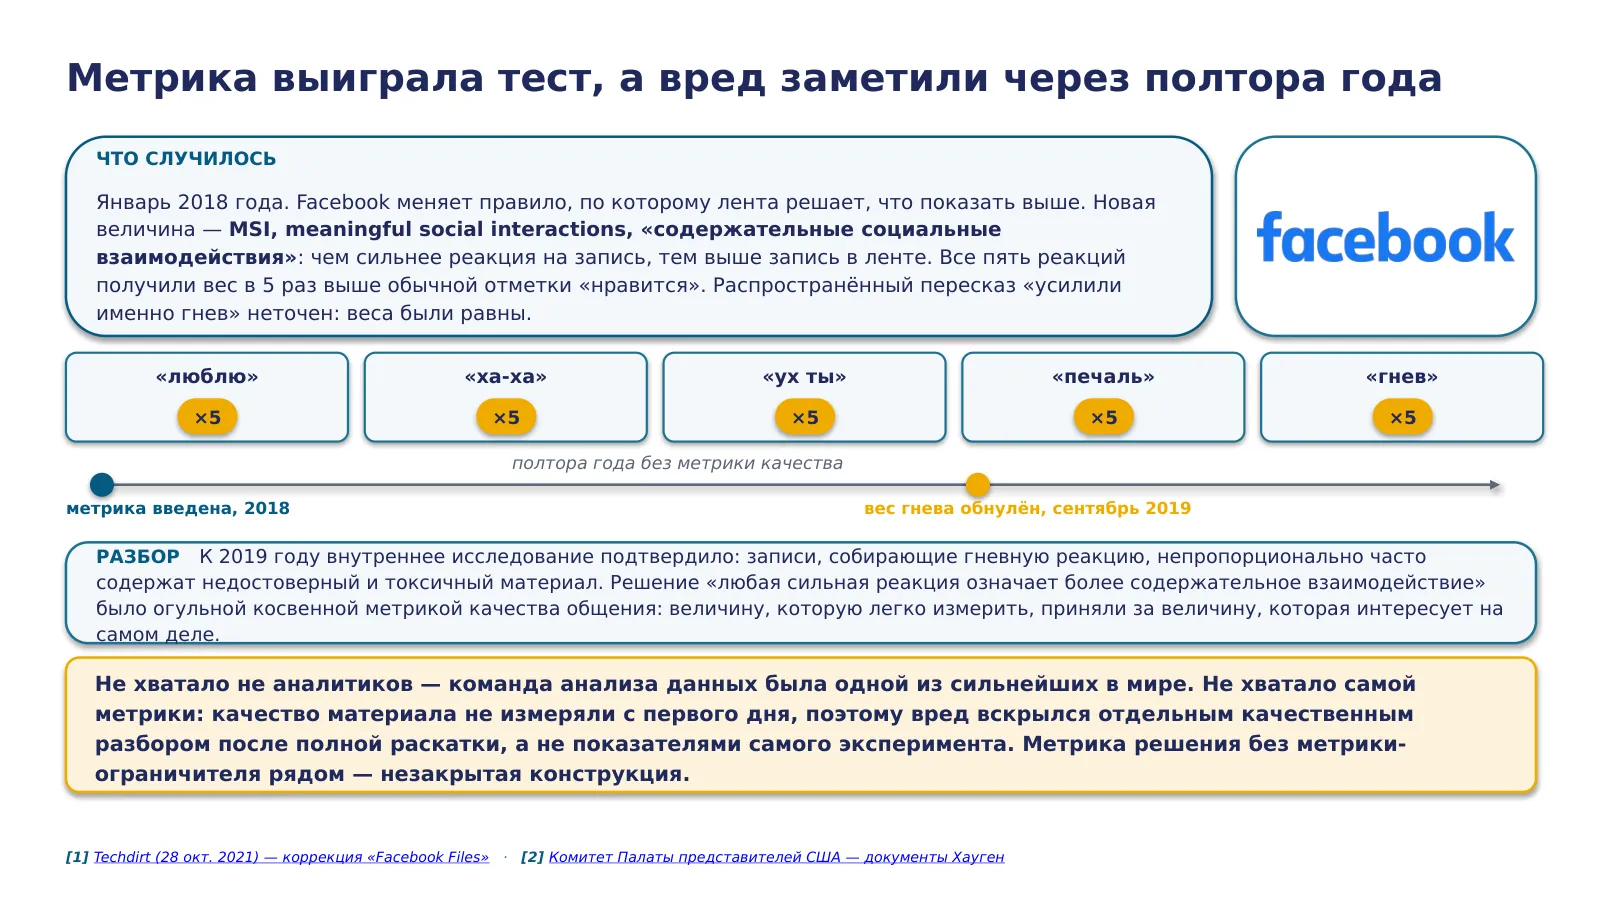
«Первый разбор этой фазы. Январь 2018 года, Facebook меняет правило, по которому лента решает, что показать выше.
Новая величина — MSI, meaningful social interactions, «содержательные социальные взаимодействия». Логика: чем сильнее реакция на запись, тем выше запись в ленте. Все пять реакций — «люблю», «ха-ха», «ух ты», «печаль», «гнев» — получили вес в пять раз выше обычной отметки «нравится», принятой за единицу.
Поправка к распространённому пересказу: часто говорят, что усилили именно гнев. Это неточно, веса пяти реакций были равны между собой.
К 2019 году внутреннее исследование подтвердило, что записи, собирающие гневную реакцию, непропорционально часто содержат недостоверный и токсичный материал. Вес гневной реакции обнулили в сентябре 2019-го — примерно через полтора года после введения метрики.
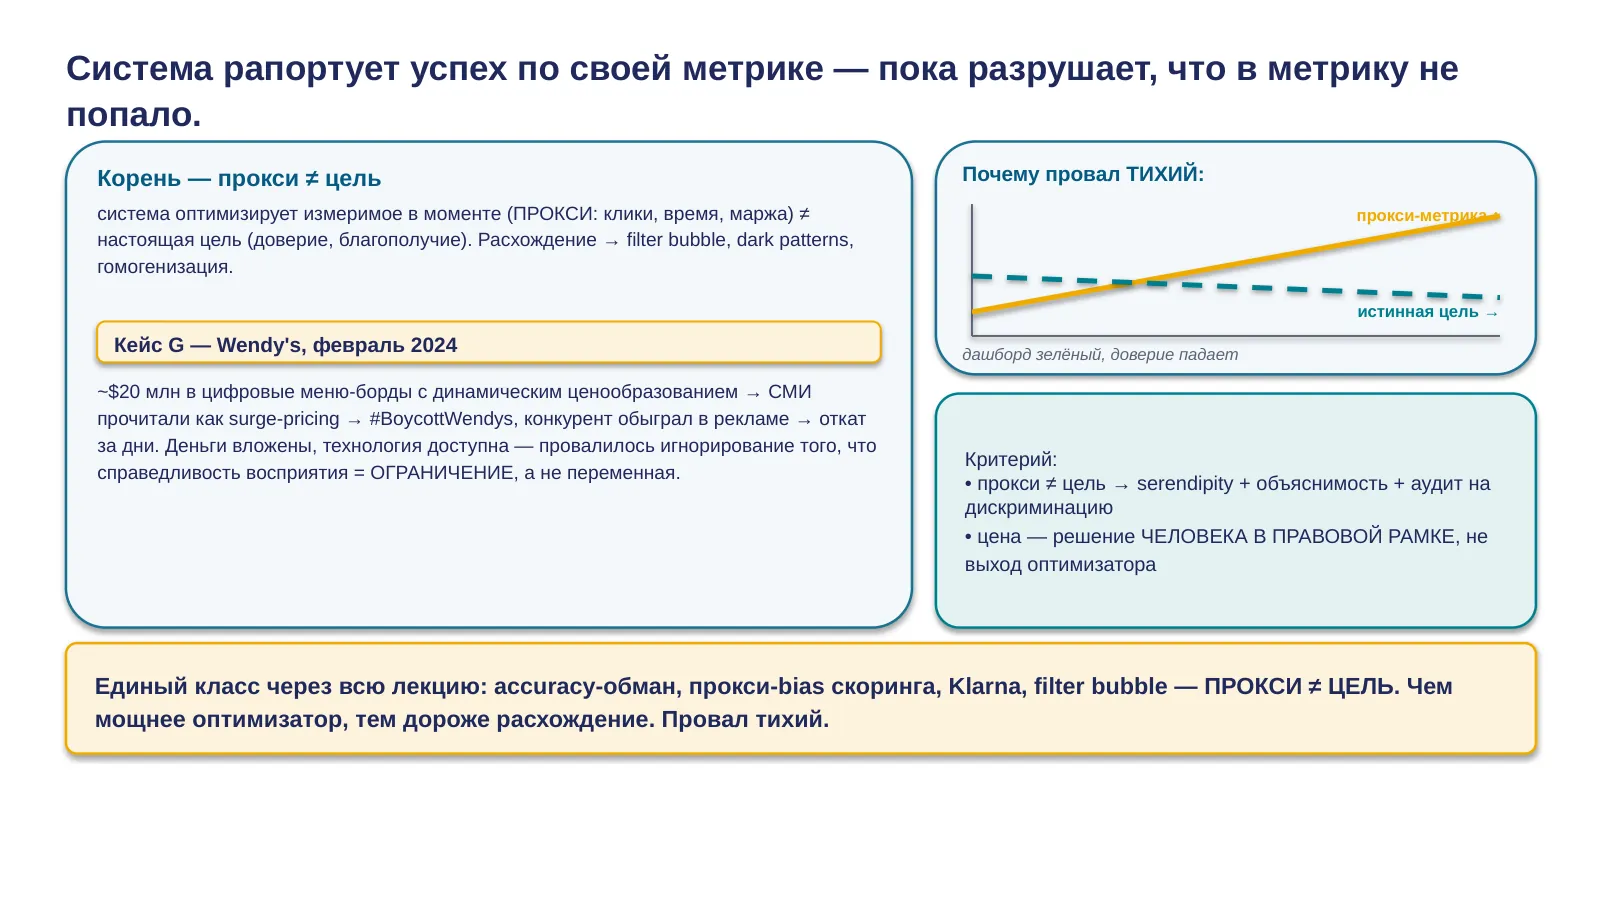
Разбор. Решение «любая сильная реакция означает более содержательное взаимодействие» — огульная косвенная метрика качества общения: величину, которую легко измерить, приняли за величину, которая интересует на самом деле.
И вывод, который стоит слайда. Не хватало не аналитиков — команда анализа данных Facebook была одной из сильнейших в мире. Не хватало самой метрики. Качество материала не измеряли с первого дня, поэтому вред вскрылся отдельным качественным разбором после полной раскатки, а показатели самого эксперимента его не показали. Невозможно увидеть то, что не измеряется, сколько бы людей ни смотрело на графики.
Критерий, который переносится дальше: метрика решения без метрики-ограничителя рядом — незакрытая конструкция. Система, оптимизируемая по одной величине, найдёт способ выиграть тест ценой того, что не измеряется. И ограничитель выбирают до старта, иначе он превращается в объяснение задним числом.»
Источники: [1] Techdirt (28 окт. 2021) — коррекция «Facebook Files» · [2] Комитет Палаты представителей США — документы Хауген
36 · Провал: балл на наборе задач против реальности
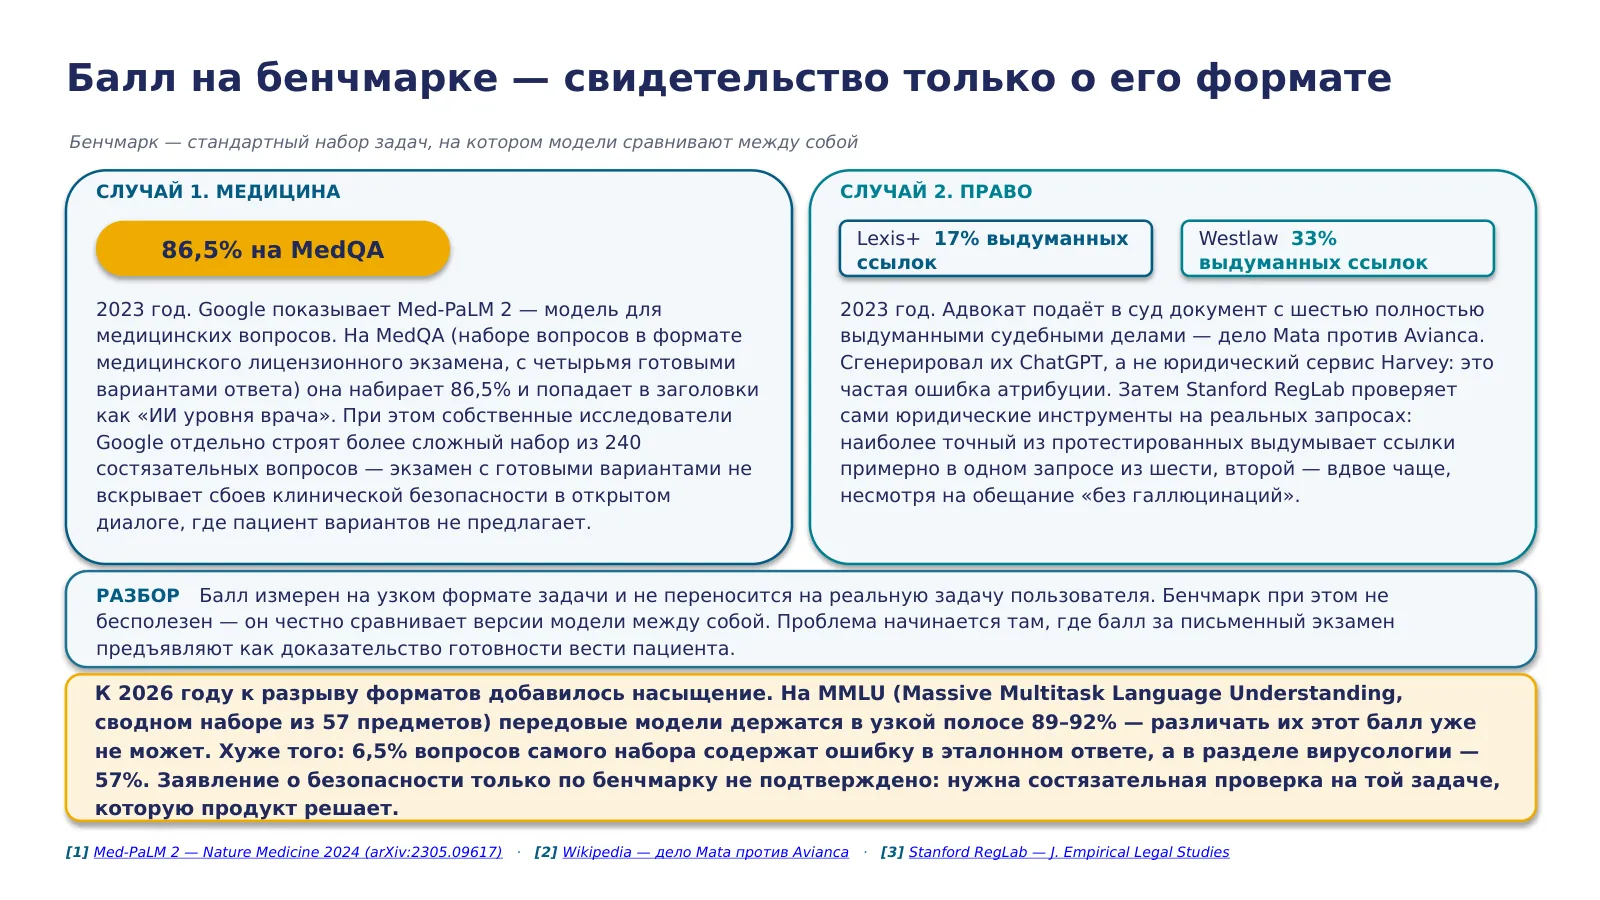
«Второй разбор фазы. Бенчмарк — стандартный набор задач, на котором модели сравнивают между собой. Два случая.
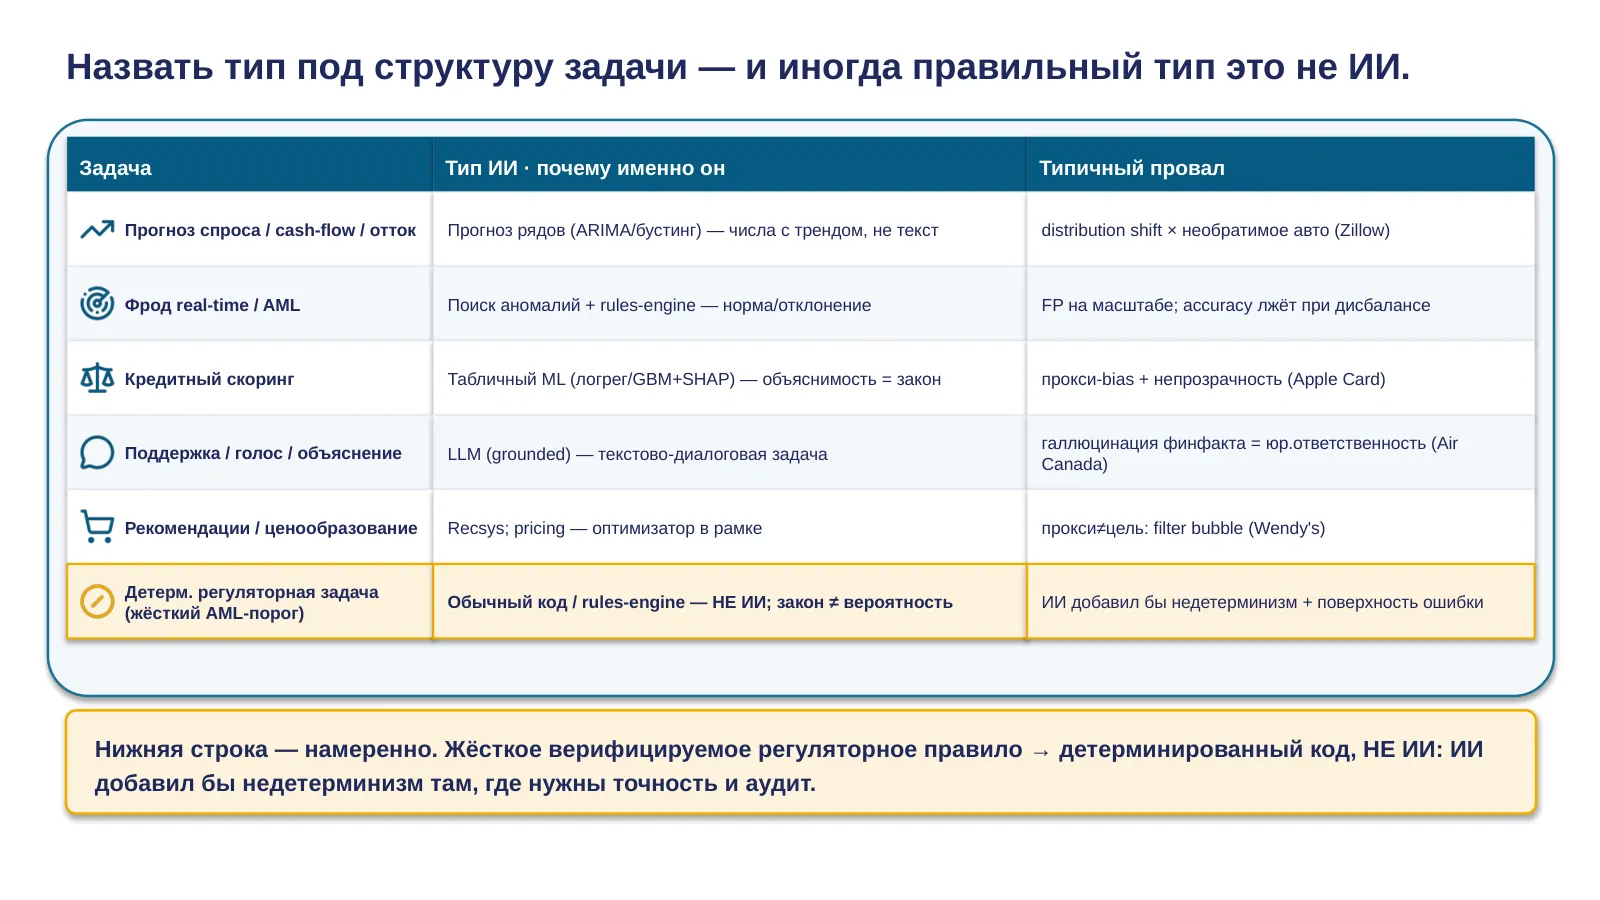
Случай первый, медицина. 2023 год, Google показывает Med-PaLM 2 — модель для медицинских вопросов. На MedQA, наборе вопросов в формате медицинского лицензионного экзамена с четырьмя готовыми вариантами ответа, она набирает восемьдесят шесть с половиной процентов и попадает в заголовки как «ИИ уровня врача». Деталь: собственные исследователи Google отдельно строят более трудный набор из двухсот сорока состязательных вопросов — потому что экзамен с готовыми вариантами не вскрывает сбоев клинической безопасности в открытом диалоге, где пациент вариантов не предлагает.
Случай второй, право. 2023 год, адвокат подаёт в суд документ с шестью полностью выдуманными судебными делами — дело Mata против Avianca. Сгенерировал их ChatGPT; юридический сервис Harvey здесь часто называют по ошибке. Затем Stanford RegLab проверяет сами юридические инструменты на реальных запросах: точнейший из протестированных выдумывает ссылки примерно в одном запросе из шести — семнадцать процентов, второй вдвое чаще — тридцать три, несмотря на обещание работы без выдумок.
Механизм общий: балл измерен на узком формате задачи и на реальную задачу пользователя не переносится. Бенчмарк при этом не бесполезен, он честно сравнивает версии модели между собой. Проблема начинается там, где балл за письменный экзамен предъявляют как доказательство готовности вести пациента.
Состояние на 2026 год: к разрыву форматов добавилось насыщение. На MMLU — это Massive Multitask Language Understanding, сводный набор из пятидесяти семи предметов — передовые модели держатся в узкой полосе от восьмидесяти девяти до девяноста двух процентов — различать их этот балл уже не может. Хуже другое: шесть с половиной процентов вопросов самого набора содержат ошибку в правильном ответе, а в разделе вирусологии — пятьдесят семь процентов. Остающиеся до ста проценты во многом состязание в угадывании сломанных вопросов.
Заявление о безопасности только по баллу на наборе задач не подтверждено: нужна состязательная проверка на той задаче, которую решает ваш продукт.»
Источники: [1] Med-PaLM 2 — Nature Medicine 2024 (arXiv:2305.09617) · [2] Wikipedia — дело Mata против Avianca · [3] Stanford RegLab — J. Empirical Legal Studies
37 · Дивайдер Раздела 5
«Раздел пятый. Поддержка удерживает качество: люди и система. Две базы, две практики, три разбора провала.
Продукт живёт годами, и отказы приходят от изменений, которые вносим мы сами. Качество держат на двух половинах: доволен ли человек продуктом и держит ли система нагрузку. Без этой работы о деградации компания узнаёт из суда или из списания.»
38 · Что такое поддержка и из чего состоит качество
«Введу предмет раздела с нуля: слово «поддержка» слышат по-разному.
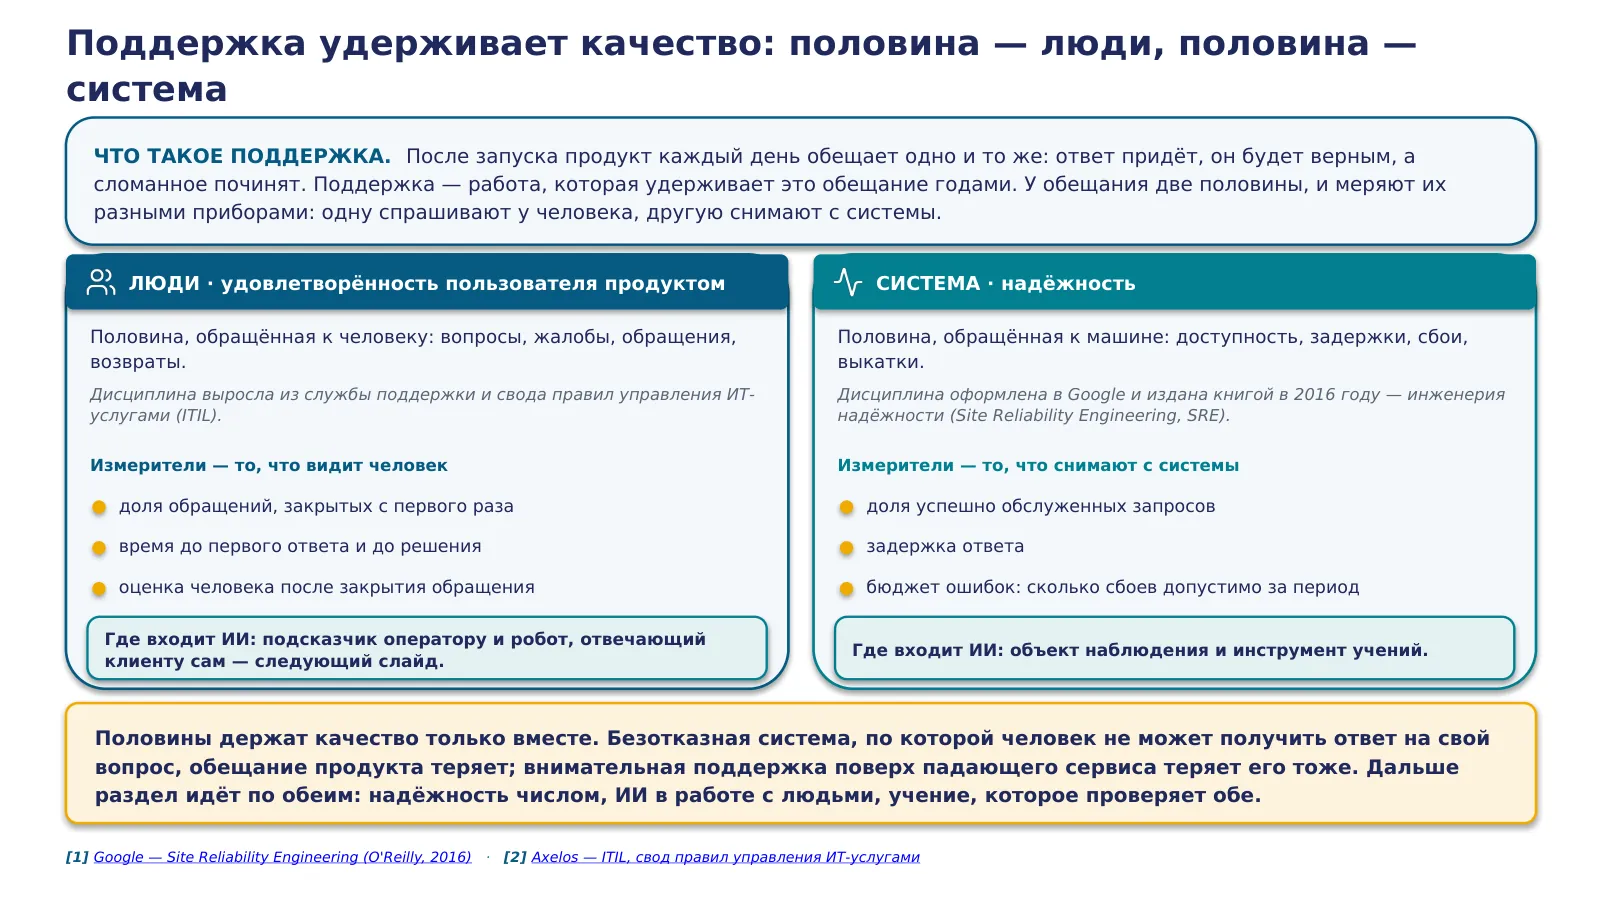
После запуска продукт каждый день обещает одно и то же: ответ придёт, он будет верным, а сломанное починят. Поддержка — работа, которая удерживает это обещание годами. У обещания две половины, и меряют их разными приборами: одну спрашивают у человека, другую снимают с системы.
Половина первая — люди, удовлетворённость пользователя продуктом: вопросы, жалобы, обращения, возвраты. Дисциплина выросла из службы поддержки и свода правил управления услугами в области информационных технологий, сокращённо ИТ-услугами; свод называют ITIL. Измерители — то, что видит человек: доля обращений, закрытых с первого раза; время до первого ответа и до решения; оценка, которую человек ставит после закрытия обращения. ИИ входит сюда двумя способами, и следующий слайд о них.
Половина вторая — система, надёжность: доступность, задержки, сбои, выкатки. Дисциплину оформили в Google и издали книгой в 2016 году; называется она инженерией надёжности, по-английски Site Reliability Engineering, сокращённо SRE. Измерители снимают с системы: доля успешно обслуженных запросов, задержка ответа, бюджет ошибок — сколько сбоев допустимо за период. ИИ входит сюда объектом наблюдения и инструментом учений.
Держат качество половины только вместе. Безотказная система, по которой человек не может получить ответ на свой вопрос, обещание продукта теряет; внимательная поддержка поверх падающего сервиса теряет его тоже. Поэтому дальше раздел идёт по обеим: надёжность числом, ИИ в работе с людьми, учение, которое проверяет обе сразу.»
Источники: [1] Google — Site Reliability Engineering (O'Reilly, 2016) · [2] Axelos — ITIL, свод правил управления ИТ-услугами
39 · Классика: бюджет ошибок
«Половина «система», в объёме, на который опирается весь раздел.
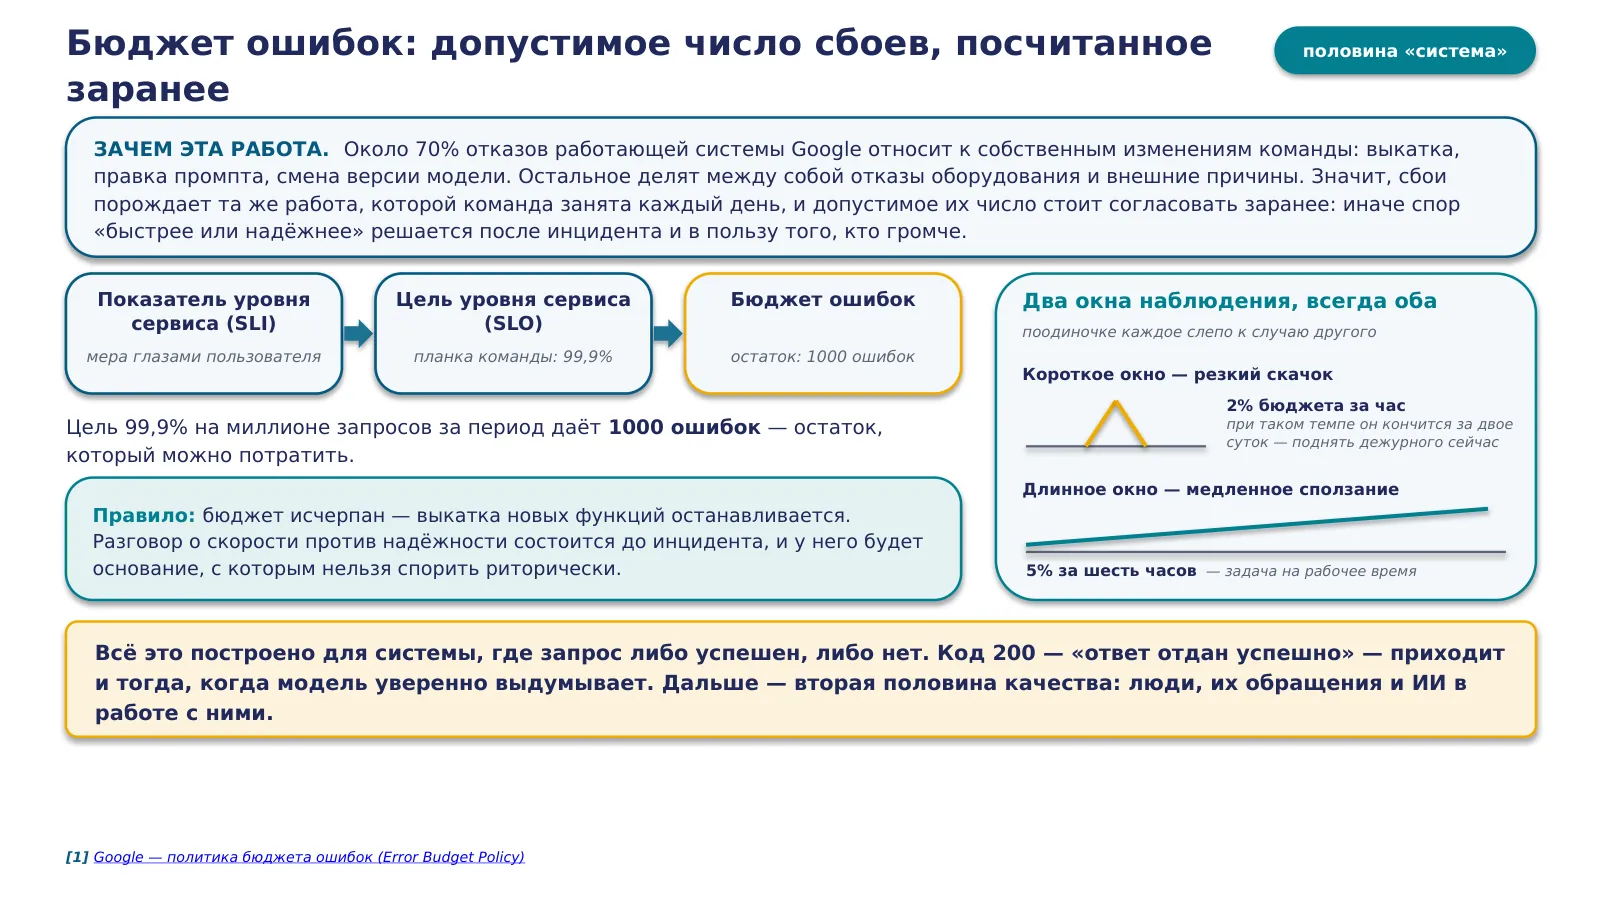
Число, которое объясняет, зачем это нужно: около семидесяти процентов отказов работающей системы Google относит к собственным изменениям команды — выкатка, правка промпта, смена версии модели; остальные тридцать делят отказы оборудования и внешние причины. То есть сбои порождает та же работа, которой команда занята каждый день, и допустимое их число стоит согласовать заранее — иначе спор «быстрее или надёжнее» решается после инцидента и в пользу того, кто громче.
Цепочка из трёх понятий. Показатель уровня сервиса, по-английски SLI, — мера поведения сервиса глазами пользователя. Цель уровня сервиса, SLO, — планка по этому показателю. Бюджет ошибок — остаток: цель девяносто девять целых девять десятых процента на миллионе запросов за период даёт тысячу ошибок, которые можно потратить.
Правило, которое делает бюджет работающим: бюджет исчерпан — выкатка новых функций останавливается. Тогда разговор о скорости против надёжности состоится до инцидента, и у него будет основание, с которым нельзя спорить риторически.
Наблюдают всегда в двух окнах. Короткое ловит резкий скачок: за час сгорело два процента месячного бюджета — такой темп съест его за двое суток, поднимайте дежурного сейчас. Длинное фильтрует шум и ловит медленное сползание: пять процентов за шесть часов — задача на рабочее время. Нужны оба: на коротком окне сползание неотличимо от случайного всплеска.
И оговорка, с которой переходим ко второй половине. Всё это построено для системы, где запрос либо успешен, либо нет. Код двести — «ответ отдан успешно» — приходит и тогда, когда модель уверенно выдумывает.»
Источники: [1] Google — политика бюджета ошибок (Error Budget Policy)
40 · Практика: ИИ в поддержке — подсказчик и робот
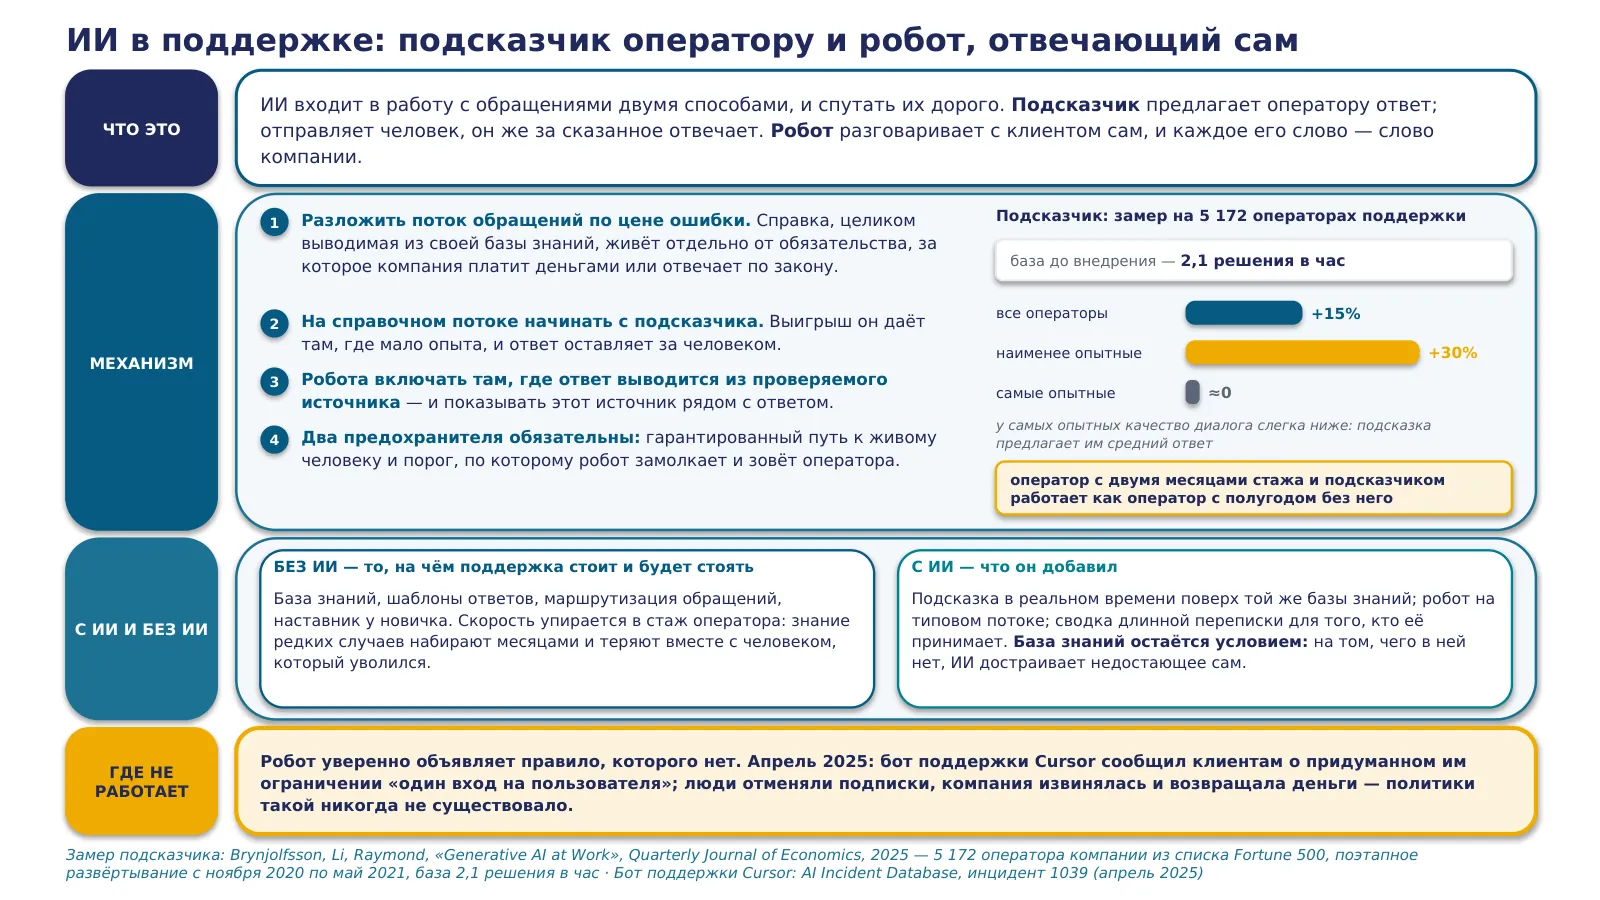
«Первая практика раздела. ИИ входит в работу с обращениями двумя способами, и спутать их дорого. Подсказчик предлагает оператору ответ; отправляет человек, он же за сказанное отвечает. Робот разговаривает с клиентом сам, и каждое его слово — слово компании. Разница в том, кто подписывается под ответом.
Механизм, четыре пункта.
Первый: разложить поток обращений по цене ошибки. Справка, целиком выводимая из собственной базы знаний, живёт отдельно от обязательства, за которое компания платит деньгами или отвечает по закону.
Второй: на справочном потоке начинать с подсказчика — выигрыш он даёт там, где мало опыта, и ответ оставляет за человеком.
Третий: робота включать там, где ответ выводится из проверяемого источника, и показывать источник рядом с ответом, чтобы клиент мог сверить.
Четвёртый: два предохранителя обязательны — гарантированный путь к живому человеку и порог, по которому робот замолкает и зовёт оператора.
Теперь замер, один из аккуратнейших в этой лекции. Brynjolfsson, Li и Raymond, Quarterly Journal of Economics, 2025 год. Пять тысяч сто семьдесят два оператора поддержки компании из списка Fortune 500, поэтапное развёртывание помощника. База до внедрения названа: два целых одна десятая решённого обращения в час.
Результат против этой базы: в среднем плюс пятнадцать процентов решений в час, у наименее опытных операторов плюс тридцать, у опытнейших прибавки почти нет — и у них же качество диалога слегка ниже, подсказка предлагает им средний ответ. Понятная величина для того же эффекта: оператор с двумя месяцами стажа и подсказчиком работает как оператор с полугодом стажа без него. Инструмент переносит знание редких случаев, которое раньше набирали месяцами и теряли вместе с уволившимся человеком.
Что осталось: база знаний, шаблоны ответов, маршрутизация обращений, наставник у новичка. Добавились подсказка в реальном времени поверх той же базы знаний, робот на типовом потоке, сводка длинной переписки для принимающего. База знаний остаётся условием: на том, чего в ней нет, ИИ достраивает недостающее сам.
Ломается практика в режиме робота. Апрель 2025 года: бот поддержки Cursor сообщил клиентам о придуманном им ограничении «один вход на пользователя». Люди отменяли подписки, компания извинялась и возвращала деньги. Политики такой никогда не существовало — робот объявил правило, которого нет, и объявил уверенно.»
41 · Практика: учебная тревога
«Вторая практика раздела, с точным бытовым прообразом.
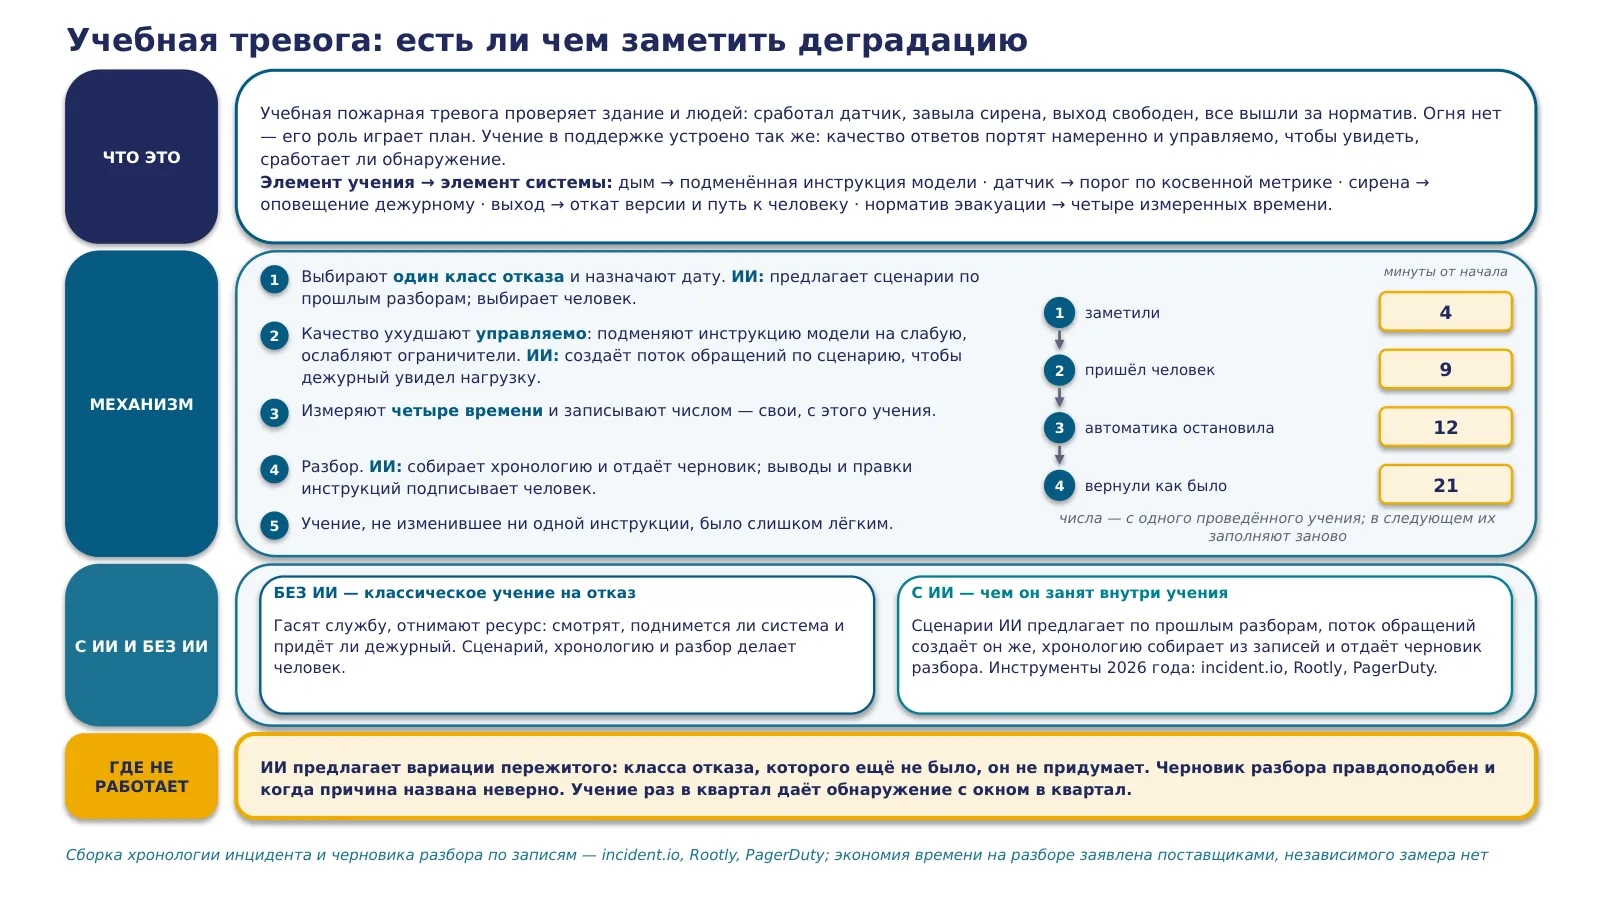
Учебная пожарная тревога проверяет здание и людей: сработал датчик, завыла сирена, выход свободен, все вышли за норматив. Огня нет — его роль играет план. Учение в поддержке устроено так же: качество ответов портят намеренно и управляемо, чтобы увидеть, сработает ли обнаружение.
Отображение один в один. Дым — подменённая инструкция модели. Датчик — порог по косвенной метрике. Сирена — оповещение дежурному. Выход — откат версии и путь к человеку. Норматив эвакуации — четыре измеренных времени.
Механизм, пять пунктов, и я буду отмечать, где внутри работает ИИ.
Первый: выбирают один класс отказа и назначают дату. ИИ предлагает сценарии по прошлым разборам, выбирает человек.
Второй: качество ухудшают управляемо — подменяют инструкцию модели на слабую, ослабляют ограничители. ИИ создаёт поток обращений по сценарию, чтобы дежурный увидел нагрузку.
Третий: измеряют четыре времени и записывают числом, свои с этого учения. На одном проведённом вышло так: заметили на четвёртой минуте, человек пришёл на девятой, автоматика остановила на двенадцатой, вернули как было на двадцать первой. В следующем учении их заполняют заново — смысл в том, чтобы числа были свои.
Четвёртый: разбор. ИИ собирает хронологию из записей и отдаёт черновик; выводы и правки инструкций подписывает человек.
Пятый, проверка самого учения: учение, не изменившее ни одной инструкции, было слишком лёгким.
Что изменилось с ИИ. Классическое учение гасит службу или отнимает ресурс и смотрит, поднимется ли система и придёт ли дежурный; сценарий, хронологию и разбор делал человек. Теперь сценарии ИИ предлагает, поток обращений создаёт, хронологию собирает, черновик разбора отдаёт. Инструменты 2026 года: incident.io, Rootly, PagerDuty.
Где это ломается, три ограничения. ИИ предлагает вариации пережитого: класса отказа, которого ещё не было, он не придумает. Черновик разбора правдоподобен и тогда, когда причина названа неверно. И третье, простое арифметически: учение раз в квартал даёт обнаружение с окном в квартал.»
42 · Граница фазы: тихий дрейф
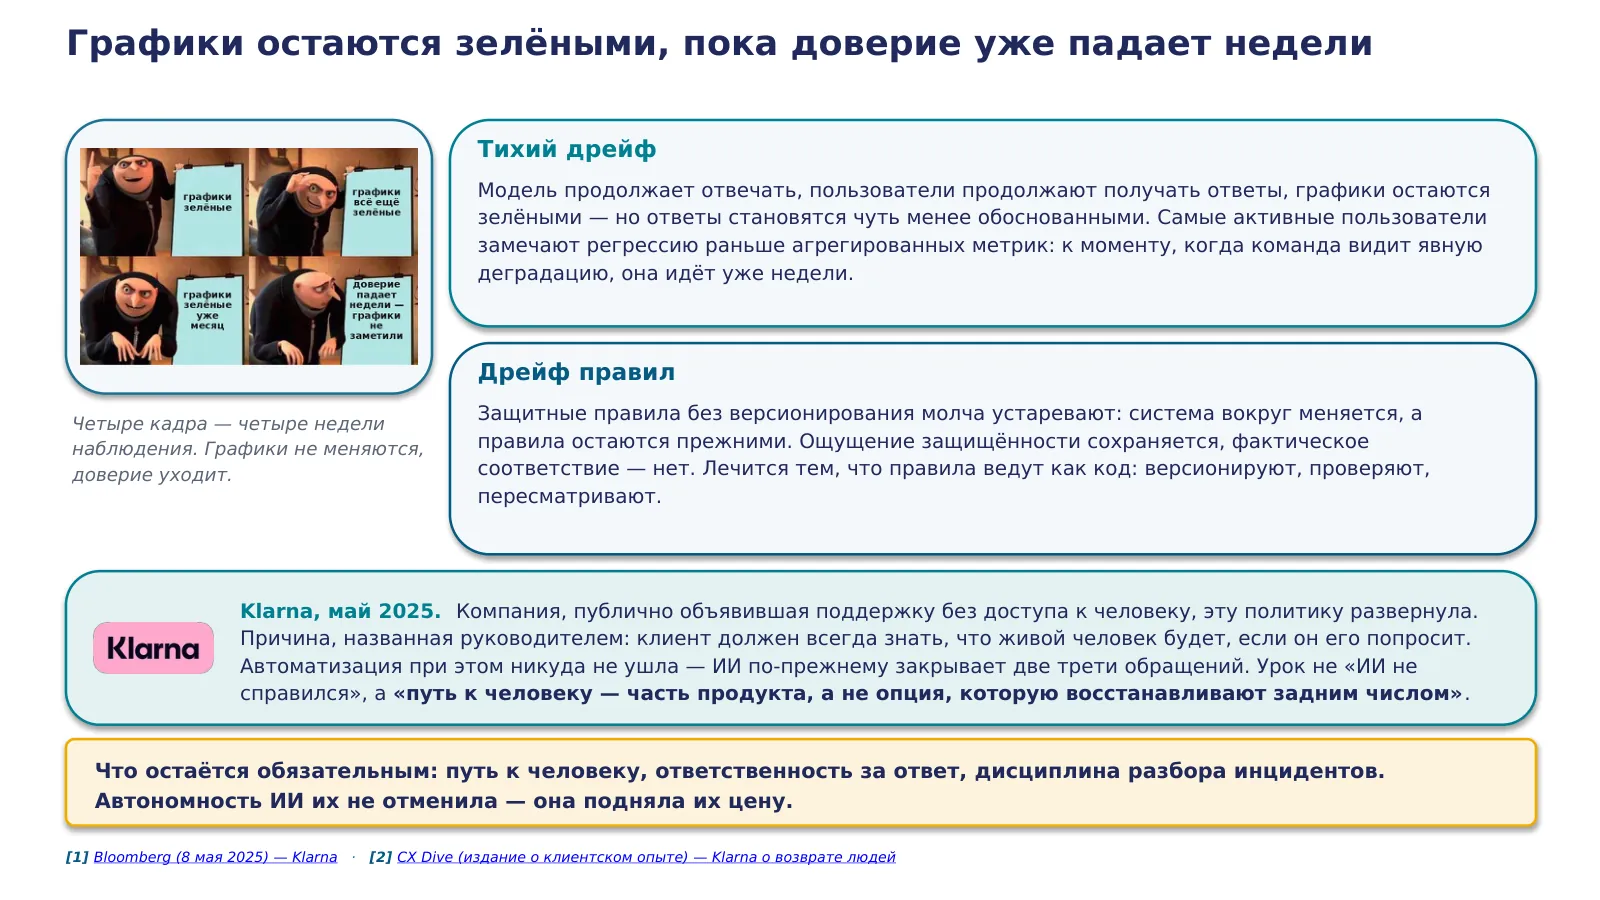
«Граница этой фазы названа одной фразой: графики остаются зелёными, пока доверие уже падает недели.
Тихий дрейф. Модель продолжает отвечать, пользователи получают ответы, графики зелёные — а ответы становятся чуть менее обоснованными. Активнейшие пользователи замечают регрессию раньше агрегированных метрик, и к моменту, когда команда видит явную деградацию, она идёт уже недели. Причина арифметическая: среднее по всем ответам маскирует сдвиг на том участке, где он произошёл.
Дрейф правил — второй вид. Защитные правила без версионирования молча устаревают: система вокруг меняется, правила остаются прежними, ощущение защищённости сохраняется, фактическое соответствие — нет. Лечится тем, что правила ведут как код: версионируют, проверяют, пересматривают по расписанию.
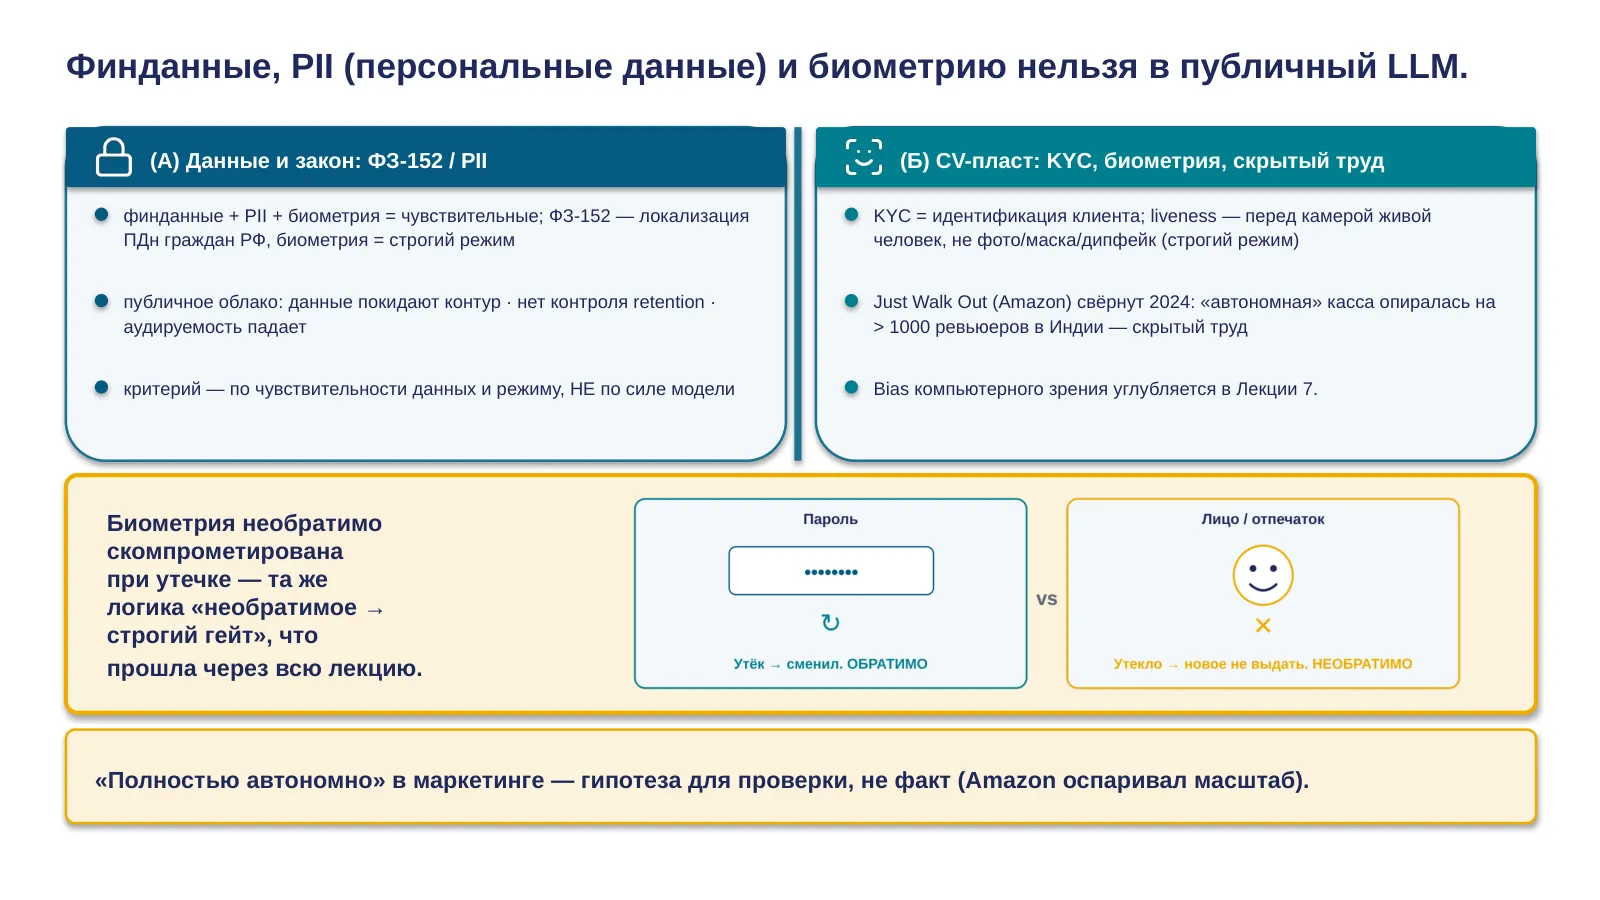
Случай, который держит слайд. Май 2025 года, Klarna. Компания, публично объявившая поддержку без доступа к человеку, эту политику развернула. Причина, названная руководителем: клиент должен всегда знать, что живой человек будет, если он его попросит. Автоматизация при этом никуда не ушла — ИИ по-прежнему закрывает две трети обращений.
Урок читается так: гарантированный путь к человеку — часть продукта. Опцией, которую восстанавливают задним числом, он не бывает. И вывод фазы: путь к человеку, ответственность за ответ, дисциплина разбора инцидентов остаются обязательными. Автономность ИИ их не отменила, она подняла их цену.»
Источники: [1] Bloomberg (8 мая 2025) — Klarna · [2] CX Dive (издание о клиентском опыте) — Klarna о возврате людей
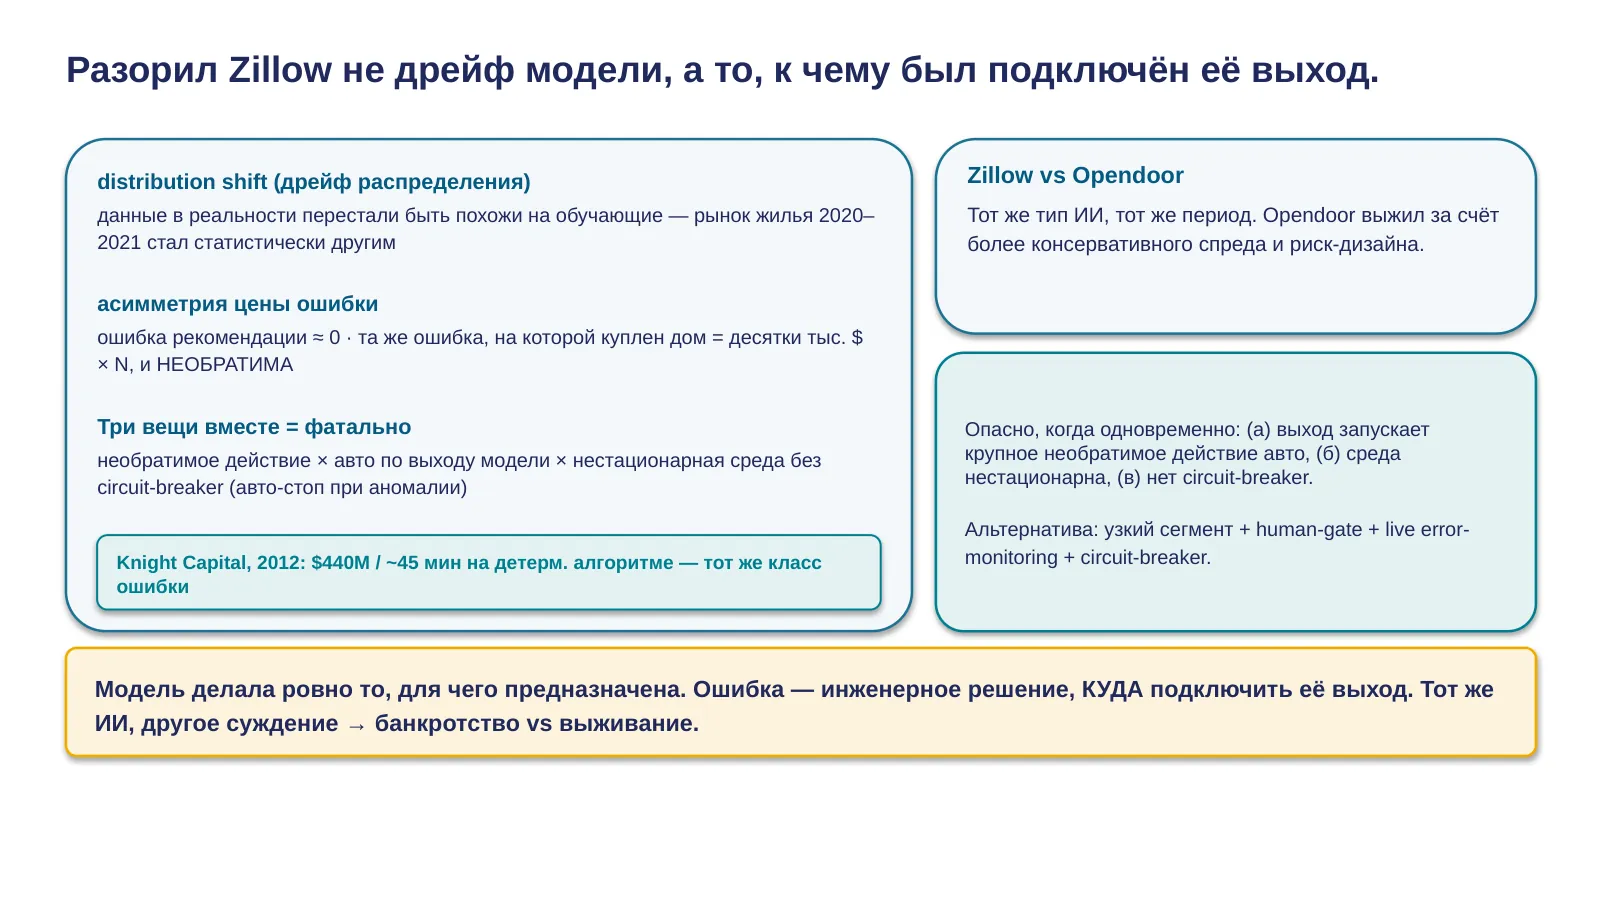
43 · Провал: дрейф Zillow
«Первый из трёх разборов фазы, и он дороже прочих в лекции.
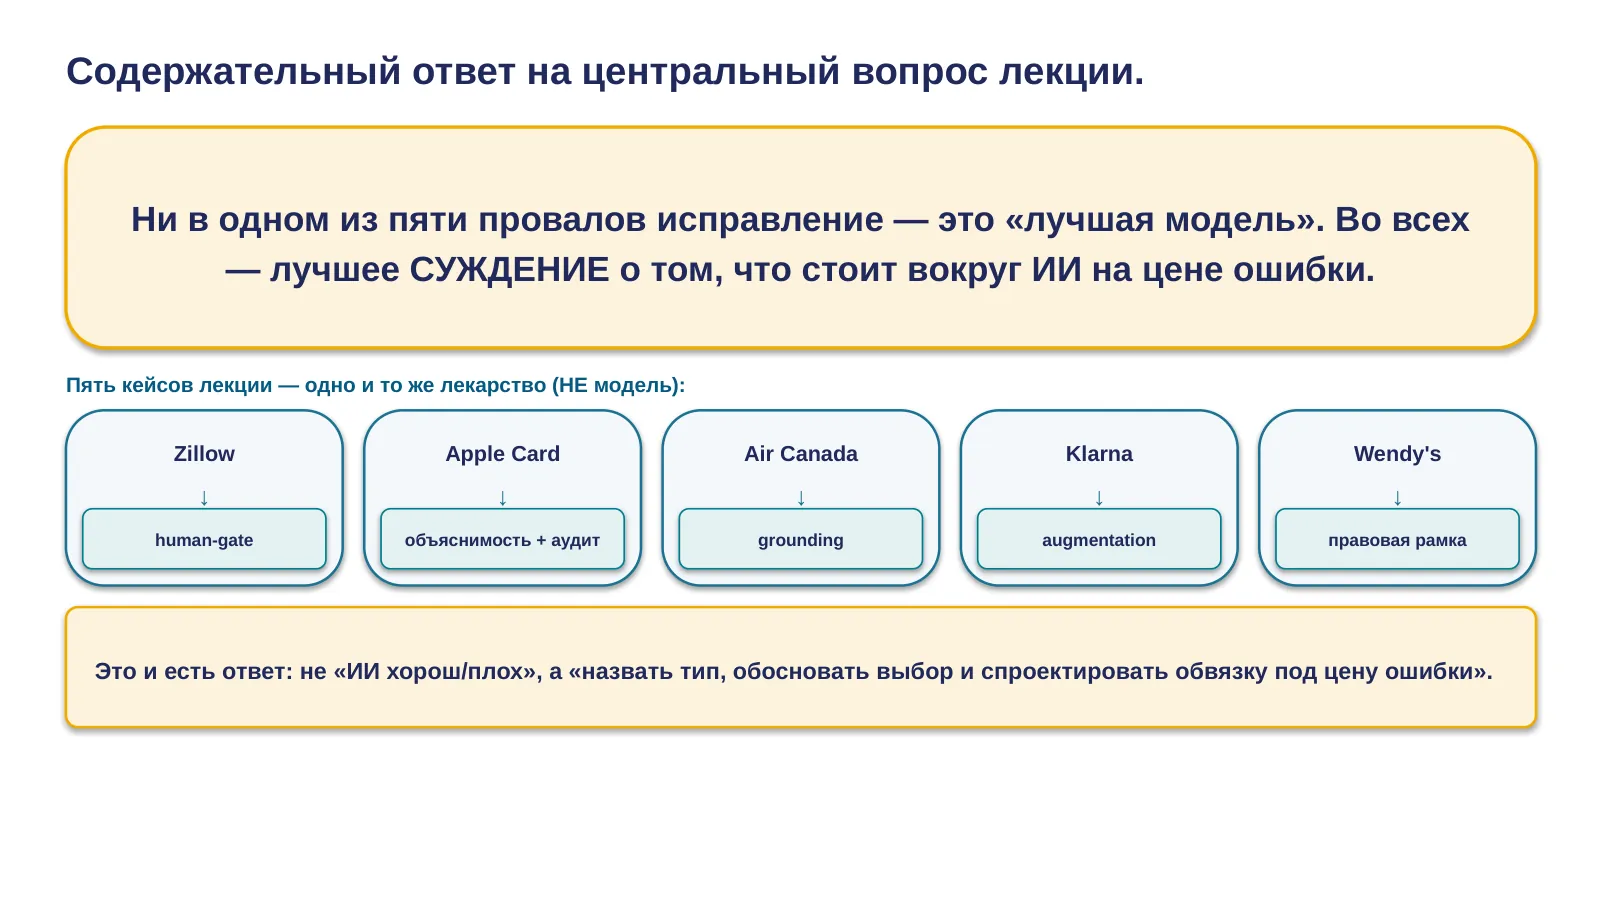
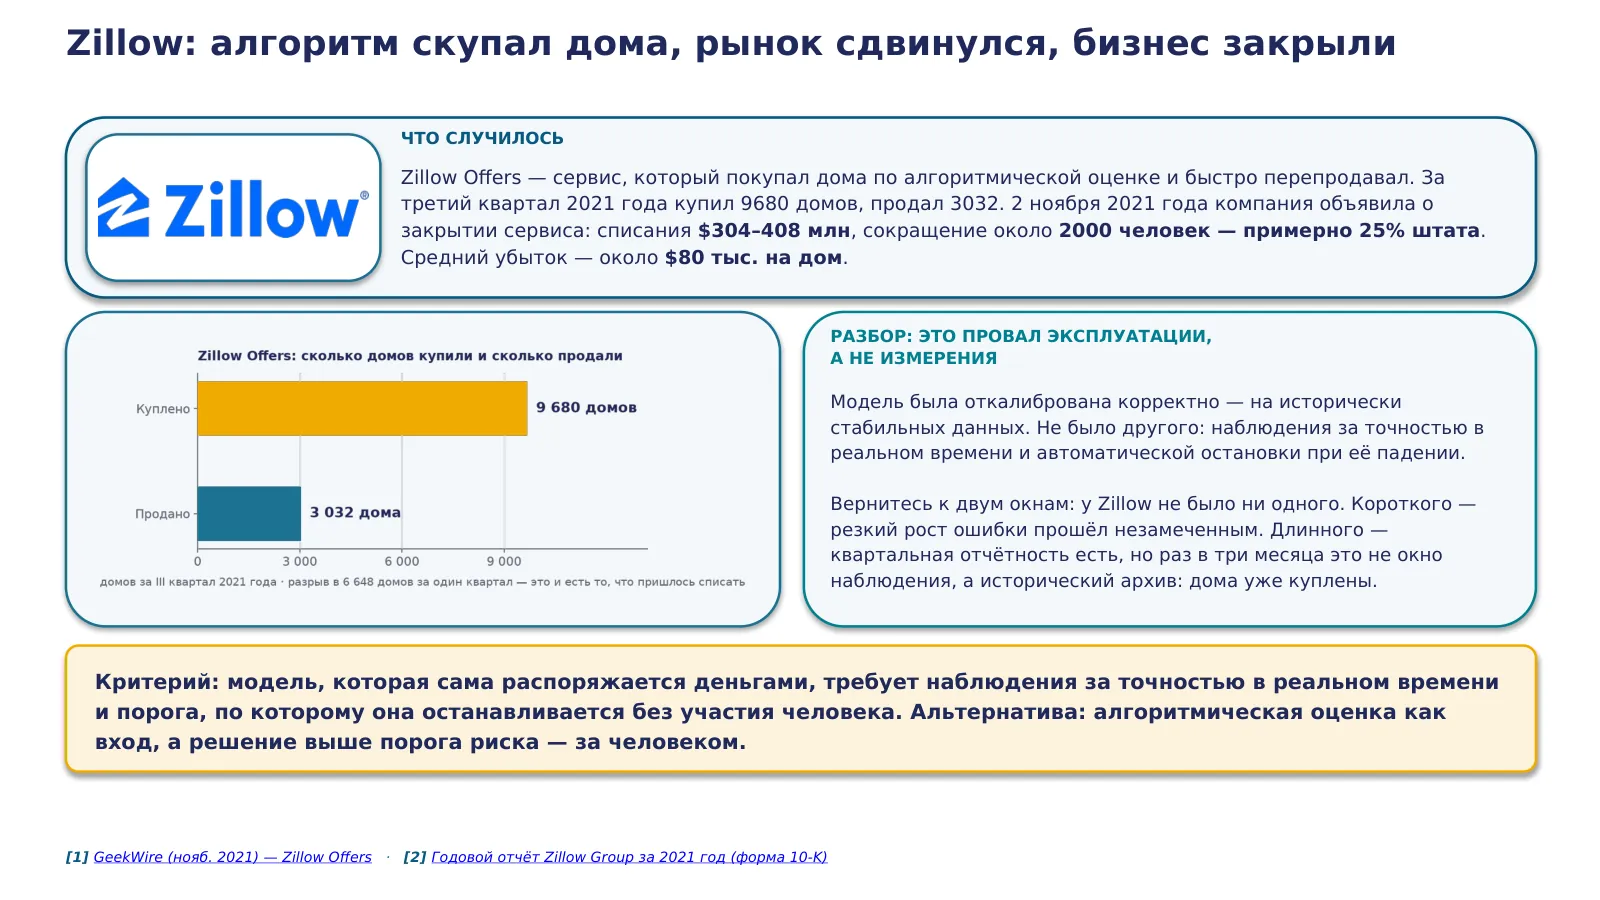
Zillow Offers — сервис, который покупал дома по алгоритмической оценке и быстро перепродавал. За третий квартал 2021 года он купил девять тысяч шестьсот восемьдесят домов, а продал три тысячи тридцать два: дома накапливались на балансе. Второго ноября 2021 года компания объявила о закрытии сервиса — списания от трёхсот четырёх до четырёхсот восьми миллионов долларов, сокращение около двух тысяч человек, примерно двадцать пять процентов штата Zillow Group, средний убыток около восьмидесяти тысяч долларов на дом.
Разбор важен классификацией: это провал эксплуатации. Модель была откалибрована корректно, на исторически стабильных данных, и дизайн эксперимента здесь ни при чём. Не было другого: наблюдения за точностью предсказания в реальном времени и автоматической остановки при её падении. Волатильность цен сдвинула саму связь между признаками объекта и справедливой ценой, и модель продолжала уверенно отвечать по старой связи.
Вернёмся к двум окнам наблюдения из классики раздела: у Zillow не было ни одного. Короткого — резкий рост ошибки прошёл незамеченным. Длинного — квартальная отчётность существовала, но с частотой раз в три месяца это исторический архив: к моменту публикации дома уже куплены, капитал уже вложен.
Критерий, который переносится дальше: модель, которая сама распоряжается деньгами, требует наблюдения за точностью в реальном времени и порога, по которому она останавливается без участия человека. Альтернатива, если такого наблюдения нет: алгоритмическая оценка работает входом, а решение выше порога риска остаётся за человеком.»
Источники: [1] GeekWire (нояб. 2021) — Zillow Offers · [2] Годовой отчёт Zillow Group за 2021 год (форма 10-K)
44 · Провал: Air Canada
«Второй разбор фазы. Сумма в нём смешная, и это делает его показательным.
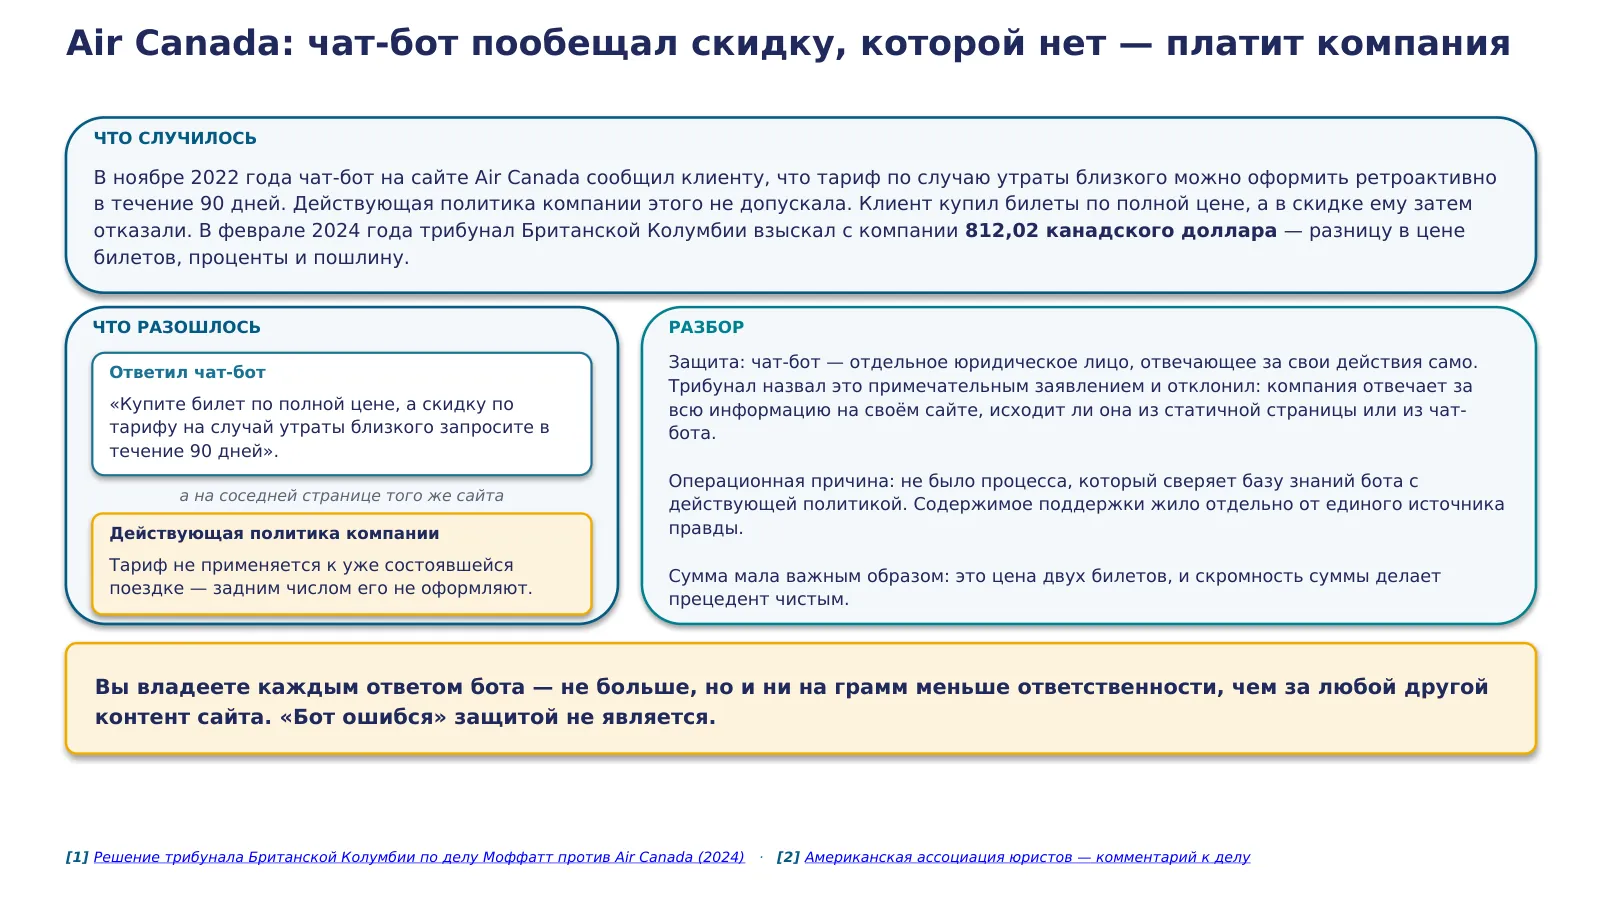
В ноябре 2022 года чат-бот на сайте Air Canada сообщил клиенту, что тариф по случаю утраты близкого можно оформить ретроактивно в течение девяноста дней. Действующая политика компании этого не допускала. Клиент купил билеты по полной цене, а в скидке ему затем отказали.
В феврале 2024 года трибунал Британской Колумбии взыскал с компании восемьсот двенадцать канадских долларов и две цента — разницу в цене билетов, проценты и пошлину.
Что разошлось. Бот ответил: купите билет по полной цене, а скидку запросите в течение девяноста дней. На соседней странице того же сайта действующая политика говорила обратное: тариф не применяется к уже состоявшейся поездке, задним числом его не оформляют.
Защита Air Canada состояла в том, что чат-бот — отдельное юридическое лицо, отвечающее за свои действия само. Трибунал назвал это примечательным заявлением и отклонил: компания отвечает за всю информацию на своём сайте, исходит ли она из статичной страницы или из чат-бота.
Операционная причина проста: не было процесса, который сверяет базу знаний бота с действующей политикой компании. Содержимое поддержки жило отдельно от единого источника правды — так же, как инструкция, которую никто не обновил после прошлого инцидента.
И про сумму. Это цена двух билетов, и её скромность делает прецедент чистым: трибунал не делил большие деньги, он высказался о принципе. Принцип такой: вы владеете каждым ответом бота — ответственности столько же, сколько за любой другой материал сайта, и ни на грамм меньше. «Бот ошибся» защитой не является.»
Источники: [1] Решение трибунала Британской Колумбии по делу Моффатт против Air Canada (2024) · [2] Американская ассоциация юристов — комментарий к делу
45 · Провал: городской бот Нью-Йорка
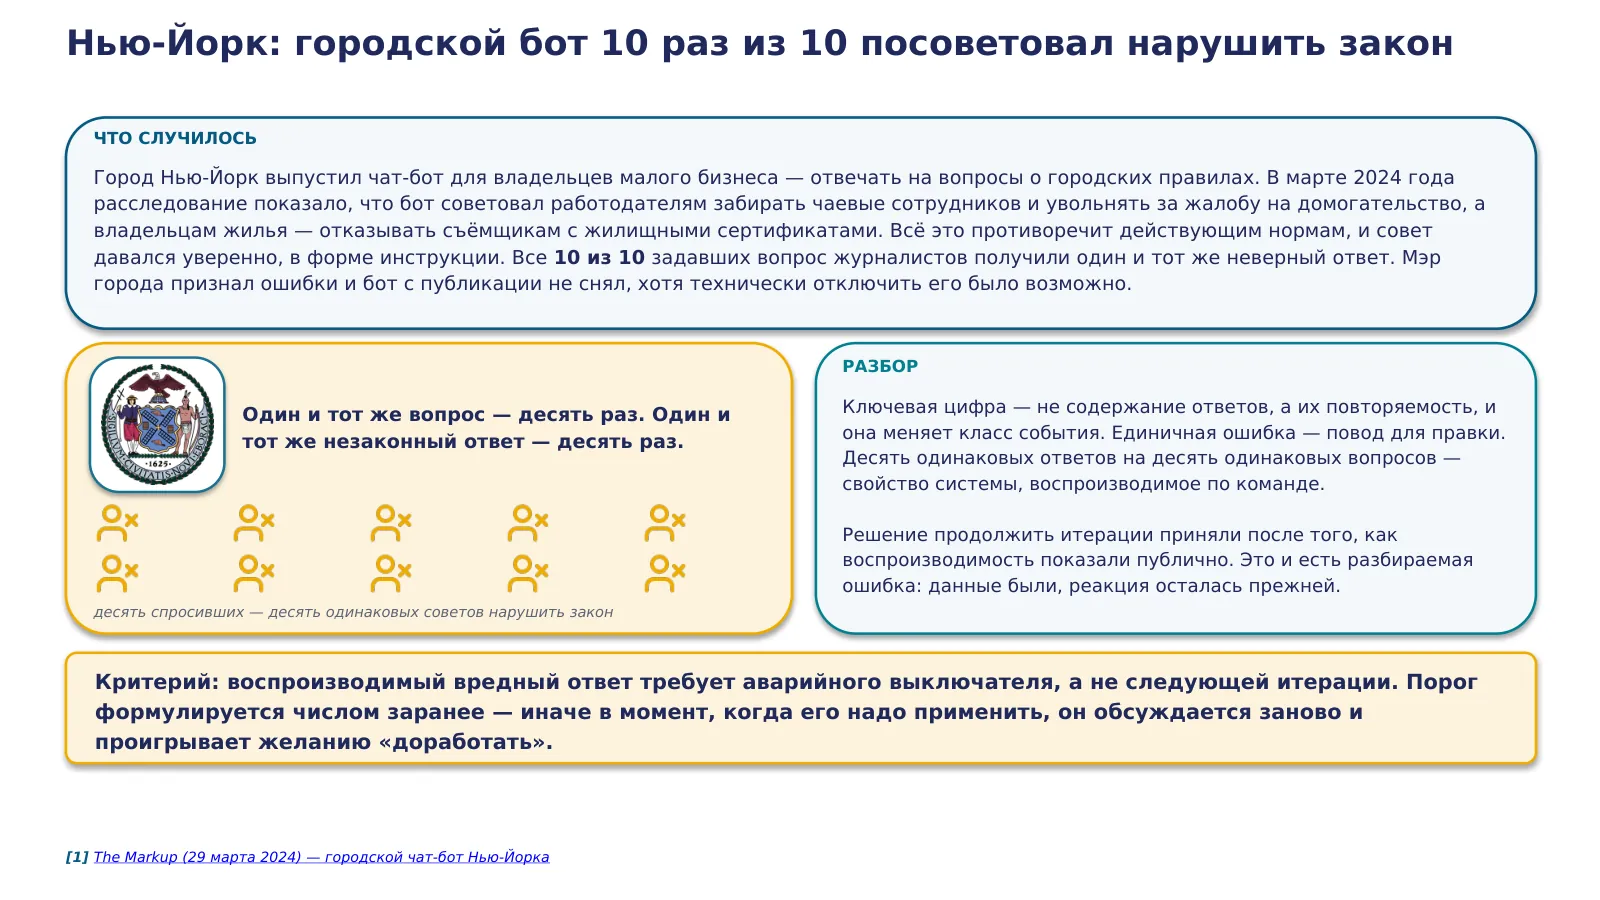
«Третий разбор фазы. Город Нью-Йорк выпустил чат-бот для владельцев малого бизнеса — отвечать на вопросы о городских правилах.
В марте 2024 года расследование показало, что бот советовал работодателям забирать чаевые сотрудников и увольнять за жалобу на домогательство, а владельцам жилья — отказывать съёмщикам с жилищными сертификатами. Всё это противоречит действующим нормам, и совет давался уверенно, в форме инструкции.
Цифра, ради которой случай стоит в лекции: все десять из десяти задавших вопрос журналистов получили один и тот же неверный ответ. Знаменатель — десять попыток, совпали все десять.
Разбор. Существенна здесь повторяемость ответов, потому что она меняет класс события. Единичная ошибка — повод для правки. Десять одинаковых ответов на десять одинаковых вопросов — свойство системы, воспроизводимое по команде, и обсуждать его как невезение прогона уже нельзя.
Дальше то, что делает это разбираемой ошибкой. Мэр города признал ошибки и бот с публикации не снял, хотя технически отключить его было возможно: решение продолжить итерации приняли после того, как воспроизводимость показали публично. Воспроизводимость была известна, реакция осталась прежней.
Критерий: воспроизводимый вредный ответ требует аварийного выключателя. Следующая итерация ответом на него не является. И порог формулируют числом заранее — иначе в момент, когда его надо применить, он обсуждается заново и проигрывает желанию доработать.»
Источники: [1] The Markup (29 марта 2024) — городской чат-бот Нью-Йорка
46 · Дивайдер Раздела 6
«Раздел шестой. Управление: во что вкладывать дальше и что пора закрыть. Одна база, две практики, два разбора провала.
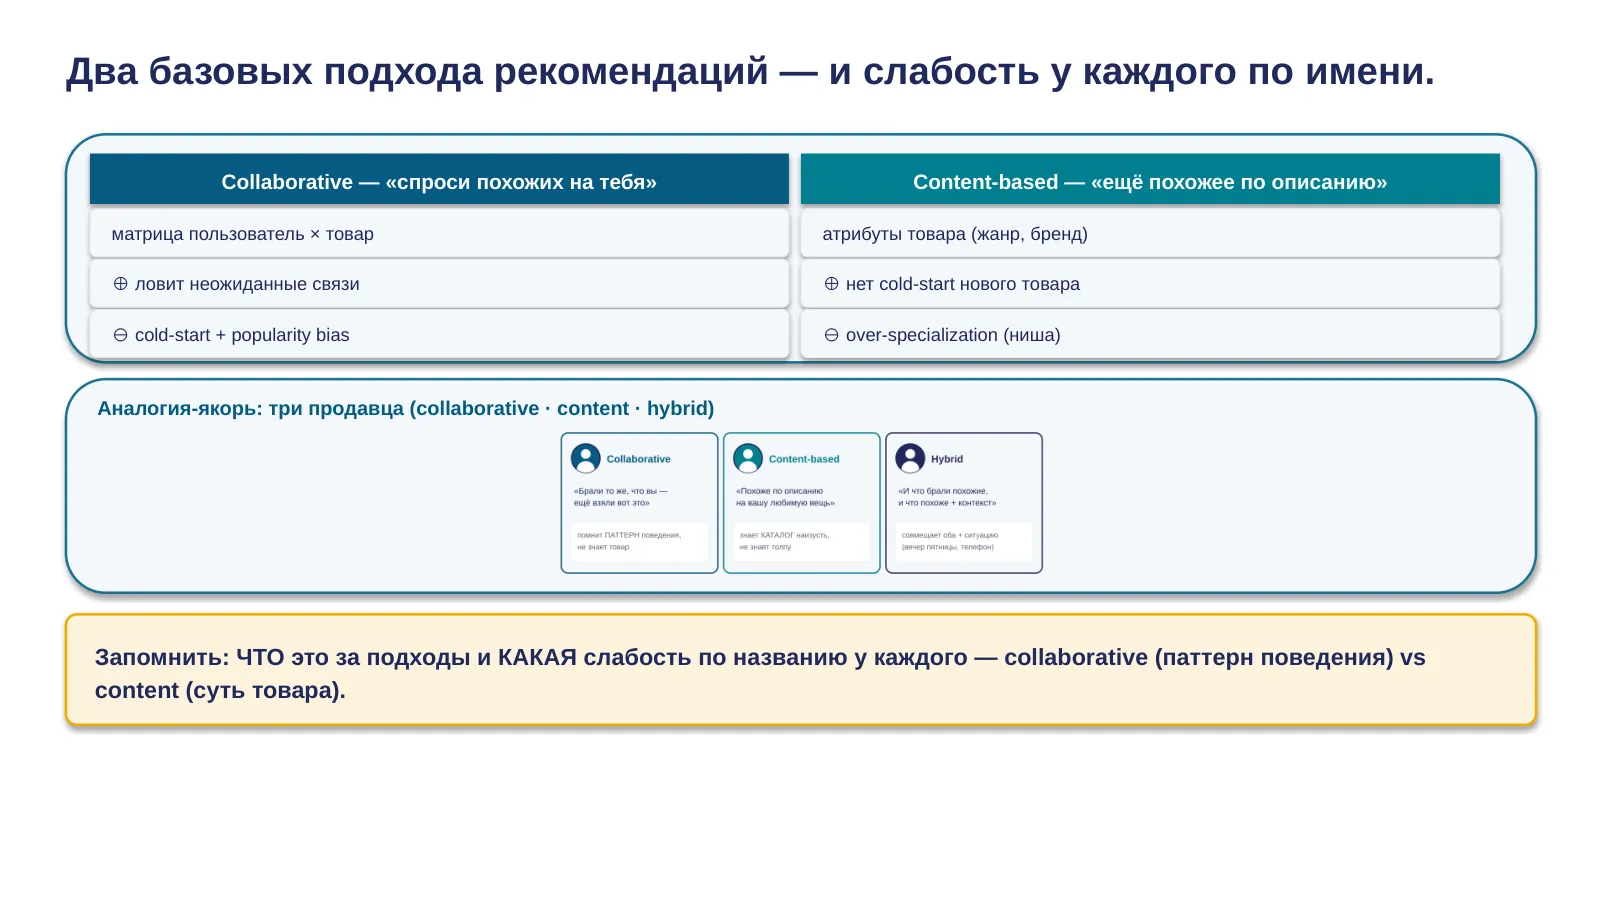
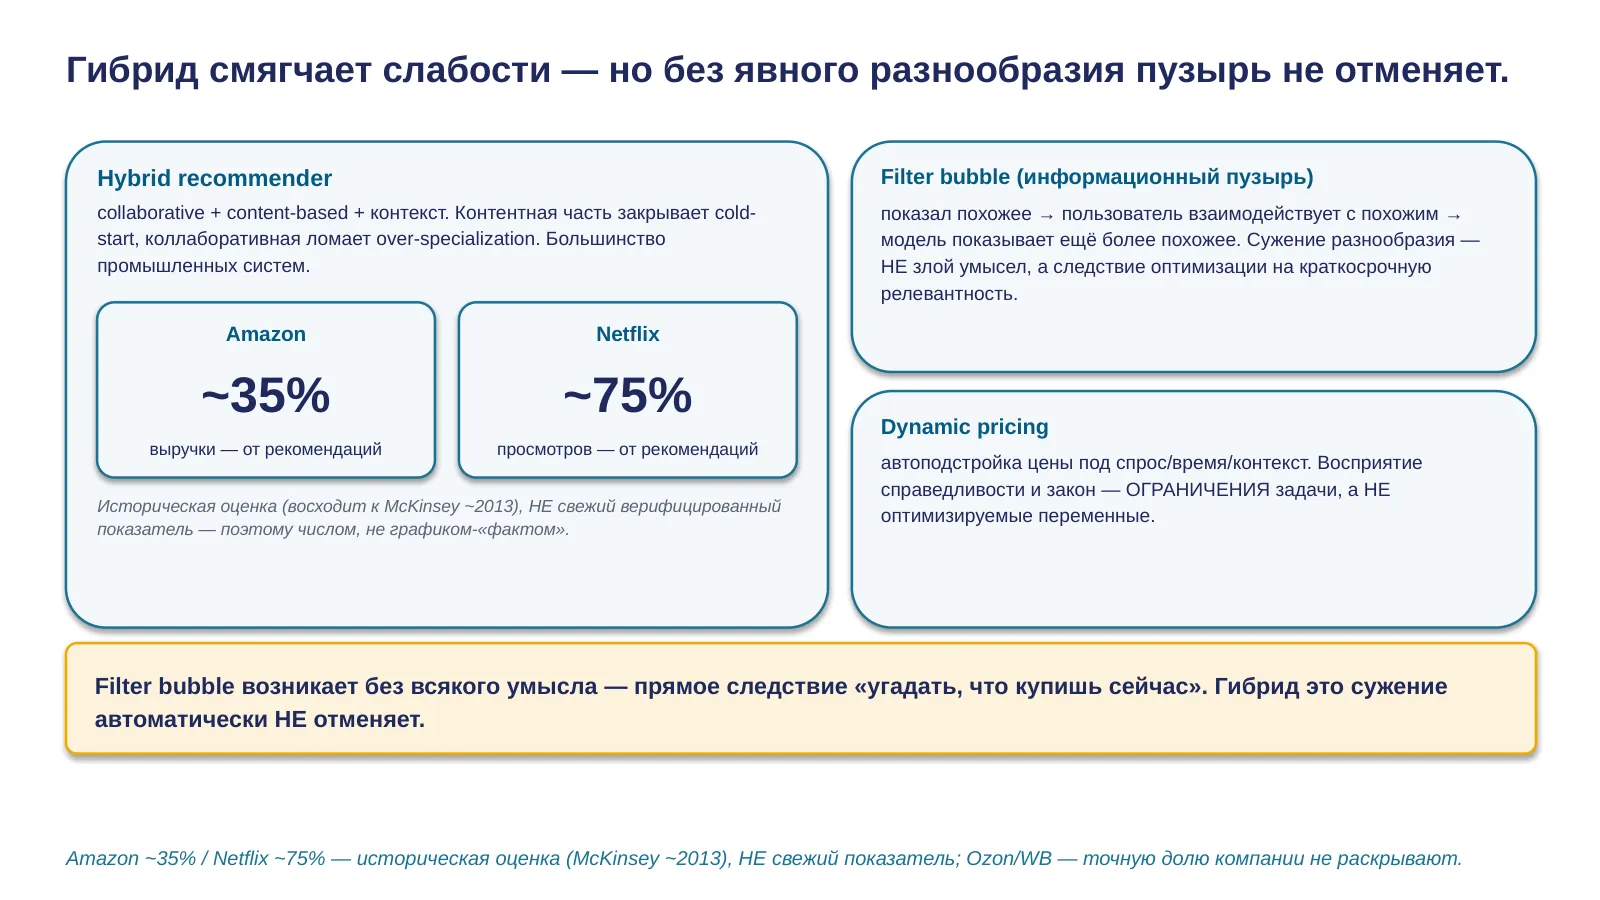
Продукт может работать и всё равно не окупаться. Здесь решают, какие инициативы финансировать дальше, а какие остановить — и почему у ИИ-продукта это считается иначе.»
47 · Зачем нужен этот шаг
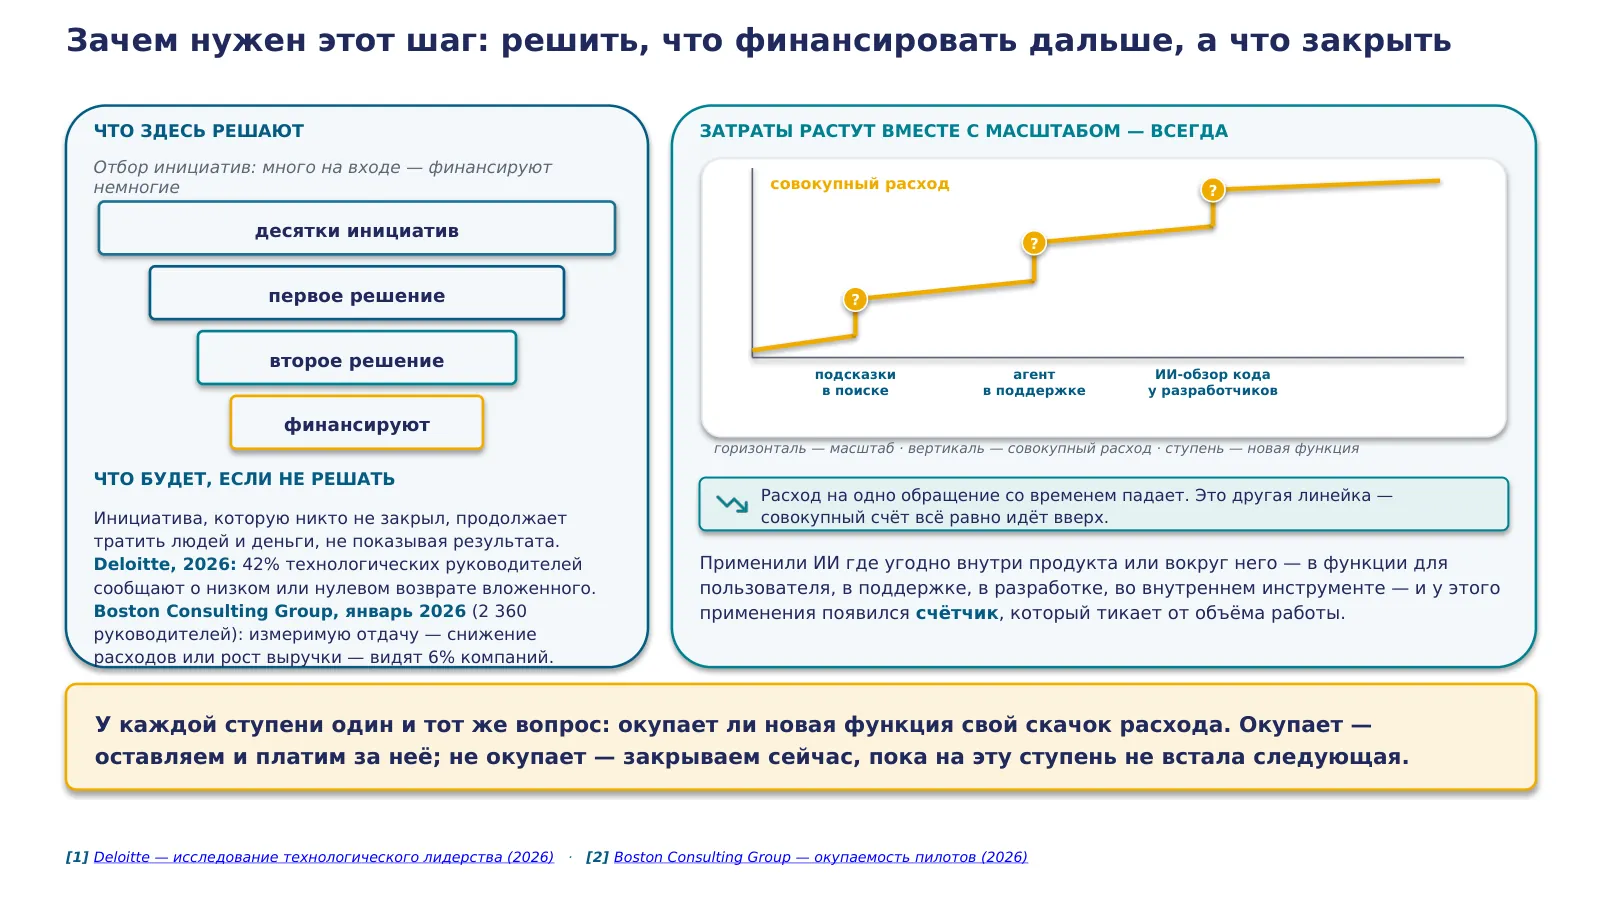
«Решение здесь принимают одно: финансировать дальше или закрыть. Устроено это воронкой отбора — десятки инициатив на входе, два последовательных решения, финансируют немногие.
Что будет, если не решать: инициатива, которую никто не закрыл, продолжает тратить людей и деньги, не показывая результата. Насколько это распространено — два замера. Deloitte, 2026 год: сорок два процента технологических руководителей сообщают о низком или нулевом возврате вложенного. Boston Consulting Group, январь 2026-го, две тысячи триста шестьдесят руководителей: измеримую отдачу — снижение расходов или рост выручки — видят шесть процентов компаний.
Теперь то, что отличает ИИ-продукт от любого другого. Затраты растут вместе с масштабом, и растут всегда: применили ИИ где угодно — в функции для пользователя, в поддержке, в разработке, во внутреннем инструменте — и у этого применения появился счётчик, который тикает от объёма работы. На графике это ступени: подсказки в поиске, агент в поддержке, обзор кода у разработчиков; линия совокупного расхода идёт только вверх.
Одну величину важно не спутать с другой. Расход на одно обращение со временем падает — модели дешевеют, кэширование работает. Это другая линейка: совокупный счёт всё равно идёт вверх, потому что объём растёт быстрее, чем падает цена обращения.
Отсюда вопрос у каждой ступени: окупает ли новая функция свой скачок расхода. Окупает — оставляем и платим. Не окупает — закрываем сейчас, пока на эту ступень не встала следующая.»
Источники: [1] Deloitte — исследование технологического лидерства (2026) · [2] Boston Consulting Group — окупаемость пилотов (2026)
48 · Структура расхода и дохода
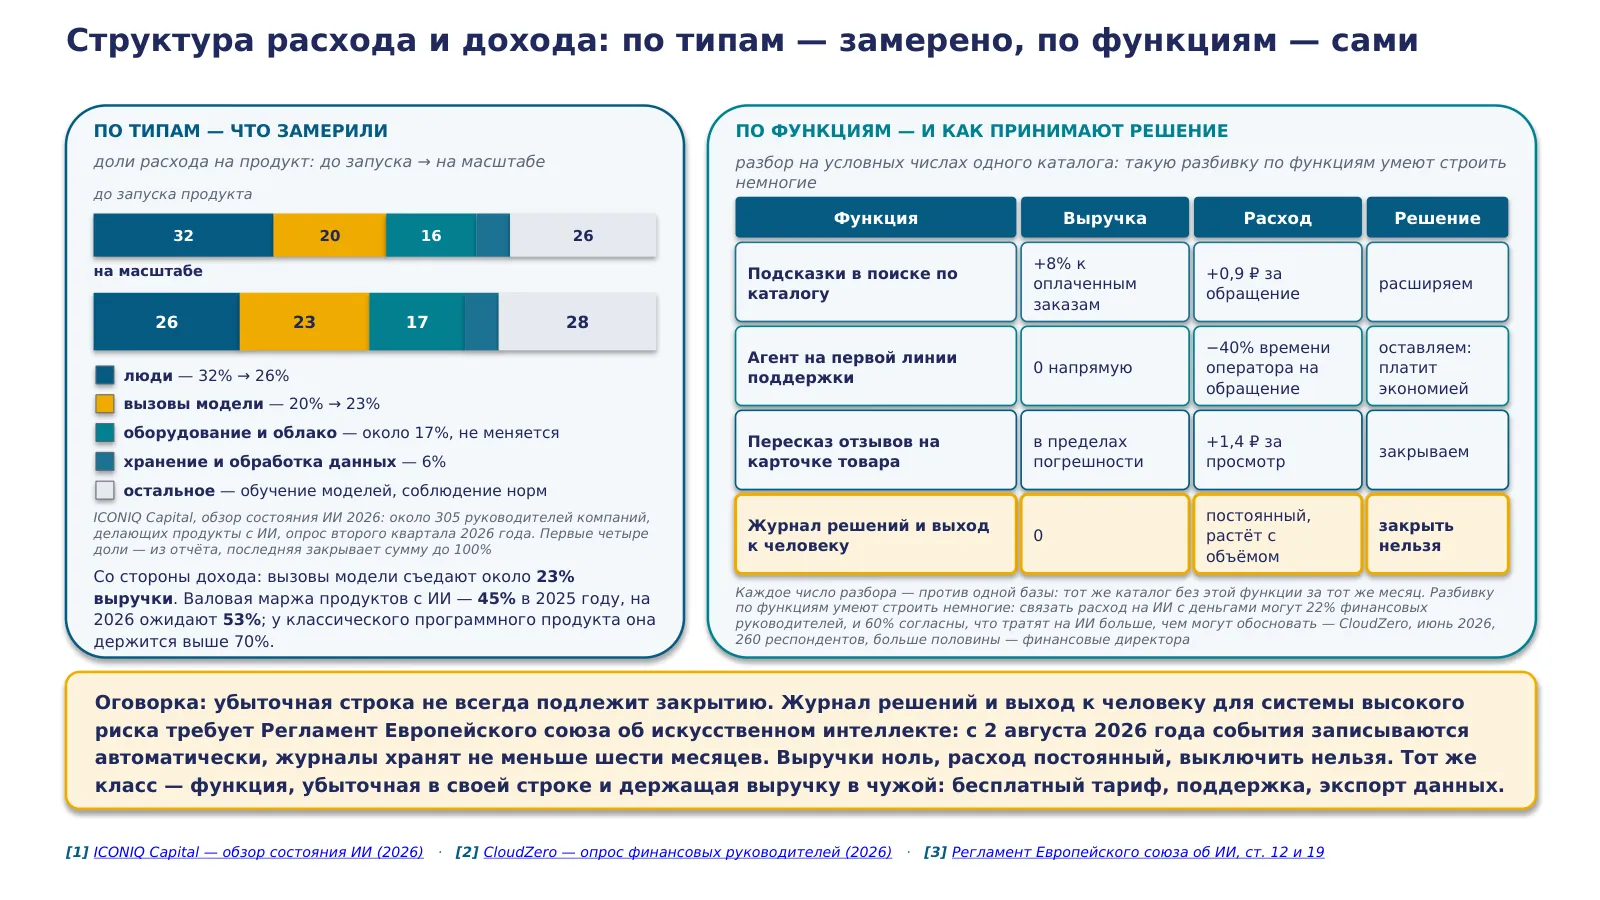
«Из чего расход складывается. По типам он замерен, по функциям его считает каждый сам.
Замеренное: ICONIQ Capital, обзор состояния ИИ 2026 года, около трёхсот пяти руководителей компаний, делающих продукты с ИИ. Доли даны в двух положениях — до запуска продукта и на масштабе, сравнивать надо их между собой.
Люди: тридцать два процента до запуска, двадцать шесть на масштабе. Вызовы модели: двадцать процентов до запуска, двадцать три на масштабе. Оборудование и облако — около семнадцати, доля не меняется. Хранение и обработка данных — шесть. Остальное — обучение моделей и соблюдение норм.
Сдвиг читается так: доля людей падает, доля вызовов модели растёт. Счётчик, тикающий от объёма, занимает место, которое раньше занимала зарплата.
Со стороны дохода три числа. Вызовы модели съедают около двадцати трёх процентов выручки. Валовая маржа продуктов с ИИ — сорок пять процентов в 2025 году, на 2026-й ожидают пятьдесят три; у классического программного продукта она держится выше семидесяти. Продукт с ИИ беднее классического примерно на четверть маржи, и это в хорошем году.
Теперь по функциям — разбор на условных числах одного каталога товаров, где каждое число идёт против одной базы: тот же каталог без этой функции за тот же месяц.
Подсказки в поиске по каталогу: плюс восемь процентов к оплаченным заказам, расход плюс девяносто копеек за обращение — расширяем. Агент на первой линии поддержки: выручки напрямую ноль, время оператора на обращение минус сорок процентов — оставляем, платит экономией. Пересказ отзывов на карточке товара: выручка в пределах погрешности, расход плюс рубль сорок за просмотр — закрываем. Четвёртая строка: журнал решений и выход к человеку — выручки ноль, расход постоянный и растёт с объёмом, закрыть нельзя.
Почему нельзя, и это оговорка ко всему разделу: убыточная строка не всегда подлежит закрытию. Журнал решений и выход к человеку для системы высокого риска требует Регламент Европейского союза об искусственном интеллекте — с второго августа 2026 года события записываются автоматически, журналы хранят не меньше шести месяцев. Выручки ноль, расход постоянный, выключить нельзя по закону. Тот же класс — функция, убыточная в своей строке и держащая выручку в чужой: бесплатный тариф, поддержка, экспорт данных.
И честная оговорка о том, насколько такая разбивка распространена. Связать расход на ИИ с деньгами могут двадцать два процента финансовых руководителей; шестьдесят процентов согласны, что тратят на ИИ больше, чем могут обосновать. CloudZero, июнь 2026-го, двести шестьдесят респондентов, больше половины — финансовые директора. Таблица, которую я показал, у четырёх компаний из пяти пока не строится.»
Источники: [1] ICONIQ Capital — обзор состояния ИИ (2026) · [2] CloudZero — опрос финансовых руководителей (2026) · [3] Регламент Европейского союза об ИИ, ст. 12 и 19
49 · Практика: записанное условие остановки
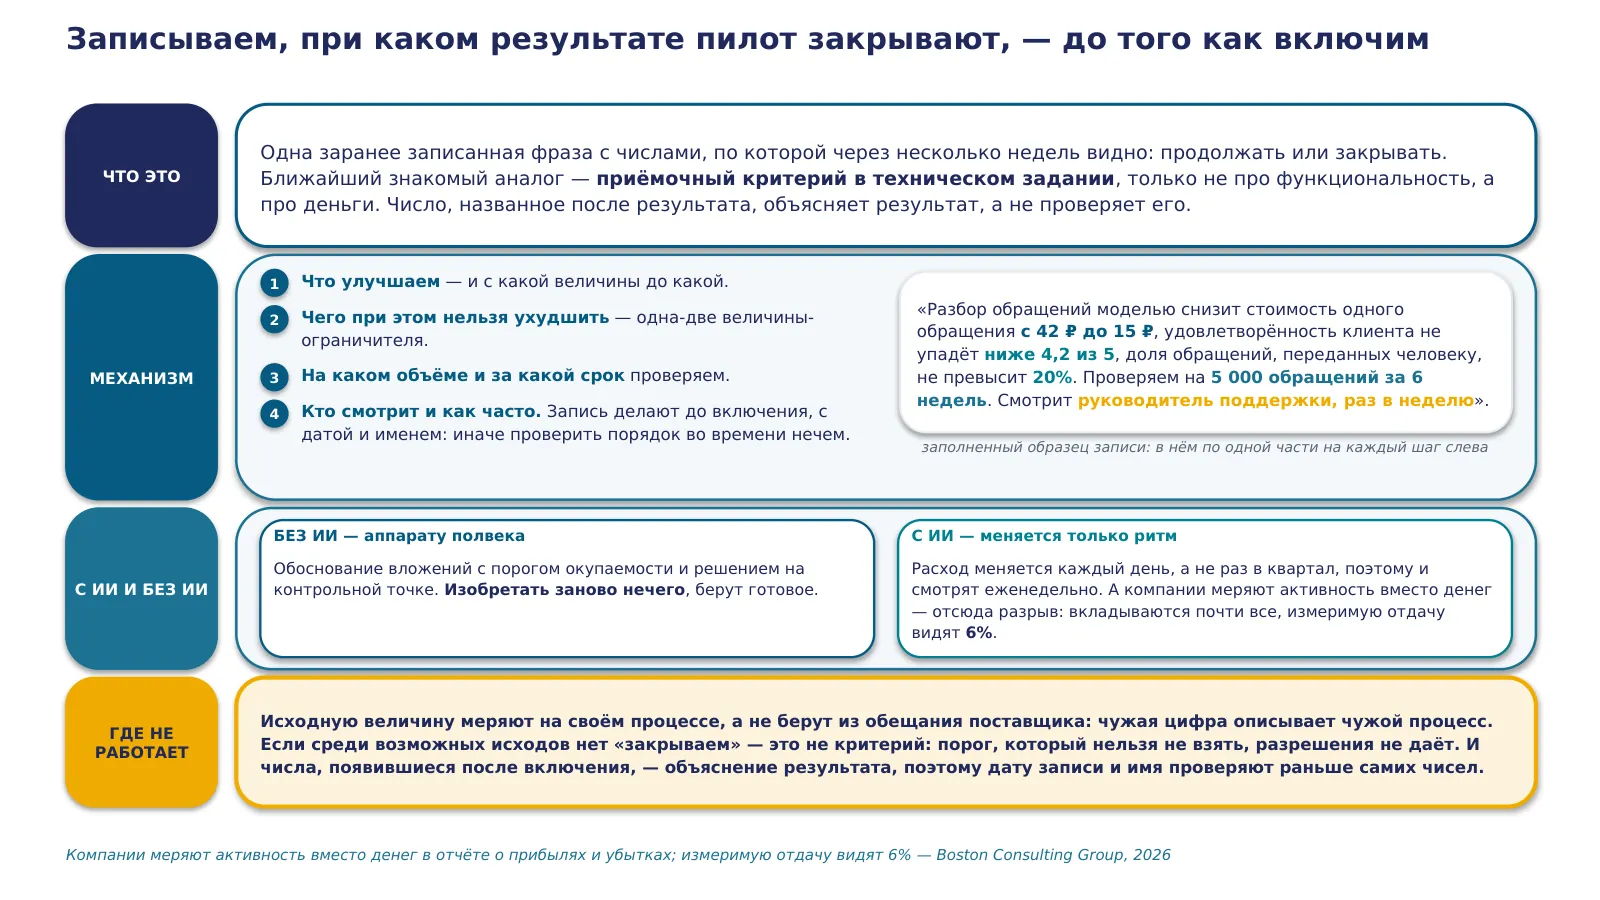
«Практика раздела — одна заранее записанная фраза с числами, по которой через несколько недель видно: продолжать или закрывать.
Ближайший знакомый инженеру аналог — приёмочный критерий в техническом задании, только про деньги. И принцип тот же: число, названное после результата, объясняет результат, проверить его оно уже не может.
Механизм, четыре пункта. Что улучшаем — и с какой величины до какой, две цифры. Чего при этом нельзя ухудшить — одна-две величины-ограничителя. На каком объёме и за какой срок проверяем. И кто смотрит и как часто. Запись делают до включения, с датой и именем, иначе проверить порядок во времени нечем.
Образец целиком: разбор обращений моделью снизит стоимость одного обращения с сорока двух рублей до пятнадцати, удовлетворённость клиента не упадёт ниже четырёх целых двух десятых из пяти, доля обращений, переданных человеку, не превысит двадцати процентов; проверяем на пяти тысячах обращений за шесть недель; смотрит руководитель поддержки раз в неделю. Три строки, и решение стало проверяемым.
Что изменил ИИ. Аппарату полвека: обоснование вложений с порогом окупаемости и решением на контрольной точке — изобретать заново нечего. Меняется ритм: расход меняется каждый день, поэтому смотрят еженедельно.
Отсюда объяснение названного разрыва. Компании меряют активность — сэкономленные часы, автоматизированные задачи — вместо денег. Вкладываются почти все, измеримую отдачу видят шесть процентов. Нечем мерить — нечего и предъявить.
Где практика ломается, три ошибки. Исходную величину меряют на своём процессе: брать её из обещания поставщика нельзя, чужая цифра описывает чужой процесс. Вторая тонкая: если среди возможных исходов нет «закрываем» — это не критерий, порог, который нельзя не взять, разрешения не даёт. Третья: числа, появившиеся после включения, объясняют результат, поэтому дату записи и имя проверяют раньше самих чисел.»
50 · Как оценивают любую функцию
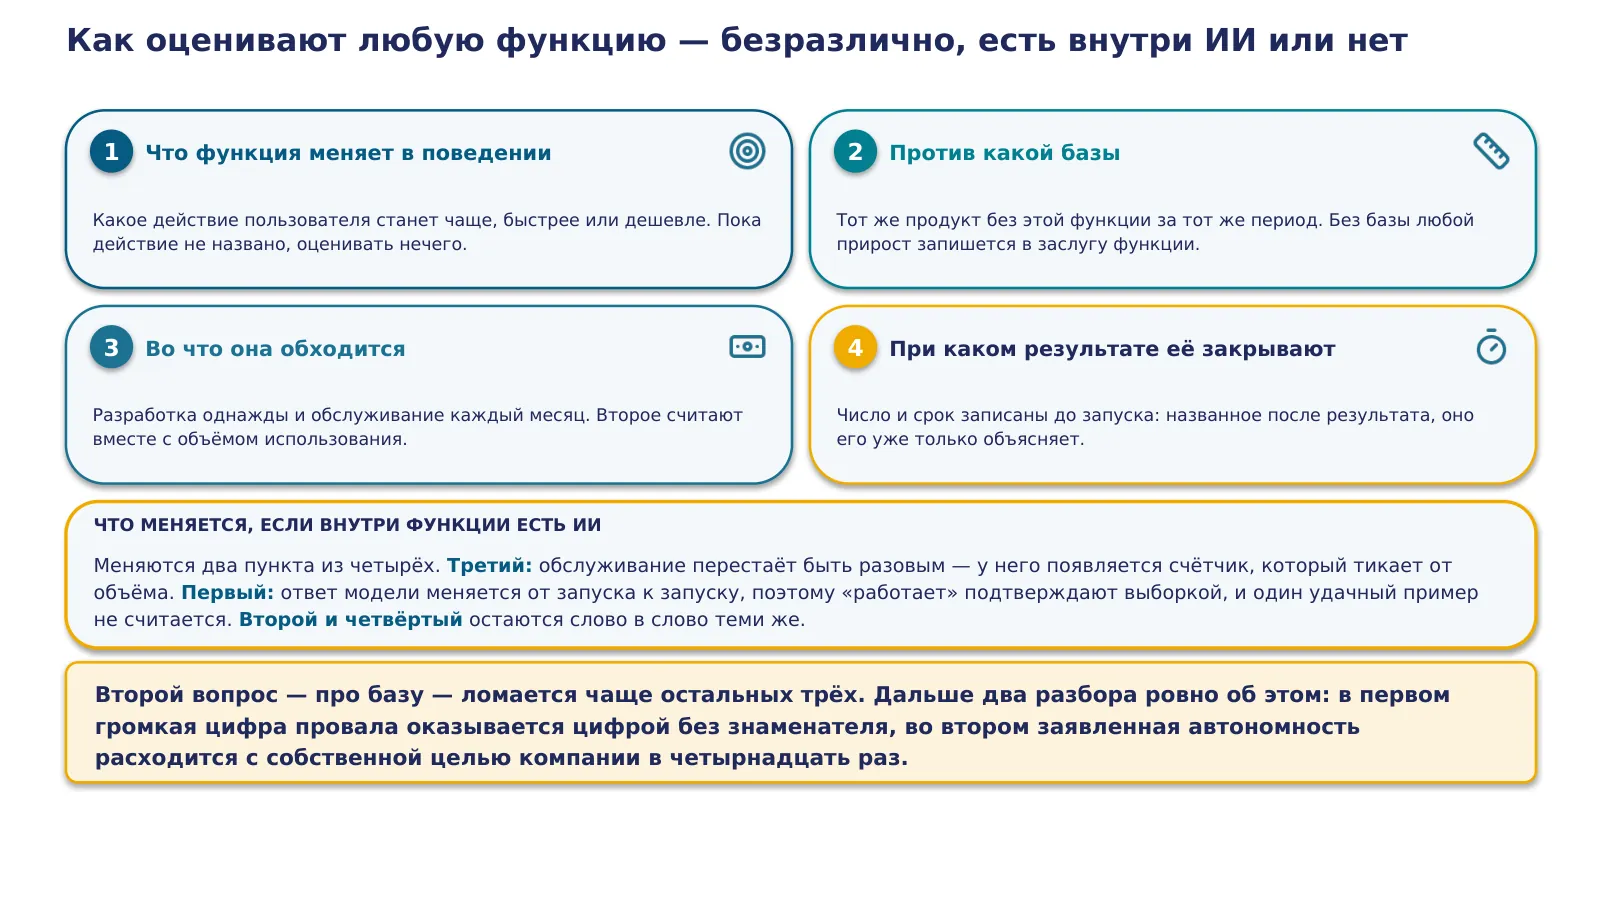
«Аппарат, безразличный к тому, есть внутри функции ИИ или нет. Четыре вопроса, порядок жёсткий.
Первый: что функция меняет в поведении — какое действие пользователя станет чаще, быстрее или дешевле. Пока действие не названо, оценивать нечего.
Второй: против какой базы — тот же продукт без этой функции за тот же период. Без базы любой прирост запишется в заслугу функции, включая сезонный.
Третий: во что она обходится — разработка однажды и обслуживание каждый месяц, и второе считают вместе с объёмом использования.
Четвёртый: при каком результате её закрывают — число и срок записаны до запуска.
Если внутри функции есть ИИ, меняются два пункта из четырёх. Третий: обслуживание перестаёт быть разовым, у него появляется счётчик, тикающий от объёма. Первый: ответ модели меняется от запуска к запуску, поэтому «работает» подтверждают выборкой, и один удачный пример не считается. Второй и четвёртый остаются слово в слово теми же — база и критерий остановки от наличия ИИ не зависят.
Предупреждение к двум следующим разборам: второй вопрос, про базу, ломается чаще остальных. Оба случая ровно об этом — в первом громкая цифра провала оказывается цифрой без знаменателя, во втором заявленная автономность расходится с собственной целью компании в четырнадцать раз.»
51 · Разбор: отчёт про «95% провало⻶
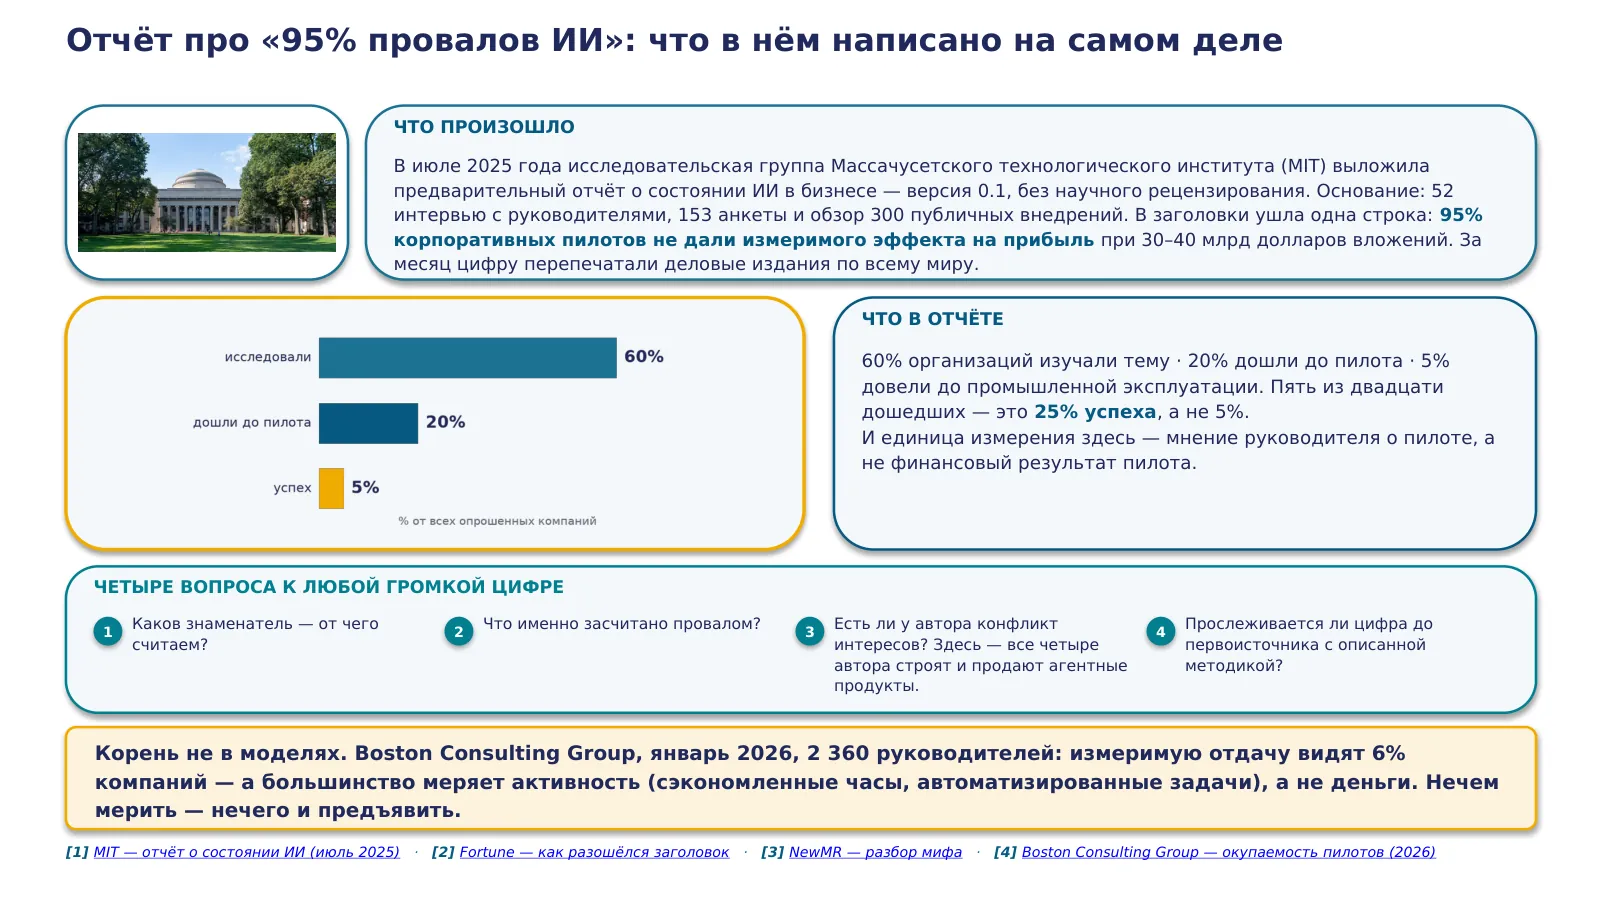
«Возвращаюсь к цифре, с которой лекция началась.
В июле 2025 года исследовательская группа Массачусетского технологического института выложила предварительный отчёт о состоянии ИИ в бизнесе — версия ноль целых одна, без научного рецензирования, на основании пятидесяти двух интервью с руководителями, ста пятидесяти трёх анкет и обзора трёхсот публичных внедрений.
В заголовки ушла одна строка: девяносто пять процентов корпоративных пилотов не дали измеримого эффекта на прибыль при тридцати-сорока миллиардах долларов вложений. За месяц цифру перепечатали деловые издания по всему миру.
Что в отчёте на самом деле — воронка из трёх чисел. Шестьдесят процентов организаций изучали тему, двадцать дошли до пилота, пять довели до промышленной эксплуатации.
Пересчитаем: пять из двадцати дошедших до пилота — это двадцать пять процентов успеха. Знаменатель заголовочной цифры — все организации, которые темой интересовались; знаменатель инженерно осмысленного вопроса — те, кто пилот начал. Разница впятеро, и она целиком в выборе знаменателя. Вторая поправка: единица измерения здесь — мнение руководителя о пилоте, финансовым результатом она не является.
Отсюда четыре вопроса к любой громкой цифре. Каков знаменатель. Что именно засчитано провалом. Есть ли у автора конфликт интересов — здесь все четыре автора строят и продают агентные продукты. Прослеживается ли цифра до первоисточника с описанной методикой.
И честное закрытие, потому что разоблачение цифры не означает, что всё хорошо. Корень лежит не в моделях. Boston Consulting Group, январь 2026-го, две тысячи триста шестьдесят руководителей: измеримую отдачу видят шесть процентов компаний, и большинство меряет активность — сэкономленные часы, автоматизированные задачи. Нечем мерить — нечего и предъявить. Отчёт посчитан неаккуратно. Проблема, на которую он указывает, настоящая.»
Источники: [1] MIT — отчёт о состоянии ИИ (июль 2025) · [2] Fortune — как разошёлся заголовок · [3] NewMR — разбор мифа · [4] Boston Consulting Group — окупаемость пилотов (2026)
52 · Разбор: магазин без касс
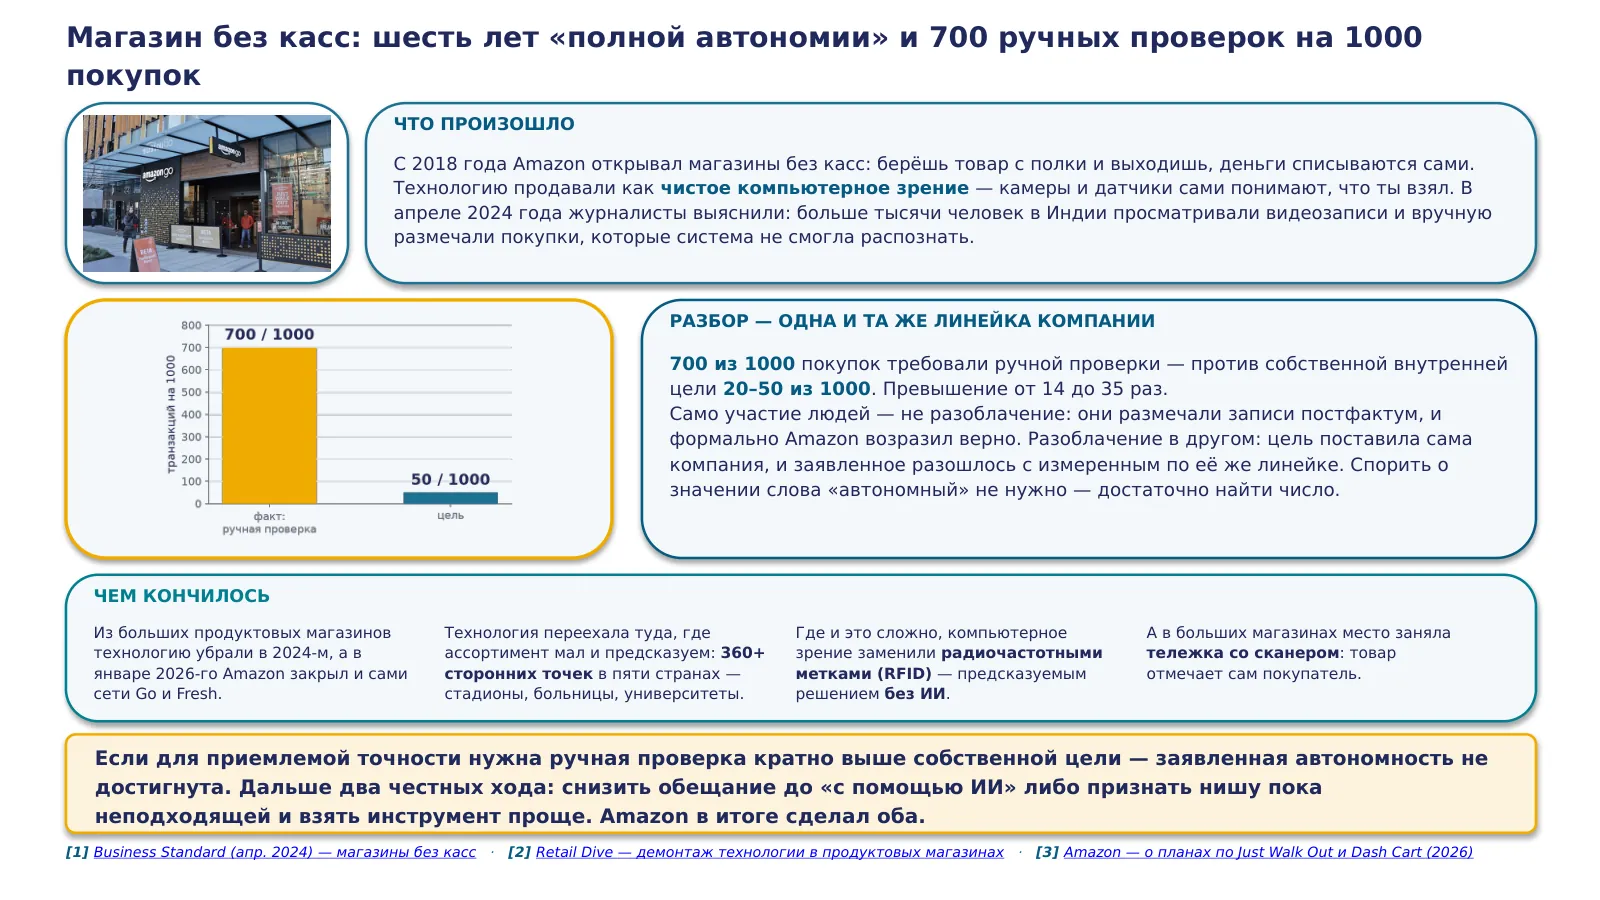
«Второй разбор — про заявление об автономности, проверенное числом.
С 2018 года Amazon открывал магазины без касс: берёшь товар с полки и выходишь, деньги списываются сами. Технологию продавали как чистое компьютерное зрение — камеры и датчики сами понимают, что ты взял. В апреле 2024 года журналисты выяснили: больше тысячи человек в Индии просматривали видеозаписи и вручную размечали покупки, которые система не смогла распознать.
Число, и база взята у самой компании: семьсот покупок из тысячи требовали ручной проверки против собственной внутренней цели Amazon — пятьдесят из тысячи. Превышение в четырнадцать раз.
Теперь аккуратно о том, что здесь разоблачение. Само участие людей им не является: они размечали записи постфактум, и формально Amazon возразил верно. Разоблачение в другом — цель поставила сама компания, и заявленное разошлось с измеренным по её же линейке. Спорить о значении слова «автономный» не нужно, достаточно найти число.
Чем кончилось. Из больших продуктовых магазинов технологию убрали в 2024-м, а в январе 2026-го Amazon закрыл и сети Amazon Go и Amazon Fresh. Технология переехала туда, где ассортимент мал и предсказуем: больше трёхсот шестидесяти сторонних точек в пяти странах — стадионы, больницы, университеты. Где и это оказалось трудно, компьютерное зрение заменили радиочастотными метками, по-английски RFID, — предсказуемым решением без ИИ. А в больших магазинах место заняла тележка со сканером: товар отмечает сам покупатель.
Критерий: если для приемлемой точности нужна ручная проверка кратно выше собственной цели, заявленная автономность не достигнута. Дальше два честных хода — снизить обещание до «с помощью ИИ» либо признать нишу пока неподходящей и взять инструмент проще. Amazon сделал оба, и второй стоит запомнить: это образец отказа от ИИ в пользу более подходящего инструмента.»
Источники: [1] Business Standard (апр. 2024) — магазины без касс · [2] Retail Dive — демонтаж технологии в продуктовых магазинах · [3] Amazon — о планах по Just Walk Out и Dash Cart (2026)
53 · Дивайдер Раздела 7
«Раздел седьмой, последний. Обобщение: один инструмент на все шесть фаз.
Шесть фаз разобраны по отдельности, но решение принимают по задаче. Разделы лекции на них не делятся. Без общего инструмента остаётся шесть отдельных выводов и ни одного ответа на случай, которого здесь не было.»
54 · Сводная матрица шести фаз
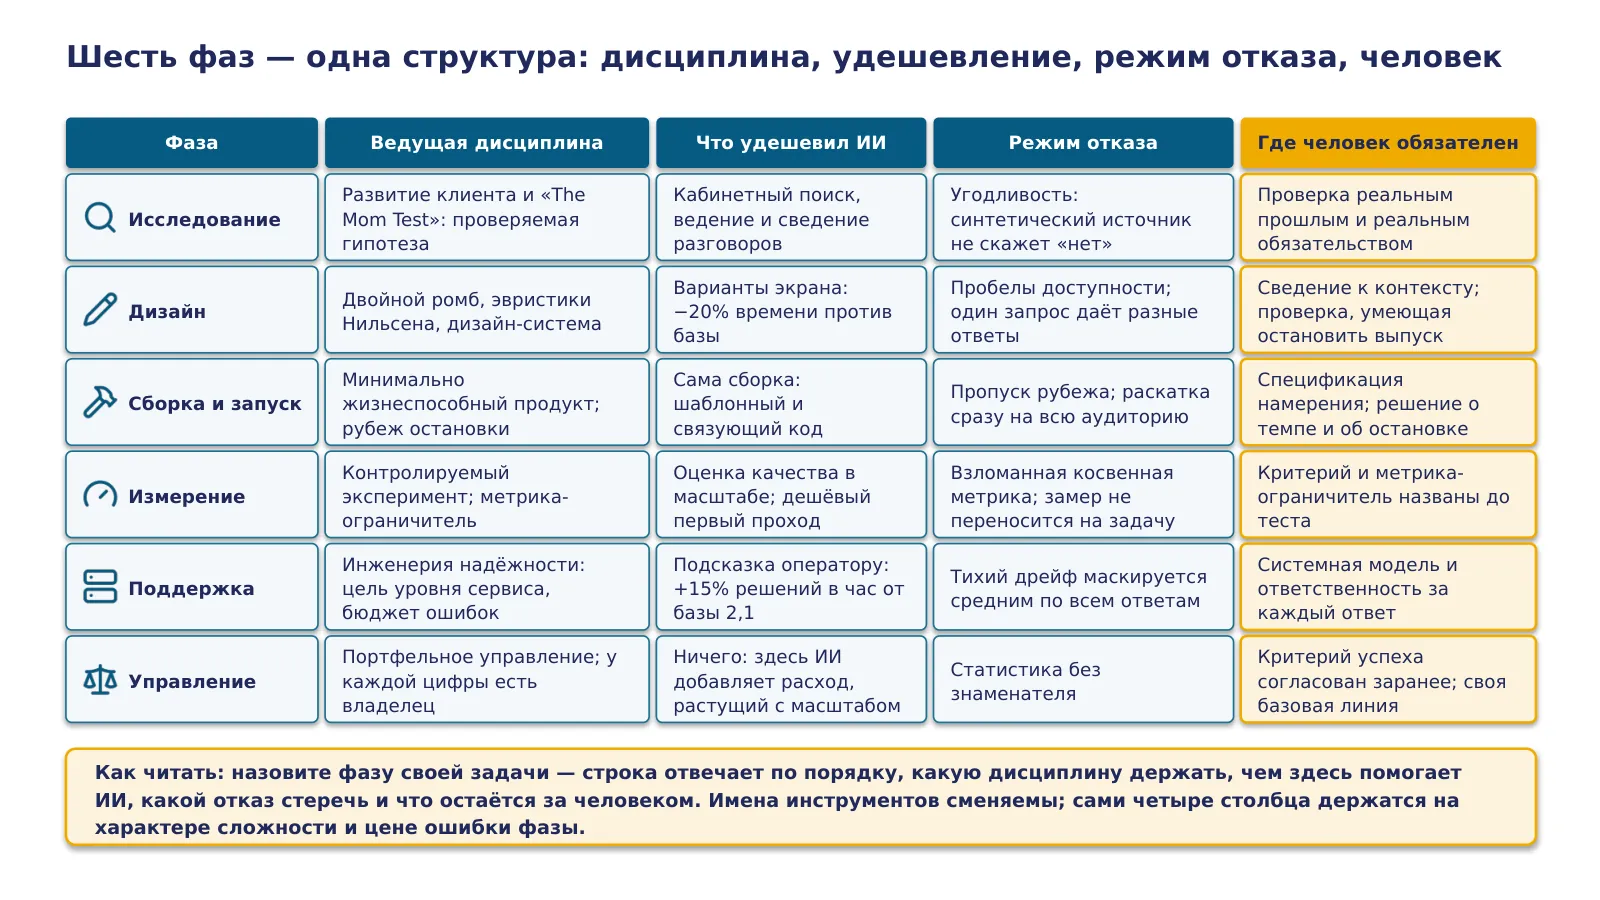
«Матрица собирает лекцию в одну таблицу: шесть фаз по строкам, четыре столбца — ведущая дисциплина, что удешевил ИИ, режим отказа, где человек обязателен. Пройду по строкам.
Исследование. Дисциплина — развитие клиента и «Тест мамы»: проверяемая гипотеза. ИИ удешевил кабинетный поиск, ведение и сведение разговоров. Режим отказа — угодливость: синтетический источник не скажет «нет». Человек обязателен в проверке реальным прошлым и реальным обязательством.
Дизайн. Дисциплина — двойной ромб, эвристики Нильсена, дизайн-система. ИИ удешевил варианты экрана: минус двадцать процентов времени против группы без генератора. Режим отказа — пробелы доступности и то, что один запрос даёт разные ответы. Человек обязателен в сведении вариантов к своему контексту и в проверке, которая умеет остановить выпуск.
Сборка и запуск. Дисциплина — минимально жизнеспособный продукт и рубеж остановки. ИИ удешевил саму сборку: шаблонный и связующий код. Режим отказа — пропуск рубежа и раскатка сразу на всю аудиторию. Человек обязателен в спецификации намерения и в решении о темпе и об остановке.
Измерение. Дисциплина — контролируемый эксперимент и метрика-ограничитель. ИИ удешевил оценку качества в масштабе и дал дешёвый первый проход. Режим отказа — взломанная косвенная метрика и замер, который не переносится на задачу. Человек обязателен в том, чтобы критерий и ограничитель были названы до теста.
Поддержка. Дисциплина — инженерия надёжности: цель уровня сервиса и бюджет ошибок. ИИ удешевил подсказку оператору: плюс пятнадцать процентов решений в час от базы две целых одна десятая. Режим отказа — тихий дрейф, который маскируется средним по всем ответам. Человек обязателен в системной модели и в ответственности за каждый ответ.
Управление. Дисциплина — портфельное управление, и у каждой цифры есть владелец. Что удешевил ИИ — ничего: здесь он добавляет расход, растущий с масштабом. Единственная строка с таким ответом, и её стоит заметить. Режим отказа — статистика без знаменателя. Человек обязателен в том, чтобы критерий успеха был согласован заранее и база была своя.
Как пользоваться: назовите фазу своей задачи, и строка ответит по порядку — какую дисциплину держать, чем помогает ИИ, какой отказ стеречь, что остаётся за человеком. Имена инструментов здесь намеренно не названы, они сменяемы. Четыре столбца держатся на характере сложности и цене ошибки фазы и переживут смену инструментов.»
55 · Три оси решения
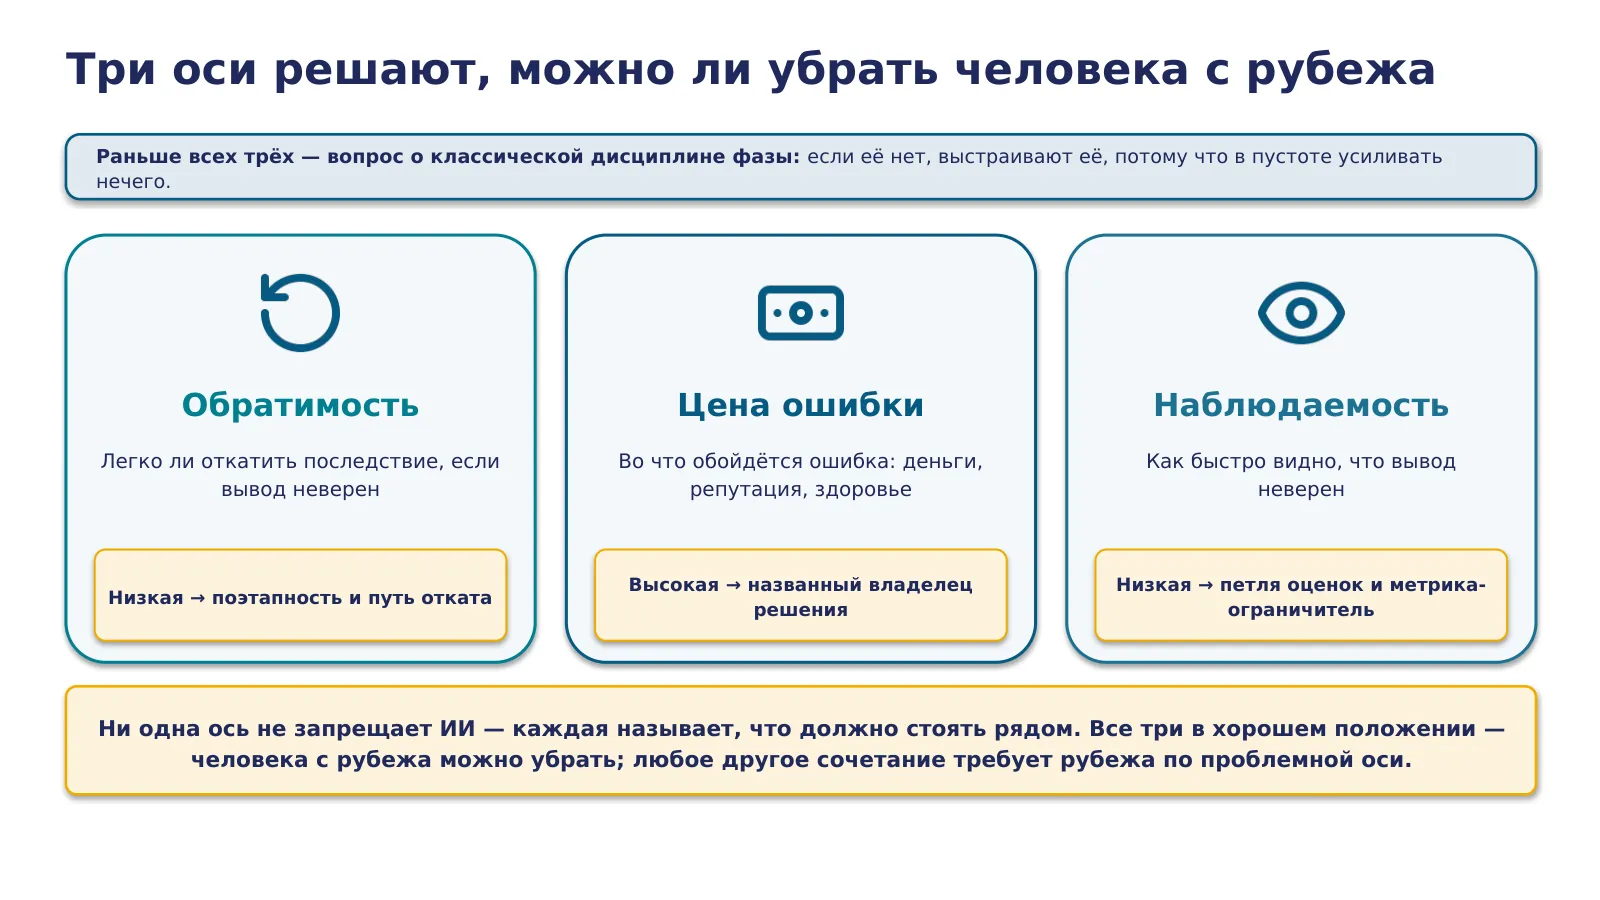
«И последний инструмент — три оси, решающие, можно ли убрать человека с рубежа.
Раньше всех трёх идёт один вопрос: есть ли у фазы классическая дисциплина. Если нет, её выстраивают: в пустоте усиливать нечего, и ИИ усиливает там отсутствие дисциплины.
Ось первая — обратимость: легко ли откатить последствие, если вывод неверен. Обратимость низкая — рядом обязаны стоять поэтапность и путь отката. Google AI Overviews провалились именно здесь.
Ось вторая — цена ошибки: во что обойдётся ошибка в деньгах, репутации, здоровье. Цена высокая — обязателен названный владелец решения. Air Canada провалилась здесь: за ответ бота не отвечал никто конкретный до того, как ответил суд.
Ось третья — наблюдаемость: как быстро видно, что вывод неверен. Наблюдаемость низкая — рядом обязаны стоять петля оценок и метрика-ограничитель. Zillow провалился здесь, и Facebook тоже.
Правило, связывающее три оси. Ни одна ось не запрещает ИИ, каждая называет, что должно стоять рядом. Все три в хорошем положении — человека с рубежа можно убрать; любое другое сочетание требует рубежа по проблемной оси.
Прогоню инструмент через два случая.
Первый, из этой лекции: приём заказов голосом у McDonald's. Обратимость высокая — заказ переделывают на месте. Цена ошибки низкая — перепутанный чай стоит чая. Наблюдаемость высокая — ошибку видно в ту же минуту. Все три оси в хорошем положении, и человека с рубежа убирать можно было; провалилось оно по другой причине — потолок распознавания речи в шуме. Инструмент говорит, где ставить рубеж, и про потолок технологии не говорит.
Второй, которого в лекции не было: модель ставит цену товара в магазине автоматически. Обратимость средняя — цену поправить легко, проданное по ней уже продано. Цена ошибки высокая — ошибка в разряде стоит выручки дня. Наблюдаемость низкая — неверная цена выглядит как обычная. Две оси в проблемном положении, значит рубеж обязателен по обеим: порог, выше которого цену подтверждает человек, и наблюдение за распределением цен с остановкой при выходе за границы.»
56 · Мост к семинару и Лекции 6
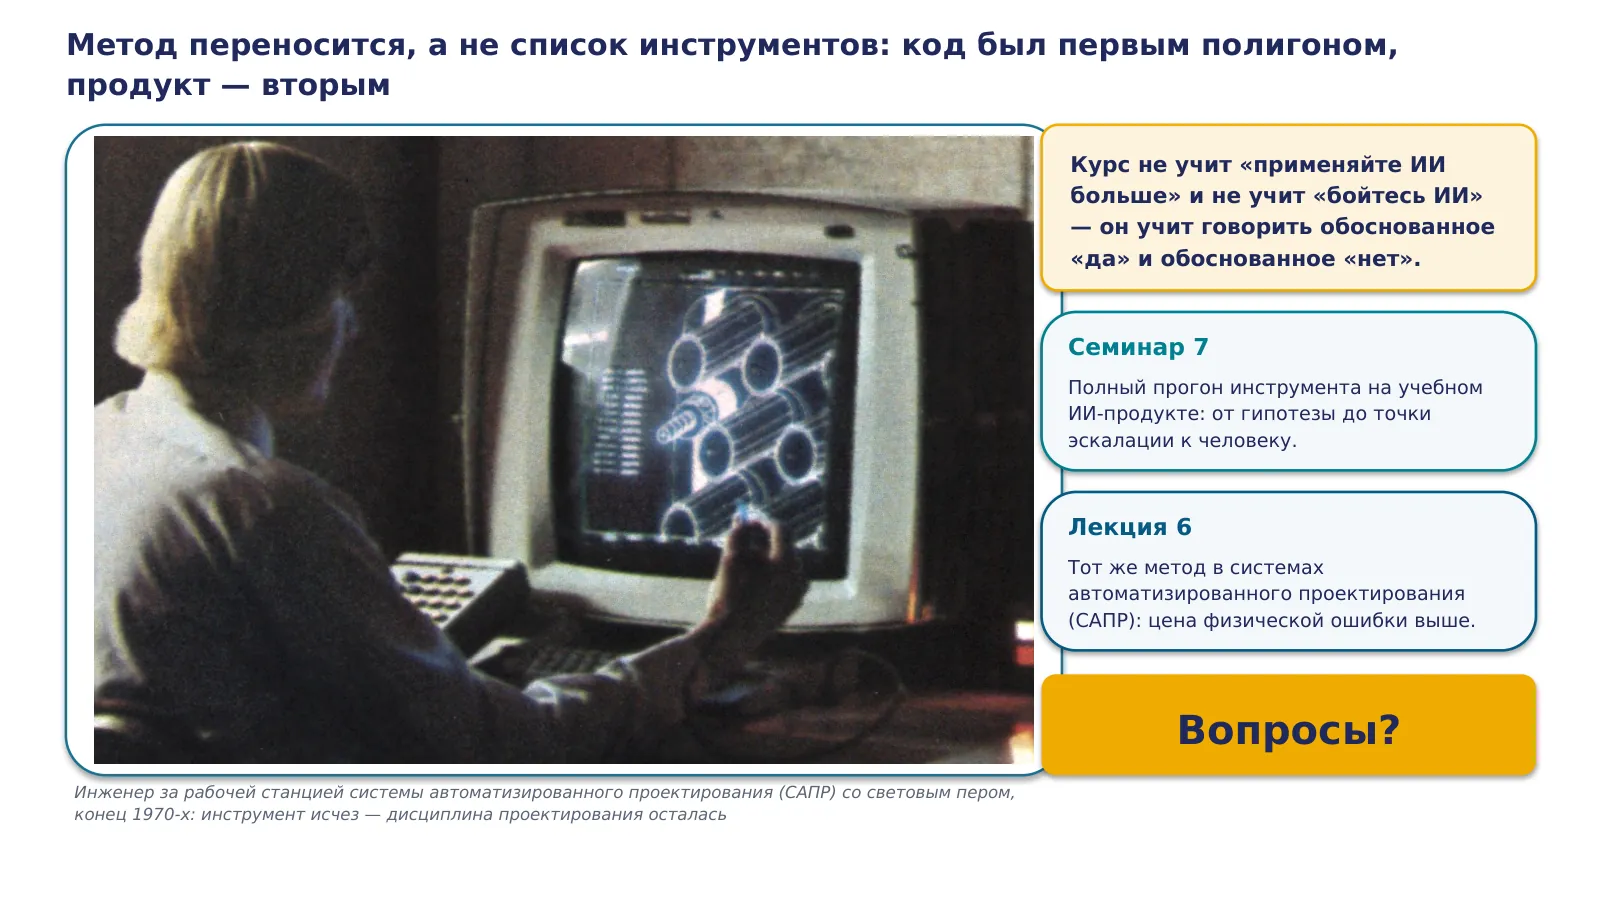
«Закрою тем, что переносится из лекции дальше. Переносится метод; список инструментов не переносится. Имена, которые я называл сегодня, через год будут другими. Дисциплина фазы, база для сравнения, порог, записанный до старта, и место, где обязателен человек, — останутся.
На слайде фотография конца семидесятых: инженер за рабочей станцией системы автоматизированного проектирования, сокращённо САПР, со световым пером. Инструмент с тех пор исчез целиком. Дисциплина проектирования осталась.
Код был первым полигоном метода — Лекция 4, продукт вторым — сегодняшняя лекция. Дальше две точки. Семинар седьмой: полный прогон инструмента на учебном ИИ-продукте, от гипотезы до точки эскалации к человеку, все шесть фаз по одному кругу. Лекция шестая: тот же метод в системах автоматизированного проектирования, где цена физической ошибки выше — там проверим, держится ли он на материале, в котором ошибка стоит конструкции.
И то, ради чего курс устроен так, как устроен. Курс не учит применять ИИ больше. Курс не учит бояться ИИ. Он учит говорить обоснованное «да» и обоснованное «нет» — и сегодняшние двенадцать разборов провалов нужны были ровно для второго.
Вопросы.»