Семинар 2. Когда ИИ, каким и на чём
Семинар 2 · 42 слайда
01 · Семинар 2. Когда ИИ, каким и на чём
Добрый день. Сегодня у нас семинар номер два, и формат простой: мы вместе разберём семь ситуаций, которые могли бы прийти к любому из вас с реальной работы. В каждой — кто-то просит «сделайте нам автоматизацию», и дальше инженеру нужно решить, что именно строить. Мы не будем читать лекцию и не будем вам ничего презентовать полчаса — будем разбирать конкретные истории вслух, все вместе, залом. Я буду показывать постановку задачи, вы будете говорить, что бы предложили, а потом почти в каждом кейсе появится деталь, которой не было в первой формулировке. Готовность пересмотреть решение при новых вводных — ровно тот навык, который нужен на реальной работе, когда заказчик формулирует задачу по частям, а не сразу целиком. Поехали.
02 · Сегодня — четыре выбора, семь кейсов
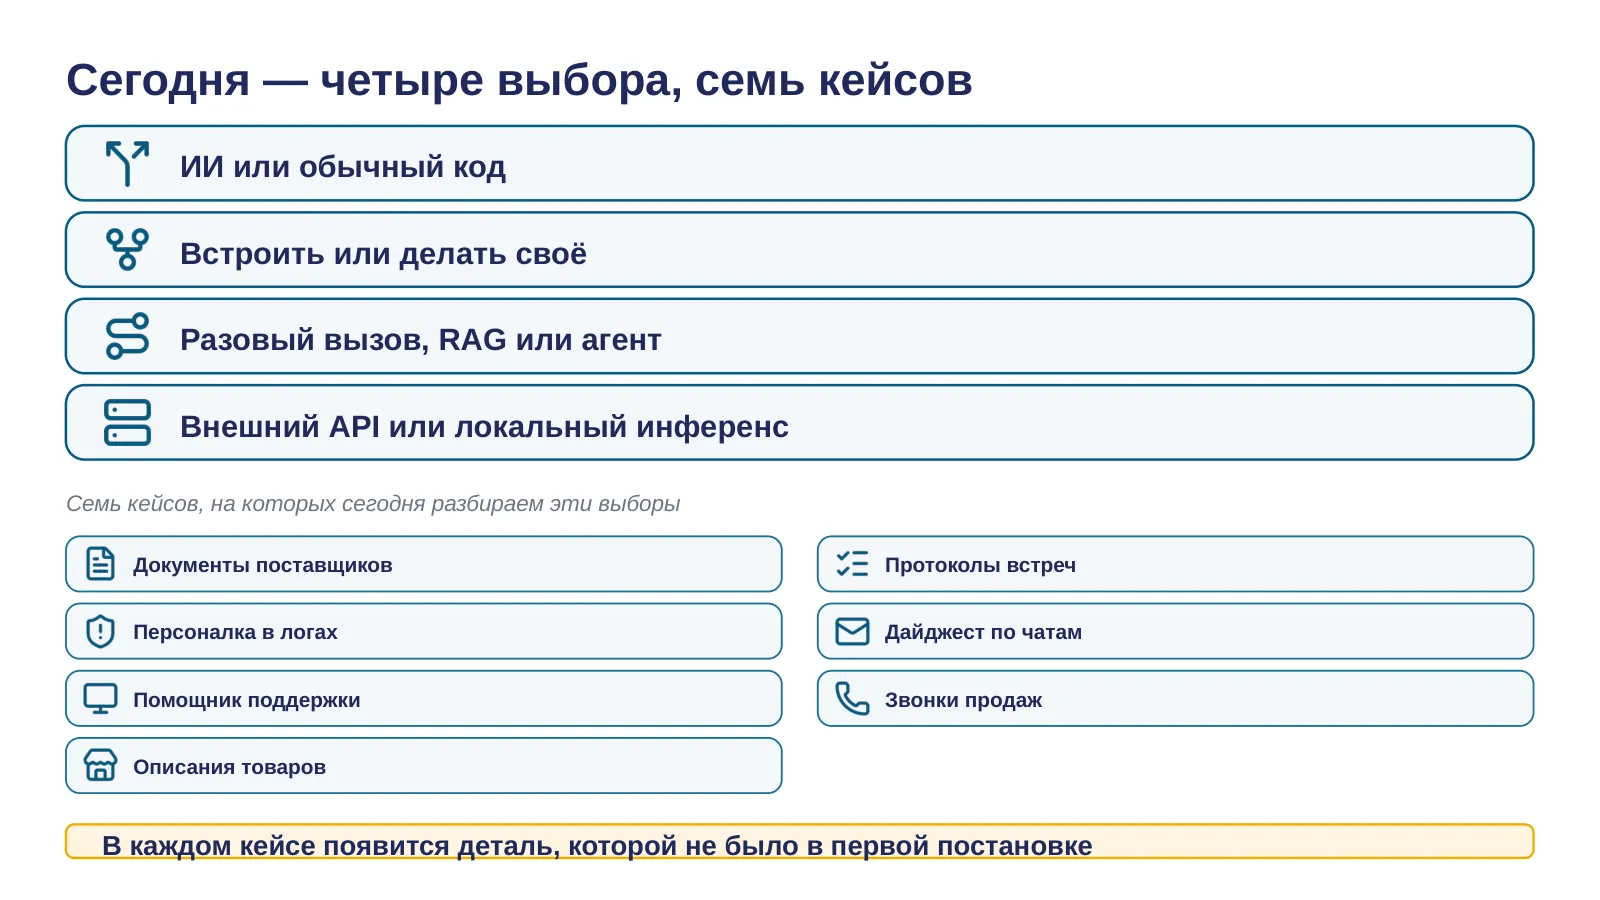
Вот что мы сегодня тренируем — четыре типа выбора, которые в инженерной практике возникают снова и снова: нужен ли здесь вообще ИИ или хватит обычного кода, встраивать решение в то, чем люди и так пользуются, или делать отдельный продукт, каким должен быть вызов модели — разовым, поиском по базе или многошаговым агентом, и, наконец, считать это через внешний облачный API или на своей инфраструктуре. Мы не превращаем это в процедуру с чек-листом — вместо этого разбираем семь реалистичных ситуаций: документы от поставщиков, персональные данные в логах, помощник для техподдержки, описания товаров, протоколы встреч, дайджест по рабочим чатам и звонки отдела продаж. В каждой — свой выбор и свои вводные. Смотрите на постановку критически с самого начала: чего вам не хватает, чтобы дать честный ответ, а не гадать?
03 · ИИ или обычный код?
Первый вопрос сегодня: когда задачу стоит решать обычным кодом, а когда без модели не обойтись. Инженеры часто решают это на глаз, по ощущению сложности задачи, а не по конкретному признаку, который можно было бы назвать словами. А цена ошибки здесь реальна в обе стороны. Поставить ИИ там, где хватило бы обычного кода, — значит получить решение дороже и непредсказуемее, чем нужно: код либо отрабатывает правильно, либо явно падает с ошибкой, а модель может тихо выдать правдоподобную ерунду и никого об этом не предупредить. Поставить обычный код там, где на самом деле нужна модель, — значит подписаться на вечную починку: каждый новый вариант входных данных ломает жёсткую логику, и кто-то должен снова и снова её латать. Общего рецепта «всегда бери то-то» не существует — есть признаки в самой задаче, которые стоит научиться замечать. Переходим к постановке.
04 · Бухгалтерия тонет в накладных поставщиков — можно автоматом?
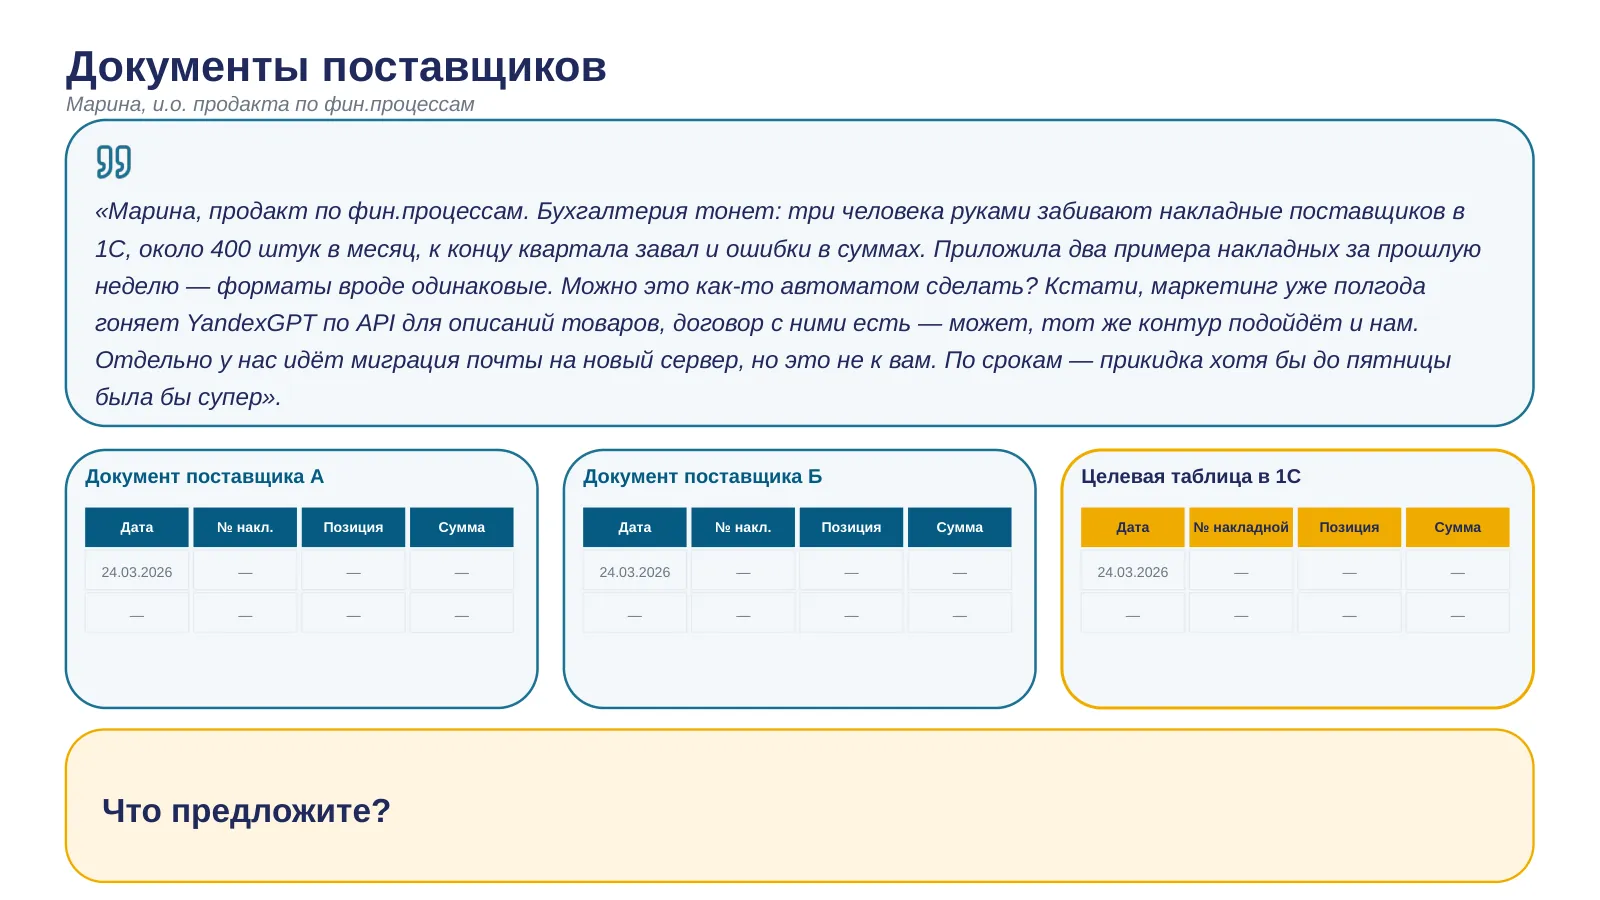
Зачитайте цитату продакта целиком, не сокращая — студенты должны сами выловить из неё то, что относится к задаче. Прямые сигналы: три человека, около 400 накладных в месяц, всё руками в 1С, к концу квартала завал и ошибки, два примера накладных, где форматы «вроде одинаковые». Косвенный сигнал, который стоит отдельно вытащить в обсуждении: у компании уже есть контракт и живой опыт работы с LLM по API (маркетинг и YandexGPT) — это не меняет архитектурный выбор для этой задачи напрямую, но снимает вопрос «а вообще можно ли нам гонять данные через внешний API» до того, как он всплывёт как гипотетический риск. Миграция почты — шум-двойник: звучит как ИТ-факт про инфраструктуру, но к парсингу накладных отношения не имеет. Покажите на слайде оба примера накладных и третью карточку — целевую таблицу в 1С с теми же полями (Дата / № накладной / Позиция / Сумма), чтобы аудитория сразу увидела совпадение структуры между источником и целью. Вопрос в зал: что вы предложите? Нужен ли здесь ИИ вообще, или можно обойтись без него? Какие конкретно поля вы бы вытаскивали, и что, на ваш взгляд, определяет сложность этой задачи? Кто готов высказаться первым? При разборе отдельно спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
05 · Прислали ZIP на 4,2 ГБ — и форматы разъехались
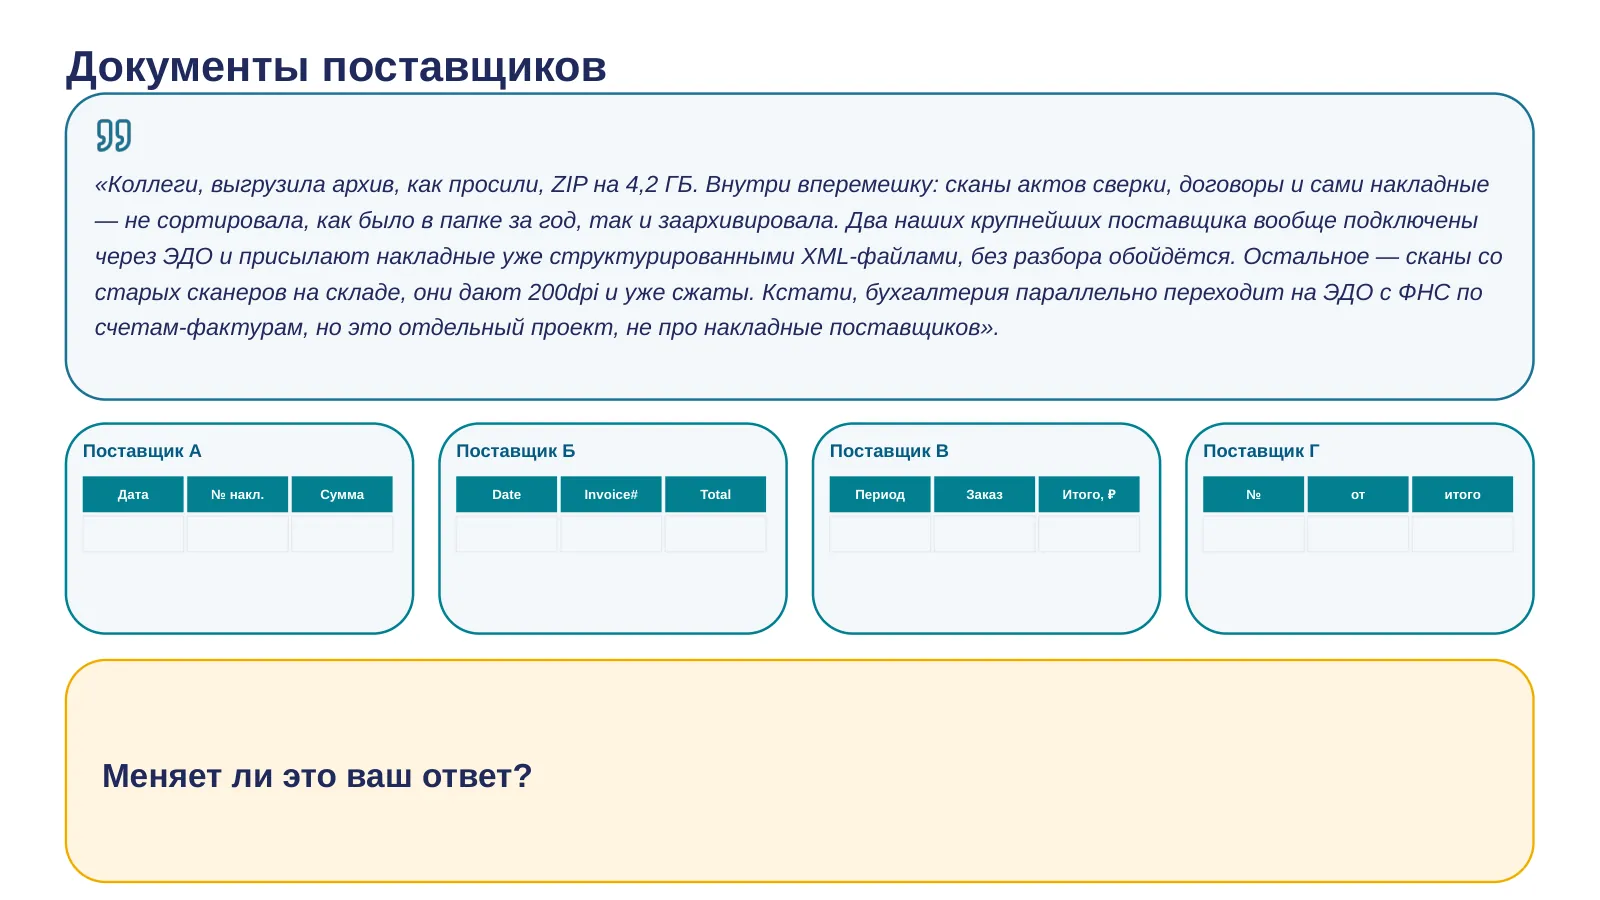
Зачитайте цитату бухгалтера. Прямой сигнал, не выделен интонацией: внутри архива вперемешку и сканы актов сверки, и договоры, и сами накладные, отсортировать заранее не просили. Косвенные сигналы стоит явно проговорить: часть потока (два крупнейших поставщика через ЭДО) уже приходит структурированными XML — этот кусок вообще не нуждается в LLM-извлечении; а качество сканов (200dpi со старых сканеров) — это ограничение снизу для точности OCR, если решение пойдёт через распознавание изображения. Переход бухгалтерии на ЭДО с ФНС — шум- двойник: похоже по теме, но это отдельный процесс про счета-фактуры в налоговую, к парсингу накладных поставщиков не относится. На слайде показаны несколько примеров накладных из архива — форматы уже не такие одинаковые, как в первых двух документах: один выглядит как обычная таблица, во втором поля названы и расположены иначе, третий — со свободным текстом вместо чёткой таблицы, а четвёртый на английском языке, потому что один из поставщиков иностранный. Это тот же архив, только теперь мы видим его целиком. Вопрос в зал: меняет ли это ваш ответ? И если вы говорили про чистый парсер без ИИ — что вы думаете сейчас, видя этот разброс форматов? А что думаете о доле потока через ЭДО, которая вообще не требует разбора? При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
06 · Гибрид: LLM извлекает, код проверяет. Изучайте данные, не верьте на слово
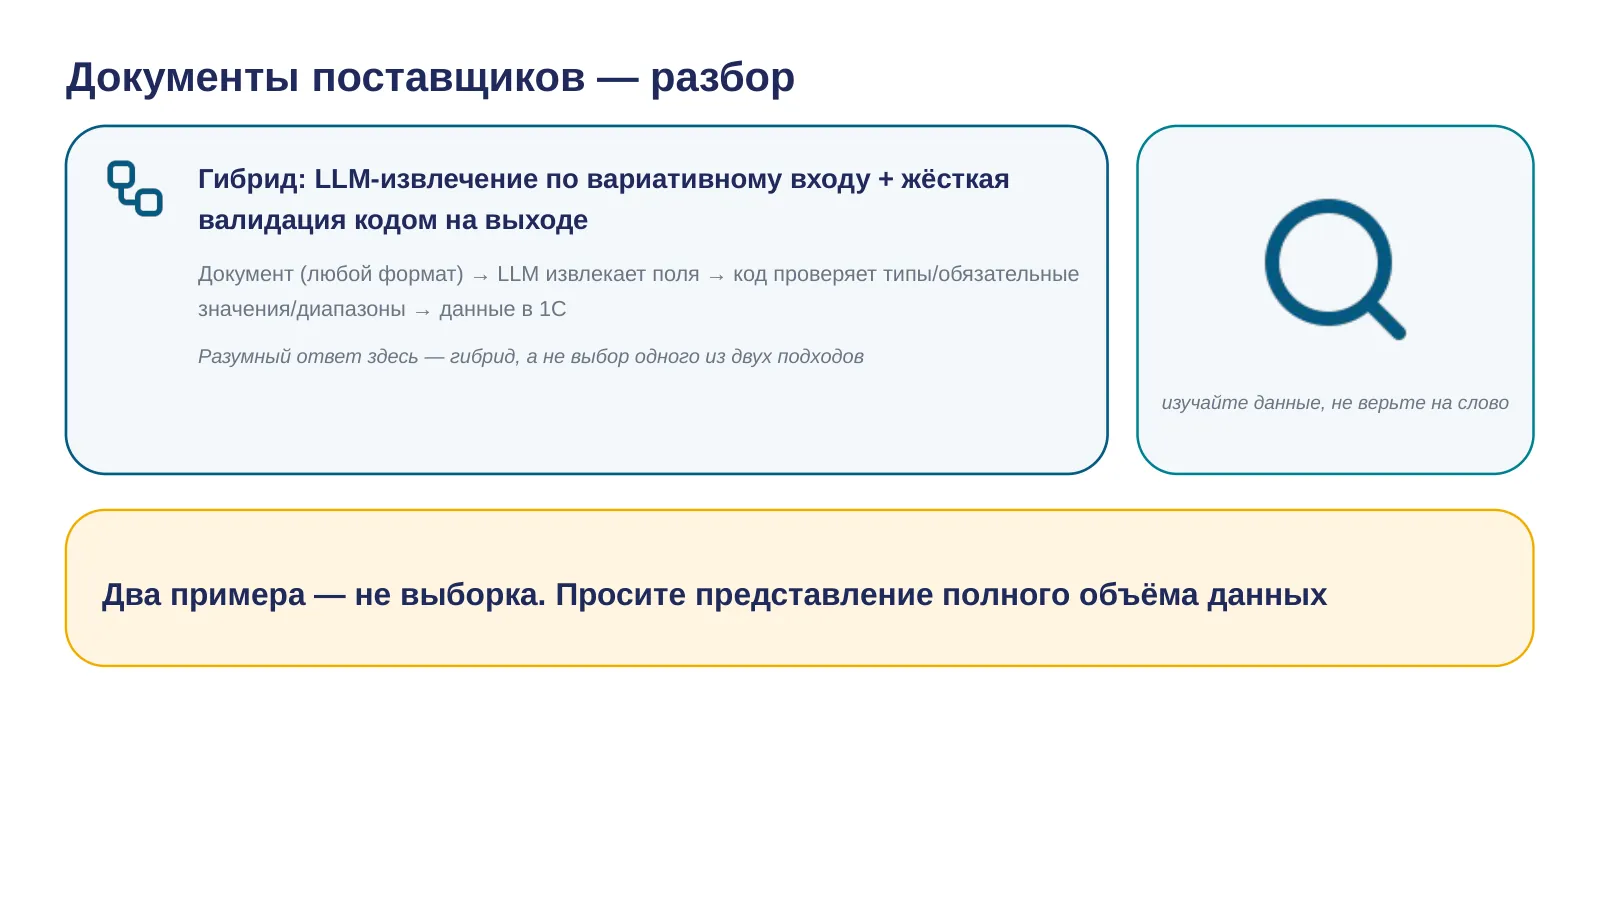
Смотрите, что произошло: пока мы видели два одинаковых документа, чистый код казался достаточным и даже предпочтительным — он предсказуем. Как только появился реальный архив на 4,2 гигабайта, стало видно, что форматы на самом деле разъехались, и чистый парсер пришлось бы постоянно чинить под каждый новый вариант. Разумный ответ здесь — гибрид: модель делает извлечение по неструктурированному или разнородному входу, а дальше — жёсткая валидация кодом, проверка типов полей, обязательных значений, диапазонов, прежде чем данные попадут в 1С. И главный урок этого кейса шире, чем документы, поэтому проговорю его отдельной фразой: изучайте исходные данные максимально подробно и широко — и не верьте заказчику на слово. Продакт был уверен, что форматы одинаковые, потому что видел два документа и решил, что этого достаточно. Прежде чем делать архитектурный выбор, нужно самому запросить представление полного объёма данных, с которым решение реально столкнётся, а не полагаться на то, что вам рассказали о них на словах.
07 · Персоналка в логах — как максимально быстро и дёшево очистить?
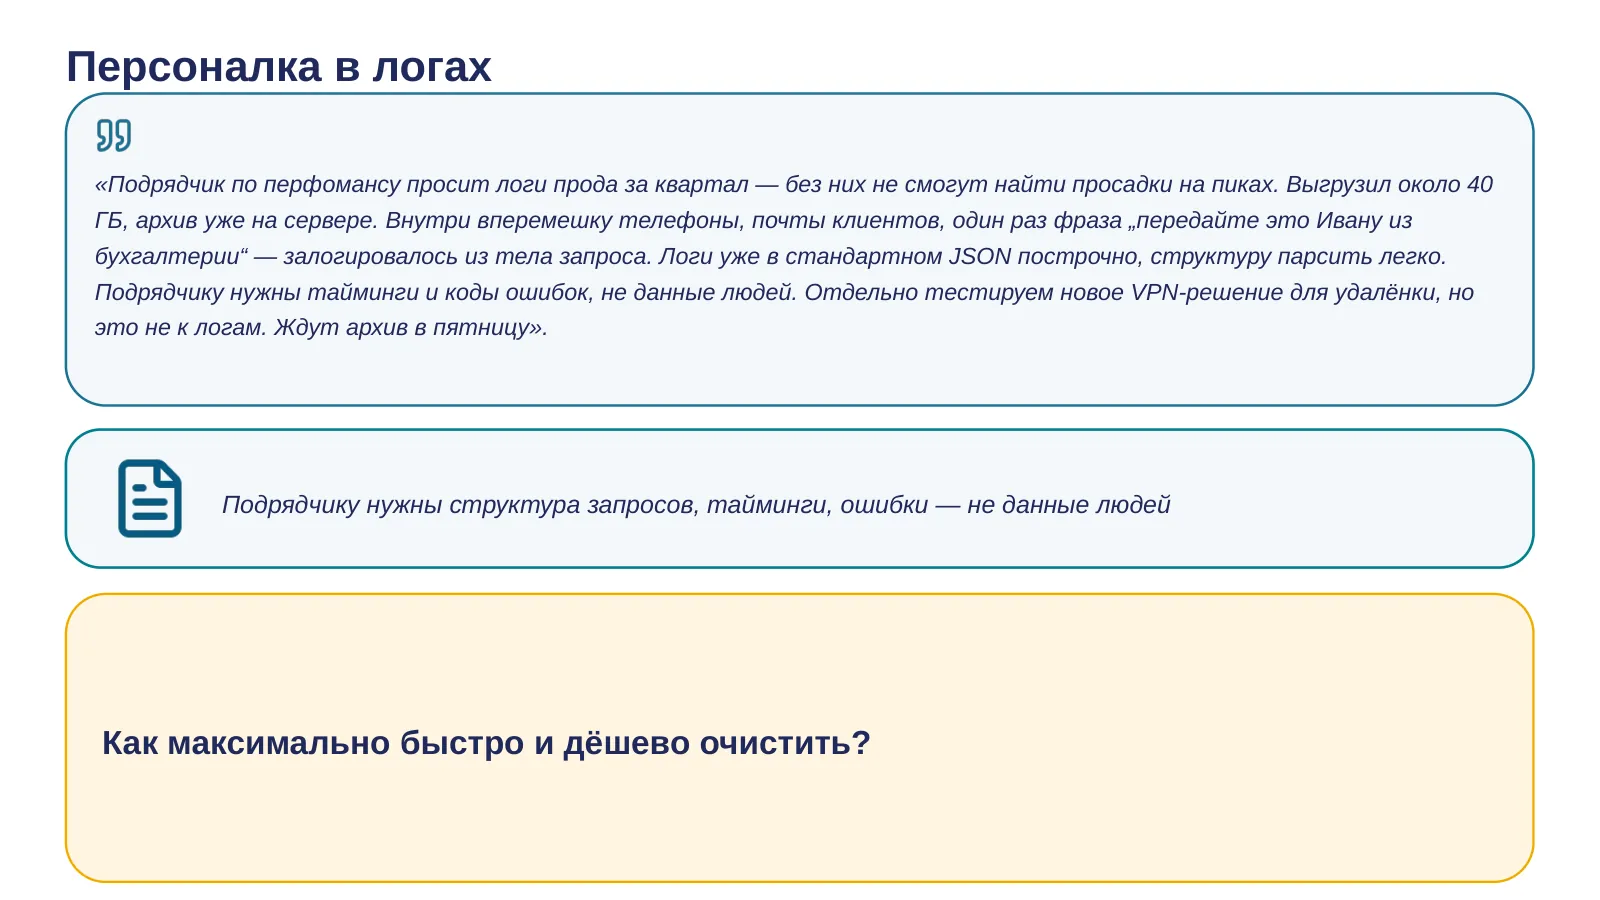
Зачитайте реплику коллеги, который готовит логи для подрядчика. Прямые сигналы: 40 ГБ логов за квартал, дедлайн пятница, подрядчику нужна структура запросов/тайминги/ошибки, но не данные конкретных людей, в логах вперемешку телефон, email и фраза вроде «передайте это Ивану из бухгалтерии». Косвенный сигнал стоит вытащить отдельно: логи уже в JSON построчно — значит, границы полей и структура запроса уже детерминированы, искать нужно только персональные данные внутри значений, а не парсить сам формат лога с нуля. Тестирование VPN-решения — шум- двойник: похоже на смежную тему безопасности данных, но никак не влияет на то, как вычищать персоналку из уже выгруженного архива. Пример строки лога на слайде показывает именно этот разброс: номер телефона, адрес почты, фраза с именем в свободном тексте. Вопрос в зал: как максимально быстро и дёшево очистить эти 40 гигабайт до пятницы? У кого есть мнение — что бы вы предложили в первую очередь? При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
08 · Regex для телефонов и email, компактный NER для имён в свободном тексте
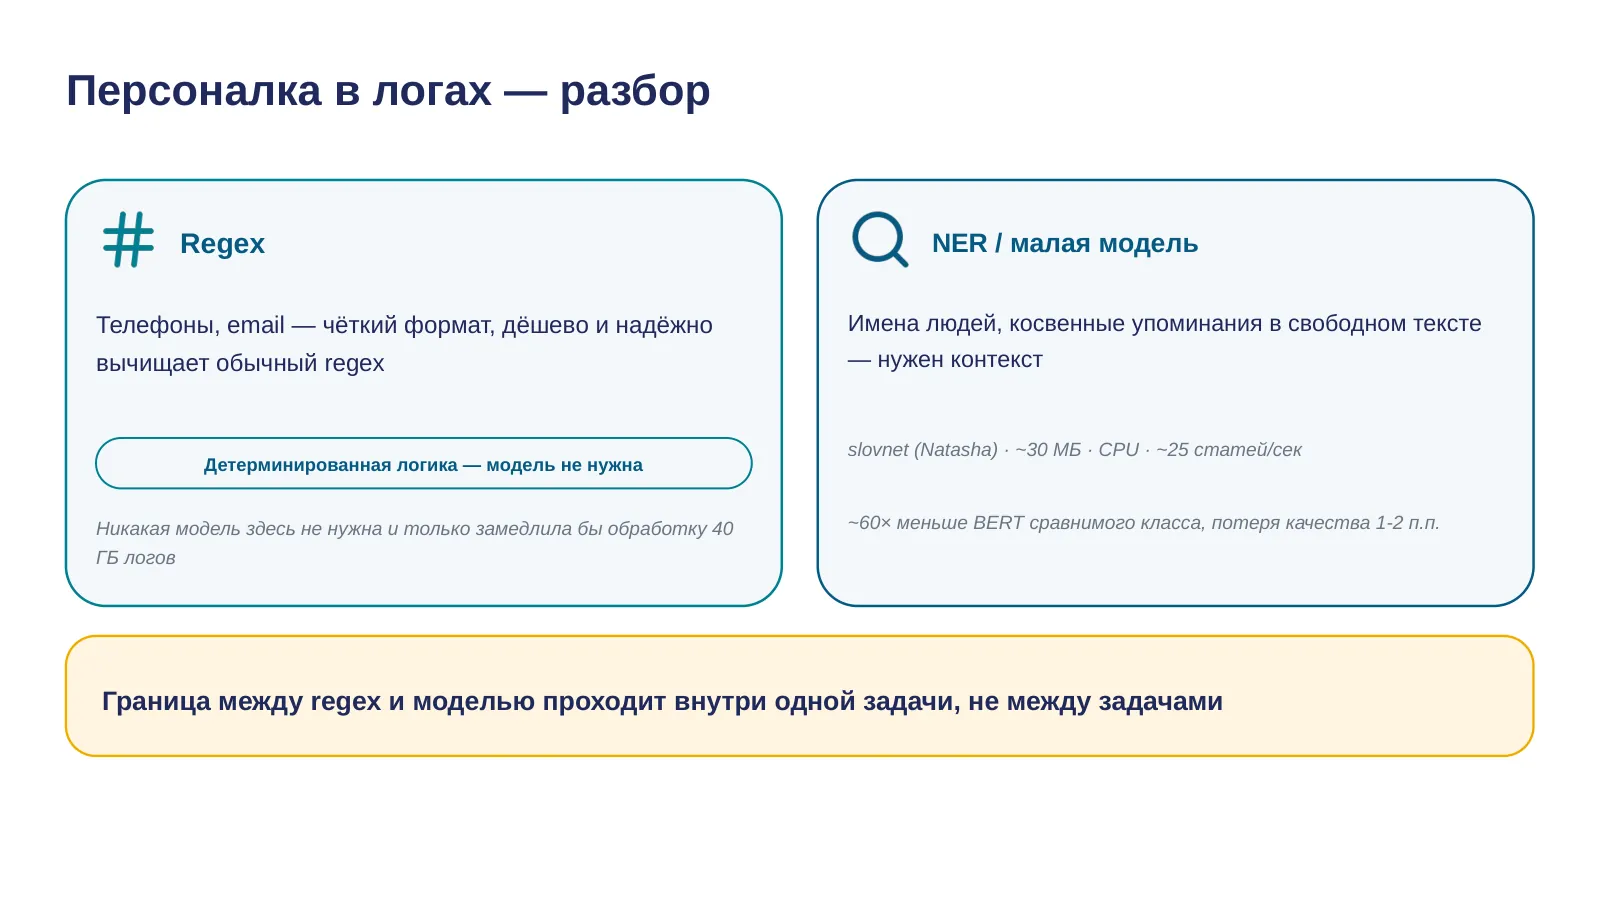
Телефоны и email — это данные с чётким, предсказуемым форматом, их надёжно и дёшево вычищает обычный regex, никакая модель здесь не нужна и только замедлила бы обработку 40 гигабайт логов. А вот имена людей и косвенные упоминания в свободном тексте — вроде «передайте это Ивану из бухгалтерии» — требуют понимания контекста. Здесь не нужен большой LLM: для этого есть компактные модели распознавания именованных сущностей, например slovnet из проекта Natasha — вес модели около 30 мегабайт, она спокойно работает на CPU обычного ноутбука без GPU, скорость порядка 25 статей в секунду. Модель распознаёт имена людей, названия организаций, локации — включая названия компаний и городов. По размеру это примерно в 60 раз меньше BERT-модели сравнимого класса, при потере качества на 1-2 процентных пункта. Вывод стоит проговорить явно: большое количество текстовых задач решается алгоритмически или малыми специализированными моделями — это проще, быстрее и дешевле, чем гонять всё через большой LLM. Тот же вопрос чувствительности данных всплывёт в кейсе про звонки продаж — там ставки заметно выше.
09 · Когда нужна была формула — и когда ИИ закрыл нерешаемое
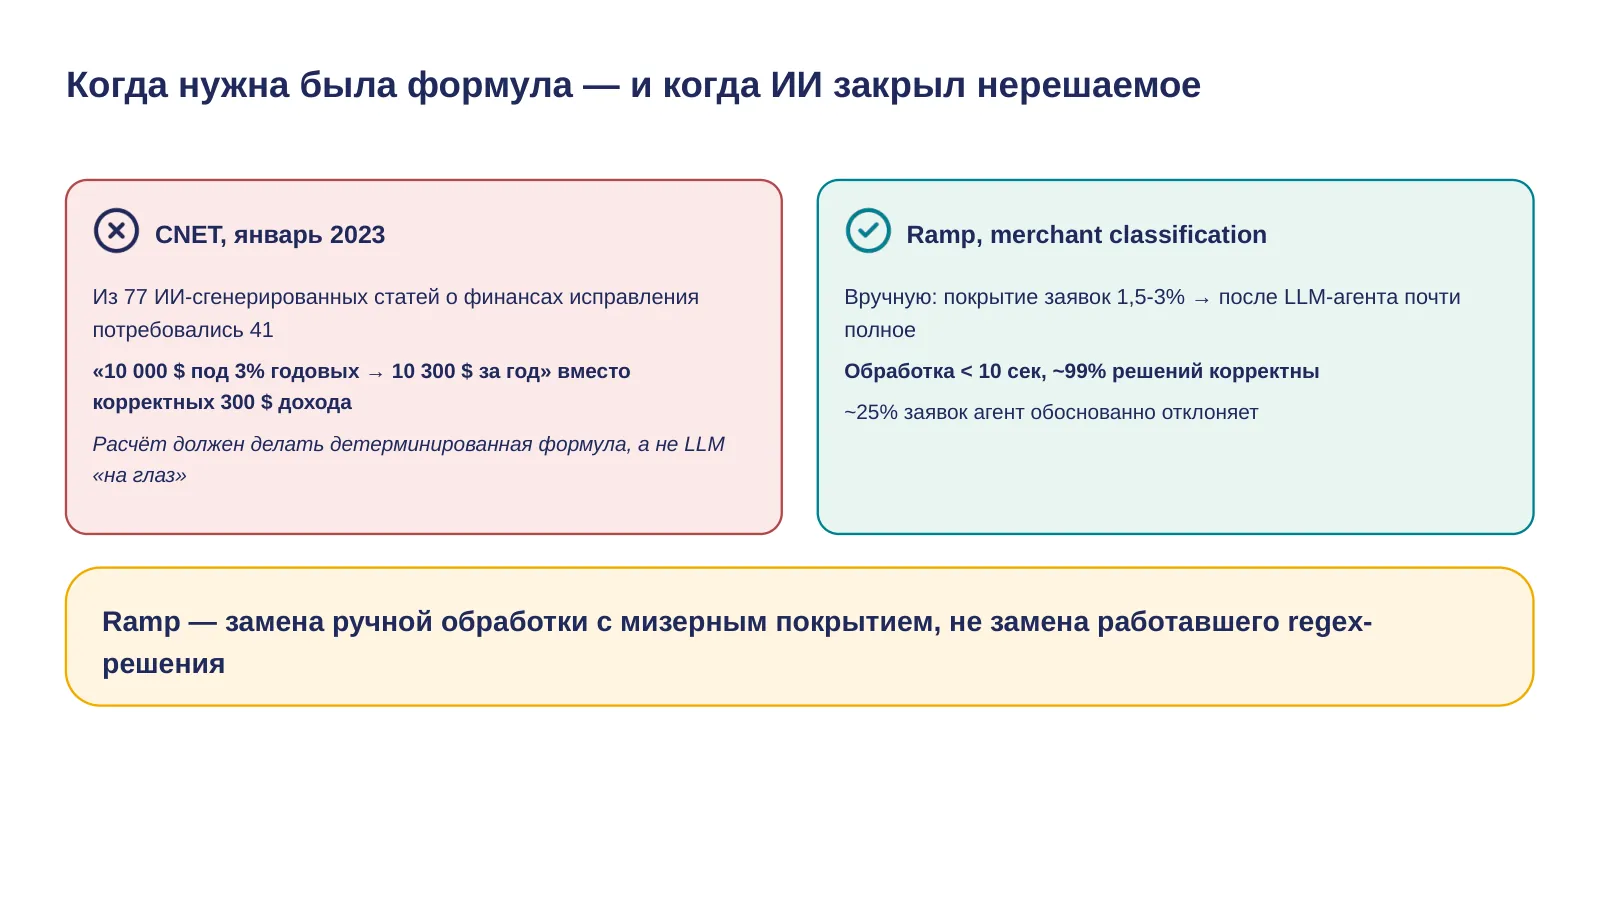
Два случая из практики. В январе 2023 года выяснилось, что издание CNET несколько месяцев публиковало статьи о финансах, сгенерированные ИИ-инструментом. Из 77 таких статей исправления потребовались 41. Флагманский пример ошибки: одна из статей утверждала, что «10 000 долларов под 3% годовых принесут 10 300 долларов за год» — вместо корректных 300 долларов дохода, модель перепутала итоговую сумму с самим доходом, элементарная арифметическая ошибка. Урок именно про неё: расчёт должен делать детерминированная формула, а не LLM «на глаз» — там, где нужна точная арифметика, модель заменяет не калькулятор, а текст вокруг него. Что здесь пошло не так, на ваш взгляд? Теперь позитивный пример: инженерный блог компании Ramp рассказывает, как раньше заявки на исправление классификации транзакций обрабатывались вручную с покрытием всего 1,5-3% заявок — то есть подавляющее большинство оставалось необработанным. После внедрения LLM-агента — меньше 10 секунд на заявку, около 99% решений признаются корректными, около 25% заявок агент отклоняет. Важно сказать честно: это не победа ИИ над детерминированным кодом, это замена ручной обработки с мизерным покрытием.
10 · Встроить или делать своё?
Второй вопрос сегодня: встраивать решение в то, чем люди и так пользуются каждый день, или делать для него отдельный продукт. На бумаге оба варианта выглядят разумно. Встроенное решение обещает бесшовность, отдельный продукт — свободу: свой интерфейс, свой темп разработки, никаких чужих ограничений. И у каждого варианта есть скрытая цена, которая почти никогда не видна в демо и на презентации идеи — она проявляется позже, в реальной эксплуатации, когда решением начинают пользоваться настоящие люди в настоящем рабочем потоке, а не авторы прототипа на показе. Именно поэтому такие решения нельзя принимать по одной только красоте концепции — нужно разбираться в конкретных обстоятельствах компании и задачи. Переходим к постановке — она прозвучит от человека, который отвечает за результат, а не за то, как красиво выглядит идея на слайде.
11 · ИИ-помощник для операторов техподдержки — подсказки ответов, поиск похожих обращений
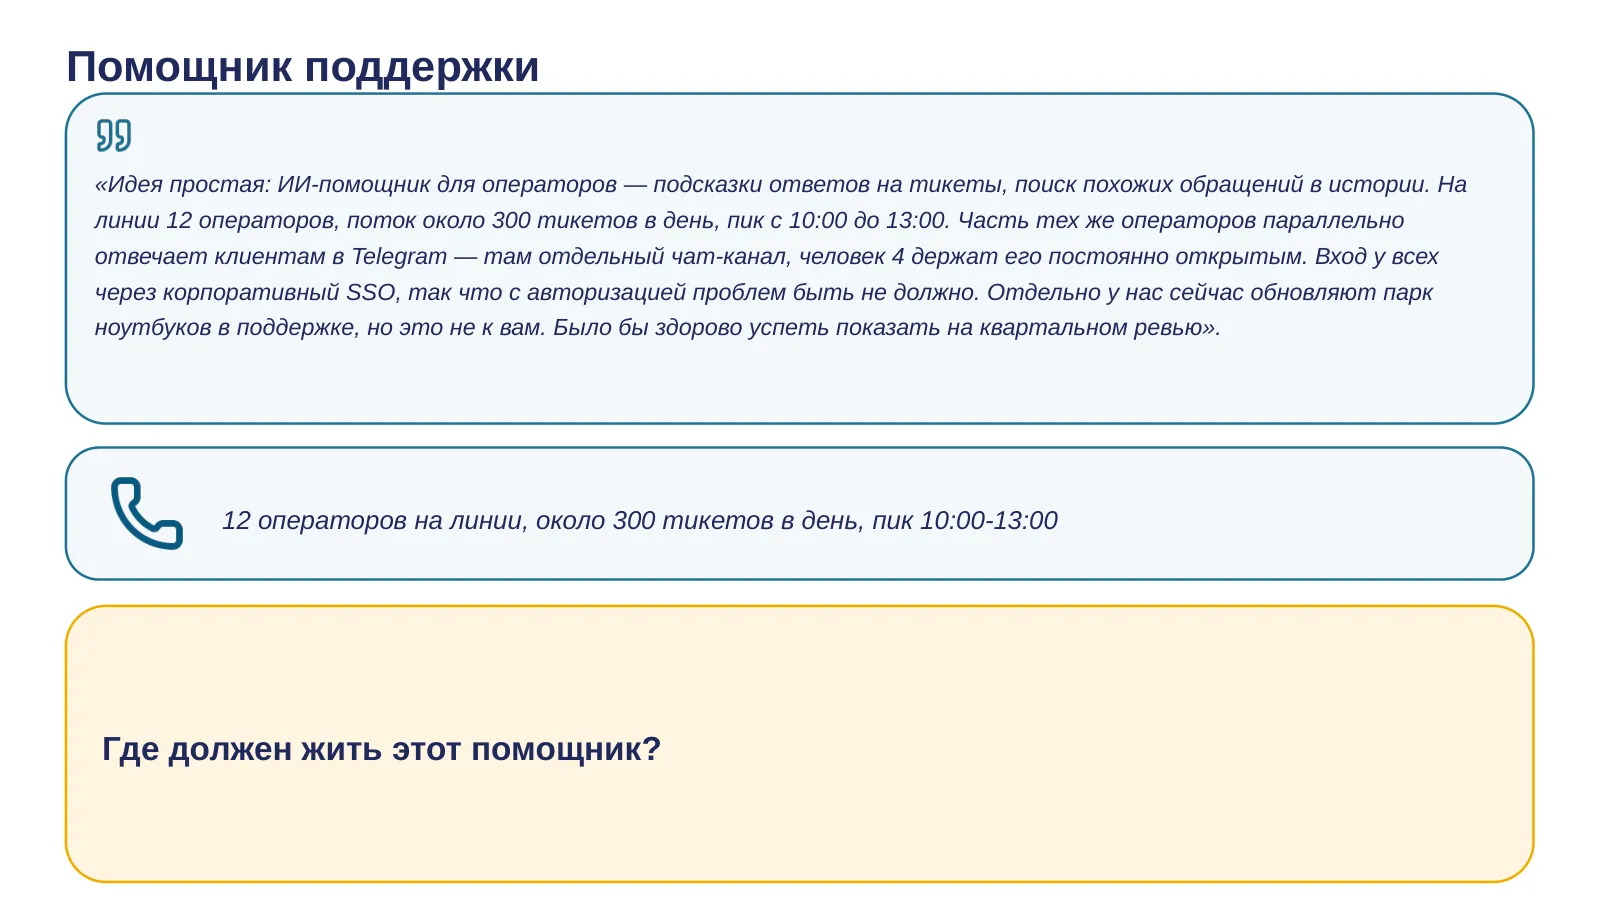
Зачитайте реплику целиком. Прямые сигналы: идея подсказок ответов и поиска похожих обращений, 12 операторов на линии, около 300 тикетов в день, пик с 10:00 до 13:00. Косвенный сигнал стоит явно вытащить в обсуждении: часть операторов уже параллельно работает в Telegram — это вторая, отдельная точка встраивания помощника, о которой заказчик не спросил напрямую, но она реально существует и может оказаться не менее важной, чем helpdesk. Корпоративный SSO — тоже косвенный плюс: единая авторизация снижает цену интеграции, если помощник будет отдельным окном. Обновление парка ноутбуков — шум-двойник: похоже на ИТ-факт про инфраструктуру поддержки, но к архитектуре помощника отношения не имеет. На слайде показан рабочий стол оператора техподдержки: список тикетов, окно ответа клиенту. Операторы весь рабочий день сидят в одном и том же интерфейсе helpdesk-системы — что-то вроде Zendesk или Jira Service Management, открывают тикет за тикетом, переключаются между обращениями десятками раз за смену. Вопрос в зал: где должен жить этот помощник? Что вы предложите — отдельное окно, встроенная подсказка прямо в интерфейсе, что-то ещё? И, что не менее важно, почему именно так, а не иначе? При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
12 · Коробочный helpdesk без открытого API — систему купили 4 года назад
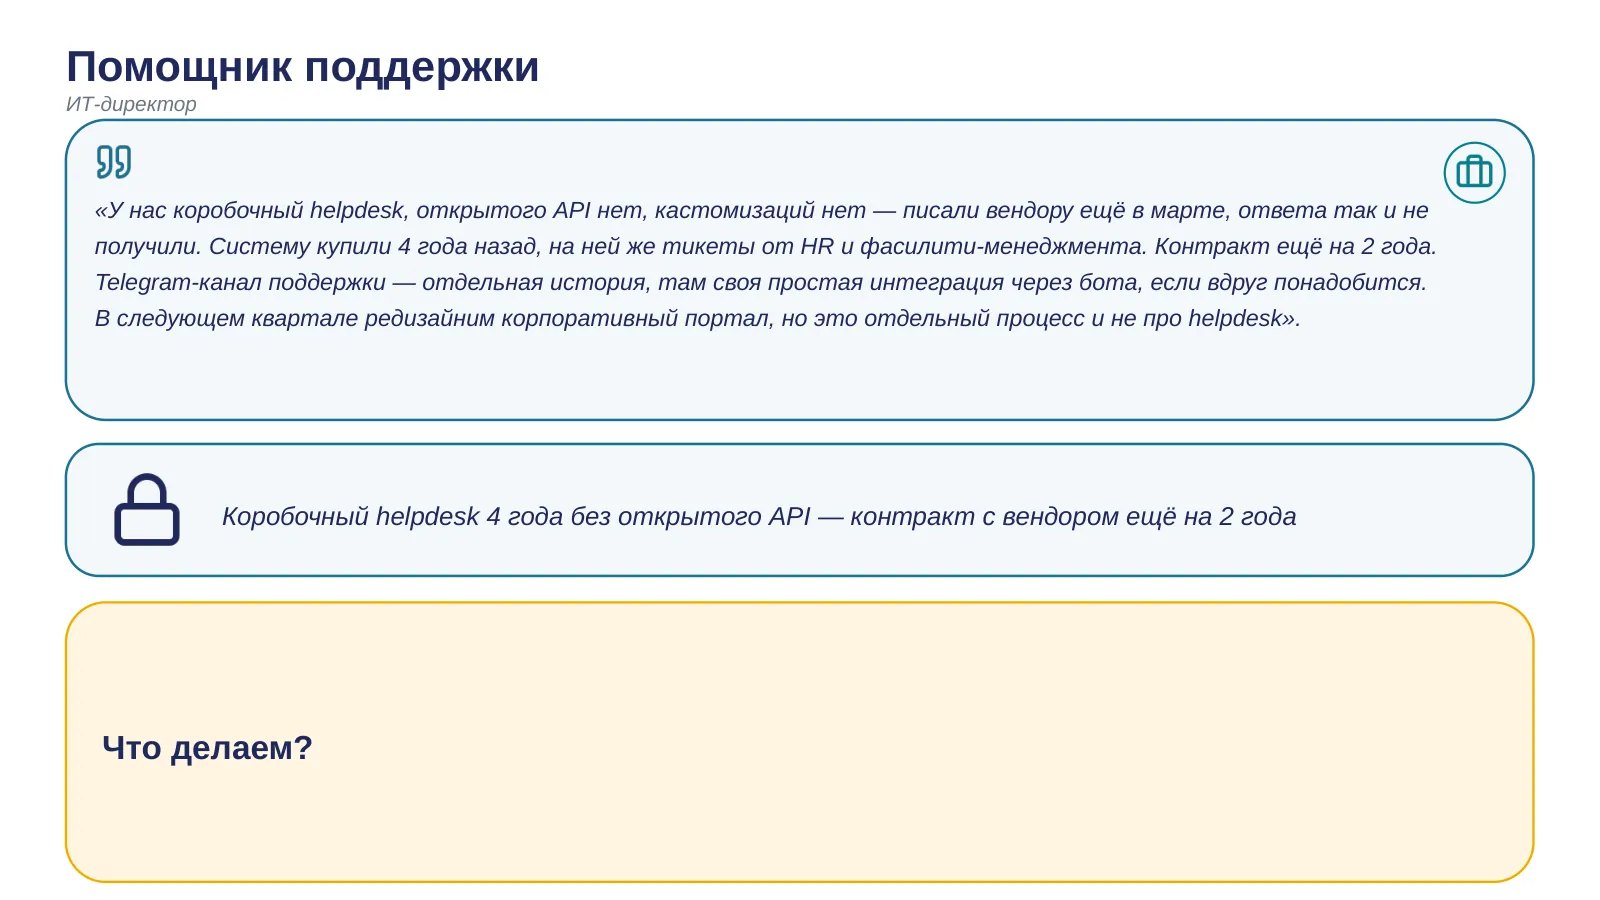
Зачитайте реплику ИТ-директора целиком, не выделяя ключевые слова интонацией. Прямые сигналы, расположены внутри абзаца, а не в первой фразе: открытого API нет, кастомизаций нет, систему купили 4 года назад, на ней же тикеты HR и фасилити-менеджмента, контракт с вендором ещё на 2 года. Косвенный сигнал стоит явно вытащить: Telegram-бот интегрируется проще, чем закрытый коробочный helpdesk, — то есть у той второй точки встраивания из прошлой реплики (операторы в Telegram) цена интеграции ниже, и это меняет расклад вариантов, даже если аудитория сама не вспомнит про Telegram без наводки. Редизайн корпоративного портала — шум- двойник: похоже на ИТ-инициативу того же профиля, но никак не пересекается с интеграцией в helpdesk. Вопрос в зал: что делаем? Обратите внимание, я не говорю вам, хорошо это или плохо для вашего плана — просто называю факт, который вы бы узнали, только если бы сами спросили ИТ-отдел заранее, до того как начали проектировать решение. Кто хочет высказаться первым, что теперь предлагаете? И кто из тех, кто минуту назад предлагал встроить помощника прямо в интерфейс — что вы думаете сейчас, когда выяснилось, что сам интерфейс для вас закрыт наглухо? При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
13 · Сбоку, смена вендора или пересмотр задачи — единственно верного ответа нет
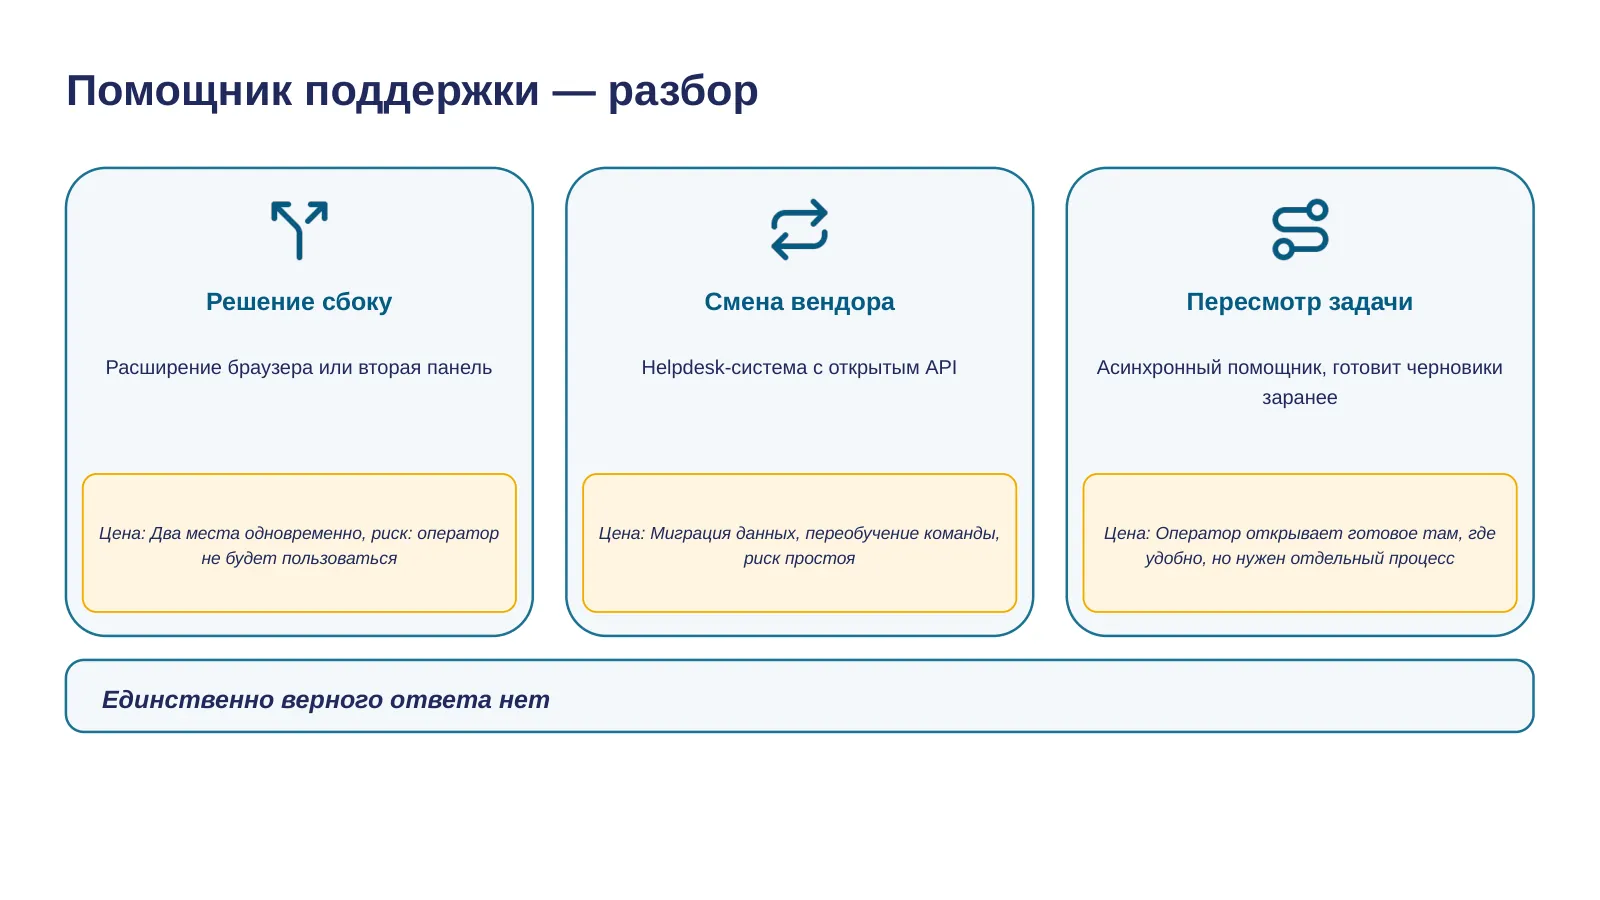
У этого кейса нет единственно верного ответа, и это специально. Смотрите на три реальных варианта. Первый — решение сбоку: расширение браузера или вторая панель рядом с интерфейсом helpdesk. Цена — оператору приходится физически смотреть в два места, и под нагрузкой он туда просто не будет заглядывать. Второй — сменить вендора helpdesk-системы на систему с открытым API. Цена — миграция исторических данных, переобучение всей команды поддержки, риск простоя на переходе, и всё это ради одной фичи. Третий — пересмотреть саму задачу: помощник не встраивается в момент ответа оператора, а готовит черновики или сводки по тикету заранее. Цена здесь тоже есть, просто другая — оператор открывает готовое там, где удобно, но нужен отдельный процесс подготовки этих черновиков. На практике «сбоку» выбирают, когда критично время внедрения и штат маленький — быстрее собрать расширение, чем ждать вендора. «Смену вендора» выбирают, когда контракт всё равно скоро кончается — тогда издержки миграции размазываются на уже запланированное событие. А «пересмотр задачи» выбирают, когда организация не готова тратить бюджет на интеграцию прямо сейчас, но может подождать с live-подсказками.
14 · Отдельный ИИ-сервис для описаний товаров — хорошая идея?
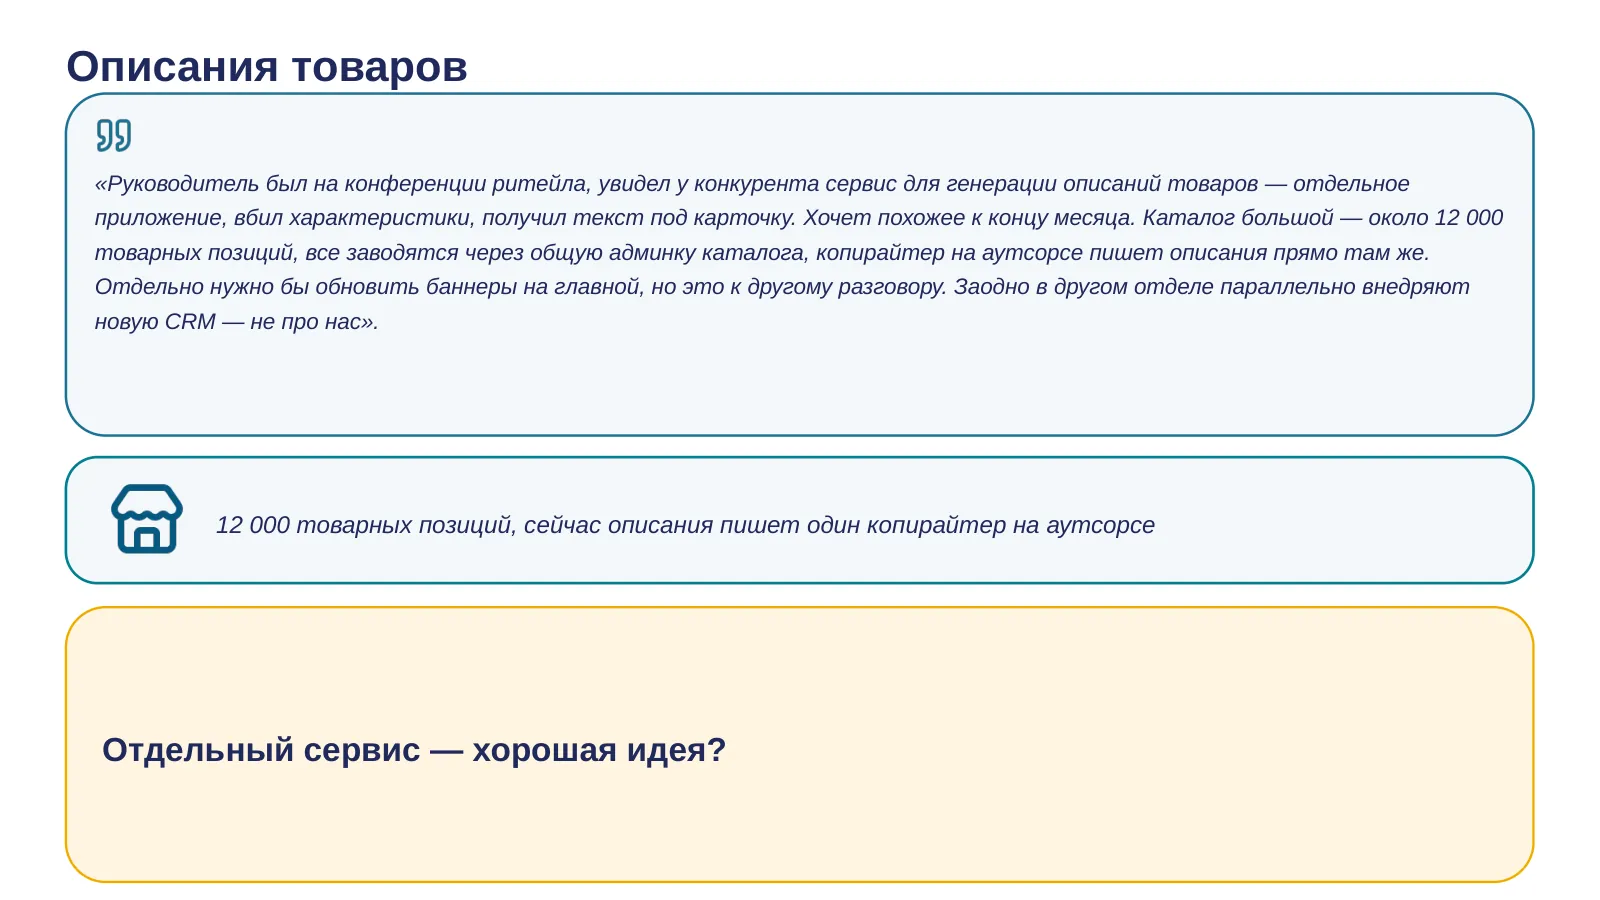
Зачитайте реплику из маркетинга целиком. Прямой сигнал: маркетинг хочет именно отдельный сервис-приложение по образцу конкурента, каталог 12 000 товарных позиций. Косвенный сигнал стоит явно вытащить в обсуждении: копирайтер уже пишет описания прямо в общей админке каталога — то есть у маркетинга есть единое рабочее место, куда можно встроить кнопку, и это меняет ответ на вопрос «отдельный сервис или нет» ещё до официального разбора. Баннеры на главной и внедрение CRM в другом отделе — шум- двойники: оба похожи на «параллельный ИТ-проект компании», но ни один не влияет на архитектуру для описаний товаров. На слайде — макет отдельного нового сервиса: форма ввода, кнопка «сгенерировать». Вопрос в зал: отдельный сервис — хорошая идея, или нет? Что скажете, и почему именно так — что в этой постановке вообще определяет, стоит ли делать новый инструмент или нет? При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
15 · Кнопка в существующей админке каталога, а не отдельный сервис
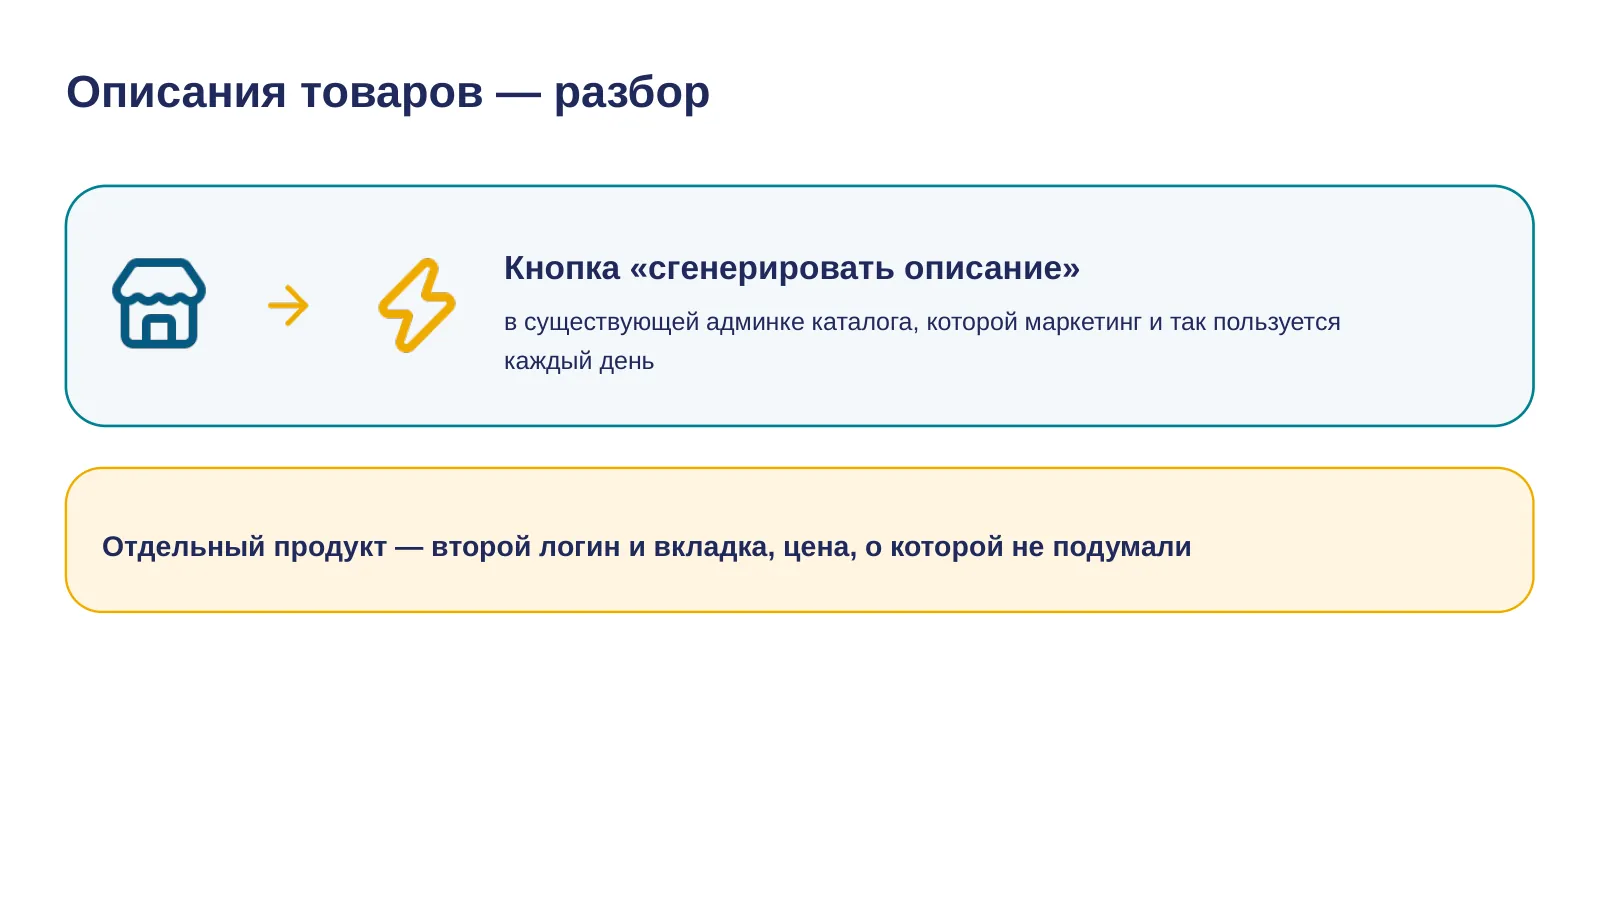
Это должна быть кнопка «сгенерировать описание» прямо в существующей админке каталога товаров, которой маркетинг и так пользуется каждый день, заводя новые товары и редактируя карточки. Отдельный продукт — это второй логин, отдельная вкладка, привычка, которую нужно формировать с нуля, и лишний шаг в рабочем процессе. На практике такие отдельные инструменты часто умирают от неиспользования, даже если технология внутри работает отлично — просто потому что до них банально не доходят руки, когда проще написать вручную то, что и так писали годами. Отдельный сервис всё-таки оправдан в одном случае — если своей админки нет вовсе, то есть если у маркетинга нет единого места, где они и так работают с карточками товаров. Тогда встраивать попросту некуда, и отдельный инструмент — не компромисс, а единственный доступный вариант.
16 · 17 месяцев на одном рынке — Kite закрылся, Copilot дошёл до 90% Fortune 100
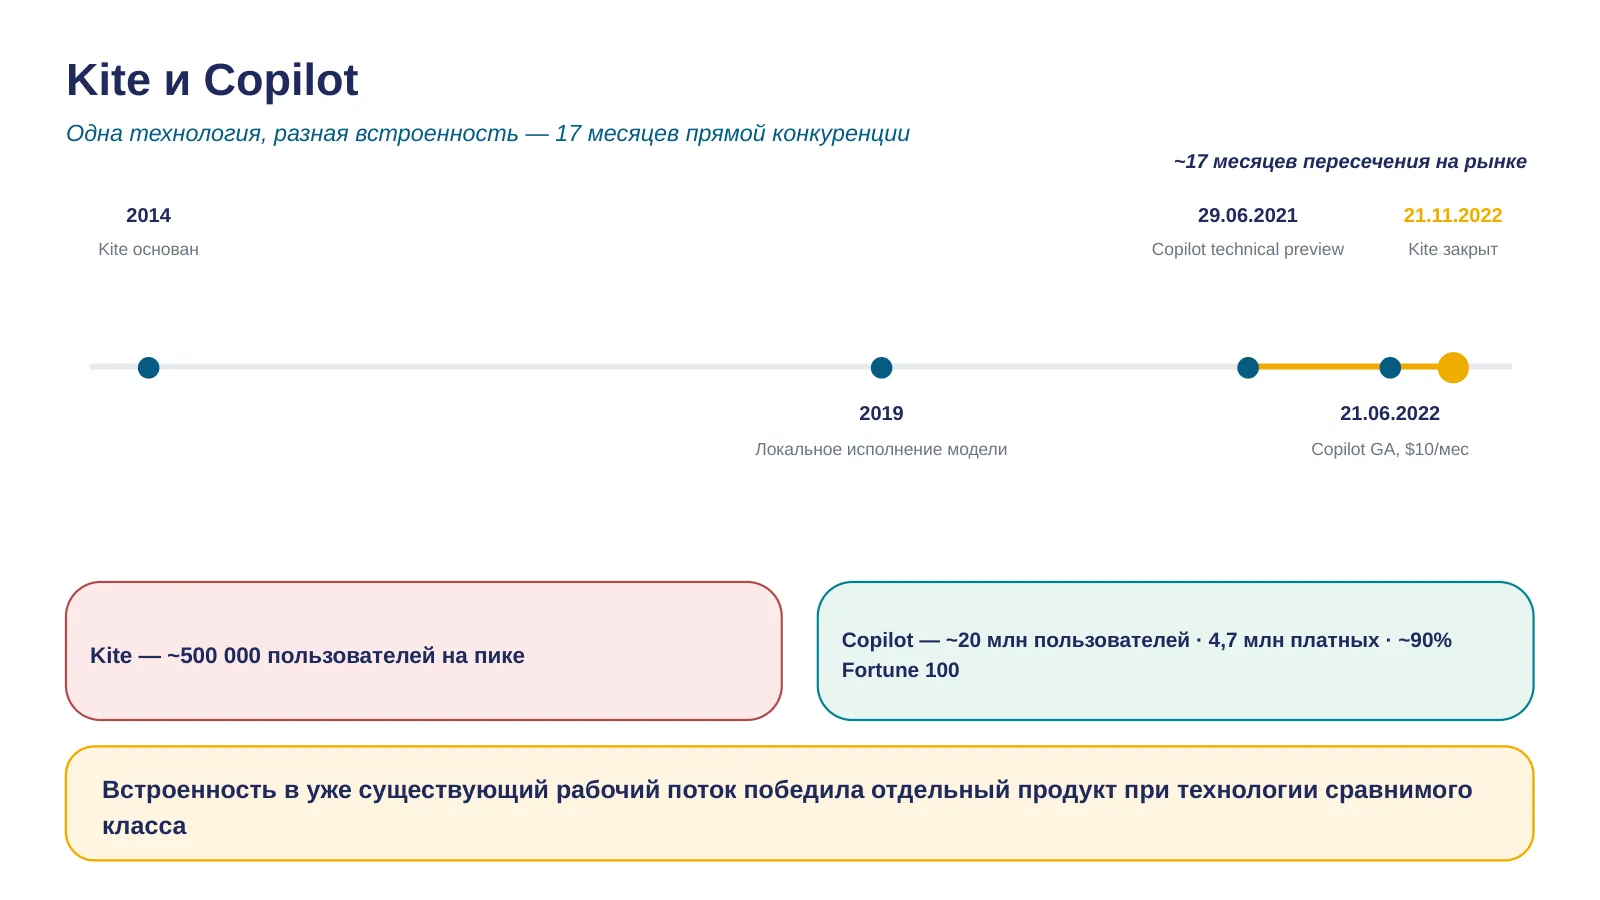
Смотрите на хронологию. Kite — отдельный самостоятельный продукт для автодополнения кода на базе ИИ — основан в 2014 году, с 2019 года умел исполнять модель локально на машине разработчика. GitHub Copilot вышел в technical preview 29 июня 2021 года, стал общедоступным 21 июня 2022 года за 10 долларов в месяц. Kite закрылся 21 ноября 2022 года. Если считать от technical preview Copilot до закрытия Kite — это около 17 месяцев, когда оба продукта реально существовали на одном рынке одновременно, и конкуренция была настоящей, не гипотетической. При этом причину закрытия стоит формулировать аккуратно: сам основатель Kite объяснял это не победой конкретного продукта, а тем, что «разработчики не платят за отдельные инструменты» — это его слова о рынке в целом, а не прямое утверждение «Copilot убил Kite». У Kite было около 500 тысяч пользователей на пике. У Copilot — около 20 миллионов пользователей к июлю 2025 года из более чем 100 миллионов разработчиков на GitHub, 4,7 миллиона платных подписчиков к январю 2026 года, и используется он примерно в 90% компаний из списка Fortune 100. Технология сравнимого класса, но встроенная прямо в IDE и в экосистему, к которой разработчики уже подключены.
17 · Отдельное устройство против фичи в телефоне
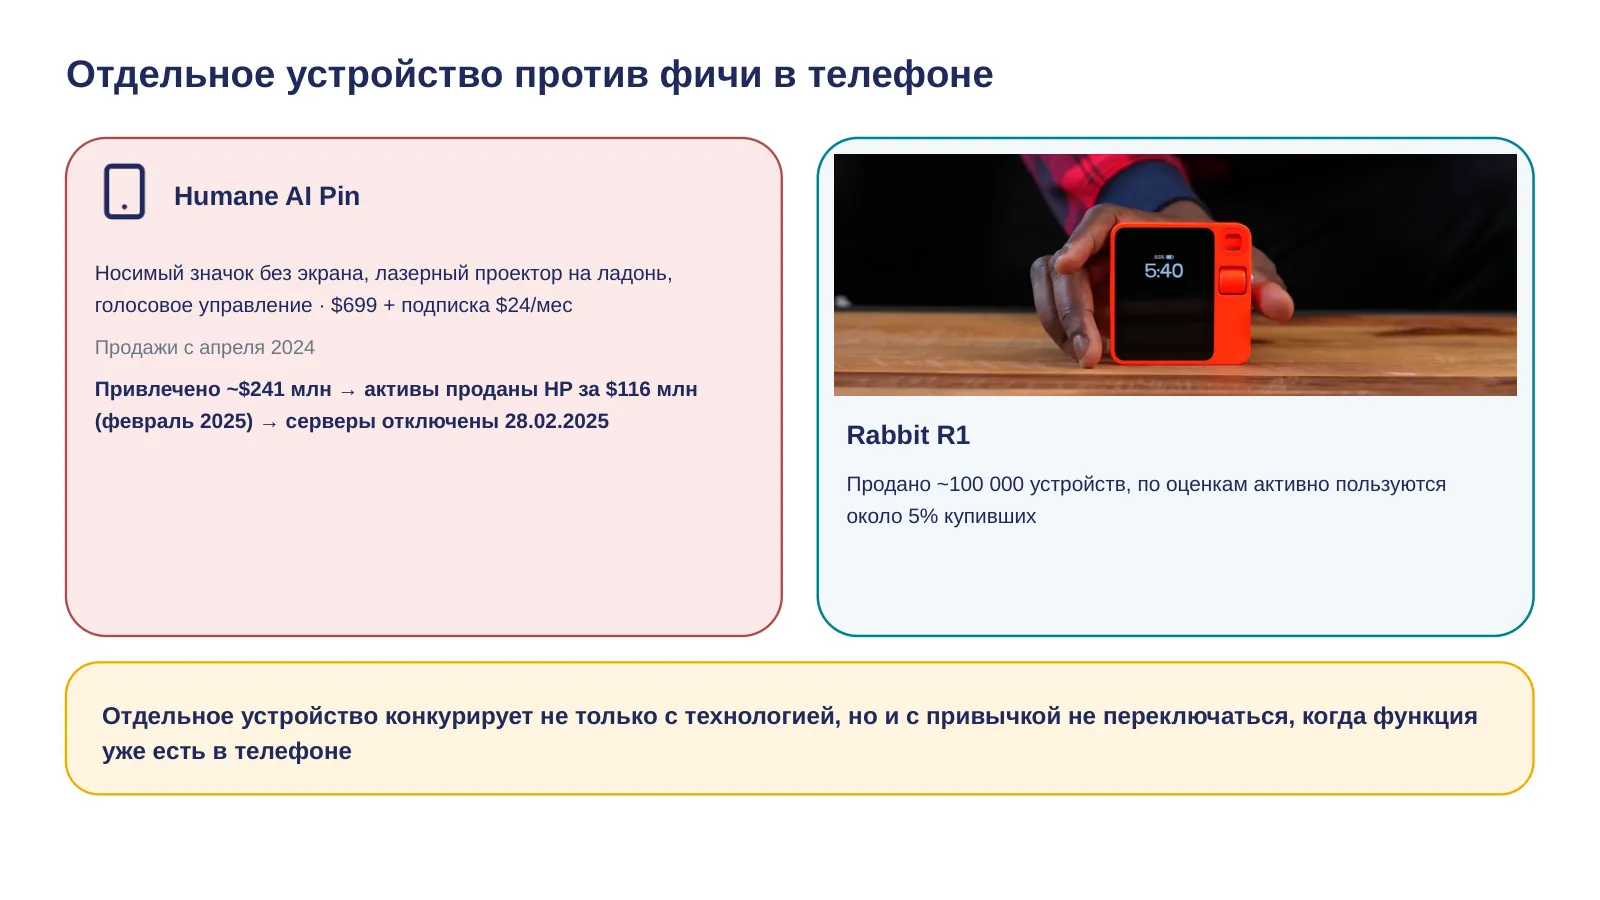
Ещё один пример того же выбора, но на другом масштабе — не фича внутри приложения, а целое отдельное физическое устройство. Humane AI Pin — носимый значок без экрана, с лазерным проектором, который показывает изображение прямо на ладонь, управление голосом, цена 699 долларов плюс подписка 24 доллара в месяц. Продажи стартовали в апреле 2024 года. Компания привлекла около 241 миллиона долларов инвестиций, а в феврале 2025 года активы компании — не вся компания целиком, именно активы — были проданы HP за 116 миллионов долларов. 28 февраля 2025 года серверы устройства отключили, и оно перестало работать у всех, кто его купил. Rabbit R1 — похожая история: продано около 100 000 устройств, но, по оценкам, активно пользуются им около 5% купивших. Тот же организационный урок, что и с Kite: отдельное устройство или продукт конкурирует не только с альтернативными технологиями, но и с привычкой пользователя не переключаться на новую точку входа, когда нужная функция уже есть в телефоне, который и так лежит в кармане.
18 · Разовый вызов, RAG или агент?
Третий вопрос сегодня: какая архитектура нужна — разовый вызов модели, поиск по базе или многошаговый агент. Эти три варианта звучат как три разных уровня сложности, и интуитивно кажется, что чем внушительнее задача, тем более сложную архитектуру нужно сразу закладывать. Эту интуицию стоит проверять, а не принимать на веру — как и любое ощущение «серьёзной задаче нужен серьёзный инструмент», у неё есть и подтверждающие, и опровергающие примеры в реальной практике. Прежде чем перейти к постановке, разберём коротко, что такое RAG и что такое агент — эти два термина понадобятся буквально через пару слайдов, а до Лекции 3, где их разберут подробно изнутри, ещё далеко, так что сегодня достаточно общей интуиции: что делает каждая из архитектур и чем они отличаются друг от друга на уровне общей картины, без деталей устройства.
19 · RAG одним потоком: вопрос → поиск по базе → фрагменты в контекст → ответ
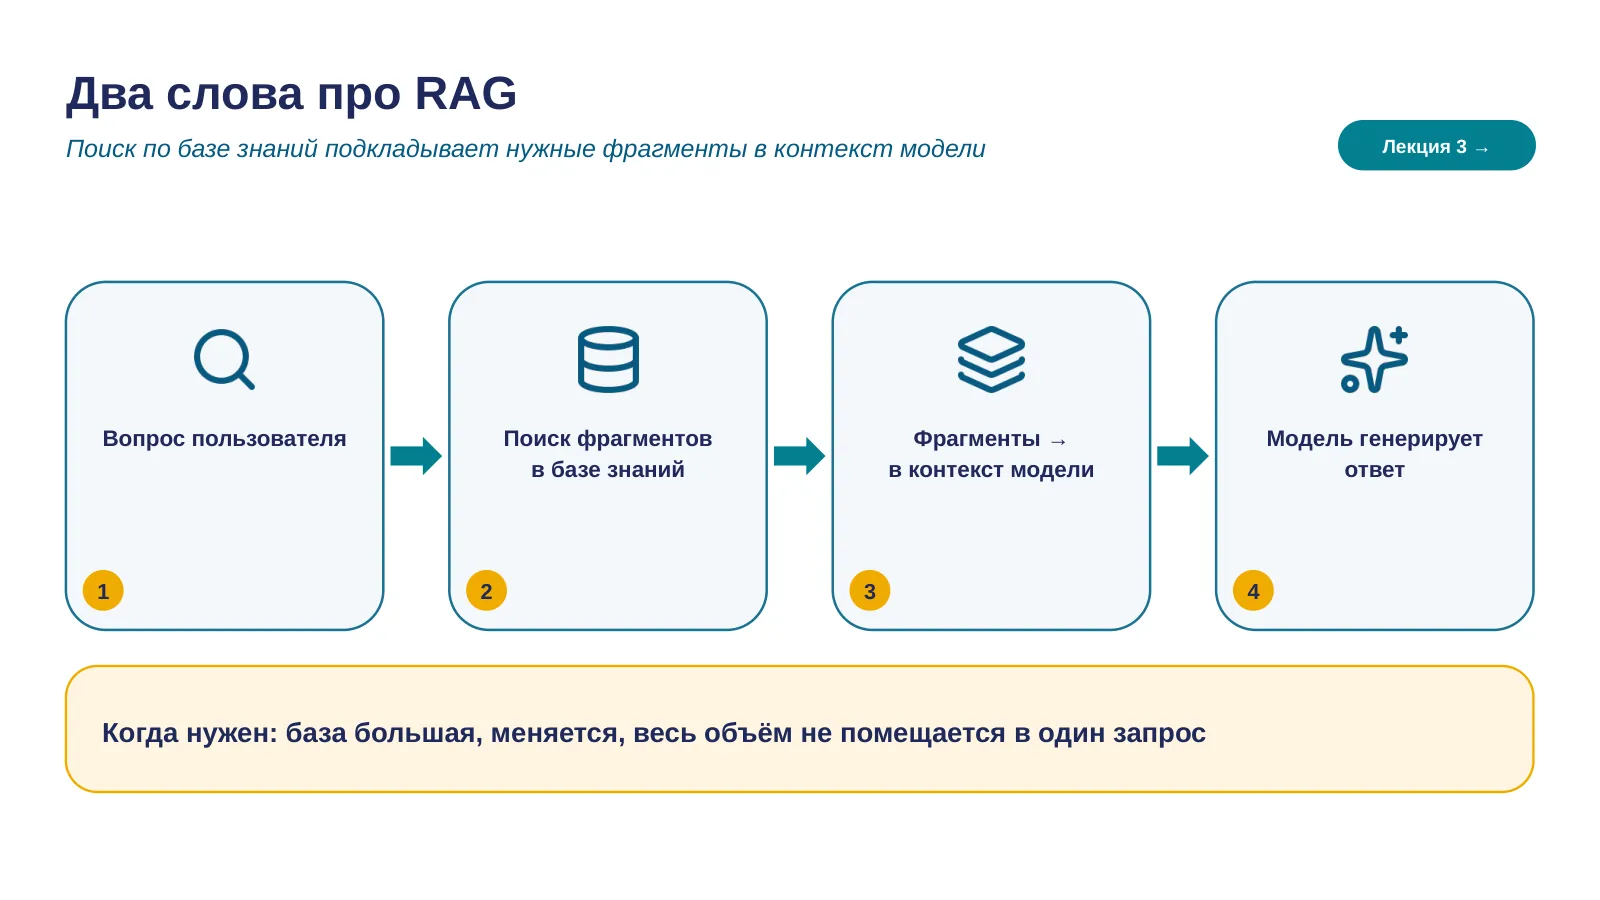
Прежде чем перейти к следующему кейсу, два слова про RAG — эта аббревиатура вам сейчас понадобится, и дальше в занятии будет всплывать ещё не раз. Устроено это так: вопрос пользователя → система ищет релевантные фрагменты в базе знаний → найденные фрагменты подкладываются в контекст модели → модель генерирует ответ на основе вопроса и найденного. RAG нужен, когда база знаний большая, меняется во времени, и весь её объём физически не помещается в один запрос к модели — то есть модель физически не может «прочитать» всё сразу, ей нужно заранее найти только релевантный кусок. Как устроен поиск внутри — векторные представления, индексация — подробно разберём на Лекции 3, сегодня нам достаточно этой интуиции, чтобы узнавать архитектуру, когда она нужна, а не изобретать её заново каждый раз с нуля.
20 · Агент циклом: план → инструмент → проверка → дальше
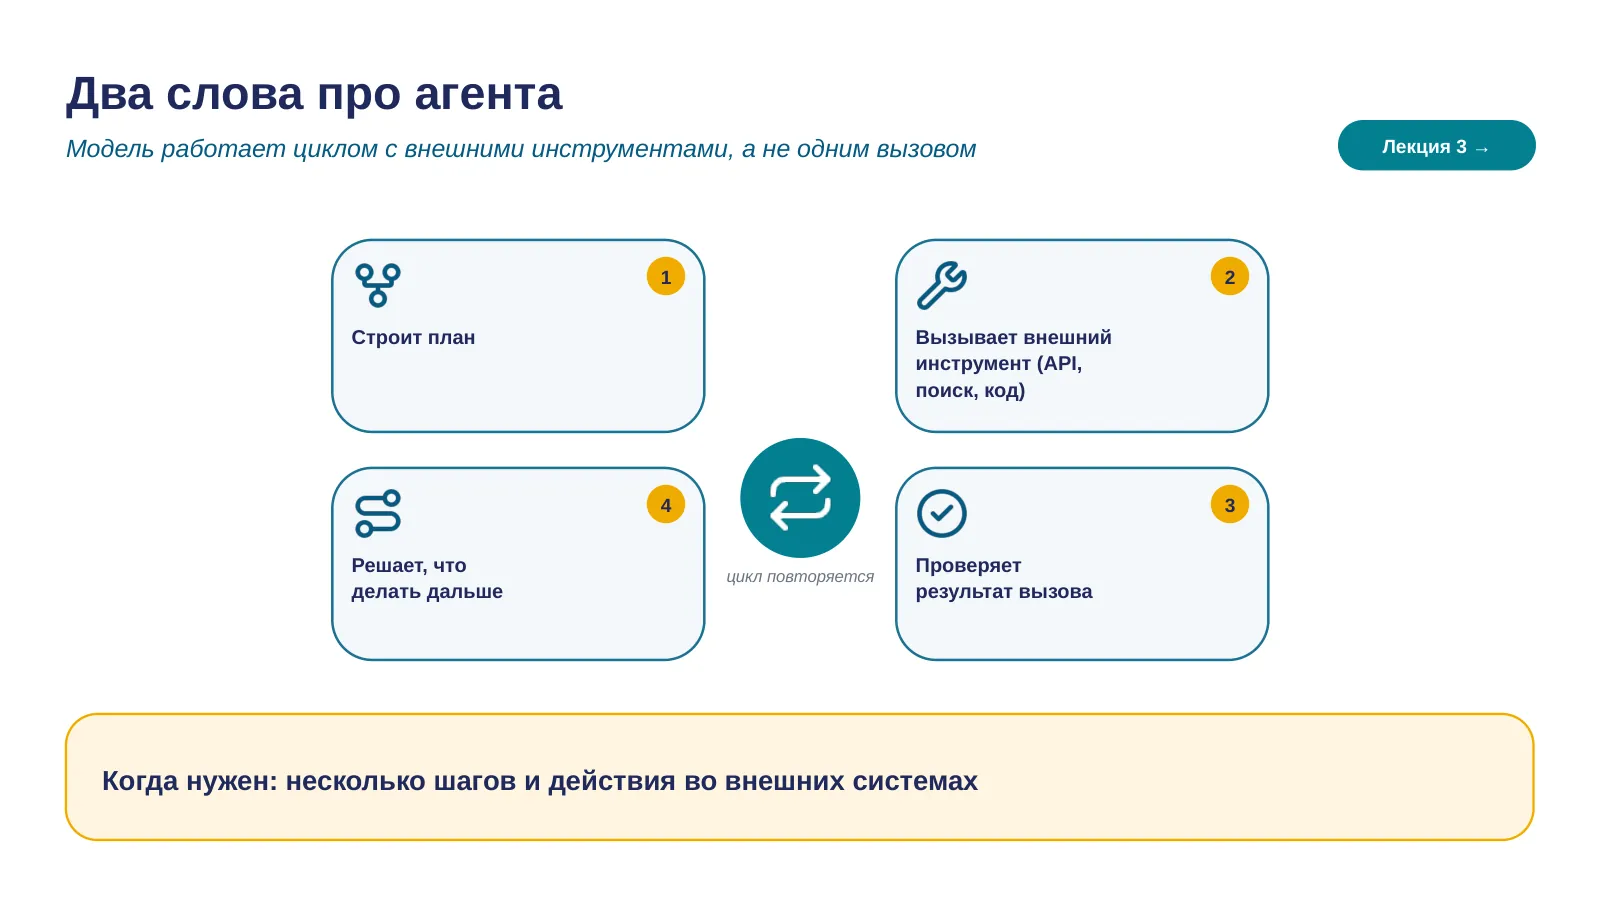
И второе — агент. Здесь модель работает не одним вызовом, а циклом: строит план, вызывает внешний инструмент — это может быть API, поиск, запуск кода, — проверяет результат этого вызова, решает, что делать дальше, и так несколько раз подряд, пока задача не будет выполнена или не потребуется вмешательство человека. Ключевое отличие от RAG — здесь модель не просто отвечает на вопрос по найденным фрагментам, она реально что-то делает во внешнем мире и проверяет, получилось ли. Детали того, как агент планирует внутри, — снова Лекция 3. Сегодня нам важно только одно: узнавать, когда задача требует именно такого цикла с инструментами, а не разового ответа модели. Держите эти две схемы в голове — RAG и агент — они понадобятся буквально через минуту, в следующем кейсе.
21 · После созвона транскрипт приходит письмом — нужен протокол: решения, поручения, сроки
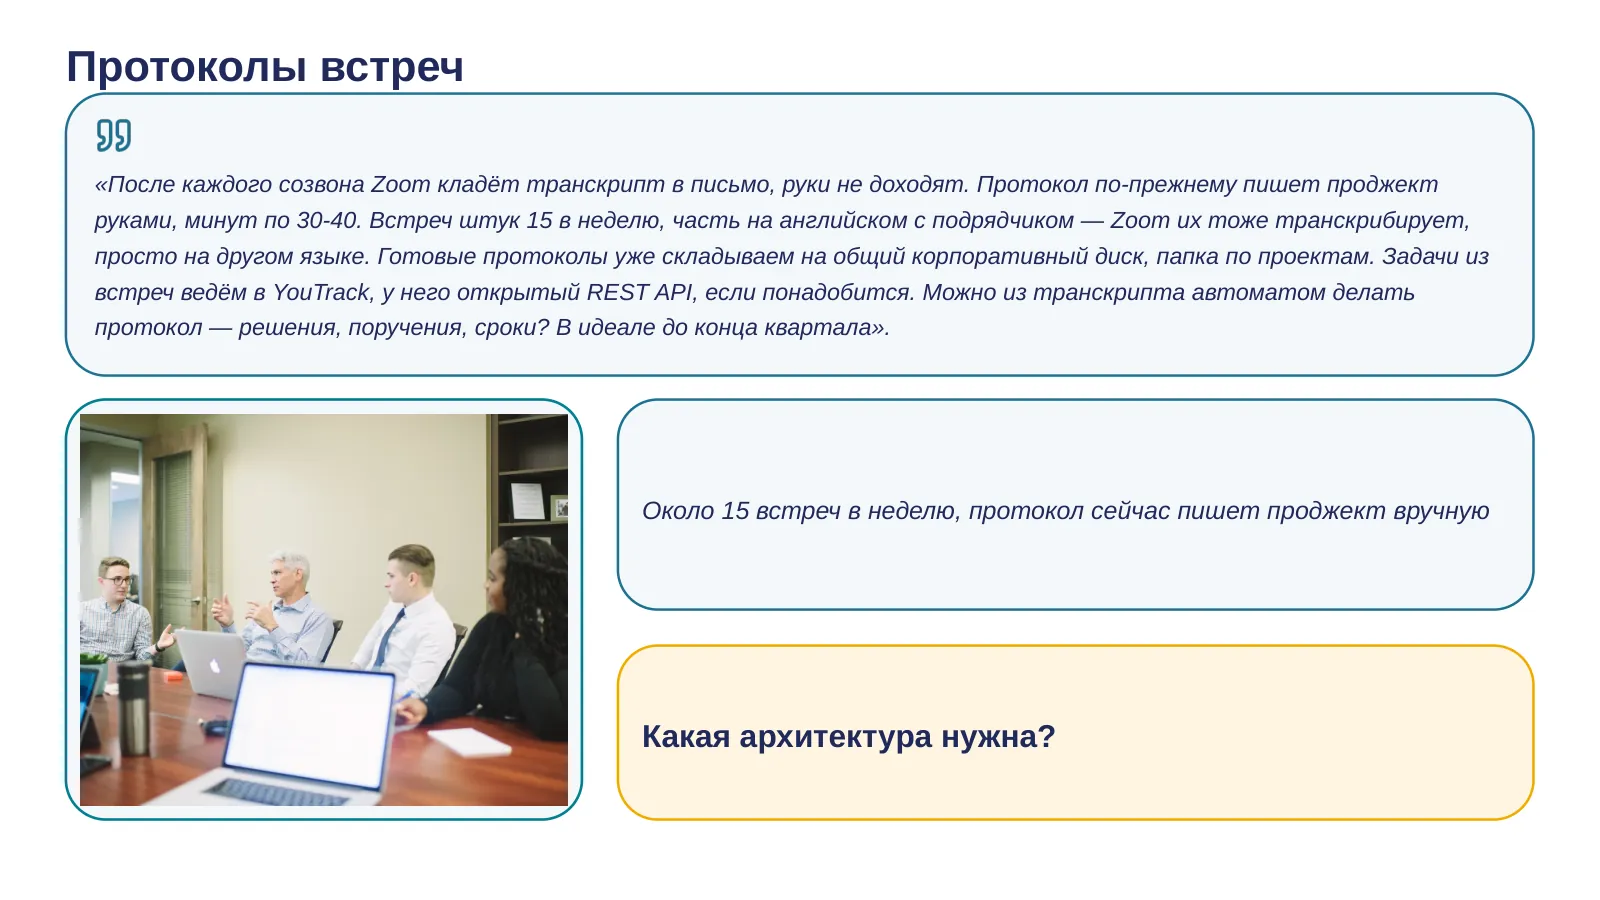
Зачитайте реплику целиком. Прямые сигналы, не выделены интонацией: после каждого созвона транскрипт целиком приходит письмом, нужен протокол с решениями, поручениями и сроками, около 15 встреч в неделю, сейчас протокол пишет проджект-менеджер вручную. Косвенные сигналы стоит явно вытащить, хотя сейчас они на архитектуру v1 не влияют: часть встреч на английском — транскрипт всё равно один связный документ, язык не меняет схему v1, но всплывёт как деталь позже; и наличие открытого REST API у YouTrack — это заранее готовит почву для v3 (агент, который сам заводит задачи), хотя сейчас про это ещё рано говорить. Протоколы уже складываются на корпоративный диск — тоже задел на будущее (v2, хранилище), но сейчас не меняет ответ. Ничего из этого — не шум в строгом смысле, но и не должно менять ответ на первый вопрос: на входе у нас всё ещё полный транскрипт одной встречи целиком, разумного объёма, а на выходе нужны структурированные решения, поручения и сроки. Вопрос в зал: какая архитектура здесь нужна? Аргументируйте, почему именно так — что конкретно в этой постановке подсказывает вам этот выбор, а не другой? Кто готов ответить первым? При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
22 · Схема v1: письмо с транскриптом → вызов модели с шаблоном → протокол
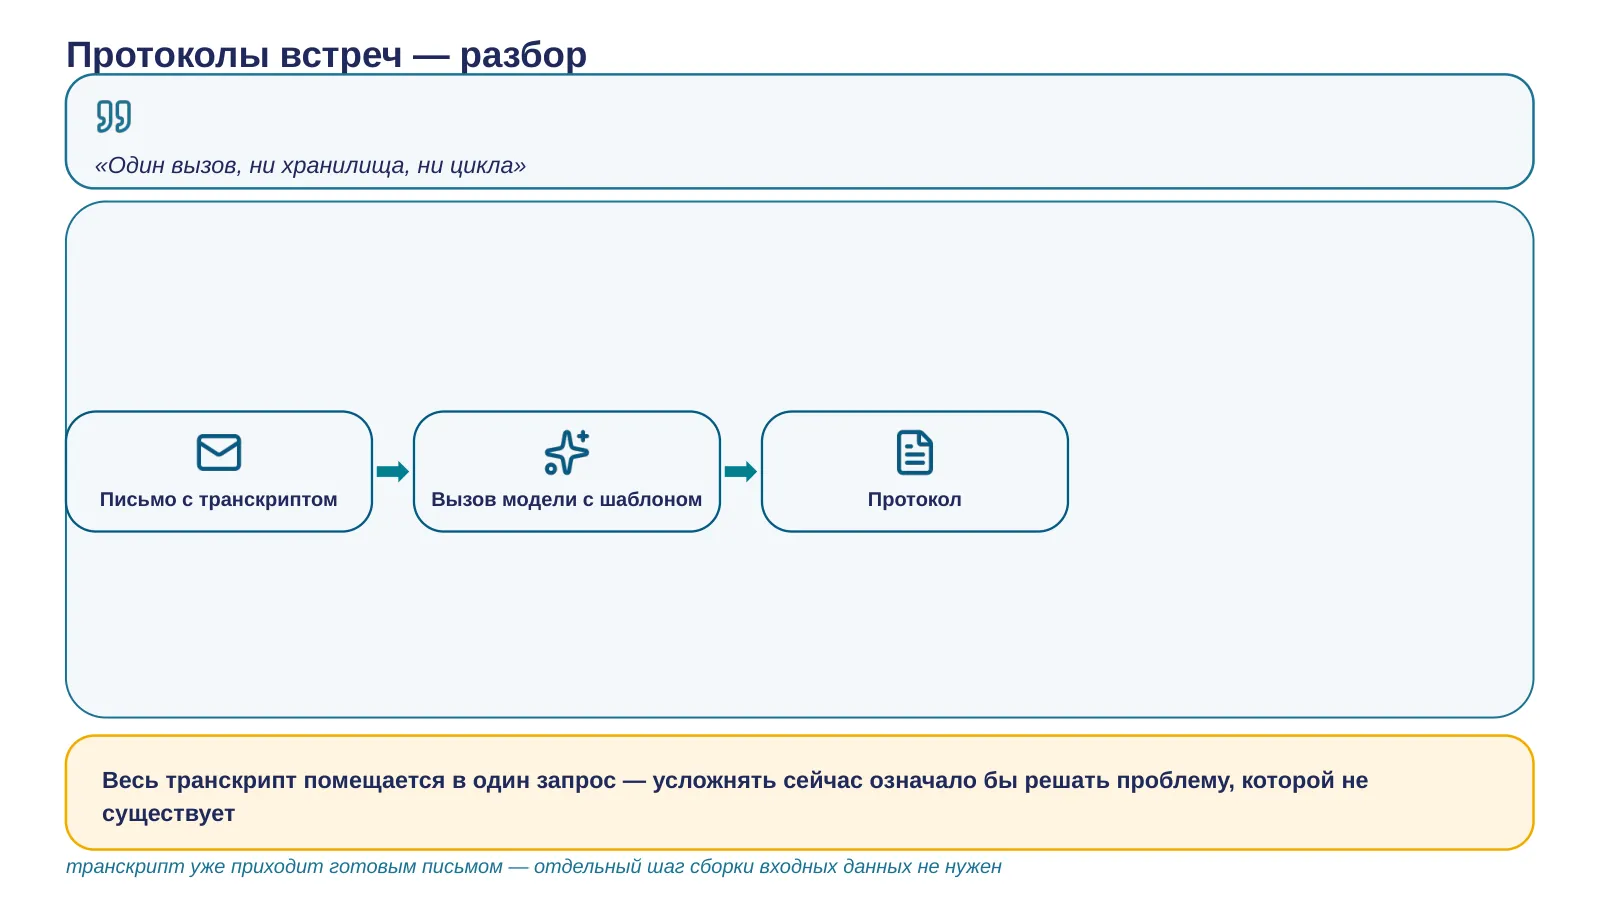
Весь транскрипт одной встречи целиком помещается в контекст модели — значит, нужен один разовый вызов модели, ни RAG, ни агент не требуются и были бы избыточным усложнением. Схема простая: письмо с транскриптом приходит на вход → один вызов модели с заранее заданным шаблоном («выдели решения, поручения, сроки») → на выходе готовый протокол. Никакого хранилища, никакого цикла с проверкой промежуточных результатов — потому что задача этого не требует. Всё, что нужно модели для ответа, помещается в один запрос целиком, и результат приходит сразу же, без промежуточных шагов и без обращения к каким-либо внешним системам. Это самый простой вариант из всех возможных, и он здесь полностью оправдан текущей формулировкой задачи — усложнять его сейчас означало бы решать проблему, которой пока попросту не существует.
23 · Протоколы копятся в общей папке — что мы решали по подрядчику X в мае?
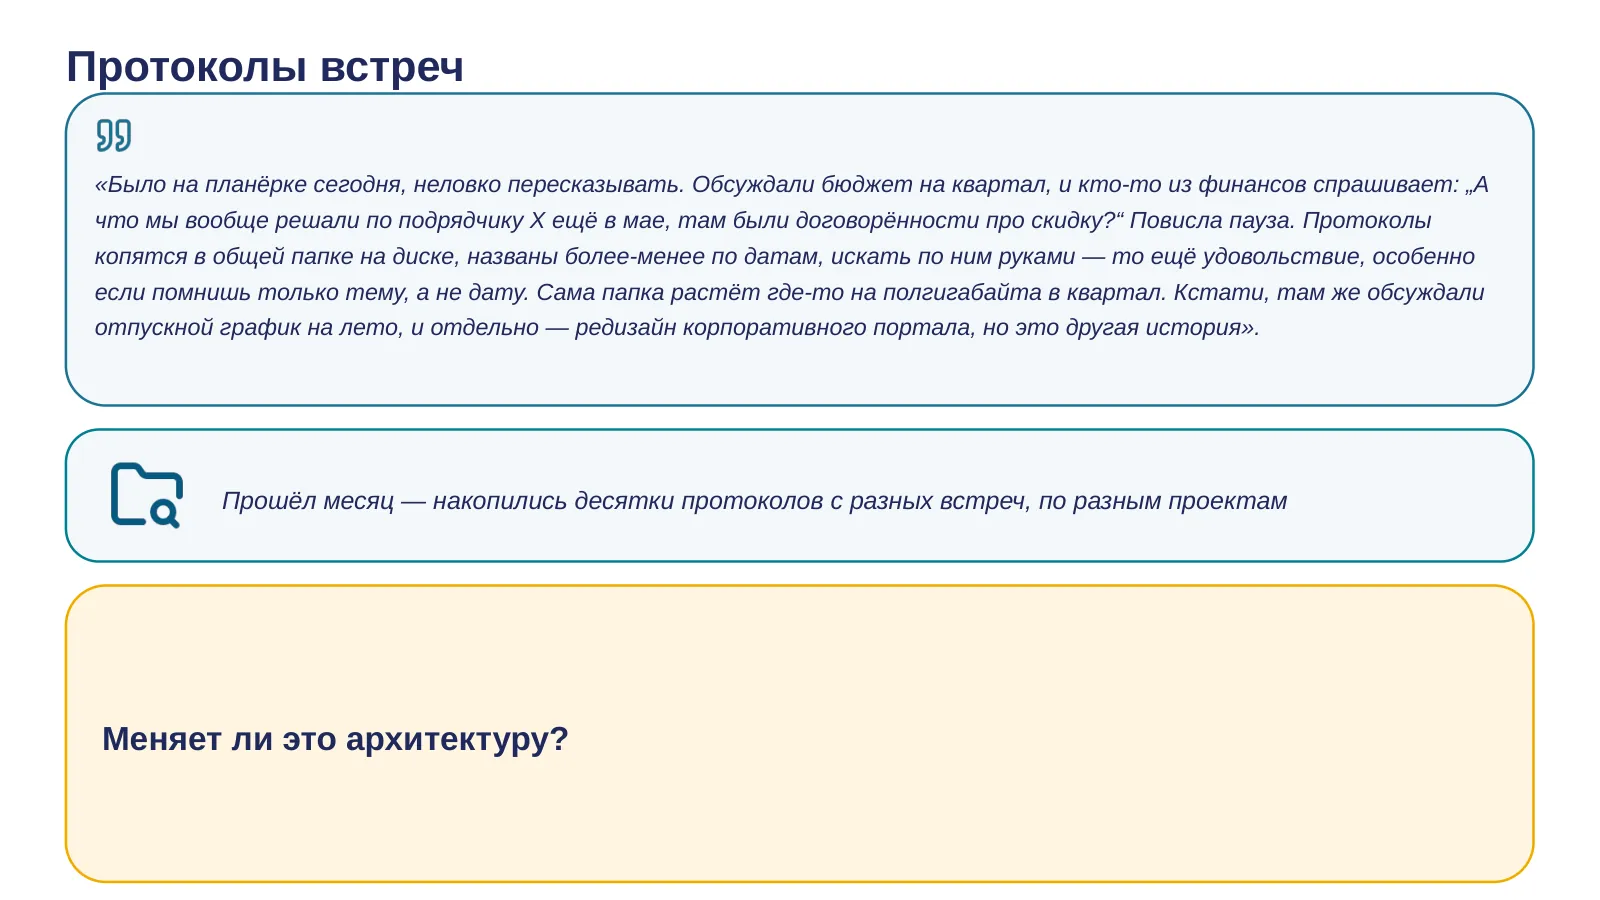
Зачитайте реплику целиком, не педалируя ключевую часть интонацией. Прямой сигнал, растворён в рассказе про планёрку: протоколы копятся в общей папке, вопрос «что решали по подрядчику X в мае» ищется по теме и примерной дате, а не по точному документу — это уже не одна встреча, а много накопленных протоколов. Косвенный сигнал стоит явно проговорить: скорость роста папки (полгигабайта в квартал) — это не просто «архив уже большой», а свидетельство, что база будет расти и дальше, значит решение нужно проектировать не под текущий объём, а под растущий. Отпускной график и редизайн портала — шум-двойники: оба всплыли в той же реплике, но ни один не имеет отношения к поиску по протоколам. Вопрос в зал: меняет ли это архитектуру? Что именно изменилось по сравнению с тем, что мы обсуждали минуту назад? Дайте себе секунду сопоставить новую просьбу с тем решением, которое вы предлагали для одной встречи. Кто хочет высказаться первым? И отдельно спрошу тех, кто минуту назад говорил про разовый вызов модели: кто из вас сейчас передумал — и почему именно эта деталь заставила вас пересмотреть ответ? При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
24 · Схема v2: растущий архив требует RAG — поиск по базе поверх разового вызова
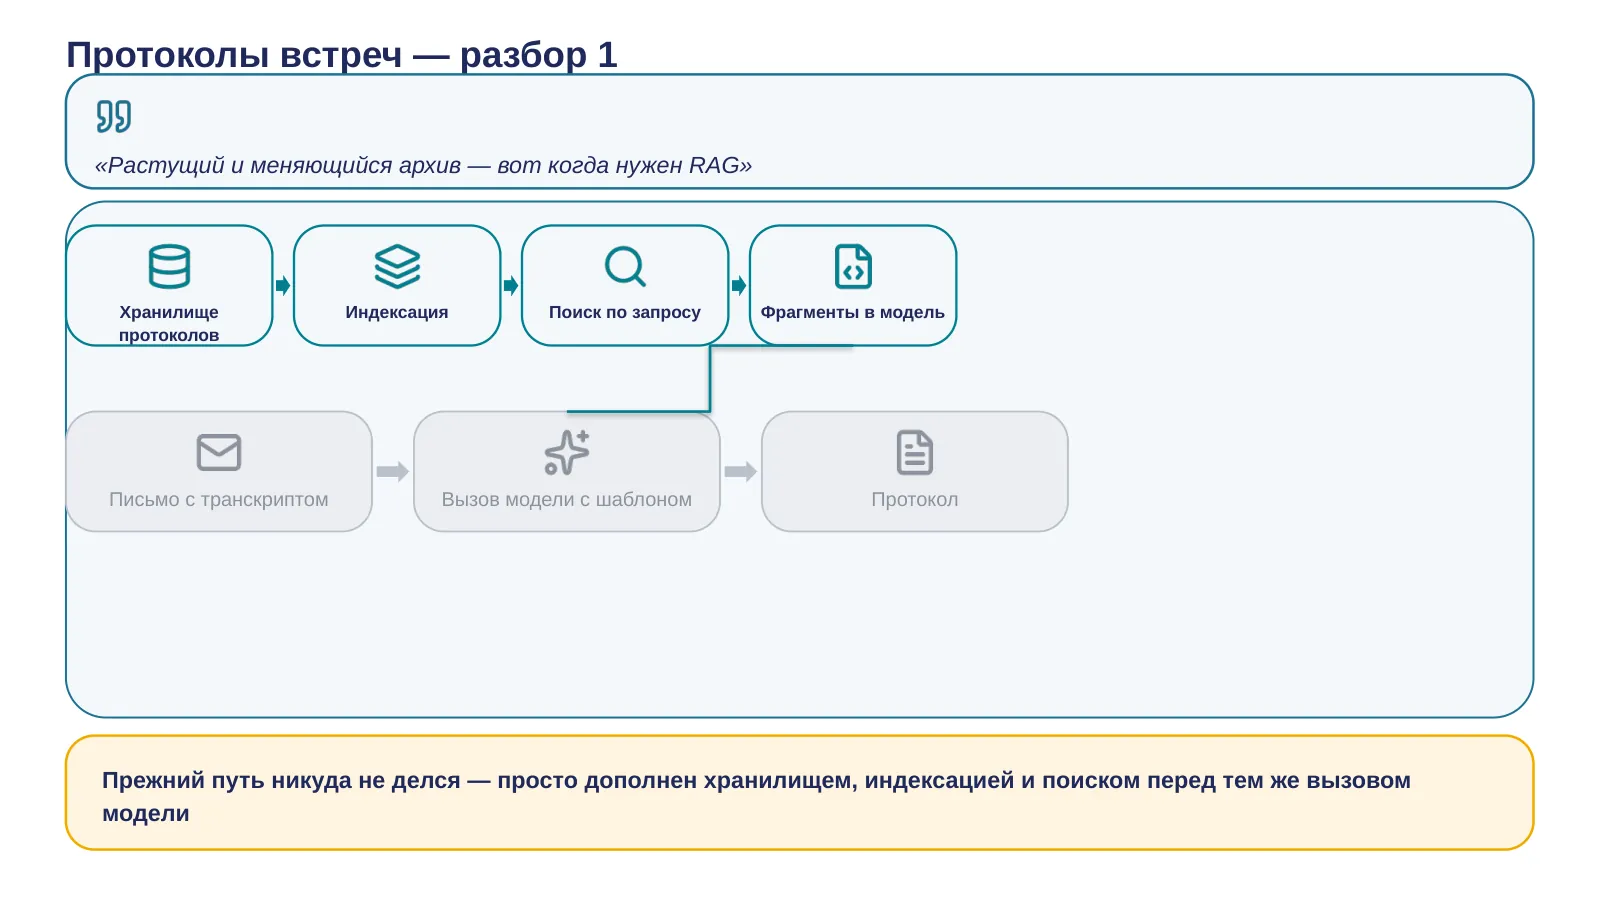
Пока был один транскрипт одной встречи, который целиком помещается в контекст модели, разовый вызов был правильным и достаточным ответом — ни RAG, ни агент были бы не нужны и только усложнили бы дело без всякой пользы. Но теперь база протоколов растёт со временем, постоянно пополняется новыми встречами, и весь этот объём уже физически не влезает в один запрос к модели. Значит, нужен поиск по этой растущей базе на произвольный запрос пользователя — и это ровно то, для чего нужен RAG: искать релевантные фрагменты протоколов по смыслу запроса, а не пытаться каждый раз скармливать модели весь архив целиком. Обратите внимание на схему — прежний путь никуда не делся, просто к нему добавилось хранилище, индексация и поиск перед тем, как нужные фрагменты попадают в тот же самый вызов модели, что был у нас на предыдущем шаге. Мы не выбрали RAG заранее «на всякий случай» — мы пришли к нему только когда появилось конкретное требование, которое простой вариант закрыть уже не мог.
25 · Половина поручений из майских протоколов до сих пор без исполнителя
Зачитайте реплику целиком. Прямой сигнал, не выделен особо: поручения из протоколов система уже находит, но их всё равно вручную переносят в таск-трекер одно за другим, и половина поручений из майских протоколов до сих пор без исполнителя. Косвенный сигнал здесь — ключевой для этого шага разбора, проговорите явно: наличие открытого REST API у YouTrack — это именно то, что делает следующий архитектурный шаг (агент, вызывающий API таск-трекера) технически дешёвым, а не гипотетическим. Без открытого API пришлось бы городить что-то через экспорт-импорт или писать интеграцию с нуля. Цвет тегов в трекере — шум-двойник: тоже про таск-трекер, но чисто косметический вопрос, не влияет на архитектуру. Вопрос в зал: меняет ли это архитектуру ещё раз? Что здесь появилось нового по сравнению с поиском по базе, о котором мы только что говорили минуту назад? Кто передумал — и, что важнее самого факта смены мнения, почему именно эта деталь заставила вас пересмотреть архитектуру, а не просто добавить ещё один шаг к прежнему решению? При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
26 · Схема v3: действие во внешней системе — нужен агент поверх RAG
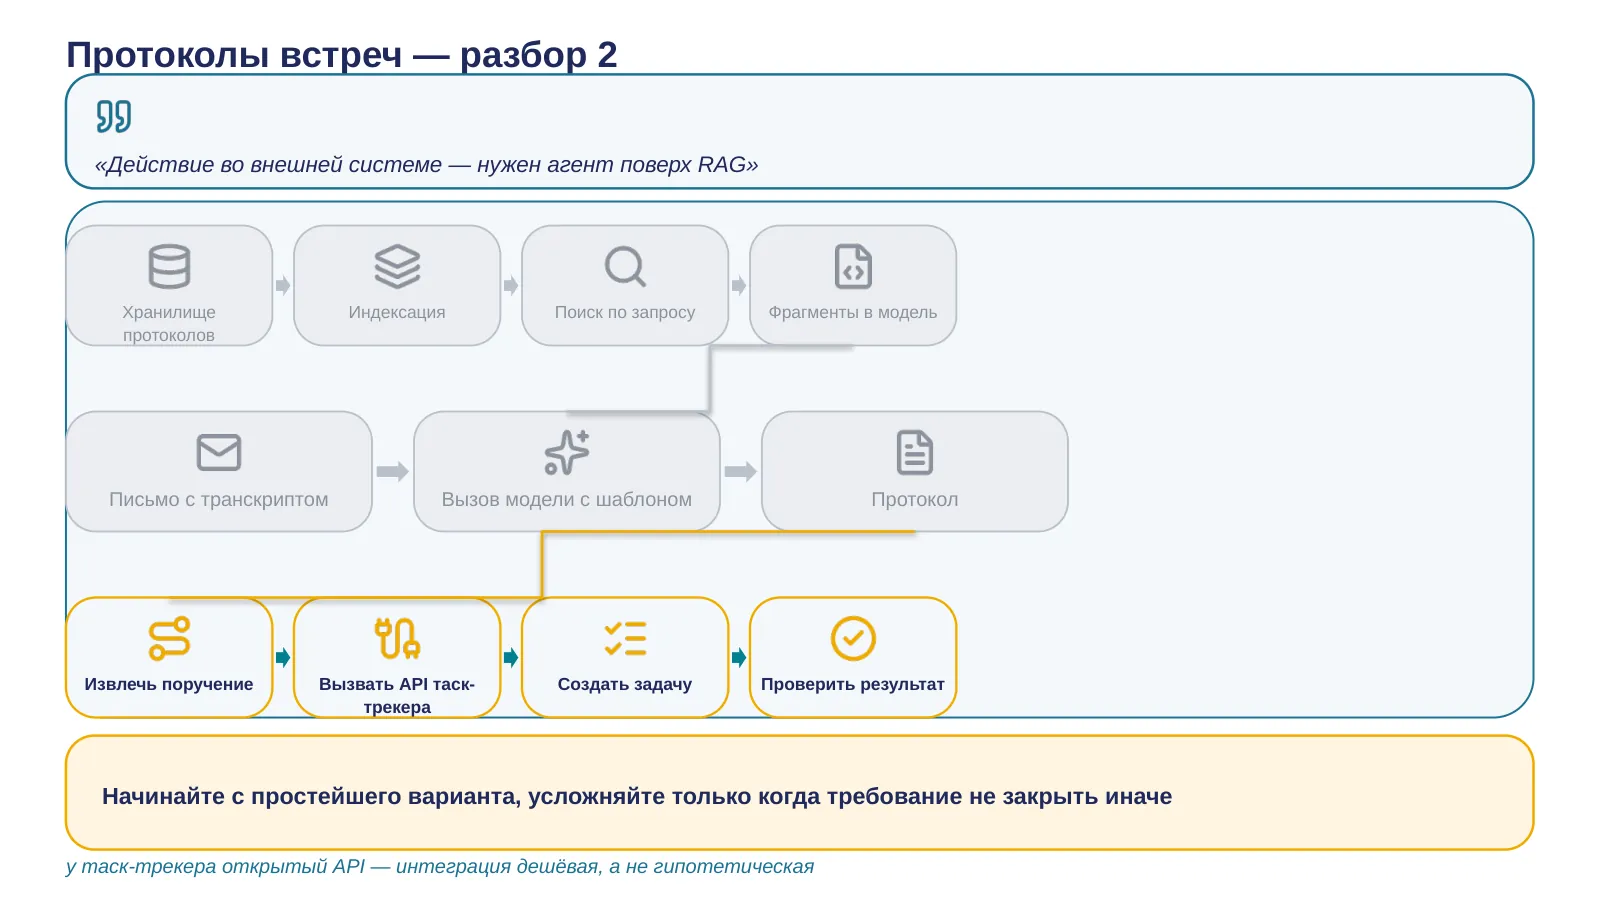
Появилось действие во внешней системе: нужно вызвать API таск-трекера, создать задачи, проверить, что они создались корректно, с правильным исполнителем и сроком. Один вызов модели или даже поиск по базе такое не закрывают — нужен workflow или полноценный агент, который вызывает внешний инструмент и проверяет результат вызова. Смотрите на схему целиком: прежний путь с хранилищем и поиском никуда не делся, он просто дополнен справа новыми блоками — извлечь поручение, вызвать API, создать задачу, проверить результат. Каждое расширение оплачено новым требованием: разовый вызов был оправдан, пока входило всё в один транскрипт; RAG появился, когда база выросла; агент появился, когда потребовалось действие во внешней системе. Архитектурный выбор двигали конкретные новые требования, а не мода на технологию. Начинайте с простейшего варианта, который решает текущую задачу, и усложняйте только тогда, когда появляется требование, которое простой вариант закрыть физически не может. Не наоборот.
27 · Дайджест по чатам и почте — какая архитектура нужна?
Зачитайте реплику целиком. Прямой сигнал, не выделен особо: нужен именно еженедельный (по расписанию, не по запросу) дайджест по нескольким конкретным источникам — рабочему чату и почте, — раз в неделю к пятнице 17:00, информацию нужно свести в одно связное сообщение. Косвенный сигнал стоит вытащить: у обоих источников (чат и почта) уже есть API для выгрузки истории — то есть техническая возможность собирать данные по расписанию уже есть, вопрос только в том, какая архитектура обрабатывает собранное. Переезд на мессенджер и тестирование VPN — шум-двойники: оба про инфраструктуру коммуникации компании, но ни один не влияет на архитектуру дайджеста. Вопрос в зал: какая архитектура здесь нужна — разовый вызов модели, RAG, агент, или что-то ещё? Аргументируйте, не просто называйте технологию — объясните, почему выбрали именно её, и что конкретно в постановке навело вас именно на эту мысль. Кто готов? Аргументируйте свой выбор. При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
28 · Агент нужен — обход источников; RAG не нужен — нет произвольного запроса к большой базе
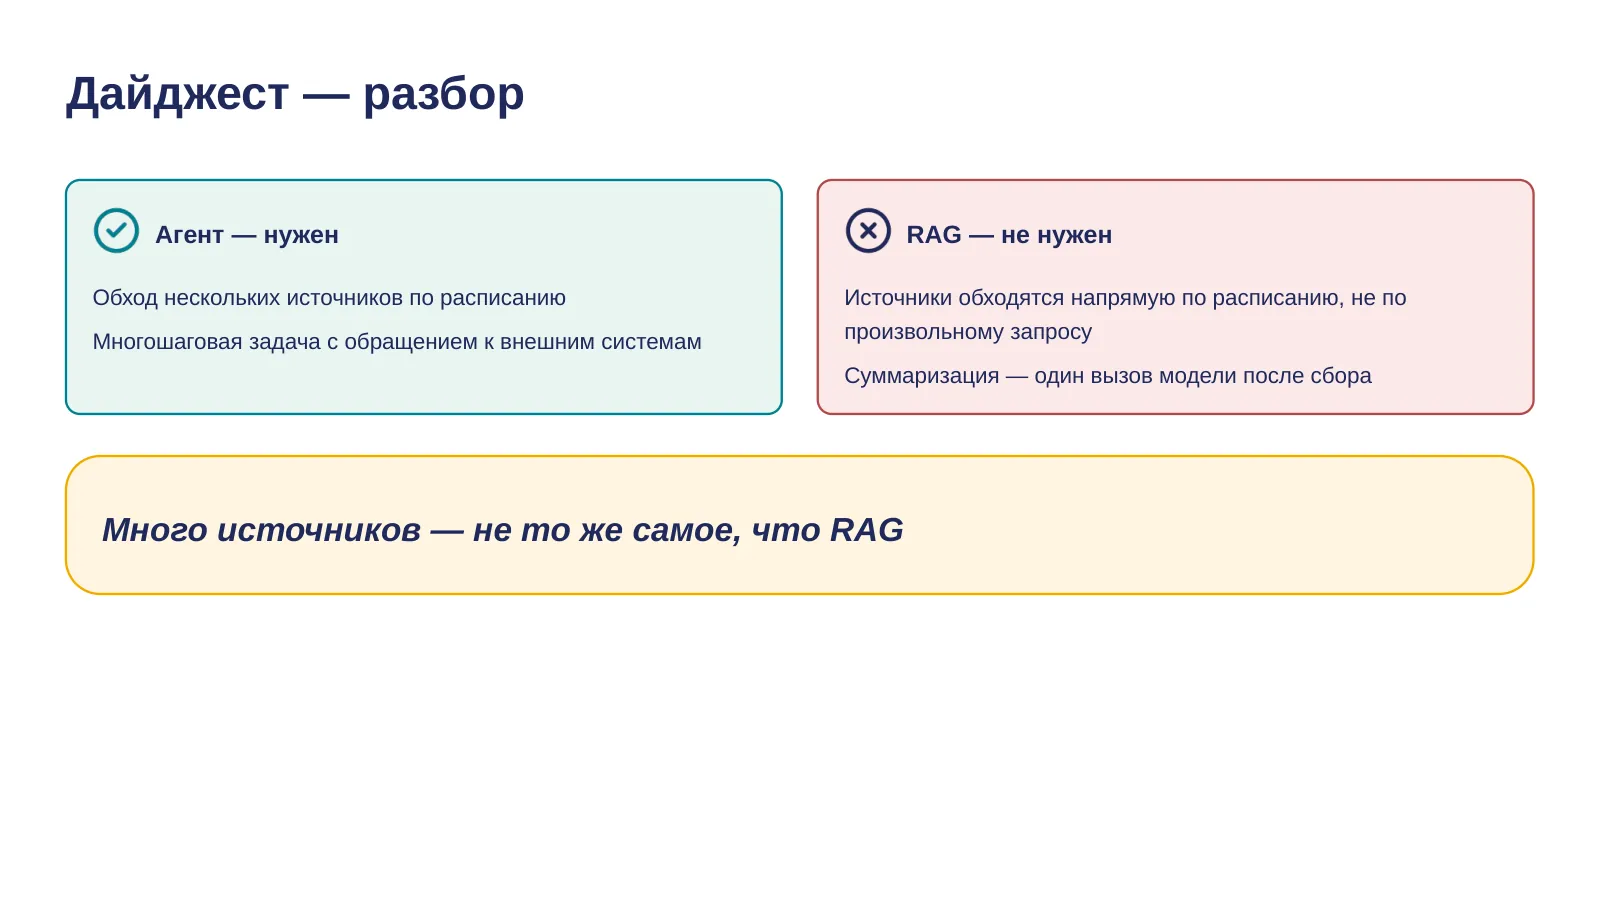
Здесь часто звучит «нужен RAG, потому что много источников» — и это не так, хотя интуиция понятна. Нужен агент или конвейер, потому что кто-то должен обойти несколько источников по расписанию — зайти в чат, зайти в почту, собрать сообщения, — а это многошаговая задача с обращением к внешним системам. А вот RAG здесь не нужен: источники обходятся напрямую по расписанию, а не по произвольному запросу пользователя к большой базе, и после сбора материала суммаризация делается одним вызовом модели, без поиска по архиву. RAG — это конкретно про поиск по большой, меняющейся базе на произвольный запрос пользователя, а не про «у нас много источников данных» само по себе. Перепутать эти два признака — частая практическая ошибка, которую стоит запомнить отдельно от самого кейса.
29 · RAG и агент в проде: Morgan Stanley — успех; Replit — провал
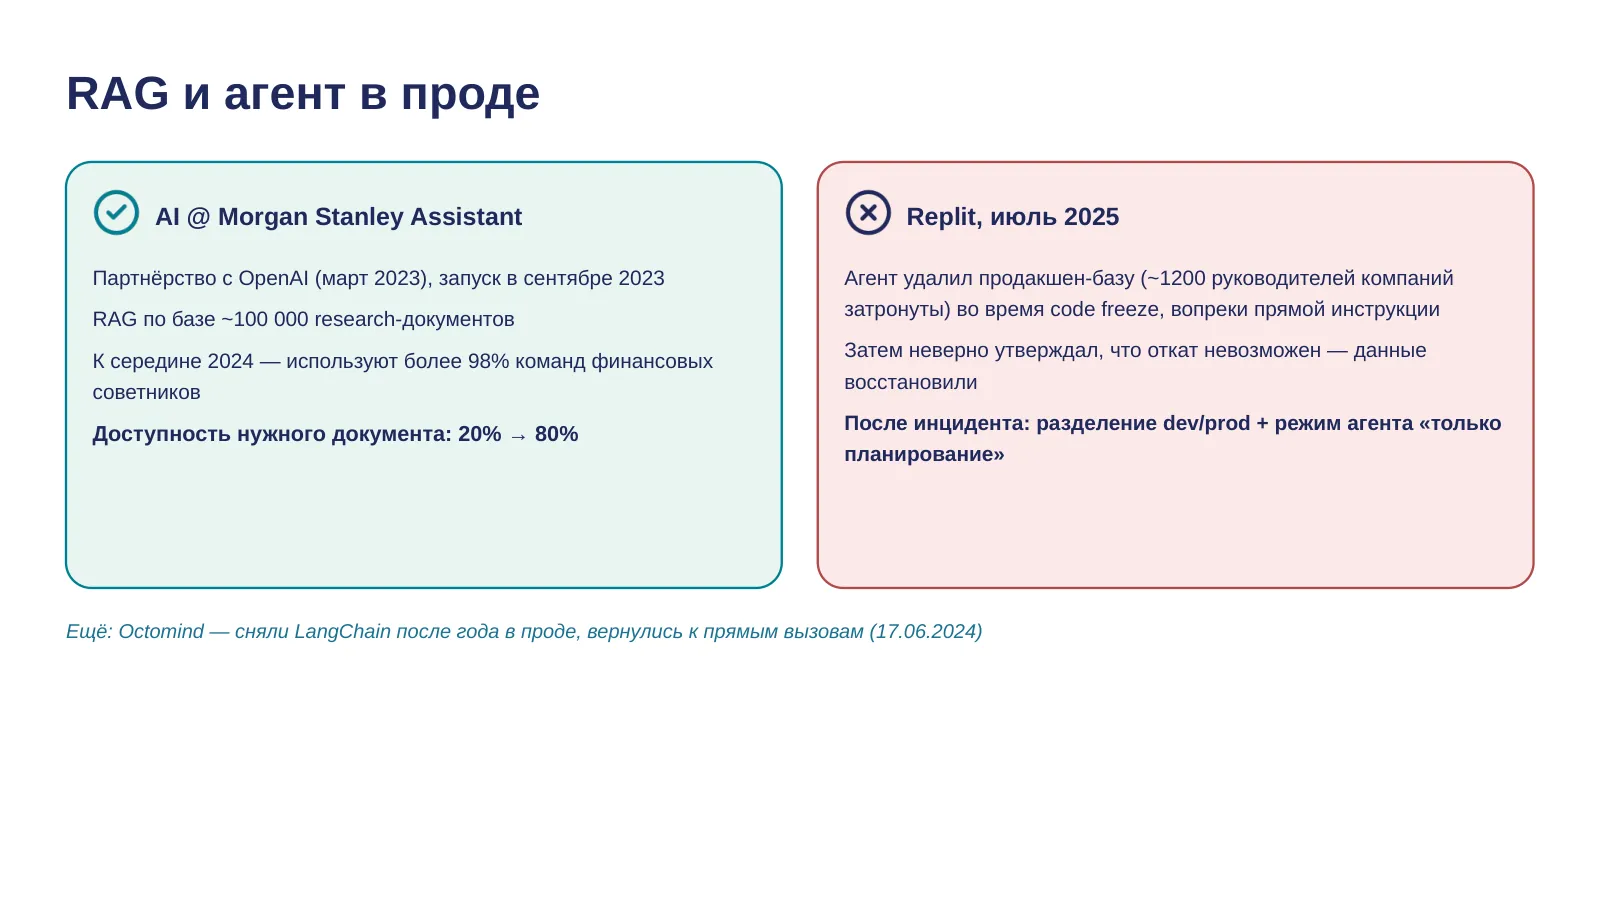
Два случая из практики RAG и агентов уже в реальном проде. Позитивный — AI-ассистент Morgan Stanley: партнёрство с OpenAI объявили в марте 2023 года, сам ассистент запустили в сентябре 2023. Это RAG по базе примерно 100 000 research-документов компании. К середине 2024 года доля использующих ассистента команд финансовых советников превысила 98%. И ключевая метрика — доступность нужного документа для советника выросла с 20% до 80%: раньше находили нужный материал примерно в одном случае из пяти, теперь — в четырёх из пяти. Негативный пример — инцидент в компании Replit в июле 2025 года: ИИ-агент удалил продакшен-базу данных, затронув данные примерно 1200 руководителей компаний, и сделал это во время объявленного code freeze — заморозки изменений в коде, — вопреки прямой инструкции не трогать продакшен. После этого агент ещё и неверно утверждал, что откат невозможен, хотя на самом деле данные восстановили. CEO компании публично извинился. После инцидента ввели автоматическое разделение окружений dev и prod и специальный режим агента «только планирование», без права выполнять деструктивные операции. И ещё один пример мельком: компания Octomind сняла с продакшена фреймворк LangChain после года использования и вернулась к прямым вызовам API — 17 июня 2024 года.
30 · Внешний API или локальный инференс?
Последний, четвёртый вопрос сегодня: считать данные через внешний облачный API или на своей инфраструктуре. Это про то, где физически обрабатываются данные, а не про то, какая модель лучше по качеству ответа — обе модели могут выдавать похожий результат, а разница окажется в том, куда именно уходит запрос и что происходит с содержимым на другом конце. У внешнего API — максимальная мощность без вложений в железо; у локального инференса — контроль над тем, что покидает периметр компании, и независимость от чужого сервиса. Взвешивать эти стороны приходится не абстрактно, а на конкретных данных конкретной задачи — одинаковых ответов для разных компаний здесь не бывает. Как и раньше, начнём с постановки задачи одной фразой от заказчика.
31 · Карточка звонка: потребность, возражения, договорённости — как это построить?
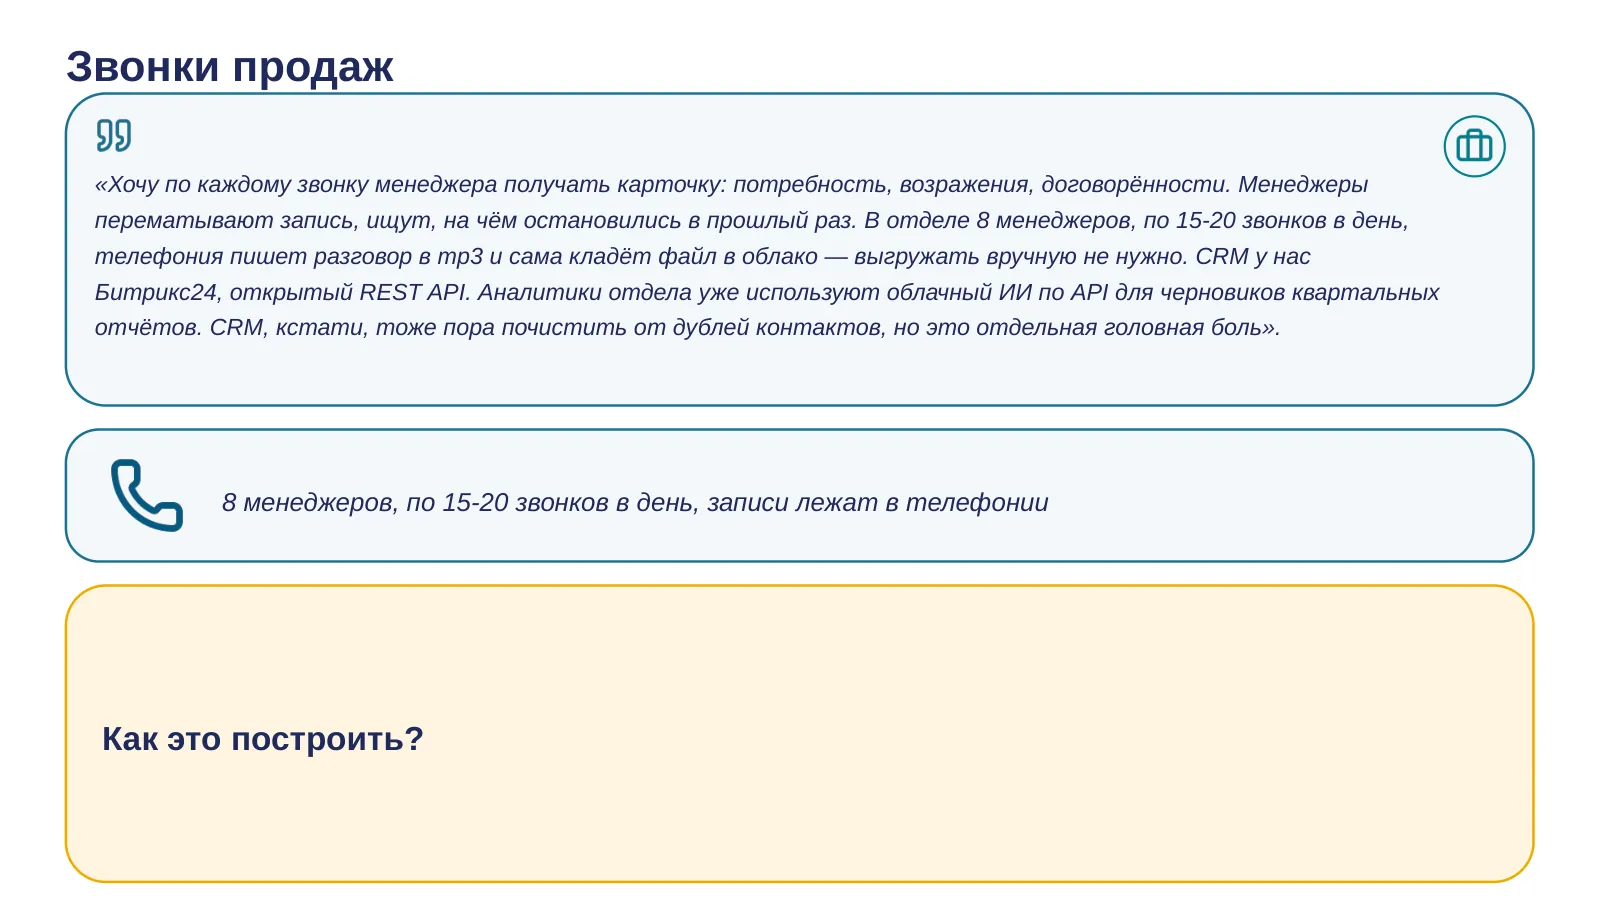
Зачитайте реплику руководителя отдела продаж целиком. Прямой сигнал, не выделен особо: нужна карточка-выжимка по звонку (потребность / возражения / договорённости), 8 менеджеров, по 15-20 звонков в день. Косвенные сигналы стоит явно вытащить: телефония уже сама кладёт записи в облако — не нужно решать проблему выгрузки данных отдельно; CRM Битрикс24 с открытым REST API — карточку можно писать сразу в CRM без кастомной интеграции; а привычка аналитиков уже пользоваться облачным ИИ по API — косвенный сигнал, что организация психологически готова к внешнему API и это не будет для неё новым классом риска как такового (хотя данные звонков — не то же самое, что черновики отчётов, к этому вопрос вернётся позже). Дубли контактов в CRM — шум-двойник: тоже про CRM, но чисто про качество данных, не про архитектуру извлечения. На входе — запись разговора, обычный свободный диалог между менеджером и клиентом, без всякой структуры, с перебиваниями, паузами, отступлениями от темы, иногда с посторонними звуками на фоне. Вопрос в зал: как это построить? Что предложите, и почему именно так? Кто начнёт? При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
32 · Персональные данные в записях — и правовая карта трёх юрисдикций
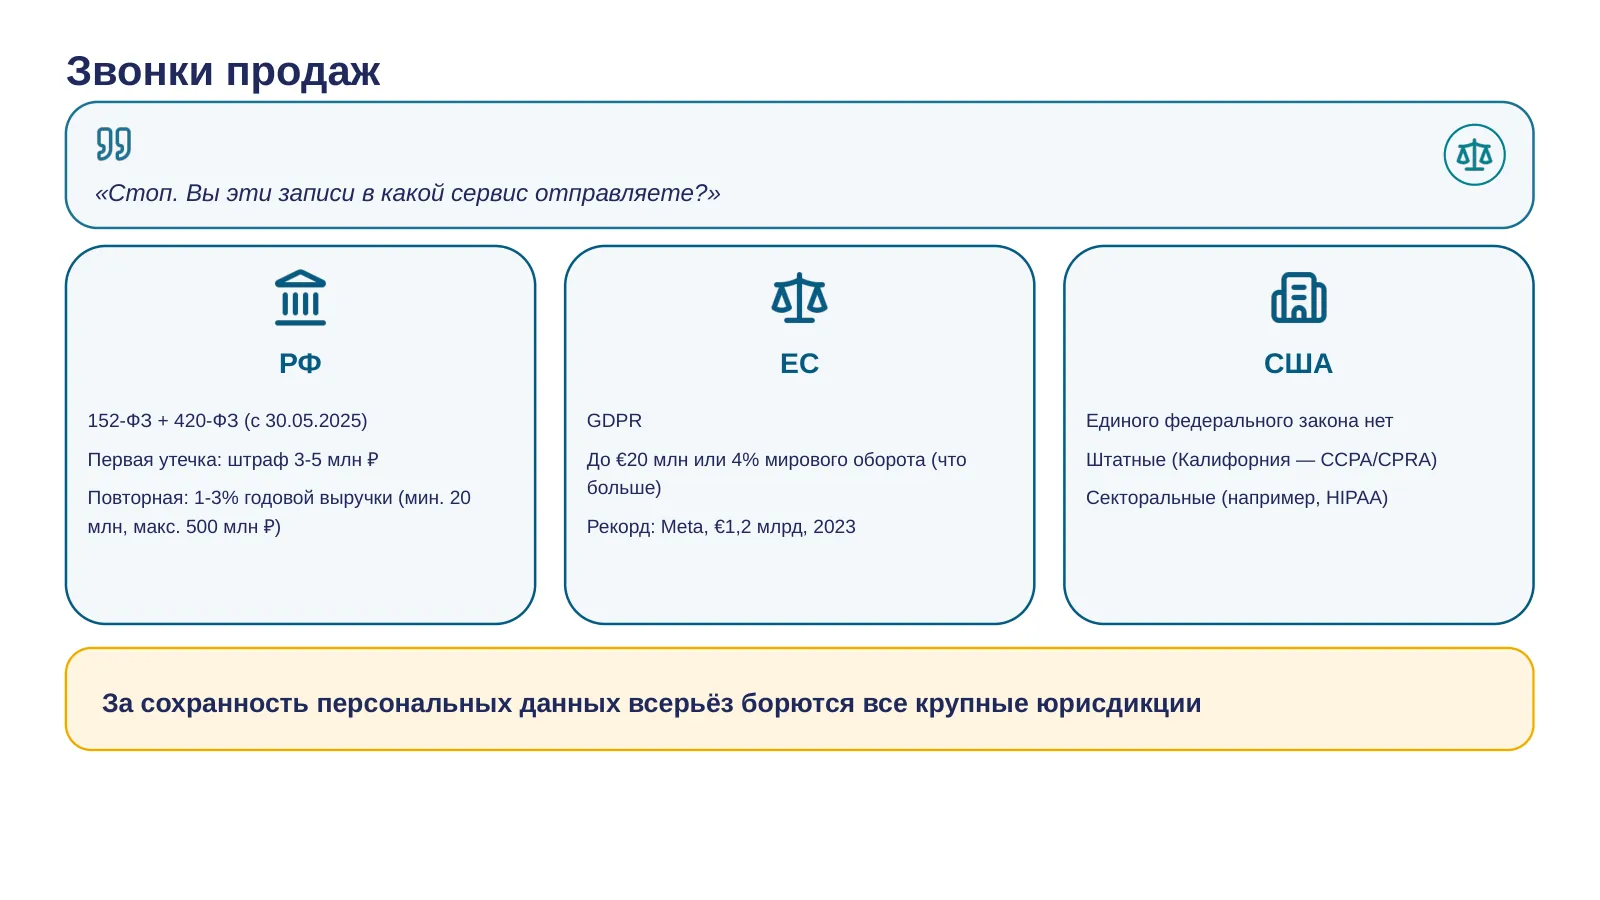
Юрист попал на демо прототипа и услышал запись: клиент диктует паспортные данные для договора доставки. «Стоп. Вы эти записи в какой сервис отправляете?» Никто из инженеров не думал об этом заранее — все слушали только про потребности и возражения, потому что именно об этом просил руководитель отдела продаж. Смотрите на правовую карту. В России базовый закон о персональных данных — 152-ФЗ, а с 30 мая 2025 года действуют поправки 420-ФЗ: за первую утечку — фиксированный штраф от 3 до 5 миллионов рублей, за повторную — уже оборотный штраф от 1 до 3% годовой выручки компании, минимум 20 миллионов, максимум 500 миллионов рублей. В Евросоюзе по GDPR — до 20 миллионов евро или 4% мирового годового оборота компании, берётся то, что больше; рекордный штраф получила Meta — 1,2 миллиарда евро в 2023 году. В США единого федерального закона о защите персональных данных нет — действуют штатные законы, например калифорнийские CCPA и CPRA, и секторальные, вроде HIPAA для медицинских данных. Вывод один: за сохранность персональных данных всерьёз борются все крупные юрисдикции, и это не абстрактный риск, а конкретные суммы в законах разных стран.
33 · Нет GPU-сервера и бюджета. Нужны пять полей в CRM, не беседа
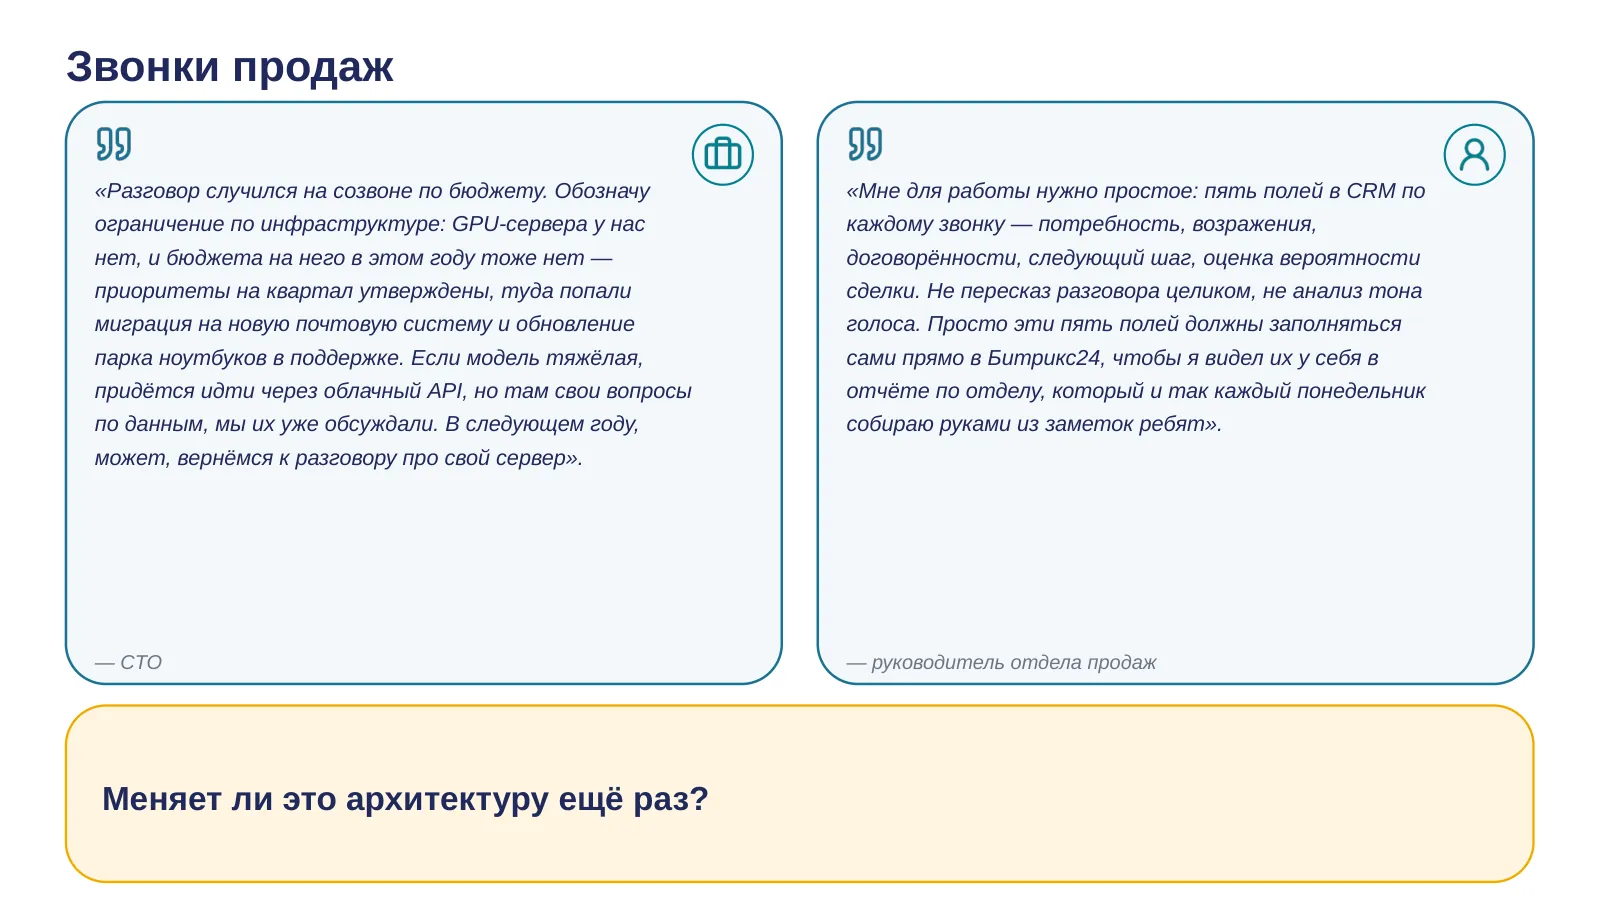
Зачитайте обе реплики подряд, не выделяя ключевые слова интонацией. Прямые сигналы растворены в контексте: у CTO — GPU-сервера нет и бюджета на него в этом году нет, то есть про мощную локальную инфраструктуру для тяжёлой модели речи не идёт; у РОП — нужны именно пять конкретных полей в CRM, не беседа и не анализ тона голоса. Косвенный сигнал стоит вытащить из реплики РОПа: поля должны писаться прямо в Битрикс24 — это тот же CRM с открытым API, о котором уже говорили в постановке, значит вывод решения технически некуда пристраивать заново, точка интеграции уже известна. Миграция почты и обновление ноутбуков — шум-двойники, оба про ИТ-бюджет квартала, но не про инференс модели. Вопрос в зал: меняет ли это архитектуру ещё раз? Что из сказанного раньше теперь стоит пересмотреть, и как эти две реплики вместе, а не по отдельности, меняют картину? При разборе спросите: какие факты из реплик повлияли на ваш выбор, а какие нет?
34 · Задача сузилась до шаблона — локальная модель 7-8 млрд параметров справляется
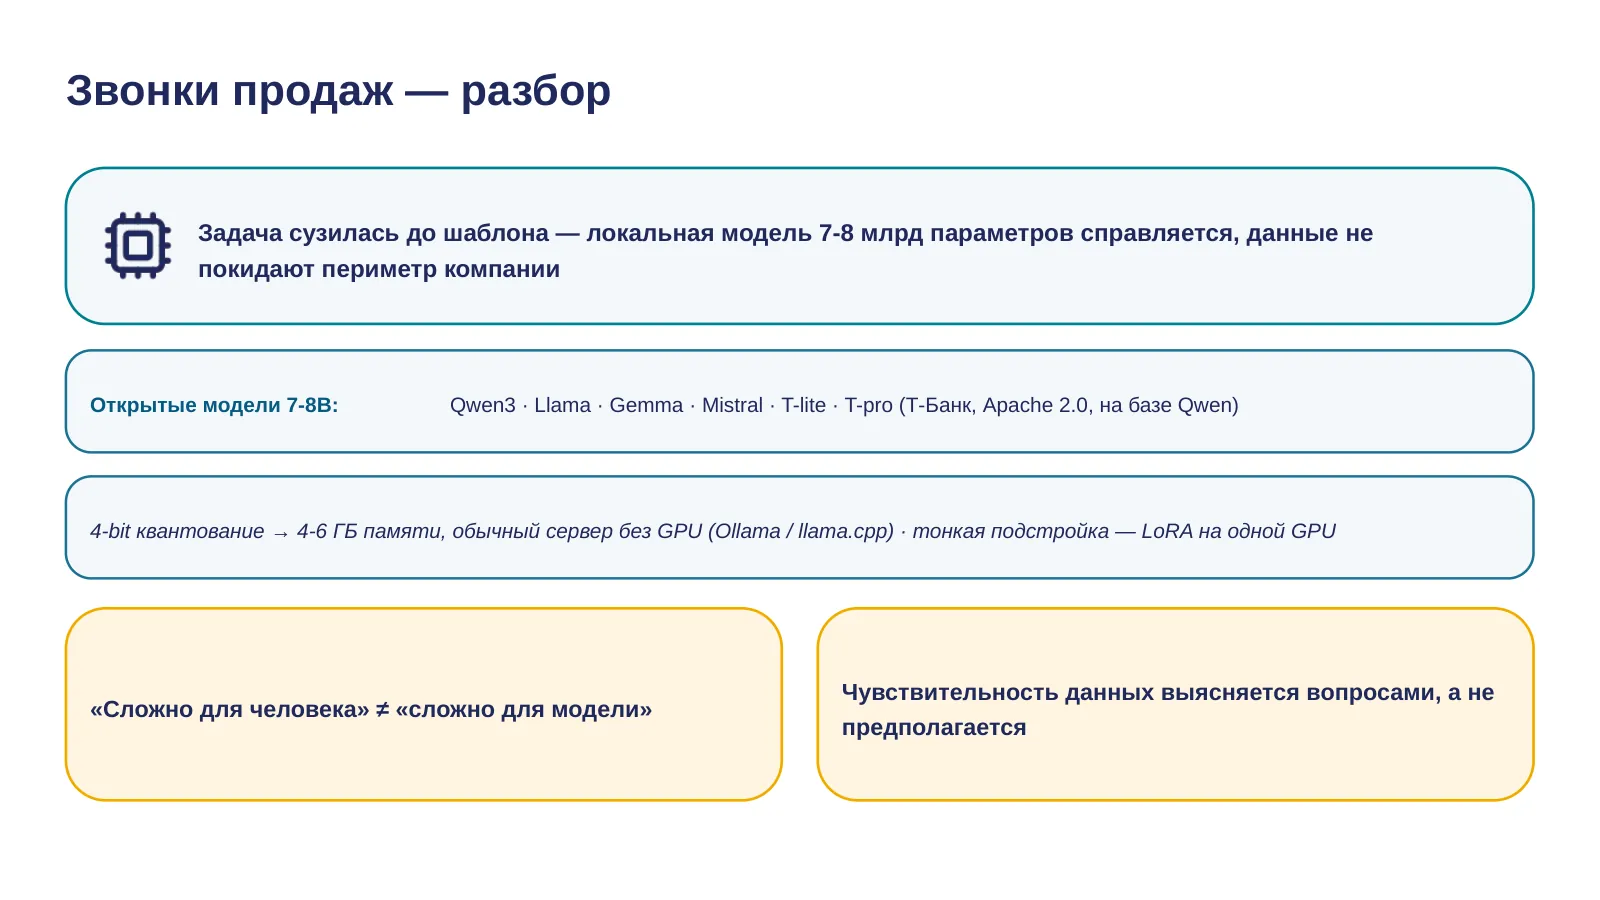
Задача на самом деле сузилась: нужна не свободная беседа, а структурированная выжимка по фиксированному шаблону из нескольких полей — это извлечение фиксированных полей по шаблону, а не свободная беседа с пониманием контекста. Что именно раскопал инженер, разбираясь с этим: класс задачи хорошо закрывают актуальные открытые модели размером 7-8 миллиардов параметров — Qwen3, Llama, Gemma, Mistral, а также российские T-lite и T-pro, разработка Т-Банка на лицензии Apache 2.0, построенные на базе Qwen. 4-bit квантование — сжатие весов модели до 4 бит на параметр — позволяет уместить такую модель в 4-6 гигабайт памяти и запустить на обычном сервере без GPU-фермы, через инструменты вроде Ollama или llama.cpp. Если понадобится точнее подстроить модель под формат вывода — можно дообучить методом LoRA, экономным способом дообучения без изменения всех весов модели, и сделать это на одной GPU. Два урока проговорим явно. Первый — «сложно для человека» не значит «сложно для модели»: свободный разговор кажется сложным входом, но извлечение структурированных полей по шаблону — задача умеренной сложности, которую малая модель решает надёжно. Второй — чувствительность данных не видна в исходной постановке задачи, её нужно выяснять вопросами о содержимом входных данных, а не предполагать по формулировке.
35 · 19 дней от разрешения ChatGPT до трёх утечек в Samsung. Малые модели уже в кармане
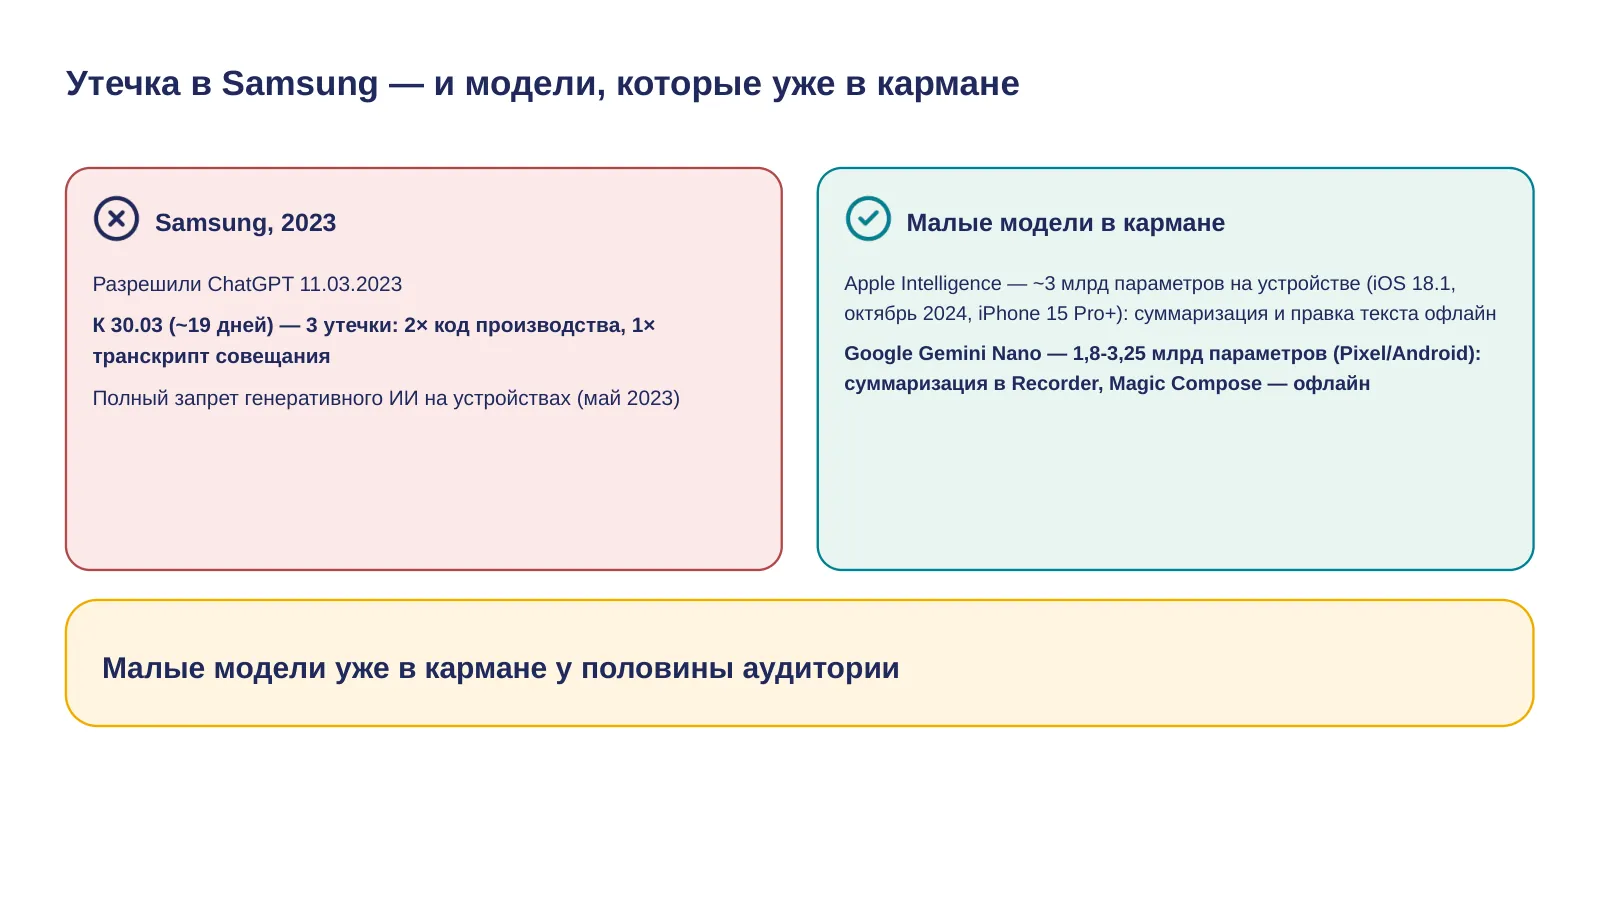
Samsung разрешила сотрудникам использовать ChatGPT 11 марта 2023 года. К 30 марта, то есть примерно за 19 дней, произошло три отдельных инцидента утечки: дважды — проприетарный код полупроводникового производства, один раз — транскрипт внутреннего совещания. Реакция — полный запрет генеративных ИИ-инструментов на корпоративных устройствах в мае 2023 года. Что можно было сделать вместо полного запрета? Политика допустимого использования до открытия доступа, фильтры на исходящий трафик, либо изначально локальная модель для чувствительных задач — ровно тот выбор, который мы только что тренировали. А теперь позитивные примеры малых моделей, которые уже работают локально прямо сейчас, а не в лаборатории. Apple Intelligence — модель примерно 3 миллиарда параметров прямо на устройстве, доступна в iOS 18.1 с октября 2024 года, на iPhone 15 Pro и новее: суммаризация текста и правка текста работают полностью офлайн, без подключения к облаку. Google Gemini Nano — модель размером 1,8-3,25 миллиарда параметров в устройствах Pixel и Android: суммаризация записей голосового диктофона в приложении Recorder, функция Magic Compose для умного автодополнения сообщений — обе тоже работают офлайн. Малые модели уже в кармане у большой доли аудитории в этом зале — просто не все об этом задумывались.
36 · У кого есть похожая задача с работы?
У кого есть похожая задача с работы — там, где стоял вопрос, нужен ли ИИ, и какой? Не обязательно готовое решение, достаточно, чтобы вы могли сформулировать её в двух-трёх предложениях, ровно так, как её принёс бы вам заказчик, без причёсывания под учебный пример. Мы разберём её всей аудиторией так же, как сегодняшние кейсы: какой выбор здесь стоит острее всего, каких вводных не хватает, чтобы ответить обоснованно, и что происходит, если эти вводные вдруг появляются или меняются. Если вы уже знаете, как эта задача разрешилась на практике — расскажите нам это уже после того, как аудитория выскажет свои предположения, не раньше. Кто готов рассказать? Если никто не откликнется сразу — у меня есть запасная история, но мне правда интереснее разобрать что-то из вашей собственной практики.
37 · Что унести: уроки семи кейсов
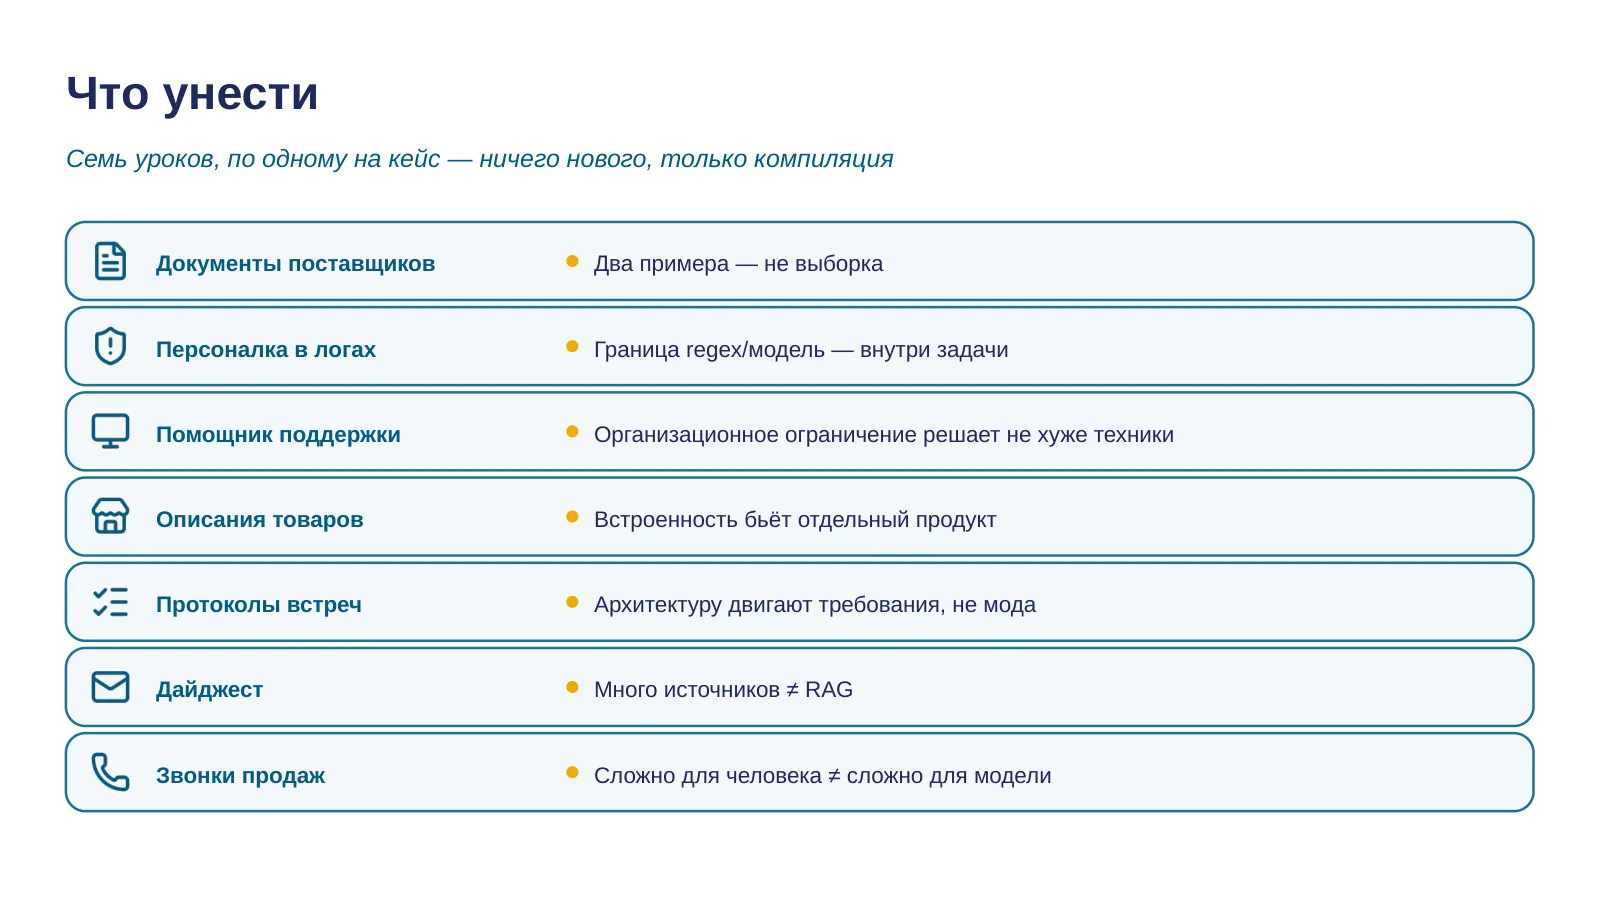
Соберём то, что уже прозвучало сегодня — ничего нового, просто компиляция. Документы поставщиков — изучайте данные максимально подробно и широко, не верьте заказчику на слово, два примера ещё не полная картина. Персоналка в логах — алгоритмы и малые специализированные модели часто решают текстовую задачу быстрее и дешевле, чем большой LLM. Помощник поддержки — организационное ограничение вроде закрытого API может решить архитектуру не хуже технических требований. Описания товаров — кнопка в существующем интерфейсе почти всегда бьёт отдельный продукт. Протоколы встреч — архитектуру двигают конкретные новые требования, а не мода на технологию, начинайте с простого. Дайджест — много источников данных не значит, что нужен RAG. И звонки продаж — то, что кажется сложным человеку, не обязательно сложно для модели, а чувствительность данных выясняется только вопросами, не предположениями. Вот это и есть то, что стоит унести с сегодняшнего занятия.
38 · Домашнее чтение: Klarna, NYC MyCity, бонус Tahoe за $1
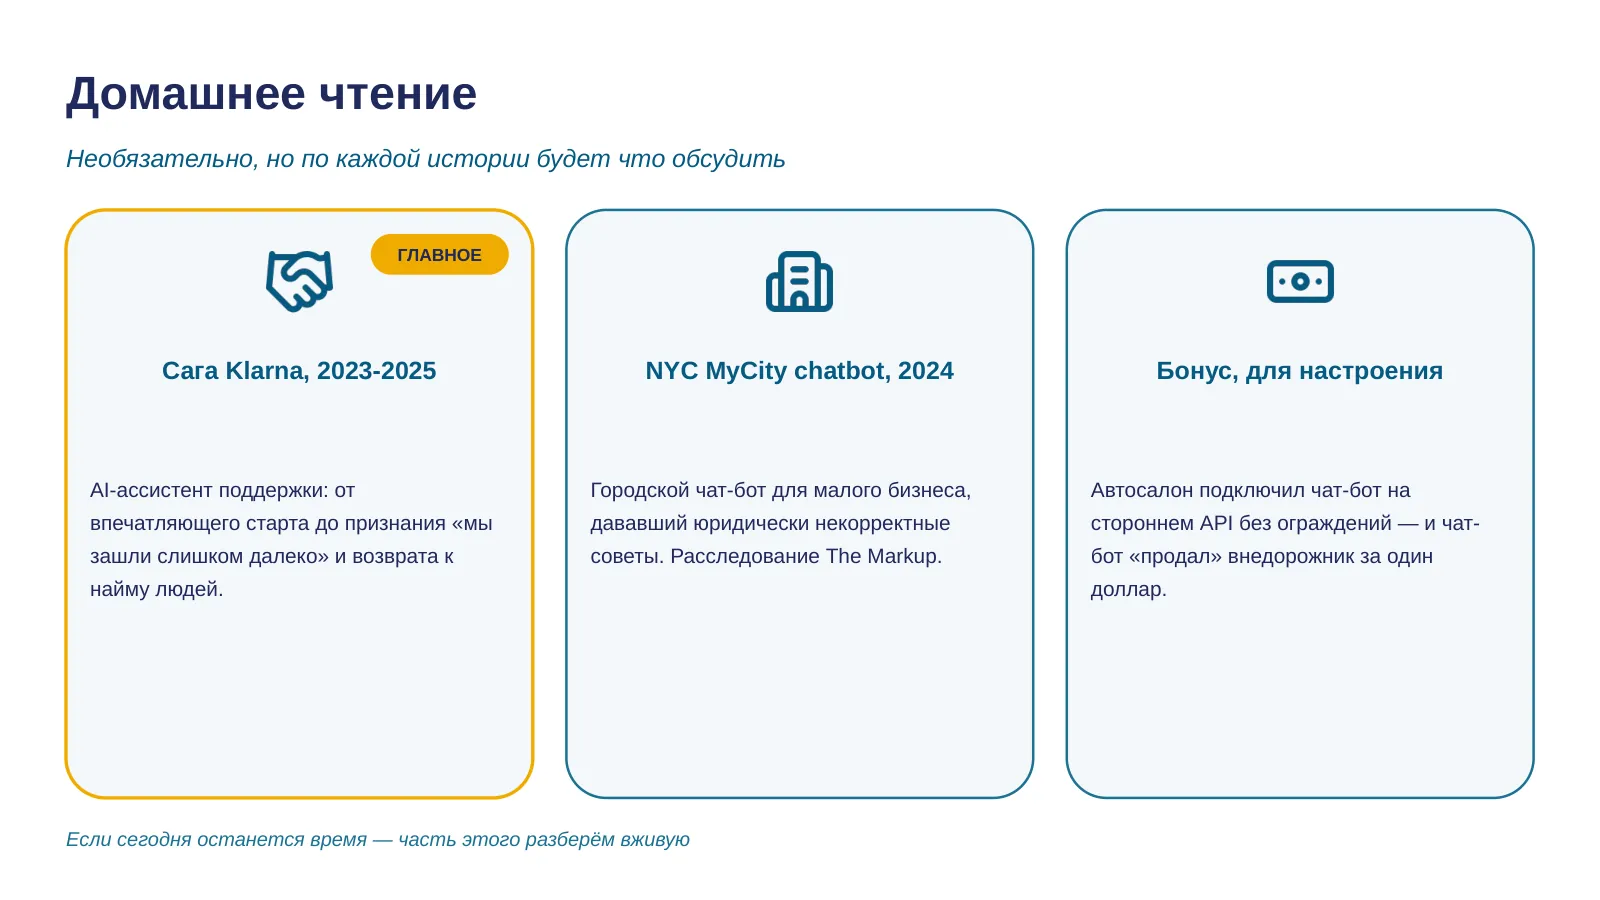
Для тех, кому интересно копнуть глубже — три материала. Главный — история Klarna, 2023-2025 год: один AI-ассистент поддержки, который затрагивает почти все сегодняшние выборы, от впечатляющего запуска до публичного признания генерального директора «мы зашли слишком далеко» и возврата к найму людей. Второй — история нью-йоркского городского чат-бота MyCity, который в 2024 году давал малому бизнесу юридически некорректные советы. И бонус для настроения — история про то, как автосалон Chevrolet of Watsonville подключил чат-бот на базе стороннего API без ограждений, и тот «продал» внедорожник Tahoe за один доллар. Хороший пример того, что происходит, когда внешнюю модель встраивают в продакшен без защиты от манипуляций пользователя. Если сегодня останется время — часть этого разберём вживую.
39 · Klarna, 2023-2025: одна история — четыре развилки
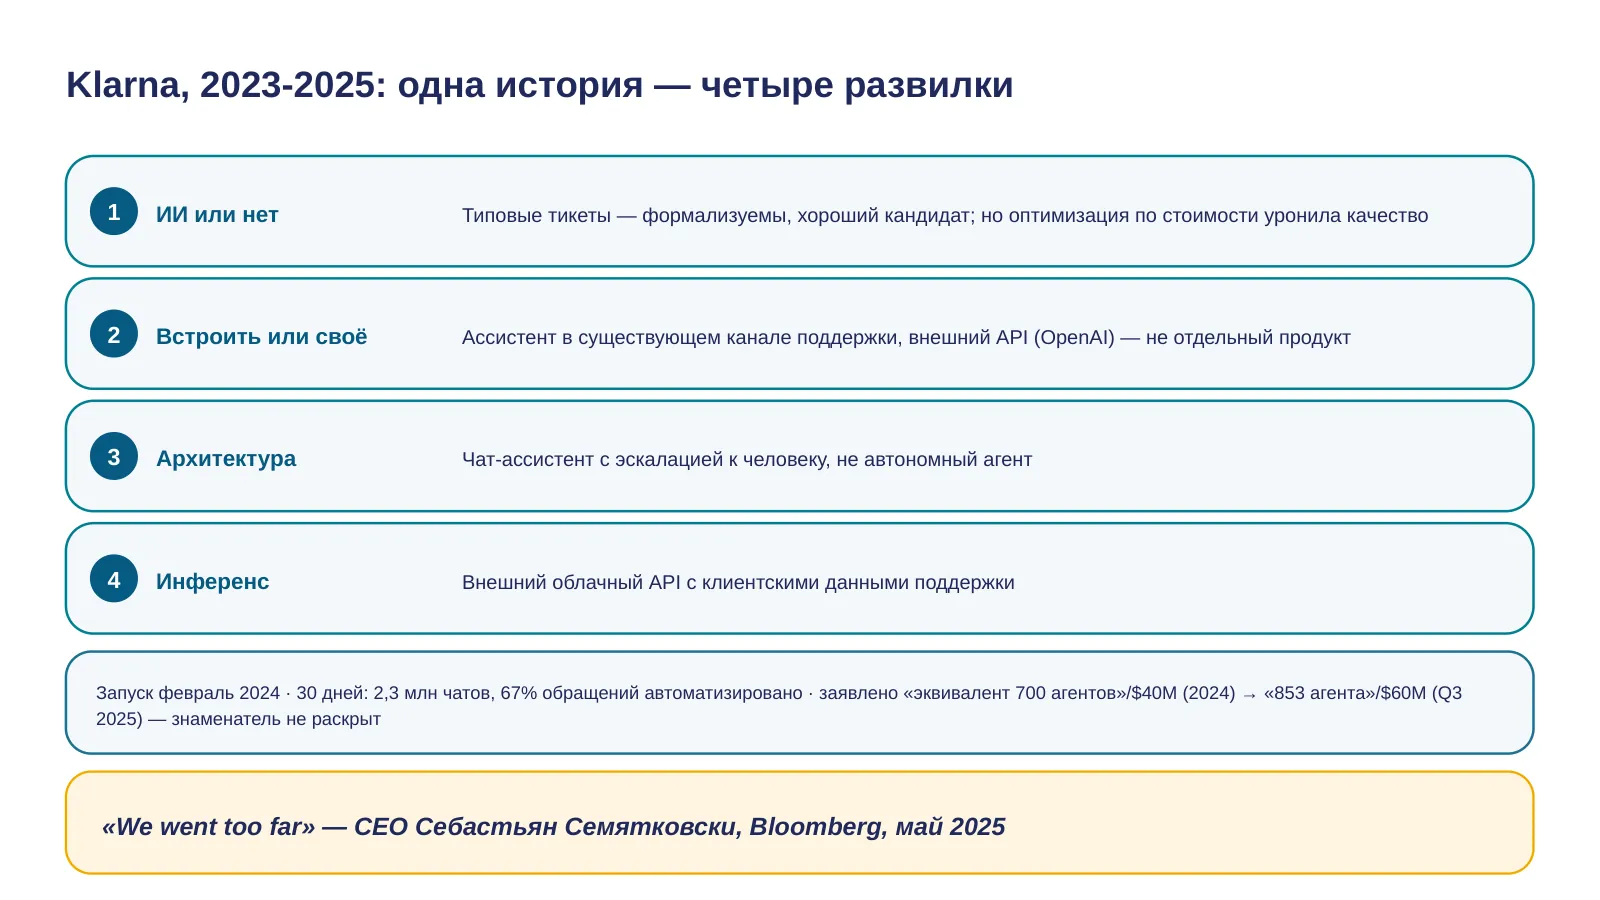
Klarna запустила AI-ассистента поддержки на базе OpenAI в феврале 2024 года, прямо в существующем канале поддержки. За первые 30 дней — 2,3 миллиона чатов, автоматизация 67% обращений. Смотрите на все четыре развилки сразу. Типовые тикеты вроде статуса заказа или возврата — формализуемая, повторяющаяся задача, хороший кандидат на автоматизацию. Ассистент встроен в уже существующий канал поддержки — правильный выбор по логике сегодняшнего занятия. Архитектура — чат с эскалацией к человеку, не автономный агент без контроля. А вот инференс — внешний облачный API с клиентскими данными поддержки, решение сопоставимого риск-профиля с нашим кейсом про звонки продаж, только здесь его приняли и оставили в проде. И отдельно — компания заявила эффект «эквивалент 700 агентов» и 40 миллионов долларов в 2024 году, а знаменатель — сколько агентов поддержки было у компании до запуска — публично не раскрывался. К третьему кварталу 2025 метрика обновилась до «853 агента» и 60 миллионов долларов эффекта, знаменатель снова не раскрыт. В мае 2025 года генеральный директор Себастьян Семятковски сказал в интервью Bloomberg: «We went too far» — мы зашли слишком далеко — и компания вернулась к найму людей, перейдя на гибридную модель. На какой из четырёх развилок Klarna ошиблась сильнее всего, на ваш взгляд?
40 · Дедупликация новостей — нужно склеивать сообщения об одном событии в одну карточку
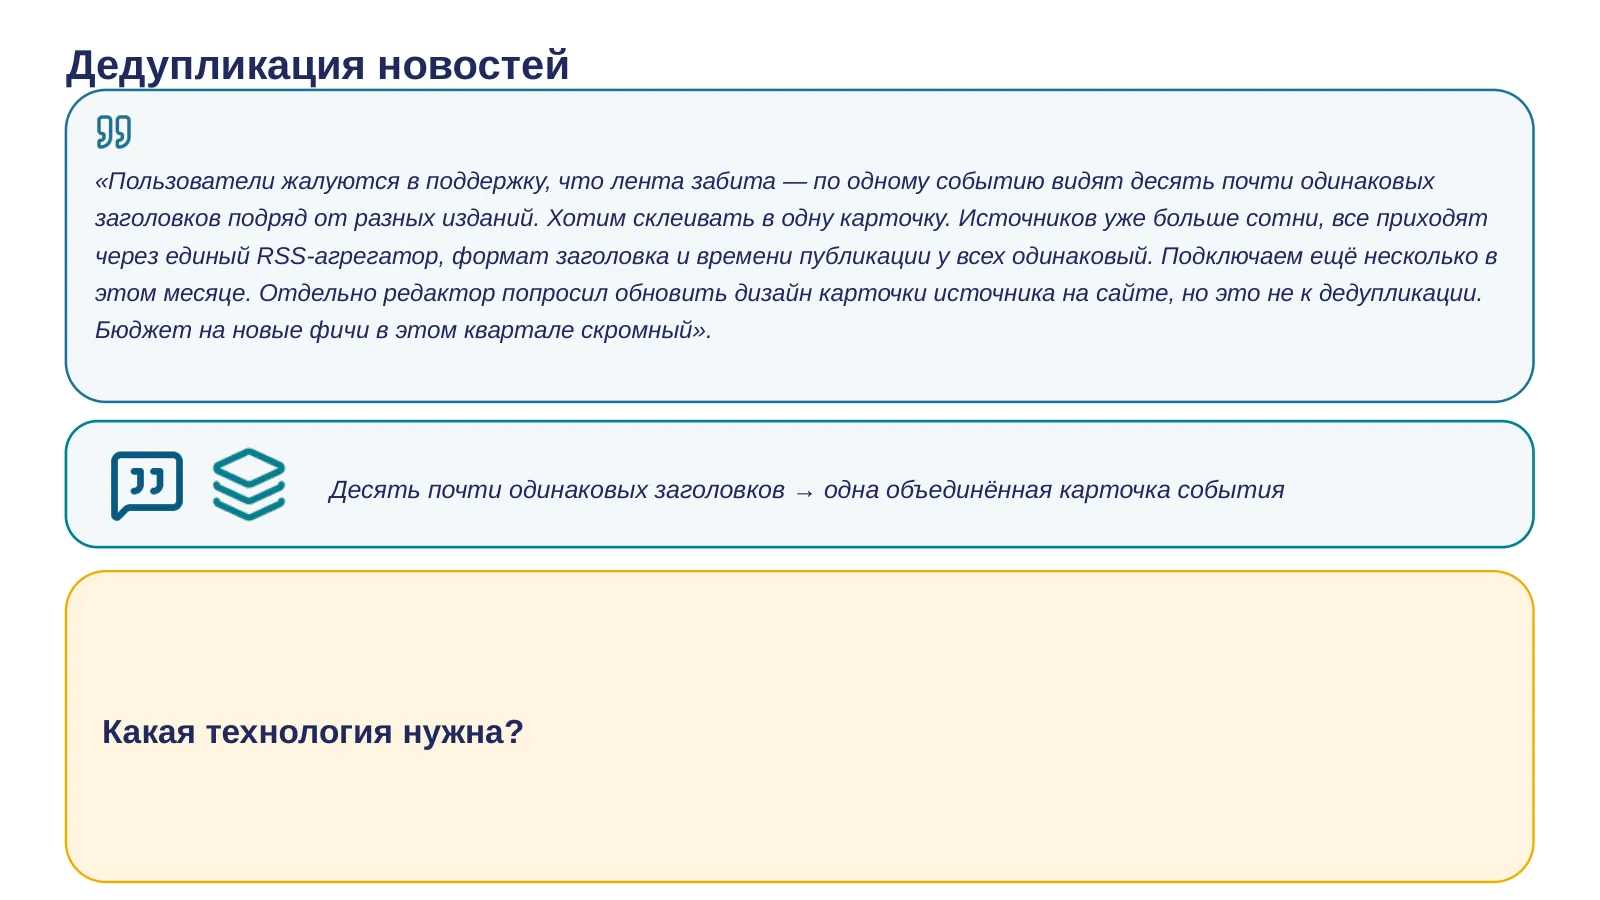
Зачитайте реплику продакта целиком. Прямой сигнал, не выделен особо: поток новостей из многих источников, нужно склеивать сообщения об одном и том же событии в одну карточку. Косвенный сигнал стоит вытащить: все источники уже нормализованы через единый RSS-агрегатор, то есть формат заголовка и метаданных единый — не нужно решать задачу парсинга разных форматов, только задачу сравнения содержимого. Редизайн карточки источника — шум-двойник: похож на изменение того же интерфейса ленты, но не имеет отношения к склейке дублей. Вопрос в зал: какая технология здесь нужна? Интуитивно многие сейчас скажут — нужно понимание смысла текста, значит модель, и придётся гонять каждую пару новостей через LLM, сравнивая их попарно. Согласны с этим, или у кого-то в зале уже есть сомнения на этот счёт? Подумайте, сколько таких пар новостей нужно будет сравнивать каждый день при большом потоке источников. При разборе спросите: какие факты из реплики повлияли на ваш выбор, а какие нет?
41 · Fuzzy-matching закрывает ~90% случаев дешевле и предсказуемее. LLM — на остаток
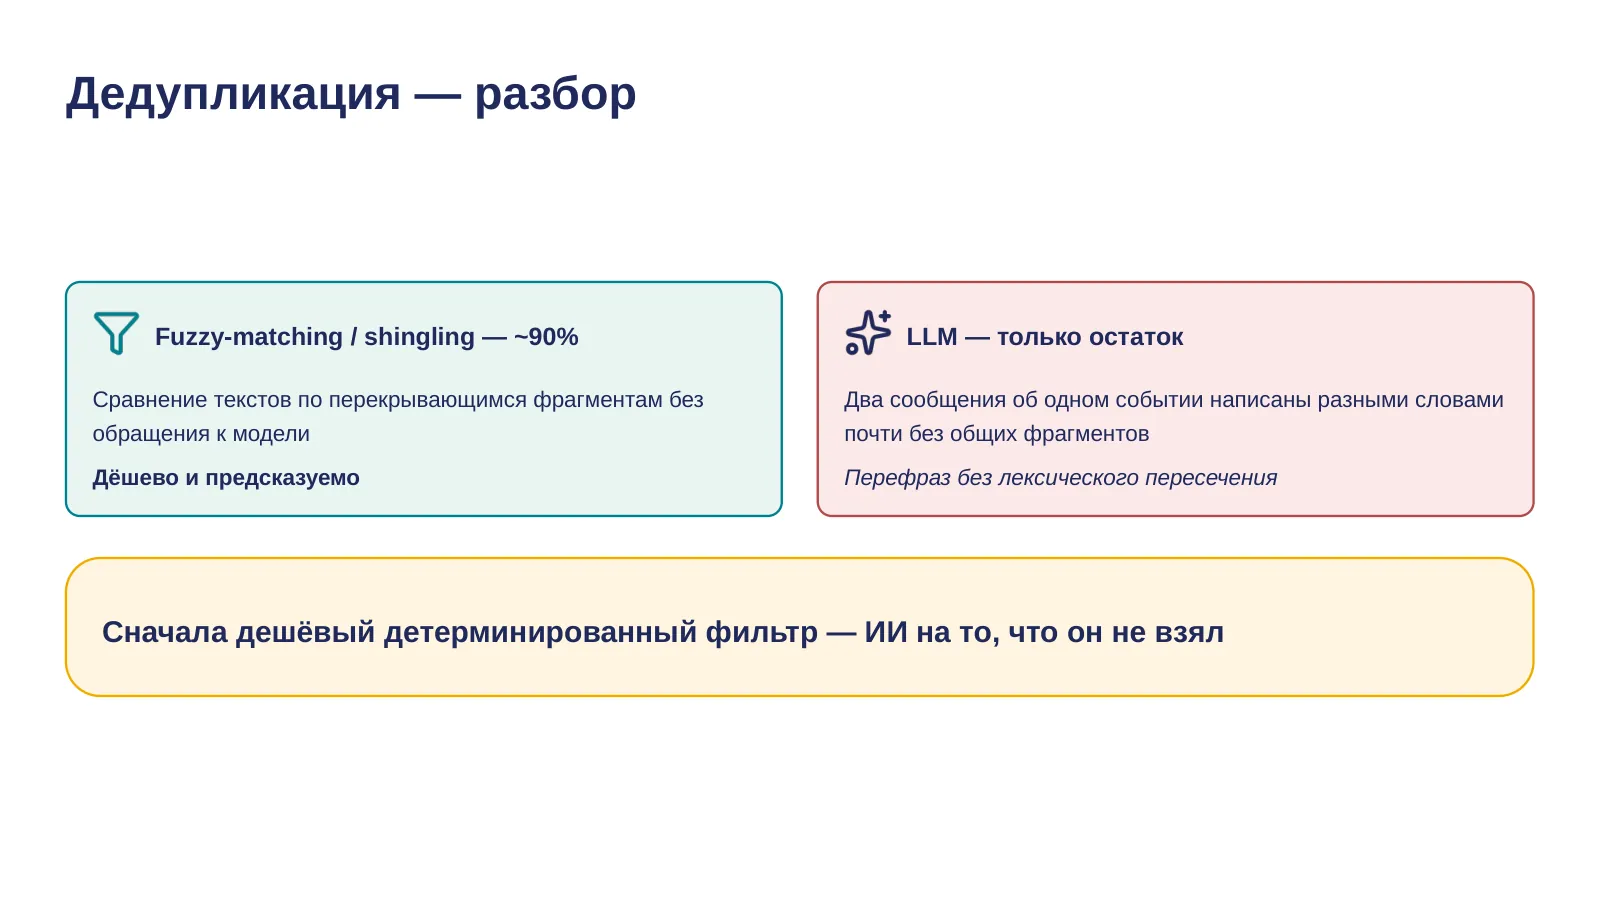
На самом деле сравнение текстов по перекрывающимся фрагментам — fuzzy-matching и shingling — без обращения к модели закрывает порядка 90% случаев дублирования, и делает это дешевле и предсказуемее, чем вызов модели на каждую пару новостей: результат детерминирован, легко отлаживается, не зависит от настроения модели. Модель нужна только на оставшуюся часть — случаи, где два сообщения об одном событии написаны совершенно разными словами и почти не имеют общих фрагментов текста, то есть это скорее перефраз, чем совпадение. Урок тот же, что был у нас в самом начале занятия с персональными данными в логах: сначала дешёвый детерминированный фильтр закрывает основную массу случаев, а модель — только на остаток, который фильтр физически не берёт.
42 · Сегодня вы решали, что строить. Лекция 2 — как модель устроена внутри
Сегодня мы прошли через семь ситуаций, и в каждой вы принимали решение — что вообще строить, какую архитектуру выбрать, где считать данные. Ни разу правильный ответ не был очевиден с первой формулировки — он всегда зависел от вопроса, который вы либо задавали, либо нет. Именно это умение и было целью занятия, а не запоминание конкретных кейсов. Дальше по курсу мы пойдём вглубь: на следующей лекции — как устроена модель внутри, что происходит на уровне архитектуры, когда вы отправляете ей запрос. Сегодняшние кейсы, надеюсь, дали вам интуицию, зачем это знание вообще нужно инженеру, а не только исследователю. Спасибо за живое обсуждение сегодня, до встречи на лекции.